计算机视觉学习笔记(第一期):一.图像分类:2.线性分类器
2.线性分类器
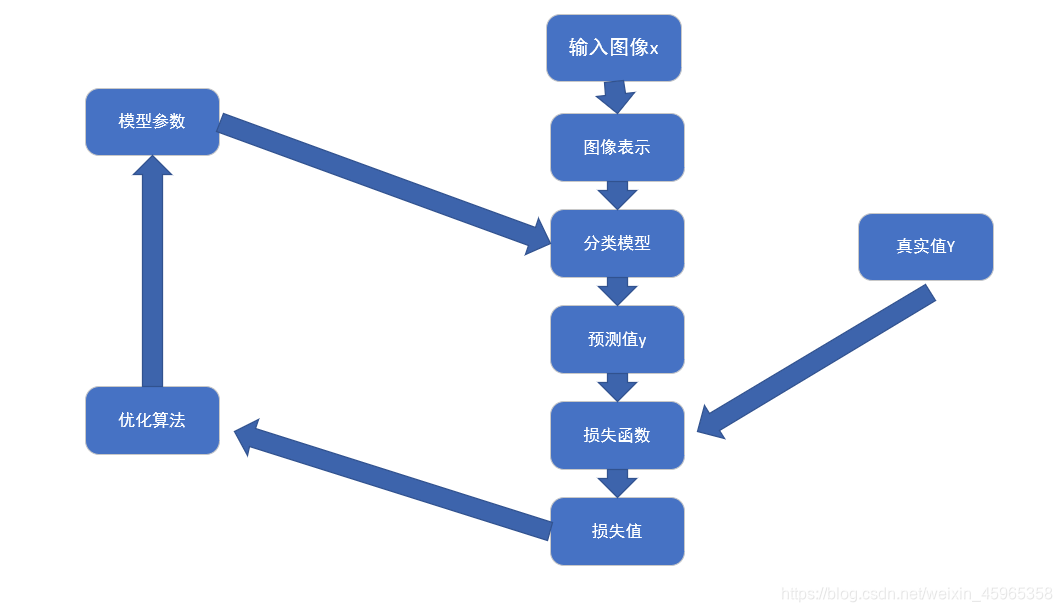
线性分类器定义
在机器学习领域,分类的目标是指将具有相似特征的对象聚集。而一个线性分类器则透过特征的线性组合来做出分类决定,以达到此种目的。对象的特征通常被描述为特征值,而在向量中则描述为特征向量。
f i ( x , w i ) = w i T + b i f_i(x, w_i) = w_i^T + b_i fi(x,wi)=wiT+bi
(1)
w
i
=
[
w
i
1
,
w
i
2
,
…
w
i
d
]
T
w_i = [{w_i}_1,{w_i}_2,…{w_i}_d]^T
wi=[wi1,wi2,…wid]T 为第i个类别的权值向量
(2)
b
i
b_i
bi为偏置值
(3)决策面:
w
i
T
+
b
i
=
0
w_i^T + b_i = 0
wiT+bi=0
损失函数
定义:
损失函数(loss function)或代价函数(cost function)是将随机事件或其有关随机变量的取值映射为非负实数以表示该随机事件的“风险”或“损失”的函数。
L
=
1
N
∑
i
L
i
(
f
(
x
i
,
w
)
,
y
i
)
+
λ
R
(
w
)
L= \frac{1}{N}\sum_iL_i(f(x_i,w),y_i)+λR(w)
L=N1i∑Li(f(xi,w),yi)+λR(w)
(1)数据损失:
1
N
∑
i
L
i
(
f
(
x
i
,
w
)
,
y
i
)
\frac{1}{N}\sum_iL_i(f(x_i,w),y_i)
N1∑iLi(f(xi,w),yi)
(2)正则损失:λR(w)
(3)超参数:λ
(超参数:在开始学习过程之前设置值的参数,而不是学习得到。)
(4)常见的正则项:
- L1正则项:R(w)= ∑ k ∑ l ∣ w k , l ∣ \sum_k\sum_l |w_{k,l}| ∑k∑l∣wk,l∣
- L2正则项:R(w)= ∑ k ∑ l w k , l 2 \sum_k\sum_lw_{k,l}^2 ∑k∑lwk,l2
- Elastic net(L1+L2) : R(w) =
∑
k
∑
l
β
w
k
,
l
2
+
∣
w
k
,
l
∣
\sum_k\sum_lβw_{k,l}^2+|w_{k,l}|
∑k∑lβwk,l2+∣wk,l∣
优化
数据集
| 数据集的子集 | 作用 |
|---|---|
| 训练集 | 用于给定的超集 |
| 验证集 | 选择超参数 |
| 测试集 | 评估泛化能力 |
!!!感兴趣的朋友可以参考我的另一篇博客:K折交叉验证
预处理

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)