python实现基于情感词典的文本情感分析(txt文档构造字典dict)
·
需求
之前做过文本分析是直接调用科大讯飞的API,之后有时间会整理出来。最近又做了一个基于情感词典的文本情感分析。原本打算拿来主义,实现自己的需求就好,但是网上找了很多代码都跑不起来,自己就慢慢分步骤写了出来。应该是有错误的
分析步骤
- 中文文章分句,这部分参考了这篇文章的代码👉中文分句
- 对单句进行分词
- 单句分词之后剔除停用词
- 对单句进行基于情感词典的评分
- 可视化
正文
中文文章分句
选取的文章是朱自清先生的荷塘月色
首先读取文章
with open('荷塘月色.txt','r', encoding="utf-8") as f:
    text  = f.read()
进行分句 参考👉中文分句
# 版本为python3,如果为python2需要在字符串前面加上u
import re
def cut_sent(para):
    para = re.sub('([。!?\?])([^”’])', r"\1\n\2", para)  # 单字符断句符
    para = re.sub('(\.{6})([^”’])', r"\1\n\2", para)  # 英文省略号
    para = re.sub('(\…{2})([^”’])', r"\1\n\2", para)  # 中文省略号
    para = re.sub('([。!?\?][”’])([^,。!?\?])', r'\1\n\2', para)
    # 如果双引号前有终止符,那么双引号才是句子的终点,把分句符\n放到双引号后,注意前面的几句都小心保留了双引号
    para = para.rstrip()  # 段尾如果有多余的\n就去掉它
    # 很多规则中会考虑分号;,但是这里我把它忽略不计,破折号、英文双引号等同样忽略,需要的再做些简单调整即可。
    return para.split("\n")
对单句进行分词
对单句进行分词,将单个句子的分词结果放进一个列表,最终分完词的结果是一个二维列表
from jieba import lcut

with open('荷塘月色.txt','r', encoding="utf-8") as f:
    text  = f.read()
text_data = cut_sent(text)  ## 直接调用上面的cut_sent方法
# 存储单句分词结果的列表
participles_list = []
# 循环遍历每一个单句进行分词
for i in range(len(text_data)):
    participles_list.append(lcut(text_data[i]))
    pass

单句分词之后剔除停用词
word_tokens = participles_list# 分词之后的列表
# 读取停用词表
with open('stopwords.txt','r') as f:
    stop_words = f.read()

# 对每一句话剔除停用词
fliter_list = []
for i in range(len(word_tokens)):
    fliter_list.append([w for w in word_tokens[i] if not w in stop_words])
fliter_list

对单句进行基于情感词典的评分
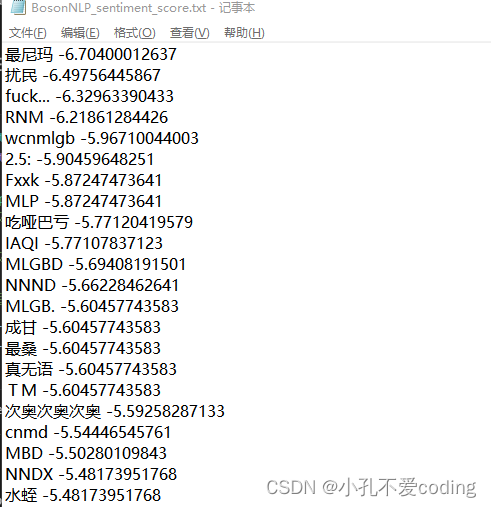
可以看到上面情感词典是一个词后面对应一个分数,我首先将情感词典的每个词和后面的分数构造成一个字典dict
import pandas as pd

df = pd.read_table('E:/jupyter notebook/文本分析/BosonNLP_sentiment_score.txt', sep=" ", names=['key', 'score'])
# 提取出词
key = df['key'].values.tolist()
# 提取出分数
score = df['score'].values.tolist()
# 构造成一个字典
score_dict = dict(zip(key, score))
score_dict

对单句进行分别匹配计算分数值
# 最终进行匹配的列表:fliter_list
# 存单句分数的列表
emo_list = []
# 循环匹配计算单句得分
for i in range(len(fliter_list)):
    score_list = [score[key.index(x)] for x in fliter_list[i] if(x in key)]
    emo_list.append(sum(score_list))
    pass
emo_list

可视化
主要根据分数值绘制了波形图,看出这篇文章的情感变化,当然也可以画饼状图,看出情感占比
import pandas as pd
from pyecharts.charts import Line,Bar,Page,Map
from pyecharts import options as opts
from pyecharts.commons.utils import JsCode

visualization_df = pd.DataFrame(emo_list,columns=['score'])
x_axis = list(visualization_df.index)

# 背景色
background_color_js = """
new echarts.graphic.RadialGradient(0.3, 0.3, 0.8, [{offset: 0,color: '#f7f8fa'},
{offset: 1,color: '#cdd0d5'}])
"""

# 线条样式
linestyle_dic = { 'normal': {
                    'width': 4,
                    'shadowColor': '#696969',
                    'shadowBlur': 10,
                    'shadowOffsetY': 10,
                    'shadowOffsetX': 10,
                    }
                }


l1 = (
    Line(init_opts=opts.InitOpts(bg_color=JsCode(background_color_js)))
    .add_xaxis(xaxis_data=list(visualization_df.index))
    .add_yaxis(
        series_name="emo_score",
        y_axis=[round(float(i),3) for i in emo_list],
        symbol_size=8,
        is_smooth=True,
        color="#009ad6",
    )
    # 系列配置项
    .set_series_opts(linestyle_opts=linestyle_dic,
                     areastyle_opts=opts.AreaStyleOpts(opacity=0.6),
                     label_opts=opts.LabelOpts(is_show=False),
                     markline_opts=opts.MarkLineOpts(data=[opts.MarkLineItem(type_="average")]),
                     markpoint_opts=opts.MarkPointOpts(
                        data=[opts.MarkPointItem(type_="max"), opts.MarkPointItem(type_="min")],
                        symbol_size=[65, 50],
                        label_opts=opts.LabelOpts(position="inside", color="#fff", font_size=10)
                        ),
                    )
    # 通用配置项
    .set_global_opts(
        title_opts=opts.TitleOpts(
                title='文章情感趋势',
                pos_top='2%',
                title_textstyle_opts=opts.TextStyleOpts(color='#4169E1', font_size=20)),
        tooltip_opts=opts.TooltipOpts(trigger="axis"),
        xaxis_opts=opts.AxisOpts(name="",type_="category",
                         boundary_gap=True,
                         axisline_opts=opts.AxisLineOpts(is_show=True,
                                                         linestyle_opts=opts.LineStyleOpts(width=2, color='#DB7093')),
                         axislabel_opts=opts.LabelOpts(rotate=45)),
        yaxis_opts=opts.AxisOpts(
                axislabel_opts=opts.LabelOpts(formatter="{value} "),
                is_scale=True,
                name_textstyle_opts=opts.TextStyleOpts(font_size=12,font_weight='bold',color='#FF1493'),
                splitline_opts=opts.SplitLineOpts(is_show=True,
                                                  linestyle_opts=opts.LineStyleOpts(type_='dashed')),
                axisline_opts=opts.AxisLineOpts(is_show=False,
                                        linestyle_opts=opts.LineStyleOpts(width=2, color='#DB7093'))
            ),
        # 图例样式
        legend_opts=opts.LegendOpts(is_show=True, pos_right='1%', pos_top='2%',legend_icon='roundRect'),
    )
)

l1.render_notebook()

结束
基于情感词典的文本情感分析,我应该做的不对。如果有大佬看到这篇文章望不吝赐教
个人邮箱:k1933211129@163.com

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐

 0
 0
- 0


 已为社区贡献4条内容

所有评论(0)