深度学习计算 & 卷积神经网络——动手学深度学习5~6
环境:PyCharm + python3.8
👉【深度学习计算】
1. 层和块
块(block)可以描述
- 单个层、
- 由多个层组成的组件
- 或整个模型本身。
使用块进行抽象的好处:
- 可将块组合成更大的组件(这一过程通常是递归) 如 图5.1.1所示。
- 通过定义代码来按需生成任意复杂度的块,可以通过简洁的代码实现复杂的神经网络。

从编程的角度来看,块由类(class)表示。
- 其子类都必须定义一个前向传播函数(将其输入转换为输出),且必须存储任何必需的参数(有些块不需要任何参数)。
- 最后,为了计算梯度,块必须具有反向传播函数。在定义自己的块时,由于自动微分(在 2.5节 中引入)提供了一些后端实现,我们只需要考虑前向传播函数和必需的参数。
下面代码生成一个网络,其中包含
- 具有 256个单元 和 ReLU激活函数 的全连接隐藏层,
- 具有 10个隐藏单元 且 不带激活函数 的全连接输出层。
import torch
from torch import nn
from torch.nn import functional as F

net = nn.Sequential(
    nn.Linear(20, 256),
    nn.ReLU(),
    nn.Linear(256, 10))

X = torch.rand(2, 20)
print(f"随机生成的原始输入:\n{X}")
print(f"模型输出:\n{net(X)}")
该例子通过实例化nn.Sequential来构建模型,层的执行顺序是作为参数传递的。
nn.Sequential定义了一种特殊的Module,即在PyTorch中表示一个块的类,它维护了一个由Module组成的有序列表。- 注意:两个全连接层都是
Linear类的实例,Linear类本身就是Module的子类。 net(X)实际上是net.__call__(X)的简写 (我们前面一直在通过net(X)调用我们的模型来获得模型的输出)。- 这个前向传播函数非常简单:它将列表中的每个块连接在一起,将每个块的输出作为下一个块的输入。
1.1. 自定义块
简要总结每个块必须提供的基本功能:
- 将输入数据作为其前向传播函数的参数。
- 通过前向传播函数来生成输出。(注意:输出的形状可能与输入的形状不同。例如,上面模型中的第一个全连接的层接收一个20维的输入,但是返回一个维度为256的输出)。
- 计算其输出关于输入的梯度,可通过其反向传播函数进行访问(通常是自动发生)。
- 存储和访问前向传播计算所需的参数。
- 根据需要初始化模型参数。
下面的代码片段从零开始编写一个块。(包含一个多层感知机,其具有256个隐藏单元的隐藏层和一个10维输出层)。 注意,下面的MLP类继承了表示块的类。我们的实现只需要提供我们自己的构造函数(Python中的__init__函数)和前向传播函数。
class MLP(nn.Module):
    # 用模型参数声明层,这里声明两个全连接的层
    def __init__(self):
        # 调用MLP的父类Module的构造函数来执行必要的初始化
        # 这样,在类实例化时也可以指定其他函数参数,例如模型参数params(稍后将介绍)
        super().__init__()
        self.hidden = nn.Linear(20, 256)  # 隐藏层
        self.out = nn.Linear(256, 10)  # 输出层

    # 定义模型的前向传播,即如何根据输入X返回所需的模型输出
    def forward(self, X):
        # 注意:这里使用ReLU的函数版本,其在nn.functional模块中定义。
        return self.out(F.relu(self.hidden(X)))
前向传播函数:
- 以
X作为输入, - 计算带有激活函数的隐藏表示,
- 并输出其未规范化的输出值。
在这个MLP实现中,两个层都是实例变量。要了解这为什么是合理的,可以想象实例化两个多层感知机(net1和net2),并根据不同的数据对它们进行训练。
接着我们实例化多层感知机的层,然后在每次调用前向传播函数时调用这些层。注意一些关键细节:
- 首先,定制的
__init__函数通过super().__init__()调用父类的__init__函数 (避免了重复编写模版代码)。 - 然后,实例化两个全连接层, 分别为
self.hidden和self.out。 - 注意,除非要实现一个新的运算符,否则不必担心反向传播函数或参数初始化,系统将自动生成这些。
net = MLP()
mlp_Out = net(X)
print(f"MLP模型输出:\n{mlp_Out}")
块的一个主要优点是它的多功能性。我们可以子类化块以创建
- 层(如全连接层的类)、
- 整个模型(如上面的
MLP类) - 或具有中等复杂度的各种组件。
1.2. 顺序块
Sequential的设计是为了把其他模块串起来。
构建自己的简化的MySequential,只需定义两个关键函数:
- 一种将块逐个追加到列表中的函数;
- 一种前向传播函数,用于将输入按追加块的顺序传递给块组成的“链条”。
下面的MySequential类提供了与默认Sequential类相同的功能。
# 直接将神经网络的每个层当作参数传进来
class MySequential(nn.Module):
    def __init__(self, *args):
        super().__init__() # 调用父类的构造函数
        for idx, module in enumerate(args):
            # 这里,module是Module子类的一个实例。我们把它保存在'Module'类的成员
            # 变量_modules中。_module的类型是OrderedDict
            self._modules[str(idx)] = module

    def forward(self, X):
        # OrderedDict保证了按照成员添加的顺序遍历它们
        for block in self._modules.values():
            X = block(X)
return X__init__函数将每个模块逐个添加到有序字典_modules中。_modules的主要优点是:在模块的参数初始化过程中,系统知道在_modules字典中查找需要初始化参数的子块。
当MySequential的前向传播函数被调用时,每个添加的块都按照它们被添加的顺序执行。下面使用MySequential类重新实现多层感知机。
net = MySequential(
    nn.Linear(20, 256),
    nn.ReLU(),
    nn.Linear(256, 10))
myModule_Out = net(X)
print(f"MySequential模型输出:\n{myModule_Out}")
1.3. 在前向传播函数中执行代码
当架构需要更强的灵活性时,则需要定义自己的块。
常数参数 (constant parameter):既不是上一层的结果 也不是可更新参数 的项。
- 例如,我们需要一个计算函数
的层,其中
- x 是 输入,
- w 是 参数,
- c 是 某个在优化过程中没有更新的指定常量。
因此下面实现一个FixedHiddenMLP类,如下所示:
class FixedHiddenMLP(nn.Module):
    def __init__(self):
        super().__init__()
        # 不计算梯度的随机权重参数。因此其在训练期间保持不变
        self.rand_weight = torch.rand((20, 20), requires_grad=False)
        self.linear = nn.Linear(20, 20)

    def forward(self, X):
        X = self.linear(X)
        # 使用创建的常量参数以及relu和mm函数
        X = F.relu(torch.mm(X, self.rand_weight) + 1)
        # 复用全连接层。这相当于两个全连接层共享参数
        X = self.linear(X)
        # 控制流
        while X.abs().sum() > 1:
            X /= 2
return X.sum()在这个FixedHiddenMLP模型中,
- 实现了一个隐藏层,其权重(
self.rand_weight) 在实例化时被随机初始化,之后为常量。 - 这个权重不是一个模型参数,因此它永远不会被反向传播更新。
- 然后,神经网络将这个固定层的输出通过一个全连接层。
- 注意:在返回输出之前,模型做了一些不寻常的事情:
- 它运行了一个while循环,在 L1范数>1 的条件下,将输出向量除以2,直到它满足条件为止。
- 最后,模型返回了
X中所有项的和。 - 注意:此操作可能不会常用于在任何实际任务中,这里只展示如何将任意代码集成到神经网络计算的流程中。
net = FixedHiddenMLP()
fixMLP_Out = net(X)
print(f"FixedHiddenMLP模型输出:\n{fixMLP_Out}") 
也可以混合搭配各种组合块的方法。如下例子,我们以一些想到的方法嵌套块:(网络结构如下)
- NestMLP(),
- net()
- nn.Linear(20, 64), nn.ReLU()
- nn.Linear(64, 32), nn.ReLU()
- nn.Linear(32, 16)
- net()
- nn.Linear(16, 20),
- FixedHiddenMLP()
- nn.Linear(20, 20)
- x*w+1, nn.ReLU()
- nn.Linear(20, 20)
- x一直减半直到 其值的和>1。
class NestMLP(nn.Module):
    def __init__(self):
        super().__init__()
        self.net = nn.Sequential(nn.Linear(20, 64), nn.ReLU(),
                                 nn.Linear(64, 32), nn.ReLU())
        self.linear = nn.Linear(32, 16)

    def forward(self, X):
        return self.linear(self.net(X))

chimera = nn.Sequential(NestMLP(), nn.Linear(16, 20), FixedHiddenMLP())
print(f"NestMLP模型输出:\n{chimera(X)}")
1.4. 效率
读者可能会开始担心操作效率的问题。毕竟,我们在一个高性能的深度学习库中进行了大量的字典查找、代码执行和许多其他的Python代码。Python的问题全局解释器锁 是众所周知的。在深度学习环境中,我们担心速度极快的GPU可能要等到CPU运行Python代码后才能运行另一个作业。
小结
一个块可以由许多层组成;一个块可以由许多块组成。
块可以包含代码。
块负责大量的内部处理,包括参数初始化和反向传播。
层和块的顺序连接由
Sequential块处理。
2. 参数管理
选择好架构并设置好超参数后,下一阶段就是训练阶段。
训练阶段的目标:找到 使损失函数最小化 的模型参数值。(这些参数就是用于做出未来的预测)
本节内容:
- 访问参数,用于调试、诊断和可视化;
- 参数初始化;
- 在不同模型组件间共享参数。
首先看一下具有单隐藏层的多层感知机:
import torch
from torch import nn

net = nn.Sequential(nn.Linear(4, 8), nn.ReLU(), nn.Linear(8, 1))
X = torch.rand(size=(2, 4))
print(f"随机生成的原始输入:\n{X}")
print(f"模型输出:\n{net(X)}")
2.1. 参数访问
从已有模型中访问参数:
- 当通过
Sequential类定义模型时,可以通过索引来访问模型的任意层。 - 可以把模型当作一个列表,每层的参数都在其属性中。
- 如下所示,可以检查第二个全连接层的参数。
print(f"第二个全连接层的参数:\n{net[2].state_dict()}")
输出的结果显示:
- 该全连接层包含两个参数,分别是该层的 权重 和 偏置。
- 两者都存储为单精度浮点数(float32)。
- 注意,参数名称允许唯一标识每个参数,即使在包含数百个层的网络中也是如此。
2.1.1. 目标参数
每个参数都表示为参数类的一个实例。要对参数执行任何操作,首先需要访问底层的数值。有几种方法可以做到这一点。下面的代码从第二个全连接层(即第三个神经网络层)提取偏置, 提取后返回的是一个参数类实例,并进一步访问该参数的值。
# 从第二个全连接层(即第三个神经网络层)提取偏置:
# 参数是复合的对象,包含值、梯度和额外信息,因此需要显式参数值
print(f"类型:{type(net[2].bias)}")
print(f"值(包括其形状和数据类型):\n{net[2].bias}")
print(f"数据部分(偏置参数的底层数据张量):{net[2].bias.data}")
除了值之外,还可以访问每个参数的梯度。在上面这个网络中,由于还没有调用反向传播,所以参数的梯度处于初始状态。
print(f"参数的梯度:{net[2].weight.grad == None}") 
2.1.2. 一次性访问所有参数
- 当需要对所有参数执行操作时,逐个访问会很麻烦。
- 当处理更复杂的块(例如,嵌套块)时,情况会变得特别复杂,因为需要递归整个树来提取每个子块的参数。
下面,将通过演示来比较 访问第一个全连接层的参数 和 访问所有层。
print(f"---访问第一个全连接层的参数:\n{[(name, param.shape) for name, param in net[0].named_parameters()]}")
print(f"---访问所有层:\n{[(name, param.shape) for name, param in net.named_parameters()]}")
# print(*[(name, param.shape) for name, param in net[0].named_parameters()])
# print(*[(name, param.shape) for name, param in net.named_parameters()])
这为我们提供了另一种访问网络参数的方式,如下所示
# net.state_dict() 返回模型的参数字典
# ['2.bias'] 从参数字典中 获取模型中第三个模块(索引从0开始)的偏置参数
print(f"另一种访问网络参数的方式:{net.state_dict()['2.bias'].data}")
2.1.3. 从嵌套块收集参数
若将多个块相互嵌套,参数命名约定是如何工作的。首先定义一个生成块的函数(可以说是“块工厂”),然后将这些块组合到更大的块中。
def block1():
    return nn.Sequential(nn.Linear(4, 8), nn.ReLU(),
                         nn.Linear(8, 4), nn.ReLU())

def block2():
    net = nn.Sequential()
    for i in range(4):
        # 在这里嵌套
        net.add_module(f'block {i}', block1())
    return net

rgnet = nn.Sequential(block2(), nn.Linear(4, 1))
rgnet(X)
print(f"嵌套块 模型输出:\n{rgnet(X)}")
设计了网络后,接下来看看它是如何工作的。
print(f"嵌套块 模型结构:\n{rgnet}")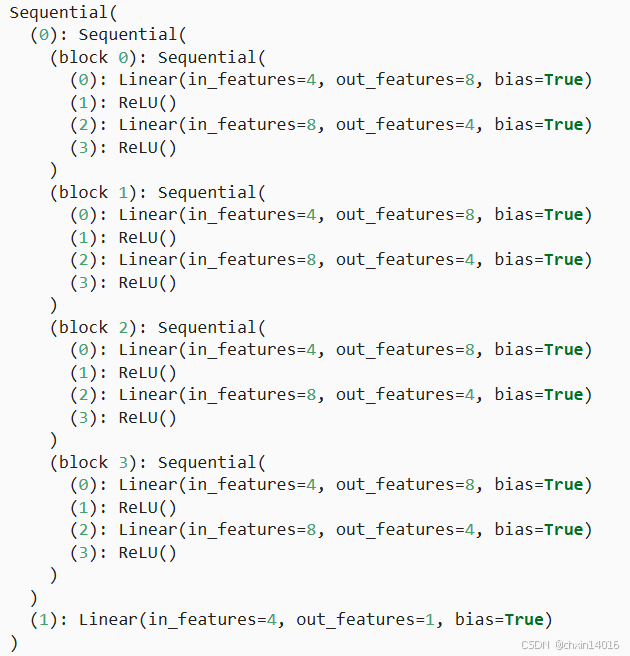
因为层是分层嵌套的,所以我们也可以像通过嵌套列表索引一样访问它们。
访问 第一个主要的块中、第二个子块的第一层的偏置项:
print(f"第一个主要的块中、第二个子块的第一层的偏置项:\n{rgnet[0][1][0].bias.data}")
2.2. 参数初始化
- 深度学习框架提供默认随机初始化,
- 也允许创建自定义初始化方法,满足我们通过其他规则实现初始化权重。
- 默认情况下,PyTorch会根据一个范围均匀地初始化权重和偏置矩阵,
- 这个范围是根据输入和输出维度计算出的。
- PyTorch的
nn.init模块提供了多种预置初始化方法。
2.2.1. 内置初始化
首先调用内置的初始化器。
2.2.1.1 初始化为高斯随机变量
- 将所有权重参数初始化为标准差为0.01的高斯随机变量,且将偏置参数设置为0。
# 将所有权重参数初始化为 标准差=0.01的高斯随机变量,且将偏置参数设置为0
def init_normal(m):
    if type(m) == nn.Linear:
        nn.init.normal_(m.weight, mean=0, std=0.01)
        nn.init.zeros_(m.bias)
net.apply(init_normal)
print(f"权重初始化为 标准差=0.01的高斯随机变量:\n{net[0].weight.data[0]}")
print(f"偏置初始化为 常量0:\n{net[0].bias.data[0]}") 
2.2.1.2 初始化为给定的常数
- 将所有参数初始化为给定的常数,比如初始化为1。
# 将所有参数初始化为给定的常数,比如初始化为1
def init_constant(m):
    if type(m) == nn.Linear:
        nn.init.constant_(m.weight, 1)
        nn.init.zeros_(m.bias)
net.apply(init_constant)
print(f"权重初始化为 常量1:\n{net[0].weight.data[0]}")
print(f"偏置初始化为 常量0:\n{net[0].bias.data[0]}")
2.2.1.3 对不同块应用不同的初始化方法
- 对不同块应用不同的初始化方法。
例如,使用Xavier初始化方法初始化第一个神经网络层,然后将第三个神经网络层初始化为常量值42。
'''
Xavier初始化:
    根据输入和输出的维度自动调整初始化的范围,
    使得每一层的输出的方差在训练初期保持一致。
    (助于缓解梯度消失和梯度爆炸)
均匀分布:
    xavier_uniform_()使用均匀分布来初始化权重,而不是正态分布。
    均匀分布的范围是[-limit, limit],其中limit是根据输入和输出维度计算得出的
'''
# 对某些块应用不同的初始化方法
def init_xavier(m):
if type(m) == nn.Linear:
nn.init.xavier_uniform_(m.weight)
def init_42(m):
if type(m) == nn.Linear:
nn.init.constant_(m.weight, 42)
net[0].apply(init_xavier) # 使用Xavier初始化方法初始化第一个神经网络层
net[2].apply(init_42) # 将第三个神经网络层初始化为常量值42
print(f"第一层网络,使用Xavier初始化权重:\n{net[0].weight.data[0]}")
print(f"第三层网络,权重初始化为 常量42:\n{net[2].weight.data}")
2.2.2. 自定义初始化
有时,深度学习框架没有提供我们需要的初始化方法。在下例中,使用以下的分布为任意权重参数w定义初始化方法:

同样,实现一个my_init函数来应用到net。
def my_init(m):
    if type(m) == nn.Linear:
        print("Init", *[(name, param.shape)
                        for name, param in m.named_parameters()][0])
        nn.init.uniform_(m.weight, -10, 10) # 使用均匀分布初始化权重,范围是[-10, 10]
        # 对权重进行阈值处理,将绝对值小于 5 的元素设置为 0。
        # 即 只有 绝对值>=5 的权重会被保留,其余的被置零
        m.weight.data *= m.weight.data.abs() >= 5
net.apply(my_init)
print(f"自定义初始化:\n{net[0].weight[:2]}")
注意,我们始终可以直接设置参数。
net[0].weight.data[:] += 1      # 将第一个模块的所有权重值加 1
net[0].weight.data[0, 0] = 42   # 将第一个模块的权重张量的 [0, 0] 位置的值设置为 42
print(f"对权重进行手动修改后:\n{net[0].weight[:2]}")
2.2.3. 参数绑定 (共享参数)
有时希望在多个层间共享参数:我们可以定义一个稠密层,然后使用它的参数来设置另一个层的参数。
# 参数绑定
# 我们需要给共享层一个名称,以便可以引用它的参数
shared = nn.Linear(8, 8)
net = nn.Sequential(nn.Linear(4, 8), nn.ReLU(),
                    shared, nn.ReLU(),
                    shared, nn.ReLU(),
                    nn.Linear(8, 1))
net(X)
print(f"检查参数是否相同:\n"
      f"{net[2].weight.data[0] == net[4].weight.data[0]}")
net[2].weight.data[0, 0] = 100
print(f"确保它们实际上是同一个对象,而不只是有相同的值:\n"
      f"{net[2].weight.data[0] == net[4].weight.data[0]}")
这个例子表明第三个和第五个神经网络层的参数是绑定的。
- 它们不仅值相等,而且由相同的张量表示。
- 因此,若改变其中一个参数,另一个参数也会改变。
- 当参数绑定时,由于模型参数包含梯度,因此在反向传播期间第二个隐藏层 (即第三个神经网络层)和第三个隐藏层(即第五个神经网络层)的梯度会加在一起。
共享参数通常可以节省内存,并在以下方面具有特定的好处:
- 对于图像识别中的CNN,共享参数使网络能够在图像中的任何地方而不是仅在某个区域中查找给定的功能。
- 对于RNN,它在序列的各个时间步之间共享参数,因此可以很好地推广到不同序列长度的示例。
- 对于自动编码器,编码器和解码器共享参数。 在具有线性激活的单层自动编码器中,共享权重会在权重矩阵的不同隐藏层之间强制正交。
小结
我们有几种方法可以访问、初始化和绑定模型参数。
可以使用自定义初始化方法。
3. 延后初始化
延后初始化 (defers initialization):直到数据第一次通过模型传递时,框架才会动态地推断出每个层的大小。
tensorflow 版本:
def delay_initialization_tf(): # tensorflow版本
    import tensorflow as tf
    net = tf.keras.models.Sequential([
        tf.keras.layers.Dense(256, activation=tf.nn.relu),
        tf.keras.layers.Dense(10),
    ])
    print(f"访问输入层的权重参数:\n{[net.layers[i].get_weights() for i in range(len(net.layers))]}")
    X = tf.random.uniform((2, 20))
    net(X)
    print(f"将数据通过网络,使框架初始化参数:\n{[w.shape for w in net.get_weights()]}")
delay_initialization_tf()

def delay_initialization():
    net = nn.Sequential(nn.LazyLinear(64),
                        nn.ReLU(),
                        nn.LazyLinear(10))
    print(f"尚未初始化:\n{net}")
    print(net[0].weight)  # 尚未初始化,会报错
    print(f"输入层的权重参数:\n{[net[i].state_dict() for i in range(len(net))]}")

    X = torch.rand(2, 20)
    net(X) # 数据第一次通过模型传递
    print(f"数据第一次通过模型传递后,完成初始化:{net}")
    print(f"输入层的权重参数:\n{net[0].weight}")
delay_initialization()
3.1. 实例化网络
让实例化一个多层感知机:
    net = nn.Sequential(nn.LazyLinear(64),
                        nn.ReLU(),
                        nn.LazyLinear(10))
此时输入维数是未知的,因此网络不可能知道输入层权重的维数。因此,框架尚未初始化任何参数:
    print(f"尚未初始化:\n{net}")
    print(net[0].weight)  # 尚未初始化,会报错
print(f"输入层的权重参数:\n{[net[i].state_dict() for i in range(len(net))]}") 


注意:每个层对象都存在,但权重为空,参数显示未初始化。使用net.get_weights()将抛出一个错误,因为权重尚未初始化。
接下来将数据通过网络,最终使框架初始化参数:
    X = torch.rand(2, 20)
    net(X) # 数据第一次通过模型传递
    print(f"数据第一次通过模型传递后,完成初始化:{net}")
    print(f"输入层的权重参数:\n{net[0].weight}")
- 一旦知道输入维数是20,框架可以通过代入值20来识别第一层权重矩阵的形状。
- 识别出第一层的形状后,框架处理第二层,
- 依此类推,直到所有形状都已知为止。
- 注意:在这种情况下,只有第一层需要延迟初始化,但是框架仍是按顺序初始化的。等到知道了所有的参数形状,框架就可以初始化参数。
小结
延后初始化使框架能够自动推断参数形状,使修改模型架构变得容易,避免了一些常见的错误。
我们可以通过模型传递数据,使框架最终初始化参数。
练习
- Q1: 如果指定了第一层的输入尺寸,但没有指定后续层的尺寸,会发生什么?是否立即进行初始化?
- A1: 可以正常运行。第一层会立即初始化,但其他层同样是直到数据第一次通过模型传递才会初始化(不知道题目理解的对不对)
- Q2: 如果指定了不匹配的维度会发生什么?
- A2:
- 如果在定义模型时,模块的输出尺寸和下一个模块的输入尺寸不匹配,PyTorch会在第一次调用
forward时抛出错误。 - 例如,如果你有一个
LazyLinear层输出尺寸为10,但下一个LazyLinear层期望输入尺寸为20,则在第一次forward调用时会引发错误
- 如果在定义模型时,模块的输出尺寸和下一个模块的输入尺寸不匹配,PyTorch会在第一次调用
- A2:
- Q3: 如果输入具有不同的维度,你需要做什么?提示:查看参数绑定的相关内容。
- A3:
- 如果输入维度比指定维度小,可以考虑使用padding填充;
- 如果输入维度比指定维度大,可以考虑用pca等降维方法,将维度降至指定维度。
- A3:
4. 自定义层
4.1. 不带参数的层
下面的CenteredLayer类要从其输入中减去均值。要构建它,只需继承基础层类并实现前向传播功能。
import torch
import torch.nn.functional as F
from torch import nn

class CenteredLayer(nn.Module): # 从输入中减去均值
    def __init__(self):
        super().__init__()

    def forward(self, X):
        return X - X.mean()
向该层提供一些数据,验证它是否能按预期工作:
layer = CenteredLayer()
X = torch.FloatTensor([1, 2, 3, 4, 5])
print(f"输入:{X}")
print(f"均值:{X.mean()}")
print(f"网络输出:{layer(X)}")
现在,可以将层作为组件合并到更复杂的模型中:
# 将层作为组件合并到更复杂的模型中
net = nn.Sequential(nn.Linear(8, 128), CenteredLayer())
作为额外的健全性检查,我们可以在向该网络发送随机数据后,检查均值是否为0。由于处理的是浮点数,因为存储精度的原因,我们仍然可能会看到一个非常小的非零数。
Y = net(torch.rand(4, 8)) # 向该网络发送随机数据
# print(f"将层作为组件合并到更复杂的模型中:{Y}")
print(f"检查均值是否为0 Y.mean():{Y.mean()}")
4.2. 带参数的层
定义具有参数(参数可以通过训练进行调整)的层,这些参数可以使用内置函数来创建。
- 内置函数提供一些基本的管理功能 (比如管理访问、初始化、共享、保存和加载模型参数)。
- 如此可以不需要为每个自定义层编写自定义的序列化程序。
下面实现自定义版本的全连接层,该层需要权重和偏置项两个参数。 这里使用修正线性单元作为激活函数。 该层需要输入参数:in_units和units,分别表示输入数和输出数。
class MyLinear(nn.Module):
    def __init__(self, in_units, units):
        super().__init__()
        # 权重和偏置项皆初始化为随机正态分布
        self.weight = nn.Parameter(torch.randn(in_units, units))
        self.bias = nn.Parameter(torch.randn(units,))
    def forward(self, X):
        linear = torch.matmul(X, self.weight.data) + self.bias.data
return F.relu(linear)接下来,实例化MyLinear类并访问其模型参数:
linear = MyLinear(5, 3)
print(f"自定义全连接层的权重:\n{linear.weight}")
可以使用自定义层直接执行前向传播计算:
print(f"使用自定义层直接执行前向传播计算:\n{linear(torch.rand(2, 5))}")
还可以使用自定义层构建模型,就像使用内置的全连接层一样使用自定义层:
net = nn.Sequential(MyLinear(64, 8), MyLinear(8, 1))
print(f"使用自定义全连接层构建的复杂模型,预测结果:\n{net(torch.rand(2, 64))}")
小结
可以通过基本层类 设计自定义层。以此来定义 行为与深度学习框架中的任何现有层不同的 灵活的 新层。
在自定义层定义完成后,就可以在任意环境和网络架构中调用该自定义层。
层可以有局部参数,这些参数可以通过内置函数创建。
5. 读写文件
- 保存训练的模型,可以 以备将来在各种环境中使用(比如在部署中进行预测)。
- 当运行一个耗时较长的训练过程时,定期保存中间结果,可以防止在服务器电源被不小心断掉时,损失几天的计算结果。
5.1. 加载和保存张量
对于单个张量,可以直接调用load和save函数分别读写它们。这两个函数都要求提供一个名称,save要求将要保存的变量作为输入。
import torch
from torch import nn
from torch.nn import functional as F

x = torch.arange(4)
torch.save(x, 'outputFile/x-file') # 将张量保存到文件中
然后可以将存储在文件中的数据读回内存:
x2 = torch.load('outputFile/x-file', weights_only=False) # 从文件中加载张量,并赋值
print(f"x2={x2}")
可以存储一个张量列表,然后把它们读回内存:
# 存储一个张量列表,然后把它们读回内存:
y = torch.zeros(4)
torch.save([x, y],'outputFile/x-files') # 将两个张量保存到文件中
x2, y2 = torch.load('outputFile/x-files', weights_only=False) # 加载列表中的张量,并将其解包到 x2 和 y2
print(f"x2, y2 = {x2, y2}")
也可以写入或读取从字符串映射到张量的字典。这利于读取或写入模型中的所有权重:
# 写入或读取从字符串映射到张量的字典
mydict = {'x': x, 'y': y} # 创建字典
torch.save(mydict, 'outputFile/mydict') # 将字典保存到文件 mydict 中
mydict2 = torch.load('outputFile/mydict', weights_only=False) # 加载字典,并将其赋值给 mydict2
print(f"mydict2={mydict2}")

5.2. 加载和保存模型参数
若想保存整个模型,并在以后加载它们,单独保存每个向量则会变得很麻烦。 毕竟,我们可能有数百个参数散布在各处。 因此,
- 深度学习框架提供了内置函数来保存和加载整个网络。
- 注意,保存的是 模型的参数,而不是保存整个模型。
例如,有一个3层多层感知机,我们需要单独指定架构。因为模型本身可以包含任意代码,所以模型本身难以序列化。 因此,恢复模型需要用代码生成架构,然后从磁盘加载参数。
下面以多层感知机为例:
class MLP(nn.Module):
    def __init__(self):
        super().__init__()
        self.hidden = nn.Linear(20, 256)
        self.output = nn.Linear(256, 10)

    def forward(self, x):
        return self.output(F.relu(self.hidden(x)))

net = MLP()
X = torch.randn(size=(2, 20))
Y = net(X)
接下来,将模型的参数存储在一个叫做“mlp.params”的文件中:
torch.save(net.state_dict(), 'outputFile/mlp.params')为了恢复模型,我们实例化了原始多层感知机模型的一个备份。这里不需要随机初始化模型参数,而是直接读取文件中存储的参数:
clone = MLP()
print(f"模型:\n{clone}")
# 直接读取文件中存储的参数
# clone.load_state_dict(...) 将加载的状态字典应用到clone中
clone.load_state_dict(torch.load('outputFile/mlp.params', weights_only=False))
clone.eval() # 设置模型为评估模式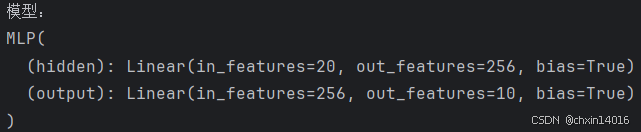
由于两个实例具有相同的模型参数,在输入相同的X时, 两个实例的计算结果应该相同。 下面进行验证:
Y_clone = clone(X)
print(f"副本与读上来版本的异同:\n{Y_clone == Y}")

小结
save和load函数可用于张量对象的文件读写。我们可以通过参数字典保存和加载网络的全部参数。
保存架构必须在代码中完成,而不是在参数中完成。
6. GPU
下载NVIDIA驱动和CUDA 并按照提示设置适当的路径。然后使用nvidia-smi命令来查看显卡信息:
!nvidia-smi 
在PyTorch中,每个数组都有一个设备(device),通常将其称为环境(context)。 默认情况下,所有变量和相关的计算都分配给CPU。有时环境可能是GPU。当跨多个服务器部署作业时,通过智能地将数组分配给环境,可以最大限度地减少在设备之间传输数据的时间。 例如,当在带有GPU的服务器上训练神经网络时, 我们通常希望模型的参数在GPU上。
首先确认电脑上是否有GPU,可以使用nvidia-smi查看;
如果有的话,可以先安装显卡驱动,然后安装pytorch的GPU版本就行。
6.1. 计算设备
可以指定用于存储和计算的设备,如CPU和GPU。
- 默认情况下,张量是在内存中创建的,然后使用CPU计算它。
在PyTorch中,CPU和GPU可以用torch.device('cpu') 和torch.device('cuda')表示。注意:
cpu设备意味着所有物理CPU和内存,这意味着PyTorch的计算将尝试使用所有CPU核心。gpu设备只代表一个卡和相应的显存。- 若有多个GPU,使用
torch.device(f'cuda:{i}')来表示第 i 块GPU(i从0开始)。
- 若有多个GPU,使用
cuda:0与cuda是等价。
import torch
from torch import nn

print(f"{torch.device('cpu'), torch.device('cuda'), torch.device('cuda:1')}")
print(f"CPU:{torch.device('cpu')}")
print(f"GPU:{torch.device('cuda')}")
print(f"第1块GPU:{torch.device('cuda:1')}")
可以查询可用gpu的数量:
print(f"GPU的数量:{torch.cuda.device_count()}")
现在定义两个方便的函数:允许我们在不存在所需所有GPU的情况下运行代码:
def try_gpu(i=0):  #@save
    """如果存在,则返回gpu(i),否则返回cpu()"""
    if torch.cuda.device_count() >= i + 1:  # 如果存在第 i 个 GPU
        return torch.device(f'cuda:{i}')    # 返回第 i 个 GPU 设备
    return torch.device('cpu') # 若系统中无足够的GPU设备(即GPU数量<i+1),则返回CPU设备

def try_all_gpus():  #@save
    """返回所有可用的GPU,如果没有GPU,则返回[cpu(),]"""
    devices = [torch.device(f'cuda:{i}')
             for i in range(torch.cuda.device_count())]
    # 如果存在可用的 GPU,则返回一个包含所有 GPU 设备的列表
    return devices if devices else [torch.device('cpu')]

print(f"{try_gpu(), try_gpu(10), try_all_gpus()}")
print(f"默认尝试返回第1个GPU设备:{try_gpu()}")
print(f"尝试返回第11个GPU设备:{try_gpu(10)}")
print(f"返回所有可用的GPU:{try_all_gpus()}")

6.2. 张量与GPU
可以查询张量所在的设备。 默认情况下,张量是在CPU上创建的。
x = torch.tensor([1, 2, 3])
print(f"{x.device}")

注意:无论何时我们要对多个项进行操作,它们都必须在同一个设备上。 例如,要确保求和的两个张量都位于同一设备上,否则框架将不知道在哪里存储结果,甚至不知道在哪里执行计算。
6.2.1. 存储在GPU上
有几种方法可以在GPU上存储张量。 例如,在创建张量的同时指定存储设备。接下来,我们在第一个gpu上创建张量变量X。 在GPU上创建的张量只消耗这个GPU的显存。可以使用nvidia-smi命令查看显存使用情况。一般来说,我们需要确保不创建超过GPU显存限制的数据。
X = torch.ones(2, 3, device=try_gpu())
X
假设至少有两个GPU,下面的代码将在第二个GPU上创建一个随机张量:
Y = torch.rand(2, 3, device=try_gpu(1))
Y
6.2.2. 复制
若要计算 X+Y,则需要决定在哪里执行该操作。 例如,如 图5.6.1所示,
- 可以将
X传输到第二个GPU并在那里执行操作。 - 不要 简单地
X加上Y,因为这会导致异常,运行时引擎不知道该怎么做:它在同一设备上找不到数据会导致失败。 - 由于
Y位于第二个GPU上,所以需要将X移到那里, 然后才能执行相加运算。

Z = X.cuda(1)
print(X)
print(Z)
现在数据在同一个GPU上(Z和Y都在),可以将它们相:
Y + Z
假设变量Z已经存在于第二个GPU上。如果我们还是调用Z.cuda(1)会发生什么? 它将返回Z,而不会复制并分配新内存。
Z.cuda(1) is Z
6.2.3. 旁注
- 人们使用GPU来进行机器学习,因为单个GPU相对运行速度快。
- 但是,在设备(CPU、GPU和其他机器)之间传输数据比计算慢得多。这也使得并行化变得更加困难。
- 因为我们必须等待数据被发送(或者接收), 然后才能继续进行更多的操作。这就是为什么拷贝操作要格外小心。根据经验,多个小操作比一个大操作糟糕得多。
- 此外,一次执行几个操作比代码中散布的许多单个操作要好得多。如果一个设备必须等待另一个设备才能执行其他操作,那么这样的操作可能会阻塞。类似排队订购咖啡,而不像通过电话预先订购:当客人到店的时候,咖啡已经准备好了。
最后,当我们打印张量或将张量转换为NumPy格式时, 如果数据不在内存中,框架会首先将其复制到内存中, 这会导致额外的传输开销。更糟糕的是,它现在受制于全局解释器锁,使得一切都得等待Python完成。
6.3. 神经网络与GPU
类似地,神经网络模型可以指定设备。下面的代码将模型参数放在GPU上。
net = nn.Sequential(nn.Linear(3, 1))
net = net.to(device=try_gpu())
# 或 net = net.to(torch.device('cuda:0'))  # 将模型移动到GPU上
接下来会有更多关于如何在GPU上运行模型的例子, 因为它们将变得更加计算密集。
当输入为GPU上的张量时,模型将在同一GPU上计算结果。
net(X)
确认模型参数存储在同一个GPU上:
net[0].weight.data.device
总之,只要所有的数据和参数都在同一个设备上,就可以有效地学习模型。
小结
可以指定用于存储和计算的设备,例如CPU或GPU。默认情况下,数据在主内存中创建,然后使用CPU进行计算。
深度学习框架要求计算的所有输入数据都在同一设备上,无论是CPU还是GPU。
不经意地移动数据可能会显著降低性能。一个典型的错误如下:计算GPU上每个小批量的损失,并在命令行中将其报告给用户(或将其记录在NumPy
ndarray中)时,将触发全局解释器锁,从而使所有GPU阻塞。最好是为GPU内部的日志分配内存,并且只移动较大的日志。
👉【卷积神经网络】
1. 从全连接层到卷积
卷积神经网络(convolutional neural networks,CNN)是机器学习利用自然图像中一些已知结构的创造性方法。
- 多层感知机对图像处理是百万维度,模型不可实现。
- 如果要在图片中找到某个物体,寻找方法应该和物体位置无关。
1.1. 不变性
假设需要从一张图片中找到某个物体:儿童游戏”沃尔多在哪里”。
沃尔多的样子并不取决于他潜藏的地方,因此
- 可以使用一个“沃尔多检测器”扫描图像。
- 该检测器将图像分割成多个区域,并为每个区域包含沃尔多的可能性打分。
- 卷积神经网络正是将空间不变性(spatial invariance)的这一概念系统化,从而基于这个模型使用较少的参数来学习有用的表示。

总结就是:(适合计算机视觉的神经网络架构:)
-
平移不变性(translation invariance):不管检测对象出现在图像中的哪个位置,神经网络的前面几层应该对相同的图像区域具有相似的反应,即为“平移不变性”。
-
局部性(locality):神经网络的前面几层应该只探索输入图像中的局部区域,而不过度在意图像中相隔较远区域的关系,这就是“局部性”原则。最终,可以聚合这些局部特征,以在整个图像级别进行预测。
1.2. 多层感知机的限制
首先,多层感知机的
- 输入是二维图像X,
- 其隐藏表示H在数学上是一个矩阵,在代码中表示为二维张量。
- 其中X和H具有相同的形状。
- 为了方便理解,我们可以认为,无论是输入还是隐藏表示都拥有空间结构。
使用 和
分别表示输入图像和隐藏表示中位置(i,j)处的像素。 为了使每个隐藏神经元都能接收到每个输入像素的信息,我们将参数从权重矩阵(如同我们先前在多层感知机中所做的那样)替换为四阶权重张量W。假设U包含偏置参数,我们可以将全连接层形式化地表示为

其中,从 W 到 V 的转换只是形式上的转换,因为在这两个四阶张量的元素之间存在一一对应的关系 我们只需重新索引下标 ,使
、
,由此可得
。 索引a和b通过在正偏移和负偏移之间移动覆盖了整个图像。 对于隐藏表示中任意给定位置(i,j)处的像素值
,可以通过在x中以(i,j)为中心对像素进行加权求和得到,加权使用的权重为
。
1.2.1. 平移不变性
现在引用上述的第一个原则:平移不变性。 这意味着检测对象在输入X中的平移,应该仅导致隐藏表示H中的平移。也就是说,V和U实际上不依赖于(i,j)的值,即 。并且U是一个常数,比如u。因此,我们可以简化H定义为:

这就是卷积(convolution)。我们是在使用系数 对位置(i,j)附近的像素
进行加权得到
。注意,
的系数比
少很多,因为前者不再依赖于图像中的位置。这就是显著的进步!
1.2.2. 局部性
现在引用上述的第二个原则:局部性。如上所述,为了收集用来训练参数 的相关信息,我们不应偏离到距 (i,j) 很远的地方。这意味着在
或
的范围之外,我们可以设置
。因此,我们可以将
重写为

简而言之, (6.1.3)是一个卷积层 (convolutional layer),而卷积神经网络是包含卷积层的一类特殊的神经网络。在深度学习研究社区中,V被称为卷积核(convolution kernel)或者滤波器(filter),亦或简单地称之为该卷积层的权重,通常该权重是可学习的参数。 当图像处理的局部区域很小时,卷积神经网络与多层感知机的训练差异可能是巨大的:以前,多层感知机可能需要数十亿个参数来表示网络中的一层,而现在卷积神经网络通常只需要几百个参数,而且不需要改变输入或隐藏表示的维数。 参数大幅减少的代价是,我们的特征现在是平移不变的,并且当确定每个隐藏活性值时,每一层只包含局部的信息。 以上所有的权重学习都将依赖于归纳偏置。当这种偏置与现实相符时,我们就能得到样本有效的模型,并且这些模型能很好地泛化到未知数据中。 但如果这偏置与现实不符时,比如当图像不满足平移不变时,我们的模型可能难以拟合我们的训练数据。
1.3. 卷积

这看起来类似于 (6.1.3),但有一个主要区别:这里不是使用 ,而是使用差值。然而,这种区别是表面的,因为我们总是可以匹配 (6.1.3)和 (6.1.6)之间的符号。我们在 (6.1.3)中的原始定义更正确地描述了互相关(cross-correlation),这个问题将在下一节中讨论。
1.4. “沃尔多在哪里”回顾
回到上面的“沃尔多在哪里”游戏,让我们看看它到底是什么样子。卷积层根据滤波器V选取给定大小的窗口,并加权处理图片,如 图6.1.2中所示。我们的目标是学习一个模型,以便探测出在“沃尔多”最可能出现的地方。

1.4.1. 通道
然而这种方法有一个问题:我们忽略了图像一般包含三个通道/三种原色(红色、绿色和蓝色)。 实际上,图像不是二维张量,而是一个由高度、宽度和颜色组成的三维张量,比如包含1024×1024×3个像素。 前两个轴与像素的空间位置有关,而第三个轴可以看作每个像素的多维表示。 因此,我们将X索引为 。由此卷积相应地调整为
,而不是
。
此外,由于输入图像是三维的,我们的隐藏表示H也最好采用三维张量。 换句话说,对于每一个空间位置,我们想要采用一组而不是一个隐藏表示。这样一组隐藏表示可以想象成一些互相堆叠的二维网格。 因此,我们可以把隐藏表示想象为一系列具有二维张量的通道(channel)。 这些通道有时也被称为特征映射(feature maps),因为每个通道都向后续层提供一组空间化的学习特征。 直观上可以想象在靠近输入的底层,一些通道专门识别边缘,而一些通道专门识别纹理。
为了支持输入X和隐藏表示H中的多个通道,我们可以在V中添加第四个坐标,即 。综上所述,

其中隐藏表示H中的索引d表示输出通道,而随后的输出将继续以三维张量H作为输入进入下一个卷积层。 所以, (6.1.7)可以定义具有多个通道的卷积层,而其中V是该卷积层的权重。
然而,仍有许多问题亟待解决。 例如,图像中是否到处都有存在沃尔多的可能?如何有效地计算输出层?如何选择适当的激活函数?为了训练有效的网络,如何做出合理的网络设计选择?我们将在本章的其它部分讨论这些问题。
1.5. 小结
图像的平移不变性使我们以相同的方式处理局部图像,而不在乎它的位置。
局部性意味着计算相应的隐藏表示只需一小部分局部图像像素。
在图像处理中,卷积层通常比全连接层需要更少的参数,但依旧获得高效用的模型。
卷积神经网络(CNN)是一类特殊的神经网络,它可以包含多个卷积层。
多个输入和输出通道使模型在每个空间位置可以获取图像的多方面特征。
2. 图像卷积
2.1. 互相关运算
严格来说,卷积层所表达的运算其实是互相关运算(cross-correlation),而不是卷积运算。 根据 “从全连接层到卷积” 中的描述,在卷积层中,输入张量和核张量通过互相关运算产生输出张量。
不同颜色所选的区域与同一个卷积核做互相关运算,最后得到输出:

首先,暂时忽略通道(第三维)这一情况,看看如何处理二维图像数据和隐藏表示。在 图6.2.1中,输入是高度为3、宽度为3的二维张量(即形状为3×3)。卷积核的高度和宽度都是2,而卷积核窗口(或卷积窗口)的形状由内核的高度和宽度决定(即2×2)。

阴影部分是第一个输出元素,
以及用于计算输出的输入张量元素和核张量元素:
0×0+1×1+3×2+4×3=19.
在二维互相关运算中,
- 卷积窗口从输入张量的左上角开始,从左到右、从上到下滑动。
- 当卷积窗口滑动到新一个位置时,包含在该窗口中的部分张量与卷积核张量按元素相乘,
- 得到的张量再求和得到一个单一的标量值,由此得出这一位置的输出张量值。
在如上例子中,输出张量的四个元素由二维互相关运算得到,这个输出高度为2、宽度为2,如下所示:

注意:输出大小略小于输入大小。因为卷积核的宽度和高度大于1,而卷积核只与图像中每个大小完全适合的位置进行互相关运算。 所以,输出大小等于输入大小 减去卷积核大小
,即:


因为在图像上“移动”卷积核,需要足够的空间。后面会演示如何通过在图像边界周围填充零来保证有足够的空间移动卷积核,从而保持输出大小不变。
在corr2d函数中实现互相关运算过程:
- 传入:输入张量
X和 卷积核张量K, - 返回:输出张量
Y。
import torch
from torch import nn

"""
# 二维互相关运算
    定义corr2d函数:
    1、该函数接受输入张量X和卷积核张量K,并返回输出张量Y
    2、输出大小 = 输入大小n(k)×n(w) - 卷积核大小k(h)×k(w)
    3、即:(n(k)-k(h)+1) × (n(w)-k(w)+1 )
"""
def corr2d(X, K):  # @save
    """计算二维互相关运算"""
    h, w = K.shape # 卷积核的高度h和宽度w,K指卷积核Kernel

    # 设置输出Y的大小,用0进行填充
    Y = torch.zeros((X.shape[0] - h + 1, X.shape[1] - w + 1))

    # 对局部区域做互相关运算
    for i in range(Y.shape[0]): # 遍历输出高度方向
        for j in range(Y.shape[1]): # 遍历输出宽度方向
            Y[i, j] = (X[i:i + h, j:j + w] * K).sum()
            # i:i + h: 这是第一个维度的切片范围
            # j:j + w: 这是第二个维度的切片范围
            # X[i:i + h, j:j + w],从输入中提取与卷积核大小相同的区域
            # 将该区域与卷积核K 逐元素相乘
            # 对乘积结果求和,得到输出位置(i, j)的值
    return Y
通过 图6.2.1的输入张量X和卷积核张量K,来验证上述二维互相关运算的输出:
X = torch.tensor([[0.0, 1.0, 2.0], [3.0, 4.0, 5.0], [6.0, 7.0, 8.0]])
K = torch.tensor([[0.0, 1.0], [2.0, 3.0]])
out = corr2d(X, K)
print(f"输入X:\n{X}")
print(f"卷积核K:\n{K}")
print(f"互相关运算输出:\n{out}")
2.2. 卷积层
- 卷积层对输入和卷积核权重进行互相关运算,并在添加标量偏置之后产生输出。
- 所以,卷积层中的两个被训练的参数是:卷积核权重和标量偏置。
- 在训练基于卷积层的模型时,同样需要随机初始化卷积核权重。(类似之前随机初始化全连接层)
基于上面定义的corr2d函数实现二维卷积层:
- 在
__init__构造函数中,将weight和bias声明为两个模型参数。 - 前向传播函数调用
corr2d函数并添加偏置。
"""
    定义卷积层Conv2D:
    1、卷积层对输入和卷积核权重进行互相关运算;
    2、并在添加标量偏置之后产生输出。
"""
class Conv2D(nn.Module):
    def __init__(self, kernel_size):
        super().__init__() # 调用父类 nn.Module 的初始化方法
        # nn.Parameter,将张量注册为可训练参数,这些参数会在训练过程中通过梯度下降进行更新
        self.weight = nn.Parameter(torch.rand(kernel_size)) # 卷积核的权重 初始化为随机张量
        self.bias = nn.Parameter(torch.zeros(1)) # 偏置初始化为零张量

    def forward(self, x):
        # 调用前面定义的corr2d函数,计算输入 x 和 卷积核self.weight 之间的二维互相关运算
        return corr2d(x, self.weight) + self.bias
高度和宽度分别为h和w的卷积核 可以被称为 h×w卷积 或 h×w卷积核 。我们也将带有h×w卷积核的卷积层称为h×w卷积层。
2.3. 图像中目标的边缘检测
做个卷积层的简单应用:通过找到像素变化的位置,来检测图像中不同颜色的边缘。
1)首先,构造一个6×8像素的黑白图像。中间四列为黑色(0),其余像素为白色(1)。
X = torch.ones((6, 8))  # 构造一个6×8像素的黑白图像
X[:, 2:6] = 0           # 中间四列为黑色(0),其余像素为白色(1)
print(f"{X}")
2)构造一个高度为1、宽度为2的卷积核K。(水平相邻元素相同输出为0)
- 当进行互相关运算时:若水平相邻的两元素相同,则输出为零,否则输出为非零。
K = torch.tensor([[1.0, -1.0]])
print(f"高度为1、宽度为2的卷积核K:\n{K}") 
3)对参数X(输入)和K(卷积核)执行互相关运算。
如下所示,输出Y中的
- 1 代表从 白色到黑色 的边缘,
- -1 代表从 黑色到白色 的边缘,
- 其他情况的输出为0。
Y = corr2d(X, K)
print(f"输入和卷积核 做 互相关运算输出:\n{Y}")
4)现在将输入的二维图像转置,再进行如上的互相关运算。 其输出如下,之前检测到的垂直边缘消失了。 (该卷积核K只可检测垂直边缘,无法检测水平边缘)
out = corr2d(X.t(), K)
print(f"将输入的二维图像转置,再进行如上的互相关运算:\n{out}")
2.4. 学习卷积核
若只需寻找黑白边缘,那么以上[1,-1]的边缘检测器足以。但,若更复杂数值的卷积核,或者连续的卷积层时,则可能手动设计滤波器。那么我们是否可以学习由X生成Y的卷积核呢?
现在让我们看看是否可以通过仅查看“输入-输出”对来学习 由X生成Y的卷积核:
- 先构造一个卷积层,并将其卷积核初始化为随机张量。
- 接下来,在每次迭代中,比较
Y与卷积层输出的平方误差,然后计算梯度来更新卷积核。 - 为了简单起见,这里使用内置的二维卷积层,并忽略偏置。
# 构造一个二维卷积层,输出通道为1,且卷积核形状为(1,2)
conv2d = nn.Conv2d(1, 1, kernel_size=(1, 2), bias=False)

# 这个二维卷积层使用四维输入和输出格式(批量大小、通道、高度、宽度),
# 其中批量大小和通道数都为1
X = X.reshape((1, 1, 6, 8)) # 输入形状:[batch_size=1, channels=1, height=6, width=8]
Y = Y.reshape((1, 1, 6, 7)) # 目标形状:[batch_size=1, channels=1, height=6, width=7]
lr = 3e-2  # 学习率=3*10的-2次方=0.03
print(f"输入:\n{X}")
print(f"目标:\n{Y}")

# 进行训练,轮数为10。计算梯度并进行更新,输出loss
for i in range(10):
    Y_hat = conv2d(X)       # 结果卷积层的预测结果值(前向传播)
    l = (Y_hat - Y) ** 2    # 计算损失值(均方差MSE损失)
    conv2d.zero_grad()      # 将梯度清零
    l.sum().backward()      # 反向传播
    # 梯度下降,更新权重 (更新可学习的参数)
    # 迭代卷积核
    # 可以使用优化器(如 torch.optim.SGD)替代手动更新
    conv2d.weight.data[:] -= lr * conv2d.weight.grad
    if (i + 1) % 2 == 0: # 每2轮打印一次损失
        print(f'epoch {i + 1}, loss {l.sum():.3f}')
在10次迭代之后,误差已经降到足够低。现在我们来看看我们所学的卷积核的权重张量:
print(f"最终卷积核权重:\n{conv2d.weight.data.reshape((1, 2))}")
可以发现,学习到的卷积核权重 非常接近前面定义的卷积核 K [1,-1]。
2.5. 互相关和卷积
- 输出的卷积层有时被称为特征映射。
- 在卷积神经网络中,对于某一层的任意元素x,其感受野是指在前向传播期间可能影响x计算的所有元素。
回想一下在 “从全连接层到卷积” 中观察到的互相关和卷积运算之间的对应关系:
- 为了得到正式的卷积 运算输出,需要执行 (6.1.6)中
 定义的严格卷积运算,而不是互相关运算。
- 幸运的是,它们差别不大,我们只需水平和垂直翻转二维卷积核张量,然后对输入张量执行互相关运算。
阴影部分是第一个输出元素,
以及用于计算输出的输入张量元素和核张量元素:
0×0+1×1+3×2+4×3=19.
由于卷积核是从数据中学习到的,因此无论这些层执行严格的卷积运算还是互相关运算,卷积层的输出都不会受到影响。为了说明这一点,
- 假设卷积层执行互相关 运算并学习 图6.2.1中的卷积核,该卷积核在这里由矩阵K表示。
- 假设其他条件不变,当这个层执行严格的卷积 时,学习的卷积核K′ 在水平和垂直翻转之后将与K相同。
- 也就是说,当卷积层对 图6.2.1中的输入和K′ 执行严格卷积 运算时,将得到与互相关运算 图6.2.1中相同的输出。
- 严格地说,“互相关运算”与卷积运算略有不同。
- 但为了与深度学习文献中的标准术语保持一致,后面将继续把“互相关运算”称为卷积运算。
- 并且,将 卷积核张量上的权重 称为元素。
2.6. 特征映射和感受野
- 特征映射(feature map):输出的卷积层。
- 可以被视为一个输入映射到下一层的空间维度的转换器。
- 感受野(receptive field):在前向传播期间可能影响x计算的所有元素(来自所有先前层)。
- 就是 获取当前数据的 来自上一层的 所有原数据。
- 特征映射 (特征图):
- 在计算机视觉和深度学习中:指输入图像通过卷积神经网络后得到的输出图像。
- 感受野:
- 在神经科学中:指神经元对于外部刺激的感知范围。
- 在计算机视觉中:指卷积神经网络中每个神经元对于输入图像的感知区域。
如在 “从全连接层到卷积”里“通道” 中所述, 图6.2.1中输出的卷积层有时被称为特征映射(feature map),因为它可以被视为一个输入映射到下一层的空间维度的转换器。 在卷积神经网络中,对于某一层的任意元素x,其感受野(receptive field)是指在前向传播期间可能影响x计算的所有元素(来自所有先前层)。
阴影部分是第一个输出元素,
以及用于计算输出的输入张量元素和核张量元素:
0×0+1×1+3×2+4×3=19.
- 注意:感受野可能大于输入的实际大小。(比如将周围填充的时候)
用 图6.2.1为例来解释感受野:
- 给定2×2卷积核,阴影输出元素值19的 感受野是输入阴影部分的 四个元素。
- 假设之前输出为Y,其大小为2×2,现在在其后附加一个卷积层,
- 该卷积层以Y为输入,输出单个元素z。在这种情况下,
- Y上的z的感受野包括Y的所有四个元素,
- 而输入的感受野包括最初所有九个输入元素。
因此,当一个特征图中的任意元素需要检测更广区域的输入特征时,我们可以构建一个更深的网络。
2.7. 小结
二维卷积层的核心计算:二维互相关运算。
最简单的形式是:对二维输入数据和卷积核执行互相关操作,然后添加一个偏置。
可以设计一个卷积核来检测图像的边缘。
可以从数据中学习卷积核的参数。
学习卷积核时,无论用严格卷积运算或互相关运算,卷积层的输出不会受太大影响。
当需要检测输入特征中更广区域时,可以构建一个更深的卷积网络。
3. 填充和步幅
假设输入形状为 ,卷积核形状为
,那么输出形状将是
。 因此,卷积的输出形状取决于输入形状和卷积核的形状。
除卷积核之外,会影响输出的大小 的因素 还有:填充(padding)和步幅(stride)。
- 问题一:应用了连续的卷积后,由于卷积核的宽度和高度通常大于1,我们最终得到的输出远小于输入大小。
- 比如,240×240像素的图像经过10层5×5的卷积后,将减少到200×200像素。
- 如此一来,原始图像的边界丢失了许多有用信息。而填充可解决此问题;
- 问题二:可能希望大幅降低图像的宽度和高度。
- 例如,如果我们发现原始的输入分辨率十分冗余。步幅则可解决此问题。
- 问题三:卷积核为什么一般选择奇数?
解决:保持空间维度的同时,我们可以在顶部和底部填充相同数量的行,在左侧和右侧填充相同数量的列。
3.1. 填充
应用多层卷积时,常常丢失边缘像素。由于通常使用小卷积核,因此
- 对于任何单个卷积,可能会丢失几个像素。
- 随着应用许多连续卷积层,累积丢失的像素数会更多。
- 解决方法为填充(padding):在输入图像的边界填充元素(通常填充元素是0)。

例如,在 图6.3.1中,将3×3输入填充到5×5,那么它的输出就增加为4×4。阴影部分是第一个输出元素以及用于输出计算的输入和核张量元素: 0×0+0×1+0×2+0×3=0。

通常,如果添加
-
行填充(大约一半在顶部,一半在底部)和
-
列填充(左侧大约一半,右侧一半),
则输出形状将为

这意味着 输出的高度和宽度将分别增加 和
。
在许多情况下,需要设置 和
,使输入和输出具有相同的高度和宽度。 这样可以在构建网络时更容易地预测每个图层的输出形状。
- 假设
是奇数,将在高度的两侧填充
行。
- 若
行,在底部填充
行。宽度同理。
- 两侧填充不等长,上面顶部向上取整,下面底部向下取整。
- 填充的行数
pad_h:- 奇数:顶部和底部各填充
pad_h // 2行,然后多出的一行加到一侧(通常是底部)。 - 偶数:顶部和底部各填充
pad_h / 2行。
- 奇数:顶部和底部各填充
卷积神经网络中卷积核的高度和宽度通常为奇数,例如1、3、5或7。选择奇数的好处是:保持空间维度的同时,可以在顶部和底部填充相同数量的行,在左侧和右侧填充相同数量的列。
此外,使用奇数的核大小和填充大小也提供了书写上的便利。对于任何二维张量X,当满足:
- 卷积核的大小是奇数;
- 所有边的填充行数和列数相同;
- 输出与输入具有相同高度和宽度
则可以得出:输出Y[i, j]是 通过以输入X[i, j]为中心,与卷积核进行互相关计算得到的。
比如,在下面的例子中,我们创建一个高度和宽度为3的二维卷积层,并在所有侧边填充1个像素。给定高度和宽度为8的输入,则输出的高度和宽度也是8。
import torch
from torch import nn

"""
    填充:
    1、输入给定8×8,输出要求8×8
    2、卷积核的大小为3×3,所有侧边填充1个像素
"""

# 为了方便起见,这里定义了一个计算卷积层的函数
# 此函数初始化卷积层权重,并对输入和输出提高和缩减相应的维数
def comp_conv2d(conv2d, X):
    # 这里的(1,1)表示批量大小和通道数都是1
    # 转换为 4D 张量,格式为 (batch_size, channels, height, width)
    X = X.reshape((1, 1) + X.shape) # (1, 1, 8, 8)
    Y = conv2d(X) # 执行卷积运算,输出 Y 的形状为 (1, 1, H_out, W_out)
    # 省略前两个维度:批量大小和通道,返回 (H_out, W_out)
    return Y.reshape(Y.shape[2:])

# 请注意,这里每边都填充了1行或1列,因此总共添加了2行或2列
# padding=1(每边填充 1 行/列,总填充量为 2 行/列)
conv2d = nn.Conv2d(1, 1, kernel_size=3, padding=1) # 卷积层定义
X = torch.rand(size=(8, 8))
print(f"形状:\n{comp_conv2d(conv2d, X).shape}")
代入参数:
- 输入尺寸:
H=8, W=8- 卷积核:
kernel_size=3- 填充:
padding=1(每边填充 1,总填充量2)- 步长:默认
stride=1计算:
因此,输出形状为
(8, 8),与输入相同。这是因为
padding=1时,3×3卷积在步长为 1 时会保持空间尺寸(即 "same" 卷积)。


当卷积核的高度和宽度不同时,可以填充不同的高度和宽度,使输出和输入具有相同的高度和宽度。如下,使用高度为5,宽度为3的卷积核,高度和宽度两边的填充分别为2和1:
conv2d = nn.Conv2d(1, 1, kernel_size=(5, 3), padding=(2, 1))
print(f"使用5*3的卷积核,顶部和底部填充2行,宽度两边填充1行,\n"
      f"卷积后输出形状:\n{comp_conv2d(conv2d, X).shape}")
3.2. 步幅
在计算互相关时,卷积窗口从输入张量的左上角开始,向下、向右滑动。在前面例子中,默认每次滑动一个元素。但有时候为了高效计算或是缩减采样次数,卷积窗口可以跳过中间位置,每次滑动多个元素。
步幅(stride):每次滑动元素的数量。到目前为止,使用过高度或宽度的步幅皆为1。

图6.3.2是垂直步幅为3,水平步幅为2的二维互相关运算。 着色部分是输出元素以及用于输出计算的输入和内核张量元素:0×0+0×1+1×2+2×3=8、0×0+6×1+0×2+0×3=6。
可以看到,为了计算输出中第一列的第二个元素和第一行的第二个元素,卷积窗口分别向下滑动三行和向右滑动两列。但是,当卷积窗口继续向右滑动两列时,没有输出,因为输入元素无法填充窗口(除非添加另一列填充)。

通常,当垂直步幅为 、水平步幅为时
,输出形状为:

- 如果设置了
和
,
- 则输出形状将简化为
。
- 则输出形状将简化为
- 更进一步,如果输入的高度和宽度可以被垂直和水平步幅整除,
- 则输出形状将为
。
- 则输出形状将为
下面,将高度和宽度的步幅设置为2,从而将输入的高度和宽度减半:
"""
    步幅:
    1、每次滑动元素的数量;
    2、为了高效计算或是缩减采样次数,卷积窗口可以跳过中间位置,每次滑动多个元素。
"""
# (8 + 2 - 3) / 2 = 4
conv2d = nn.Conv2d(1, 1, kernel_size=3, padding=1, stride=2)
print(f"使用3*3的卷积核,每边填充 1 行/列,宽高步幅皆设为2,从而将输入的宽高皆减半\n"
      f"卷积后输出形状:\n{comp_conv2d(conv2d, X).shape}")
接下来,看一个稍微复杂的例子:
conv2d = nn.Conv2d(1, 1, kernel_size=(3, 5), padding=(0, 1), stride=(3, 4))
print(f"使用3*5的卷积核,顶部和底部不填充,左右各填充1行,高度步幅设为3,宽度步幅设为4\n"
      f"卷积后输出形状:\n{comp_conv2d(conv2d, X).shape}")
为了简洁起见:
- 当输入高度和宽度两侧的填充数量分别为
。
- 当
时,填充是
。
- 当
- 同理,当高度和宽度上的步幅分别为
和
时,我们称之为步幅
。
- 特别地,当
时,我们称步幅为
。
- 特别地,当
- 默认情况下,填充为0,步幅为1。
- 在实践中,很少使用不一致的步幅或填充,也就是说,通常有
和
。
3.3. 小结
填充可以增加输出的高度和宽度。这常用来使输出与输入具有相同的高和宽。
步幅可以减小输出的高和宽,例如输出的高和宽仅为输入的高和宽的1/n(n是一个大于1的整数)。
填充和步幅可用于有效地调整数据的维度。
4. 多输入多输出通道
当添加通道时,输入和隐藏的表示都变成了三维张量。例如:
- 每个RGB输入图像具有
的形状。
- 将这个大小为
的轴称为通道(channel)维度。
4.1. 多输入通道
当输入包含多个通道时,需要构造一个与输入数据具有相同输入通道数的卷积核 (卷积核的输入通道数需与输入数据的输入通道数相同),以便与输入数据进行互相关运算。

- 假设输入的通道数为
,则卷积核的输入通道数也需要为
- 若卷积核的窗口形状是
,那么
- 当
时,可把卷积核看作形状为
- 当
时,卷积核的每个输入通道将包含形状为
- 将这些张量
的卷积核。
- 由于输入和卷积核都有
- 可以对每个通道输入的二维张量和卷积核的二维张量进行互相关运算,
- 再对通道求和(将
- 这是多通道输入和多输入通道卷积核之间进行二维互相关运算的结果。
- 将这些张量
- 当
在 图6.4.1中,演示了一个具有两个输入通道的二维互相关运算的示例。阴影部分是第一个输出元素以及用于计算这个输出的输入和核张量元素: 。

为了加深理解,下面实现多输入通道互相关运算。 简而言之,所做的就是对每个通道执行互相关操作,然后将结果相加。
# 多输入通道的二维互相关运算
def corr2d_multi_in(X, K):
    # 先遍历“X”和“K”的第0个维度(通道维度),再把它们加在一起
    # corr2d(x, k) 调用前面定义的二维互相关运算
    # zip(X, K) 将输入数据和卷积核按通道配对,生成一个可迭代的元组序列
    # corr2d(x,k) for x,k in zip(X,K) 生成器表达式:惰性计算每个通道的互相关结果,避免中间存储
    return sum(corr2d(x, k) for x, k in zip(X, K))
import torch
# 多输入通道的二维互相关运算
def corr2d_multi_in(X, K):
# 先遍历“X”和“K”的第0个维度(通道维度),再把它们加在一起
# corr2d(x, k) 调用前面定义的二维互相关运算
# zip(X, K) 将输入数据和卷积核按通道配对,生成一个可迭代的元组序列
# corr2d(x,k) for x,k in zip(X,K) 生成器表达式:惰性计算每个通道的互相关结果,避免中间存储
return sum(corr2d(x, k) for x, k in zip(X, K))可以构造与 图6.4.1中的值相对应的 输入张量X 和 核张量K ,以验证互相关运算的输出。
X = torch.tensor([[[0.0, 1.0, 2.0], [3.0, 4.0, 5.0], [6.0, 7.0, 8.0]],
                  [[1.0, 2.0, 3.0], [4.0, 5.0, 6.0], [7.0, 8.0, 9.0]]])
K = torch.tensor([[[0.0, 1.0], [2.0, 3.0]], [[1.0, 2.0], [3.0, 4.0]]])

print(f"多输入通道互相关运算结果:\n{corr2d_multi_in(X, K)}")
print(f"原始 核张量K 的形状:{K.shape}")
print(f"原始 核张量K:\n{K}")

4.2. 多输出通道
- 在最流行的神经网络架构中,随着神经网络层数的加深,常会增加输出通道的维数,通过减少空间分辨率以获得更大的通道深度。
- 可以将每个通道看作对不同特征的响应。
而现实可能更为复杂一些,因为每个通道非独立学习,而是为了共同使用而优化。因此,多输出通道并不仅是学习多个单通道的检测器。
为 输出 通道的数目
为 卷积核的 宽度
为了获得多个通道的输出,可以为每个输出通道创建一个形状为 的卷积核张量,这样卷积核的形状是
。在互相关运算中,
- 每个输出通道先获取所有输入通道,
- 再以对应该输出通道的卷积核计算出结果。
如下所示,实现一个 计算多个通道的输出 的互相关函数。
# 计算多个通道的输出 的互相关
def corr2d_multi_in_out(X, K):
    # 迭代“K”的第0个维度,每次都对输入“X”执行互相关运算。
    # 最后将所有结果都叠加在一起
return torch.stack([corr2d_multi_in(X, k) for k in K], 0)通过将核张量K与K+1(K中每个元素加1)和K+2连接起来,构造了一个具有个输出通道的卷积核。
# 通过将核张量K与K+1(K中每个元素加1)和K+2连接起来,构造了一个具有个输出通道的卷积核
# 将三个张量沿 新的第 0 维 堆叠,形成一个3通道卷积核
K = torch.stack((K, K + 1, K + 2), 0)
print(f"核张量K 的形状:{K.shape}") #(输出通道数,输入通道数,高度,宽度)
print(f"核张量K:\n{K}")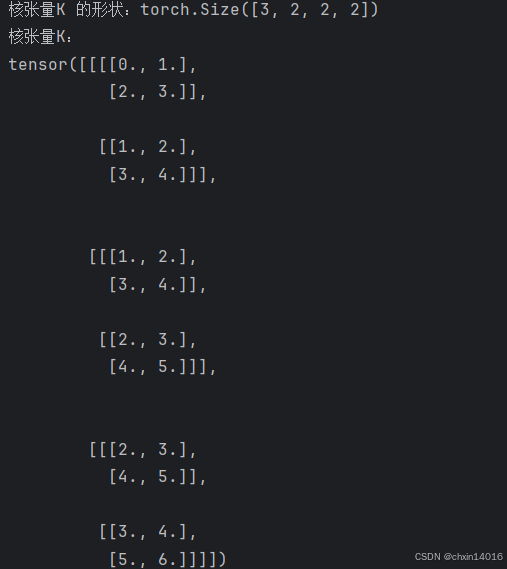
下面,对输入张量X与卷积核张量K执行互相关运算。现在的输出包含3个通道,第一个通道的结果与先前输入张量X和多输入单输出通道的结果一致。
print(f"多个通道的输出 的互相关 运算结果:\n{corr2d_multi_in_out(X, K)}")
4.3. 1×1 卷积层
- 1×1卷积核被经常用来改变通道,相当于全连接层
- 可以对输入和输出的形状进行调整
1×1 卷积,即 。
- 卷积的本质是:有效提取相邻像素间的相关特征。
- 尽管 1×1 卷积没有如上作用,但 1×1 仍十分流行,经常包含在复杂深层网络的设计中。
因为使用了最小窗口,卷积失去了卷积层的特有能力——在高度和宽度维度上,识别相邻元素间相互作用的能力。 其实卷积的唯一计算发生在通道上。
图6.4.2展示了使用1×1卷积核 与 3个输入通道 和 2个输出通道 的互相关计算:
- 这里输入和输出具有相同的高度和宽度,
- 输出中的每个元素 都是从输入图像中同一位置的元素 的线性组合。
- 可以将 1×1 卷积层看作在每个像素位置应用的全连接层,以
- 因为这仍然是一个卷积层,所以跨像素的权重是一致的。
- 同时, 1×1 卷积层需要的权重维度为
,再额外加上一个偏置。

其中,输入和输出具有相同的高度和宽度
下面,使用全连接层实现卷积。注意,我们需要对输入和输出的数据形状进行调整:
'''
1x1 卷积的本质:
1x1 卷积相当于对每个空间位置 (i,j) 独立进行 全连接层计算(跨通道的线性变换)
可以通过矩阵乘法高效实现
'''
# 1x1 卷积的多输入多输出通道版本(使用全连接层实现1×1卷积)
def corr2d_multi_in_out_1x1(X, K):
    c_i, h, w = X.shape          # 输入数据的形状: (输入通道数, 高度, 宽度)
    # K:(输出通道,输入通道,高度,宽度)
    c_o = K.shape[0]             # 输出通道数 (K的第一维)
    X = X.reshape((c_i, h * w))  # 将空间维度展平: (c_i, h*w)
    K = K.reshape((c_o, c_i))    # 将卷积核展平: (c_o, c_i)
    # 全连接层中的矩阵乘法
    Y = torch.matmul(K, X)       # 矩阵乘法: (c_o, h*w)
return Y.reshape((c_o, h, w)) # 恢复空间维度: (c_o, h, w)当执行1*1卷积运算时,上述函数相当于先前实现的互相关函数corr2d_multi_in_out。下面用一些样本数据来验证这一点:
# 验证与通用卷积的一致性
# 从均值=0,方差=1的离散正态分布中随机抽取数值
X = torch.normal(0, 1, (3, 3, 3))    # 组成3*3*3的张量
K = torch.normal(0, 1, (2, 3, 1, 1)) # 组成2*3*1*1的张量

print(f"---------------------")
Y1 = corr2d_multi_in_out_1x1(X, K)  # 1*1卷积优化计算
Y2 = corr2d_multi_in_out(X, K)      # 通用多通道卷积
assert float(torch.abs(Y1 - Y2).sum()) < 1e-6 # 验证结果一致
print(Y1)
print(Y2) 
分别调用 “多输入通道的二维互相关运算” 和 “1*1卷积的多输入多输出通道版本” 后,发现两个运算出来后结果是一致的。
卷积的多输入多输出通道版本 流程(自己理解的):
假设:
- 输入:3通道的 2*2图像,比如 RGB 图像的某个小块;
- 卷积核:2输出通道的 1*1卷积,相当于 2 个不同的“调色盘”;
X = torch.tensor([ # 输入图像
    [[1, 2], [3, 4]],   # 通道0(R)
    [[5, 6], [7, 8]],   # 通道1(G)
    [[9, 10], [11, 12]] # 通道2(B)
])  # 形状: (3, 2, 2)

K = torch.tensor([ # 卷积核
    [[[1]], [[2]], [[3]]],  # 调色盘0:对R、G、B通道分别用权重1,2,3混合
    [[[4]], [[5]], [[6]]]   # 调色盘1:对R、G、B通道分别用权重4,5,6混合
])  # 形状: (2, 3, 1, 1)
目标:
- 对每个像素点
(i,j)(比如(0,0)、(0,1)等),用K的不同“调色盘”混合它的 R、G、B 值,生成新的通道值。拆解计算过程:
- 将输入摊开,变成 每个通道单独处于一行,几个通道就几行 (某列代表某像素位置的RGB);
- 展开卷积核,变成 每行都是一个输出值对应的 输入行的权重参数,要几个输出值就几行 (几个调色盘 )
- 矩阵乘法,核找行(RGB对应的权重),输入找列(某位置的RGB),相乘相加(全连接计算后的结果标量)。所以改维度后,核的列数要与输入的通道数一样,核的行数就=卷积后自己要的输出通道数。
- 矩阵乘法后的结果 形状为:行数=调色盘个数 即输出通道数,列数=输入数据单个通道的像素总数 即RGB位置总数。需要将其变换回输入数据原有的w*h 即重转回输入展开前 每个通道的 行*列。
1、将输入摊开:
# 原始 X 形状是 (3, 2, 2)(通道、高度、宽度):
通道0: [1  2]    通道1: [5  6]    通道2: [9  10]
       [3  4]           [7  8]          [11 12]

# 展平空间维度后(把每个通道的 2x2 矩阵拉直成一行):
X_reshaped = [
    [1, 2, 3, 4],   # 通道0的所有像素
    [5, 6, 7, 8],   # 通道1的所有像素
    [9, 10, 11, 12] # 通道2的所有像素
]  # 形状: (3, 4)

# 展开后,每一列代表一个像素位置(比如第1列是所有通道在 (0,0) 的值)
2、展开卷积核:(像准备两个调色盘)
# 原始 K 形状是 (2, 3, 1, 1)(输出通道、输入通道、高度、宽度):
调色盘0: [ [1], [2], [3] ]  # 对R、G、B通道的权重
调色盘1: [ [4], [5], [6] ]  # 另一组权重

# 展平成矩阵(丢掉冗余的 1x1 维度):
K_reshaped = [
    [1, 2, 3],  # 调色盘0的权重
    [4, 5, 6]   # 调色盘1的权重
]  # 形状: (2, 3)
3、矩阵乘法:(用调色盘混合颜色)
# 计算 Y = K_reshaped @ X_reshaped:
# 调色盘0(第1行 [1,2,3])对所有像素的 RGB 值加权求和:
Y[0, :] = 1*R + 2*G + 3*B
# 调色盘1(第2行 [4,5,6])对所有像素的 RGB 值加权求和:
Y[1, :] = 4*R + 5*G + 6*B

# 具体计算(以第1个像素 (0,0) 为例):
# 原始值: R=1 (通道0), G=5 (通道1), B=9 (通道2)
# 调色盘0输出: 1*1 + 2*5 + 3*9 = 1 + 10 + 27 = 38
# 调色盘1输出: 4*1 + 5*5 + 6*9 = 4 + 25 + 54 = 83
# 对所有 4 个像素重复此操作,得到 Y 的形状是 (2, 4)
4、恢复空间结构:(把纸折回 2x2)
# 将 Y 从 (2, 4) 恢复为 (2, 2, 2):
Y = [
    [[38, 83], [50, 106]],  # 调色盘0和调色盘1在(0,0)和(0,1)的结果
    [[110, 155], [122, 170]] # 在(1,0)和(1,1)的结果
]  # 形状: (2, 2, 2)
# 现在每个像素点从 3 通道(RGB)变成了 2 通道(调色盘0和调色盘1的结果)
over
4.4. 小结
多输入多输出通道可以用来扩展卷积层的模型。
当以每像素为基础应用时,1×1卷积层相当于全连接层。
1×1卷积层通常用于调整网络层的通道数量和控制模型复杂性。
5. 汇聚层 (池化层)
通过逐渐聚合信息,生成越来越粗糙的映射,最终实现学习全局表示的目标,同时将卷积图层的所有优势保留在中间层
汇聚(pooling)层,即池化层,它具有双重目的:
- 降低卷积层对位置的敏感性,
- 同时降低对空间降采样表示的敏感性。
5.1. 最大汇聚层和平均汇聚层
汇聚层与卷积层的原理大体相似,只不过把互相关运算换成求最大值或者求平均值。

- 与卷积层类似,汇聚层运算符由一个固定形状的窗口组成,
- 该窗口根据其步幅大小在输入的所有区域上滑动,为固定形状窗口(有时称为汇聚窗口)遍历的每个位置计算一个输出。
- 然而,不同于卷积层中的输入与卷积核之间的互相关计算,汇聚层不包含参数。
- 相反,池运算是确定性的,通常计算汇聚窗口中所有元素的最大值或平均值。也就是
- 最大汇聚层(maximum pooling)和
- 平均汇聚层(average pooling)。
在这两种情况下,与互相关运算符一样,汇聚窗口从输入张量的左上角开始,从左往右、从上往下的在输入张量内滑动。在汇聚窗口到达的每个位置,它计算该窗口中输入子张量的最大值或平均值(取决于使用的是最大汇聚层还是平均汇聚层)。

着色部分是第一个输出元素,
以及用于计算这个输出的输入元素: max(0,1,3,4)=4
图6.5.1中的输出张量的高度为2,宽度为2。这四个元素为每个汇聚窗口中的最大值:

汇聚窗口形状为 的汇聚层 称为
汇聚层,汇聚操作称为
汇聚。
回到开头提到的对象边缘检测示例,使用卷积层的输出作为 2*2最大汇聚 的输入。
- 设置卷积层输入为
X,汇聚层输出为Y。 - 最大汇聚层(Max Pooling)的平移不变性(Translation Invariance)特性:
- 表现:
- 即使输入的特征图中模式(如边缘、纹理等)在高度或宽度上微移一个元素(例如从
X[i,j]移动到X[i,j+1]或X[i,j+2]), - 只要该模式仍落在某个汇聚窗口内,最大汇聚层的输出
Y[i,j]仍会捕获到这个模式的最大激活值(例如固定输出1)。 - 因此,输出
Y对输入模式的微小位置变化不敏感。
- 即使输入的特征图中模式(如边缘、纹理等)在高度或宽度上微移一个元素(例如从
- 具体例子:
- 无论
X[i,j]和X[i,j+1]的值相同与否,或X[i,j+1]和X[i,j+2]的值相同与否,汇聚层始终输出最大值Y[i,j]=1。 - 也就是说,使用最大汇聚层,即使在高度或宽度上移动一个元素,卷积层仍然可以识别到模式(如边缘、纹理等)。
- 无论
- 表现:
在下面的代码中的 pool2d函数,我们实现汇聚层的前向传播 (类似于前面图像卷积中的corr2d函数)。但这里没有卷积核,输出为输入中每个区域的最大值或平均值。
import torch
from torch import nn

"""
# 自定义二维汇聚层(默认为最大汇聚层)
    定义汇聚层:
    1、设置汇聚层与输出的大小
    2、设置模式:大汇聚层和平均汇聚层
"""
def pool2d(X, pool_size, mode='max'):
    p_h, p_w = pool_size # 池化窗口的高度和宽度
    # 计算输出张量的形状(输入大小 - 池化窗口大小 + 1)
    Y = torch.zeros((X.shape[0] - p_h + 1, X.shape[1] - p_w + 1))
    # 进行遍历,相当于对矩阵的局部区域[i:i+p_h, j:j+p_w]求最大值/平均值
    for i in range(Y.shape[0]):
        for j in range(Y.shape[1]):
            window = X[i: i + p_h, j: j + p_w] # 提取当前窗口的子矩阵
            if mode == 'max':   # 最大汇聚:取窗口内的最大值
                Y[i, j] = window.max()
            elif mode == 'avg': # 平均汇聚:取窗口内的平均值
                Y[i, j] = window.mean()
    return Y
可以构建 图6.5.1中的输入张量X,验证二维最大汇聚层的输出:
# 构建输入张量X,验证二维最大汇聚层输出
X = torch.tensor([[0.0, 1.0, 2.0], [3.0, 4.0, 5.0], [6.0, 7.0, 8.0]])
print(f"输入X:\n{X}")
print(f"最大汇聚层(最大池化层):\n{pool2d(X, (2, 2))}")
此外,还可以验证平均汇聚层:
print(f"平均汇聚层(平均池化层):\n{pool2d(X, (2, 2), 'avg')}")
5.2. 填充和步幅
与卷积层一样,汇聚层也可以改变输出形状:
- 和以前一样,可以通过填充和步幅以获得所需的输出形状。
下面用深度学习框架(pytorch)中内置的二维最大汇聚层,来演示汇聚层中填充和步幅的使用:
- 首先构造一个输入张量
X, - 它有四个维度,
- 其中样本数和通道数都是1。
# 直接使用 PyTorch中内置的 二维最大汇聚层:
# 输入输出通道数皆为1的 4*4张量
X = torch.arange(16, dtype=torch.float32).reshape((1, 1, 4, 4))
print(f"输入X:\n{X}")
默认情况下,深度学习框架中的步幅与汇聚窗口的大小相同。
即:若使用形状为(3,3)的汇聚窗口,则默认情况下,得到的步幅形状为(3,3):
pool2d = nn.MaxPool2d(3) # 池化窗口大小 3×3
print(f"最大汇聚层(最大池化层):池化窗口大小 3×3"
f"\n{pool2d(X)}") (因为
3×3 窗口只能滑动一次,取最大值 10)
填充和步幅可以手动设定:
pool2d = nn.MaxPool2d(3, padding=1, stride=2)
print(f"最大汇聚层(最大池化层):输入四周补1圈0,步长设为2\n{pool2d(X)}") (计算方式:补零后滑动窗口取最大值)
也可以设定任意大小的矩形汇聚窗口,并分别设定填充和步幅的高度和宽度:
pool2d = nn.MaxPool2d((2, 3), stride=(2, 3), padding=(0, 1))
print(f"最大汇聚层(最大池化层):非对称窗口和步长"
f"\n步长为2行3列,仅在宽度方向补1圈0:"
f"\n{pool2d(X)}") (计算方式:滑动
2×3 窗口并取最大值)
5.3. 多个通道
- 在处理多通道输入数据时,汇聚层在每个输入通道上单独运算,而不是像卷积层一样在通道上对输入进行汇总。
- 汇聚层的输出通道数 = 输入通道数。
下面,在通道维度上连结张量X和X+1,以构建具有2个通道的输入:
# 多个通道的情况:
# 张量的维度顺序通常遵循 NCHW 格式(批量大小 × 通道数 × 高度 × 宽度)
X = torch.cat((X, X + 1), 1) # 沿现有维度 第一维即通道 拼接两个张量
print(f"输入X:通道数为2\n{X}")
如下所示,汇聚后输出通道的数量仍然是2:
pool2d = nn.MaxPool2d(3, padding=1, stride=2)
print(f"最大汇聚层(最大池化层):输入四周补1圈0,步长设为2"
      f"\n池化后通道数不变"
      f"\n{pool2d(X)}")
5.4. 小结
对于给定输入元素,
最大汇聚层:输出该窗口内的最大值,
平均汇聚层:输出该窗口内的平均值。
汇聚层的主要优点之一是减轻卷积层对位置的过度敏感。
可以指定汇聚层的填充和步幅。
使用最大汇聚层以及大于1的步幅,可减少空间维度(如高度和宽度)。
汇聚层的输出通道数与输入通道数相同。
6. 卷积神经网络(LeNet)
用卷积层代替全连接层的好处:
- 可以在图像中保留空间结构;
- 模型更简洁、所需的参数更少。
LeNet是最早发布的卷积神经网络之一,因其在计算机视觉任务中的高效性能而受到广泛关注。
- 由AT&T贝尔实验室的研究员Yann LeCun在1989年提出的(并以其命名);
- 目的:识别图像 (LeCun et al., 1998)中的手写数字;
- 与支持向量机(support vector machines)性能相媲美,成为监督学习的主流方法;
- LeNet被广泛用于自动取款机(ATM)机中,帮助识别处理支票的数字。
6.1. LeNet
总体来看,LeNet(LeNet-5)由两个部分组成:
- 卷积编码器:由两个卷积层组成;
- 全连接层密集块:由三个全连接层组成。
该架构如 图6.6.1所示。


- 每个卷积块中的基本单元是一个卷积层、一个sigmoid激活函数和平均汇聚层。
- (注意:虽然 ReLU和最大汇聚层更有效,但在20世纪90年代还没有这俩)
- 每个卷积层使用5*5卷积核和一个sigmoid激活函数。
- 这些层将输入映射到多个二维特征输出,通常同时增加通道的数量。
- 第一卷积层有6个输出通道,而第二个卷积层有16个输出通道。
- 每个2*2池操作(步幅2)通过空间下采样将维数减少4倍。
- 卷积的输出形状由批量大小、通道数、高度、宽度决定。
为了将卷积块的输出传递给稠密块,必须在小批量中展平每个样本。即,将这个四维输入转换成全连接层所期望的二维输入。这里的二维表示的
- 第一个维度:索引小批量中的样本,
- 第二个维度:给出每个样本的平面向量表示。
LeNet的稠密块有三个全连接层,分别有120、84和10个输出。因为在执行分类任务,所以输出层的10维对应于最后输出结果的数量。
通过下面的LeNet代码,可以看出用深度学习框架实现此类模型非常简单。只需要实例化一个Sequential块并将需要的层连接在一起:
import torch
from torch import nn
import common

net = nn.Sequential( # 定义顺序容器
    nn.Conv2d(1, 6, kernel_size=5, padding=2), nn.Sigmoid(), # 输入通道=1,输出通道=6,5×5 卷积核,padding=2 保持尺寸不变
    nn.AvgPool2d(kernel_size=2, stride=2),  # 2×2平均池化,步幅=2(输出尺寸减半)
    nn.Conv2d(6, 16, kernel_size=5), nn.Sigmoid(),  # 输入通道=6,输出通道=16,5×5卷积核(无padding,尺寸缩小)
    nn.AvgPool2d(kernel_size=2, stride=2),  # 2×2平均池化,步幅=2(输出尺寸减半)
    nn.Flatten(),                           # 展平层:将多维张量展平为一维向量,供全连接层使用

    nn.Linear(16 * 5 * 5, 120), nn.Sigmoid(), # 经过两次池化后,特征图尺寸为(16,5,5),展平为 16*5*5=400 维向量
    # 后续接两个隐藏层(120 和 84 个神经元)和输出层(10 类)
    nn.Linear(120, 84), nn.Sigmoid(), # Sigmoid激活函数,将输出压缩到(0,1)区间(现代CNN通常用ReLU)
    nn.Linear(84, 10))  # 输出层通常不用激活函数,CrossEntropyLoss会包含Softmax
这里对原始模型做了一点小改动,去掉了最后一层的高斯激活。除此之外与最初的LeNet-5一致。
下面,将一个大小为28*28的单通道(黑白)图像通过LeNet。通过在每一层打印输出的形状,可以检查模型,以确保其操作与我们期望的 图6.6.2一致。

# 模拟输入:batch_size=1,通道=1,高度=28,宽度=28(Fashion-MNIST尺寸)
X = torch.rand(size=(1, 1, 28, 28), dtype=torch.float32)
for layer in net: # 逐层前向传播并打印输出形状
    X = layer(X)  # 前向计算
    print(layer.__class__.__name__,'output shape: \t',X.shape) # 打印层类型和输出形状(张量的维度)
预期输出:
Conv2d output shape:     torch.Size([1, 6, 28, 28])  # 卷积1(padding=2保持尺寸)
Sigmoid output shape:    torch.Size([1, 6, 28, 28])  # 激活函数不改变形状
AvgPool2d output shape:  torch.Size([1, 6, 14, 14])  # 池化1(尺寸减半)
Conv2d output shape:     torch.Size([1, 16, 10, 10]) # 卷积2(无padding,28→10)
Sigmoid output shape:    torch.Size([1, 16, 10, 10]) # 激活函数
AvgPool2d output shape:  torch.Size([1, 16, 5, 5])   # 池化2(10→5)
Flatten output shape:    torch.Size([1, 400])        # 展平(16*5*5=400)
Linear output shape:     torch.Size([1, 120])        # 全连接层1
Sigmoid output shape:    torch.Size([1, 120])        # 激活函数
Linear output shape:     torch.Size([1, 84])         # 全连接层2
Sigmoid output shape:    torch.Size([1, 84])         # 激活函数
Linear output shape:     torch.Size([1, 10])         # 输出层(10类)

注意:在整个卷积块中,与上一层相比,每一层特征的高度和宽度都减小了。
- 第一个卷积层使用2个像素的填充,来补偿卷积核导致的特征减少。
- 相反,第二个卷积层没有填充,因此高度和宽度都减少了4个像素。
- 随着层叠的上升,通道的数量从输入时的1个,增加到第一个卷积层之后的6个,再到第二个卷积层之后的16个。
- 同时,每个汇聚层的高度和宽度都减半。
- 最后,每个全连接层减少维数,最终输出一个 维数与结果分类数相匹配的 输出。
6.2. 模型训练
现在已经实现了LeNet,可以看看LeNet在Fashion-MNIST数据集上的表现:
batch_size = 256 # 批量大小,每次处理256张图像
# 加载Fashion-MNIST数据集,返回 训练集和测试集的DataLoader对象
train_iter, test_iter = common.load_data_fashion_mnist(batch_size=batch_size)
虽然卷积神经网络的参数较少,但与深度的多层感知机相比,其计算成本仍然很高,因为每个参数都参与更多的乘法。 通过使用GPU,可以用它加快训练。
为了进行评估,需要对 线性回归实现 & softmax回归实现—— 动手学深度学习3.2~3.7-CSDN博客 中(softmax回归的从零开始实现—5. 分类精度)描述的evaluate_accuracy函数进行轻微的修改。 由于完整的数据集位于内存中,因此在模型使用GPU计算数据集之前,需要将其复制到显存中。
"""
# 评估函数
    定义精度评估函数:
    1、将数据集复制到显存中
    2、通过调用accuracy计算数据集的精度
"""
def evaluate_accuracy_gpu(net, data_iter, device=None): #@save
    """使用GPU计算模型在数据集上的精度"""
    if isinstance(net, nn.Module):  # 判断模型是否为深度学习模型
        net.eval()  # 设置为评估模式(关闭Dropout和BatchNorm的随机性)
        if not device: # 如果没有指定设备,自动使用模型参数所在的设备(如GPU)
            device = next(iter(net.parameters())).device # 自动检测设备
    # 初始化计数器:累计 正确预测的数量 和 总预测的数量
    metric = common.Accumulator(2) # metric[0]=正确数, metric[1]=总数
    with torch.no_grad():  # 禁用梯度计算(加速评估并减少内存占用)
        for X, y in data_iter:  # 每次从迭代器中拿出一个X和y
            # 将数据移动到指定设备(如GPU)
            if isinstance(X, list):
                # BERT微调所需的(之后将介绍)
                X = [x.to(device) for x in X]
            else:
                X = X.to(device)
            y = y.to(device)
            # 计算预测值和准确率,并累加到metric中
            metric.add(common.accuracy(net(X), y), y.numel()) # 累加准确率和样本数
    # metric[0, 1]分别为网络预测正确数量和总预测数量
    return metric[0] / metric[1] # 计算准确率
为了使用GPU,还需要一点小改动。 与 线性回归实现 & softmax回归实现—— 动手学深度学习3.2~3.7-CSDN博客 中(softmax回归的从零开始实现—5. 分类精度)定义的train_epoch_ch3不同,在进行正向和反向传播之前,需要将每一小批量数据移动到我们指定的设备(例如GPU)上。
如下所示,训练函数train_ch6也类似于 线性回归实现 & softmax回归实现—— 动手学深度学习3.2~3.7-CSDN博客 中(softmax回归的从零开始实现—5. 分类精度)定义的train_ch3。 由于将实现多层神经网络,因此将主要使用高级API。 以下训练函数假定从高级API创建的模型作为输入,并进行相应的优化。使用在 多层感知机实现—— 动手学深度学习4.2~4.9-CSDN博客 中(数值稳定性和模型初始化—2. 参数初始化—2.2. Xavier初始化)介绍的Xavier随机初始化模型参数。 与全连接层一样,使用交叉熵损失函数和小批量随机梯度下降。
"""
    定义GPU训练函数:
    1、为了使用gpu,首先需要将每一小批量数据移动到指定的设备(例如GPU)上;
    2、使用Xavier随机初始化模型参数;
    3、使用交叉熵损失函数和小批量随机梯度下降。
"""
#@save
def train_ch6(net, train_iter, test_iter, num_epochs, lr, device):
    """用GPU训练模型(在第六章定义)"""
    def init_weights(m):
        if type(m) == nn.Linear or type(m) == nn.Conv2d:
            nn.init.xavier_uniform_(m.weight) # Xavier初始化,保持输入输出的方差稳定
    net.apply(init_weights)  # 应用初始化到整个网络(初始化权重)
    print('training on', device)
    net.to(device)  # 模型移至指定设备(如GPU)
    optimizer = torch.optim.SGD(net.parameters(), lr=lr) # 定义优化器:随机梯度下降(SGD),学习率为lr
    loss = nn.CrossEntropyLoss()  # 交叉熵损失
    # 初始化动画绘图器,用于动态绘制训练曲线
    animator = common.Animator(xlabel='epoch',
                               xlim=[1, num_epochs],
                               legend=['train loss', 'train acc', 'test acc'])
    # 初始化计时器和计算总批次数
    timer, num_batches = common.Timer(), len(train_iter)
    # 开始训练循环
    for epoch in range(num_epochs):
        # Accumulator(3)创建3个变量:训练损失总和、训练准确度总和、样本数
        metric = common.Accumulator(3) # 用于跟踪训练损失、准确率和样本数
        net.train()  # 切换到训练模式(启用Dropout和BatchNorm的训练行为)
        for i, (X, y) in enumerate(train_iter):
            timer.start()           # 开始计时
            optimizer.zero_grad()   # 清空梯度
            X, y = X.to(device), y.to(device)   # 将数据移动到设备
            y_hat = net(X)          # 前向传播:模型预测
            l = loss(y_hat, y)      # 计算损失(向量形式,每个样本一个损失值)
            l.backward()            # 反向传播计算梯度
            optimizer.step()        # 更新参数
            with torch.no_grad(): # 禁用梯度计算后累计指标
                metric.add(l * X.shape[0], common.accuracy(y_hat, y), X.shape[0])
            timer.stop()            # 停止计时
            train_l = metric[0] / metric[2]     # 平均训练损失
            train_acc = metric[1] / metric[2]   # 平均训练准确率
            # 每训练完1/5的epoch 或 最后一个batch时,更新训练曲线
            if (i + 1) % (num_batches // 5) == 0 or i == num_batches - 1:
                animator.add(epoch + (i + 1) / num_batches,
                             (train_l, train_acc, None))
        test_acc = evaluate_accuracy_gpu(net, test_iter)  # 测试集准确率
        animator.add(epoch + 1, (None, None, test_acc)) # 更新测试集准确率曲线
    print(f'最终结果:loss {train_l:.3f}, train acc {train_acc:.3f}, '
          f'test acc {test_acc:.3f}')
    print(f'训练速度(样本数/总时间):{metric[2] * num_epochs / timer.sum():.1f} examples/sec '
          f'on {str(device)}')
现在,训练和评估LeNet-5模型:
lr, num_epochs = 0.9, 10 # 学习率,训练轮数(训练10轮)
train_ch6(net, train_iter, test_iter, num_epochs, lr, common.try_gpu())


左图自己跑的,右图学习资料的
6.3. 小结
卷积神经网络(CNN)是一类使用卷积层的网络。
在卷积神经网络中,组合使用卷积层、非线性激活函数和汇聚层。
为了构造高性能的卷积神经网络,通常对卷积层进行排列,逐渐降低其表示的空间分辨率,同时增加通道数。
在传统的卷积神经网络中,卷积块编码得到的表征在输出之前需由一个或多个全连接层进行处理。
LeNet是最早发布的卷积神经网络之一。

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐

 15
 0
- 0


 已为社区贡献1条内容

所有评论(0)