scrapy--(failed 3 times): [<twisted.python.failure.Failure twisted.web._newclient.ParseError
·
问题:
[scrapy.downloadermiddlewares.redirect] DEBUG: Redirecting (302)
(failed 3 times): [<twisted.python.failure.Failure twisted.web._newclient.ParseError: (‘wrong number of parts’, b’’)>]
理论知识:
1、在使用Scrapy框架中URl被重定向
2、根据 HTTP标准 ,返回值为200-300之间的值为成功的resonse。
3、如果想处理在这个范围之外的response,可以通过 spider的 handle_httpstatus_list 属性或HTTPERROR_ALLOWED_CODES 设置来指定spider能处理的response返回值。
解决1:
在爬虫文件的 settings.py文件里添加:
HTTPERROR_ALLOWED_CODES = [301]
解决2:
在爬虫文件中添加headers
该headers要添加自己的值,且cookie添加前,要先登录一下爬取的网站。
bibi为例,我已经登录成功了 F12–》Network --》刷新—》Header
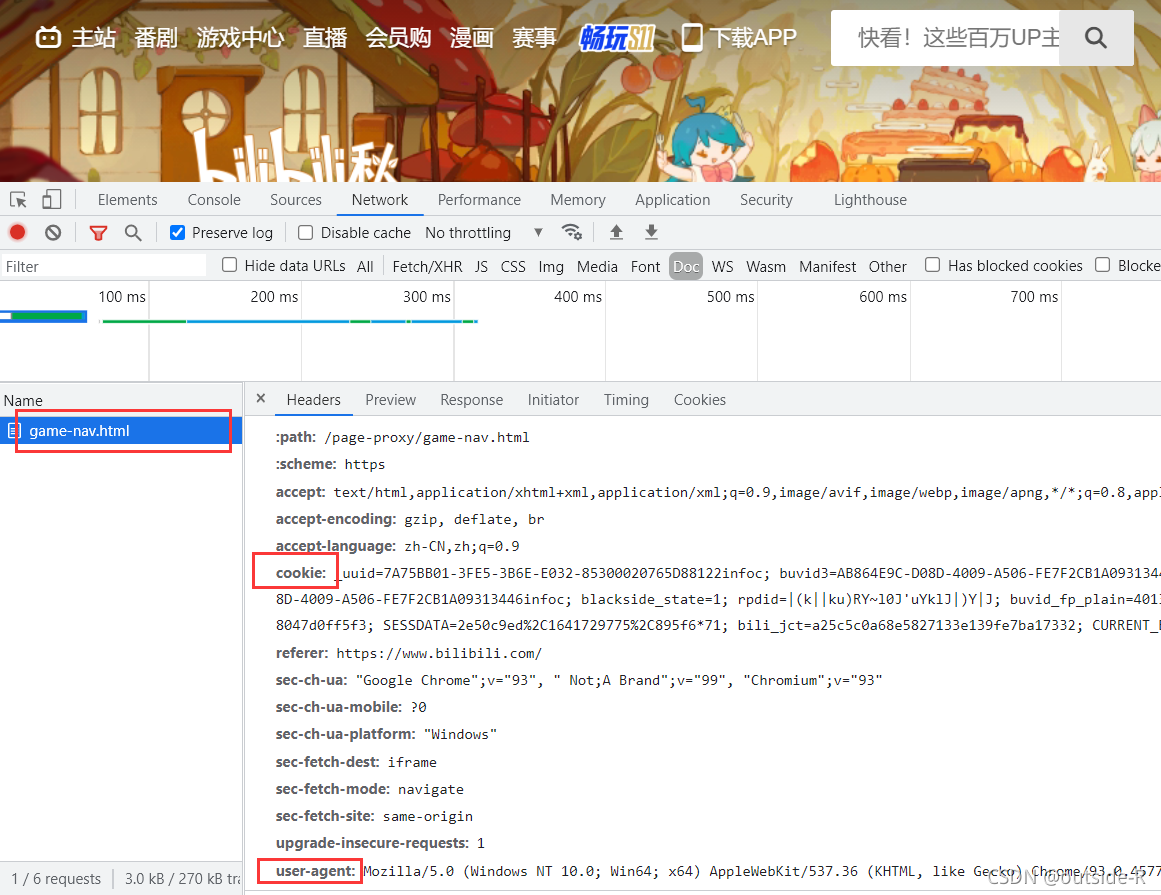
herders={
	'user-agent':' Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/93.0.4577.63 Safari/537.36',
	'cookie':' MUID=0D619CB8AF6860562CB38CC9AE466165; MUIDB=0D619CB8AF6860562CB38CC9AE466165; _EDGE_V=1; SRCHD=AF=NOFORM; SRCHUID=V=2&GUID=FE70CC4A14BD454AAF0D558AA801761A&dmnchg=1; _tarLang=default=en; _TTSS_IN=hist=WyJ6aC1IYW5zIiwiYXV0by1kZXRlY3QiXQ==; _TTSS_OUT=hist=WyJlbiJd;'
}
解决3:
模拟人查询方式方式,点击时间不同,利用随机数,在sittings.py中设置
import random
DOWNLOAD_DELAY = random.uniform(1,3)  #延迟1秒

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐

 1
 0
- 0


 已为社区贡献2条内容

所有评论(0)