登录社区云,与社区用户共同成长
邀请您加入社区
我们先说下hash这个词出现的场景。编程语言里的数据类型:java里的hashmap, python里的哈希表dict 负载均衡:一致性哈希算法文件和程序的版本管理:通过哈希值来判断 用户的密码以上的场景,覆盖了:开发的编码,服务的管控,版本的管理。贯穿于整个互联网项目的周期中。hash,一般翻译为散列、杂凑,或者音译为哈希,是把任意长度的输入(又叫做预映射pre-image)通过散列算法变换成固
③ 生成200个在[200, 10000]之间的整数保存数组A中,以此数组元素作为关键字,采用快速排序算法按非递减方式进行排序,给出操作的结果及相应的操作次数;① 生成100个在[200, 1000]之间的整数保存数组A中,以此数组元素作为关键字,采用希尔排序算法按非递减方式进行排序,给出操作的结果及相应的操作次数;④ 生成500个在[200, 10000]之间的整数保存数组A中,以此数组元素作为
算法在计算机领域指的是对特定问题的解决方案的一系列指令化描述。算法必须是明确且有穷的,即一个算法必须要有明确的定义,一定的输入在有限的步骤内可以获得要求的输出。1.抓包确定目标参数2.jadx 发现是否有壳 回填2.jadx java层 hook 动静态 分析 参数加密地方3.参数加密属于so层 找出对应的so文件 也就是 native 属于哪个so4.进入so层 ida分析 打开确定是否混淆 是
目录1、题目描述2、解题思路第一种解法:暴力枚举第二种解法:哈希映射3、代码展示4、小结前言声明:本文仅为学习记录,图片以及题目资源来自牛客和力扣网,如有侵权请联系删除大家好,我是尼根。一个又菜又想学算法的准程序猿????,今天为大家带来一道leetcode上简单的算法题,^_+两数之和^_+。1、题目描述给定一个整数数组nums,和一个整数目标值target,请你找出整数数组中和为目标值targ
点击关注公众号,实用技术文章及时了解上篇提升系统性能,榨干计算机资源是程序员的极致追求,今天跟大家聊聊性能优化。分为上中下三篇,由浅及深的写了关于性能优化的方方面面,并不仅仅局限于代码层面,希望小伙伴们能有所收获。引言:取与舍软件设计开发某种意义上是“取”与“舍”的艺术。关于性能方面,就像建筑设计成抗震9度需要额外的成本一样,高性能软件系统也意味着更高的实现成本,有时候与其他质量属性甚至会冲突,比
主要介绍Chore的建立及其查找过程
哈希表是高效的查找数据结构,尤其适用于需要快速插入、删除和查找操作的场景。常见的碰撞解决方法有链式法和开放地址法,其中链式法通过链表来处理碰撞,而开放地址法通过探测空位置来处理碰撞。根据应用的不同,选择合适的哈希表实现可以大大提高程序的效率。
菜鸟日常学习算法的总结!
在一个神秘的古代中国王国里,皇帝拥有一本强大的魔法书,这本书记录了每个居民的信息。皇帝能够通过书中的魔法快速找到任何居民的信息。今天,皇帝决定向他的臣民们揭示这本魔法书的秘密——哈希表。
0 拉宾-卡普算法来自wiki在计算机科学中,拉宾-卡普算法(英語:Rabin–Karp algorithm)或卡普-拉宾算法(Karp–Rabin algorithm),是一种由理查德·卡普与迈克尔·拉宾于1987年提出的、使用散列函数以在文本中搜寻单个模式串的字符串搜索算法单次匹配。该算法先使用旋转哈希以快速筛出无法与给定串匹配的文本位置,此后对剩余位置能否成功匹配进行检验。此算法可推广到用于
显示发生器,集成了视频驱动器、同步分离器、视频分离开。能够方便地以任意字符、尺寸显示各种信息,,提高了系统的集成度,有效降低了系统成。例如公司标识、常用图形、时间、日期等。编程字符,适合于全球市场。兼容串行接口进行在线编程。个用户定义字符或图形存储于。视频驱动器输出带有衰减补偿。同时可外部输入复合同步信号。个字符和图形,并可以通过。闪烁、反色和背景控制字符。出厂时带有预先编程的字符组。封装,工作温
散列技术散列技术是在记录的存储位置和它的关键字之间建立一个确定的对应关系f,使得每个关键字key对应 一个存储位置f(key),即存储位置=f(关键字)。我们把这种对应关系f称为散列函数,又称为哈希(Hash)函数。采用散列技术将记录存储在一块连续的存储空间中,这块连续存储空间称为散列表或哈希表(Hash table)。关键字对应的记录存储位置我们称为散列地址。
可扩展哈希表是普通哈希表的优化版本,核心解决了扩容时的性能问题。它通过局部桶分裂替代全局rehash,仅迁移满桶数据而非全部数据,避免了扩容卡顿。主要改进包括:1)按需分裂桶而非整体扩容;2)取消链表冲突处理,通过桶分裂保持查询效率O(1);3)采用目录索引实现高效数据定位。适用于大数据量场景,在保持普通哈希表接口的同时,显著提升了扩容效率和查询稳定性。实现上包含桶和目录两个核心组件,支持动态调整
HashMap 主要用来存放键值对,它基于哈希表的 Map 接口实现,是常用的 Java 集合之一,是非线程安全的。HashMap可以存储 null 的 key 和 value,但 null 作为键只能有一个,null 作为值可以有多个JDK1.8 之前 HashMap 由数组+链表组成的,数组是 HashMap 的主体,链表则是主要为了解决哈希冲突而存在的(“拉链法”解决冲突)。JDK1.8 以
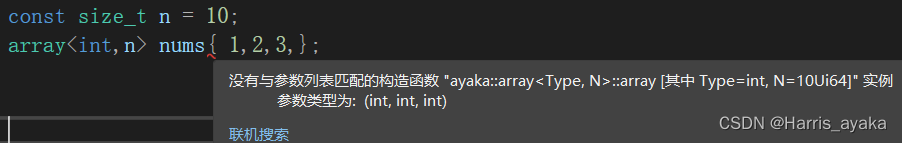
最近为了让自己深入了解C++,于是开始动手实现C++的一些简单的常用组件,在基本完成了最简单的链表、栈、队列等数据结构之后,我又挑了一个最简单的,开始实现C++的静态数组array类参考文档:<array> 函数 | Microsoft DocsarrayC++的array是一个定长静态数组,声明如下。接收两个模板参数:元素类型,一个是数组长度。把数组长度也作为模板参数之一
技术核心思想空间复杂度时间复杂度主要优势典型应用传统哈希表键值映射到数组O(n)O(1)平均快速访问字典、缓存一致性哈希哈希环映射O(n)O(log n)节点增减影响小分布式系统虚拟节点多对一映射O(kn)O(k log n)负载均衡负载均衡器布隆过滤器多哈希位图O(m)O(k)空间效率高存在性检测。
顺序容器:vector、deque、list关联容器(有序):map、set(基于红黑树)无序容器(C++11新增):unordered_map、unordered_set(基于哈希表)// 自定义类型:学生int id;// 1. 对于map:需要定义operator<用于排序/*map底层的红黑树需要通过比较键的大小来维持结构平衡和有序性。对于基础类型(如 int、string 等),编译器已
通过上述操作:将数组的具体数值转化为了新布尔数组的下标,此时要查找某个元素,在新数组中已经知道了该数组的索引下标,因此查找起来非常快。但是这样也有一个问题,就是如果我这个数组中的数据范围很分散,比如[10,100000,1000000000]这种,那我最少要创建一个1000000000+1大小长度的新数组,太不划算了。JDK中的HashMap的factor默认是0.75,而在阿里的实验室论证中,在
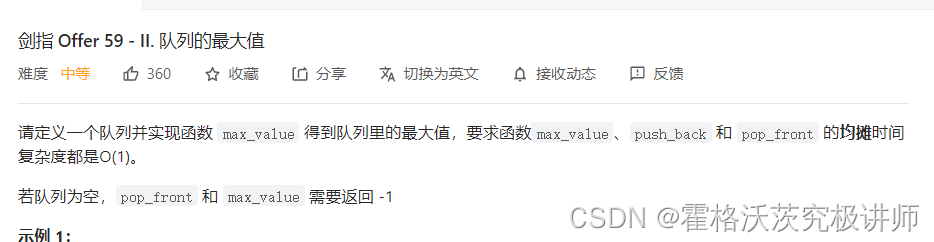
最值问题第一题typedef struct {struct Queue q1;struct Queue q2;//存最大值int idx;} MaxQueue;MaxQueue* maxQueueCreate() {MaxQueue* ret=(MaxQueue*)malloc(sizeof(MaxQueue));QueueClear(&ret->q1);QueueClear(&am
阿姆斯特丹流数据分析与事件驱动平台工程实践让我们认识到:实时分析能力不只是计算速度,而是事件管道、状态管理和监控体系的整体能力。当流式计算、事件队列、监控、容错机制工程化结合,平台才能在高并发、高密度场景下持续稳定运行,为业务实时决策提供可靠支撑。
散列表也叫作哈希表(hash table),这种数据结构提供了键(Key)和值(Value)的映射关系。只要给出一个Key,就可以高效查找到它所匹配的Value,时间复杂度接近于O(1)
今天就是最后一次数据结构的课程了,但是查找hash表会非常常用,所以这一篇文章我也是觉得是数据结构里面特别重要的一篇,我尽量好好写。大家一起学习呀0.0三连即可提高学习效率🧑🏻作者简介:一个学嵌入式的年轻人✨联系方式:2201891280(QQ)📔源码地址:https://gitee.com/xingleigao/study_qianrushi⏳全文大约阅读时间: 120min文章目录查找查
根据左神数据结构学习后做的一些笔记,和在牛客网刷题做的代码笔记
哈希表
low指针一开始指向13,high指针一开始指向134,所以mid指向50,第一次比较90>15,所以low+1,high指针不变,此时low指针指向62,high指针指向134,即mid指向90,即第二次比较时找到目标元素,查找成功的比较次数为2。1、已知有序表(13,18,24,35,47,50,62,83,90,115,134),当二分查找值为90的元素时,查找成功的比较次数为()。,查找成
对哈希表及相关概念的理解,用C语言实现哈希表(直接定址法)
散列表与线性表和树表的查找不同,后者是通过在表中进行一系列的关键字与给定值进行比较,达到检索的目的,关键字与其所对应的元素在表中的位置不存在映射关系,因此查找效率取决与给定值与关键字的比较次数。**散列表**却与之不同,*散列表会根据关键字直接访问表中的数据,即关键字与其所在的元素在表中的位置存在映射关系*。例如通过身份证号(身份证号作为关键字)可以找到这个人的信息。其中这种映射关系(规则)*叫做
目录1 哈希概念1.1 直接定址法1.2 哈希冲突1.3 负载因子1.4 将关键字转成整数1.5 哈希函数1.5.1 除法散列法 / 除留余数法1.5.2 乘法散列法1.5.3 全域散列法1.5.4 其他方法1.6 处理哈希冲突1.6.1 开放地址法1.6.1.1 线性探测编辑1.6.1.2 二次探测1.6.2 代码实现开放地址法1.6.2.1 扩容操作1.6.2.2 Key不能取模的问
log2Nlog_2 Nlog2N),搜索的效率取决于搜索过程中元素的比较次数如果构造一种存储结构,通过某种函数(hashFunc)使元素的存储位置与它的关键码之间能够建立的关系,那么在查找时通过该函数可以很快找到该元素那么这种方式即为哈希(散列),举个例子:),其中capacity为存储元素空间的总大小。若我们将该集合存储在 capacity 为10的哈希表中,则各元素存储位置对应如下:用该方
c++、数据结构、哈希表
废话不多说,喊一句号子鼓励自己:程序员永不失业,程序员走向架构!本篇Blog的主题是【原地哈希】,使用【数组】这个基本的数据结构来实现,这个高频题的站点是:CodeTop,筛选条件为:目标公司+最近一年+出现频率排序,由高到低的去牛客TOP101去找,只有两个地方都出现过才做这道题(CodeTop本身汇聚了LeetCode的来源),确保刷的题都是高频要面试考的题。明确目标题后,附上题目链接,后期可
以上就是对哈希相关内容的总结了,需要具体代码的可以查看我的gitee仓库:传送门。
本文解析2010年考研408真题中关于散列表构造和查找的问题。题目要求将关键字序列(7,8,30,11,18,9,14)存入散列表,使用散列函数H(key)=(key×3)mod7,采用线性探测法处理冲突,装填因子为0.7。 关键步骤包括: 根据装填因子计算表长为10 逐个插入关键字并处理冲突,记录查找次数 构造最终散列表 计算查找成功ASL(12/7)和查找不成功ASL(18/7) 重点注意事项
本文主要探讨了哈希表及其相关容器的实现原理与应用。文章首先对比了unordered_set/set和unordered_map/map的底层实现差异:前者基于哈希表实现,提供O(1)的平均时间复杂度但无序;后者基于红黑树实现,保持有序但时间复杂度为O(logn)。接着详细解析了哈希表的核心概念,包括哈希函数设计(如除法散列法、乘法散列法)、哈希冲突处理机制(开放地址法和链地址法)以及负载因子控制等
本文为SZU 数据结构课程 哈希表与排序 第一节实验的 AC代码
【代码】数据结构实习--散列表实现电话号码查询系统(完整c语言代码!
这段代码的主要目的是从一个被认为是连续序列起始位置的数字开始,向上查找所有连续的数字,并统计它们的数量。通过这种方式,可以有效地找到以num开始的最长连续序列的长度。这种方法有效地利用了哈希集合的特性,能够在 O(n) 的时间复杂度内找到最长的连续序列,是解决此类问题的高效方案。
本文总结了五大核心算法及其LeetCode经典题解,包含双指针/滑动窗口、哈希表应用、树形结构、排序算法和动态规划。针对每类算法给出了3道典型例题的最优解法和模板代码,如移动零(数组)、字母异位词分组(哈希)、二叉树最大深度(树)、快速排序和编辑距离(DP)。文章还提供了高效训练建议,包括每日专项、三遍刷题法和重点突破方向,强调掌握双指针、哈希空间换时间、递归三要素和DP状态转移等核心技巧。
我想走出浪浪山既有适合小白学习的零基础资料,也有适合3年以上经验的小伙伴深入学习提升的进阶课程,涵盖了95%以上大数据知识点,真正体系化!由于文件比较多,这里只是将部分目录截图出来,全套包含大厂面经、学习笔记、源码讲义、实战项目、大纲路线、讲解视频,并且后续会持续更新需要这份系统化资料的朋友,可以戳这里获取++i)return -1;//一般走不到这里,随便返回一个值即可## 📢写在最后我想走出
C语言数据结构之哈希表(HASHTABLE)的实现,哈希表数据结构的定义、创建、释放,推入、取出数据,遍历哈希表的节点,读文件到哈希表等功能的实现。
CS61Bhttps://github.com/cy-Yin/UCBerkeley-CS61B-sp18
摘要:哈希表是一种通过哈希函数将键映射到数组位置实现快速访问的数据结构,核心特性包括键值对存储、O(1)时间复杂度操作和键唯一性。文章详细解析了哈希表工作原理、常见的哈希冲突解决方案(链地址法和开放地址法),以及Java中HashMap的实现机制(包括树化优化和扩容策略)。同时探讨了哈希表在缓存系统、词频统计等场景的应用,并分析了哈希攻击防御、内存优化等实际问题。最后对比了不同哈希实现的优缺点,指
本文系统介绍了哈希表的核心原理与应用。首先概述了哈希表作为高效键值存储结构的基本特性,其通过哈希函数实现O(1)时间复杂度操作。重点分析了哈希冲突问题及其解决方案:包括优化哈希函数设计(直接定制法、除留余数法)、调节负载因子,以及开放寻址法(线性/二次探测)和链地址法(哈希桶)两种冲突处理策略。特别阐述了Java中的具体实现类:非线程安全的HashMap、线程安全的Hashtable以及高并发场景
答:哈希算法是一种将输入数据(通常是任意大小的信息)转换为固定大小的值(即哈希值)的算法。哈希值通常是一个较短的字符串。用于快速查找和数据完整性验证等目的。哈希算法广泛应用于数据结构(如哈希表)、加密和数据完整性验证等领域。1.相同的输入永远会产出相同的输出(哈希值)2.固定输出长度:无论输入数据的大小如何,输出的哈希值长度都是固定的3.快速计算:计算哈希值的过程应该是快速的,能够在合理的时间内完
该方法最关键的是对于p的选择,当数据量较大,冲突产生,一般选择近m的质数。以关键字为自变量,通过一定的函数关系,计算出对应的函数值(哈希值)H(key)=key 或者 H(key) = a key + b。哈希函数是一个映象,将关键字的集合映射到某个地址集合上。最为常见的方法之一。选择一个随机数,取关键字的随机函数值为它的散列地址。(如果非数字关键字,则需先对其进行数字化处理)哈希函数为关键字的线
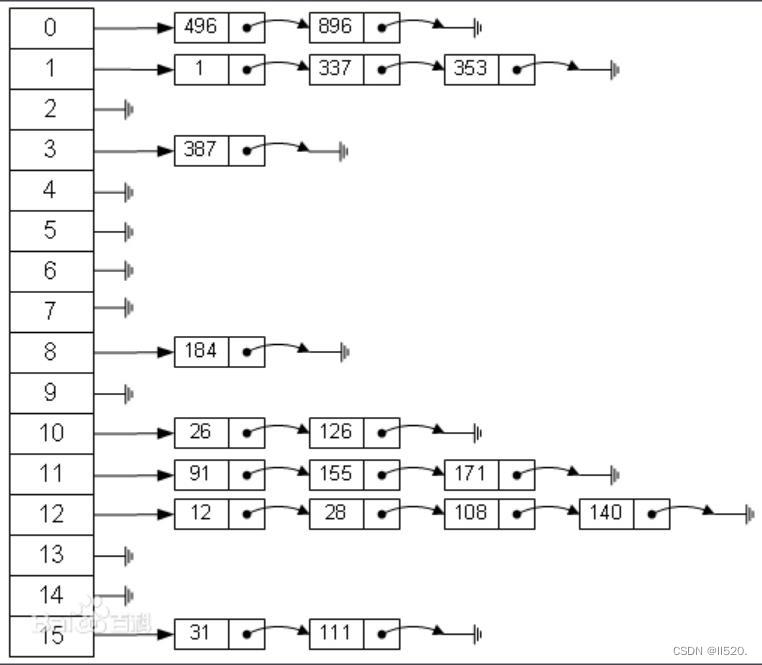
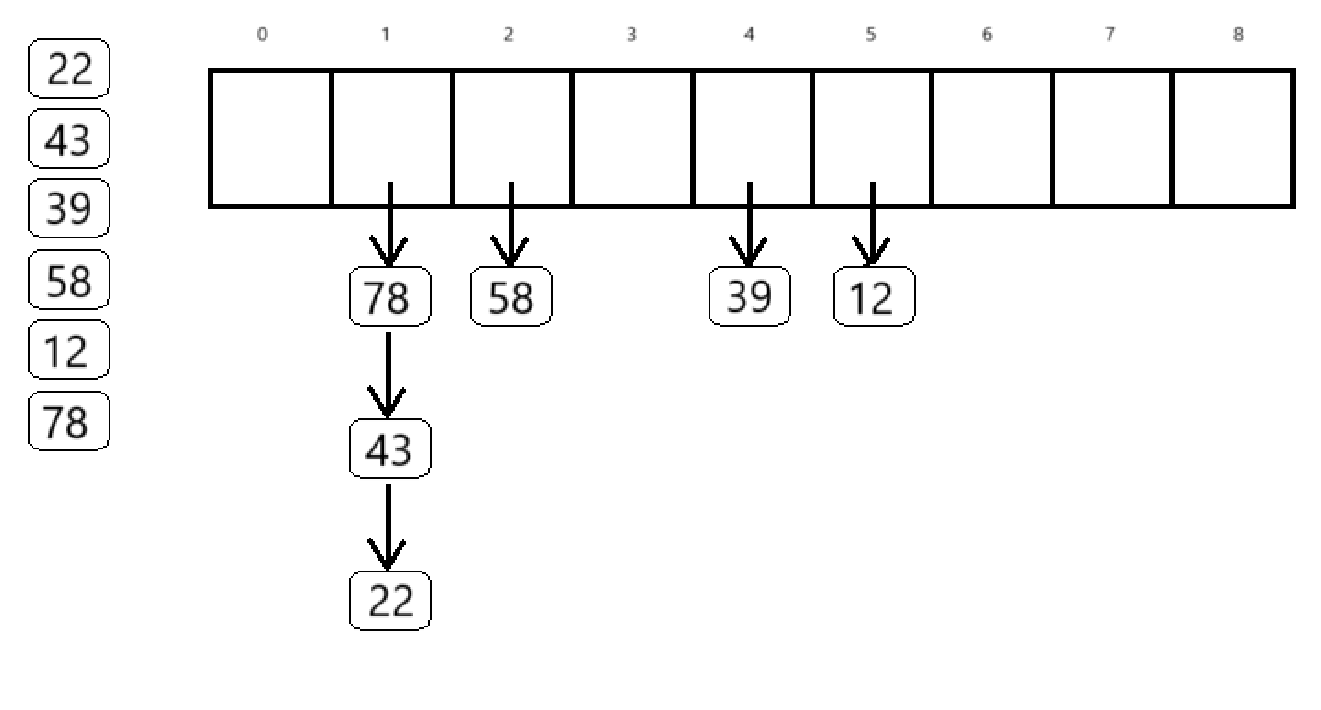
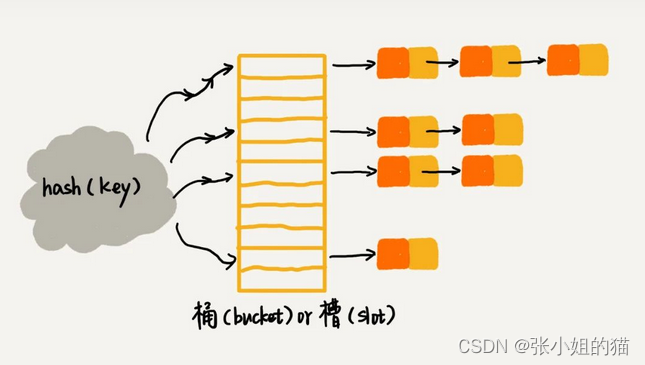
在这种方法中,哈希表的每个槽(slot)或桶(bucket)都关联一个链表,我们把具有相同属性的元素进行连接,最后只需要我们进行查找的时候只需要进行哈希映射,找到数组的地址之后,去遍历里面的链表,找到对应的元素。- **性能依赖于负载因子**:当哈希表的负载因子(即表中元素数量与槽数量的比率)较高时,链表可能会变得较长,导致查找效率下降。- **动态扩容**:随着元素的增加,可以动态地增加哈希表的
本文探讨了哈希函数的设计原则与实现方法。好的哈希函数需具备确定性、高效性和均匀性三大品质。文章详细介绍了四种经典哈希方法:1)除留余数法(整数Key首选);2)平方取中法(处理规律性Key);3)折叠法(适用于超长Key);4)多项式滚动哈希(字符串Key标准方案)。每种方法都附有C++实现代码,并分析了其适用场景和优缺点。最后强调应根据Key特征选择合适方法,其中除留余数法对整数最常用,多项式哈
在数据结构的江湖中,数组以其 $O(1)$ 的随机访问速度称雄,而链表则以 $O(1)$ 的高效增删操作见长。然而,我们常常面临一个两难的抉择:有没有一种数据结构能兼具二者的优点,实现快速的查找、插入和删除呢?答案是肯定的,它就是我们今天的主角——**哈希表(Hash Table)**,也被称为**散列表**。本文将带你深入探索哈希表的内部世界,从其诞生的背景、核心工作原理,到其灵魂组件——哈希函
unordered_map自定义key结构体