登录社区云,与社区用户共同成长
邀请您加入社区
【代码】数字图像处理——彩色图像平滑HSI均值滤波、RGB图像进行平滑处理。
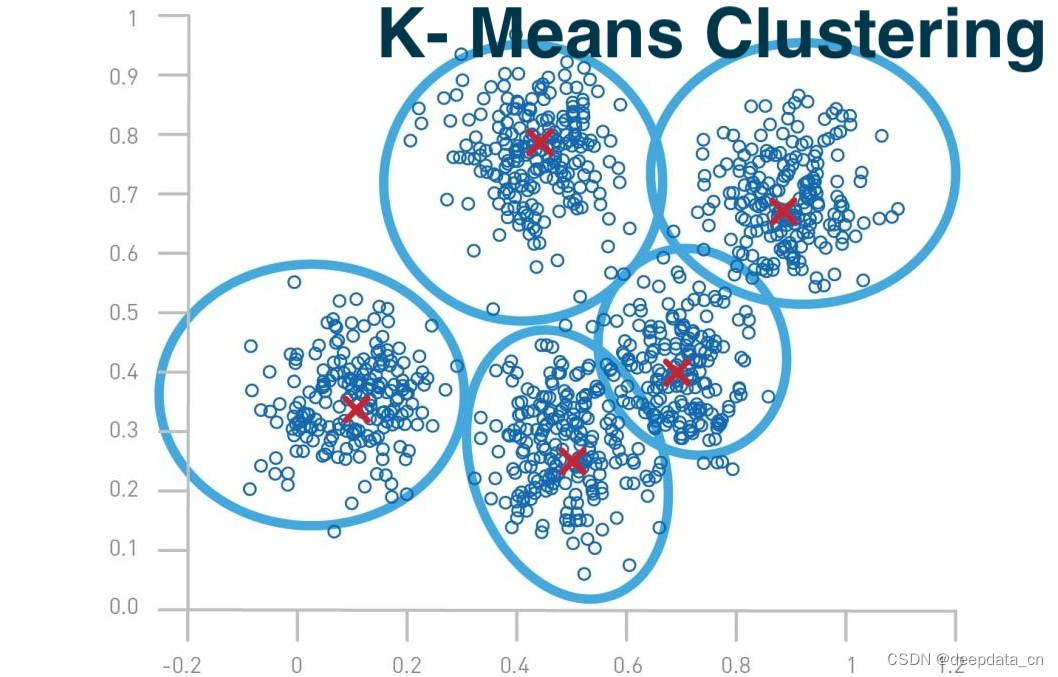
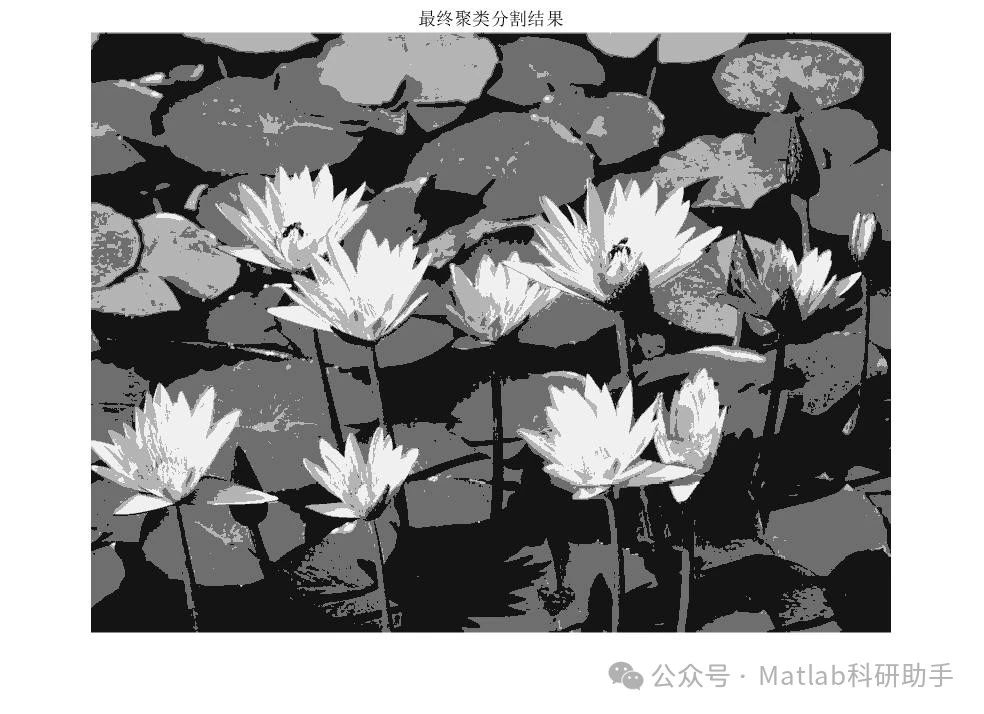
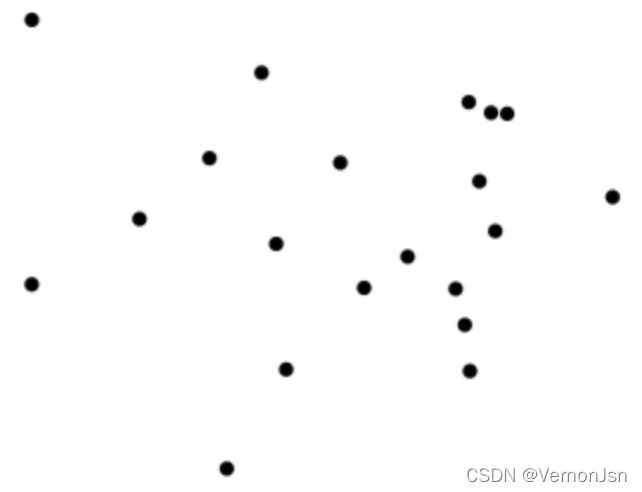
K-均值聚类 (K-Means Clustering)是一种经典的无监督学习算法,用于将数据集分成K个不同的簇。其核心思想是将数据点根据距离的远近分配到不同的簇中,使得簇内的点尽可能相似,簇间的点尽可能不同。
k均值算法的优点是简单、易于实现,并且对大规模数据集的处理速度较快,作为一种简单、高效的聚类分析技术,K均值算法在数据分析和机器学习的领域中发挥着重要作用
通过上述步骤,我们详细介绍了非局部均值去噪算法的实现过程,包括搜索相似块、计算权重和加权平均去噪。这些步骤共同作用,能够有效地去除图像中的噪声,同时保持图像的细节和结构。在实际应用中,根据图像的特性和噪声的类型,可能需要调整算法的参数,以达到最佳的去噪效果。
聚类分析作为一种无监督学习方法,在数据挖掘、模式识别和图像处理等领域有着广泛的应用。模糊C均值聚类 (FCM) 算法作为一种经典的模糊聚类算法,因其能够处理数据样本隶属度的不确定性而备受关注。然而,FCM算法的性能严重依赖于初始聚类中心的选取,容易陷入局部最优解。
图像的获取过程存在各种不确定因素,易导致其质量下降 或 退 化,常常需要利用图像增强技术,改善其视 觉 效 果。图像增强是对图像进行分析的预处理环节,即将图像转换成更适合于人眼观察和机 器 分 析 识 别 的 形 式,以 突 出 图 像 细 节 和 对比度。基于空域的直接增强算法,可对图像灰度进行处理,包 括 Gamma校 正 法、对 比 度 拉 伸 法、直 方 图均衡化、小波变换法等。频域的处理
模糊C均值聚类 (Fuzzy C-Means, FCM) 作为一种常用的模糊聚类算法,广泛应用于图像分割、模式识别、数据挖掘等领域。然而,FCM算法的结果通常以隶属度矩阵和聚类中心的形式呈现,难以直观地理解和分析。因此,对FCM聚类结果进行有效可视化至关重要,它能够帮助研究者更好地理解数据结构、评估聚类效果,并为后续分析提供支撑。本文将探讨基于FCM模糊C均值聚类结果的可视化方法,并分析其优缺点及
(2)若高斯-马尔可夫条件中 Cov (εi , εj ) = 0, i ̸= j 被违背,即误差项出现自相关性 的情况下,εi = ρ*εi−1 + ui,其中 ui 是满足高斯-马尔可夫条件的误差项,推导(1)中 σ 2 估计的期望。今晚在做回归分析的时候,在一道有关中心化的题目里面纠结了一个晚上,最终发现对于中心化的理解错误,于是打算把我的理解分享出来。中心化后的数据违背了回归分析的前提假设
原文题目:Digital Image Enhancement and Noise Filtering by Use of Local Statistics在学习完原文后,发现了一篇中文,不能说毫无关系,只能说是YMYY:[1]陈业仙. DIGITAL IMAGE ENHANCEMENT AND NOISE FILTERING BY USE OF LOCAL STATISTICS[J]. 计算机应用
k均值聚类是机器学习中一种非常常用的技术,简单来说,k均值聚类就是将数据分成k个组,根据数据点距离哪个组的中心点最近而决定。
RGB和HSI相互转换 matlab实现 色调域均值滤波。
如果你曾尝试过在SPSS中使用K均值聚类分析,那么你可能会遇到一个让人挠头的问题:到底应该将数据分成多少类最合适呢?这个问题就像一个迷宫,引得无数英雄竞折腰。别急,本文就带你走进K均值聚类的世界,探讨如何在SPSS中找到那个“恰到好处”的分类数量。
df[‘gdp’] = list(map(lambda x:float(str(x).rstrip(‘亿’)),df[‘gdp’]))pages = int(‘’.join(re.findall(‘共 ([0-9]) 页’,pages)))‘新疆’:‘新疆维吾尔自治区’,‘宁夏’:‘宁夏回族自治区’,‘广西’:‘广西壮族自治区’}‘重庆’:‘重庆市’,‘北京’:‘北京市’,‘天津’:‘天津市’,‘
基于Matlab的图像处理②(图像增强技术,中值滤波,均值滤波)
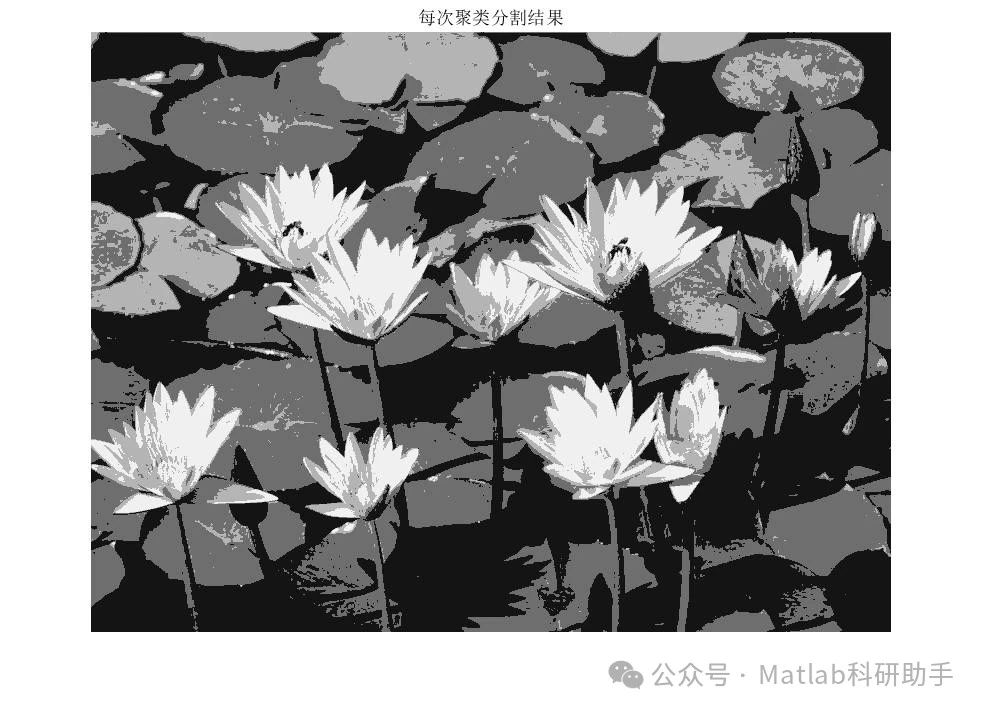
图像分割是计算机视觉领域中一项重要的基础任务,其目的在于将图像分割成不同的区域,每个区域对应于图像中不同的对象或背景。C均值聚类算法是一种经典的无监督聚类算法,近年来被广泛应用于图像分割领域。基于C均值聚类的图像分割方法是一种简单有效的方法,但其也存在一些局限性。在实际应用中,需要根据具体情况进行改进和优化。近年来,一些新的聚类算法和图像分割方法被提出,例如K均值聚类、模糊C均值聚类、谱聚类等,这
无监督学习是一类强大的算法,能够在没有标签的数据集中发现结构与模式。聚类作为无监督学习的重要组成部分,在各类数据分析任务中广泛应用。本文将深入讲解聚类算法中的两种常见方法:K均值聚类和层次聚类,结合Python代码详细介绍它们的实现与应用,帮助理解不同聚类方法的优劣与使用场景。
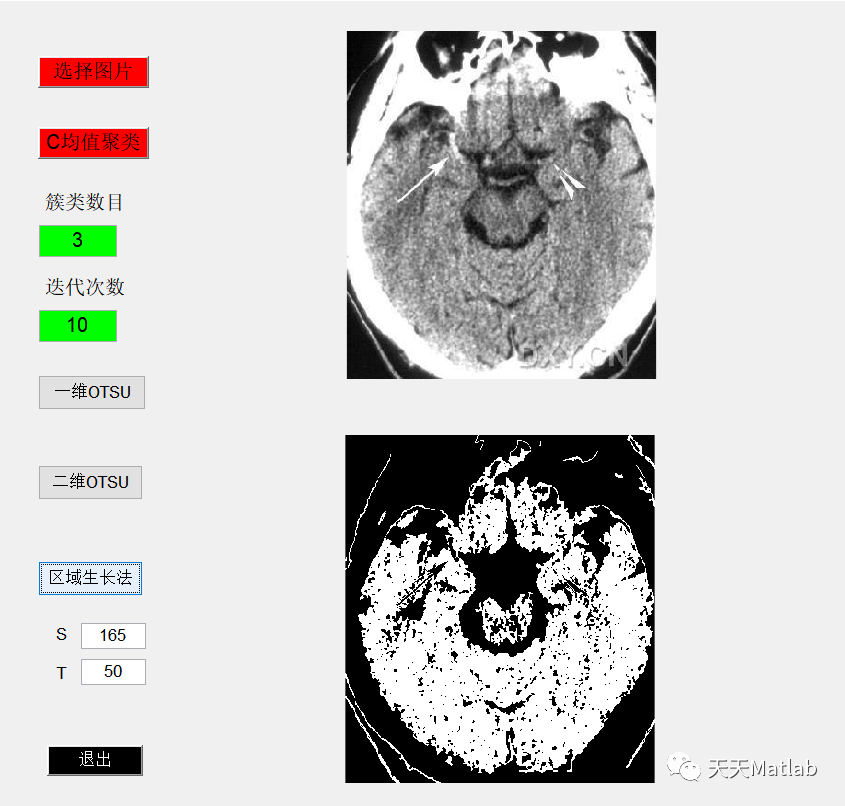
在现代医学领域中,医学影像处理技术随着计算机科学和影像技术的进步,已经成为医学领域重要的一个分支.室外光照度不均,CT自身空间分辨率和层厚参数,人体组织器官蠕动等诸多外界因素造成了医学X线图像具有噪声污染,细节信息隐藏,病变组织边缘模糊等问题[1]-[3],对医生诊断和治疗的准确性构成了潜在影响. 本文以"人体肺"CT图像为研究对象,利用MATLAB GUI(Graphical UserInter
1. 聚类算法1.1 聚类(Clustering)的定义有一天老板给你一堆数据,然后他说,你给我分出几类来聚类目的在将相似的事物归类。聚类分析又称为“同质分组”或者“无监督的分类指把一组数据分成不同的“簇”,每簇中的数据相似而不同簇间的数据则距离较远。●簇内文档之间应该彼此相似●簇间文档之间差异大无监督意味着没有已标注好的数据集提出一个算法来寻找该例中的簇结构1.2 分类 ...
本数据集基于Google Earth Engine(GEE)平台,通过对Landsat系列卫星影像进行逐年最大值合成处理,生成1985年至2024年中国区域30米空间分辨率的年度NDVI数据集。
本数据集基于全球开源地图项目OpenStreetMap(OSM),专门提取并整合了中国区域的旅馆信息,数据更新至2025年12月8日。我们已对原始内容进行了系统性的清洗、坐标纠偏与本地化处理,显著提升了数据在中文场景下的准确性与可用性。
本摘要简明扼要地介绍了基于MODIS(MCD43A4)数据生产的中国2000-2023年燃烧面积指数数据集。
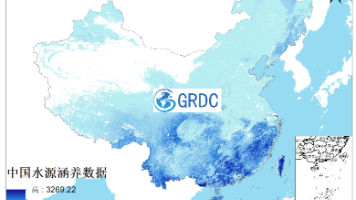
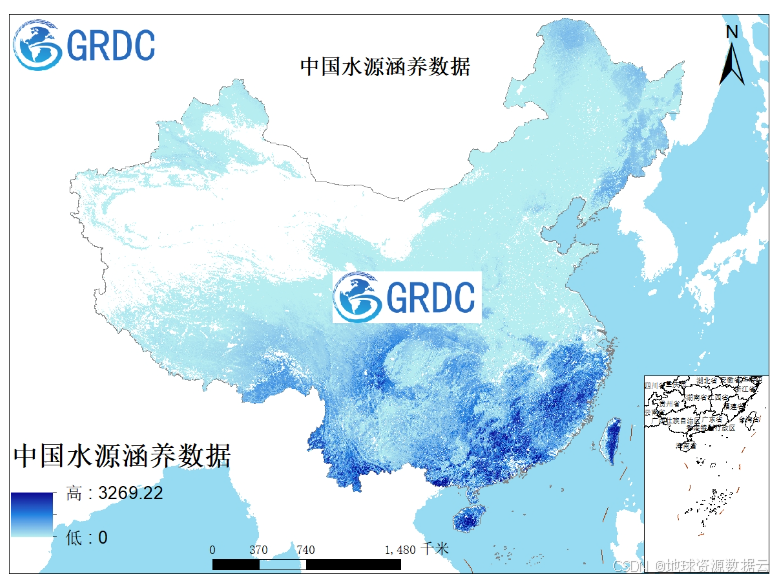
随着计算机科学的不断进步,目前,国外学者主要基于水文评估模型(SWAT)、水文生态模型(InVEST)和生态系统评价模型(GUMBO)对水源涵养量分布及动态特征进行研究,而国内学者则利用参数本地化后的模型对中国不同尺度、不同生态背景的区域,如黑河流域、石羊河流域、黄土高原和淮河流域等地区水源涵养功能进行评价,并取得较好的评估效果。该模型综合考虑不同土地利用/覆被类型的土壤渗透性、地形差异和地表粗糙
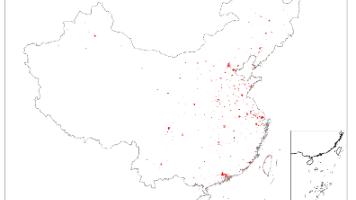
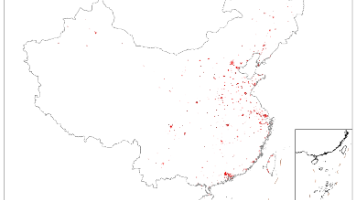
全国城市建成区空间分布数据(1972-2023年),利用Google Earth Engine平台,基于Landsat系列遥感影像提取了1972–2023年城市不透水面,后经过不透水面聚集密度计算方法计算了不透水面聚集密度,通过阈值划分提取了城市建成区,并设置了建成区面积阈值,去除了噪点,获取了全国城市建成区空间分布数据集。该提取能准确刻画城市形态,提取精度高,保持了建成区的完整性。数据集包括41
降雨侵蚀力因子其实是用来描述降雨对土壤侵蚀的潜在能力大小的,就是降雨的冲刷对土壤的侵蚀效应。到降雨侵蚀力因子R的计算方法非常的繁多,不过这些计算方法总结下来,核心思路其实大概可以分为两种:一种是将降雨的动能引入模型来计算,因为降雨的动能越大,说明冲刷的力度越大;另一种是直接引用月降雨量或年降雨量来计算,降雨量越大对土壤的侵蚀能力就越大。降雨侵蚀力因子的计算可以根据所获取的降雨资料分别采用不同的计算
K均值聚类,对客户进行划分类别的分析,丰富的可视化过程
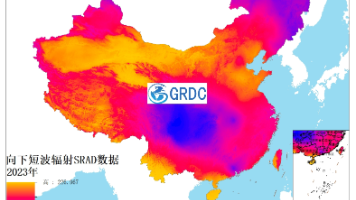
Terra Climate是一个基于卫星数据的多变量气候数据集。这些数据为需要高空间分辨率和时变数据的全球尺度的生态和水文研究提供了重要输入。除了最高和最低温度和降水量外,Terra Climate还提供衍生变量,包括参考蒸散量、蒸气压赤字和帕尔默干旱严重性指数。本数据集就是在此前提下收录了中国区域2000-2023年向下短波辐射SRAD年数据集,主要以tif的格式存储,单位为w/m2。
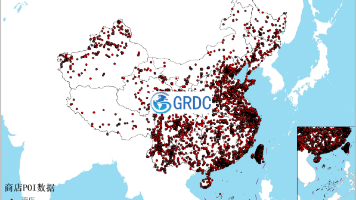
本数据集基于全球开源地图项目OpenStreetMap(OSM),专门提取并整合了中国区域的商店信息,数据更新至2025年12月8日。我们已对原始内容进行了系统性的清洗、坐标纠偏与本地化处理,显著提升了数据在中文场景下的准确性与可用性。
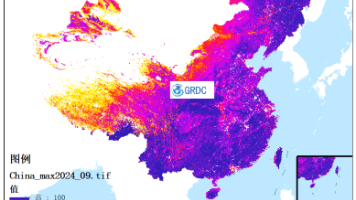
本数据集提供了2019年至2024年逐年10米空间分辨率的归一化植被指数最大值合成产品。
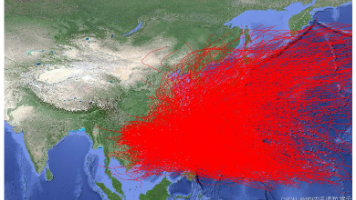
1945至今,中国近海台风路径数据集,包含每个台风的真实路径信息、台风强度、气压、中心风速、移动速度、移动方向,台风的中英文名称,编号等。数据有shp格式和文本格式两种,共计1800余条数据,持续更新中。
FPAR(Fraction of Photosynthetically Active Radiation Absorbed),即植被光合有效辐射吸收比率,是指植被冠层吸收的光合有效辐射(PAR,400-700nm)占入射光合有效辐射的比例。FPAR 是植被光合作用的关键参数,广泛用于生态系统生产力评估、碳循环研究和植被健康状况监测。MODIS 组合光合有效辐射 (FPAR) 产品是一个 8 天复合
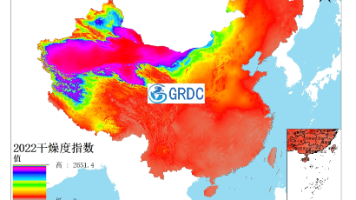
干燥度指数,又称干燥度,是表征一个地区干湿程度的指标。降水代表水分收入,蒸发代表水分支出,是多年平均潜在蒸散发量与降水之比,其倒数称为湿润指数。干燥度是专门用来描述和衡量气象条件中水分循环的一个参数,它直接关联到气候的湿度和水分状况,是气象学中的一个重要概念。本数据集收录了2000-2022年中国1KM逐年干燥数据,主要以tiff的格式存储。
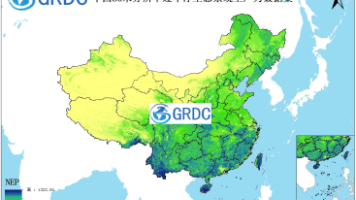
本数据集提供了2000年至2024年全球逐年净生态系统生产力(NEP)数据,空间分辨率为1000米。
c++实现均值滤波(附带源码)
在大数据时代,时序数据在多个领域占据了重要位置,包括金融市场、医疗诊断、能源管理、交通预测等。如何高效地分析和预测复杂的时序数据成为研究热点。双向长短期记忆(BiLTTM)网络是一种能够捕获时序数据中前向和后向依赖的深度学习模型,具有出色的特征提取能力。然而,BiLTTM 的性能在很大程度上依赖于超参数的配置,这些超参数包括学习率、隐藏层单元数、批次大小等。传统的超参数调优方法如网格搜索和随机搜索
本数据集基于全球开源地图项目OpenStreetMap(OSM),专门提取并整合了中国区域的露天矿场信息,数据更新至2025年12月8日。我们已对原始内容进行了系统性的清洗、坐标纠偏与本地化处理,显著提升了数据在中文场景下的准确性与可用性。
水质数据的收集和分析对于确保公众健康至关重要。该数据集包括1980-2022年间每天(3588次)、每周(217751次)以及每月(114954次)的水质观测数据,包括中国内陆到沿海/海洋地区的2384个站点的330000多次观测的18个指标。该数据集主要以csv和shp的格式存储,其中包括监控位置标识、经度、纬度、监控日期、监控指标名称、监控指标数值、指标单位以及监控站点名称等变量。
遥感技术作为获取地球表面信息的重要手段,其应用日益广泛。然而,单一传感器获取的图像往往信息量有限,难以满足日益复杂的应用需求。图像融合技术应运而生,它通过将不同传感器或不同时间获取的图像数据进行整合,生成具有更高空间分辨率、光谱分辨率和信息量的新图像,从而提高信息提取精度和应用效率。本文重点探讨遥感图像配准融合技术,并着重分析辐射校正、辐射归一化、均值方差等关键环节在融合过程中的作用。遥感图像融合
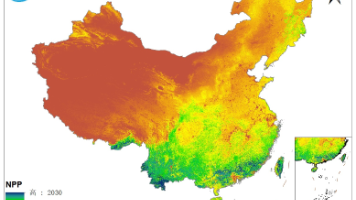
摘要:植被净初级生产力(Net PrimaryProductivity, NPP)是指绿色植物在单位面积、 单位时间内所累积的有机物数量,表现为光合作用固定的有机碳中扣除植物本身呼吸消耗的部分。它不仅表征植物活动的重要变量,而且是判定生态系统碳汇和调节生态过程的主要因子,构建长时间序列净初级生产力数据集对生态系统及全球气候变化研究具有重要意义。本数据集利用改进的CASA (Cainegie-Ame
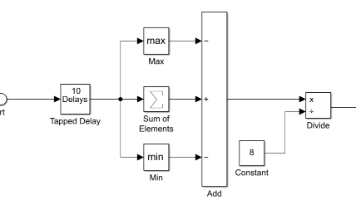
基于Simulink的均值滤波数据处理模型
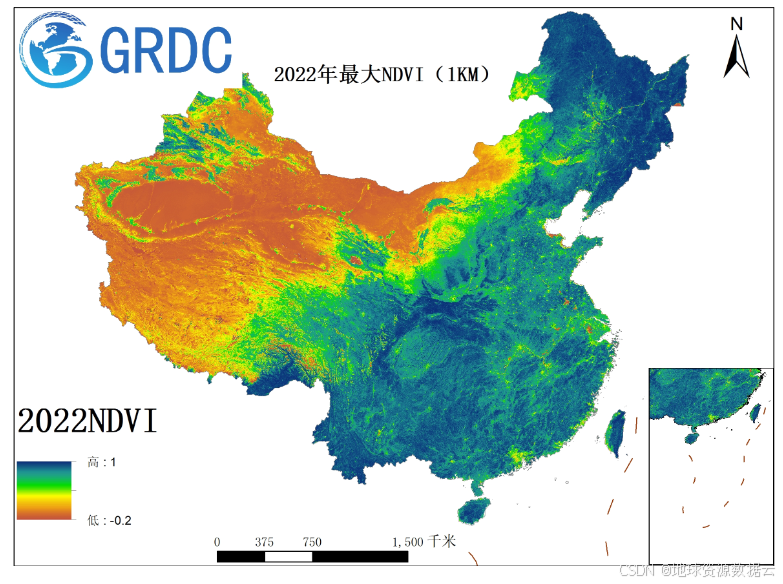
/ 输入:目标区域的shp文件名路径 Map.addLayer(geometry, {color:"#ff0000", fillColor:"#00000000"}, "yanhai");第一个是归一化植被指数 (NDVI),它被称为现有国家海洋和大气管理局高级甚高分辨率辐射计 (NOAA-AVHRR) 导出的 NDVI 的连续性指数。// 加载中国区域的矢量边界。
MOD11A2 V6.1 产品提供 1200 x 1200 公里网格中的 8 天平均地表温度 (LST)。MOD11A2 中的每个像素值都是在 8 天内收集的所有相应 MOD11A1 LST 像素的简单平均值。MOD11A2 会对所有每日 LST 值进行简单的平均处理,而不会对特定质量检查位进行任何过滤。每个 MOD11A2 质量检查值均根据任何给定像素的大多数输入每日质量检查值而设置。之所以选择