登录社区云,与社区用户共同成长
邀请您加入社区
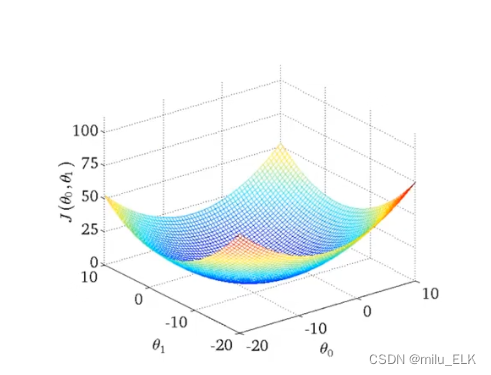
梯度下降算法有两种实现方式:批量梯度下降和随机梯度下降。批量梯度下降是指每次迭代都使用全部样本进行参数更新,而随机梯度下降是指每次迭代只使用一个样本进行参数更新。梯度下降算法是一种优化算法,通过迭代的方式最小化代价函数。
ywTxby=w^Tx+bywTxb符号说明:x∈Rnx∈Rn:输入特征向量(维度为 𝑛)。w∈Rnw∈Rn:权重向量,表示每个特征的系数。b∈Rb∈R:偏置(bias),表示线性模型的截距。y∈Ry∈R:输出变量,通常是一个连续值。目标: 根据训练数据集Dxiyii1mD{(xiyii1m,学习参数 𝑤 和 𝑏,使得模型能对未知数据的输出 𝑦 做出准确预测。ywTxbϵ。
踏入未知,我们携带启发式算法的魔法手册,揭示如何在迷雾重重的数据森林中开辟捷径。从遗传算法的自然选择智慧到模拟退火的冷静决策,再到粒子群的集体智慧风暴,每一次迭代都是对优化极限的挑战。蚂蚁军团与禁忌探索者携手,共同揭示了全局最优的奥秘。这不仅是一场算法的盛宴,更是未来科技跃进的蓝图!
线性回归是一种广泛用于统计学和机器学习中的回归分析方法,用于建立自变量(特征)与因变量(目标)之间的线性关系模型。线性回归的基本原理是寻找一条直线(或者在多维情况下是一个超平面),以最佳地拟合训练数据,使得模型的预测与真实观测值之间的误差最小化。下面我们来详细解释线性回归的基本原理和假设。简单线性回归模型:其中:是因变量(需要预测的值)。是自变量(特征),可以是一个或多个。是截距(模型在自变量都为
逐步构建解的候选方案,并在发现某个候选方案无法成为有效解时,及时“回退”并尝试其他可能的方案
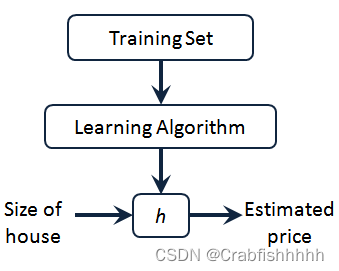
线性回归是一种基础的监督学习算法,用于解决回归问题。它的目标是找到一个线性函数,能够尽可能准确地预测目标变量(如房价)与特征变量(如房屋面积)之间的关系。
ERROR: Could not install packages due to an EnvironmentError: [WinError 5] 拒绝访问。在最后它还建议我使用–user命令,我猜是权限的缘故,那就只能使用命令行来安装了。在运行吴恩达线性回归模型测试显示No module named ‘ipympl‘使用命令行先切换到python中Lib\site-packages文件夹下。然
毕业设计:python农产品价格预测系统 爬虫+线性回归预测算法+Flask框架(源码)✅
时,我们有此时不计入误差,即此时值取0;证明:我们由支持向量回归的定义,我们可以知道当。支持向量回归假设我们能容忍。我们使用拉格朗日数乘数法来求解最优解。时,我们有此时计入误差,即此时值取。为计算中引入的拉格朗日乘子。那么,我们引入分段函数。希望得到一个回归模型。我们引入拉格朗日因子。代入该拉格朗日函数对。
《动手学强化学习》是一本面向初学者的强化学习入门教材,由上海交大ACM班课程改编而成,获得李沐、李航等专家推荐。书籍包含三部分内容:强化学习基础(概念与表格型方法)、强化学习进阶(深度价值函数与策略学习)、以及前沿算法介绍。该书特色在于提供可执行代码,降低学习门槛,帮助读者快速上手。适用于游戏AI、自动驾驶、金融交易等多个应用领域的学习者。电子版可通过关注公众号获取。
简单一元线性回归模型与多元线性回归模型
本文为学堂在线平台驭风计划机器学习课程实验二,主要内容为使用线性回归来根据已有评分数据完成对得分预测模型的构建
回归分析是数据分析中最基础也是最重要的分析工具,绝大多数的 数据分析问题,都可以使用回归的思想来解决。回归分析的任务就是, 通过研究自变量X和因变量Y的相关关系,尝试去解释Y的形成机制,进 而达到通过X去预测Y的目的。常见的回归分析有五类:线性回归、0‐1回归、定序回归、计数回归 和生存回归,其划分的依据是因变量Y的类型。本讲我们主要学习线性 回归。
线性回归分析-回归算法1 回归算法之线性回归 回归问题的判定:目标是连续的,在指定区间内可以是任意一个数值。 线性回归的定义是:目标值预期是输入变量的线性组合。线性回归通过一个或多个自变量与因变量之间进行建模的回归分析。 一元线性回归:涉及到的变量只有一个 多元线性回归:涉及到的变量两个或两个以上...
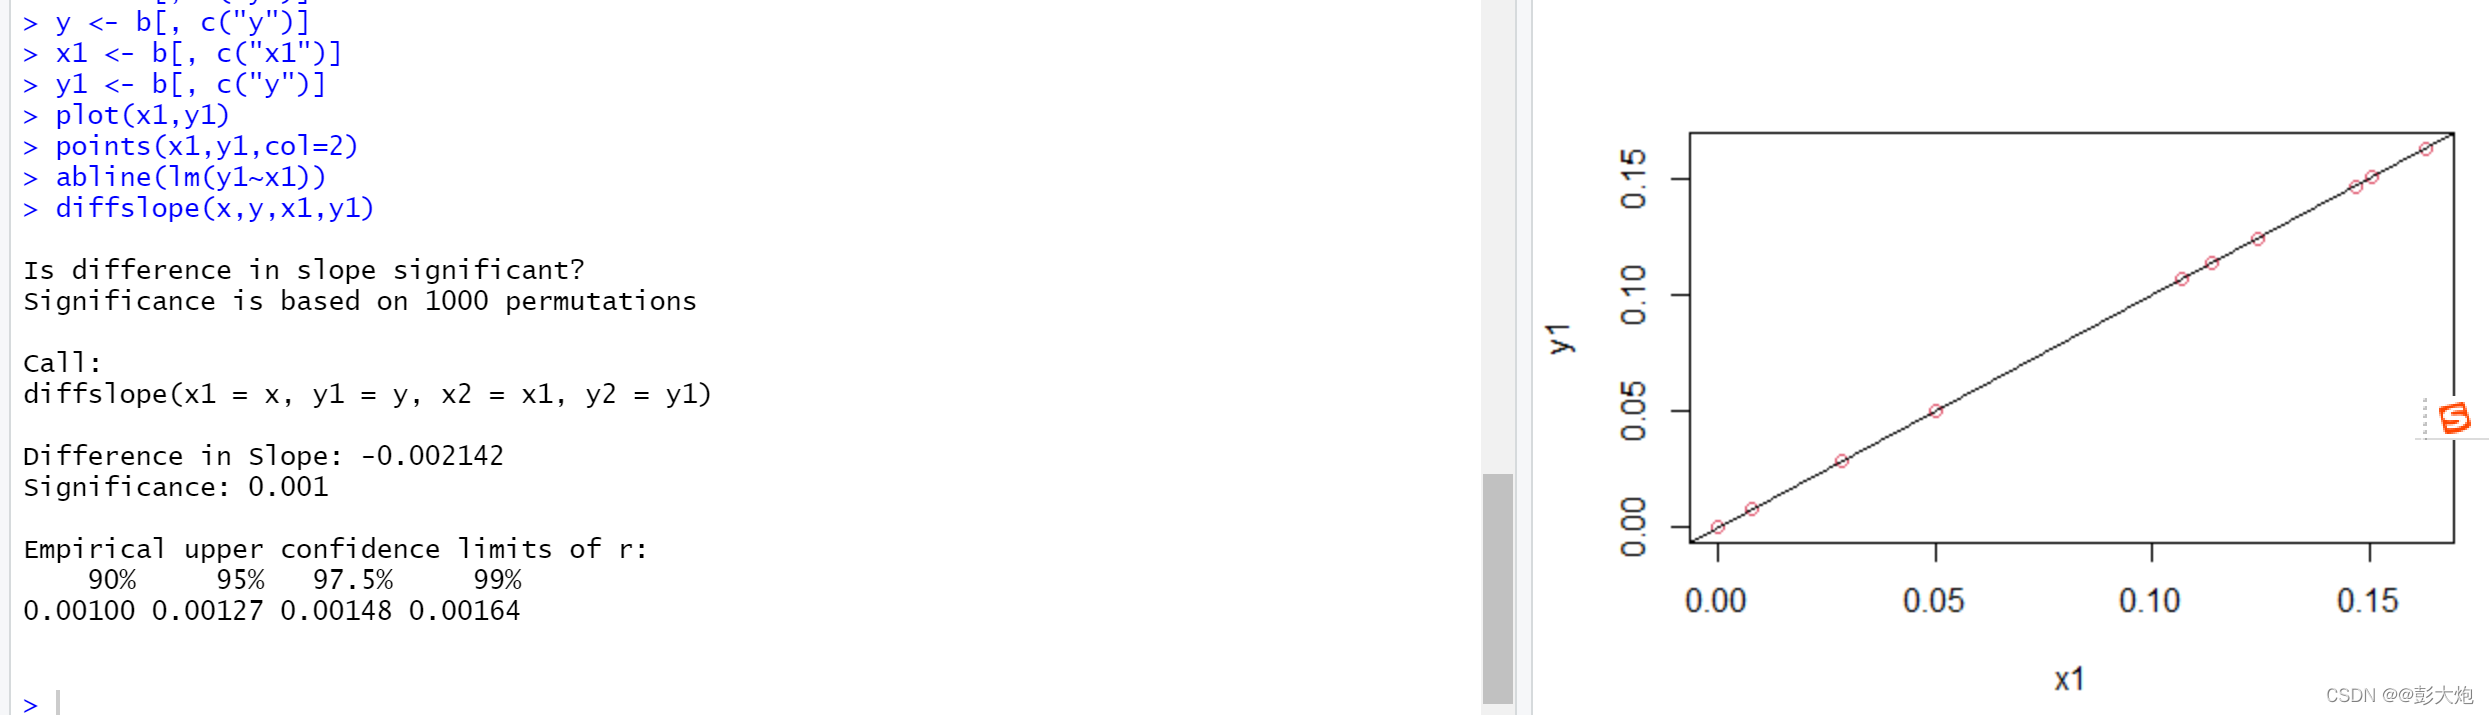
代码如下:library(simba)x <- a[, c(“x”)]y <- a[, c(“y”)]x1 <- a[, c(“x”)]y1 <- a[, c(“y1”)]plot(x1,y1)points(x1,y1,col=2)abline(lm(y1~x1))diffslope(x,y,x1,y1)diffic(x,y,x1,y1)
在数学上,变量之间的关系用来表示是比较常见的一种方式。然而在现实应用中,还存在许多变量之间不能用确定的函数关系来表示的例子。本节将介绍变量之间存在线性相关关系的模型:线性回归模型。下面先介绍简单的,进而再拓展到较为复杂的。最后给出线性回归模型的Python实现方法。所谓一元线性回归,就是自变量和因变量只有一个的线性相关关系模型。以下通过现实生活中的例子引入,再而谈及回归模型、拟合优度等相关概念。
本文主要讲解在matlab中实现Linear Regression和Logistic Regression的代码,并不涉及公式推导。具体的计算公式和推导,相关的机器学习文章和视频一大堆,推荐看Andrew NG的公开课。当然,用的时候可以换成其它数据,两种方法得出的结果都是。这种方法最简单,但是公式推导过程很复杂。注意,Y的值只能取0和1两种。
【代码】用R语言写循环函数,来对数据进行线性回归分析,最终提取p值,并将数据放入数据框中。
表2为回归系数的t检验分析结果,可见intercept(截距)和temp(temp列的回归系数)均达到极显著水平,且temp回归系数大于0。Dep.Variable:响应变量的名称,Dep为Depended的缩写。Df Residuals:残差自由度,样本容量减去参与估计的参数个数。由散点图可以看出啤酒(beer)的销量与温度(temp)有正相关的关系。Prob(F-statistc):F统计量对
文件存储是一种简单且常见的数据存储方式,适用于数据量较小且结构简单的场景。常见的文件存储格式包括文本文件(.txt)、CSV文件(.csv)、JSON文件(.json)等。文件存储的优点是实现简单,易于理解和使用,但不适合处理复杂的查询和大规模数据。
在这篇文章中,我们将探讨监督学习算法的基本概念,重点介绍线性回归、逻辑回归和支持向量机(SVM)等几种常见的监督学习算法。我们将分别阐述它们的基本原理,并通过实际案例展示如何应用这些算法。
线性回归分析学习内容总结
1. 解决`matplotlib`不能绘制中文的问题2. 如何使用`matplotlib`包绘制柱状图、折线图、箱线图、饼图等3. 填充na的方法(线性模型,支持向量机)4. 衡量变量之间的关系以及建模5. 图(graph)可视化分析
线性回归分析是统计学中最常用的分析方法之一,但在使用前需要确保数据满足一定的适用条件。以下是线性回归分析的主要适用条件及相应的检验方法,基于SPSSAU(在线SPSS)平台的操作建议。通过SPSSAU平台进行线性回归分析时,系统会自动完成上述各项检验并生成详细报告,帮助研究者快速判断数据是否满足线性回归的适用条件。二、主要适用条件及检验方法。
线性回归,通俗点讲就是拟合的数据与真实数据间的差别,在这里主要参考徐士良编写的《常用算法程序集(C/C++描述)》里面的内容。这些算法原理是利用最小二乘进行拟合的,不是基于稳健的估算方法,因为它默认y值是真值,但实际中这个值是包含误差的。(1)随机样本分析(2)一元线性回归分析(3)多元线性回归分析(4)半对数数据相关(5)对数数据相关...
本文详细介绍使用SPSS软件进行简单线性回归的理论基础、操作步骤及结果分析。回归分析是定量反映数值型变量之间明显存在的相关关系的一种统计推断方法。回归分析根据自变量的多少可分为简单回归分析和多元回归分析,根据关系类型可分为线性回归分析和非线性回归分析。简单线性回归分析就是在一个因变量与一个自变量之间进行的线性相关关系的统计推断。分析散点图、残差图判断线性关系是否真实存在,以及模型假设是否成立。根据
原文链接:http://tecdat.cn/?p=21557分段回归( piecewise regression ),顾名思义,回归式是“分段”拟合的。其灵活用于响应变量随自变量值的改变而存在多种响应状态的情况,二者间难以通过一种回归模型预测或解释时,不妨根据响应状态找到合适的断点位置,然后将自变量划分为有限的区间,并在不同区间内分别构建回归描述二者关系。 分段回归最简单最常见的类型就是分段线性回
1. 线性回归概述2. 一元线性回归4. 模型评估与改进5. 实践中的注意事项6. 结论
用途:研究两个具有线性关系的变量之间的关系。
R语言线性相关Sepal.WidthSepal.Length0.7425467> cor.test(i1$Sepal.Length,i1$Sepal.Width)Pearson's product-moment correlationdata: i1$Sepal.Length and i1$Sepal.Widtht = 7.6807, df = 48, p-value =...
分析x和y之间的相关关系,解释Y的形成机制,进而用X去预测Y,在不同立场和情景下,Y的解释可以不同。注意相关性不等同于因果性。
简述什么是回归分析,为何要把普通线性模型推广到广义,为什么要关注被解释变量服从什么分布、连结函数的选择与被解释变量所属分布是否有关、为什么说最小二乘法是训练广义线性模型的一种特例、如何处理离散且无序的解释变量、如何训练模型、如何检验模型效果等一系列问题。并通过代码给出一个在车险纯风险保费定价中的应用示例。
摘要:医疗知识图谱结合AI技术,为医学知识管理提供了创新解决方案。AI通过自然语言处理等技术自动化构建知识图谱,支持知识推理、智能问答和个性化医疗建议,显著提高医疗决策效率和质量。典型案例包括百度医疗知识图谱和IBM Watson系统。当前面临数据标准化、动态更新等挑战,未来将向多模态数据融合、实时决策等方向发展。这些技术突破将推动医疗知识管理进入新阶段,为医疗行业带来变革性影响。
常见的线性回归模型就是:f(x)=w0+w1x1+w2x2+...+wnxnf(x)=w0+w1x1+w2x2+...+wnxn这样的一个函数。其中(w1,w2,...wn)(w1,w2,...wn)是模型的系数向量w0w0是截距(x1,x2,...,xn)(x1,x2,...,xn)是样本数据(n是样本数据的维度简单来说,线性回归模型的训练就是通过样本数据来确定系数向量(w1,w2,...wn)
R语言读入表格数据进行多元回归分析
多元线性回归的预测案例,三个自变量同时适用于多个自变量的预测,详细的划分了具体的实现过程。
本文总结了《Python数学建模》中多元线性回归和Logistic回归的核心内容。多元线性回归通过最小二乘法估计参数,用F检验和t检验评估变量显著性,并需注意线性假设、多重共线性和误差项要求。通过水泥热量与化学成分关系的案例,演示了模型构建与评估过程。Logistic回归则用于分类问题,通过最大似然估计求解参数,以家庭收入与购房决策为例展示了模型应用。两种方法都强调了统计检验的重要性,并提供了Py
用到的数据:汽车销售数据:https://pan.baidu.com/s/1VlTy4nfvgXdDzgimVguZMg1 分析数据1.1 导包,读取数据import pandas as pdimport numpy as npfrom sklearn.linear_model import LinearRegressionfrom sklearn.model_selection ...
无监督学习是一类强大的算法,能够在没有标签的数据集中发现结构与模式。聚类作为无监督学习的重要组成部分,在各类数据分析任务中广泛应用。本文将深入讲解聚类算法中的两种常见方法:K均值聚类和层次聚类,结合Python代码详细介绍它们的实现与应用,帮助理解不同聚类方法的优劣与使用场景。
几天不见,甚是想念!小Mi系列的活动正在如火如荼地进行中,小Mi看到大伙儿的热情,动力更加十足,这不又迫不及待地更新来了!在上期的多变量线性回归介绍中,我们学习了多维特征、多变量的梯度下降法以及在实现梯度下降过程中的特征缩放和如何选择学习率这两个技巧,今天小Mi在其基础上,继续带领大家学习多项式回归、正规方程法以及介绍正规方程的不可逆性。好啦,废话不多说啦,我们继续开始吧!5特征和多项式回归依旧是
代码:导入库:import kerasimport numpy as npimport matplotlib.pyplot as pltfrom keras.models import Sequential # 按顺序构成的模型from keras.layers import Dense # 全连接层生成随机数# 使用Numpy生成随机点x_data = np.ran...
然后你按照自己的判断又迈出一步,重复上面的步骤,从这个新的点,你环顾四周,并决定从什么方向将会最快下山,然后又迈进了一小步,并依此类推,直到你接近局部最低点的位置。对于这个问题,求导的目的,基本上可以说取这个红点的切线,就是这样一条红色的直线,刚好与函数相切于这一点,让我们看看这条红色直线的斜率,就是这条刚好与函数曲线相切的这条直线,这条直线的斜率正好是这个三角形的高度除以这个水平长度,现在,这条
回归分析:根据数据,确定两种或两种以上变量间相互依赖的定量关系。
其中,b是回归系数,X是自变量矩阵,y是因变量向量,X'是X的转置矩阵,(X'X)-1是X'X的逆矩阵。通过最小二乘法求解回归系数,就可以得到一条最优的直线,使得预测值与实际值之间的误差平方和最小。线性回归算法是机器学习领域中最基础的算法之一,它可以用于解决各种问题,如房价预测、销售预测等。它是一种用于预测连续值的监督学习算法,可以用于解决各种问题,如房价预测、销售预测等。其中,y是因变量,x1、
范数的计算方法与欧几里得距离的计算方法相同。范数时,通常会省略指数2,直接写作。范数表示的是欧几里得范数(也称为。在数学中,通常认为当。
吴恩达机器学习笔记,本节涵盖多元线性回归,矢量化、特征缩放、特征工程、多项式回归和常用 ml 框架 Scikit-Learn。
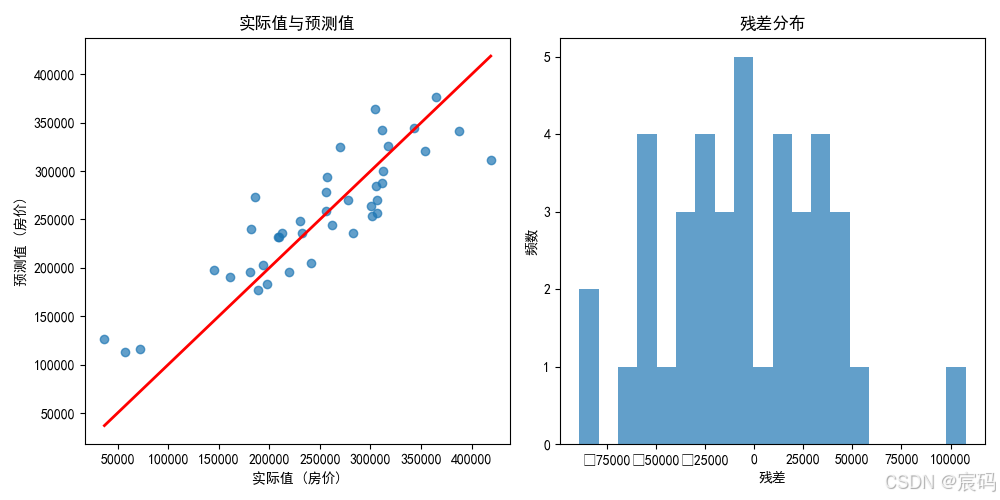
线性回归是机器学习和统计学中最经典且实用的算法之一,以其易于理解的理论和广泛的应用而被广泛接受。从19世纪最小二乘法的提出,到现代大数据和人工智能场景下的优化应用,线性回归的历程充满了创新与实践。本篇文章将带你全面剖析线性回归的基本概念、数学原理及实际应用案例,帮助读者深入理解其优势和局限性。同时,通过一个完整的房价预测案例,手把手指导如何将理论转化为实践。最后,我们展望线性回归在处理复杂数据、与
目录一、线性回归的原理二、线性回归的损失和优化原理三、 实例——波士顿房价预测四、拓展-关于优化方法GD、SGD、SAG五、 总结一、线性回归的原理1.1 线性回归使用场景房价预测销售额度预测金融:贷款额度预测、利用线性回归以及系数分析因子1.2什么是线性回归线性回归(Linear regression)是利用回归方程(函数)对一个或多个自变量(特征值)和因变量(目标值)之间关系进行建模的一种分析
上一章——监督学习与无监督学习回到上一章的第一个例子,依旧是卖房子所有的数据点都拥有Price和Size两个属性/特征,我们根据它的属性制作了一个数据表我们将上面这些数据的集合称之为数据集,而若用它来进行机器学习训练便称其为训练集而机器学习的目的就是通过给出的训练集来学习如何预测房价其中m代表训练集的数据量x代表训练集的输入的特征y代表训练集的输出的目标变量用(x(i),y(i))x^{(i)},