登录社区云,与社区用户共同成长
邀请您加入社区
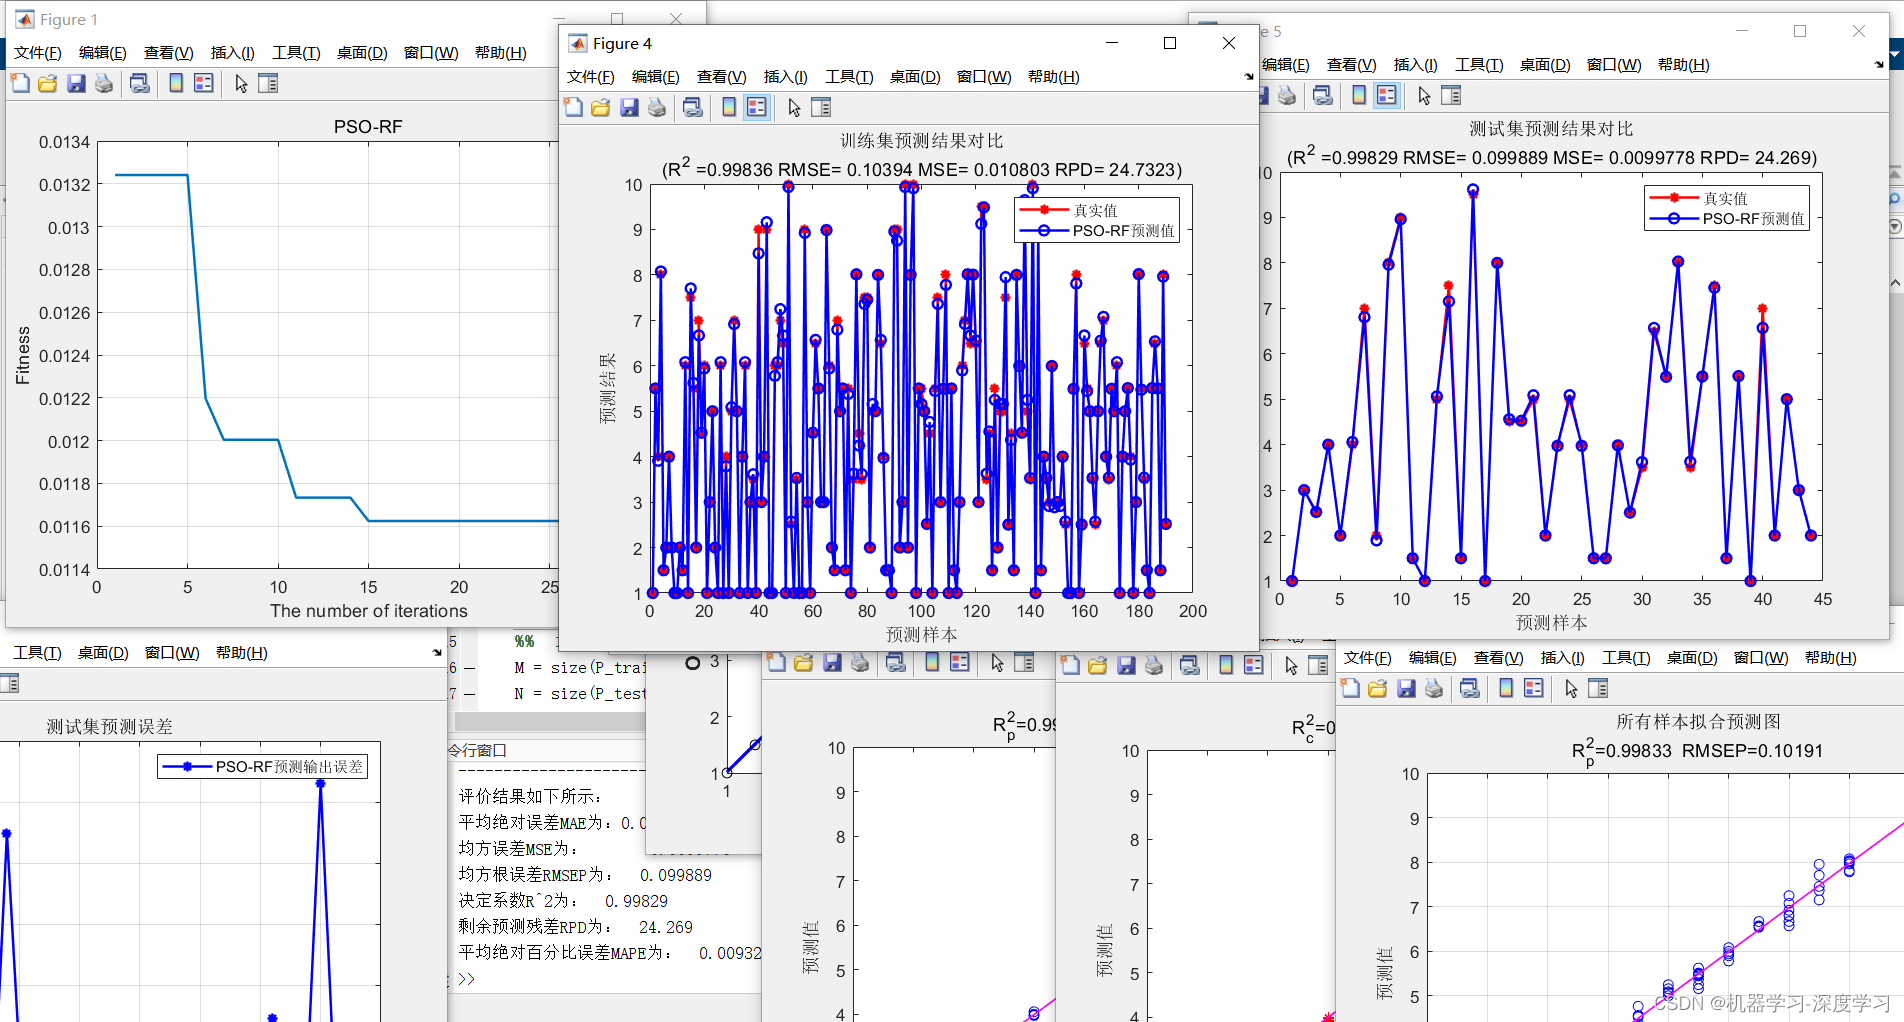
粒子群算法(PSO)优化随机森林的数据回归预测,PSO-RF回归预测,多变量输入模型。评价指标包括:R2、MAE、MSE、RMSE和MAPE等,代码质量极高,方便学习和替换数据。
最近准备了16大块的内容,124个算法问题的总结,完整的机器学习小册,免费领取~
综合分析结果显示,基于回归模型的中国黄金价格预测研究取得了一定的成果,提供了可靠的预测模型和分析方法,为投资者和研究人员提供了重要参考和决策依据。综合而言,未来的研究将不断探索创新,提升模型的预测能力和应用效果,为黄金市场的预测和分析领域带来更多新的突破与进展。开盘价收盘价最高最低价格的变化是一样的,都是集中200-450这个范围区间,其中有两个波峰,分别是200-300之间和300-400之间,
Python语言实现随机森林 (Random Forest)算法随机森林(Random Forest)是一种集成学习方法,通常用于分类和回归任务。它通过构建多个决策树并结合它们的预测结果来提高模型的准确性和鲁棒性。下面是一个使用Python的库实现随机森林算法的简单示例。
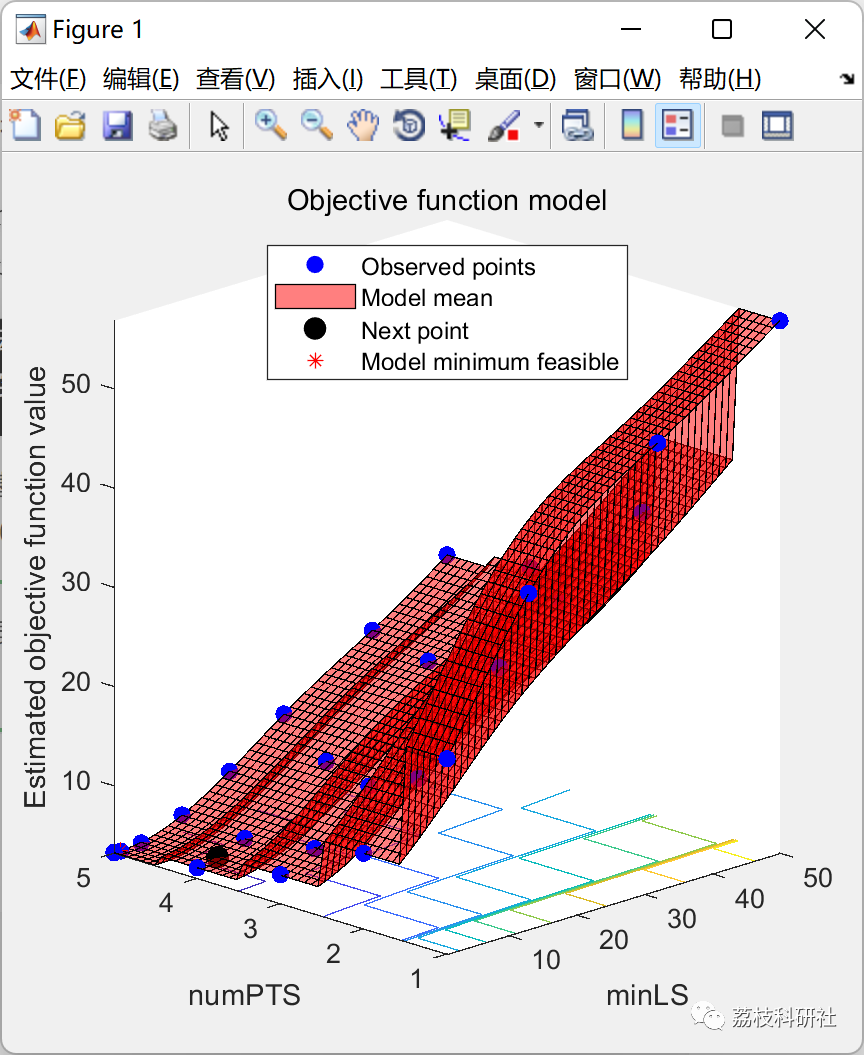
基于麻雀算法改进的随机森林分类算法文章目录基于麻雀算法改进的随机森林分类算法1.数据集2.RF模型3.基于麻雀算法优化的RF4.测试结果5.Matlab代码摘要:为了提高随机森林数据的分类预测准确率,对随机森林中的树木个数和最小叶子点数参数利用麻雀搜索算法进行优化。1.数据集数据的来源是 UCI 数据库中的肿瘤数据。数据信息如下:data.mat 的大小为569*32。其中第2列为标签数据,包含两
随机森林(RandomForest)一、随机森林(RandomForest)基本原理二、Out-Of-Bag Estimate 袋外数据估计泛化误差三、随机森林如何评估特征重要性。四、随机森林如何处理缺失值五、其它常见问题5.1、为什么Bagging算法的效果比单个评估器更好?5.2、为什么Bagging可以降低方差?5.3、Bagging有效的基本条件有哪些?Bagging的效果总是强于弱评估器
演示如何通过Matlab自带的随机森林函数进行特征选择,筛选出大量特征数据中对于回归预测最重要的特征,并对各特征进行重要性排序,充分反应不同特征的重要性。演示如何在种植随机树林时为数据集选择适当的拆分预测变量选择技术。随机森林特征筛选一种特征选择技术,特征选择( Feature Selection )也称特征子集选择( Feature Subset Selection , FSS ),或属性选择(
全文链接:https://tecdat.cn/?p=33632机器学习模型的表现不佳通常是由于过度拟合或欠拟合引起的,我们将重点关注客户经常遇到的过拟合情况(点击文末“阅读原文”获取完整代码数据)。相关视频过度拟合是指学习的假设在训练数据上拟合得非常好,以至于对新数据的模型性能造成负面影响。该模型对于训练数据中没有的新实例的泛化能力较差。复杂模型,如随机森林、神经网络和XGBoost,更容易出现过
本文研究了随机森林(Random Forest, RF)及其与多目标粒子群优化(Multi-Objective Particle Swarm Optimization, MOPSO)相结合的方法(RF_MOPSO),用于多特征过程的最佳参数优化。本文提出了一种混合方法(RF_MOPSO),通过MOPSO优化RF的超参数,以提高模型在多特征过程中的预测性能。本文提出的RF_MOPSO方法结合了RF的
可以看到,使用两个特征进行预测的准确度为85.2077,与使用所有特征进行预测的准确度相差不大,这表明随机森林特征选择方法有效的选择出了最重要的特征,实现了从大量特征到少数重要特征的特征降维筛选,极大的降低了特征的冗余性。当随机森林评价完成特征的重要性后,还需要对各个特征变量之间的相关性进行评估,以更加明显的看出何种特征最能影响预测结果,使用皮尔逊系数作为各个特征变量之间的相关性评价指标,从下图可
目录目录摘要:1.随机森林:2.随机森林的特征选取:3.基于Matlab自带的随机森林函数进行特征选取具体步骤(1)加载数据(2)首先建立随机森林并使用全部特征进行车辆经济性预测(3)使用随机森林进行特征选择(4)评价各个特征之间的相关性(5)使用筛选后的特征进行测试4 Matlab相关代码摘要:演示如何通过Matlab自带的随机森林函数进行特征选择,筛选出大量特征数据中对于回归预测最重要的特征,
聚类分析不仅是数据科学工具箱中的一把利器,更是我们探索数据内在规律、发现未知世界的钥匙。通过不断学习和实践,我们能够更好地掌握聚类分析的技术精髓,为数据驱动的决策和创新提供强有力的支持。在这个数据爆炸的时代,让我们携手并进,共同开启聚类分析的奇妙之旅吧!
用户可以通过系统界面输入不同的特征组合,系统将根据这些特征进行预测,并将预测结果可视化展示给用户。首先,该系统使用Flask框架搭建了一个用户友好的网页界面,用户可以通过该界面进行交互。该系统旨在帮助用户更好地了解租房市场,并通过预测算法提供有关租房价格的准确预测。总之,基于Python Flask的租房数据可视化系统利用随机森林预测算法,为用户提供了一个方便、准确的租房价格预测工具,帮助用户更好
然后,我们找到了包含缺失值的列,并将数据拆分成有缺失值和没有缺失值的两部分。接着,我们使用TreeBagger类构建了一个随机森林模型,并使用X_complete和Y_complete训练了模型。最后,我们使用predict方法预测了缺失值,并将预测结果合并回原始数据矩阵中。需要注意的是,在使用随机森林预测缺失值时,可能需要使用其他技术来处理数据。例如,如果特征矩阵中包含分类变量,则需要使用Tre
python,matlab相关学习资料:https://edu.51cto.com/video/3832.htmlhttps://edu.51cto.com/video/4102.htmlhttps://edu.51cto.com/video/4645.htmlMATLAB TreeBagger 与 Python 随...
本文提出了一种基于随机森林(RF)的等级评价方法,该方法利用了RF强大的分类能力和鲁棒性,并结合了多种评价指标,对目标对象的等级进行综合评估。该方法具有准确性高、鲁棒性强、可解释性好的特点,可广泛应用于各种等级评价场景。
在机器学习和统计学中,特征工程下的特征选择也被称为变量选择、属性选择或变量子集选择。它是指为了构建模型而选择相关特征(即属性、指标)子集的过程。使用特征选择技术有三个原因:简化模型,使之更易于被用户理解缩短训练时间改善通用性、降低过拟合(即降低方差)要使用特征选择技术的关键假设是:训练数据包含许多冗余或无关的特征,因而移除这些特征并不会导致丢失信息。冗余或无关特征是两个不同的概念。如果一个特征本
基于粒子群优化随机森林(PSO-RF)的数据回归预测。
随机森林是一种强大的机器学习算法,它可以用于解决各种分类和回归问题。在工程领域,特别是在故障诊断和分类方面,随机森林算法也被广泛应用。本文将重点介绍如何利用随机森林算法实现故障分类。故障分类是工程领域中非常重要的一个任务,它可以帮助工程师们快速准确地识别设备或系统中的故障,从而采取相应的维修措施。传统的故障分类方法通常基于专家经验或规则,但这些方法往往无法处理大规模的数据和复杂的故障模式。相比之下
随机森林回归算法X = S2(1:22,:); %S2为数据集T = S2(23:end,:);%nTree = round(sqrt(size(X,2)-1));nTree = 50;train_data = X(:,1:end-1);train_label = X(:,end); test_data = T(:,1:end-1);Factor = TreeBagger(nT...
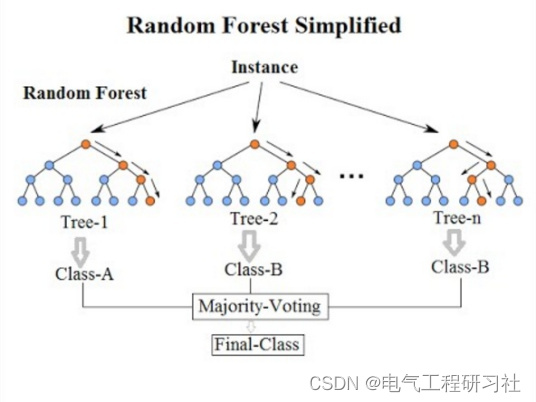
随机森林的基本原理是构建多棵决策树,每棵树都是基于原始训练数据的一个随机子集进行训练。在构建每棵树时,算法会随机选择一部分特征进行考虑,而不是考虑所有的特征。然后,对于一个新的输入样本,每棵树都会进行分类预测,并将预测结果提交给“森林”进行最终的分类决策。一般来说,森林会选择出现次数最多的类别作为最终的分类结果。理论上来看,随机森林分类应该比决策树分类有更加好的准确度,特别是在高维度的数据情况下。
随机森林是一种集成学习算法,通过构建多棵决策树并结合它们的预测结果来提高模型准确性和稳定性。其核心机制包括Bootstrap抽样(样本随机性)和特征随机选择(特征随机性),有效降低过拟合风险。随机森林具有泛化能力强、适用性广、抗噪声等优点,广泛应用于金融、医疗、电商等领域。本文以鸢尾花分类为例,展示了使用Scikit-learn实现随机森林的完整流程,包括数据准备、模型训练、评估和特征重要性分析,
随机森林(Random Forest)是一种算法,由多个决策树(Decision Tree)集成而成。它通过** bootstrap 抽样特征随机选择**两种随机性机制,综合多棵决策树的预测结果,最终输出更稳定、更准确的预测结论。其核心思想是“”——单棵决策树容易过拟合(对训练数据拟合过好,泛化能力差),而多棵决策树通过合理组合可以降低方差、提升模型的泛化能力。
python招聘数据分析可视化系统 django框架 Vue框架 scrapy爬虫 大数据计算机毕业设计✅
本文介绍了使用Scikit-learn实现随机森林的方法。主要内容包括:随机森林概念(由多棵决策树组成,通过投票或平均进行预测);分类和回归的应用示例(分别使用鸢尾花和房价数据集);关键参数说明(如n_estimators、max_depth等);以及随机森林的优势(无需特征归一化、抗过拟合能力强等)。文章提供了完整的代码示例,展示了从数据准备到模型评估的完整流程,适合机器学习初学者快速上手使用随
在机器学习领域,随机森林(Random Forest, RF)和梯度提升树(Gradient Boosting Machine, GBM)是两种非常流行的集成学习方法。其中,XGBoost 是 GBM 的一个高效实现,因其卓越的性能而备受青睐。然而,在大数据场景下,随机森林的表现往往不如 XGBoost。本文将从理论角度深入探讨这一现象,揭示两者在大数据上的性能差异。
本文介绍了矿物数据清洗的完整流程与方法。数据清洗通过完整性、全面性、合法性、唯一性检查确保数据质量。针对矿物数据,采用10个步骤进行处理:数据读取筛选、缺失值检查、特征标签分离、标签编码、类型转换、Z标准化、数据集切分、数据填充(提供删除空值、均值/中位数/众数填充、线性回归和随机森林6种方法)、过采样(SMOTE算法)和数据保存。重点阐述了不同填充方法的实现细节,包括按类别计算统计量、基于机器学
没有pycharm的,在站内搜索安装教程即可。
它提供强大的QoS功能,包括流量策略、流量计和灵活的队列调度(WRR/WFQ/SP)。它们具有高抗噪性和强大的性能。对于服务质量应用,IP1811LR支持基于端口、基于 802.1Q 标记、基于 ACL、基于 IP TOS、基于 SMAC、基于 IP 地址、基于 IGMP 和基于 WAN/LAN 来决定输出帧的优先级。对于服务质量应用,IP1819支持基于端口、基于802.1Q标签、基于ACL、基
故障诊断是工业生产中至关重要的环节,可以有效避免设备故障带来的安全隐患和经济损失。本文提出了一种基于随机森林(RF)和Adaboost算法相结合的故障诊断方法,充分利用了RF算法的非线性拟合能力和Adaboost算法的弱分类器集成思想,提高了故障诊断的准确性和鲁棒性。1. 随机森林算法随机森林算法是一种集成学习算法,通过构建多个决策树并对其进行集成,得到最终的分类结果。其主要思想是:从训练集中有放
随着我国城市化进程的加快,城市交通拥堵问题日益严重,因此,构建一个高效、实时的城市交通流量分析及可视化系统设计与实现具有重要的现实意义。基于此,本文以Django为框架,设计并实现了一套城市交通流量分析及可视化系统设计与实现。本文的主要内容包括:首先,对城市交通流量数据进行预处理,包括数据清洗、数据整合和特征工程;其次,采用机器学习算法构建城市交通流量分析模型,并通过模型评估指标对模型进行优化;最
项目名称:基于联邦学习的入侵检测系统目标:通过联邦学习对NSL-KDD数据集进行训练,检测网络入侵。技术栈编程语言联邦学习框架:PySyft(基于PyTorch)深度学习框架:PyTorch数据集:NSL-KDD模型:神经网络模型(MLP)这是一种使用联邦学习来训练入侵检测模型的方法。通过使用NSL-KDD数据集训练模型,模拟多个客户端的训练过程,并将各自的模型更新通过联邦平均进行聚合。
cross_val_score交叉验证不用自己分测试集和训练集,交叉验证输入的是完整的特征矩阵和完整的标签,cv是交叉验证的次数。#交叉验证:一个结果会对模型造成影响,希望在探究在不同的测试集和训练集来看模型的稳定性。
随机森林算法详解,随机森林(Random Forest)是一种集成学习算法
本研究基于多元线性回归、随机森林和神经网络构建了农作物元素含量预测模型,并采用SHAP方法进行特征重要性分析。首先对土壤-作物元素数据进行探索性分析,包括缺失值检查、相关性分析和数据标准化处理。随后分别建立三种预测模型,其中随机森林和神经网络表现优于多元线性回归。最后通过SHAP值解释模型,揭示了不同土壤元素对农作物元素含量的影响程度和方向。研究为理解土壤-作物元素迁移规律提供了数据支持和科学依据
随机森林
该类用于实现随机森林分类器。__init__方法是类的构造函数,用于初始化随机森林的参数,包括决策树的数量、最大深度、子空间维度和随机种子。是一个空列表,用于存储随机森林中的每棵决策树。fit方法用于训练随机森林模型。对于每棵决策树:调用sample函数对数据进行自助采样,得到训练样本X_sample和对应的标签y_sample。使用随机选择个特征,得到特征子空间的索引。从采样数据中提取特征子空间
斯科特·哈茨霍恩的《使用随机森林和决策树的机器学习》为机器学习初学者提供了一个理解随机森林和决策树的直观视角。本书不仅解释了这些算法是如何工作的,还提供了Python代码示例,帮助读者深入理解并应用于实际问题。作者强调了概念层面的理解和代码实践的平衡,旨在帮助读者构建起机器学习的知识体系。
随着大数据时代的到来,数据分类算法的研究和应用变得越来越重要。在众多的分类算法中,随机森林(Random Forest,简称RF)因其在处理大规模数据集和高维特征上的优势而备受关注。然而,传统的随机森林算法在构建决策树和选择特征子集时存在一定的不足之处。为了克服这些问题,研究者们提出了许多改进的方法,其中一种是基于粒子群优化(Particle Swarm Optimization,简称PSO)的随
本文主要带领大家学习数据分析。首先,完成数据的缺失值处理,数值指标正态化,异常值处理。使用皮尔逊相关分析完成特征的初步提取,再使用随机森林对筛选的指标进行特征提取,即过滤法结合封装法。最后将指标2:8切分过采样的方式划分数据集。训练集训练模型,完成预测集预测。
天辛大师团队研发的"命理算法大模型"融合传统命理与现代科技,提出四大核心原则:1)以"天人合一"为哲学基础,结合大数据分析;2)采用"阴阳平衡"的动态演化系统;3)实现"象数结合"的感性理性平衡;4)秉持"以人为本"的伦理导向。该创新尝试既传承传统文化精髓,又赋予其现代科学实证基础,旨在为个体提供积
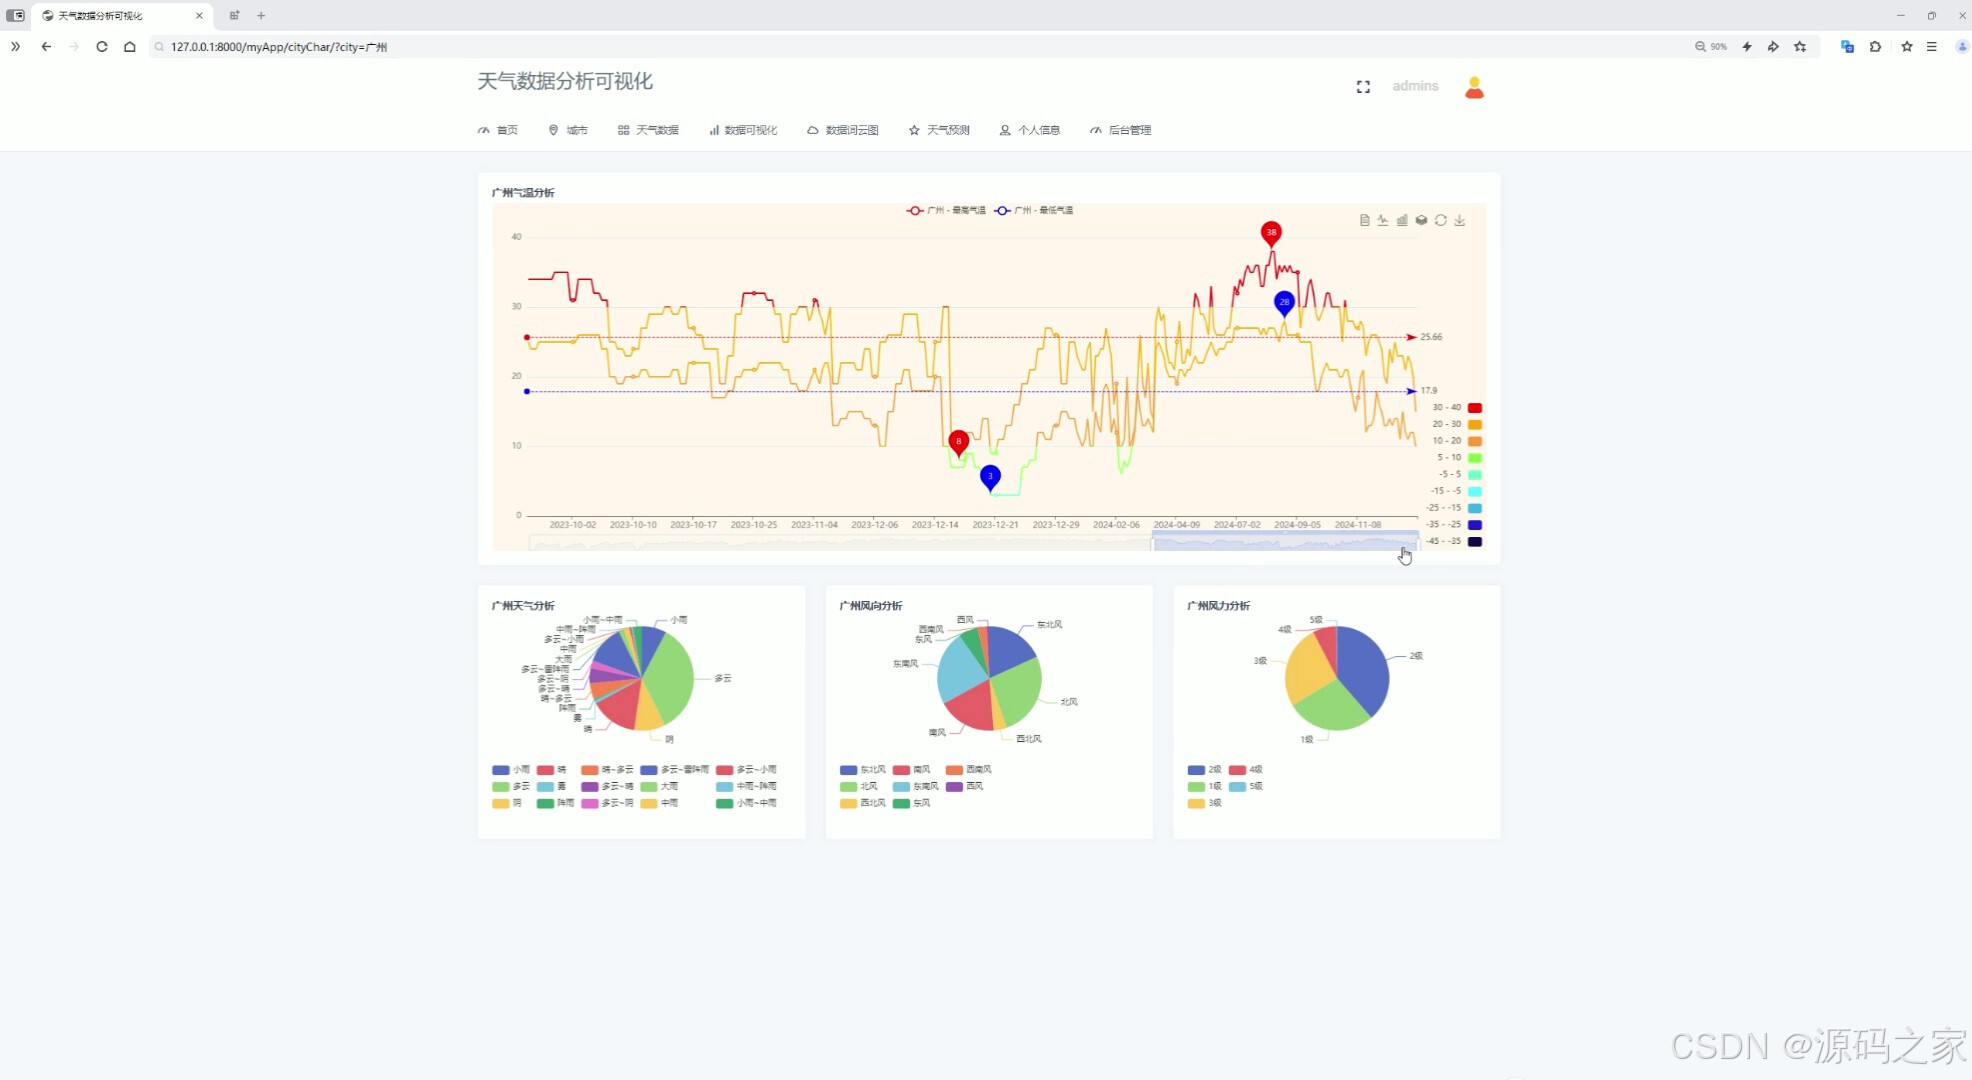
基于python天气分析预测系统 机器学习 气象数据 随机森林预测算法 爬虫 中国天气网 Django框架 数据分析 可视化大屏 毕业设计(源码+文档)✅