登录社区云,与社区用户共同成长
邀请您加入社区
千锋逆战班,Rayson.Jin学习打卡第三天!今天给大家介绍一下前后端交互 B/S。1.前后端认知前端:1.把后端给的数据渲染再页面你上2.把用户输入的数据传递给后端存储起来后端:1.接受前端的数据存储到数据库2.把数据库里面的数据拿出来传递给前端数据库:专门让 后端 进行数据的增删改查2.了解服务器什么是服务器?一台网络那一头的电脑运行了一个特殊的环境启动了...
java.lang.UnsupportedOperationException: class org.apache.calcite.sql.SqlIdentifier: json原因 表字段类型是 json , flink 不支持;改为 string解决转载出处:https://www.saoniuhuo.com/question/detail-1911817.html?sort=hot
模板项目后端总结(mysql,node)
需要描述:抽凭的抽凭证制单人和审核人的逻辑没有通过子模块的弹性域传递到凭证上的弹性域上,需要穿透到子模块去获取,并且每个子模块的的抽取逻辑还不一样,目前凭证行规模和子分类账规模都是几千万级别,多个表联查效率有点低下,因为改写SQL代价太高,奔着尽量不改动业务逻辑代码的前提下,从代码架构改造和参数配置上来进行优化。尝试方法:先后尝试了如下方法SQL TUNING利用Oracle内置的SQL 执行计划
大坑就是order()排序,gorm使用order时,不会进行预编译,首先明确一个问题,什么时候会存在SQL注入?当CRUD操作直接拼接了用户输入*,并且未做有效过滤/防护时,就会存在注入。
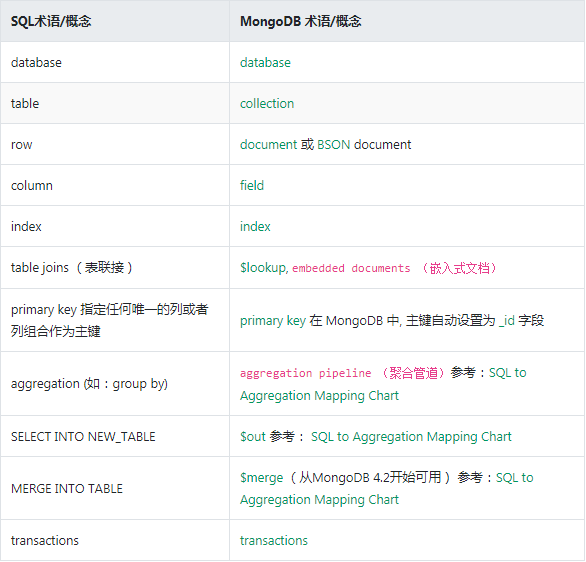
前言很多开发者首次接触数据库(通常是在高校课堂)的概念,或者说接触第一个数据库,通常是 SQL 数据库,而现在,NoSQL 数据库后来居上,很多原 SQL 数据的使用者难免有转向 NoSQL 的需求。而作为 NoSQL 数据库的代表,MongoDB 在社区越来越流行,生产环境的使用也日益广泛。对于 SQL 转战 NoSQL的开发人员来说,最难的一步其实是将原有的 SQL 的概念和知识直接复用过..
在当今的信息化时代,运维类技能对于职场人士来说同样至关重要。运维工程师负责保障公司IT系统的稳定、高效运行,是企业不可或缺的重要角色。本文将详细介绍职场运维类技能的学习路径,包括从入门到精通的各个阶段。一、学习运维类技能的基础知识1、计算机基础知识:学习计算机的基本原理、硬件组成、操作系统等基础知识,为后续学习打下基础。2、网络知识:了解网络协议、网络安全、网络拓扑结构等方面的知识,有助于更好地理
go 自带的数据库操作
✅ 5分钟发布API:可视化配置参数、权限、缓存,自动生成OpenAPI文档✅ 团队协作革命:业务自助取数、接口统一管控,减少80%跨部门沟通✅ 安全与性能兼得:字段级脱敏、SQL防注入、单节点扛住300+ QPS✅ 国产化无缝迁移:支持达梦/人大金仓等数据库,企业级审计溯源
flinkSQL 建表设置水位线时间格式转换 & flinkSQl滚动窗口
sqlserver查看表架构修改历史记录
将多条SQL语句打包成批次一次性提交给数据库执行。
OQL是Object Query Language的简写,即对象查询语言,OQL语法和关系型标准查询语言SQL的语法相似,只是增加了比如对象标识、复杂对象、操作、继承、多态性以及联系。SELECT1.SELECT * FROM java.lang.String2.SELECT toString(s), s.count, s.value FROM java.lang.String s (@为属性访问
摘要: ChatBI(对话式商业智能)通过自然语言交互简化数据分析,但面临数据准确性、多指标查询和自动化不足等挑战。基于MCP(模型上下文协议)架构的ChatBI解决方案,通过NL2Tools代替NL2SQL提升准确性,利用任务规划实现多指标链式调用,并通过模型推理动态生成分析链路。实战案例显示,该方案将电商数据分析耗时从2小时缩短至5分钟,且数据可靠。未来,ChatBI将向多模态、联邦学习和低代
MySQL查询性能优化指南摘要 本文详细介绍了MySQL查询性能优化的关键技术,包含三大核心内容: 执行计划分析(EXPLAIN) 详解EXPLAIN输出的12个关键字段,重点解析type连接类型和Extra附加信息 提供真实SQL示例展示从const(最优)到ALL(最差)的性能差异 结合案例分析如何通过索引优化避免全表扫描 慢查询日志配置 演示如何启用慢查询日志并设置阈值 说明如何记录未使用索
本博客为使用python连接mysql数据库,对其主要方法进行解析pymysql主要使用cursor对数据库进行交互操作和结果处理,所以cursor对象为重中之重0、一个简单的数据库交互案例环境安装:pymysqlpip3 install pymysql本博客测试数据库结构:create table TEST_TABLE(ID int auto_incrementprimary key,USER_
【代码】flink-sql写入hudi的行列转换lateral。
1、如果模型有DeletedAt字段,它将自动获得软删除功能! 那么在调用Delete时不会从数据库中永久删除,而是只将字段DeletedAt的值设置为当前时间db.Where("age = ?", 20).Delete(&User{})2、使用struct更新仅适用于非零值警告:当使用struct更新时,FORM将仅更新具有非空值的字段对于下面的更新,什么都不会更新为"",0,...
解决了Navicat运行Sql大文件的两个报错问题:[ERR] 2006 - MySQL server has gone away[ERR] 1118 - Row size too large (> 8126). Changing some columns to TEXT or BLOB or using ROW_FORMAT=
首先在 starrocks 上创建一个表,插入一些数据。在 flink 上创建表。
1. 选择<select id="getStaffName" parameterType="String" resultType="com.wlhse.entity.SuperVisionGroupMemberPojo">select * from supervisiongroupmember where SupervisionGroupCode=#{uid};</select&
onstat 运维常见统计命令
ORACLE-SQL性能优化-排序取第一条数据
SQL基础查询、多表连接
目前flink的sql客户端提供了一种交互式的sql查询服务,用户可以使用sql客户端执行一些sql的批任务或者流任务。但是当我想执行一些sql的定时任务时,flink却没有提供一个合适的方式,所以综合考虑了一下,我决定在sql的客户端基础上给加一个 ‘-filename (-f)’ 参数,就像类似’hive -f abc.sql’ 一样,可以执行一批sql任务。
在数据库中对字段设置了唯一索引后,实施添加功能时属性重复就会抛出这个异常java.sql.SQLIntegrityConstraintViolationException: Duplicate entry在有了全局异常处理的情况下,我又想单独捕获这个异常并返回自己设置的信息,于是就干他,代码如下@ExceptionHandler(SQLIntegrityConstraintViolationExc
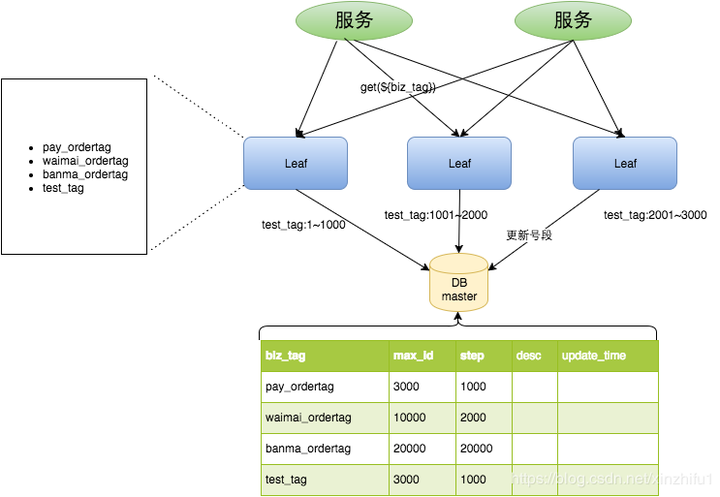
LOADING_PERCENT的值就是20),即设定loadingId为20%的阈值,例如当前id是10000,步长为10000,那么loadingId=12000。Leaf的snowflake模式依赖于ZooKeeper,不同于原始snowflake算法也主要是在workId的生成上,Leaf中workId是基于ZooKeeper的顺序Id来生成的,每个应用在使用Leaf-snowflake时,
大型金融机构通常有相当多的数据监控和分析系统,运维大数据日增量超过1TB,总数据超过100TB。 AIOps平台,集中管理中台架构的运维数据,实时分析。 由于定位,将异常发现和故障控制在几分钟内。 区域银行解决方案。 区域性银行多为本地金融服务,业务系统数量众多,IT运维数据日增数百GB级,很多已部署第三方监控,但数据封闭孤立。 AIOps提供了极其丰富的接口,接入第三方数据。同时,日志
未来,随着技术的不断进步,智慧餐饮系统将会迎来更多的挑战和机遇,我们有信心通过不断优化和创新,打造更加优秀的智慧餐饮系统体验。合理的后端服务实现可以确保系统的稳定性和安全性,同时支持系统对大数据的高效处理和分析。在前端界面的实现中,需要考虑到不同设备和操作系统的兼容性,以及用户数据的安全传输和存储。另外,智慧餐饮系统还需要考虑到第三方服务的集成,比如支付系统、配送系统、评价系统等。在实际实现智慧餐
解决办法:1、创建数据库create database mytest;2.连接数据库,报以下错:原因:创建完数据库后,需要进行授权,在本地访问一般不会存在这个问题。3.授权数据库操作其中:xxx代表创建的数据库; password为用户密码,在此为root的密码,root为账户名。...
nio,没什么好说的,值得注意的是"直接内存"的特点,使用场景;java多线程同步异步;架构师还要针对业务特点、系统的性能要求提出能解决问题成本最低的设计方案才合格,人家一个几百人用户的系统,访问量不大,数据量小,你给人家上集群、上分布式存储、上高端服务器,为了架构而架构,这是最扯淡的,架构师的作用就是第一满足业务需求,第二最低的硬件网络成本和技术维护成本。数据库的设计能力,mysql必备,最基础
ctf.show的SQL注入(web171-web253)
分布式事务配置方式及需使用DTCPing.exe进行验证1、打开服务器“组件服务”2、在组件服务器中找到本地DTC,点击右键属性,在安全选项卡中将配置修改为下图中的配置3、打开控制面板\所有控制面板项\Windows Defender 防火墙,点击下图中红色选中的菜单找到“分布式事务处理协调器”将专用,公用全部打勾。4、以上设置完成后如果还是不成功,需使用DTCPing.exe进行测试,在web端
OceanBase采用了一种被称为"单机分布式一体化架构"的设计。这种架构兼顾了分布式架构的扩展性与集中式架构的性能优势。它使用一套引擎同时支持OLTP(联机事务处理)和OLAP(联机分析处理)的混合负载
1、原生SQL用法概述django可以执行原生SQL语句,主要分读和写两类,用法如下:读(查):xxxModel.object.raw()写(增删改):connection.cursor()2、应用案例2.1 django执行原生SQL 读 操作django内置方法中的raw(),可以帮助我们直接执行SQL的原生语句,返回QuerySet 集合对象。# appName: test# tableNa
书接上回,解决了选择性的忽略某些字段这个问题,新的问题出现,想要使用gorm完成动态sql,我只知道mybatis中使用标签可以完成动态sql,不会使用gorm完成动态sql,下面通过一个需求学习一下gorm的动态sql。
随着 Navicat 17 的盛大发布,其一系列创新特性赢得了广大用户的热烈反响。它不仅在,还大幅优化了,同时,并引入了,这标志着Navicat的全面进化。近期,我们后台接到一些用户的咨询,核心聚焦于哪些新功能可以完美适配并增强非关系型数据库MongoDB的使用体验。今日,就让我们深入探索 Navicat 17 针对MongoDB 精心打造的核心亮点,以满足您对数据管理与操作的高效需求。Navic
sqlserver运维宝典
前言很多开发者首次接触数据库(通常是在高校课堂)的概念,或者说接触第一个数据库,通常是 SQL 数据库,而现在,NoSQL 数据库后来居上,很多原 SQL 数据的使用者难免有转向 NoSQL 的需求。而作为 NoSQL 数据库的代表,MongoDB 在社区越来越流行,生产环境的使用也日益广泛。对于 SQL 转战 NoSQL的开发人员来说,最难的一步其实是将原有的 SQL 的概念和知识直接复用过来,
try{if (this.textBoxTransparent2_3.Text == null || this.textBoxTransparent2_3.Text == ""){MessageBox.Show("MIS项目编号是必填项!"); this.textBoxTransparent2_3.Focus(); return;}else if (textBoxTransparent_path.
三种udf:(SQL里可解释的Function)ScalarFunctionTableFunctionAggregateFunction一、Scalar Functions 标量函数标量函数,是指返回一个值的函数。标量函数是实现将0,1,或者多个标量值转化为一个新值。标量函数的行为就是通过evaluation方法来实现的。evaluation方法必须定义为public,命名为eval。evalua
参考文档:https://nightlies.apache.org/flink/flink-docs-release-1.17/docs/dev/table/config/#table-local-time-zone。
supersqli 翻译一下为超级数据库打开题目很明显,直接想到sql注入验证一下猜想提交 1’ and 1=1#和1‘ and 1=2#(输入框中没有显示在url中)说明存在注入漏洞接下来用order by判断字段 提交1'order by 2#提交1'order by 3#说明只有两个字段爆出接下来尝试爆数据库名提交:1'union select 1,database()#返回错误信息retu
经过我的测试,是名字的问题,如图,出现这样的错误,
postgresql9.5版本才引入upsert,当前版本greenplum基于postgresql9.4.24(greenplum6.12.0)。
当zabbix监控的体量上去后,数据量就会非常大,在web页面上总是查询很慢、甚至查询失败时。又或者,当其他用户向你提出一些查询需求,特别是在web页面很难做到的个性化查询时,那么就要编写查询sql了。本篇不是sql教程,而是分享如何快速获得查询zabbix数据的sql语句,并在其基础上改造成适合你的sql。
CTFshow--web入门171-184的wp。
/** * 雪花算法模式 * @param key * @return */ @RequestMapping(value = "/api/snowflake/get/{key}") public String getSnowflakeId(@PathVariable("key") String key) { return get(key, snowflakeService.getId(key));
gorm例子func (r *repo) List(offset, pageSize int, filter *do.Filter) (total int, list []do.UserDo, err error) {rows := make([]models.User, 0)params := make([]interface{}, 0)condition := " u.state = ? an