登录社区云,与社区用户共同成长
邀请您加入社区
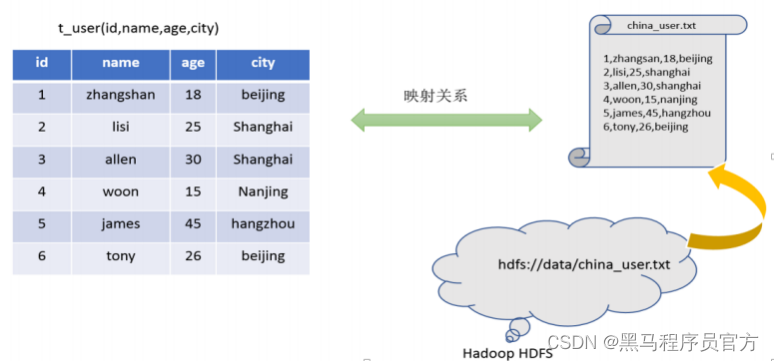
Apache Hive是一款建立在Hadoop之上的开源数据仓库系统,可以将存储在Hadoop文件中的结构化、半结构化数据文件映射为一张数据库表,基于表提供了一种类似SQL的查询模型,称为Hive查询语言(HQL),用于访问和分析存储在Hadoop文件中的大型数据集。Hive核心是将HQL转换为MapReduce程序,然后将程序提交到Hadoop群集执行。Hive由Facebook实现并开源。..
目录一、函数的分类二、Hive内置函数三、UDF开发流程四、hive事务五、hive的优化设计六、压缩算法一、函数的分类从输入输出角度分类标准函数:一行数据中的一列或多列为输入,结果为单一值聚合函数:多行的零列到多列为输入,结果为单一值表生成函数:零个或多个输入,结果为多列或多行从实现方式分类内置函数自定义函数UDF:自定义标准函数UDAF:自定义聚合函数UDTF:自定义表生成函数二、Hive内置
Hive不仅支持基本类型,还支持比较复杂的类型,同时配套了一些函数,灵活运用这些复杂类型的字段,可以更好的设计离线表更加详细内容可以见:...
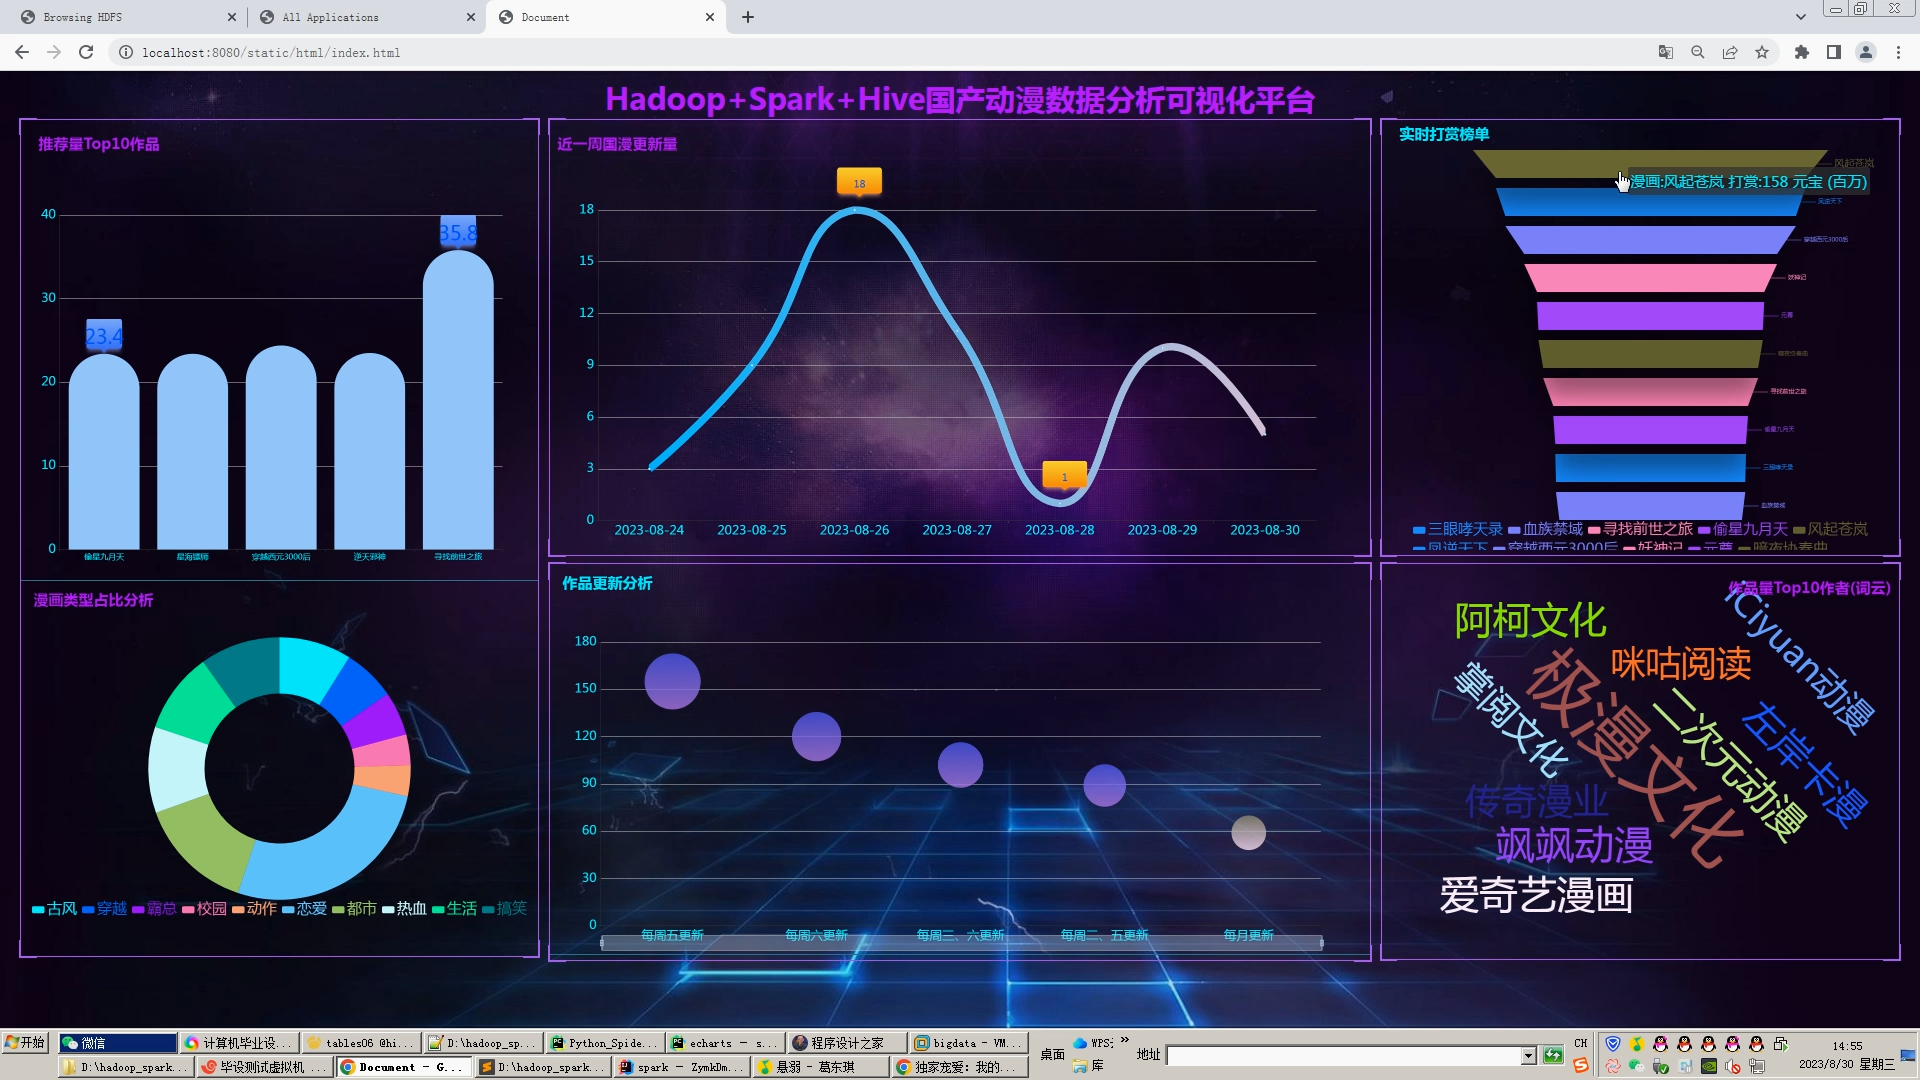
计算机毕业设计hadoop+spark+hive漫画推荐系统 动漫视频推荐系统 漫画分析可视化大屏 漫画爬虫 漫画推荐系统 漫画爬虫 知识图谱 大数据
protobuf代码解读复制代码// 语法 // 导包 // package // option // message、service // protoc.exe .\hello.proto --java_out=../src/main/java syntax = "proto3";基本使用:每次创建一个channel吞吐量2000左右顶破天一直使用同一个channel:吞吐量最高9000多,但是
Impala完全抛弃了MapReduce这个不太适合做SQL查询的范式,而是像Dremel一样借鉴了MPP并行数据库的思想另起炉灶,因此可做更多的查询优化,从而省掉不必要的shuffle、sort等开销。8.使用Impala,您可以访问存储在HDFS,HBase和Amazon s3中的数据,而无需了解Java(MapReduce作业)。7.由于在数据驻留(在Hadoop集群上)时执行数据处理,因此
Hive常用交互命令[dev1@hadoop102 hive]$ bin/hive -help》》1 "-e"不进入hive的交互窗口执行sql语句[dev1@hadoop102 hive]$ bin/hive -e "select id from default.student;"》》2 "-f"执行脚本中sql语句(1)在/opt/module/data目录下创建hivef.sql文件[dev
hive客户端无法进入(Cannot create directory /tmp/hive/root/a0ec1f00-cd32-41ef-814d-b6aa3d669d77. Name node is in safe mode.)欢迎使用Markdown编辑器你好! 这是你第一次使用 Markdown编辑器 所展示的欢迎页。如果你想学习如何使用Markdown编辑器, 可以仔细阅读这篇文章,了解
【转载原因:get_json_object与json_tuple的用法,作者讲解非常清楚】【转载原文:https://blog.csdn.net/weixin_37536446/article/details/80622220】在技术对app进行埋点时,会讲多个字段存放在一个数组中,因此模型调用数据时,要对埋点数据进行解析,以作进一步的清洗。本文将介绍解析json字符串的两个函数:get_json
hive处理json字符串以及json数组
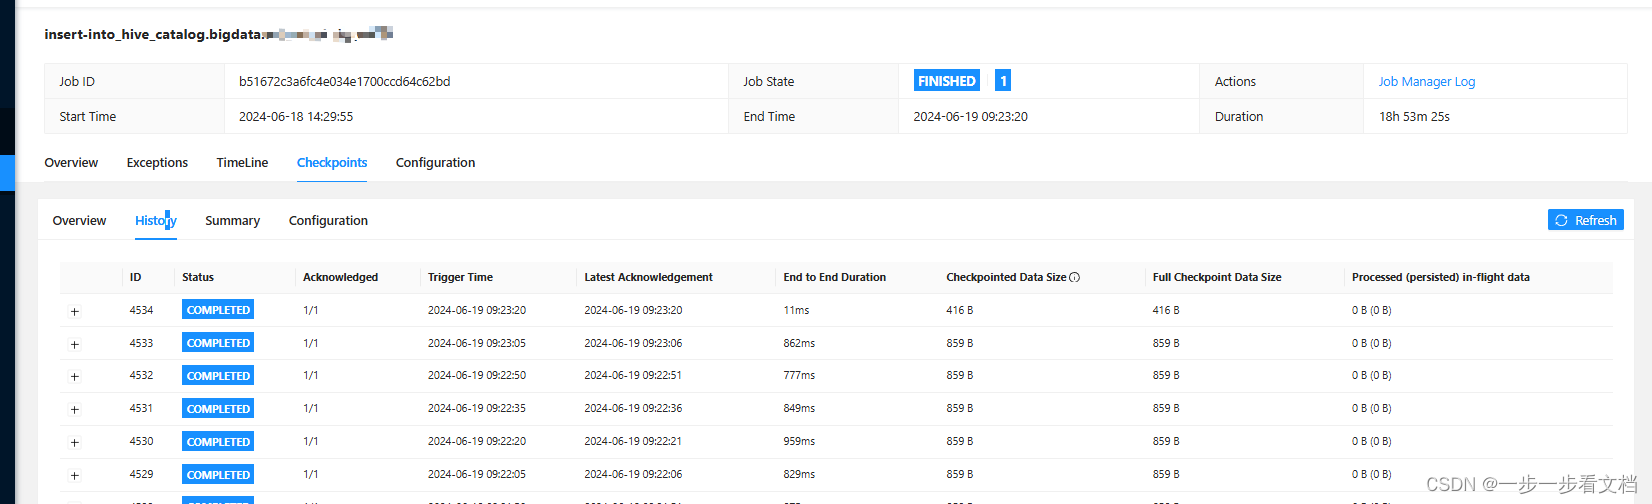
flinksql 通过jdbc 写入 hive_catalog 的表。发现问题
报错如下:FAILED: SemanticException org.apache.hadoop.hive.ql.metadata.HiveException: java.lang.RuntimeException: Unable to instantiate org.apache.hadoop.hive.ql.metadata.SessionHiveMetaStoreClient网上找了一圈..
解析json数组的函数通常有get_json_object()json_tuple()split()explode()regexp_replace()lateral viewget_json_object() 一次只能解析一个key,当需要解析多个字段时,不好用于是使用 json_tuple() 函数,结合lateral view() 使用一个解析json数组的思路:对于如下的字段,其中内容是[{
## Sql中json使用方法对于jsonArray(json数组),如person表的xjson字段有数据:```scala[{"name":"王二狗","sex":"男","age":"25"},{"name":"李狗嗨","sex":"男","age":"47"}]取出第一个json对象,那么hive sql为:SELECT get_json_object(xjson,"$.[0]") FR
hana分割函数,hana处理json函数,等相关hana技巧
[root@master ~]# cp /usr/bigdata/apache-hive-3.1.2-bin/conf/hive-site.xml /usr/bigdata/spark-3.0.0-bin-hadoop3.2/conf//usr/bigdata/spark-3.0.0-bin-hadoop3.2/conf[root@master conf]# cp spark-defaults.c
虽然逻辑上理解并不矛盾,尽管该UDTF返回的是个表,但一行输入只会对应一行输出,只是输出的字段可能是多个,并不像explode那样返回的是多行。和get_json_object不同的是,get_json_object是一个普通的UDF函数,返回的是一个值。,该函数适用于对传入的json对象一次性解析多个key的场景,如果用get_json_object需要解析多次,该函数只需要解析一次。(通配符个
Hive:写好UDF后,测试时报错:找不到或无法加载主类欢迎使用Markdown编辑器新的改变功能快捷键合理的创建标题,有助于目录的生成如何改变文本的样式插入链接与图片如何插入一段漂亮的代码片生成一个适合你的列表创建一个表格设定内容居中、居左、居右SmartyPants创建一个自定义列表如何创建一个注脚注释也是必不可少的KaTeX数学公式新的甘特图功能,丰富你的文章UML 图表FLowchart流
hadoop版本3.3.6 mysql版本8.0.20。
如果hive表中有扩展字段,那么扩展字段格式最常见的就是json格式,所以如何解析json字符串相对繁琐(虽然没啥技术????)用到的hive功能函数有:get_json_object、explode、split、regexp_replace、regexp_extract-- json字段样式:[{'a':1, 'b':2}, {'a':3, 'b':4}], 字段名称为json_strselec
1、概述1.1、简介Cloudera Manager(简称CM)是Cloudera公司开发的一款大数据集群安装部署利器,这款利器具有集群自动化安装、中心化管理、集群监控、报警等功能,使得安装集群从几天的时间缩短在几小时以内,运维人员从数十人降低到几人以内,极大的提高集群管理的效率。CDH (Cloudera’s Distribution, including Apache Hadoop),是Had
首先在Hive 中查看json_tuple 函数的详细信息desc function extended json_tuple;出现解释:json_tuple(jsonStr, p1, p2, …, pn) - like get_json_object, but it takes multiple names and return a tuple. All the input parameters
差不多就是如下 a join bjoin c join djoin e join f 一长串。说实话我也难搞,每次就是一长串sql让我找问题 让我优化,我看完sql理解下都要十几分钟。。。
hive/lib。
select *,explode(split(regexp_replace(regexp_extract(statement_inputs,'^\\[(.+)\\]$',1),'\\}\\,\\{', '\\}\\|\\|\\{'),'\\|\\|')) as statement_inputs_new
在hive的内置函数中,提供了两个函数用来解析json,分别是get_json_object和json_tuple以下出现的hive函数不懂的请到 hive2.0中常用的内置函数大全 这篇博客去查看了解首先来查看下get_json_object函数的详细信息> desc function extended get_json_object;OKtab_nameget_json_object(j
- Hive解析json的几种方法get_json_object(string json_string, string path)说明:第一个参数填写json对象变量,第二个参数使用$表示json变量标识,然后用 . 或 [] 读取对象或数组;如果输入的json字符串无效,那么返回NULL。每次只能返回一个数据项。举例:data 为 test表中的字段,数据结构如下:data ={"store":
本文按照 flink 1.13 官网中的读写 hive 内容翻译整理,内容十分全面。
hive中get_json_object是一个用来处理json数据的方法,非常好用!1)数据[{“name”:“大郎”,“sex”:“男”,“age”:“25”},{“name”:“西门庆”,“sex”:“男”,“age”:“47”}]2)取出第一个json对象hive (gmall)>select get_json_object(’[{“name”:“大郎”,“sex”:“男”,“age”
hive表生成函数explode、stack、lateral view和json_tuple、parse_url_tuple示例
属性是用来描述所属业务对象的性质和特征。1、考虑技术约束和考量、应用要求、性能要求,支撑详细的数据需求和业务规则的实施,设计出的数据在IT系统中的具体存储结构。2、是面向计算机物理表示的具体实现模型,与具体的DBMS类型有关。
或[‘’]:表示子节点。MaxCompute支持用这两种字符解析JSON对象,当JSON的Key本身包含.时,可以用[‘’]来替代。获取key1的对象为嵌套对象,可以使用.或[]获取,但是如果key包含.,则需要使用[]获取。[]:[number]表示数组下标,从0开始。
hive函数get_json_object不支持含特殊字符的key。例如,解析的json的key中包含’.‘,'@','#'等特殊字符。直接解析的话,结果为null。selectget_json_object(a.json,'$.ro\.boot\.serialn')asrbs--null 不支持转义,get_json_object(a.json,'$.\@serialNo')assn--null
最近经常用到datax从oracle抽取大表到数仓hive当表的数据量超过千万 很容易卡住 一直抽不过来经过测试可以在querysql上加并行抽取/*+ parallel(n) */基于并行查询要启动并行进程、分配任务与系统资源、合并结果集一般而言主要在如下情况使用parallel1.表的数据量很大,超过一千万;2.数据库主机是多个CPU;3.系统的当前负载较低;但这个容易直接把资源占死 导致别人
shell替换xml中指定的属性值sed -i 's;<id>.*<\/id>;<id>新内容<\/id>;g' your.xml
Swagger 2 的依赖底层使用的是 javax 依赖包,而 Spring Boot 3 使用的是 Jakarta 依赖包。一般来说,可以将 Spring Boot 的版本降到 3.0.1 以下来解决这个问题,但如果想要使用 3.0.1 版本以上的 Spring Boot,启动时就会出现报错。去pop.xml查看你springframework的版本,如果你已经是Spring boot3了,像我
tez-site.xml:2:6: The processing instruction target matching "[xX][mM][lL]"因为在hive\conf\tez-site.xml的配置文件中第一行有空格所以会报错。已解决。
用户定义的必须实现org.apache.hadoop.hive.ql.security.authorization.HiveMetastoreAuthorizationProvider接口;用户定义的要实现org.apache.hadoop.hive.ql.security.authorization.HiveAuthorizationProvider;从脚本读数据的时候的默认reader,默认是
在实现上基于函数回调,可以对几乎所有请求进行过滤,使用过滤器的目的是用来做一些过滤操作,获取我们想要获取的数据,比如:在过滤器中修改字符编码;Tips:我们说的拦截指的是发送的请求会进入SpringMVC的拦截器,具体是否能访问到目标资源要看拦截器是否放行;再次访问:http://localhost:8080/js/test.js,发现资源能够直接访问,1)即使访问的资源不存在,只要符合Sprin
1.说明:springboot连接多数据源是大家经常要用到的操作,下面我用springboot连接两个mysql和一个hive,采用的连接池是druid,学会这个后大家可以连接各种多数据源了,采用的操作方式是mybatis,也大致讲述使用jdbc的操作方式2.步骤(表演来了:我用的是2.1.8版本的springboot)1.导入相应的jar包<dependency>...
<?xml version="1.0" encoding="UTF-8" standalone="no"?><?xml-stylesheet type="text/xsl" href="configuration.xsl"?><!--Licensed to the Apache Software Foundation (ASF) under one or moreco
阿里云spring插件仓库</name><name>阿里云spring仓库</name><name>阿里云central仓库</name><name>阿里云阿帕奇仓库</name><name>阿里云公共仓库</name><name>maven仓库</name><name>阿里云谷歌仓库
在Java Web应用程序中,web.xml是一个XML配置文件,用于定义和配置Servlet、过滤器、监听器和其他Web应用程序组件的行为和属性。web.xml文件通常位于Web应用程序的WEB-INF目录下,用于描述Web应用程序的部署信息和配置。每个 <servlet> 元素包含 <servlet-name> 和 <servlet-class> 子元素,用于定义Servlet的名称和Java
默认切换到主数据源master,方法切换到hive后,执行完毕后再次自动切换到master。配置成功后在需要切换数据源的方法上添加@DS注解,写入数据源名称。hive是需要手动事务开启的,则seta代理不能开启。nacos中system.yml配置。nacos中datasource配置。项目启动时会初始化数据源。
ORACLE存储过程转化为HQL平台时,可能会出现各种问题。ORACLE与HIVE都使用SQL语句,但是语法和特性不尽相同,注意一下几种情况。一.INSERT语句ORACLE:EXECUTE IMMEDIATE 'TRUNCATE TABLE TABLE_A';INSERT /*+APPEND*/ INTO A NOLOGGING (COL_1,COL_2,COL_3,)迁移至HIVE语句为:IN
hive 作为一个常用的分布式数据库,往往会存储多种数据源,其中xml格式的数据导入到hive中有多种方式,借助etl工具,如datax,kettle, nifi等都可以轻松实现,在这里我来给大家介绍一种hive直接读取xml格式数据,并将其转换为行的方式xml数据文件test.xml:<?xml version="1.0" standalone="no" ?><Root>
下载地址两个版本sqoop1(1.4.x)和sqoop2(1.99.x),两种不同的架构。本文使用sqoop1。sqoop是apache旗下一款“hadoop与关系数据库之间传送数据”的工具。导入数据:从MySQL、Oracle导入数据到Hadoop的HDFS、HIVE、HBASE等存储系统。导出数据:从Hadoop的HDFS、HIVE中导出数据到关系数据库mysql等。sqoop的工作机制是将导
异常:Caused by: java.lang.RuntimeException: org.apache.hadoop.hive.ql.parse.SemanticException:Line 1:14 Table not found ‘0205role’at org.apache.hadoop.hive.ql.parse.SemanticAnalyzer.getMetaData(Semant..
使用仓库、组织、物料、库存流水,进行响应测试,oracle使用dbeaver等将测试数据从外系统加载至测试环境,hive使用sqoop将测试数据从外系统加载至测试环境。备注:1、数据量超达到4万条,dbeaver客户端加载数据明显慢很多,受限于客户端工具(客户端工具是java所开,需要将sql文件在工具中打开),使用服务端加载。测试数据的加载,按照oracle、hive的不同,分别采用不同的方式和
上面的配置中,hive.metastore.uris是Hive的元数据存储地址。确认系统中已经安装了Hadoop和Spark,并且配置好了环境变量。其中,my_table是Hive中已经创建的表。