登录社区云,与社区用户共同成长
邀请您加入社区
-bootstrap-server <bootstrap-server-list> # KRaft 控制器或 broker 的地址(必填)--broker-list <String: brokerlist> # "0,1,2" (与--topics-to-move-json-file 配合)[--command-config <config-file>] # 客户端配置文件(如认证信息)[--re
写在前文本文是我自己经过实践记录的,环境搭建简单快速,适合于前期学习(如果想深入了解Kafka、Redis、MySQL集群同步等相关知识本文不适用)。使用canal同步有两种方案,一种是使用canal原始的tcp方式,一种是使用canal+kafka类型;Canal原理Canal的服务端伪装成MySQL的从服务器,订阅MySQL的主服务器的binlog日志,实现增量同步数据,保持最终一...
kafka的broker介绍
version: '2'services:zoo1:image: wurstmeister/zookeeperrestart: unless-stoppedhostname: zoo1ports:- "2181:2181"container_name: zookeeperkafka1:image: wurstmeister/kafkaports:- "9092:9092"enviro.
java.lang.UnsupportedOperationException: class org.apache.calcite.sql.SqlIdentifier: json原因 表字段类型是 json , flink 不支持;改为 string解决转载出处:https://www.saoniuhuo.com/question/detail-1911817.html?sort=hot
服务端 kafka_2.11-1.0.1客户端 kafka-clients-1.0.1在断网等情况下,程序会停止在consumer.commitSync(final Map<TopicPartition, OffsetAndMetadata> offsets)这个方法上。是因为默认的超时时间为Long.MAX_VALUE意味着消费者会一直不停的尝试提交offset,只到发生一些unre
一、准备工作1.idea(安装过程略)2.jdk(安装过程略)3.scala 安装配置下载:首先到Scala官网下载Scala网址为https://www.scala-lang.org/download/安装默认就ok在系统环境变量 Path 中,一般会自动生成,如果没有自己创建。安装成功后,查看 scala 的版本号:Scala -version4. gradle官网:https://gradl
本文主要阐述的是Kafka可靠性相关参数中的一个,即unclean.leader.election.enable。随着Kafka版本的变更,有的参数消失,也有的参数被加入进来,而传承下来的参数一般都不太会修改既定的默认值,而unclean.leader.election.enable参数却是其中的一个反例。从Kafka 0.11.0.0版本开始unclean.leader.election....
参考文章:kafka和rabbitmq对比1、吞吐量kafka吞吐量更高:1)Zero Copy机制,内核copy数据直接copy到网络设备,不必经过内核到用户再到内核的copy,减小了copy次数和上下文切换次数,大大提高了效率。2)磁盘顺序读写,减少了寻道等等的时间。3)批量处理机制,服务端批量存储,客户端主动批量pull数据,消息处理效率高。4)存储具有O(1)的复杂度,读物因为分区和seg
Kafka 是一个分布式的基于发布/订阅模式的消息队列(Message Queue),主要应用于大数据实时处理领域。1.1 kafka的基础架构1)Producer :消息生产者,就是向 kafka broker 发消息的客户端;2)Consumer :消息消费者,向 kafka broker 取消息的客户端;3)Consumer Group (CG):消费者组,由多个 consumer 组成。消
问题原因java安装路径有空格,导致无法识别一、查看环境变量配置是否正确.;%Java_Home%\bin;%Java_Home%\lib\dt.jar;%Java_Home%\lib\tools.jar(一般不是此问题)二、修改kafka文件1. 找到**\kafka_2.12-2.3.0\bin\windows2. 找到kafka-run-class.bat3. 找到set COMMAND=%
创建,格式如下(以},},},},},配置说明replicas数组中,第一个元素为原副本(保持 leader 不变,减少迁移开销),后两个为新增副本的 broker ID。确保新增的 broker(如 1、2、3)均正常运行,且集群总 broker 数量 ≥ 3(否则无法分配 3 个副本)。log_dirs 用于指定每个副本存放的日志目录,默认用 “any” 表示由 Kafka 自动分配。
安装Kafka -> 启动Kafka -> 测试Kafka是否正常工作
https://blog.csdn.net/ZhongGuoZhiChuang/article/details/79550570
分区排序:Kafka 通过分区来保证消息的顺序。同一分区内的消息是有序的,但不同分区之间的消息则不保证顺序。如果一个消费者组中有多个消费者,可以通过调整消费者的数量,确保每个分区只由一个消费者处理。配置生产者:通过配置生产者,可以减少消息乱序的可能性。配置消费者:通过配置消费者,可以确保消息按顺序处理。
什么是kafka一个分布式流式处理平台,以高吞吐、可持久化、可水平扩展、支持流数据处理等特性被广泛使用。Kafka的s:
1 配置文件配置kafka路径。2 我这里选择配置文件注入。
flume采集数据源为lo日志
当zk与kafka集成sasl认证出现异常时,切换zk主从可能导致新Topic的分区leader和ISR为空的情况处理
Broker端则会针对每个\维护一个序列号(SN),只有当对应的SequenceNumber = SN+1时,Broker才会接收消息,同时将SN更新为SN+1。通过预分配ID就容易避免,客户端每次提交订单都需要携带一个提前获取的订单id,当服务端检查有重复的订单id时,就可以拒绝。如果改为提前分配好ID, 客户端将ID与数据一同发送给服务端,服务端进行ID验证,检查这个ID是否已经处理过了。这个
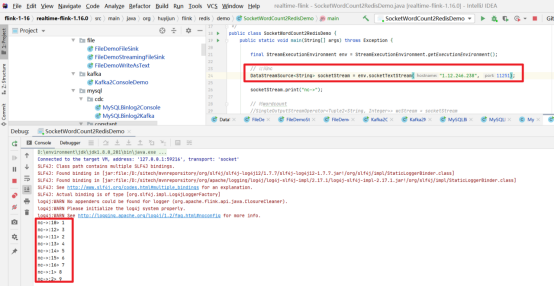
k<通信端口>强制 nc 待命链接.当客户端从服务端断开连接后,过一段时间服务端也会停止监听。但通过选项 -k 我们可以强制服务器保持连接并继续监听端口。-l 开启 监听模式,用于指定nc将处于监听模式。通常 这样代表着为一个 服务等待客户端来链接指定的端口。Flink程序订阅对应端口的socket流,模拟消费kafka数据。-p<通信端口> 设置本地主机使用的通信端口。中,命令nc -lk 和n
1、问题背景为保障系统大促期间稳定运行,计划进行全链路生产压测。2、问题现象1》压测期间产生大量事后数据流向flink实时计算环节,flink任务消费的kafka出现堆积而产生告警。2》通过flink监控平台查看日志发现flink任务频繁重启失败,checkpoint save失败。3》通过kafka平台监控发现,flink任务连接kafka的连接数不断攀升,即kafka连接泄漏。4》短时间内所有
文章目录kafka理论kafka介绍生产者消费者和kafka的连接对象zookeeper作用kafka下面各个角色的作用消费者生产者生产者发送消息怎么保证kafka一定收到了消息ISR机制生产者允许消息丢失的时候怎么处理kafka理论kafka介绍kafka是一个基于发布/订阅的消息队列,生产者发布消息到topic,消费者采用拉的模式,轮询的去问kafka有没有消息,好处在于消费的速度可以自己控制
1、返回topic列表./kafka-topics.sh --list --zookeeper localhost:21812、创建topic./kafka-topics.sh --zookeeper localhost:2181 --create --topic kafka_test --partitions 60 --replication-factor 33、查看指定to...
1、一致性协议算法一致性协议算法主要有Paxos、Raft、ZAB。Paxos算法是Leslie Lamport在1990年提出的一种基于消息传递的一致性算法,非常难以理解,基于Paxos协议的数据同步与传统主备方式最大的区别在于:Paxos只需超过半数的副本在线且相互通信正常,就可以保证服务的持续可用,且数据不丢失。Raft是斯坦福大学的Diego Ongaro、John Ousterhout两
flinkSQL 建表设置水位线时间格式转换 & flinkSQl滚动窗口
kafka设置jdk的位置
在Kafka的实际应用中,消息重复消费是分布式系统面临的经典难题。在阿里/字节跳动这样的高并发场景下,该问题尤为突出。fill:#333;color:#333;color:#333;fill:none;消息重复来源生产者端Broker端消费者端网络问题导致重试副本切换导致重复Rebalance导致偏移重置提交失败后重复处理。
kafka
对消费者代码进行修改,增加异常处理,使其跳过旧消息。异常处理的好处,同时也能解决由于数据中可能存在的错误格式的数据不能处理的报错。在启动kafka集群之前检查kafka集群文件是否还有为消费的消息文件,将其删除。换一个新的topic。
本文主要内容一、kafka架构二、kafka 特性实现原理2.1、kafka 高可靠性2.2 kafka 高吞吐2.3 kafka 水平扩展三、kafka数据处理原理3.1、消息生产者3.2、消息处理及持久化3.3、消息消费者一、kafka架构二、kafka 特性实现原理2.1、kafka 高可靠性2.2 kafka 高吞吐2.3 kafka 水平扩展三、kafka数据处理原理3.1、消息生产者3
toc参数配置:config/server.propertieszookeeper.connect指明Zookeeper主机地址,如果zookeeper是集群则以逗号隔开,如: 172.6.14.61:2181,172.6.14.62:2181,172.6.14.63:2181eg: zookeeper.connect=localhost:2181(kafuka和zookeeper在同一台服务器上
kafka --> elasticsearchflink版本1.10设置初始化参数ParameterTool parameter_tool = ParameterTool.fromArgs(args);String config_path = parameter_tool.get("ConfigPath");String source_topic = "my-topic";String so
日志文件结构log文件,index文件,timestamp文件log文件:0000000000000123.log,
在kafka.service文件中写入如下代码并保存。验证kafka是否启动成功。下载kafka4.0。
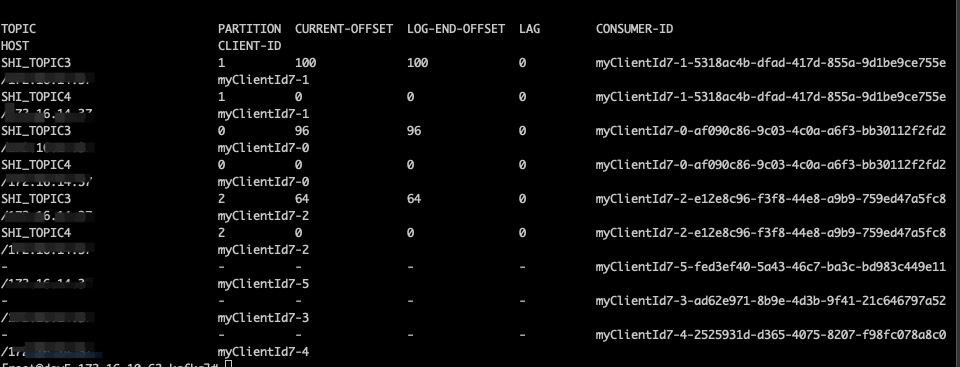
补充:kafka manager 中lag的正数、0、负数的含义:正数:就是kafka数据积压了,消费速度小于生产速度;0:生产者和消费者速率基本相当,说明2者都工作正常;负数:说明kafka的消费者干活很快,分分钟就处理完消费的数据,供小于求。...
Flink消费kafka,某partition突然从头开始消费,yarn per job部署,ui页面无报错,检查点也没有异常,很神奇,不知道什么原因?
【github】:librdkafka1、封装 redis 客户端
目录列出所有topic创建topic删除topic查询topic的描述信息模拟生产者模拟消费者列出所有topic# 通过 zk 集群中的一个列出所有 topicbin/kafka-topics.sh --list --zookeeper 10.10.2.60:2181创建topic# 注意创建的分区数是可以大于brokers的个数,但是创建的副本数只能 <= brokers的个数bin/ka
通过Nginx代理Kafka实现跨网络消费1. 服务器环境2. 服务搭建2.1 服务器B服务搭建2.2 服务器A服务搭建3. 测试连通性1. 服务器环境两台服务器同在一个网段(都开打开防火墙模拟跨网)分别为服务器A、服务器B服务器A(172.**.**.219):安装Nginx(1.8.0以上的Nginx才支持stream模块)服务,对所有网段打开9092端口服务器B(172.**.**.220)
使用Redission分布式锁与Kafka消息队列,实现学生抢课系统(高并发秒杀场景)
kafka是一款消息中间件。可以帮助我们消费和发送消息。可以做数据同步。首先kafka需要导入pom文件然后需要kafka的核心config如下@Configuration@Slf4jpublic class KafkaTemplateConfig {@Value("${kafka.archive.servers}")private String KAFKA_SERVERS;@Value("${k
在开头跟大家分享的时候我就说,面试我是没有做好准备的,全靠平时的积累,确实有点临时抱佛脚了,以至于我自己还是挺懊恼的。(准备好了或许可以拿个40k,没做准备只有30k+,你们懂那种感觉吗)如何准备面试?1、前期铺垫(技术沉积)程序员面试其实是对于技术的一次摸底考试,你的技术牛逼,那你就是大爷。大厂对于技术的要求主要体现在:基础,原理,深入研究源码,广度,实战五个方面,也只有将原理理论结合实战才能把
ZooKeeper 模式是 Kafka 传统架构,依赖 ZooKeeper 集群管理元数据(如 Topic 信息、分区副本分配、broker 存活状态等)。broker 启动时向 ZooKeeper 注册自身信息;broker 通过 ZooKeeper 监听集群变化(如其他 broker 加入/退出);控制器(Controller)节点从 ZooKeeper 获取元数据并同步给其他 broker。
kafka Java
今天遇到个问题,zookeeper启动正常,但是kafka启动老是报错,配置文件都是正常的,去查了下网上,发现是kafka消息队列拥堵,碰到这种情况为了不影响在线系统的正常使用,需要大家手动的清理Kafka Log。当手动删除Kafka某一分片上的消息日志时,如上图蓝线所示,此是只是将Kafka Log中的信息清0了,但是Zookeeper中的Partition和Offset数据依然会记录。,删除
在 TP5 中使用 Kafka 作为消息队列可以显著提高系统的并发处理能力和异步处理能力。通过生产者发送消息到 Kafka 主题,消费者从主题中消费消息,可以实现异步任务处理、实时数据分析等多种应用场景。高吞吐量:支持大量的消息发布和订阅。持久性:消息会被持久化到磁盘,保证消息不丢失。可靠性:通过配置可以实现至少传递一次或恰好传递一次的消息传递语义。扩展性:通过分区和副本机制,可以实现水平扩展。通
操作系统:centos7.xkafka版本:kafka_2.12-2.6.0jdk版本jdk1.7.xkafka启动报错Exception in thread “main” java.lang.UnsupportedClassVersionError: kafka/Kafka : Unsupported major.minor version 52.0原因:java版本过低 java版本为1.7.
一:用kafka命令发送消息时候,一直报WARN Error while fetching metadata with correlation id 0 {test=UNKNOWN_TOPIC_OR_PARTITION}?原因:由于主题没创建导致的,生成是禁止自动创建的。
一、简介Kafka是最初由Linkedin公司开发,是一个分布式、支持分区的(partition)、多副本的(replica),基于zookeeper协调的分布式消息系统,它的最大的特性就是可以实时的处理大量数据以满足各种需求场景:比如基于hadoop的批处理系统、低延迟的实时系统、Storm/Spark流式处理引擎,web/nginx日志、访问日志,消息服务等等,用scala语言编写,Linke