登录社区云,与社区用户共同成长
邀请您加入社区
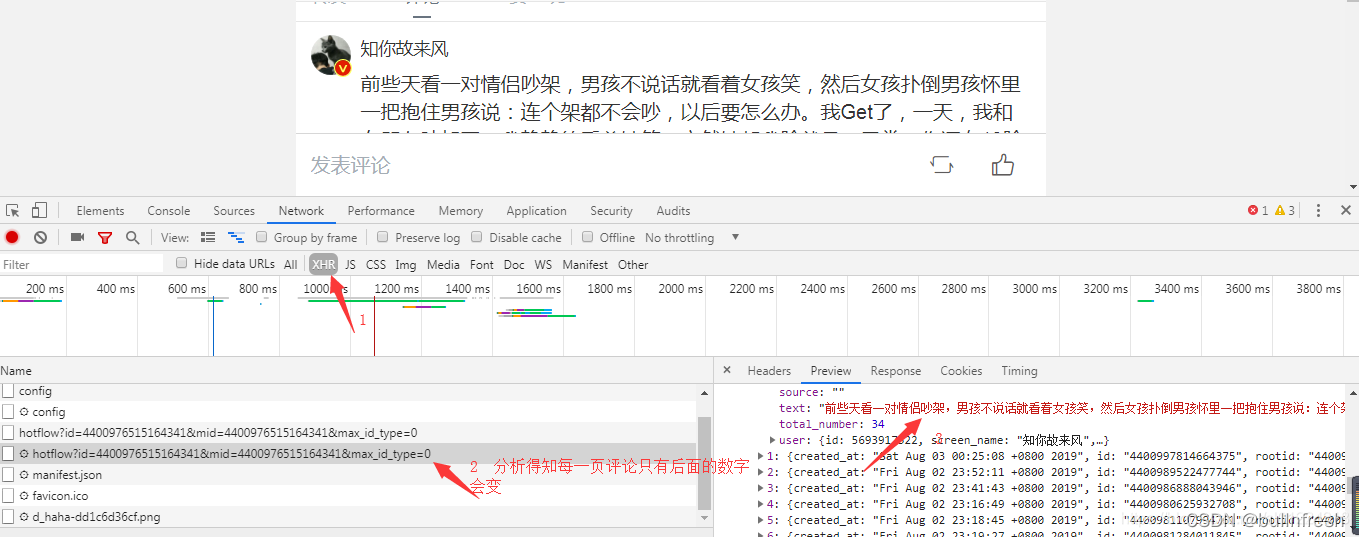
一、非结构化文本的爬取微博上有一篇关于“#学校里的男生有多温柔#”的话题,点进去一看感觉评论很真实,于是想把评论给爬下来看一看,并生成词云。刚开始思路是通过网页端微博爬取,通过开发者工具查看分析后,发现并没有看到相关评论。百度搜索之后得知web做了一些反爬虫策略,不太容易爬取(踩了相当时间的坑)。但是微博手机端相对容易些,于是转战手机端获取该评论链接,然后使用谷歌浏览器登录该链接,一阵分析后,发现
出现字符nan,原因1,出现非数字,或者无穷大是数字,原因2,malloc构造空间程序在循环体内,而有的空间没有在循环体内释放,单片机空间用完了。
Hive不仅支持基本类型,还支持比较复杂的类型,同时配套了一些函数,灵活运用这些复杂类型的字段,可以更好的设计离线表更加详细内容可以见:...
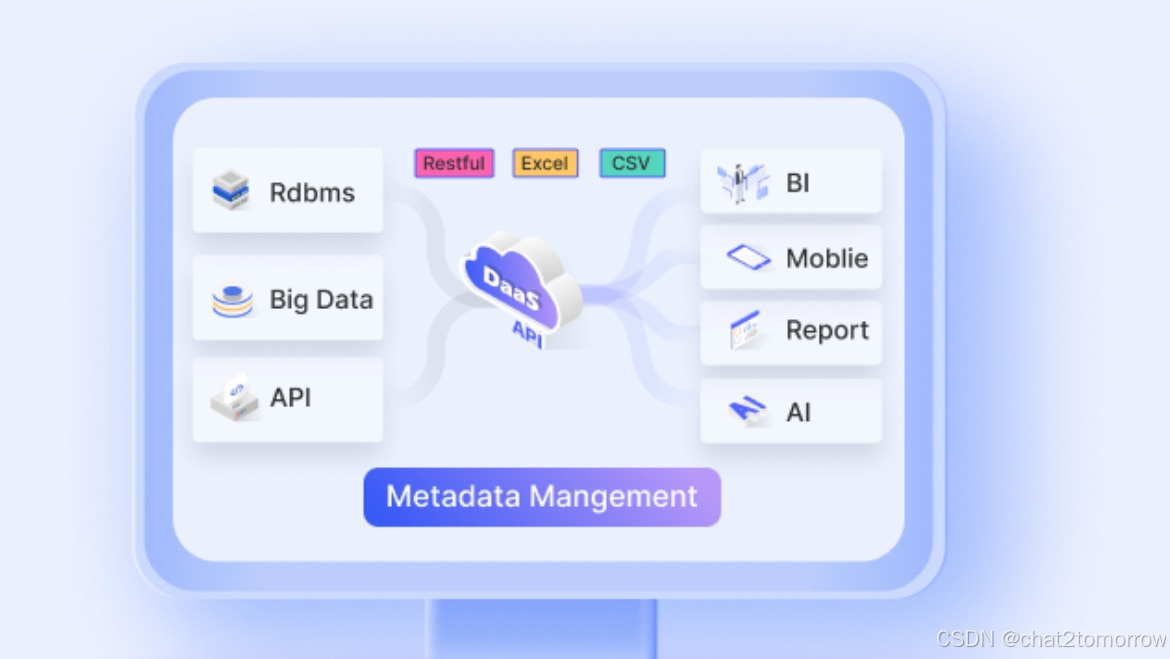
SQL2API平台,是麦聪软件提出的一款将SQL直接转化为数据API的低代码平台。借助它,用户能绕过复杂的代码编写过程,把数据库里的SQL查询快速转化成可调用的API接口,极大地简化了数据访问与交互流程。即使是非技术人员,也能借此轻松获取和运用数据库数据。从本质上看,它是数据库与应用程序间的桥梁,让应用程序能以标准方式访问数据库,无需担忧数据库的具体实现细节,有效提升开发效率,增强系统的可维护性与
数据架构总是在更新迭代的路上,以使其快速适应变化的数据环境,更为敏捷和规模化地给业务部门交付数据。在传统的数据架构中,存在数据复杂度高、缺乏敏捷性、不便于协作、数据和一致性可解释性低下等问题。这些挑战阻碍了企业迈向数据驱动型企业的道路,也难以实现快速响应业务需求。在寻求最佳数据架构的过程中,Data Fabric 和 Data Mesh 常常被关注到,这两者乍一看很相似,...
页面卡顿不要急,本文就来教你如何提升页面性能
最近网上和各大公司在对比spark 和flink , 也有一部分人,演讲时不分析代码原理,不根据事实,直接吹嘘flink比spark好,flink 能干掉spark 的话,今天就跟大家从技术,应用和未来发展角度对两个产品进行对比。先说产品特性:1.spark中批处理使用 RDD, 流处理使用 DStream,flink中批处理使用 Dataset, 流处理使用 DataStreams。目前flin
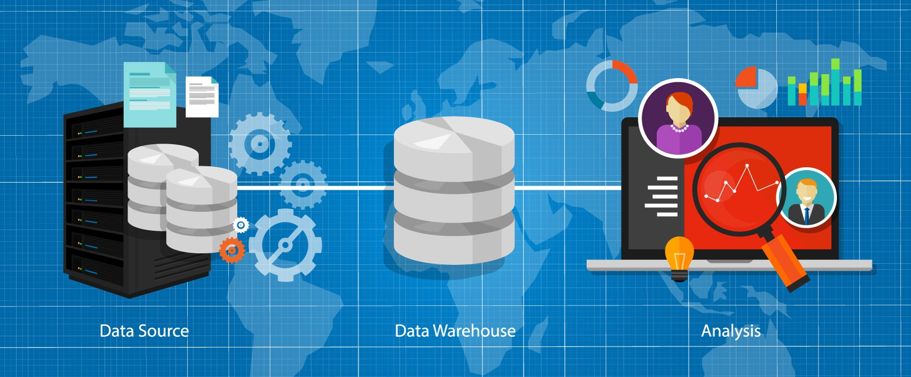
数仓概念及架构
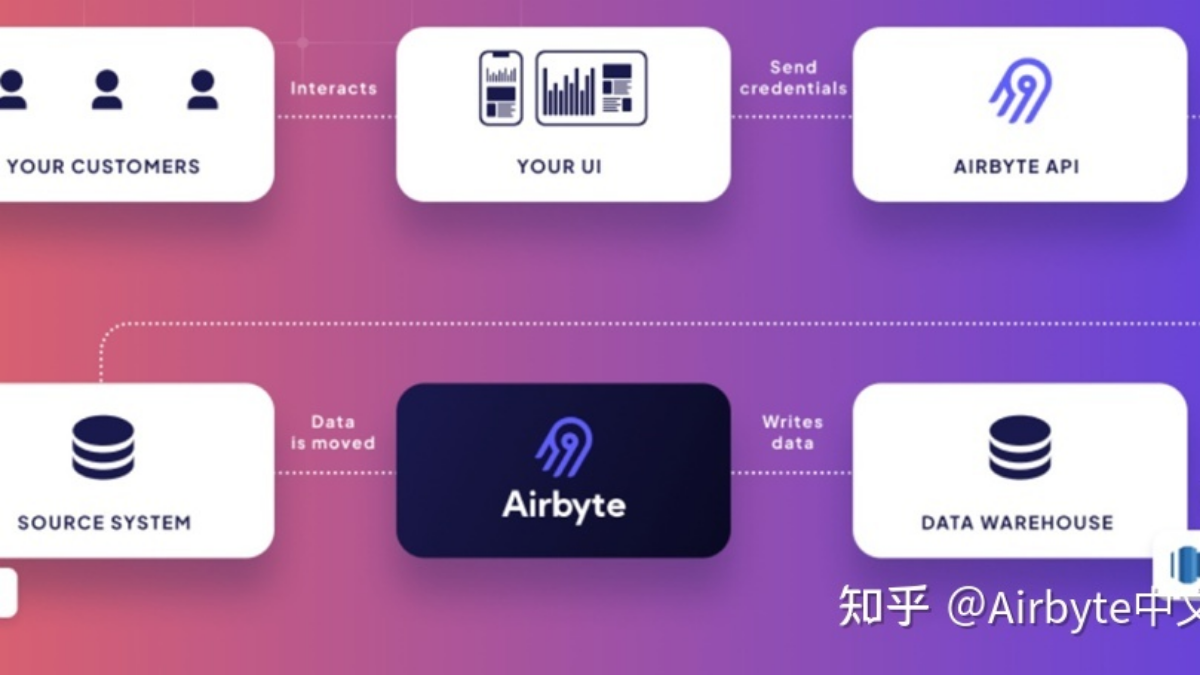
作为一款技术复杂的数据集成管道,Airbyte的架构模式非常清晰明了。UI:一个易于使用的图形界面,用于与Airbyte API进行交互。WebApp Server:处理 UI 和 API 之间的连接。Config Store:存储所有连接信息(凭据、频率等)。Scheduler Store:存储调度程序簿记的状态和作业信息。Config API:Airbyte 的主控制平面。Airbyte 中的
MPP架构 && 分布式架构MPP1.传统数仓中常见的技术架构,将单机数据库组成集群,提高整体性能2.节点间为非共享架构(Sharing Nothing),每个节点都有独立的磁盘存储系统和内存系统(独立存储+独立计算),独立运行时不需要关心其他节点的情况和数据,如果需要用到其他节点的数据,各个节点之间通过专用网络或者商用网络,进行点对点交换,完成协同运算的过程3.设计上先考虑C(一
随着新技术的出现,每一个进销存供应商都会尝试使用新技术,以在满足用户需求的同时成为市场的佼佼者。在今天的世界上,大多数的进销存市场都使用一个服务器作为进销存数据库。进销存的未来将转向云,因为随着对进销存需求的增加,在服务器中存储数据变得越来越困难,因为担心发生任何灾难,大量数据在服务器中的安全性降低。而且,目前,进销存源码在移动设备上可用,但与在计算机和笔记本电脑上访问进销存相比,它在移动设备中的
hadoop版本3.3.6 mysql版本8.0.20。
数据仓库分层架构包含ODS、DWD、DWS等核心层级。ODS层直接接入业务系统原始数据;DWD层进行数据清洗和规范化处理;DWS层按业务主题聚合数据形成宽表。这种分层设计实现了数据流向清晰、质量可控、复用性高三大优势:各层职责明确便于问题定位,统一处理确保数据一致性,预计算提升查询效率。经典三层模型(ODS原始数据→DWD明细数据→DWS/ADS易用数据)构成了企业级数据平台的基础架构,通过标准化
1.Vertica架构Vertica是一款基于列存储的MPP(大规模并行处理)架构的数据库,它可以支持存放PB级别的结构化数据。(1)MPP架构该结构由多个完全独立的处理节点构成,每个处理节点具有自己独立的处理器、独立的内存(主存储器)和独立的磁盘存储,多个处理节点在处理器由高速通信网络连接,系统中的各个处理器使用自己的内存独立地处理自己的数据。在这种结构中,每一个处理节点就是一个小型的数据库系统
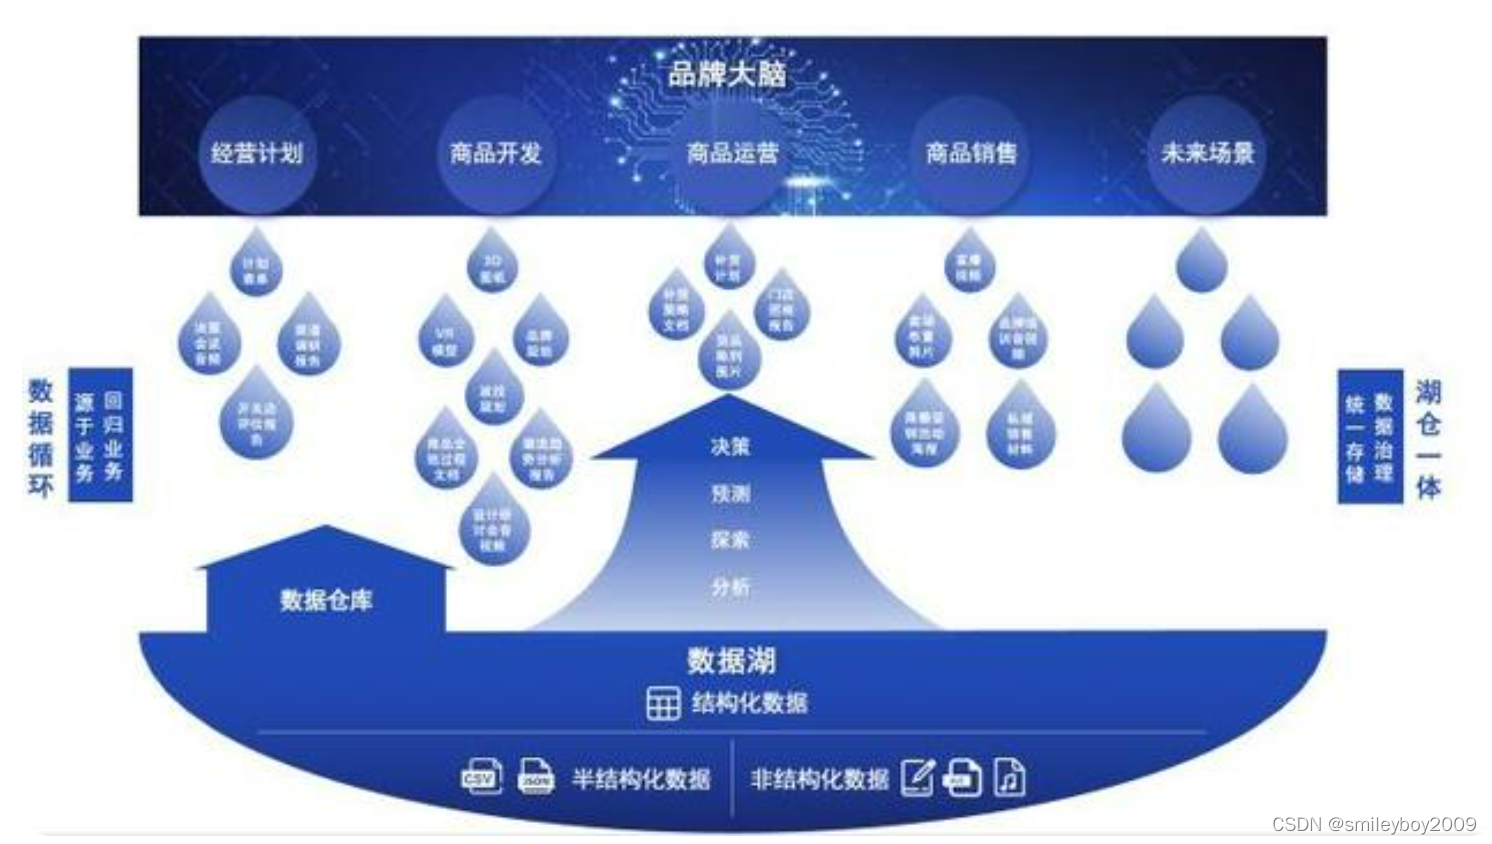
全文共7110个字,建议阅读15分钟在了解湖仓一体化之前,我们先来看一则有关数据仓库的有趣故事吧~沃尔玛拥有世界上最大的数据仓库系统,它利用数据挖掘方法对交易数据进行分析后发现"跟尿布一起购买最多的商品竟是啤酒!后来经过大量实际调查和分析,发现在美国,一些年轻的父亲下班后经常要到超市去买婴儿尿布,而他们中有30%~40%的人同时也为自己买一些啤酒,这是因为美国的太太们常叮...
flink udf/udaf/udtf
ETL(Extract, Transform, Load)工具是一种用于从多个数据源提取数据,转换它们以符合目标数据模型的要求,并将其加载到目标数据库的软件。HOP和Kettle是两种流行的ETL工具。HOP是开源的ETL工具,由Pentaho(现在是Hitachi Vantara)开发。它是基于Java的,支持跨平台运行,并具有丰富的可视化界面,可以帮助用户轻松地创建和管理ETL作业。HOP还.
点击上方蓝色字体,选择“设为星标”回复"面试"获取更多惊喜八股文教给我,你们专心刷题和面试Hi,我是王知无,一个大数据领域的原创作者。放心关注我,获取更多行业的一手消息。背景在B站,每天都有PB级的数据注入到大数据平台,经过离线或实时的ETL建模后,提供给下游的分析、推荐及预测等场景使用。面对如此大规模的数据,如何高效低成本地满足下游数据的分析需求,一直是我们重点的工作...
上一篇我们介绍了数据集市的概念以及它和数仓的区别,并且重点论述了大数据数仓中的分层架构体系。这篇我们简要分析一下以下5家公司的数仓分层架构模型:1、马蜂窝数仓分层架构2、阿里云MaxCom...
会员体系架构的设计思路
或[‘’]:表示子节点。MaxCompute支持用这两种字符解析JSON对象,当JSON的Key本身包含.时,可以用[‘’]来替代。获取key1的对象为嵌套对象,可以使用.或[]获取,但是如果key包含.,则需要使用[]获取。[]:[number]表示数组下标,从0开始。
答案解析:二次文献又称二级次文献,是对一次文献进行加工整理后的产物,即对无序的一次文献的外部特征如题名、作者、出处等进行著录,或将其内容压缩成简介、提要或文摘,并按照一定的学科或专业加以有序化而形成的文献形式,如目录、文摘杂志(包括简介式检索刊物)等。答案解析:在科研研究的伦理原则中,科技工作者应该坚持科学研究的客观性,杜绝蓄意的捏造、作假和对研究成果的曲解,指的是 诚信原则。10、在科研研究的伦
clickhouse分布式表副本同步不了项目场景:在clickhouse终创建副本表问题描述:原因分析:解决方案:项目场景:在clickhouse终创建副本表问题描述:创建副本表之后,插入数据,在副本服务器上查不到数据CREATE TABLE default.test_distribute ON CLUSTER clickhouse_remote_servers(`EventDate` DateT
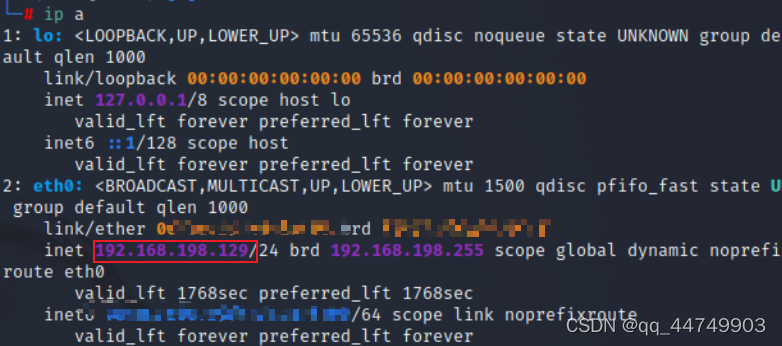
kali无法和win ping通,kali虚拟机无法和windows主机连接网络
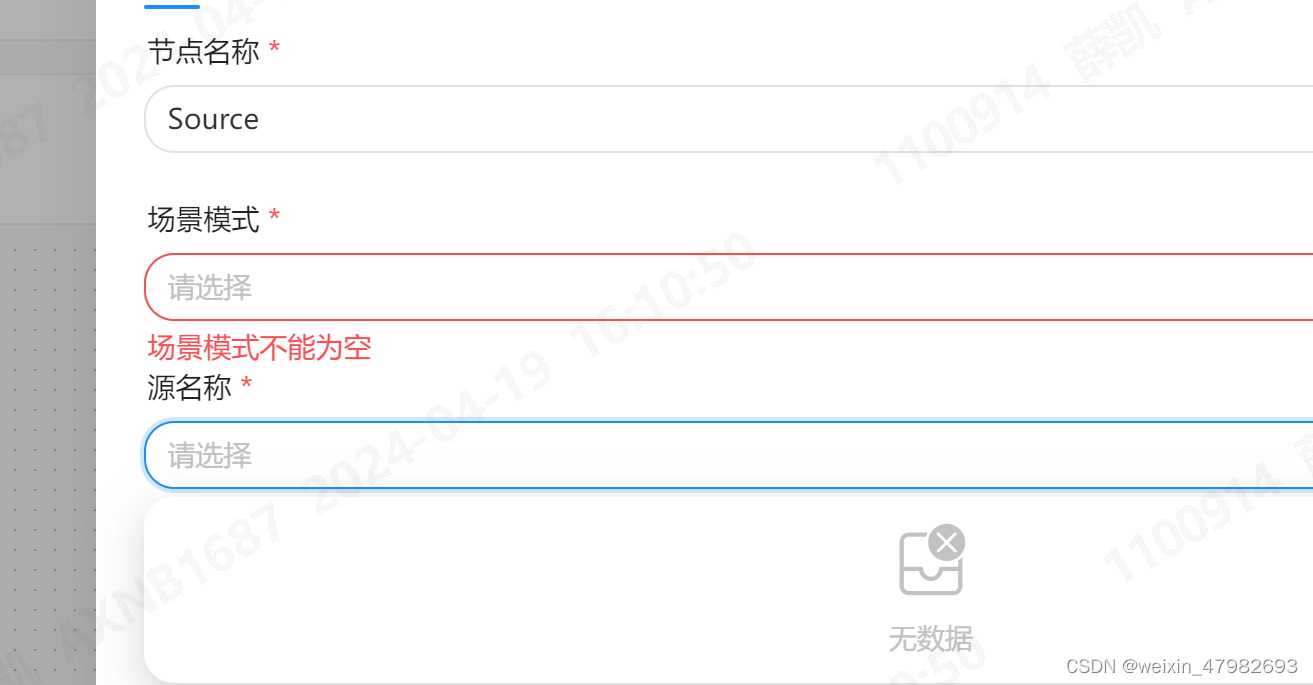
SeaTunnel 后端文件夹中两个文件复制到web下边。设置SeaTunnel_HOME指定到后端文件夹。web端会去查询服务端的connector。1.source数据源未显示。
数据治理是一个系统性工程,需要从顶层设计到落地执行的全链路管理。通过上述体系化治理,关键在于建立可量化、可落地的治理机制,而非单纯追求技术完美。
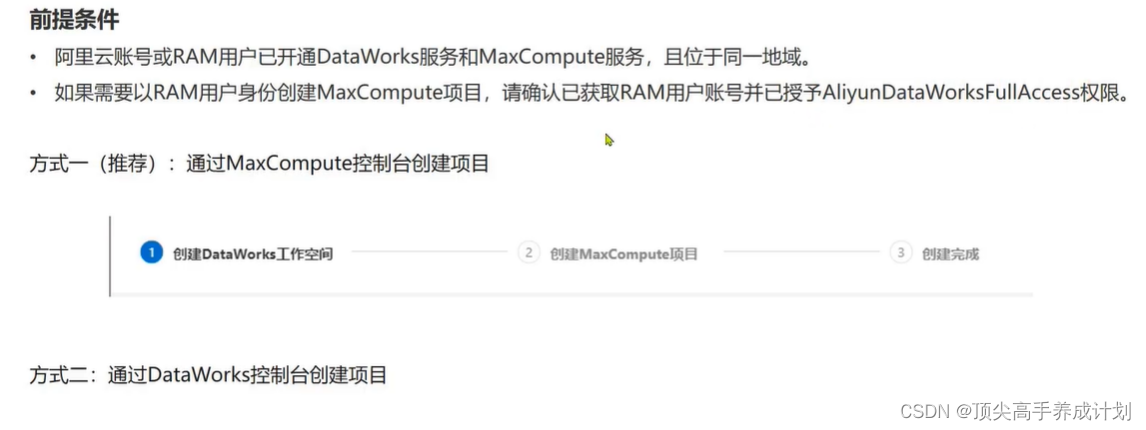
ACP(MaxCompute篇)-MaxCompute开发工具
数据治理数仓建设真正的难点不在于数仓设计,而在于后续业务发展起来,业务线变的庞大之后的数据治理,包括资产治理、数据质量监控、数据指标体系的建设等。其实数据治理的范围很⼴,包含数据本⾝的管理、数据安全、数据质量、数据成本等。在DAMA 数据管理知识体系指南中,数据治理位于数据管理“车轮图”的正中央,是数据架构、数据建模、数据存储、数据安全、数据质量、元数据管理、主数据管理等10大数据管理领域的总纲,
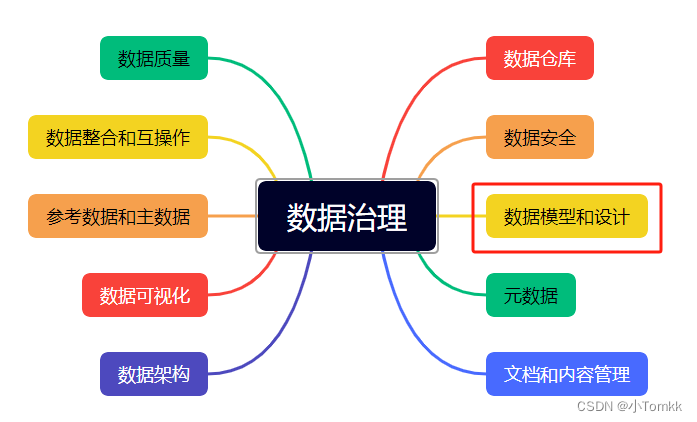
数据治理, 数据模型和设计
湖仓一体的数据治理
芯片批量操作
丝印是芯片特殊的代码,也是判定是否真伪的凭证之一,但是也有个别厂商的代码似乎永远是个谜,比如:ON 、ADI部分物料本身是没有数字代码说明年份问题的,永远都是字母代替,但是这些字母对应的年份说明是查不到的,各位贴友有知道的吗?
MaxCompute报错处理方案摘要:报错可能由lxml版本限制、依赖缓存问题或环境不一致导致。解决方法是指定安装lxml旧版本(<6)并重新安装tqdm包,命令为/home/tops/bin/pip3 install "lxml<6" simple-salesforce。此操作能促使pip重新解析依赖,选择兼容版本,避免编译错误,确保环境一致性。新版lxml可能引
oracle12.2.0.1.0_win64安装包
数仓中数据清洗的方法
1.一般导入imp用户名/密码@172.16.5.36/orcl file=E:\t02 fromuser=xyjj touser=dbcenter grants=n FEEDBACK=100 ignore=y2.较大的sql文件采用 CMD 登陆SQLplus导入sql文件start c:/emp.sql3.指定导入过程日志路径,缓存空间大小imp 用户名/密码@172.16.2.33/orcl
常见的数据清洗正则表达式
关于数据清洗工作的理解-清洗是做什么的,为什么要进行数据清洗工作,什么样的数据叫脏数据,脏数据如何进行数据的处理
oracle错误代码解释
oracle11$conn = oci_connect("GADATA0009","gold","(DEscriptION=(ADDRESS=(PROTOCOL=TCP)(HOST=WIN-FBN9RSHMGLC)(PORT=1521))(CONNECT_DATA =(SID=orcl)))");oracle10$conn = oci_connect("GADATA0009","gold","lo
ETL数据清洗工具总结 - osc_a0ivqvbh的个人空间 - OSCHINA - 中文开源技术交流社区
select * from表 where rownum
数据清洗与数据集成(随笔)文章目录数据清洗与数据集成(随笔)一、数据清洗数据清洗的意义数据清洗的目的数据异常的不同类型1.语法类异常2.语义类异常3.覆盖类异常数据质量的评价标准1.正确性2.唯一性数据清洗的任务和过程数据清洗的操作数据清洗的过程数据清洗的具体方法二、数据集成数据集成需要解决的问题--异构性数据集成的模式联邦式数据库模式数据仓库模式中介者模式实体解析一、数据清洗**数据清洗是一种消
说明:此次演示基于windows10系统第一步:在任务管理器中关闭oracle的所有服务第二步:找到卸载程序第三步:点击“卸载产品”第四步:勾选目录(注意:第一个没勾选,在这里卸载不了)第五步:点击“删除”第六步:点击“是”第七步:等待即可第八步:关闭对话框第九步:关闭窗口第十步:点击“是”第十一步:打开注册表第十二步:找到指定目录第十三步:删除ORACLE目录第十四步:找到指定目录第十五步:删除
关于ODS层是否做数据清洗一直是存在争议的,但有一点是可以确定的,对于比较重的清洗工作是要留到后面数仓的ETL过程中进行处理。但是,有这么一种情况:我们在长期的生产实际过程中,发现部分已知的数据问题的处理可以通过自动化的方式来处理,这种方式通常在数据入库之前,做额外的加工处理后再做入库操作。数据清洗的主要工作是处理那些不符合要求的数据,从而提升数据质量,比如一些常见的问题:错误的数据、重复的数据错
报错内容:2021-08-06 15:18:30 : Job aborted due to stage failure: Task 0 in stage 0.0 failed 1 times, most recent failure: Lost task 0.0 in stage 0.0 (TID 0, localhost, executor driver): java.sql.BatchUpda
说起数据清洗,可能会有些小伙伴会觉得这一步可以忽略掉,但是!作为混迹在数据分析这一块多年的老油条,小编在此严肃地声明!资料清理是资料处理中最不能被忽略的部分,它是资料分析过程中不可缺少的一环,其结果的好坏直接关系到模型的效果。实际上,数据清洗通常要占用50%—80%的分析过程。国外有些学术机构还会专门研究如何做数据清洗,相关的书籍也不少。数据清洗的主要类型有哪几种一、残缺数据此类数据主要是缺少某
ETL 是 Extract(抽取)、Transform(转换)、Load(加载)的缩写,是数据仓库和大数据处理中常用的概念,数据清洗是 ETL 过程中 Transform 阶段的重要工作内容。以下为你详细介绍:抽取(Extract):从各种数据源中提取数据,数据源可以是数据库(如关系型数据库 MySQL、Oracle,非关系型数据库 MongoDB 等)、文件系统(如 CSV、JSON、XML 文
在搭建数据中台、数据仓库或者做数据分析之前,首要的工作重点就是做数据清洗,否则会影响到后续对数据的分析利用。那么数据清洗到底是做什么事情呢?今天我就来跟大家分享一下。
mql如下SELECTb.*, (@curRand := @curRand + 1) AS rank FROM (SELECT trcp.user_id as userId,count( t.id ) AS finishNum,u.HEAD_PORTRAIT AS headPortrait,u.name as userNameFROM osi_task AS tLEFT JOIN osi_task