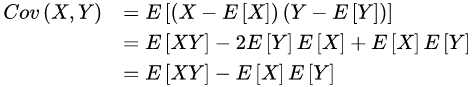登录社区云,与社区用户共同成长
邀请您加入社区
在平时的科研中,我们经常使用统计概率的相关知识来帮助我们进行城市研究。因此,掌握一定的统计概率相关知识非常有必要。本文将讨论我们经常遇到的概率分布,希望能从概念层面帮助大家建立总体认知。本文件涉及的概念包括:随机变量(Random Variable)密度函数(Density Functions)伯努利分布(Bernoulli Distribution)二项式分布(Binomial Distribu
除了上节的布里尔分数外,另一种常用的概率损失衡量是对数损失(log_loss),又叫做对数似然、逻辑损失或者交叉熵损失,它是多元逻辑回归以及一些拓展算法(比如神经网络)中使用的损失函数。它被定义为,对于一个给定的概率分类器,在预测概率为条件的情况下,真实概率发生的可能性的负对数。由于是损失,因此对数似然函数的取值越小,则证明概率估计越准确,模型越理想。需要注意的是,对数损失只能用于评估分类型模型。
OMLSA算法推导LSA估计增益贝叶斯定理估计条件语音存在概率DD准则估计先验信噪比通过先验信噪比的软决策估计先验语音缺失概率MCRA方法估计底噪递归平滑最小值控制语音存在概率OM-LSA(Optimally-modified log-spectral amplitude)是经典的降噪算法,这里做一个学习总结,把中间的一些公式推导一下,写一些自己的想法,水平有限,欢迎指正。LSA估计增益OM-LS
# 随机过程的分类《随机过程与控制(修订版)》P41```mermaidgraph TDA(随机过程分类)-->B1(根据时间和状态划分)A-->B2(根据样本函数形式划分)A-->B3(根据概率分布特性划分)B1-->C1(连续型随机过程)B1-->C2(离散型随机过程)B1-->C3(连续随机序列)B1-->C4(离散随机序列)B2-->D1(不
lingo的使用函数
其由二项分布推广而来,从而更加普遍。所以我们先回顾一下二项分布。二项分布的典型例子是扔硬币,设硬币正面朝上概率为ppp, 重复扔nnn次硬币,记硬币正面朝上的次数为XXX,显然XXX是一个随机变量,且服从二项分布,即X∼B(n,p)X\sim B(n,p)X∼B(n,p)。把二项分布推广至两种以上的状态,就得到了多项分布。比如做一次实验,结果有k种可能,各自的概率为(p1,…,pk)(p_1,\l
问题描述:假设你正参加一个有奖游戏节目,并且有3道门可选:其中一个后面是汽车,另外两个后面是山羊。你选择一道门,比如说选择1号门,主持人当然知道每道门后面是什么,并且打开了另一道门,比如说3号门,后面是一只山羊。然后主持人问你“你想改选2号门吗?”那么问题来了,改选的话对你会有利吗?这就是所谓的蒙蒂霍尔悖论游戏,也是一个经典的概率问题。基本思路:使用字典来模拟3道门,使用键表示门的编号,值表示门后
供应链与库存优化供应链的定义因引用的来源而异,但它们都有相同的基本思想。 供应链被定义为“相互连接和相互依赖的组织网络,相互合作,共同控制、管理和改善从供应商到最终用户的材料和信息流。” 供应链的规模和复杂程度各不相同,有些只有几级,有些则有数级。 例如,一个供应链可能由原材料供应商、制造工厂和向消费者销售的零售商组成,如图 1 所示。但是,另一条供应链可能由多个供应商组成,每个供应商都有几个独立
概率分布函数就是概率密度函数。累计分布函数:对概率密度函数从负无穷到xxx积分,得到的是累计分布函数。如何通俗的理解概率密度函数?首先考虑这样一个问题,你点了一个外卖,外卖说会在两个小时送达。那么送达的时间如下图(本次问题不考虑你进行催单和其他特殊情况,请勿抬杠)若外卖在第30分钟到60分钟送达那么概率是多少呢?没错是(60-30)/120=1/4,我们是怎么判断的呢?我们通过面积判断 ,如下图:
一种简单好学的以概率论为主要思想的算法
一、预测概率直方图我们可以通过绘制直方图来查看模型的预测概率的分布。直方图以样本的预测概率分箱后的结果为横坐标,每个箱中的样本数量为纵坐标绘制一个图像。具体代码实现为:from sklearn.datasets import load_breast_cancerfrom sklearn.model_selection import train_test_splitfrom sklearn.naiv
PSO改进系列算法简洁1、引入w的PSO:标准粒子群优化算法,引入惯性权重w,w随着迭代次数的变化而变化。2、APSO(Adaptive Particle Swarm Optimization):自适应粒子群优化算法,引入三种策略:参数自适应策略,精英学习策略,状态评估策略3、CPSO():协作粒子群优化算法,K1个D1维的小分组,K2个D2维的小分组,按组更新而不是整个粒子群整体更新4、CCPS
核心思想粒子群优化算法(PSO)是一种进化计算技术(evolutionary computation),1995 年由Eberhart 博士和kennedy 博士提出是根据鸟类的捕食行为简化出的一种模型假设一只鸟在捕食时,会和种群中其他的鸟类共享信息,并且根据自己寻找到的最优位置以及群体中给出的最优位置来改变自己的速度(包括大小与方向),从而从无序寻找到最终变成有序飞行。其速度的改变遵循三条原则:
| 拉斯维加斯算法 | 两种情况1. 找不到解2. 找到正确的解 || 蒙特卡洛算法 | 两种情况1. 找到正确的解2. 找到错误的解|| 舍伍德算法 | 一种情况找到问题正确的解 || 数值概率算法 | 一种情况近似解 |......
原文链接点云配准是计算机视觉的热门研究方向,目前对于刚性点云配准的研究比较全面,对于非刚性点云配准算法的研究相对较弱,总体上来说,ICP、卡尔曼滤波等见到的比较多,这篇博客也只是对一些点云配准算法的简单摘抄以做记录。ICP首先就是大名鼎鼎的 迭代最近点算法(Iterative Closest Point,简称ICP算法), 其 Paul J.Bed 和 Neil D. Mckay 提出。由于它简单
本文介绍了EM算法的基本流程及其在高斯混合模型中的应用。EM算法是一种求解含有隐变量的概率模型参数的迭代算法,已经广泛应用于信号处理、计算机视觉、自然语言处理等领域。希望本文能够对读者有所帮助。
本博客主要记录学习高翔老师视觉SLAM14讲的总结笔记,若有总结不对的地方,欢迎大家与我讨论。
一、首先理解运动方程和观测方程(1)运动方程: x表示相机的位姿,每个时刻位姿记为x1, x2...... xk,构成了运动的轨迹。uk 是传感器的输入;wk 是噪声,假设噪声服从高斯分布。运动方程的意义是: k-1 到 k 时刻,机器人位姿x 是如何变化的。 SLAM中的定位问题就是估计 x的值。区分位姿和位置:位姿代表位置和姿态。任何一个刚体在空间坐标系(OXYZ)中,可以用位置和姿态来精确、
本文系统梳理了贝叶斯统计的核心概念。首先介绍了联合概率和条件概率的定义与关系,指出条件概率蕴含联合概率。接着通过条件概率推导出贝叶斯公式的基本形式,展示概率事件的相互转换关系。然后结合全概率公式,将贝叶斯公式扩展到多事件互斥互补的情况。最后强调要灵活运用联合概率等式进行概率转换,掌握先验、后验概率的相互推导方法。全文清晰呈现了贝叶斯理论的基本框架和计算逻辑。
xj为在隐节点为网络输入,在输出点则为下层(隐)节点的输出(j=1,2…各种地质灾害都是在地球表层一定空间范围和一定时间限度内发生的,尽管不同种类的地质灾害之间、同一种类的地质灾害的不同个体之间大都形态各异,形成机理也是千差万别,但它们都是灾害孕育环境与触发因子共同作用的结果,而这些都与空间信息密切相关,利用GIS技术不仅可以对各种地质灾害及其相关信息进行管理,而且可以从不同空间和时间的尺度上分析
音频压缩编码概述什么是音频信号人耳听觉系统三特性音频编码技术概览波形编码参数编码混合编码感知编码什么是音频信号通常,将人耳可以听到的信号,叫做音频信号(20Hz-20kHz)。人的发声器官能产生的频段在80-3400Hz左右。正常人说话的语音频段在300-3000Hz左右。人耳听觉系统三特性人耳对不同频率的灵敏度不同。在2-5KHz的频段信息很容易被人耳听到。频率遮蔽效应(FME)。高频信息和低频
视觉SLAM中会用到一些概率论相关的知识,此处介绍了一下贝叶斯公式相关的理论知识
在交换机设计中,CAM(内容可寻址存储器)芯片的选型直接影响MAC地址学习的效率和系统性能,需综合考虑。TCAM(三态内容寻址存储器)与BCAM(二进制内容寻址存储器)因特性差异,适用场景显著不同。
<?xml version="1.0" encoding="UTF-8"?><beans xmlns="http://www.springframework.org/schema/beans"xmlns:mvc="http://www.springframework.org/schema/mvc"xmlns:context="http://www.springframework.
自定义mybatis底层:报这个错误的原因可能是因为网络不好或者没有连接网络
1 简介遗传算法(GeneticAlgorithm,GA)是一种受人工生命启发,模拟生物进化过程的随机搜索算法。遗传算法的理论及应用的研究受到广大研究者们的重视,应用领域也得到了广泛推广。遗传算法在求解函数优化问题时,算法中的控制参数交叉概率Pc和变异概率Pm取值的选择对遗传算法的性能影响很大,目前,普遍接受的Pc和Pm取值范围分别是0.4~0.99和0.0001~0.1,这两个取值范围的合理性以
一. 基础知识1. 马尔可夫假设马尔可夫过程(Markov Process)是一种随机过程,其中系统的未来状态只依赖于当前状态,而与过去的状态无关2. 高斯分布的KL散度KL散度(Kullback-Leibler Divergence)是一种衡量两个概率分布之间差异的指标, 取值范围是[0,+∞][0, +\infty][0,+∞], 越小说明两个概率分布越相似KL散度的定义KL散度的定义为两个概
在研究两组数据之间的关联性时会用到的一些概念。1. 协方差(Covariance) 和协方差矩阵协方差表示的是两个变量的总体的误差,这与只表示一个变量误差的方差不同。 如果两个变量的变化趋势一致,也就是说如果其中一个大于自身的期望值,另外一个也大于自身的期望值,那么两个变量之间的协方差就是正值。 如果两个变量的变化趋势相反,即其中一个大于自身的期望值,另外一个却小于自身的期望值,那么两个变量之间的
异常检测定义与应用高斯分布异常检测算法对模型进行评估异常检测VS监督学习对数据处理多元高斯分布多元和多个一元高斯分布模型区别补充内容:Σ\SigmaΣ和μ\muμ对模型的影响定义与应用异常检测就是在样本集中发现与绝大部分相异的样本点,也就是离群样本。可用于检测计算机系统异常,检测飞机系统异常等。高斯分布高斯分布也称正态分布,若一个随机变量X服从高斯分布,记为:x∼N(μ,σ2)x \sim N(
概率与分布(Probability and Distributions)(中)6.4 概括性统计和独立性我们通常对概括随机变量集和比较随机变量对感兴趣。随机变量的统计量是该随机变量确定的函数。分布的概括性统计量为随机变量的行为提供了一个有用的视角,顾名思义,它用数字概括和描述分布。我们将描述均值和方差这两个众所周知的概括性统计量。然后讨论比较一对随机变量的两种方法:一是如何说明两个随机变量是独立的
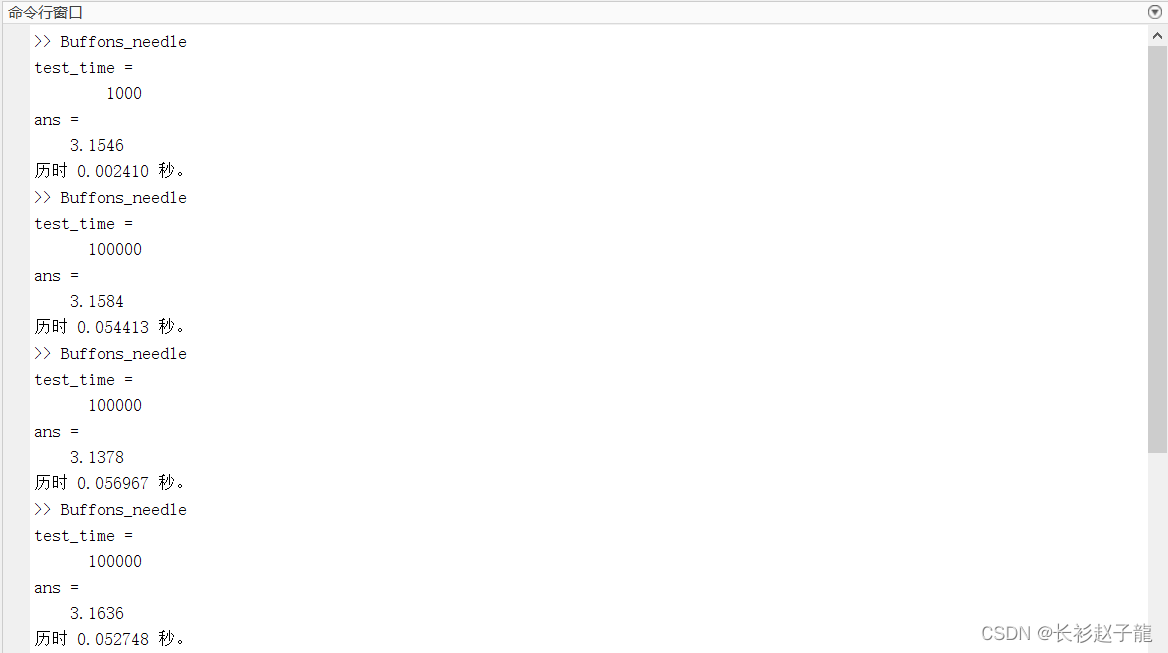
蒲丰投针问题的仿真实验
在联邦学习场景下,各方的数据理应不为同分布,即不满足iid,因此在模拟时不能随机进行数据分配,应该适当调整下发给各client的数据分布。本文借鉴论文:FLTrust: Byzantine-robust Federated Learning via Trust Bootstrapping 中的数据分配方法。在文中,q 决定 某一group所有clients 最大类出现的概率。唯一的缺点是 除了第
3.4.参数估计3.4.1.矩估计样本矩:样本矩依概率收敛于相应的总体矩期望实际上是一阶矩统计一阶样本矩:方差实际上是二阶中心矩统计二阶样本矩:阶样本矩:3.4.2.极大似然估计离散型:连续型:极大似然估计:要求参数θ使得抽到样本的联合概率最大,也就是把θ看成变量,求函数L(θ)的最大值,求极值的做法通常就是求导:由于函数L(θ)是连乘的形式,不好求解,因此把连乘变成连加,套路就是取.
一、实验要求在计算机上验证和测试k-means聚类和高斯混合模型聚类实验,sklearn的相关聚类算法。实验目的1、掌握k-means聚类算法的原理2、掌握高斯混合模型聚类算法的原理;3、掌握sklearn如何实现聚类;三、实验内容实验步骤请根据cluster文件代码,根据K均值聚类算法的原理,有两种初始化方法,一种是随机中心点,一种是随即分类,请修改代码实现另一种初始化也就是随机分类代码,然后观
在数据挖掘中,异常检测(英语:anomaly detection)对不匹配预期模式或数据集中其他项目的项目、事件或观测值的识别。 通常异常项目会转变成银行欺诈、结构缺陷、医疗问题、文本错误等类型的问题。异常也被称为离群值、新奇、噪声、偏差和例外。
1、离散型随机变量若使X取4,5,6时的连乘概率最大,则P取0.5;2、连续型随机变量若是概率值f(x)连乘结果最大,则绿线u=100时满足条件。在现实中,通过使f(x)连乘结果最大,对u进行估计,即最大似然估计。...
第1关:概率基础之贝叶斯1、假设有两碗曲奇饼,碗A包含30个香草曲奇饼和10个巧克力曲奇饼,碗B这两种曲奇饼各20个。 现在假设你在不看的情况下随机地挑一个碗拿一块饼,得到了一块香草曲奇饼。从碗A渠道香草曲奇饼的概率是多少?A、0.6B、0.2C、0.4D、0.3答案:A2、假设一个学校里有60%男生和40%女生。女生穿裤子的人数和穿裙子的人数相等,所有男生穿裤子。一个人在远处随机看到了一个穿裤子
核密度估计(Kernel Density Estimation)定义核密度估计是估计随机变量的概率密度函数的非参数方法,即一种针对连续数据的密度估计方法,并且其根据数据本身的相互关系得到,无需对数据分布做假设。假设样本彼此独立并遵循相同的分布。给定带宽H,每个样本都由平滑的核函数拟合。某数据的密度值可以视为其他所有样本对该数据的平均影响。这里以高斯kernel为例。KDE对于数据里的每一个点,都画
变量替换是一种在统计学和数学中广泛应用的技术,它通过定义新的变量来简化问题,使得原本复杂的随机变量变得更加容易分析。变量替换的公式,用于将一个随机变量 XXX 的概率密度函数 fXf_XfX 转换为其经过函数 ggg 变换后的随机变量 Y=g(X)Y=g(X)Y=g(X) 的概率密度函数 fYf_YfY。定理(变量替换公式)设 XXX 是一个概率密度函数为 fXf_XfX 的连续型随机变量,
6. 欧拉定理 快速模幂1. 欧拉定理和Fermat定理欧拉定理(很重要!!!!!)定理(Euler定理)若(k,m)=1, 则 kφ(m)≡1(mod m)若(k,m)=1,\ 则\ k^{\varphi(m)}≡1(mod\ m)若(k,m)=1, 则 kφ(m)≡1(mod m)证明设置a1,a2,...,aφ(m)是模m的一个既约
本系列文章主要讲解 MEM/MBA 数学基础,系列文章总纲链接为:MEM/MBA 数学总纲1 排列组合1.1 加法原理和乘法原理:加法(分类)原理:如果完成一件事有 n 类办法,只要选择其中任何一类办法中的任何一种方法,就可以完成这件事.若第一类办法中有m1种不同的方法,第二类办法中有m2种不同的方法,......,第n类办法中有m [n]种不同的办法 ,那么完成这件事共有N =m1+m2 +..
数学建模中极为重要的一点数据可视化说白了就是为了使整篇数学建模文章中富有颜色色彩,使得整个文章好看赏心悦目,不那么单调。因此才需要有分析图的陪衬才能使让评委给你高分,一般一篇文章中绘制5至8个图不等。......
本篇复习一些机器学习和深度学习常用的概率论的基础知识,因为我发现有挺多人对这些东西都不了解,或者说忘了,所以,本篇文章,意在唤醒你那已经交还给老师的概率论基础记忆,以为下一篇文章做基础[数学基础——生成模型必备知识-哔哩哔哩]
两个随机变量 XX和 YY被称为独立的,如果它们满足以下条件:对于连续型随机变量:它们的联合概率密度函数f(x,y)可以表示为各自边缘概率密度函数的乘积:$$$$对于离散型随机变量:它们的联合概率质量函数P(X=x,Y=y)可以表示为各自边缘概率质量函数的乘积:$$$$
统计学习方法第四章 朴素贝叶斯法公式推导最大后验估计 贝叶斯估计
最近看《机器人学中的状态估计》和《概率机器人》过程中遇到点公式推导的困难,所以还是把基础打好吧,花1~2个月的时间复习一下数学知识,用博客记录下学习的过程。数学知识补充:1、线性代数、矩阵论教材+哈工大严质彬课程:https://www.bilibili.com/video/BV18s411W758/2、概率论与数理统计教材3、最优化4、现代控制工程算法知识补充:1、大话数据结构、LeetCode