登录社区云,与社区用户共同成长
邀请您加入社区
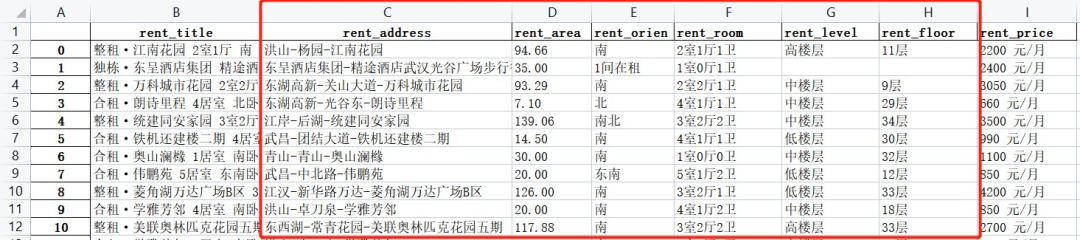
我们希望得到的效果是在地图上标注出各个房源的地点,具体地,使用经纬度与地图上的位置进行匹配,并用散点标记,点的大小表示房屋的面积rent_area,颜色表示楼层高度等级rent_level,房屋的户型、租金和楼层数在点的标签里进行展示。在jupyter notebook中的展示结果如下,我们可以滑动鼠标进行区域的放缩,也可以将鼠标移动至感兴趣的位置,查看对应的房源信息,这样房屋的地理位置、周围环境
昨天还运行的好好的代码,今天就报错。代码如下:importpandasaspdimportjsonresult ='result.json'df=pd.read_json(result)print(df.category.value_counts())先是报了个ValueError: Expected object or value百度了很...
pd.__version__#查看版本号原因是pandas在0.21的版本才加入了columns关键字,之前的版本是没有的。用下面这个命令更新Pandaspip install --upgrade pandas再次运行就不报错了...
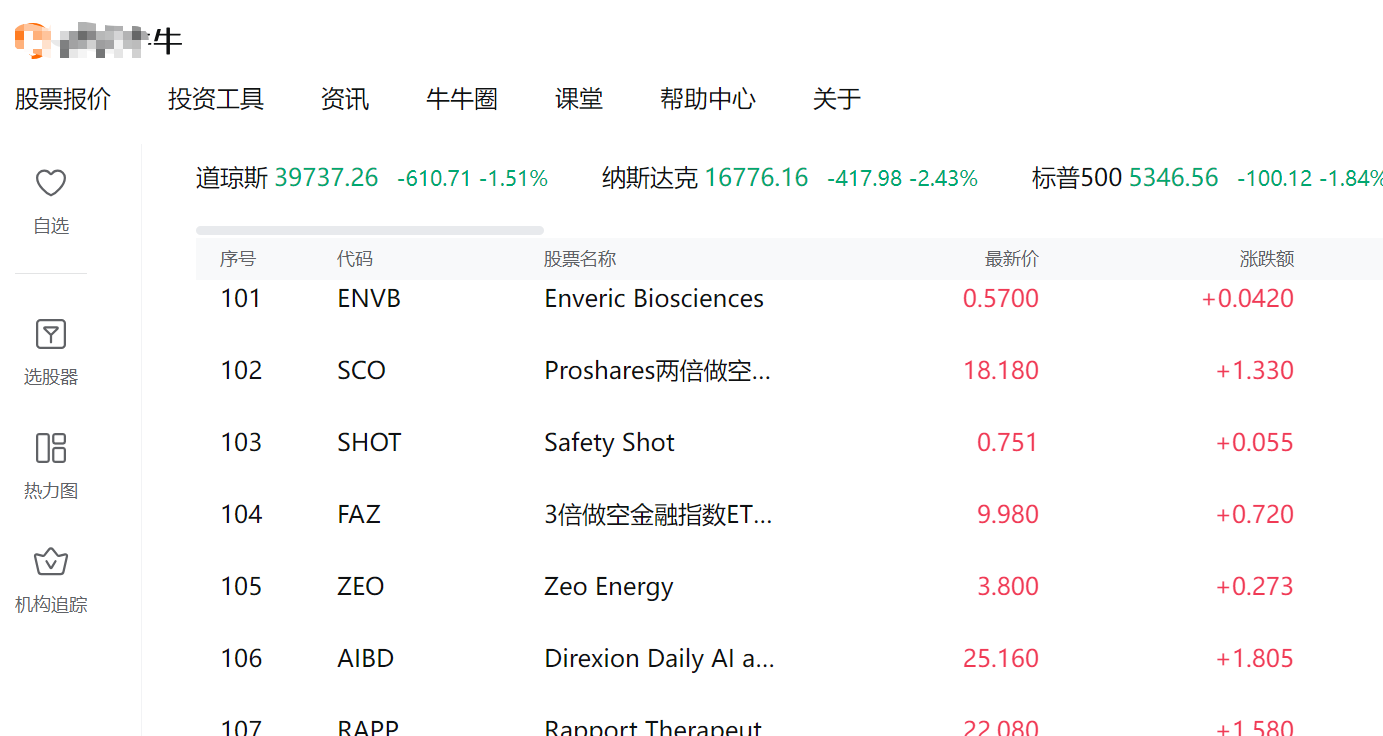
富途牛牛js逆向分析 获取股票实时数据
KNN算法案例
是的,Django、Flask、NumPy、Pandas等Python库都可以在PyCharm社区版中使用。PyCharm是一款强大的Python集成开发环境(IDE),支持管理Python项目、代码调试、版本控制和代码分析等功能,并且支持广泛的Python库。在PyCharm中,您可以使用pip安装所需的库,然后将它们导入到您的Python代码中。...
爬虫 :一段自动抓取互联网信息的程序,从互联网上抓取对于我们有价值的信息。 Python 爬虫架构主要由五个部分组成,分别是调度器、URL管理器、网页下载器、网页解析器、应用程序(爬取的有价值数据)。............
RESTful(Representational State Transfer)是一种基于HTTP协议设计网络应用程序接口(API)的架构风格,由Roy Fielding在2000年的博士论文中提出。其核心思想是以资源为中心,通过统一的接口对资源进行操作,实现客户端与服务器的解耦也就是RESTful是基于http定义了一组接口格式规范,用来规范所有http请求。
和这个标准圆的半径上的差值就形成了上面的小圆,所以每个小圆的所引入的频率的叠加,就构成了最终的圆度波形。
本文由chatgpt生成,文章没有在chatgpt生成的基础上进行任何的修改。以上只是chatgpt能力的冰山一角。作为通用的Aigc大模型,只是展现它原本的实力。对于颠覆工作方式的ChatGPT,应该选择拥抱而不是抗拒,未来属于“会用”AI的人。🧡AI职场汇报智能办公文案写作效率提升教程 🧡专注于AI+职场+办公方向。下图是课程的整体大纲下图是AI职场汇报智能办公文案写作效率提升教程中用到的
多个geojson转换坐标并合并一个shp
在处理数据时,有时可能会遇到重复项值的情况。例如,在一个表格中,一个人可能被列出多次,或由于数据输入重复,同一时间可能会有多个记录。在这种情况下,合并重复项是很必要的,以便更有效地分析数据,并提高性能。本文由chatgpt生成,文章没有在chatgpt生成的基础上进行任何的修改。以上只是chatgpt能力的冰山一角。作为通用的Aigc大模型,只是展现它原本的实力。对于颠覆工作方式的ChatGPT,
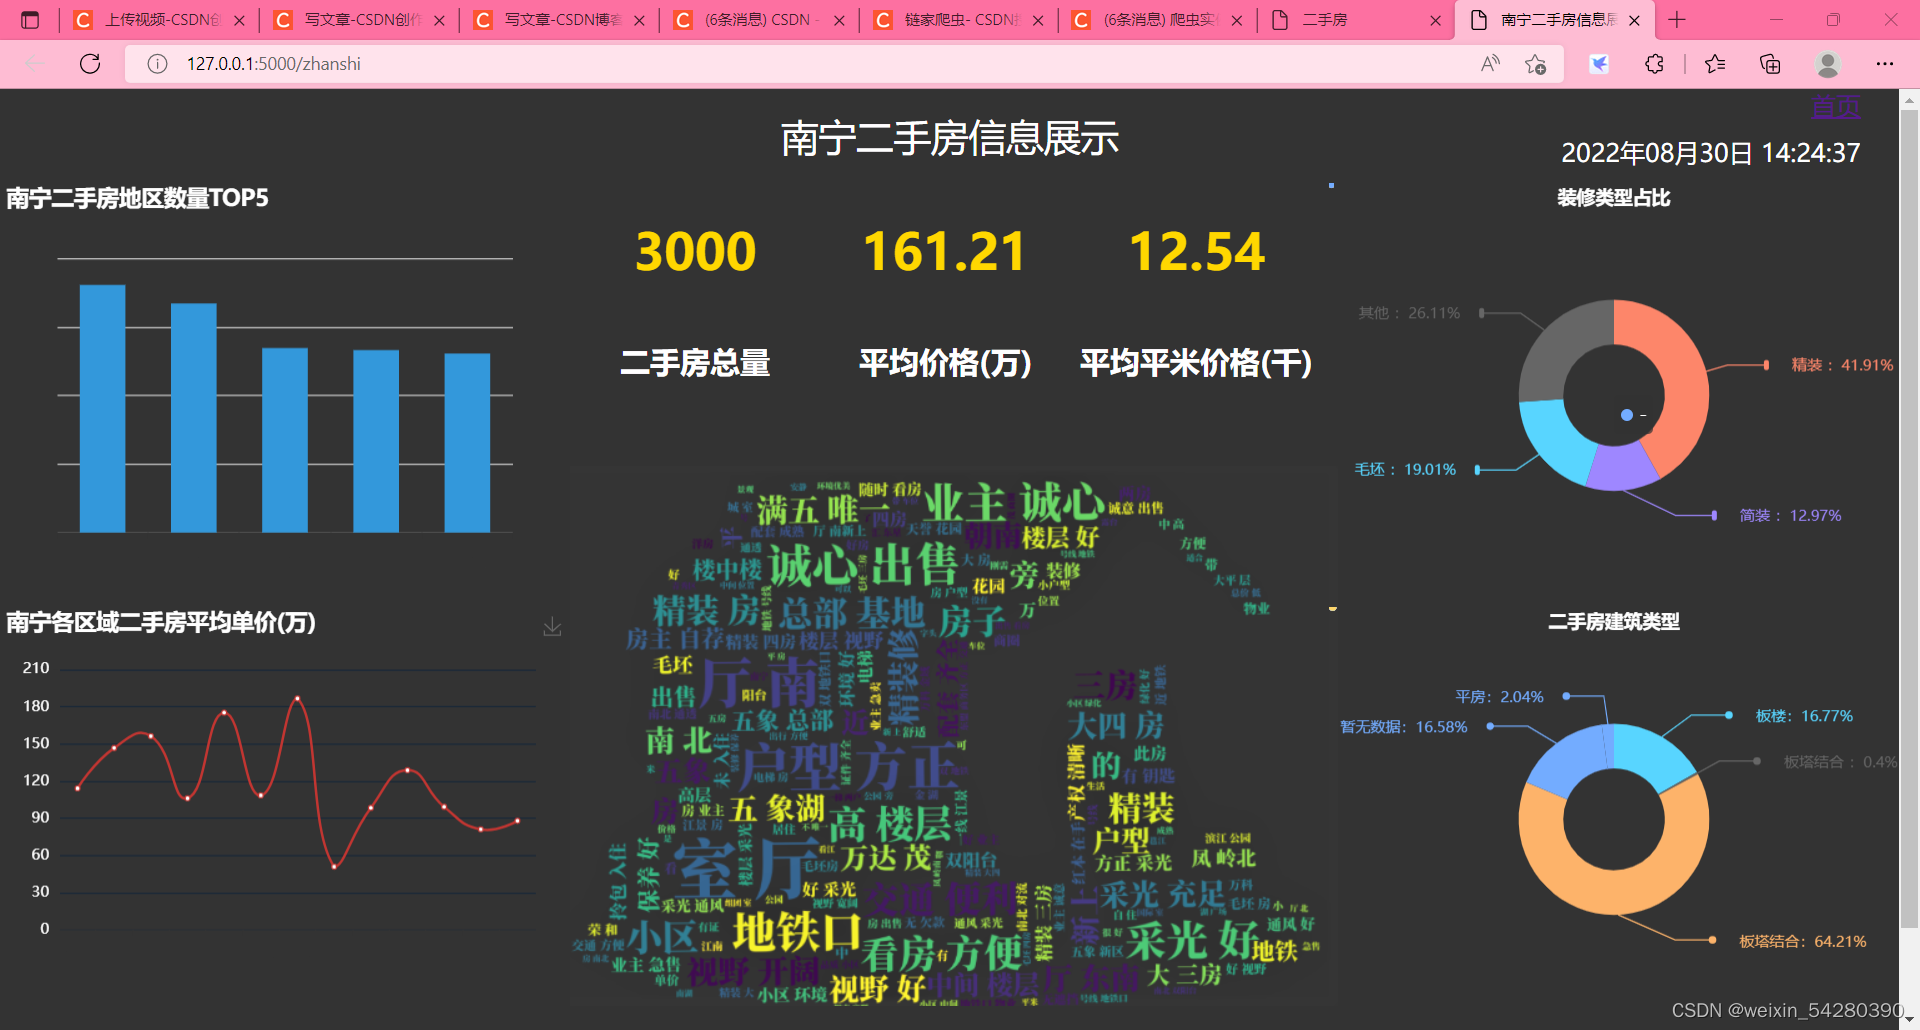
文章目录前言一、基本库介绍二、具体实现步骤1.引入库和请求头的初始化2.获取移动端接口的数据3.存储和解析4.获取多页数据5.可视化数据总结前言写过各种爬虫代码,但一直没有写过具体的实现过程,现分享一个简单的爬虫实现过程,其它复杂的爬虫也能举一反三,下面爬取的是一个售房网站一、基本库介绍示例:requests是python的一个三方扩展库,可用pip直接安装,或者手动在pypi下载后使用pip离线
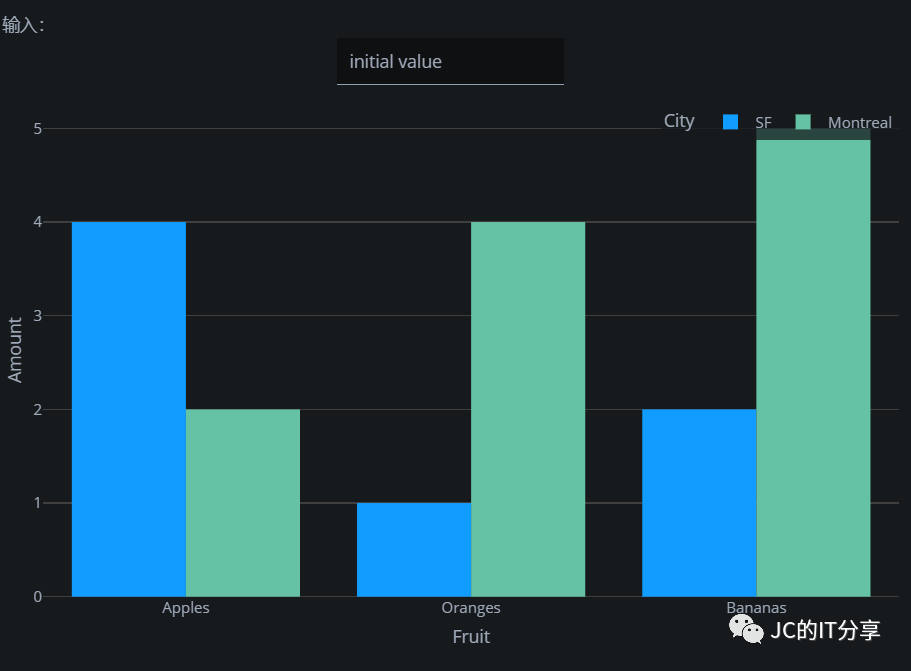
其建立在 Plotly.js、React 和 Flask 之上,将现代 UI 元素如下拉框、滑块和图形直接与 Python 代码绑定,以帮助开发人员快速构建强大的应用程序,同时Dash也保持了Python的全部灵活性。这里说明一下,一般来说构建一个数据分析应用都是要依赖于其他库的,例如Pandas和Numpy,因此,如果有没用过这两个库的小伙伴,也安装一下,以便于日后的数据分析!最近在做可视化相关
请问有大佬可以解决这个问题吗。想降序排列,代码是这样的。
# 利用Python实现爬虫,包括pandas库的read_html()方法、requests库和Scrapy库
Pandas中有一种特殊的数据类型叫做category。它表示的是一个类别,一般用在统计分类中,比如性别,血型,分类,级别等等。有点像java中的enum。今天给大家详细讲解一下category的用法。
文章目录一、Kmeans算法及其优缺点1.简单介绍2.K-means的优点与缺点二、性能指标1.选择K值手肘法轮廓系数CH指标sklearn提供的方法2.其他性能指标资料整理一、Kmeans算法及其优缺点跳过算法原理1.简单介绍Kmeans算法是基于划分的聚类算法,其优化目标是同类的点尽量近,类间的点尽量远。需要做的是(1)给定聚类个数K(2)选择K个初始点,可以是随机值,也可以是随机的样本点(3
😽爬取近3个月绵阳市的降水量数据,并存储在文档中。利用和爬虫技术获取数据,利用把数据存储到文档中。⚠️示例:pandas 是基于NumPy 的一种工具,该工具是为了解决数据分析任务而创建的。😿打开中国天气网的数据,发现只有40天的选项里能更全面的显示降水量,但是只能显示一个月的,我需要找到其他月份的数据😹发现这边可以选择月份,初步认为当我选择月份的时候,会触发某些函数事件而返回数据。打开开发
中考批量查分脚本
随着信息技术的快速发展和互联网的普及,旅游行业也迎来了数字化和智能化的变革。数据覆盖了一年的12个月,出游次数分别为:1月39次,2月54次,3月56次,4月81次,5月55次,6月40次,7月55次,8月63次,9月64次,10月78次,11月52次,12月53次。8月和9月的出游次数也较高,分别为63次和64次,这可能与暑期有关,暑假期间学校放假,家庭出游较为集中。出游时间的分析结果为旅游市场
元宇宙是人类运用数字技术构建的,由现实世界映射或超越现实世界,可与现实世界交互的虚拟世界 ,具备新型社会体系的数字生活空间。“元宇宙”本身并不是新技术,而是集成了一大批现有技术,包括5G、云计算、人工智能、虚拟现实、区块链、数字货币、物联网、人机交互等。
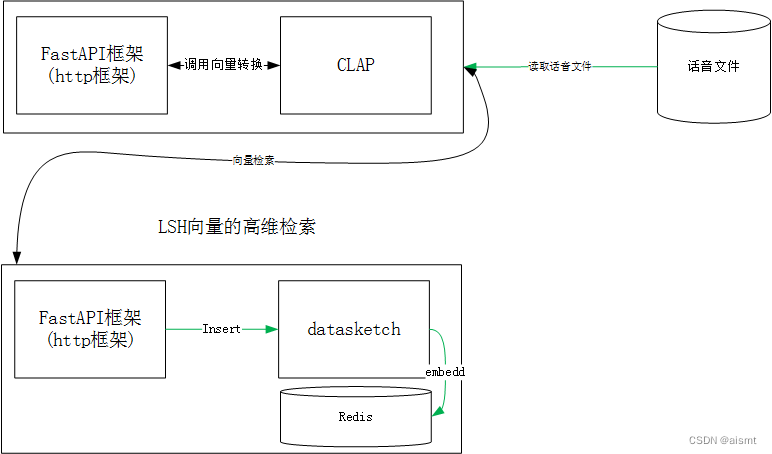
基于CLAP 和 datasketch 音频文件向量检索
Pandas进行数据清洗的方法介绍,数据清洗是一项复杂且繁琐的工作,同时也是整个数据分析过程中最为重要的环节。Pandas中常见的数据清洗操作有空值和缺失值的处理、重复值的处理、异常值的处理、统一数据格式等。
对 CircR2Disease v2.0 进行数据清洗产生circRNA-disease关联矩阵的方法circRNA-disease关联矩阵 是通过机器学习方法和深度学习方法预测与疾病存有潜在关联的circRNA所必须要的数据材料, 借此,基于最新记录关联数据的数据库 CircR2Disease v2.0 向大家介绍一种通过pandas进行数据清洗产生circRNA-disease 关联矩阵的方法
csv文件转为xml文件
来源:数据分析与统计学之美今天我们重新盘点66个Pandas函数合集,包括数据预览、数值数据操作、文本数据操作、行/列操作等等,涉及“数据清洗”的方方面面。Pandas 是基于NumPy的一种工具,该工具是为解决数据分析任务而创建的。它提供了大量能使我们快速便捷地处理数据的函数和方法。数据预览对于探索性数据分析来说,做数据分析前需要先看一下数据的总体概况。info()方法用来查看数据集信息,des
文章目录一、快餐数据1.1 探索数据1.1.1 数据表一共多少行数据?有多少列1.1.2 是否存在缺失值?哪个字段?1.1.3 数据去重操作1.2 描述性统计1.2.1 被下单数最多的前五的商品(item_name)有哪些?1.2.2 在item_name这列中,一共有多少商品被下单?1.2.3 商品下单总数量是多少?1.2.4 目前item_price数据类型为?如何转换为浮点数?1.2.5 在
数据清洗(Data Cleaning)是指对数据进行检测和修正的过程.数据往往会有缺失值、异常值或者不一致的格式,清洗数据的目的是提高数据的质量,使得后续的分析和建模更加准确.
空值,异常值,重复值,类型转换和数据整合
清洗数据是数据预处理的一个重要步骤,Pandas 提供了许多功能和方法来帮助您进行数据清洗。以下是一般情况下使用 Pandas 清洗数据的常见步骤:
数据清洗是对一些没有用的数据进行处理的过程。很多数据集存在数据缺失、数据格式错误、错误数据或重复数据的情况,如果要对使数据分析更加准确,就需要对这些没有用的数据进行处理。在这个教程中,我们将利用 Pandas包来进行数据清洗。
qcut()函数也能将一组连续的数据分成若干个离散的区间,与cut()函数不同的是,它能自动根据数据的分布情况,将数据划分成n个等频的区间。比如要把数据分为四份,则四段分别是数据的0-25%,25%-50%,50%-75%,75%-100%,每个间隔段里的元素个数尽可能都是相同的。cut()函数可以帮助我们将一组连续的数值数据分成若干个离散的区间,主要用于对数据从最大值到最小值进行等距划分。
数据清洗是数据分析和建模的基础工作,目标是将原始数据转化为一致、准确和完整的形式。Pandas 提供了强大的数据操作工具,可以高效完成各种数据清洗任务。以下是利用 Pandas 进行数据清洗的详细步骤和方法。Pandas 提供了系统化、灵活且高效的数据清洗工具,能够满足各种数据清洗需求。熟练掌握 Pandas 的清洗功能,可以为后续的数据分析和建模打下坚实的基础!进行灵活的类型转换。
pandas数据清洗函数大全
【代码】Python入门——Pandas之数据清洗。
【代码】python解析返回值类型为xml的数据接口。
前言上一次我们已经学习了Pandas的基础知识,接下来让我们一起继续探索Pandas的魅力吧~ - ~第一步当然是导入相应的库啦!import numpy as npimport pandas as pdfrom pandas import DataFrame好了,让我们开始这次清洗活动吧。GOGOGO!!!1 pandas处理空值首先我们先定义一个名叫df的二维数组,并把它的第3行第4列变为no
数据清洗的目的是修正异常值,以更好地进行运算和观察结果。通过Pandas对序列或数据帧的清洗分为两个步骤:异常检测和数据修正。1.异常检测Pandas中的空值用‘NaN’表示,可以通过调用isnull和notnull来检测序列对象和数据帧对象是否为异常值。import pandas as pddic = {'name': ['Tom', 'Tony', 'Jack'], 'age': [16, 1
轻松学习Pandas 数据清洗
在数据处理和分析过程中,数据清洗是至关重要的一步。Pandas是Python中用于数据处理和分析的强大库,提供了多种数据清洗方法。。
1.dataframe查看属性DataFrame.index DataFrame的索引(行标签)。DataFrame.columns DataFrame的列标签。DataFrame.dtypes 返回DataFrame中各列的dtypes。DataFrame.ftypes 返回DataFrame中的ftypes(稀疏/密集和dtype的指示)。DataFrame.get_dtype_counts(
pandas 笔记010目录pandas 笔记010十、数据清洗和预处理1. 处理缺失数据1.1 判断是否存在缺失值 isnull()1.2 丢弃缺失数据 dropna()1.3 填充缺失值 fillna()1.3.1 精确填充1.3.2 参数inplace=True1.3.3 参数method='ffill'1.3.4 参数limit2. 数据转换2.1 移除重复值2.1.1 duplicate
构造一个数据集,便于演示这些函数。import pandas as pddf = {'姓名': ['漩涡鸣人', '宇智波佐助', '旗木卡卡西', '春野樱', '宇智波鼬'],'性别': ['男', '男', 'men', 'women', '男'],'身份证': ['463895200003128433', '429475199912122345', '420934199110102311'
本篇介绍数据清洗的相关内容,包括删除数据、数据去重、缺失值处理三部分,这些都是拿到一个原始数据表之后很常用的操作。
数据分析工具Pandas(1):Pandas的数据结构数据分析工具Pandas(2):Pandas的索引操作数据分析工具Pandas(3):Pandas的对齐运算数据分析工具Pandas(4):Pandas的函数应用数据分析工具Pandas(5):Pandas的层级索引数据分析工具Pandas(6):Pandas统计计算和描述数据清洗数据清洗是数据分析关键的一步,直...
Pandas核心知识与实战系列文章
数据清洗:因为数据中出现了异常值,需要将异常值剔除。