登录社区云,与社区用户共同成长
邀请您加入社区
一款强大的AI产品—webotAI,它集AI聊天、AI写作和AI绘画于一身,为您提供全方位的智能服务。更智能的AI聊天,超清有趣的AI绘画,智能写作辅助办公。国内也能免费畅玩ChatGPT啦!
AIGC(AI Generated Content)技术,即人工智能生成内容的技术,具有非常广阔的发展前景。随着技术的不断进步,AIGC的应用范围和影响力都将显著扩大。以下是一些关于AIGC技术发展前景的预测和展望:1、AIGC技术将使得内容创造过程更加自动化,包括文章、报告、音乐、艺术作品等。这将极大地提高内容生产的效率,降低成本。2、在游戏、电影和虚拟现实等领域,AIGC技术将能够创造更加丰富
stable-diffusion-webui 界面汉化
更新到1.6之后,Stable Diffusion的WebUI多了三种采样器,简单测试了一下三种采样器效果,探索如何使用三种采样器,确定大概的CFG和步数值。
本文提供的方法主要用于缓解国内访问GitHub不稳定导致安装出现错误,以及通过使用国内的镜像提升安装包的安装速度,同时尽可能不影响原本的安装过程和使用体验。注:作者目前仅在Windows平台且有NIVIDA GPU的环境下部署,理论上Linux平台同样适用。若有问题,欢迎留言。注:由于stable-diffusion-webui官方的手动安装教程落后于版本,因此不建议遵照手动安装教程进行安装。
回到aotopanel页面,在tensorboard处即可查看。然后输入调用tensorboard指令。删除当前tensorboard进程。显示tensorboard进程。
从Stable Diffusion这一AI应用出现之后,在极短时间内就迅速走红,成为众多玩家口口相传的“最美小姐姐”生成工具。不过这一AI计算画图工具在Stable Diffusion官方推出之初,无论是WEB UI的部署还是模型的训练生成,都基本是基于NVIDIA CUDA加速的算法,因此A卡最初并不被Stable Diffusion官方支持。不过好在Stable Diffusion算是一个开源
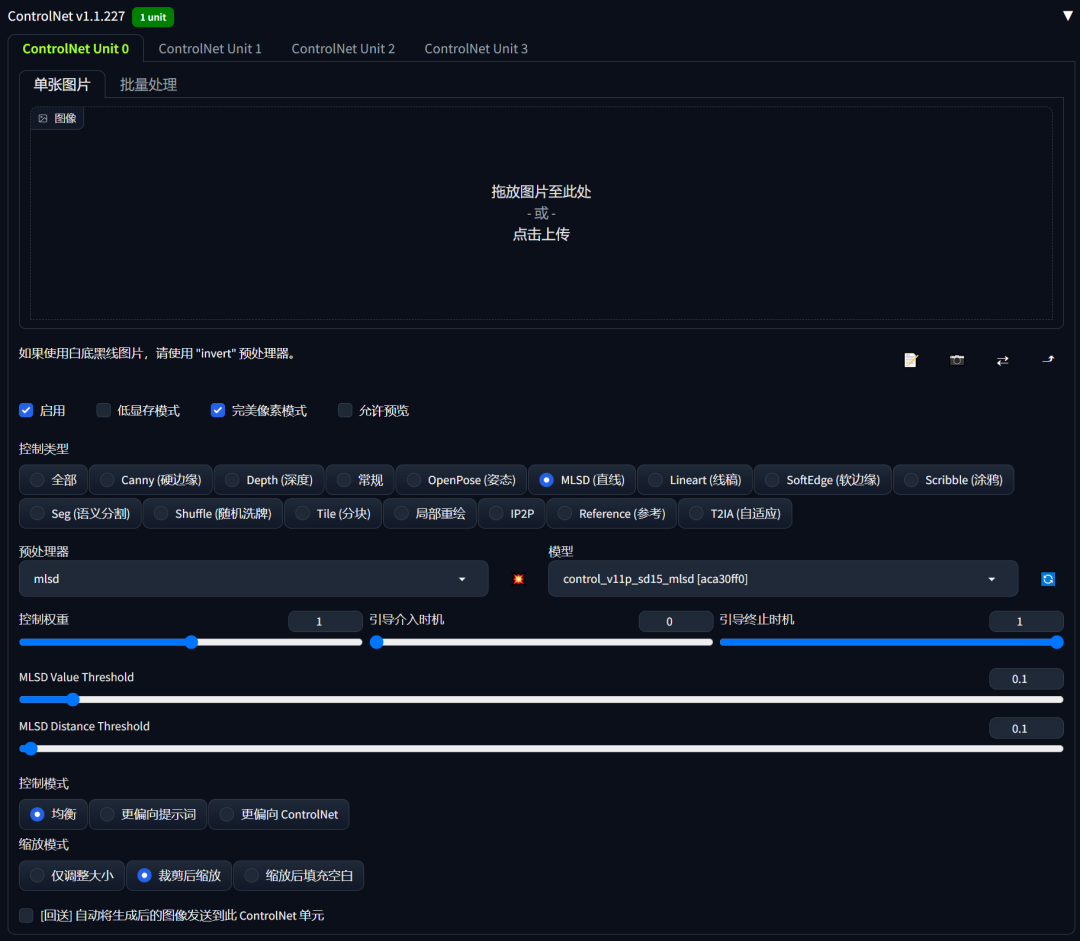
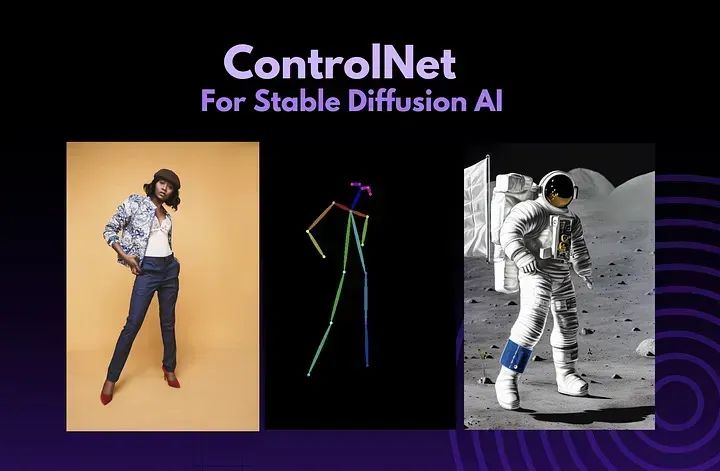
ControlNet是一种通过添加额外条件来控制。
以上是对使用StableDiffusion进行电商产品视觉制作的分享。虽然目前AI生成的图片仍需要使用第三方图片处理工具进行二次处理,但这已经极大地提高了我们的工作效率。写这篇文章的初衷,网上的Stable Diffusion教程太多了,但是我真正去学的时候发现,没有找到一个对小白友好的,被各种复杂的参数、模型的专业词汇劝退。所以在我学了之后,给大家带来了腾讯出品的Stable Diffusion
AIGC技术的未来发展前景广阔,随着人工智能技术的不断发展,AIGC技术也将不断提高。未来,AIGC技术将在游戏和计算领域得到更广泛的应用,使游戏和计算系统具有更高效、更智能、更灵活的特性。同时,AIGC技术也将与人工智能技术紧密结合,在更多的领域得到广泛应用,对程序员来说影响至关重要。未来,AIGC技术将继续得到提高,同时也将与人工智能技术紧密结合,在更多的领域得到广泛应用。感兴趣的小伙伴,赠送
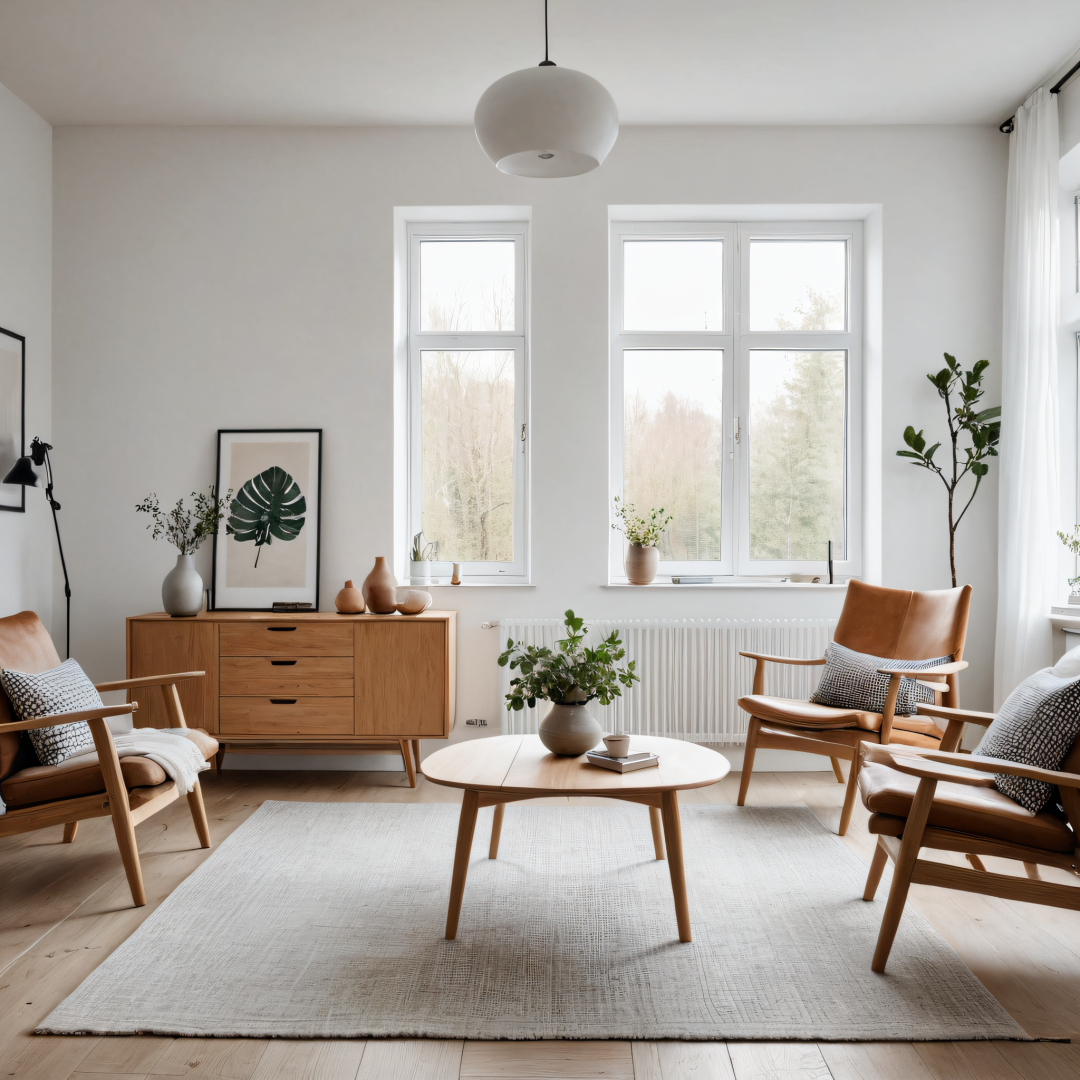
参数设置大模型Lightning采样器采样迭代步数:5CFG:2图片宽高:1024*1024反向提示词模型下载地址(文末网盘地址也可获取)LiblibAI提示词:简约的斯堪纳维亚客厅,自然光线充足,配有木制家具。
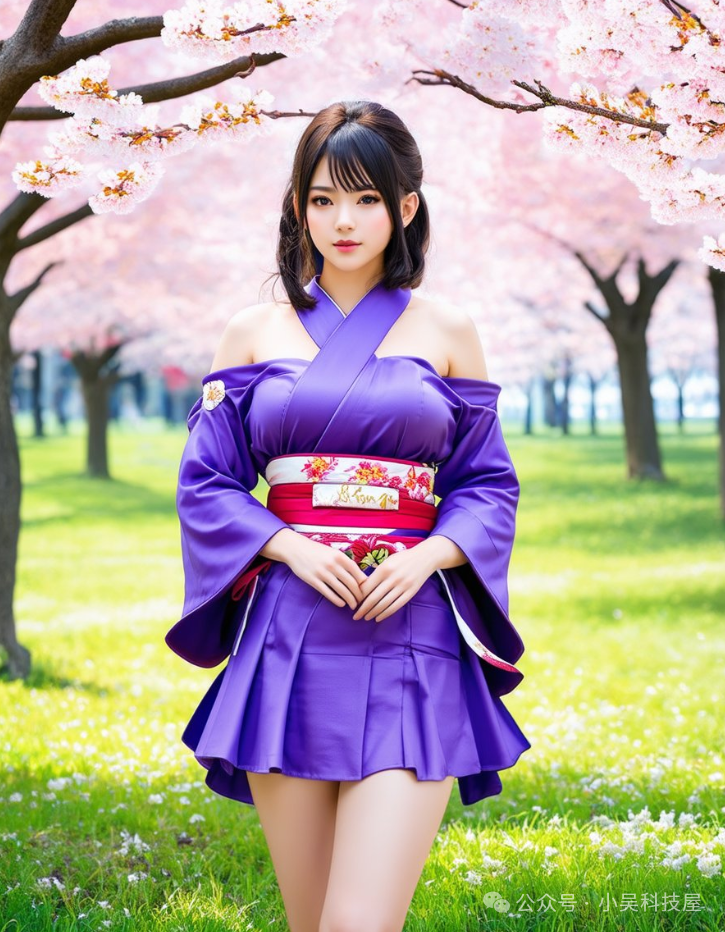
随着[AI技术]的飞速发展,AI绘画已经成为了艺术创作领域的新宠。而亚洲人物写实模型,以其绝美的颜值和青春靓丽的形象,成为了AI绘画领域的一大亮点。
当我学到一定基础,有自己的理解能力的时候,会去阅读一些前辈整理的书籍或者手写的笔记资料,这些笔记详细记载了他们对一些技术点的理解,这些理解是比较独到,可以学到不一样的思路。我们今天主要来讲讲图像编辑模型 cosxl_edit,这个模型相当于图生图,不同的是,这个模型只需要简单的提示词描述就可以对图片进行修改,不需要遮罩等一系列复杂的操作。AIGC所有方向的技术点做的整理,形成各个领域的知识点汇总,
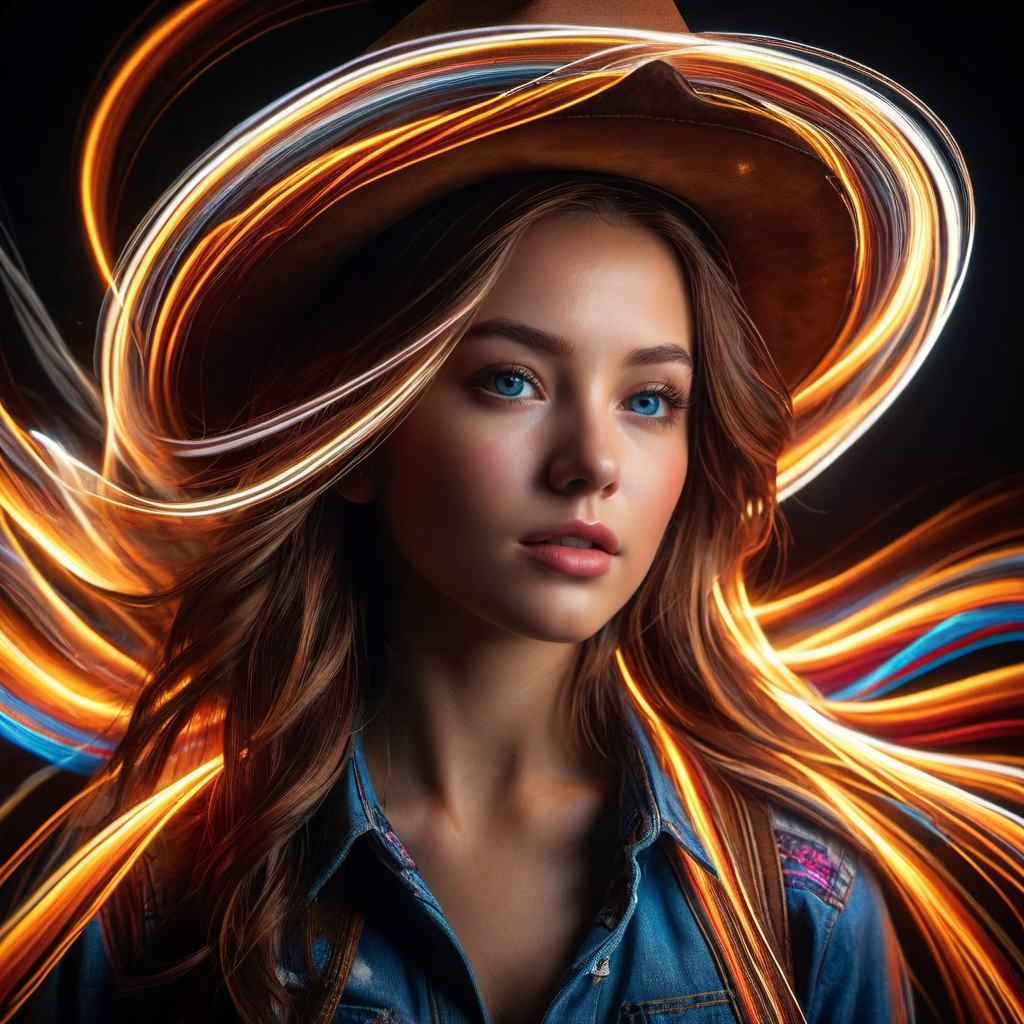
长曝光摄影。所谓长曝光摄影即长时间曝光摄影(Long exposure photography),是一种长时间开启快门的摄影技巧。通常对于快门时间慢于1秒的曝光都可以称之为长时间曝光。长曝光摄影手法常被用于夜间摄影、光迹摄影、水景摄影等,可以把光线暗的景色拍摄更清晰,也可以拍摄出如梦幻般的画面。感兴趣的小伙伴,赠送全套AIGC学习资料,包含AI绘画、AI人工智能等前沿科技教程和软件工具,具体看这里
你是否已经厌倦了传统的室内设计方式,想探索新方法来增强作品设计感?本期小编就同大家分享一个新武器,用Stable Diffusion的ControlNet来打造一个室内设计全新工作流。无论你是经验丰富的室内设计师还是初学小白,都将使你的日常工作如虎添翼、告别爆肝,焕发出令甲方爸爸们赞叹的设计感。#01/介绍ControlNet是一种通过添加额外条件来控制扩散模型的AI神经网络结构,它提供了一种增强
案例展示1.将一张效果图,将它重新导入ControlNet中;2.控制类型选择Seg(语义分割),在预处理器栏中我们可以看到有seg_ofade20k、seg_ofcoco、seg_ufade20k三种预处理器可供选择。seg_ofade20k和seg_ufade20k都使用了ADE20k协议,所以这两种预处理器识别图片中素材所用标记颜色是相同的。区别在于它们采用了不同的算法:OneFormer算
今天的介绍一款筑梦工业【写实摄影】梦幻泡影-Dreams and bubbles,这是一款亚洲面孔写实摄影模型,该模型在人物姿态和画面构图更加丰富、动感、有视觉吸引力,在人物的构图与自然语言方面理解方面都有不错的绘图效果。同时也包含了优秀的观影效果,如:夜晚和低光摄影、人像摄影、背景虚化效果等。能够直出青春靓丽亚洲女孩人物摄影效果,如学生、车模等。对于1.5模型在修手方案,依然是难题;关于修手方案
当我学到一定基础,有自己的理解能力的时候,会去阅读一些前辈整理的书籍或者手写的笔记资料,这些笔记详细记载了他们对一些技术点的理解,这些理解是比较独到,可以学到不一样的思路。AIGC所有方向的技术点做的整理,形成各个领域的知识点汇总,它的用处就在于,你可以按照下面的知识点去找对应的学习资源,保证自己学得较为全面。观看全面零基础学习视频,看视频学习是最快捷也是最有效果的方式,跟着视频中老师的思路,从基
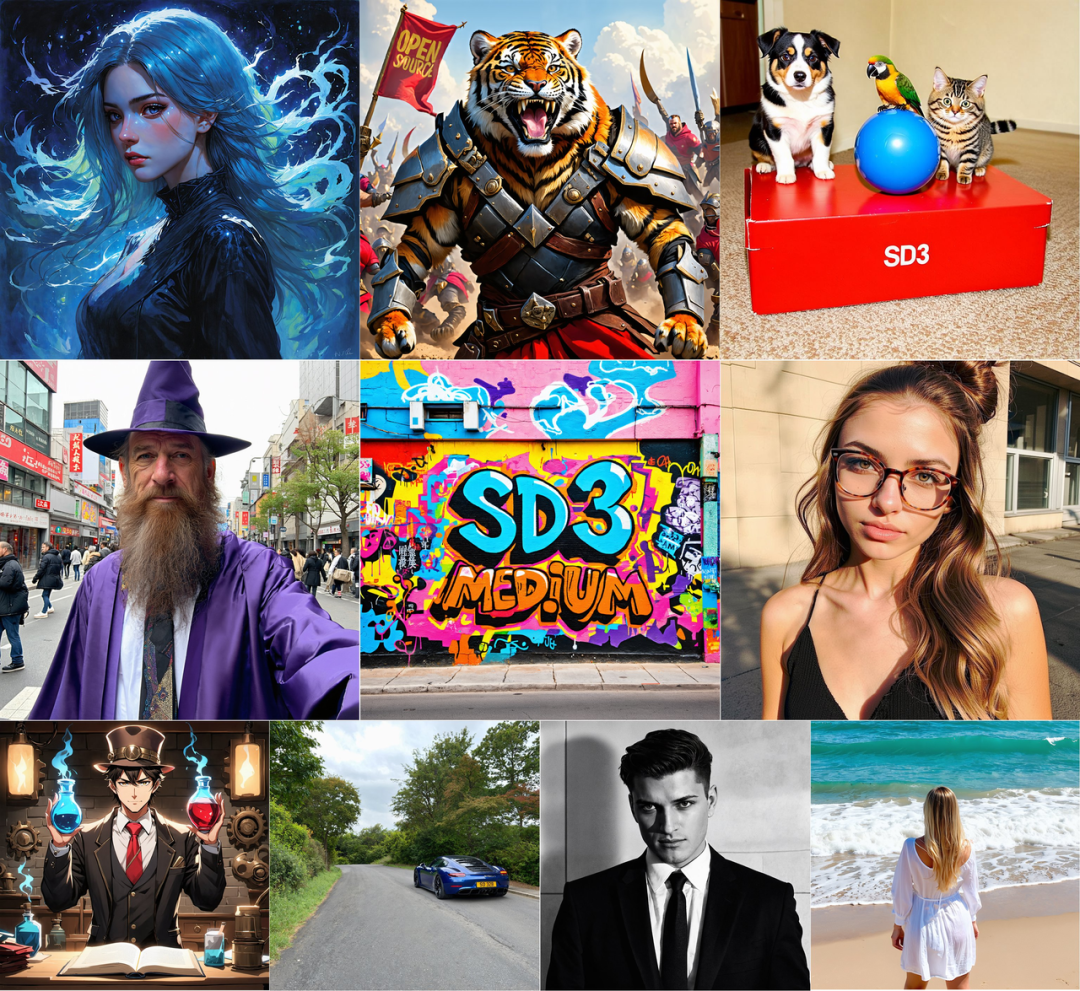
就在刚刚,Stable Diffusion 3 Medium 如约而至。几天前,Stability AI 在社交平台 X 上官宣,SD3 Medium 将在 6 月 12 日正式开源。
今天,我们将揭秘三款顶尖的AI视频生成工具——Synthesia.io、Magisto、和Aicbo,它们将彻底改变你对视频创作的传统认知,带你步入智能化视频制作的新纪元。用户只需上传原始视频片段和照片,选择一个风格主题,Magisto就会自动分析素材,识别关键画面,选取最佳镜头,并根据音乐节奏智能剪辑,添加过渡效果,生成一部富有感染力的视频短片。在AI的赋能下,视频创作的门槛被大大降低,每个人都
MiniCPM-V是一款官方称能够媲美GPT4V级的国产多模态视觉大模型。MiniCPM-V是面向图文理解的端侧多模态大模型系列。模型能够接受图像和文本输入,并提供高质量的文本输出。该系列模型中,最新版本是,也是其中最新、具有最佳性能的模型。• 模型总参数量 8B,能够实现单图、多图和视频理解性能超越了 GPT-4V。• 在单图理解上,它取得了优于GPT-4o mini、Gemini 1.5 Pr
Invoke 是一个领先的创意引擎,旨在为专业人士和爱好者提供支持。使用最新的 AI 驱动技术生成和创建令人惊叹的视觉媒体。Invoke 提供行业领先的基于 Web 的 UI,并作为多个商业产品的基础。
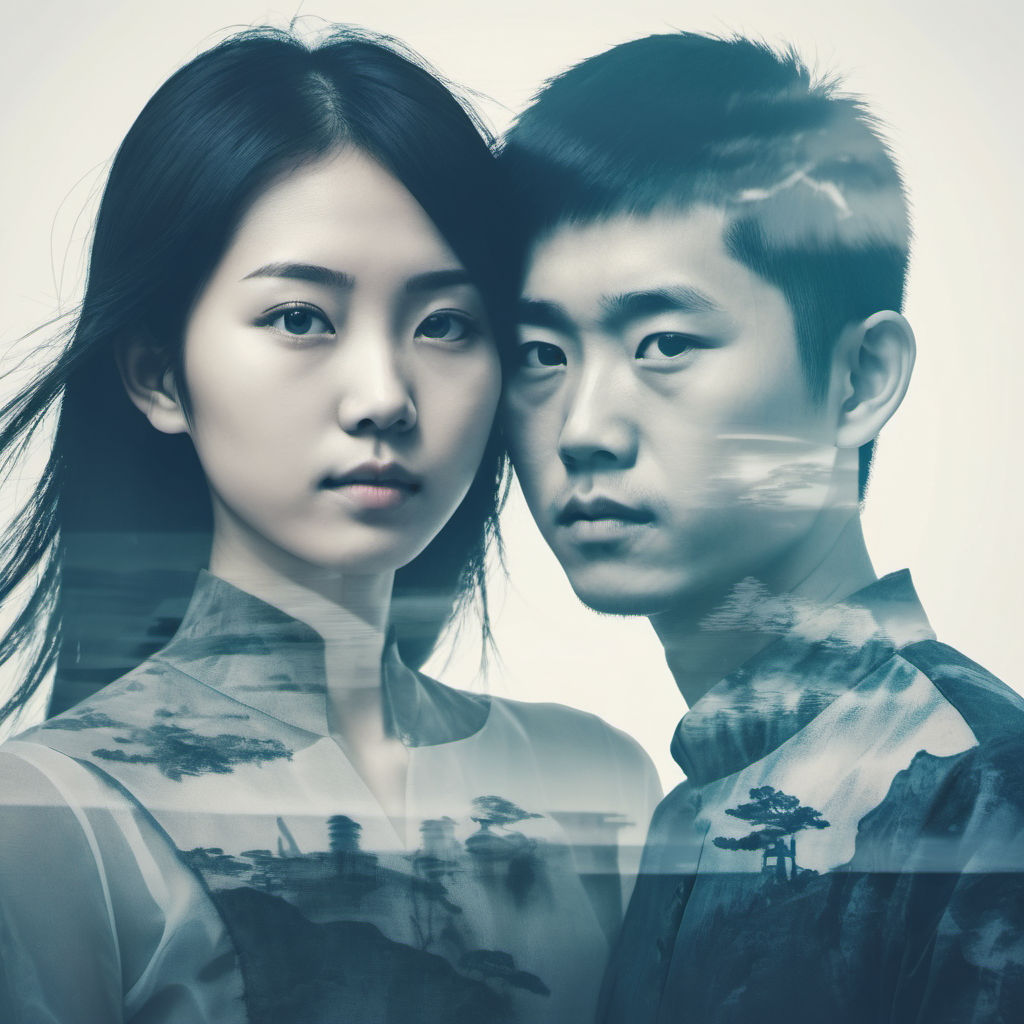
今天给大家介绍AIGC绘图提示语使用常见摄影手法:双重曝光。双重曝光摄影效果是一种摄影爱好所热衷的常见摄影手法之一。通过双重曝光摄影手法,能够为图同摄影图像引入神秘的意境感和一种难以言喻的视觉体验,带来一种如梦如幻和让人沉醉的摄影效果。在现实摄影中最早的实现手法为:将两张或多张图像叠加在一起实现双重曝光效果。当前进入数码摄影时代后,手机和数码产品都已经内置双重曝光的摄影手法,是的这一摄影手法的门槛
输入提示词:人有三宝,精气神有3种仙果是补精气神的,是哪三种呢?核桃是健脑的花生米是补心的花生,你看它有一个外壳,里边一个红的皮,花生长得像什么,像心脏啊,所以也称为长生谷,松子是补精的松子,在高山之上吸天地的凉气,这都是补身体的。养生赛道昨日有拆解了图文成片的制作流程,今日分享如何利用数字人做养生视频,这个账号仅仅做了15天就拥有12w粉丝,可以说是相当的不错。2.把上面的流程固定下来,就下一步
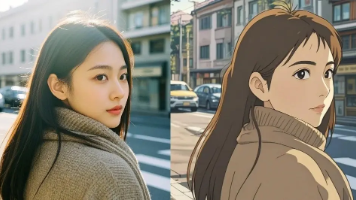
最近全网都在疯传的吉卜力滤镜,不用苦等GPT-4o了,一方面GPT-4o使用门槛较高,另一方面还经常服务繁忙。使用以下这几款国产AI工具也能让你轻松生成吉卜力风格图片。
(有linux经验的可以看:CMP 40HX的Nvidia驱动程序,原生驱动程序只有460.35.1-490这几个可以,再高或者再低的版本,就不支持了。总之说这么多,就是驱动很难搞。华硕CMP 40HX硬体上占用二个半槽位,卡长接近24cm,如果补完电容后,是pcie 16x通道的,所以在入手前先要自己评估一下安装条件。特别是pcie通道不如硬体一样,一眼能看出来的,很多显卡在4x或者8x上也能正
【Stable Diffusion】SVD Forge使用详解 | 图像生成视频 | Stable Forge详细介绍SVD的界面,参数,功能模型地址:https://civitai.com/models/207992/stable-video-diffusion-svd...
在当今数字化时代,图像处理技术已成为各行各业不可或缺的工具。SDXLControlnetTileV2作为一款先进的图像增强模型,不仅提供了高清分辨率,还允许用户实现更灵活和可控的图像处理。本文将详细介绍SDXLControlnetTileV2的特点,并为您提供使用ComfyUI操作指南,帮助您充分利用这款强大的图像增强工具。近日模型更新到 V2 版本了,这是一款现实逼真绘图 Controlnet
如果你是真正有耐心想花功夫学一门技术去改变现状,我可以把这套AI教程无偿分享给你,包含了。
综上所述,AI机西作为一款免费的AI图像生成软件,凭借其简单易用的特性和强大的功能,成为内容创作者的理想选择。无论你是专业人士还是初学者,这款工具都能帮助你轻松提升创作效率和作品质量。建议有兴趣的用户立即尝试AI机西,利用这款工具提升自己的创作能力。
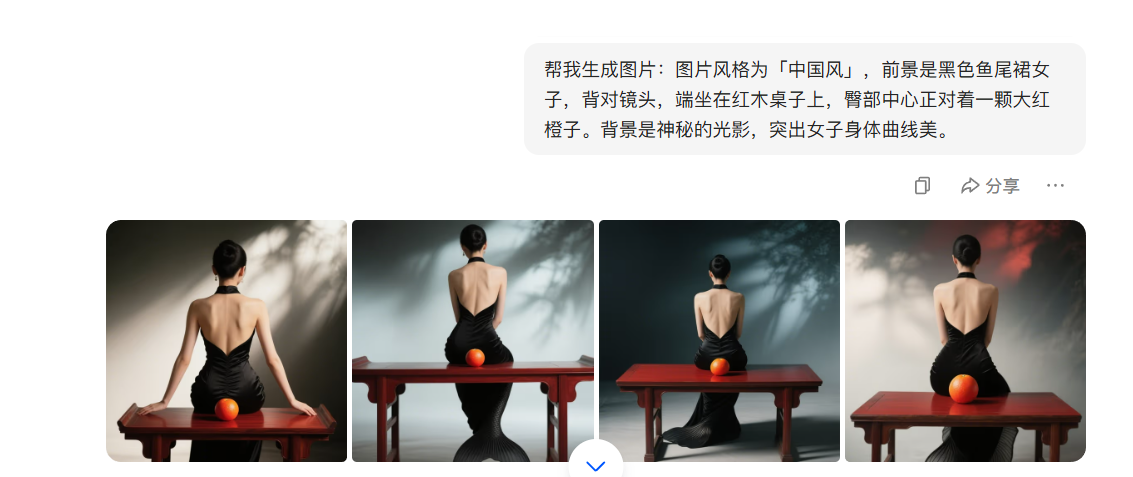
风格体验最好的是,【港风】,是动漫绘画风格,处于写实和二次元之间,【中国风】是写实风格。说到prompt自然有两种风格,第一种是自然语言描述,富有连贯性和确定的画面。第二种是AI绘画开始时采用的关键词方式,各种词语的堆砌,不确定画面。这是我体验了通义千问,腾讯元宝,智谱清言,SDhuggingface,MDhuggingface,kreaAI等等软件的。在写prompt前,可以先确定【比例】,【风
强化学习中的数据增强:一项突破性进展本文来自加州大学伯克利分校和纽约大学的 Michael Laskin、Kimin Li 等人。文章提出了一种将数据增强应用于强化学习的全新方法,并宣称其效果显著,甚至超越了近五年来强化学习领域的大部分研究成果。文章首先回顾了强化学习的基本概念:一个智能体在一个环境中,通过反复与环境交互来学习解决优化问题。以“步行者任务”为例,智能体需要通过反复尝试,学习如何..
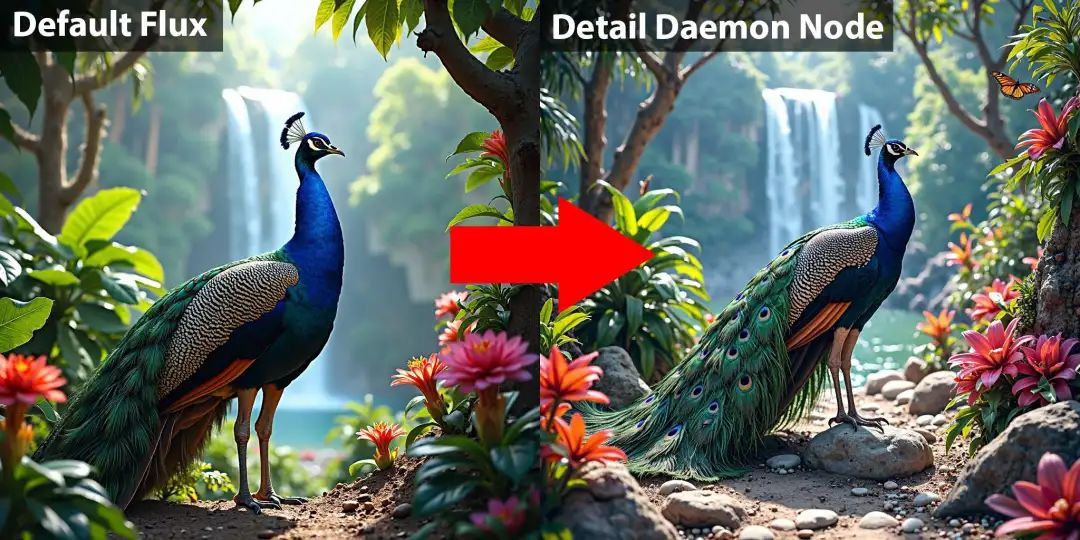
comfyui教程:ComfyUI-Detail-Daemon将muerrilla的sd-webui-Detail-Daemon移植为ComfyUI的节点。通过调整生成过程中的sigma值,该工具帮助用户在生成高分辨率图像时实现更精细的细节控制。增加flux生成图像的细节,使其更丰富和真实!工作流链接在文章最后。
本文介绍了如何使用ComfyUI的Mv-Adapter插件从单张图像生成多视角图像。文章详细描述了实现环境、工作流内容及模型选择,包括提示词反推、抠图、多视图生成、图像修复等步骤。通过Mv-Adapter生成768x768尺寸的多视图图像,并结合ControlNet和脸部修复流程提升图像质量。文章还提供了ComfyUI的学习资料,帮助用户掌握AI绘画技术。
Omost,作为ControlNet作者倾力打造的创新项目,标志着图像生成技术的一次革命性飞跃。该项目巧妙地将大型语言模型(LLM)的强大编码能力转化为直观且高效的图像生成能力,为用户带来前所未有的创作体验。Omost项目的问世,不仅为艺术家、设计师等创意工作者提供了强大的创作工具,也为广大图像爱好者打开了通往图像生成新世界的大门。随着技术的不断成熟与普及,Omost有望成为未来图像生成领域的重要
昨天Comfui官方组织Comfy Org宣布了Comfyui V1的发布,这是一个类似于桌面程序的客户端,同时支持Windous、MacOS和Linux系统。一键安装使用,更简单易用,对于普通用户更友好。准确的说Comfyui已经不止是图像生成工具了,虽然它大多数时候被用来生成图像,在众多开源贡献者成立Comfy Org组织后,Comfyui更新积极,各种新插件层出不穷,已经成了利用各种开源模型
FLUX的开源生态系统正在日益壮大,Xlabs已经推出了基于FLUX的Controlnet模型和Lora模型的训练脚本。随着更多Controlnet和IPA等插件的推出,Flux有望确立其在AI绘画领域的主导地位。公众号回复 flux 获取工作流、模型和7个lora的下载地址。资料软件免费放送次日同一发放请耐心等待关于AI绘画技术储备学好 AI绘画 不论是就业还是做副业赚钱都不错,但要学会 AI绘
在人工智能领域,Stable Diffusion模型以其卓越的图像生成能力备受瞩目。本文将深入解析Stable Diffusion的工作原理,并指导您如何安装秋叶整合包,以便轻松上手图像生成测试。通过掌握这一技术,您将能够体验到从文本到图像的神奇转换,开启创意无限的艺术创作之旅。让我们一起探索Stable Diffusion的魅力,见证科技与艺术的完美融合。
近期,Stable Diffusion 3.5 Large推出了三款ControlNet:Blur、Canny和Depth,为用户提供了更多强大的图像生成功能。
ControlNet++采用设计了一种新架构:在基于原始ControlNet架构基础上,提出了两个新模块:扩展原始ControlNet,使用相同的网络参数支持。
扩散模型(Diffusion Model)原理:AI绘画与图像生成的底层逻辑
提示词:生成20张可视化海报,内容凸显你的图像生成能力,重点是:“批量生成”、“比例自定”、“智能理解”、“创意迭代”、“风格万变”,标题是“图像生成能力大揭秘”,页面内容是豆包的IP形象,短发卡通小女孩,下面是一系列批量生成的图像,图片尺寸为4:3。提示词:图片风格为「手办」,生成34张比例 「1:1」的图片,分别生成34个省会城市/直辖市的水晶球形状的创意微缩场景,透明的水晶球中是该城市的一个
在人工智能飞速发展的今天,AI绘画工具已成为艺术家和设计师的新宠。这些智能助手不仅能理解绘画提示,还能根据用户的想法生成令人惊叹的作品。本文将带你探索AI绘画提示的奥秘,助你轻松驾驭这一神奇工具,开启创意新篇章。
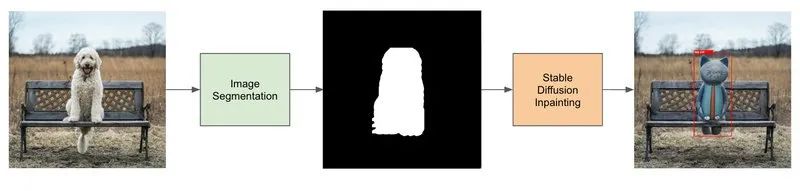
本文提出了使用图像分割和stable diffusion来自动生成目标检测数据集的方法。
FLUX.1 是由 Black Forest Labs 推出的文本到图像生成模型,已成为 AI 绘画领域的高品质模型。该模型由 Stability AI 的前核心成员开发,具备强大的生成能力和高质量的图像输出。Flux & AE 模型:https://huggingface.co/black-forest-labs/FLUX.1-devCLIP 模型:https://huggingface.co/