卷积神经网络(CNN):图像处理的深度学习利器
卷积神经网络(CNN):图像处理的深度学习利器
卷积神经网络(Convolutional Neural Networks, CNN)是一种专门用于处理具有网格结构数据(如图像、视频)的深度学习模型。自1998年由纽约大学的Yann LeCun提出以来,CNN在计算机视觉领域取得了里程碑式的突破,并在图像分类、目标检测、图像分割等多个任务中表现出色。
CNN的基本架构
CNN的模型架构通常由以下几部分组成:
-
输入层:接收原始图像数据,可能需要进行预处理,如归一化、尺寸调整等。
-
卷积层:通过一系列可学习的卷积核(或称为滤波器)对输入图像进行卷积操作,以提取图像中的局部特征。每个卷积核都会生成一个特征图(feature map),这些特征图共同构成了卷积层的输出。
-
激活函数层:通常使用ReLU(Rectified Linear Unit)等非线性函数,使网络能够学习并表达复杂的特征。
-
池化层:对卷积后的特征图进行下采样,减少数据的空间维度和参数数量,同时保留重要特征。常见的池化操作包括最大池化和平均池化。
-
全连接层:将卷积层和池化层提取的特征进行全局整合,并映射到样本标记空间。全连接层的每个神经元都与前一层的所有神经元相连,起到分类器的作用。
CNN的工作原理
CNN的工作原理可以概括为“分步卷积、层级递归、多通道卷积”。在训练过程中,CNN通过反向传播算法不断调整卷积核的权重,使得网络能够从原始图像中提取出更有用的特征。在测试阶段,输入图像经过一系列卷积、激活和池化操作后,最终得到分类结果。
CNN 的优势
CNN 之所以在图像处理领域表现出色,主要归功于以下几个关键优势:
-
局部连接性:卷积操作能够聚焦局部区域,从图像中提取重要特征,减少了全连接网络中庞大的参数数量。
-
共享权重:每个卷积核在图像的不同位置共享同样的权重,既降低了计算复杂度,又增强了模型的泛化能力。
-
平移不变性:通过卷积核的滑动窗口机制,CNN 可以检测图像中的特征位置不敏感,即即使目标发生轻微的平移,模型仍能识别出它。
CNN的应用场景
CNN在图像处理和计算机视觉领域有着广泛的应用,包括但不限于以下几个方面:
-
图像分类:通过学习图像中的特征,CNN能够自动将图像分为不同的类别。例如,在ImageNet图像分类挑战中,基于CNN的模型如AlexNet、VGGNet、ResNet等都取得了优异的成绩。
-
目标检测:CNN能够识别图像中的物体并定位它们的位置,这对于自动驾驶汽车、视频监控和无人机等领域至关重要。常见的目标检测框架如R-CNN、Fast R-CNN、Faster R-CNN和YOLO(You Only Look Once)等都基于CNN。
-
图像分割:CNN可用于图像分割,将图像中的每个像素进行分类或标记,以生成像素级别的分割结果。这在医学图像分析、卫星图像处理和自动驾驶等领域非常有用。例如,U-Net是一种常用的用于医学图像分割的卷积神经网络。
-
人脸识别:通过训练CNN模型来学习人脸的特征表示,可以实现人脸识别、人脸验证和人脸检测等任务。这些系统在安全和监控领域有广泛应用。
CNN的未来发展
随着深度学习技术的不断发展,CNN在图像处理和计算机视觉领域的应用前景更加广阔。未来,CNN有望在更多领域发挥更大的作用,如三维重建、视频理解、虚拟现实等。同时,如何设计更有效的网络结构、优化训练算法以及解决过拟合等问题,将是CNN研究的热点和难点。
配图说明
以下是一个简单的CNN架构示意图,展示了CNN的基本组成部分及其工作流程:
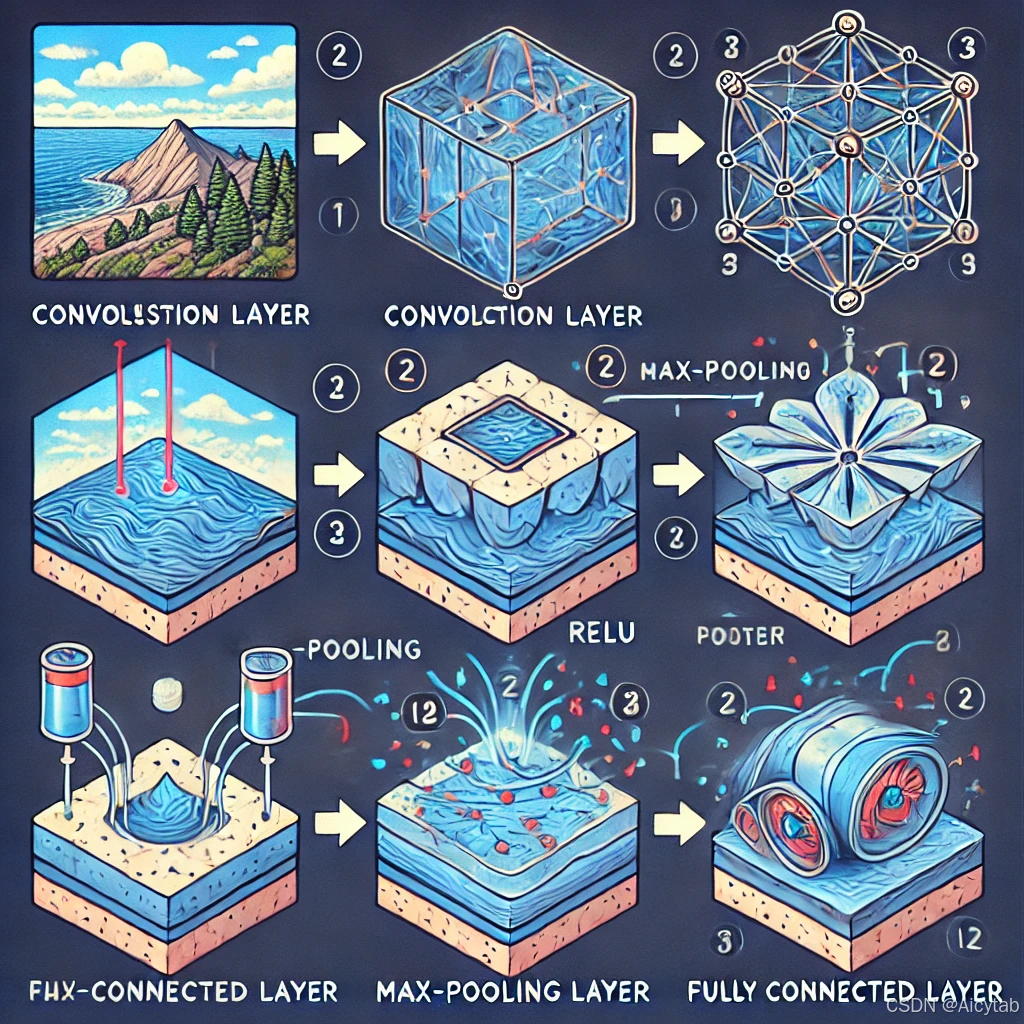
AI绘图
[输入层] -> [卷积层 + 激活函数] -> [池化层]
->[卷积层 + 激活函数] -> [池化层] -> [全连接层 + 激活函数]
-> [输出层]
在示意图中,每个方框代表一个网络层,箭头表示数据流动的方向。输入层接收原始图像数据,经过一系列卷积、激活和池化操作后,最终通过全连接层输出分类结果。

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 34
 0
- 0


 已为社区贡献1条内容

所有评论(0)