超分算法FSRCNNN:Accelerating the Super-Resolution Convolutional Neural Network 图像超分辨率重建
FSRCNNN:Accelerating the Super-Resolution Convolutional Neural Network
FSRCNN是SRCNN的加强版,对其网络结构进行了优化,主要目的是降低计算成本,加快其运行速度。在保持良好性能的同时,在通用CPU上实现实时性能。此外,还提出了一种相应的转移策略,用于跨不同放大因子的快速训练和测试。
文章指引:https://arxiv.org/abs/1608.00367

Abstract
1、作者旨在加速现有的SRCNN,并提出了一种紧凑的沙漏形CNN结构,以更快更好地实现SR。
2、FSRCNN模型的速度比SRCNN提高了40倍以上,并且图像恢复质量更高。
3、作者还提出了一种转移策略,用于应对不同的放大因子的训练和测试。
1 Introduction
超分辨率卷积神经网络(SRCNN)有着简单的网络结构和良好的恢复质量。但就实际应用而言,其运行速度远不能达到实时性的性能要求(24fps)。例如要将 240 × 240 240×240 240×240图像的放大3倍,SRCNN的速度约为 1.32 f p s 1.32fps 1.32fps。也就是说,至少要对SRCNN加速至少17倍,且在保证性能的前提下。当然不能仅通过减少参数来实现加速,这会严重影响图像恢复的质量。
作者对网络结构进行深入研究时,发现限制其运行速度的两个固有限制。
-
SRCNN在预处理时,需要使用双三次插值将原始LR图像上采样到所需大小(HR图像大小),作为网络的输入。计算复杂度与HR图像大小成正比。
-
SRCNN采用较宽的映射层,映射精度可以显著提高,但代价是运行时间,会极大的拖慢网络速度。
针对第一个问题,作者直接将原始LR图像作为输入,并采用反卷积层来代替双三次插值,并将其放在网络的末端。那么网络的计算复杂度就与原始LR图像大小成正比。对于放大因子n,与插值LR图像进行卷积的计算成本将是对原始LR图像卷积成本的
n
2
n^2
n2倍 。加速度将非常显著,将快大约
n
2
n^2
n2倍。
针对第二个问题,作者在映射层的开头和结尾分别添加了一个收缩层和一个扩展层,以限制低维特征空间中的映射数量。此外,还将单个宽映射层分解为几个层。这个结构的整体形状看起来像沙漏,整体对称,两端厚,中间细。
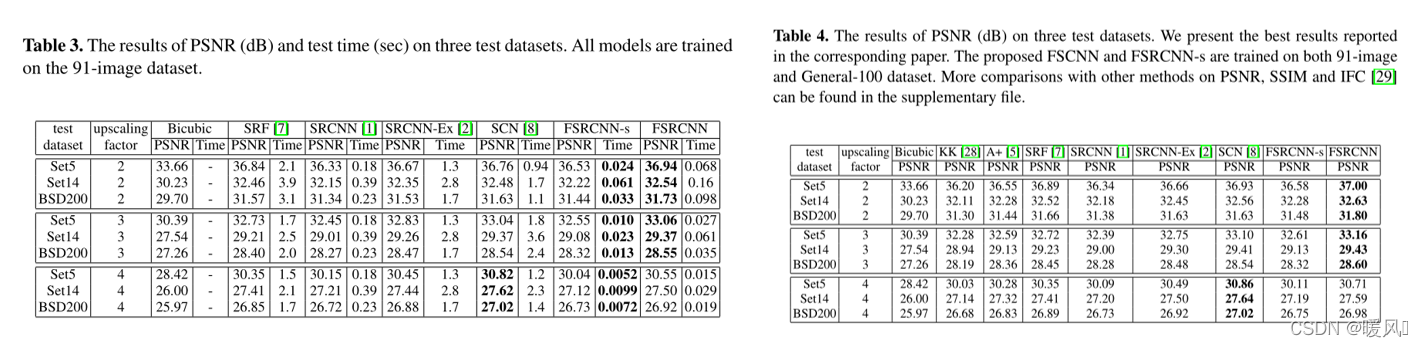
快速超分辨率卷积神经网络FSRCNN,其速度比SRCNN-Ex提高了40倍以上,性能甚至优于SRCNN-Ex。同时还提出了一个小型FSRCNN网络(FSRCNN-s),其恢复质量与SRCNN相似,但速度快17.36倍,可以在通用CPU上实时运行(24fps),且仍能获得优异的性能。
除了速度上的显著提高外,FSRCNN还可以在不同缩放因子的条件下快速训练和测试。具体地说,在FSRCNN中,所有卷积层(除反卷积层外)都可以由具有不同放大因子的网络共享。在训练期间,使用经过良好训练的网络,只需微调反卷积层,就能获得另一个放大因子的网络。在测试过程中,只需要做一次卷积运算,并使用相应的反卷积层将图像上采样到不同的尺度。
2 Methods
本节将详细介绍如何逐层重新构造FSRCNN网络以及各个参数的由来、复杂度对比。

首先我们回顾一下SRCNN的结构:
SRCNN一共有三层卷积:特征提取层 - 非线性映射层 - 重建层
原始图像LR经过预处理(双三次插值)作为网络的输入。
特征提取层: 从输入中提取图像特征,表示为高维特征向量。采用的是采用卷积核大小为
c
×
f
1
×
f
1
×
n
1
c \times f_1 \times f_1 \times n_1
c×f1×f1×n1
非线性映射层: 将特征向量非线性映射到另一组特征向量,加深网络深度 卷积核:
n
1
×
1
×
1
×
n
2
n_1\times 1 \times 1 \times n_2
n1×1×1×n2
重建层: 聚集提取的特征,形成最终的输出图像。卷积核:
n
2
×
f
3
×
f
3
×
c
n_2 \times f_3 \times f_3\times c
n2×f3×f3×c
根据作者使用的参数,网络可以表示为 Conv(9,64,1) - ReLU - Conv(1,32,64) - ReLU -Conv(5,1,32)
FSRCNN
SRCNN主要有三个方面不同。
1. FSRCNN采用原始低分辨率图像作为输入,无需进行双三次插值。在网络末端引入反卷积层来完成上采样。
2. 将SRCNN中的非线性映射层替换为FSRCNN中的三个层,即收缩、映射和扩展。
3. FSRCNN采用更小的卷积核尺寸和更深的网络结构。
如图2所示,FSRCNN可分解为五个部分——特征提取、收缩、映射、扩展和反卷积。
特征提取层: 同SRCNN一样,从输入中提取图像特征,表示为特征向量。不同之处在于输入图像是原始LR图像,
收缩层: 为了减少网络参数数量,提高计算效率,采用1×1卷积核
映射层: 将上一层的feature map进一步做非线性映射处理。为了保持良好性能,使用多个3×3层来替换单个宽层。
扩展层: 收缩层的逆作用,为了保持与收缩层的一致性,仍采用1×1卷积核,其数量与特征提取层相同。
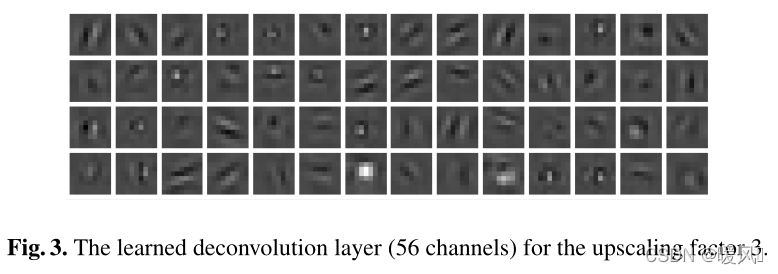
反卷积层: 完成图像的上采样。由多种自动学习的上采样核组成,这些核共同产生最终的HR输出。(可以参看2.1节最后的图3)
前四部分是卷积层,最后一部分是反卷积层。
为了更好地理解,将卷积层表示为Conv(fi,ni,ci),将反卷积层表示为DeConv(fi,ni,ci)
其中变量fi,ni,ci分别表示卷积核大小、卷积核数量和通道数量。
根据文章的参数设置网络表示为:(具体的参数设置会在下文说明原因)
Conv(5,d,1) - PReLU - Conv(1,s,d) - PReLU - m
×
\times
×Conv(3,s,s) - PReLU -Conv(1,d,s) - PReLU -DeConv(9,1,d)
2.1 Parameters
由于整个网络包含非常多的参数,提前为不敏感变量指定一个合理的值,并保持敏感变量未设置。
(当变量的微小变化可能显著影响性能时,称其为敏感变量。)
这些敏感变量总是代表SR中一些重要的影响因素,下面具体描述如何来确定每个参数。
特征提取:
C
o
n
v
(
f
1
,
n
1
,
c
1
)
Conv(f_1,n_1,c_1)
Conv(f1,n1,c1)
在SRCNN中,第一层的卷积核大小
f
1
f_1
f1设置为9。这是在上采样图像Y上执行的。(设SRCNN中输入的插值图像为Y,原始图像LR为Ys)。
因此使用5×5卷积核对Ys进行特征提取足以覆盖9×9卷积核提取图像Y的几乎所有信息。所以在FSRCNN中采用较小的卷积核尺寸
f
1
=
5
f_1=5
f1=5,能保证较小的信息损失,还能减少参数。
对于通道数,按照SRCNN将c1设置为1。
对于特征维度n1,将其表示为d——第一个敏感变量。
最后,第一层可以表示为
C
o
n
v
(
5
,
d
,
1
)
\bm{Conv(5, d, 1)}
Conv(5,d,1)。
收缩:
C
o
n
v
(
f
2
,
n
2
,
c
2
)
Conv(f_2,n_2,c_2)
Conv(f2,n2,c2)
在SRCNN中,非线性映射层由于LR特征维数d通常非常大,计算复杂度相当高,所以应用了1×1层以节省计算成本。出于同样的考虑,FSRCNN将卷积核大小设定为为
f
2
=
1
f_2=1
f2=1.
作为收缩层目的是降低特征维度d,所以采用较小的通道数,设置
n
2
=
s
n_2=s
n2=s,使LR特征维数从d降低到s。s是决定收缩水平的第二个敏感变量。这一步极大减少了参数数量。
第二层可以表示为
C
o
n
v
(
1
,
s
,
d
)
\bm{Conv(1, s, d)}
Conv(1,s,d)。
非线性映射:
C
o
n
v
(
f
3
,
n
3
,
c
3
)
Conv(f_3,n_3,c_3)
Conv(f3,n3,c3)
非线性映射层是网络贡献最大的一层,是影响SR性能的最重要部分。最重要的影响因子是映射层的宽度和深度。
首先,为了在性能和网络规模之间进行权衡,采用了中等大小卷积核
f
3
=
3
f_3=3
f3=3。然后,为了保持与SRCNN相同的良好性能,使用多个3×3层来替换单个宽层。映射层的数量是另一个敏感变量(表示为m),它决定了映射的准确性和复杂性。为了保持一致,所有映射层都使用相同数量的卷积核
n
3
=
s
n_3=s
n3=s。(这个地方应该是对每组映射层进行了拼接或者相加,论文中作者没写 😐)
非线性映射部分可以表示为
m
×
C
o
n
v
(
3
,
s
,
s
)
\bm{m\times Conv(3,s,s)}
m×Conv(3,s,s)。
扩展:
C
o
n
v
(
f
4
,
n
4
,
c
4
)
Conv(f_4,n_4,c_4)
Conv(f4,n4,c4)
扩展层的作用与收缩层的作用相反,相当于收缩的逆。为了提高计算效率,收缩操作减少了LR特征维数。如果直接从这些低维特征生成HR图像,最终的恢复质量将很差。因此,在映射层之后添加一个扩展层来扩展HR特征维度。
为了保持与收缩层的一致性,还采用了1×1卷积核,其数量与LR特征提取层相同。
与收缩层Conv(1,s,d)相反,扩展层是
C
o
n
v
(
1
,
d
,
s
)
\bm{Conv(1,d,s)}
Conv(1,d,s)。
反卷积:
D
e
C
o
n
v
(
f
5
,
n
5
,
c
5
)
DeConv(f_5,n_5,c_5)
DeConv(f5,n5,c5)
使用一组反卷积核对之前的特征进行上采样和聚合。反卷积可以看作是卷积的逆运算。
卷积核与图像以步长k卷积,输出为输入的1/k倍。相反,如果交换输入和输出的位置,输出将是输入的k倍,这就是反卷积。利用这个属性来设置步幅k=n,n是所需的放大因子。然后直接输出重建的HR图像。(由步长来控制放大倍数)。
在确定放大因子n的情况下。我们把FSRCNN反过来看,反卷积层就相当于对(重建的)SR图像做了一个缩放并从中提取特征,如果不管缩放,反卷积层相当于SRCNN第一层特征提取。所以和SRCNN第一层一致,作者采用了9×9卷积核,即
f
5
=
9
f_5=9
f5=9。类似地,图3显示了学习的反卷积核,其模式与SRCNN中的第一层卷积核非常相似。
反卷积层表示为
D
e
C
o
n
v
(
9
,
1
,
d
)
\bm{DeConv(9,1,d)}
DeConv(9,1,d)。
PReLU:
每个卷积层 之后的激活函数,作者使用PReLU,而不是常用的ReLU。选择PReLU主要是为了避免ReLU中的零梯度导致的“死特征“。实验表明,PReLU激活网络的性能更稳定,可以看作是ReLU激活网络性能的上界。
LOSS:
采用均方误差(MSE)作为cost函数。优化目标表示为
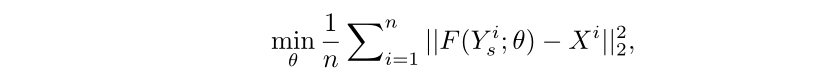
所有参数均采用标准反向传播的随机梯度下降法进行优化。
2.2 Different Upscaling Factors
与以前基于深度学习的方法相比,FSRCNN的另一个优点是,可以实现跨不同放大倍数的快速训练和测试。
作者发现FSRCNN中所有卷积层总体上都像LR图像的复杂特征提取器,只有最后一个反卷积层包含放大因子的信息。
实验也证明了这一点,对于不同的放大因子,卷积核几乎是相同的。利用这个特性,作者使用转移卷积核进行快速训练和测试。
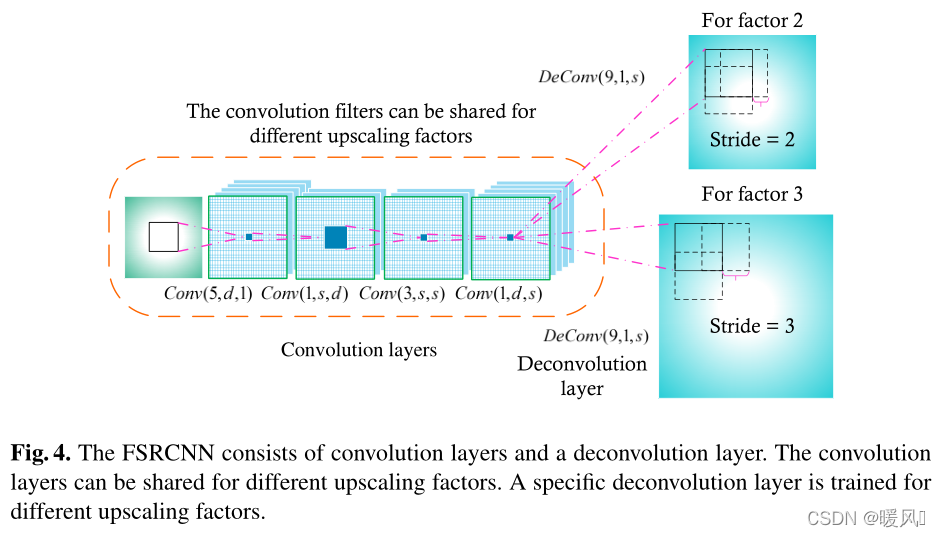
在实验中,作者提前训练了一个上采样因子的模型。然后在训练过程中,只需微调反卷积层以获得另一个上采样因子,并保持卷积层不变。微调速度很快,性能与从头开始train的一样好。
在测试期间,只需执行一次卷积操作,并使用相应的反卷积层将图像上采样到不同大小。
实验中作者展示了跨放大因子训练的灵活性。作者选择FSRCNN(56,12,4)作为默认网络。
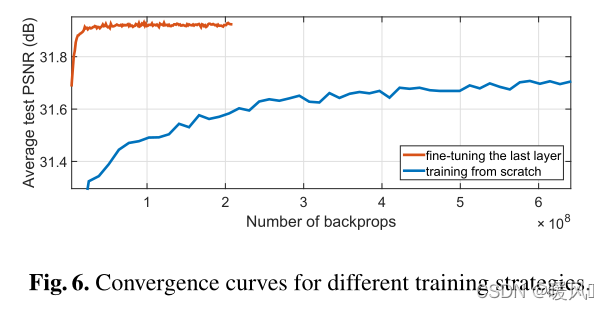
首先在放大因子3下获得了一个经过良好训练的模型。在此基础上,再对×2的网络进行了训练。×3网络训练好的模型中所有卷积核的参数都被转移到×2的网络中。在训练期间,只对91-image数据集和General-100数据集上的×2反卷积层进行微调。
为了进行比较,作者也为×2训练了另一个网络,但从零开始。
这两个网络的收敛曲线如图6所示。显然,通过转移参数,网络收敛速度非常快(只有几个小时),与从头开始的训练具有相同的良好性能。在接下来的实验中,作者都是从零开始训练网络×3,并微调相应的反卷积层×2和×4。
2.3 Computational Complexity
本节对比以下SRCNN和FSRCNN的计算复杂度(耗时)
SRCNN网络可以表示为
C
o
n
v
(
f
1
,
n
1
,
1
)
−
R
e
L
U
−
C
o
n
v
(
f
2
,
n
2
,
n
1
)
−
R
e
L
U
−
C
o
n
v
(
f
3
,
1
,
n
2
)
\bm{Conv(f_1,n_1,1) - ReLU - Conv(f_2,n_2,n_1) - ReLU -Conv(f_3,1,n_2)}
Conv(f1,n1,1)−ReLU−Conv(f2,n2,n1)−ReLU−Conv(f3,1,n2)
(带入参数为Conv(9,64,1) - ReLU - Conv(1,32,64) - ReLU -Conv(5,1,32),一共有57184个参数)
SRCNN网络的计算复杂度可计算如下:
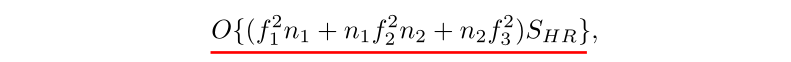
其中
{
f
i
}
i
=
1
3
和
{
n
i
}
i
=
1
3
{\{f_i}\}^3_{i=1}和{\{n_i}\}^3_{i=1}
{fi}i=13和{ni}i=13分别是三层卷积核尺寸和卷积核数量。
S
H
R
S_{HR}
SHR是HR图像的大小。观察到,复杂度与HR图像的大小成正比,中间层对网络参数的贡献最大。
再看看FSRCNN:有三个敏感变量d,s,m来控制性能和速度。网络可以表示为:
Conv(5,d,1) - PReLU - Conv(1,s,d) - PReLU - m
×
\times
×Conv(3,s,s) - PReLU -Conv(1,d,s) - PReLU -DeConv(9,1,d)
记为FSRCNN(d,s,m)。计算复杂度为:
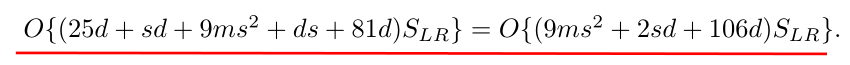
作者排除了PReLU的参数对复杂度的影响,这些参数带来的计算成本可以忽略不计。
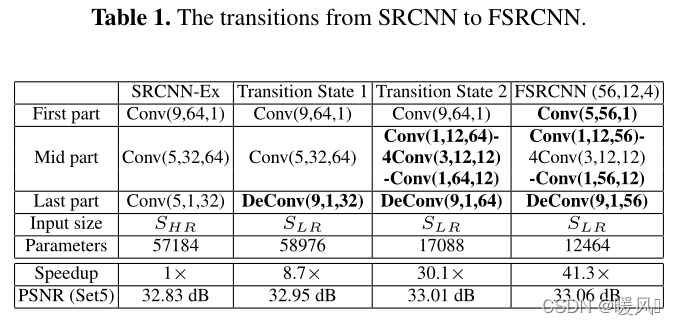
为了更好地理解如何加速SRCNN,作者分三步将SRCNN-Ex转换为另一个FSRCNN(56,12,4),并显示每步骤获得的加速度和PSNR增益。作者使用了一个代表性的放大因子n=3。SRCNN、FSRCNN和两种过渡状态的网络配置如表1所示。
具体看一下实验步骤:
首先,将SRCNN-Ex的最后一个卷积层替换为反卷积层,然后整个网络将在原始LR图像上执行。这一步反卷积层将扩大网络规模,但计算复杂度与
S
L
R
而
不
是
S
H
R
S_{LR}而不是S_{HR}
SLR而不是SHR成正比。所以实现了8.7倍(即
57184
/
58976
×
3
2
57184/58976×3^2
57184/58976×32)的加速。由于学习到的反卷积核优于单个双三次核,因此性能大约提高了0.12 dB。
其次,将SRCNN单个非线性映射层替换为FSRCNN的收缩层、4个映射层和扩展层的组合。虽然卷积层层数增加了有5层,但参数从58976减少到17088。这一步的加速度是最显著的30.1倍。人们普遍认为,深度是影响性能的关键因素。在这里,使用四个“窄”层来代替单个“宽”层,从而用更少的参数获得更好的结果(性能提高到33.01 dB)。
最后,采用更小的卷积核尺寸和更少的卷积核(例如,从Conv(9,64,1)到Conv(5,56,1)),并获得41.3倍的最终加速比。当去除一些冗余参数时,网络的训练效率更高,并实现了另一个0.05 dB的改善。
值得注意的是,这种加速并不是以性能下降为代价的。相反,FSRCNN(56,12,4)比SRCNN-Ex有很大的优势(例如,在Set5数据集上为0.23dB)。
3 Experiments
第二部分中以及讲解了一部分实验下面就不再赘述。
3.1 Implementation Details
作者使用91-image数据集作为训练集。但研究发现91张图像不足以将深度模型推向最佳性能。因此,作者提供了一个新的General-100数据集,其中包含100个bmp格式的图像(无压缩)。新引入的100幅图像的大小从710×704(大)到131×112(小)。它们都具有良好的质量,边缘清晰,但平滑区域较少(例如天空和海洋),因此非常适合SR训练。
作者还使用了两种方式增加数据。
- 缩放:每个图像的缩放比例分别为0.9、0、8、0.7和0.6。
- 旋转:每个图像以90度、180度和270度旋转。
最后作者得到了5×4− 1=19倍的训练图像。
测试和验证数据集。作者使用Set5、Set14和BSD200数据集进行测试。从BSD500数据集的验证集中选择另外20个图像进行验证。
训练样本。为了准备训练数据,首先对原始训练图像按所需的比例因子n进行下采样,以形成LR图像。然后,将LR训练图像裁剪成一组具有步长 k k k的 f s u b × f s u b f_{sub}×f_{sub} fsub×fsub像素子图像。相应的HR子图像(具有大小( n f s u b ) 2 nf_{sub})^2 nfsub)2)也从ground truth图像裁剪而来。这些LR/HR子图像对是主要的训练数据。
培训策略。作者还探索了两步培训策略。
首先,使用91-image数据集从头开始训练网络。然后,当训练饱和时,添加General-100数据集进行微调。使用这种策略,训练比从一开始就使用两个数据集的训练收敛得早得多。 当使用91-image数据集进行训练时,卷积层的学习速率设置为
1
0
−
3
10^{−3}
10−3,反卷积层为
1
0
−
4
10^{−4}
10−4。然后在微调过程中,所有层的学习率降低一半。初始化使用何凯明为PReLU设计的方法初始化卷积核的权重。由于最后没有激活函数,反卷积核的初始化方法与SRCNN相同(即,从均值为零、标准偏差为0.001的高斯分布中随机抽取)。
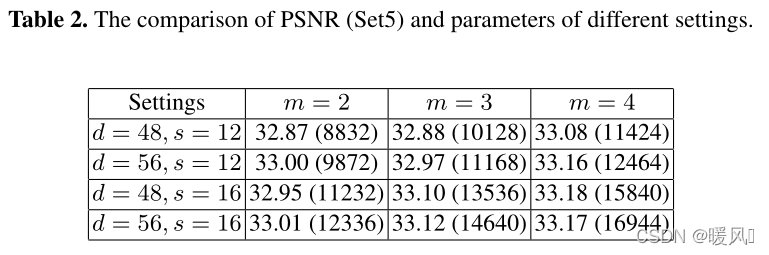
为了测试FSRCNN结构的特性,作者设计了一组控制实验,使用三个敏感变量的不同值——LR特征维数d、收缩卷积核的数量s和映射深度m。具体来说,选择不同的d=48、56、s=12、16和m=2、3、4进行实验。因此,作者总共进行了2×2×3=12个不同组合的实验。
这些实验的Set5数据集上的平均PSNR值如表2所示。从两个方向分析结果,即在表格中水平和垂直。首先,修正d,s并检查m的影响。显然,m=4比m=2和m=3的结果更好。其次,修正m并检查d和s的影响。一般来说,更好的结果通常需要更多的参数(例如,更大的d或s),但更多的参数并不总是保证更好的结果。从所有结果中,作者找到了性能和参数之间的最佳权衡——FSRCNN(56,12,4),它在中等数量的参数下实现了最高的结果之一。
值得注意的是,最小的网络FSRCNN(48,12,2)实现了32.87 dB的平均峰值信噪比,这已经高于SRCNN-Ex(32.75 dB)。FSRCNN(48,12,2)仅包含8832个参数,与SRCNN Ex相比,加速度为
57184
/
8832
×
3
2
=
58.3
57184/8832×3^2=58.3
57184/8832×32=58.3倍。
3.2 Towards Real-Time SR
文章的目的是使网络速度达到满足实际应用的需求,在保持良好性能的同时实现实时SR。
首先,计算有多少参数可以满足实时实现的最低要求(24 fps)。如引言中所述,SRCNN将图像上采样到760×760的速度为1.32fps。放大系数为3,SRCNN有8032个参数。然后根据复杂度公式,所需的FSRCNN网络最多应具有
8032
×
1.32
/
24
×
3
2
≈
3976
8032×1.32/24×3^2≈ 3976
8032×1.32/24×32≈3976个参数。为了实现这个目标,作者找到了一个合适的配置——包含3937个参数的FSRCNN(32,5,1),记为FSRCNN-s。作者用C++测试代码,FSRCNN(32,5,1)的速度达到24.7 fps,满足实时性要求。此外,FSRCNN(32,5,1)甚至优于SRCNN(9-1-5)。
4 Conclusion
文章主要目的就是对SRCNN进行加速(减小网络参数),且不影响网络的重建质量,改进了网络的结构,提出了一种沙漏型CNN,整体上是对称的,末端是厚的,中间是细的。由三个敏感变量来控制沙漏外观。实验表明,这种沙漏设计对图像超分辨率非常有效。
最主要的贡献:
- 网络输入使用
原始图像LR,而不使用插值图像,极大的减小了网络参数,加快网络速度。 - 网络通过增加
收缩层和扩展层,减少特征参数维度,减小了网络的参数,加快网络速度。 - 将“宽”的非线性映射层用“
窄”的“深”的网络来替代,从而用更少的参数获得更好的效果。 - 提出了一种转移策略,能够
跨不用放大因子来进行快速训练和测试。
综上,FSRCNN-s能够达到实时性能要求(24pfs),速度比SRCNN快17.36倍,且恢复效果与SRCNN相似(略优)。而FSRCNN网络比当代SR模型快得多,但仍能获得优异的性能。
文章详细描述了每个网络参数的由来,也给我们今后的对网络结构的设计和改进有着重要启发。
记录一个markdown编辑器的空行功能:
# 空一行
最后祝大家科研顺利,身体健康,万事胜意~

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 7
 0
- 0


 已为社区贡献5条内容

所有评论(0)