深度学习ResNet,Inception和BN
我了解的ResNet,Inception和BN
1. ResNet
1.1.1 What is ResNet?
ResNet 网络是在 2015年 由微软实验室中的何凯明等几位大神提出,斩获当年ImageNet竞赛中分类任务第一名,目标检测第一名。获得COCO数据集中目标检测第一名,图像分割第一名。
1. 1.2 过拟合?Overfitting?
神经网络叠的越深,则学习出的效果就一定会越好吗?
答案无疑是否定的,人们发现当模型层数增加到某种程度,模型的效果将会不升反降。也就是说,深度模型发生了退化(degradation)情况。那么,为什么会出现这种情况?
首先印入脑海的就是Andrew Ng机器学习公开课[1]的过拟合问题
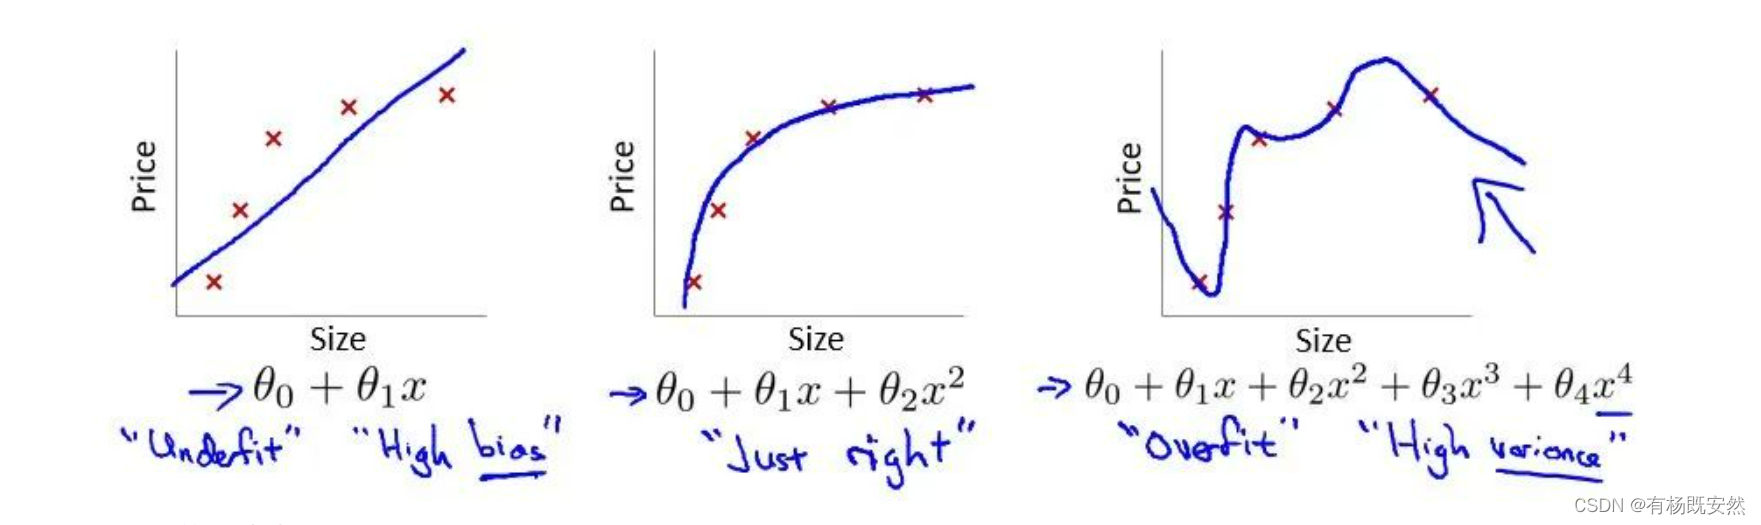
Andrew Ng的课件截图
在这个多项式回归问题中,左边的模型是欠拟合(under fit)的此时有很高的偏差(high bias),中间的拟合比较成功,而右边则是典型的过拟合(overfit),此时由于模型过于复杂,导致了高方差(high variance)。
然而,很明显当前CNN面临的效果退化不是因为过拟合,因为过拟合的现象是"高方差,低偏差",即测试误差大而训练误差小。但实际上,深层CNN的训练误差和测试误差都很大。
1.2 网络中的亮点
1.超深的网络结构(超过1000层)。
2.提出residual(残差结构)模块。
3.使用Batch Normalization 加速训练(丢弃dropout)。
1.3 什么是残差模块?
在2015年ResNet提出之前,所有的神经网络都是通过卷积层和池化层的叠加组成的。
所有的相关人员都认为卷积层和池化层的层数越多,获取到的图片特征信息越全,学习效果也就越好。但是在实际的试验中发现,随着卷积层和池化层的叠加,不但没有出现学习效果越来越好的情况,反而出现以下问题(1.梯度消失和梯度爆炸)(2.训练模型退化问题)。
1.3.1 为什么要使用残差模块?(主要解决2.3的问题2)
向前传播的计算方法(绿色,蓝色):
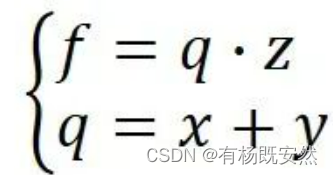
反向传播的计算方法(红色):

两种计算方法的演示:
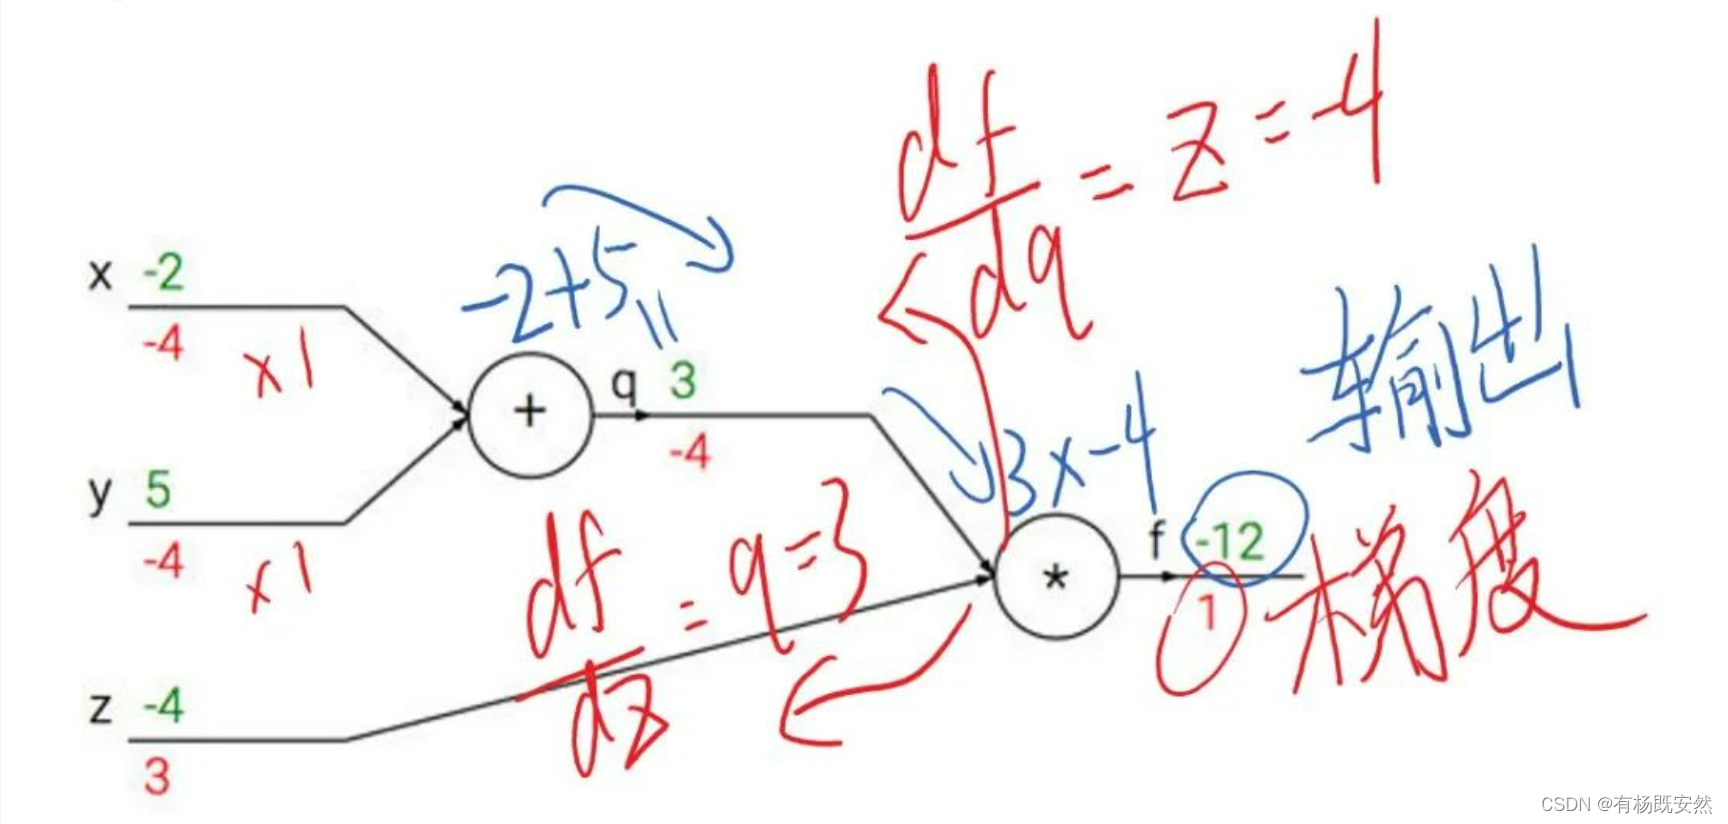
以上三图来自:https://blog.csdn.net/qq_42722197/article/details/119860994?spm=1001.2014.3001.5506
观察上图反向传播(红色),不难发现,在输出端梯度的模值,经过回传扩大了3~4倍。(当计算图每次输入的模值都大于1,想象一下重复上万次,想象一下310000有多大……),直到Nan,这就是梯度爆炸现象。)
当然反过来观察上图前向传播(蓝色),如果我们每个阶段输入的模恒小于1,那么梯度也将不可避免地呈几何倍数下降(比如每次都变成原来的三分之一,重复一万次就是3-10000),直到0。这就是梯度消失现象。值得一提的是,由于人为的参数设置,梯度更倾向于消失
1.梯度消失和梯度爆炸(结合以上三张图,相信你可以理解这个问题)
梯度消失:若每一层的误差梯度小于1,反向传播时,网络越深,梯度越趋近于0
梯度爆炸:若每一层的误差梯度大于1,反向传播时,网络越深,梯度越来越大
为了解决梯度消失或梯度爆炸问题,ResNet论文提出通过数据的预处理以及在网络中使用 Bacth Normalization(简称BN),而BN的作用本质上也是控制每层输入的模值,因此梯度的爆炸/消失现象理应在很早就被解决了(至少解决了大半),所以相对简单,而我们的主角重中之重是解决模型退化问题。
2.退化问题
按理说,当我们堆叠一个模型时,理所当然的会认为效果会越堆越好。因为,如果一个比较浅的网络已经可以达到不错的效果,那么即使之后堆上去的网络什么也不做,模型的效果也不会变差。
然而事实上,这却是问题所在。“什么都不做”恰好是当前神经网络最难做到的东西之一。
也许是我们的科研人员赋予神经网络无限可能性的“非线性”让神经网络模型走得太远太远,却也让它忘记了为什么出发的初心(想想还挺哲学)。这也使得特征随着层层前向传播得到完整保留(什么也不做)的可能性都微乎其微。
用学术点的话说,要保留这种神经网络丢失的“不忘初心”/“什么都不做”的品质叫做恒等映射(identity mapping)。
因此,可以认为Residual Learning的初衷,其实是让模型的内部结构至少有恒等映射的能力。以保证在堆叠网络的过程中,网络至少不会因为继续堆叠而产生退化!
首先,我们把网络层看成是映射函数。(1)在传统的前馈网络中,网络中堆叠的层可以将输入x映射为F(x),这一整体网络的输出为H(x),F(x)=H(x)。但是对于恒等映射函数f(x)=x,即网络的输入与输出相等,直接让这样的层去拟合这样的恒等映射函数会很困难,不过f(x)=0还是比较容易训练拟合的。(2)所以我们可以让输出H(x)=F(x)+x,这样如果整体网络H(x)需要是恒等映射,只需要把堆叠层拟合成F(x)=0即可。(其实简单的来说就是原始数据x经过layers的时候原始数据有损失得到H(x),但是当我们继续进行数据的学习,就会出现原始数据和期望数据会相差过大,从而使模型退化。)括号内属于个人理解,可能不正确,如有想法私信讨论
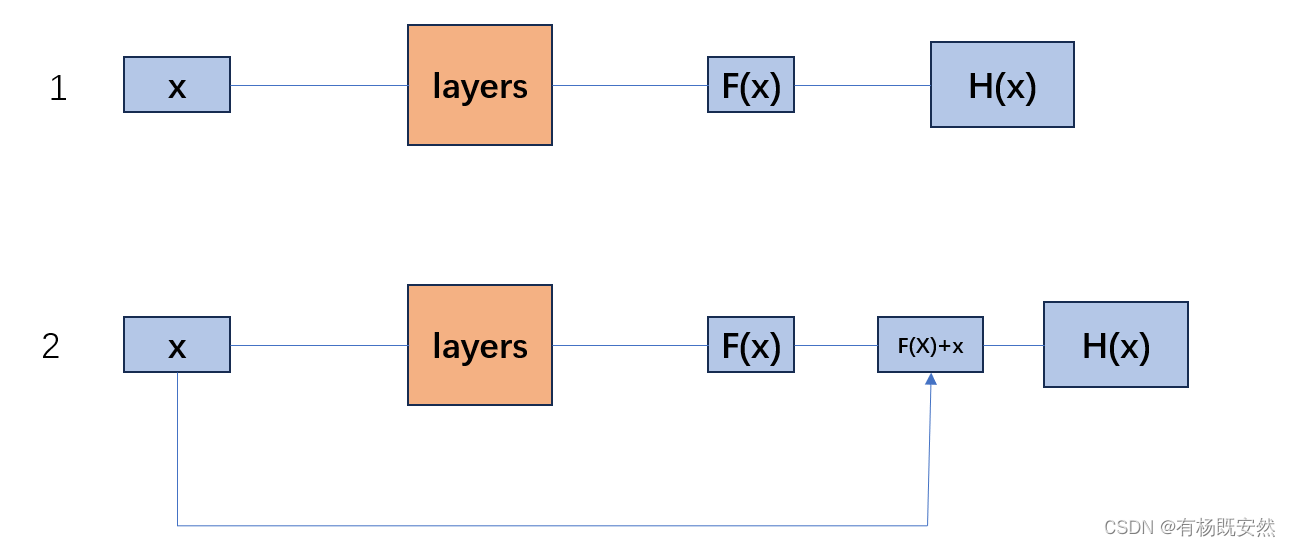
为了解决深层网络中的退化问题,可以人为地让神经网络某些层跳过下一层神经元的连接(就是F(x)+x部分,隔层相连,弱化每层之间的强联系。这种神经网络被称为 残差网络 (ResNets)。ResNet论文提出了 residual结构(残差结构)来减轻退化问题,下图是使用residual结构的卷积网络,可以看到随着网络的不断加深,效果并没有变差,而是变的更好了。
图中x 指向 F(x)+x的线叫做跳接(shortcut connection)
2. BN (Batch Normalization)
Batch Normalization是指批标准化处理,将一批数据的feature map满足均值为0,方差为1的分布规律。
2.1 BN原理
我们在图像预处理过程中通常会对图像进行标准化处理,这样能够加速网络的收敛,如下图所示,对于Conv1来说输入的就是满足某一分布的特征矩阵,但对于Conv2而言输入的feature map就不一定满足某一分布规律了(注意这里所说满足某一分布规律并不是指某一个feature map的数据要满足分布规律,理论上是指整个训练样本集所对应feature map的数据要满足分布规律)。而我们Batch Normalization的目的就是使我们的feature map满足均值为0,方差为1的分布规律。论文中的一段话:“对于一个拥有d维的输入x,我们将对它的每一个维度进行标准化处理。” 假设我们输入的x是RGB三通道的彩色图像,那么这里的d就是输入图像的channels即d=3,x=(x^{(1)}, x^{(2)}, x{(3)}),其中x{(1)}就代表我们的R通道所对应的特征矩阵,依此类推。标准化处理也就是分别对我们的R通道,G通道,B通道进行处理。
2.2 计算演示
原文的公式: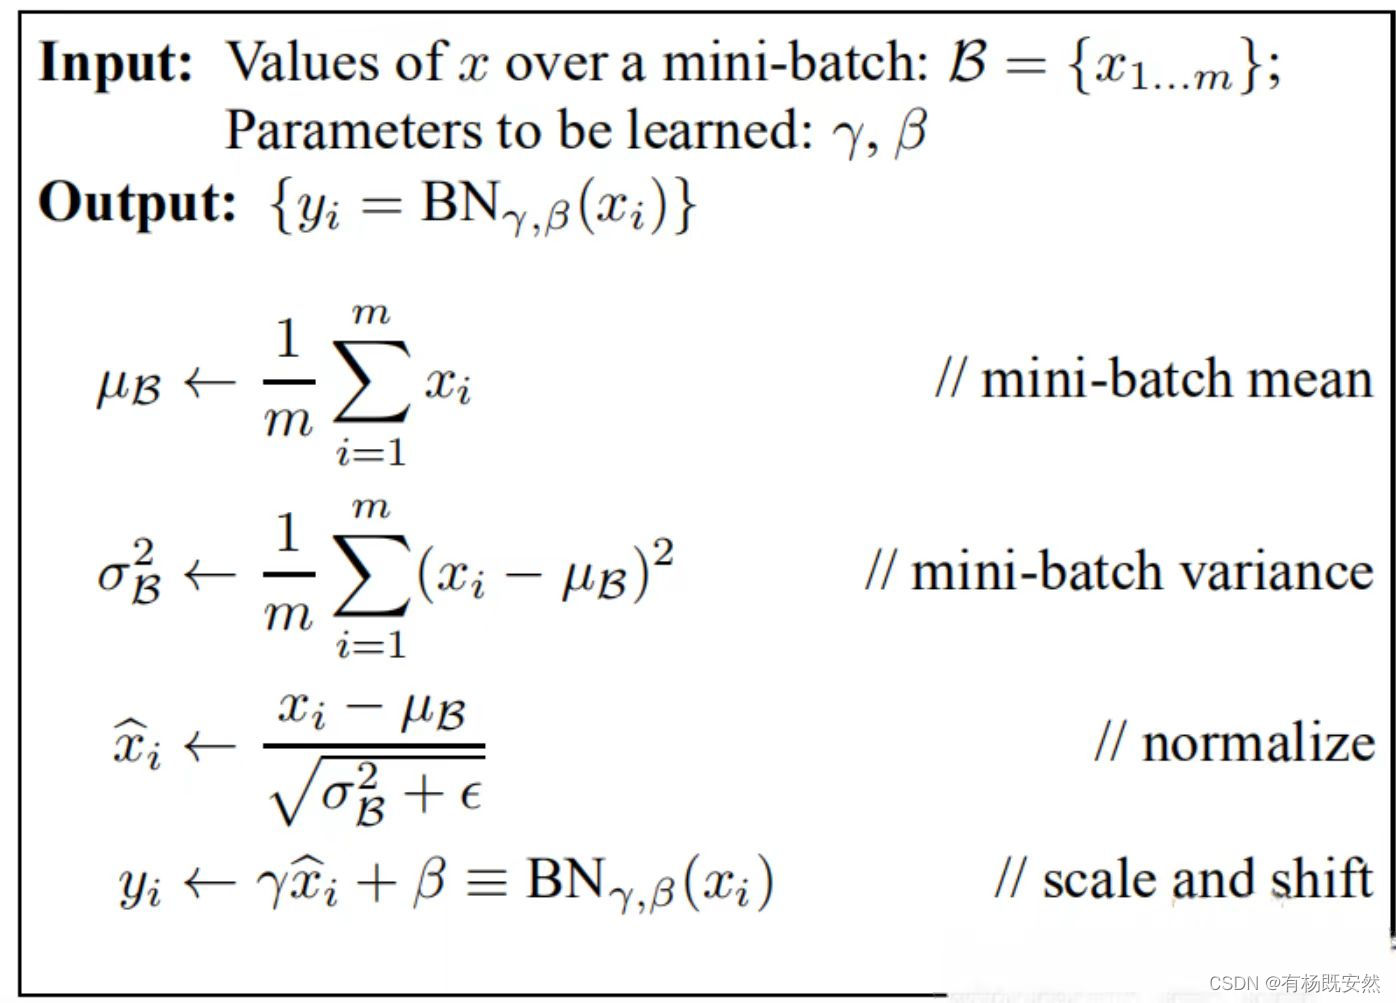
这个公式一看就晦涩难懂,我们看看下述更具体的: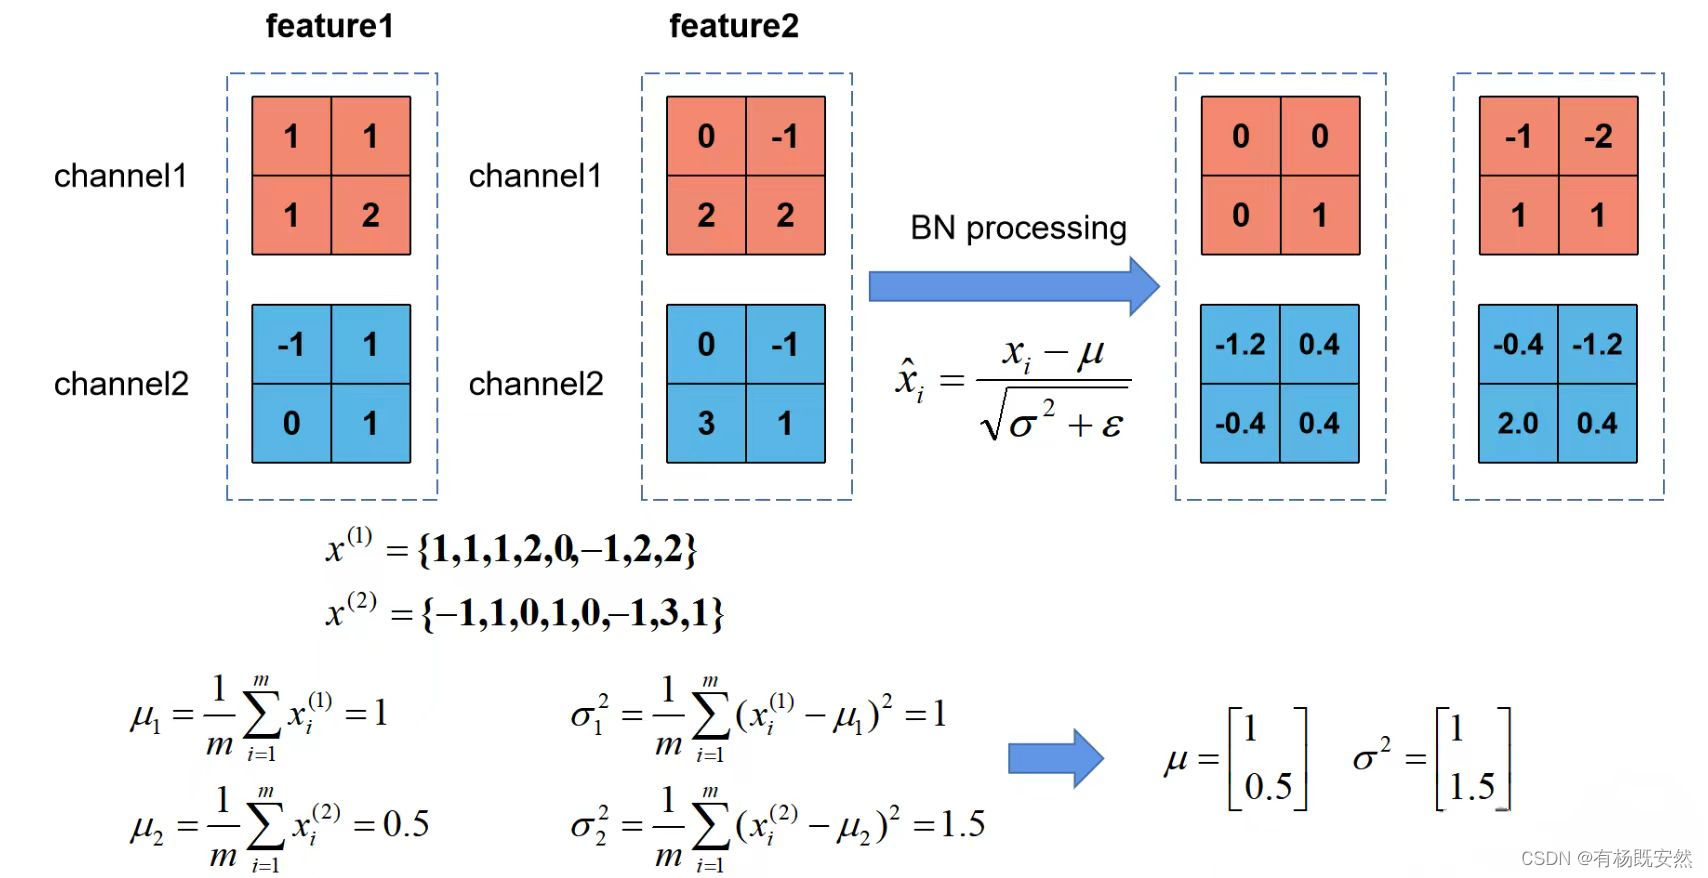
在原论文公式中不是还有两个参数吗?是的γ,β是用来调整数值分布的方差大小,是用来调节数值均值的位置。这两个参数是在反向传播过程中学习得到的,γ的默认值是1,β的默认值是0。
上图展示了一个batch size为2(两张图片)的Batch Normalization的计算过程,假设feature1、feature2分别是由image1、image2经过一系列卷积池化后得到的特征矩阵,feature的channel为2,那么代表该batch的所有feature的channel1的数据,同理代表该batch的所有feature的channel2的数据。然后分别计算和的均值与方差,得到我们的和两个向量。然后在根据标准差计算公式分别计算每个channel的值(公式中的是一个很小的常量,防止分母为零的情况)。在我们训练网络的过程中,我们是通过一个batch一个batch的数据进行训练的,但是我们在预测过程中通常都是输入一张图片进行预测,此时batch size为1,如果在通过上述方法计算均值和方差就没有意义了。所以我们在训练过程中要去不断的计算每个batch的均值和方差,并使用移动平均(moving average)的方法记录统计的均值和方差,在训练完后我们可以近似认为所统计的均值和方差就等于整个训练集的均值和方差。然后在我们验证以及预测过程中,就使用统计得到的均值和方差进行标准化处理。
3. Inception
3.1 背景
该篇主要介绍Inception系列Inception V1。
Google家的Inception系列模型提出的初衷主要为了解决CNN分类模型的两个问题,其一是如何使得网络深度增加的同时能使得模型的分类性能随着增加,而非像简单的VGG网络那样达到一定深度后就陷入了性能饱和的困境(Resnet针对的也是此一问题);其二则是如何在保证分类网络分类准确率提升或保持不降的同时使得模型的计算开销与内存开销充分地降低。
3.2 Inception V1-2014年
卷积网络为了提取高维特征,一般方式进行更深层卷积,但是随之带来网络变大的问题。Inception V1模块(借鉴network in network论文中mlpconv思想)提出可以使网络变宽,在保证模型质量的前提下,减少参数个数,提取高维特征。
下面先抽象说明一下Inception V1的基本思想:
Inception结构,首先通过1x1卷积来降低通道数把信息聚集一下,再进行不同尺度的特征提取以及池化,得到多个尺度的信息,最后将特征进行叠加输出(官方说法:可以将稀疏矩阵聚类为较为密集的子矩阵来提高计算性能)。
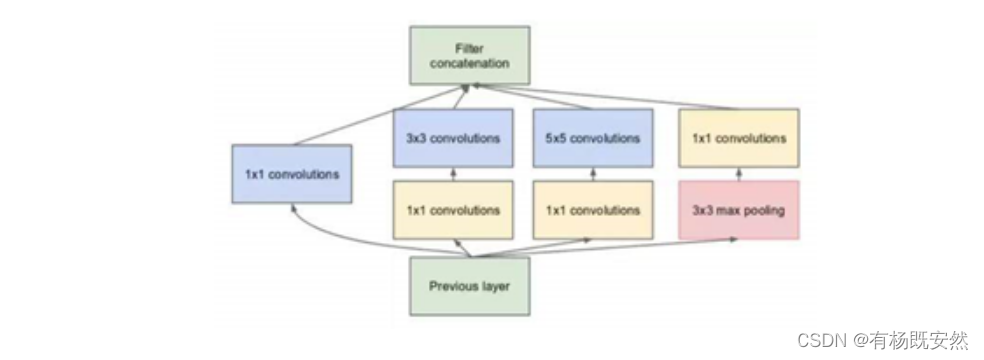
主要过程:
1.相应的在3x3卷积和5x5卷积前面、3x3池化后面添加1x1卷积,将信息聚集且可以有效减少参数量(称为瓶颈层);
2.下一层block就包含1x1卷积,3x3卷积,5x5卷积,3x3池化(使用这样的尺寸不是必需的,可以根据需要进行调整)。这样,网络中每一层都能学习到“稀疏”(3x3、5x5)或“不稀疏”(1x1)的特征,既增加了网络的宽度,也增加了网络对尺度的适应性;
3.通过按深度叠加(deep concat)在每个block后合成特征,获得非线性属性。
原文链接:https://blog.csdn.net/weixin_45422462/article/details/108416139

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 14
 0
- 0


 已为社区贡献1条内容

所有评论(0)