【机器学习】模型过拟合解决方案(模型评估)
·
【机器学习】模型过拟合解决方案(模型评估)
前言:本文框架参考经济学大神论文的一部分,细节部分多处参考,在此致谢,侵权必删
致谢:
- Varian, H. R. 2014. “Big Data: New Tricks for Econometrics,” The Journal of Economic Perspectives (28:2), pp. 3-27.
- https://blog.csdn.net/qq_46020653/article/details/119430176
背景
- 机器学习(Machine Learning)的重要目标:Prediction ( Finding an efficient systems to predict some tasks )
- 预测目标:minimizes loss function ( 残差平方和 SSR, 残差绝对值均值 …)
- 预测挑战:out-of-sample predictions,即预防过拟合问题 overfitting*(即样本内有效,样本外有偏)
过拟合的三个解决方案
- 简单模型(“若无必要,勿增实体” Occam’s razor):惩罚复杂性 regularization
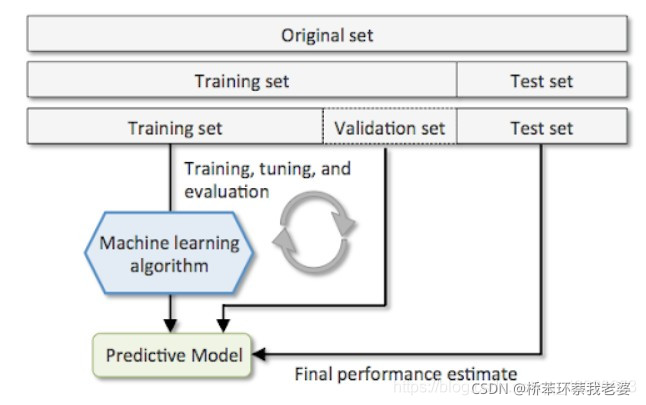
- 留出法 Hold-out :训练(training data – estimate model) 、测试(validation data – choose model) 、验证(testing data – evaluate model)
- K折交叉验证 k-fold cross-validation:划分k个子样本(常见 k = 5, 10),每次“留一个在外”(leave one out)用于验证,其余用于训练,验证时用调优参数(tunning paramater)量化模型效果
留出法 Hold-out
- 留出法(Hold-out Method): 直接将数据集D划分成两个互斥的集合,其中一个为训练集S,另一个作为测试集T
- 保持数据分布的一致性(即保持若S,T中样本类别比例近似)
- 分层采样(stratified sampling):在对数据集进行划分的时保留类别比例
举例:数据集D,包含500个正例,500个反例;训练集S(70%)应为350个正例,350个反例,测试集T(30%)应为150个正例,150个反例
- 分层采样(stratified sampling):在对数据集进行划分的时保留类别比例
- 一般要采用若干次随机划分、重复进行实验评估后,取平均值作为留出法的评估结果
- 划分比例:常见使用 23−45\frac{2}{3} - \frac{4}{5}32−54 作为训练集
- 训练集S太大,测试集T太小,评估结果会不稳定、不准确;
- 测试集T太大,训练集S太小,训练出来的模型丧失真实性。
- 保持数据分布的一致性(即保持若S,T中样本类别比例近似)
- 为什么有验证集(validation dataset)
- 如果每次都使用test data对模型评估与选择,实际上也将test data也成为了train data,过拟合问题依然存在,因此引入验证集validation data 减缓训练时的过拟合
| 训练集 train dataset | 验证集 validation dataset | 测试集 test dataset | |
|---|---|---|---|
| 目的 | 训练模型 | 模型选择与超参数调优 | 评估模型泛化性能 |
| 步骤 | Model Estimation | Model Selection | Model Evaluation |
| 要求 | 与test互斥 | – | 与train互斥 |
| 使用频率 | 多次(反复训练) | 多次(反复调参) | 一次(最后一次) |
Hold-out Method for Model Evaluation
- 目标:基于将数据集分割为训练数据集(train)和测试数据集(test),使用固定的超参数集的模型评估
- 将数据集分为训练集和测试集两部分(一般比例:70%-30%);
- 在训练集上训练模型,在训练之前要选择固定的一些模型超参数设置;
- 把训练好的模型在测试集上评估(测试);
- 在整个数据集上训练最终模型,得到一个在未来数据集上能够更好进行泛化的模型;
Hold-out method for Model Selection
- 目标:模型超参数确定
- 把数据集分成训练集、验证集和测试集;
- 训练不同的模型用不同的机器学习算法(如logistic regression, random forest, XGBoost);
- 对于用不同算法训练的模型,调整超参数,得到不同的模型。对于步骤2中提到的每个算法,改变超参数设置,并配备多个模型;
- 在验证集上测试每个模型(属于每个算法)的性能;
- 从验证数据集中测试的模型中选择最优的模型。对于特定的算法,最优模型将具有最优的超参数设置;
- 在测试数据集中测试最优模型的性能;
- 总结图:
Cross-Validation(交叉验证)/ k-fold Cross-Validation(K折交叉验证) & Nested Cross-Validation(嵌套交叉验证)
k-fold Cross-Validation for Model Evaluation
- 交叉验证法(cross validation) / k折交叉验证(k-fold cross validation):将数据集 DDD 划分成 kkk 个大小相似的互斥子集,每个子集 DiD_iDi 都尽量保持数据分布的一致性(分层采样),每次用 k−1k - 1k−1 个子集的并集作为训练集,余下一个作为测试集,即获得 kkk 组数据进行 kkk 次训练测试,最终结果为 kkk 次训练测试的均值
- 随机划分:随机使用不同的划分重复 ppp 次,最终结果是这p次k折交叉验证结果的均值
k-fold Cross-Validation for Model Selection
- k-fold Cross-Validation 也可以作为参数调优方法
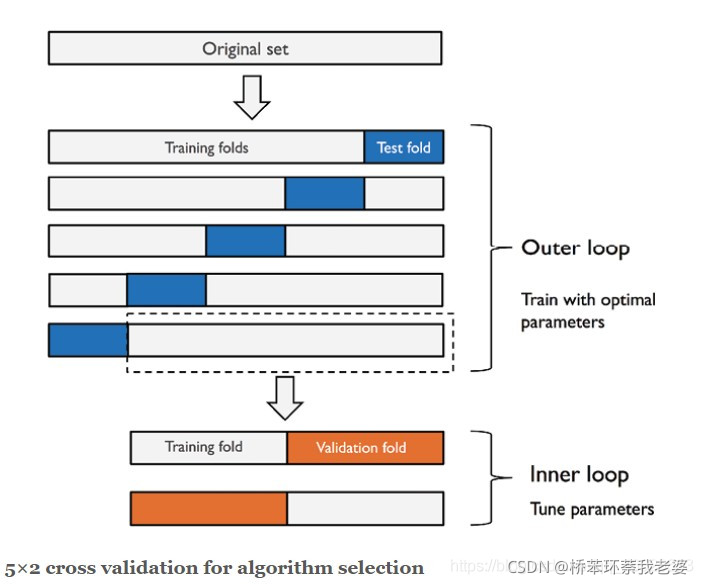
- 在 k-fold Cross-Validation for Model Evaluation 基础上,训练集(train)进一步划分成 k′k'k′ 个大小相似的互斥子集,每次用 k′−1k' - 1k′−1 个子集用于训练,一个作为验证,即这样得到 k′k'k′ 组训练/验证集,从而进行 k′k'k′ 次训练验证,根据结果模型选择和进行超参数调整
Nested Cross Validation(嵌套交叉验证)
- 两种方法的嵌套使用两者,如下图:
机器学习评估方法
- 以下为 Brief Talk ,以后单开一章节
- 混淆矩阵 —— 精度评价(准确率,精确率,召回率,P-R区县,F1-score,ROC值与AUC值)
- 距离/相似性 —— 余弦距离,欧氏距离
- A/B测试
- Holdout检验
- 交叉检验 / k-fold交叉验证 / 自助法
- 超参数调优 —— 网格搜索、随机搜索、贝叶斯优化
- 过拟合 & 欠拟合

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 1
 0
- 0


 已为社区贡献4条内容

所有评论(0)