李宏毅机器学习笔记
李宏毅机器学习笔记
看李宏毅的机器学习总结的笔记,自己复习用。
神经网络训练效果不好解决方法
局部最小和鞍点
优化失败:卡在了critical point(驻点)
1.局部最小点
2.鞍点
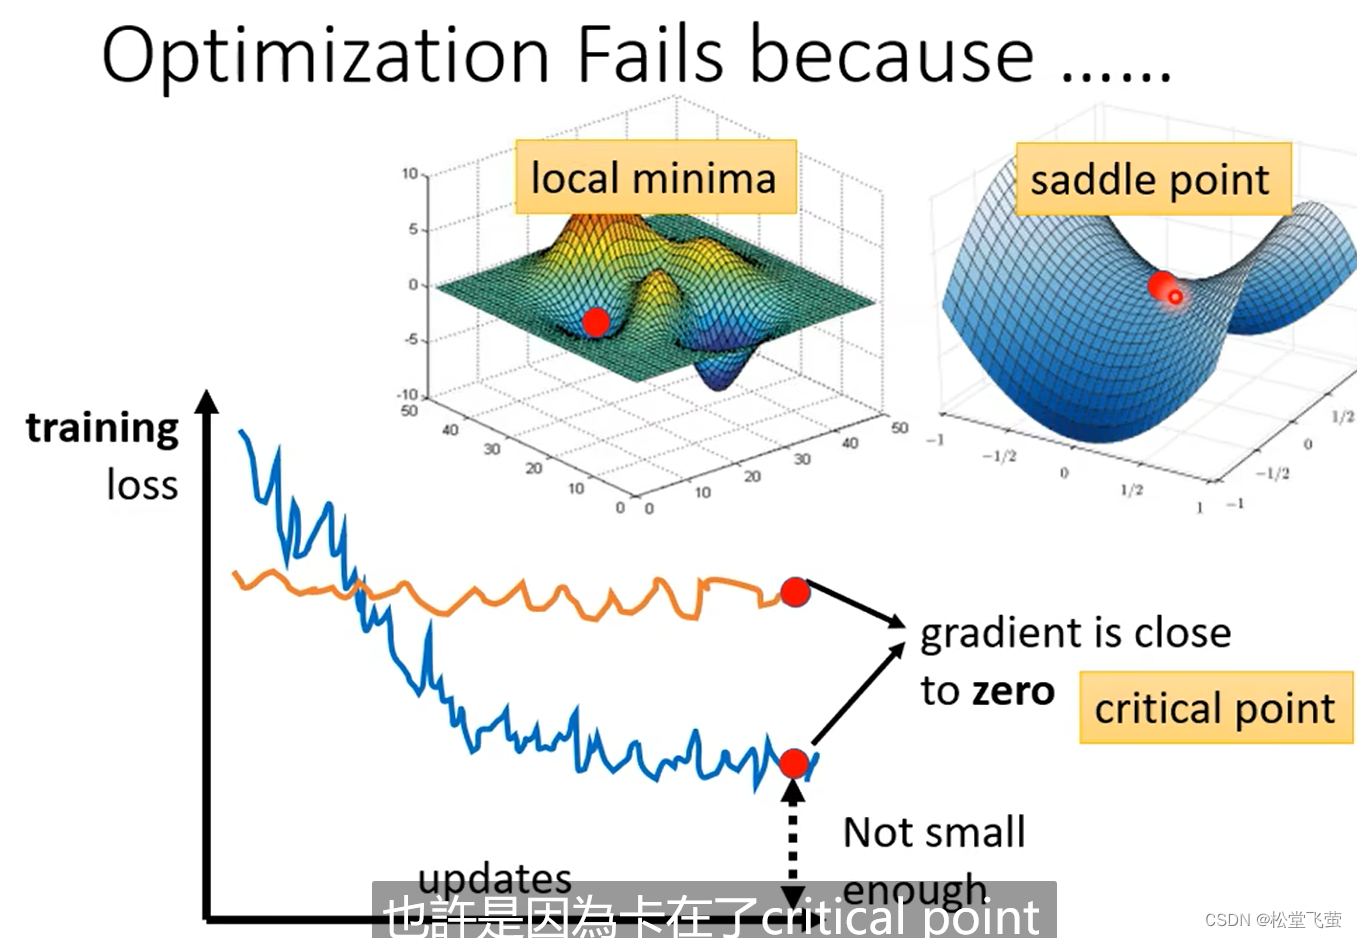
鞍点的话可解,但是局部最小值不可解,
通过增加维度,使得低维角度的局部最小点 从高维角度看成为了鞍点。
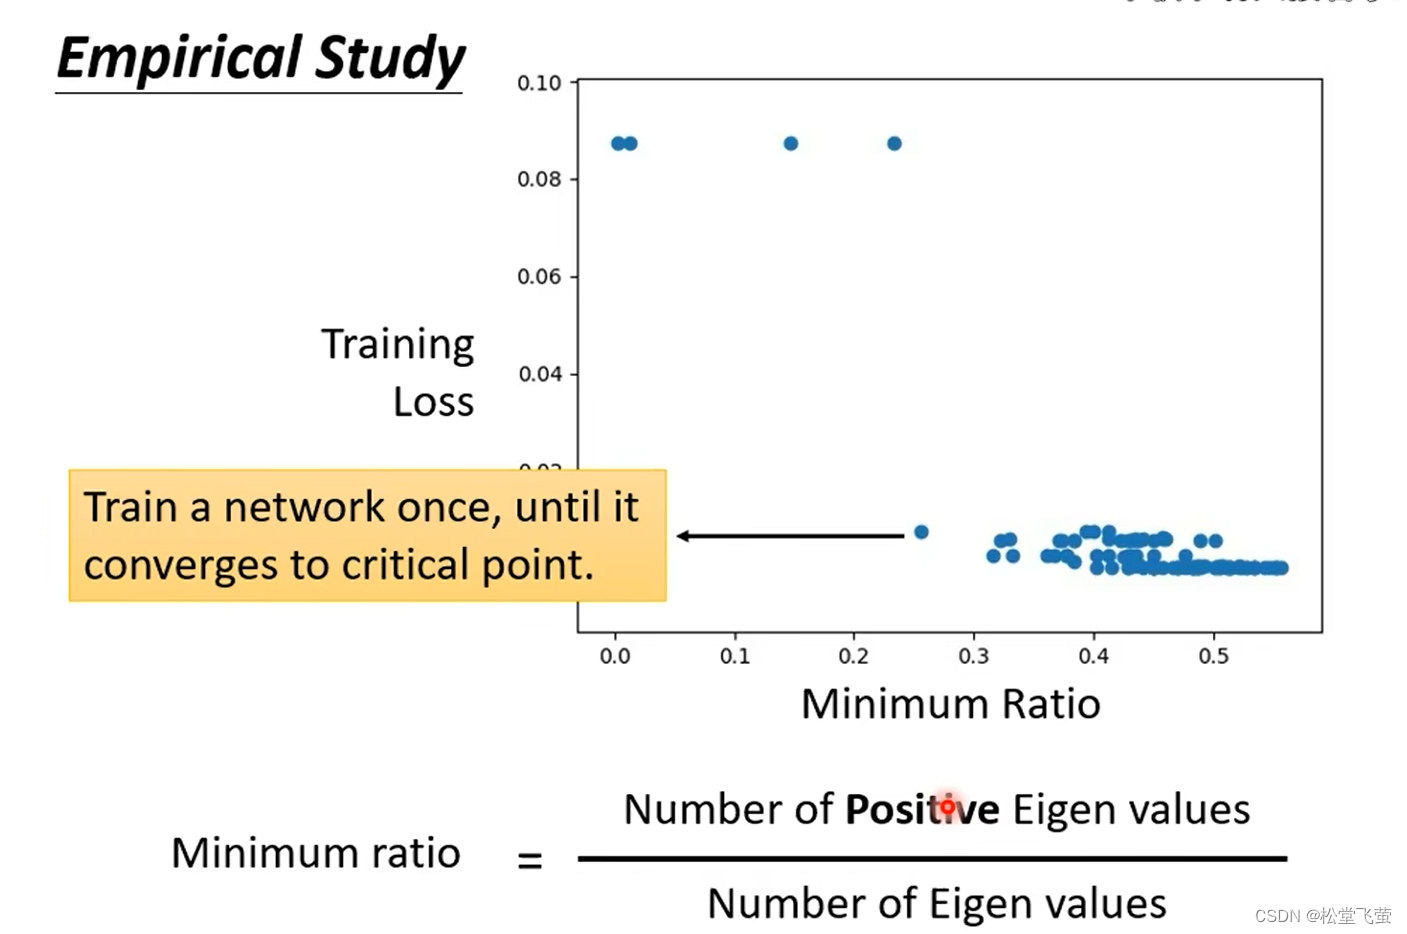
如果所有的eigen values为正,说明为局部最小
否则为鞍点
批次和动量
batch
批次:batch
每次取出一部分batch的训练集来代替整体的训练集求梯度。
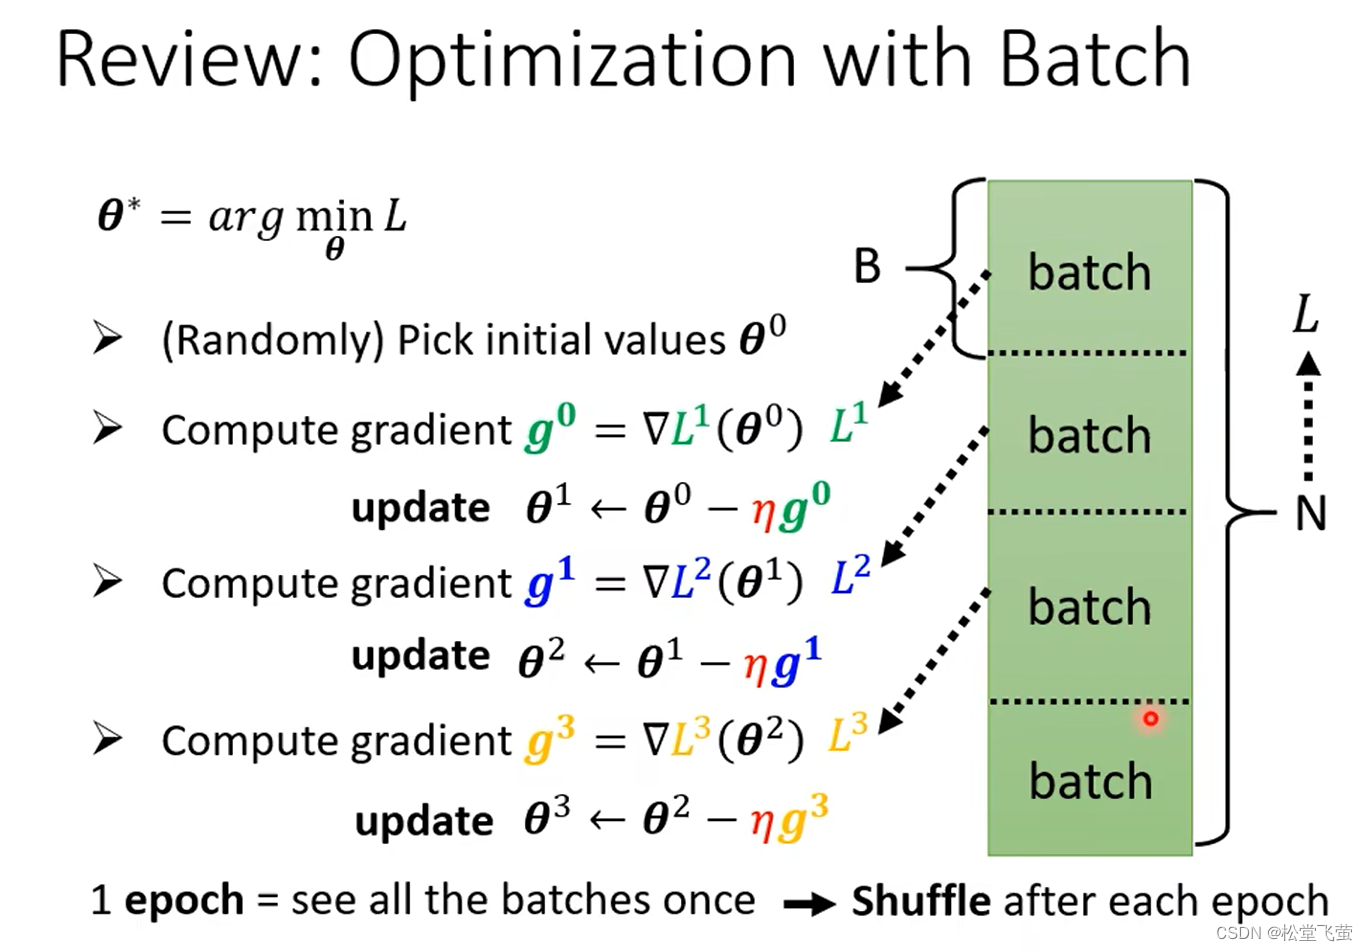
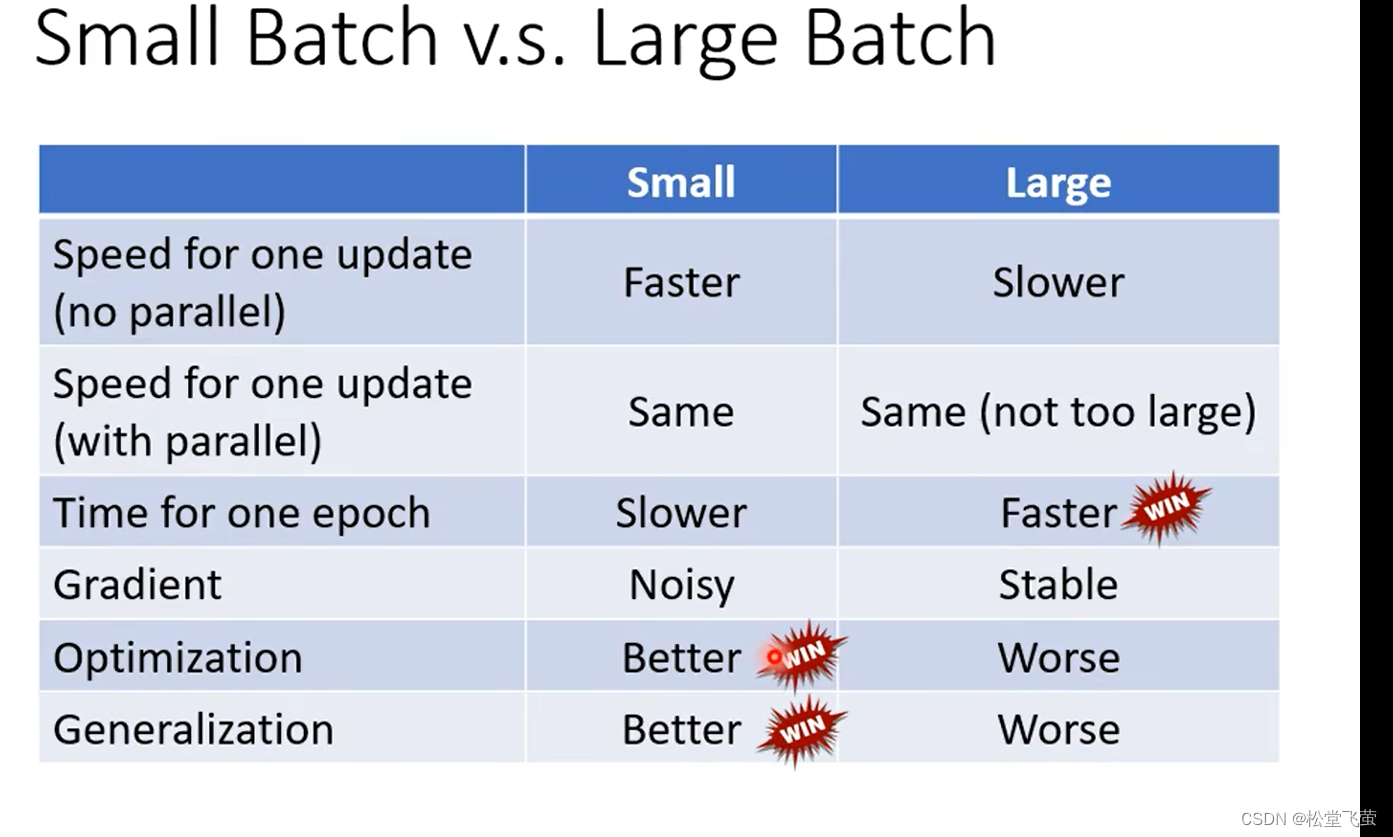
一次epoch对比举例
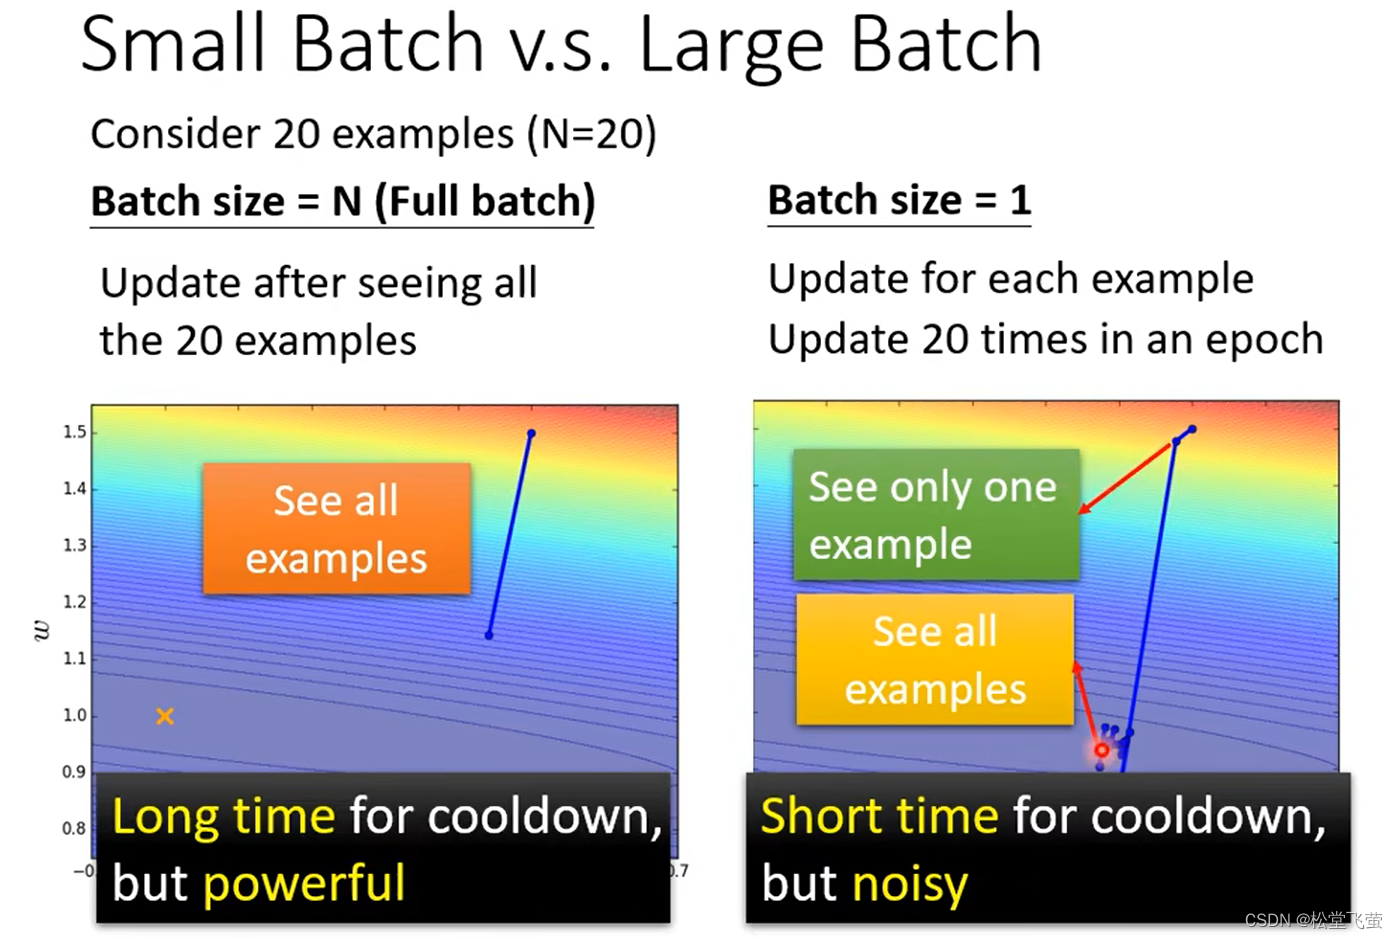
由于并行运算,左边不是很长,但是并行有极限。
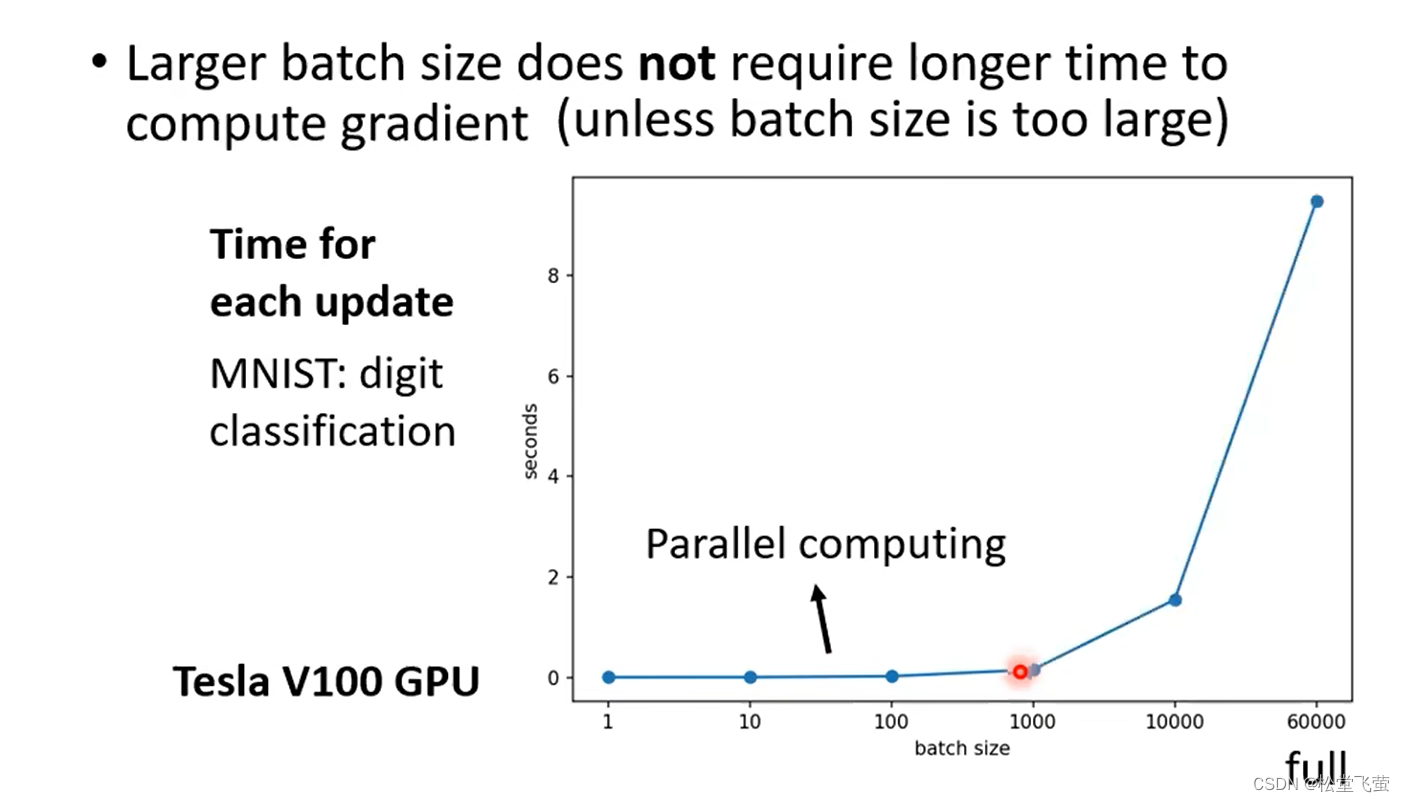
比较实际一次epoch
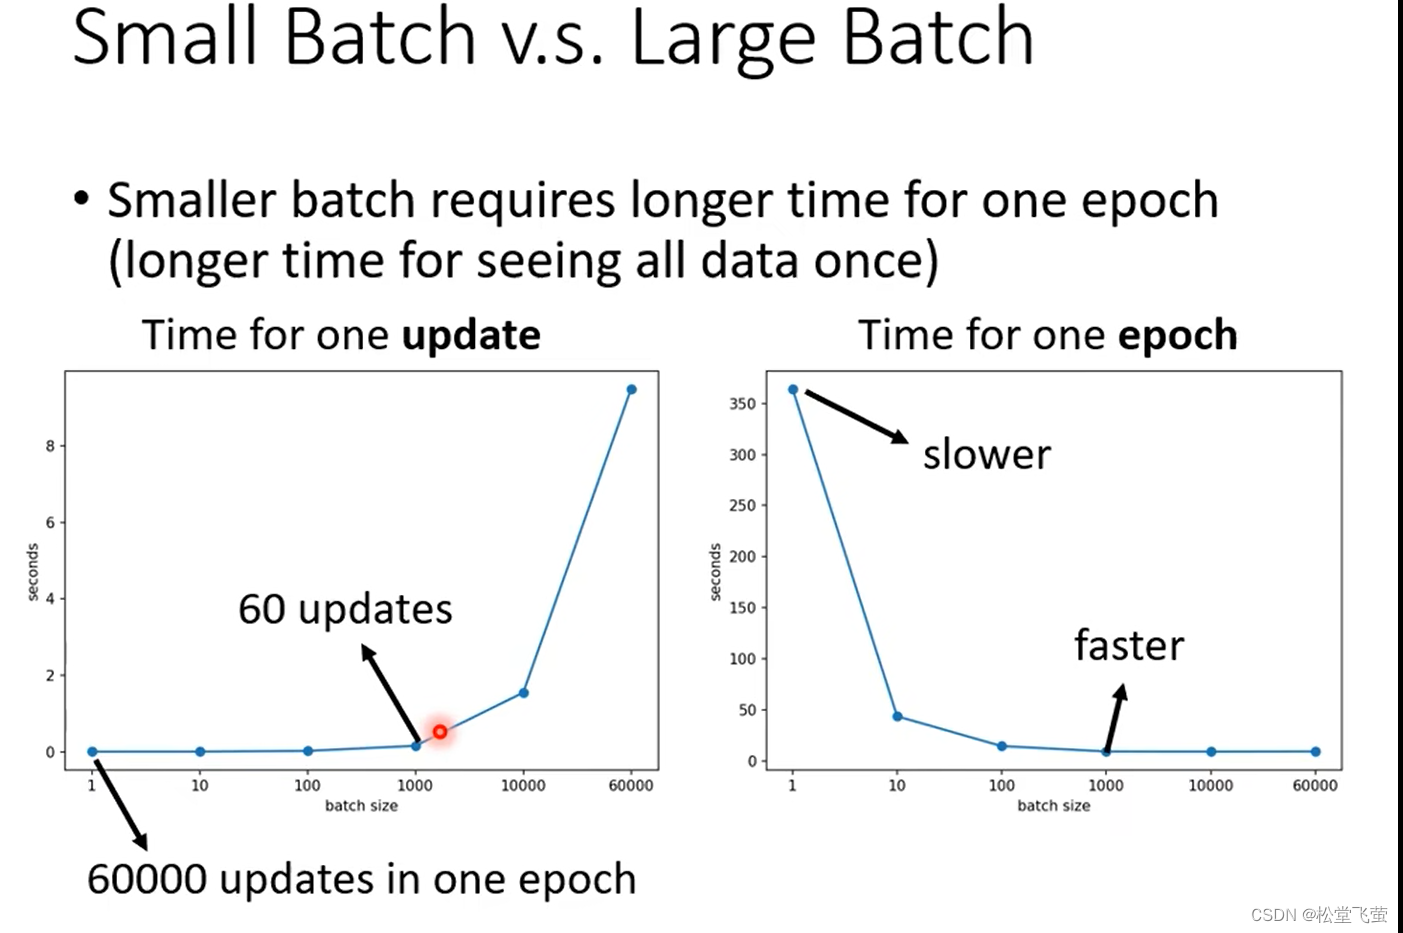
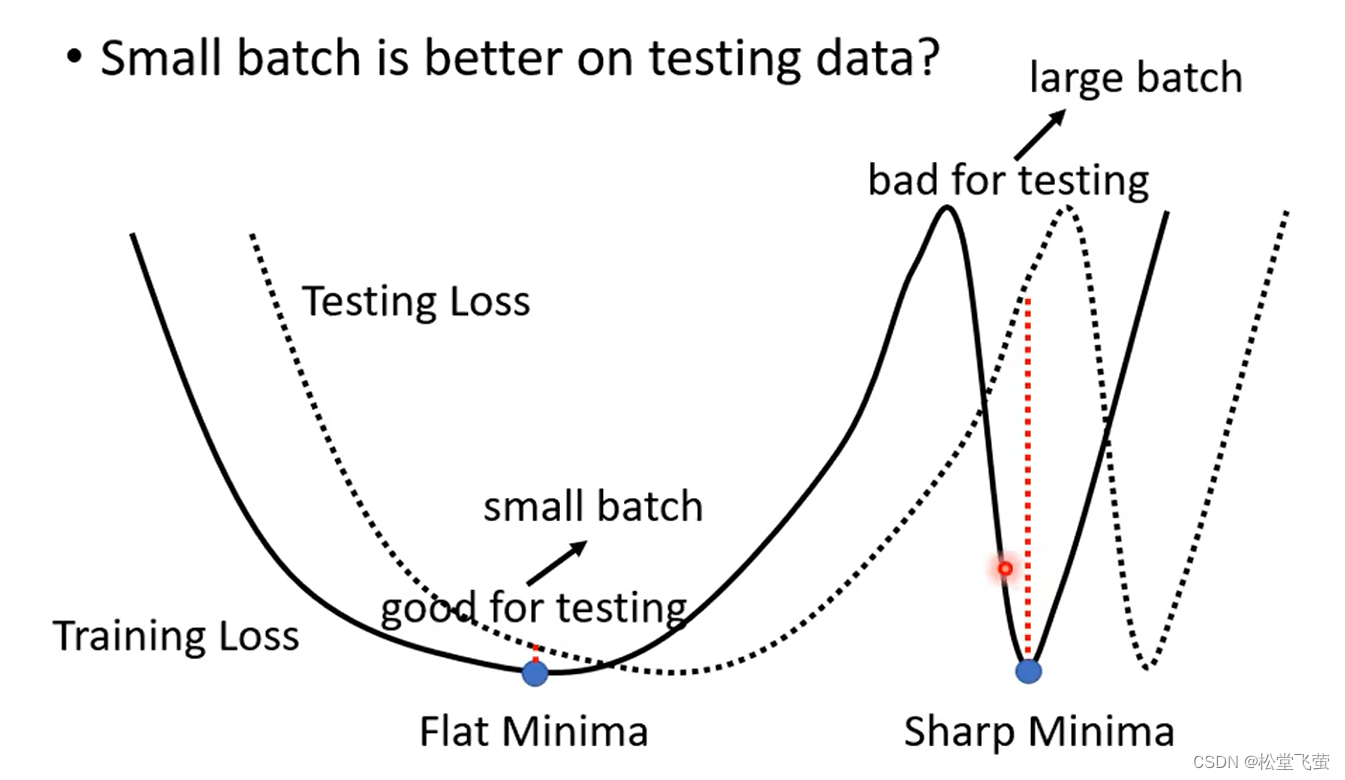
但是大的batchsize会带来一个比较差的结果,如下:
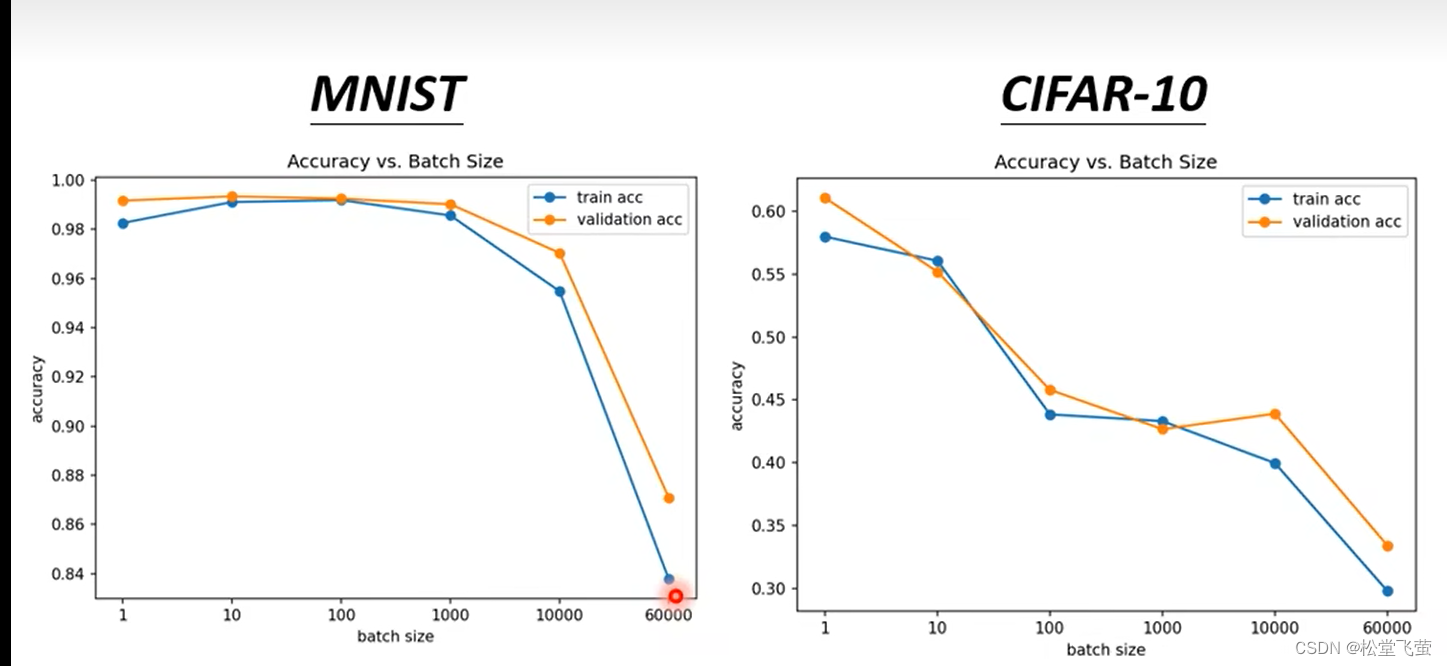
一个解释是:小批量可以跳过局部最优点
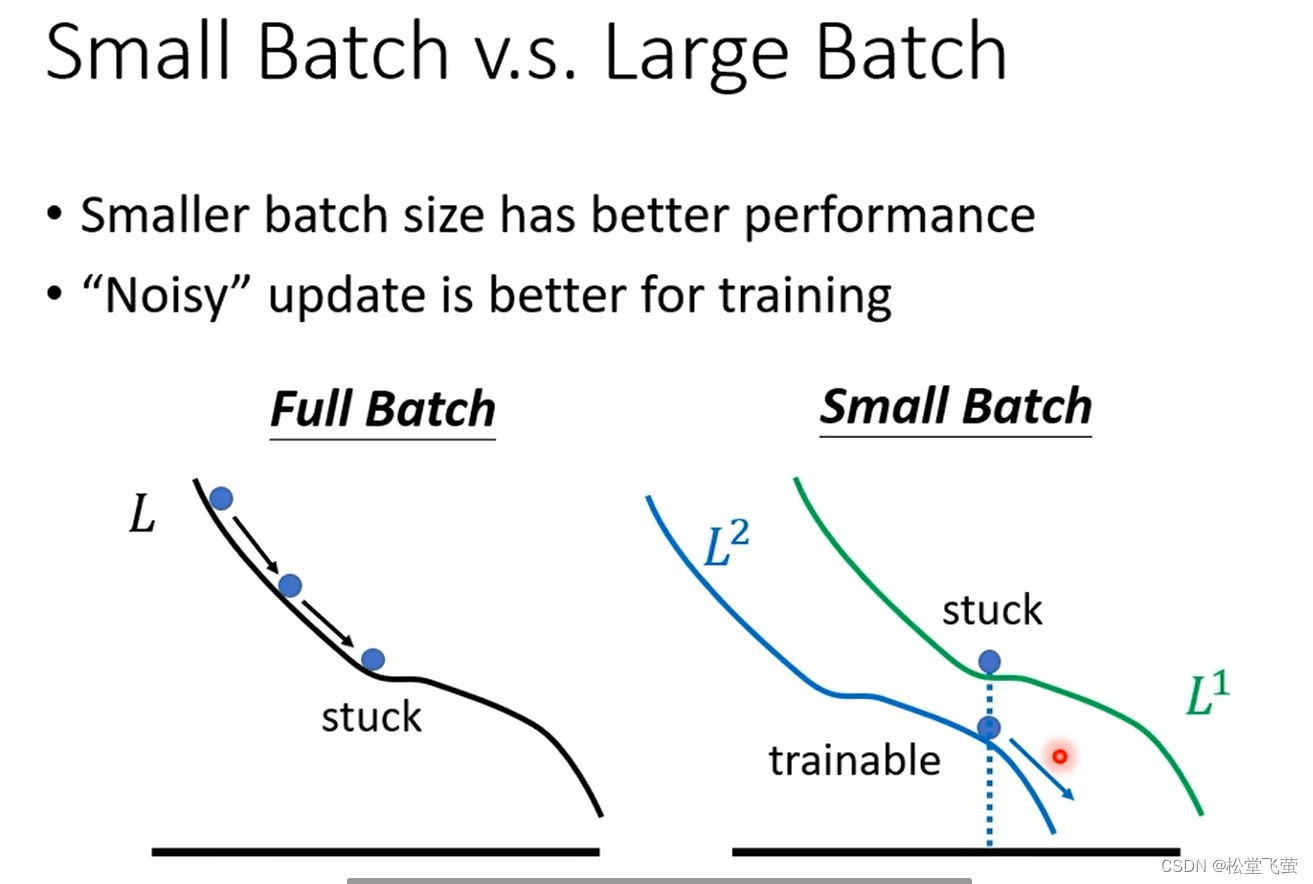
想到的有两点:
-
epoch的batch_size约小则每个batch的分布差异越大,训练的epoch往往是多次的,同时因为shuffle,相当于提高了数据量。
-
batch_size与整体分布具有一定差异时,更容易帮助模型突破鞍点,相对于方向的不稳定,没有梯度才是最致命的。
但是,当设置到train loss在大小batch size相同时,在测试集上的表现,还是小的batch好。
momentum
不止往梯度的反方向移动参数,而是通过上一步的方向加上新的一步的方向的新方向进行移动。
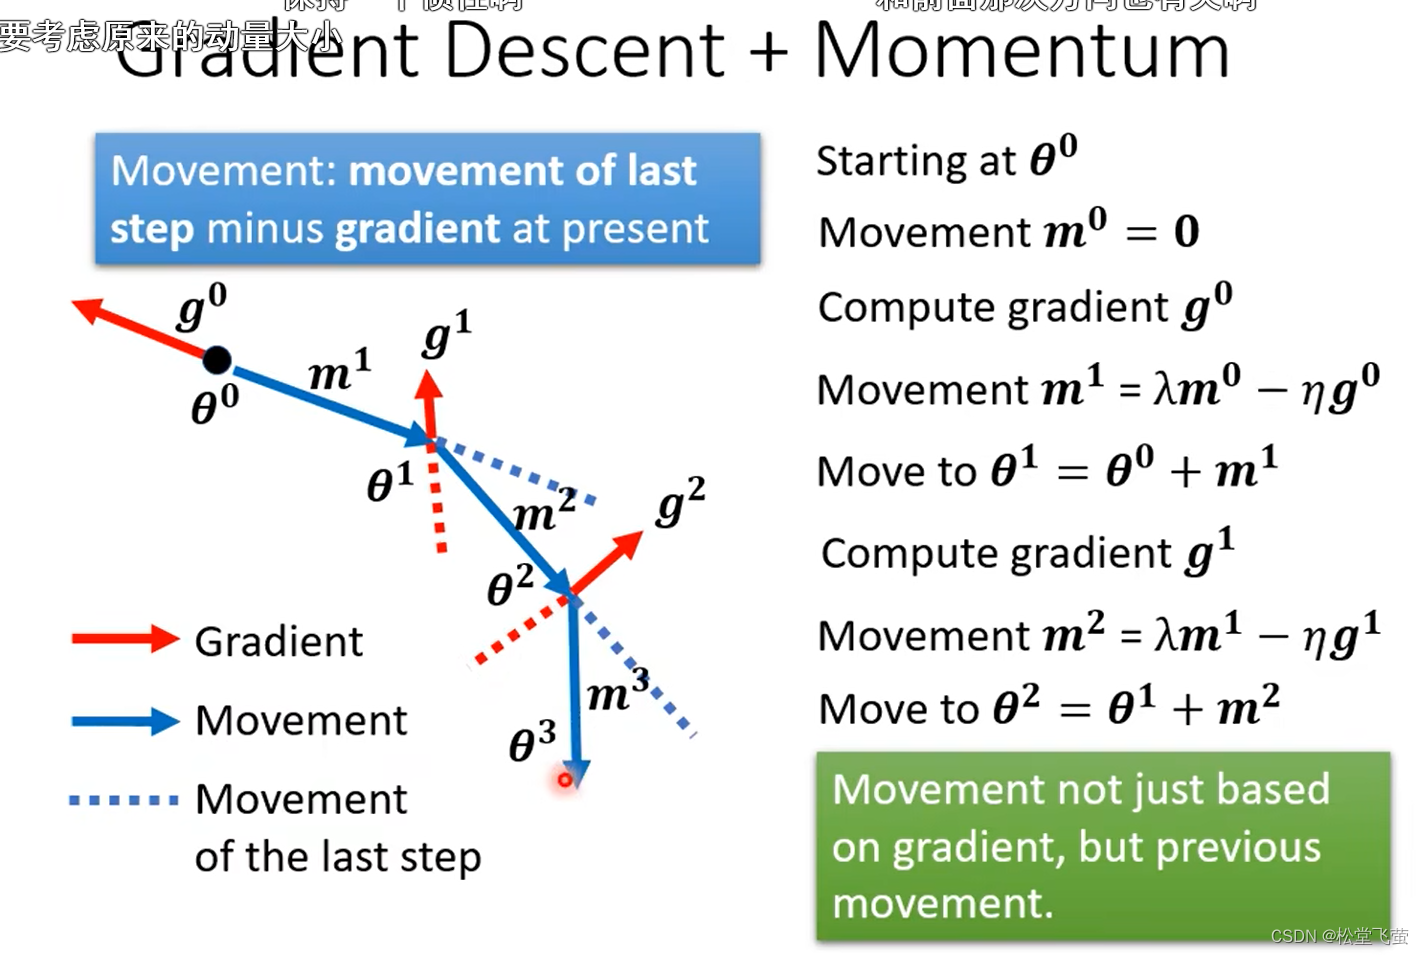
另一种角度,m是考虑过去所有的方向的耦合
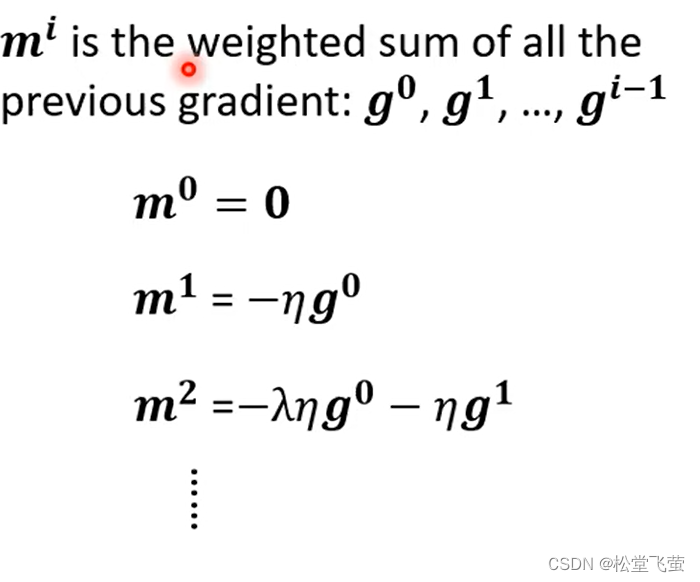
learning rate
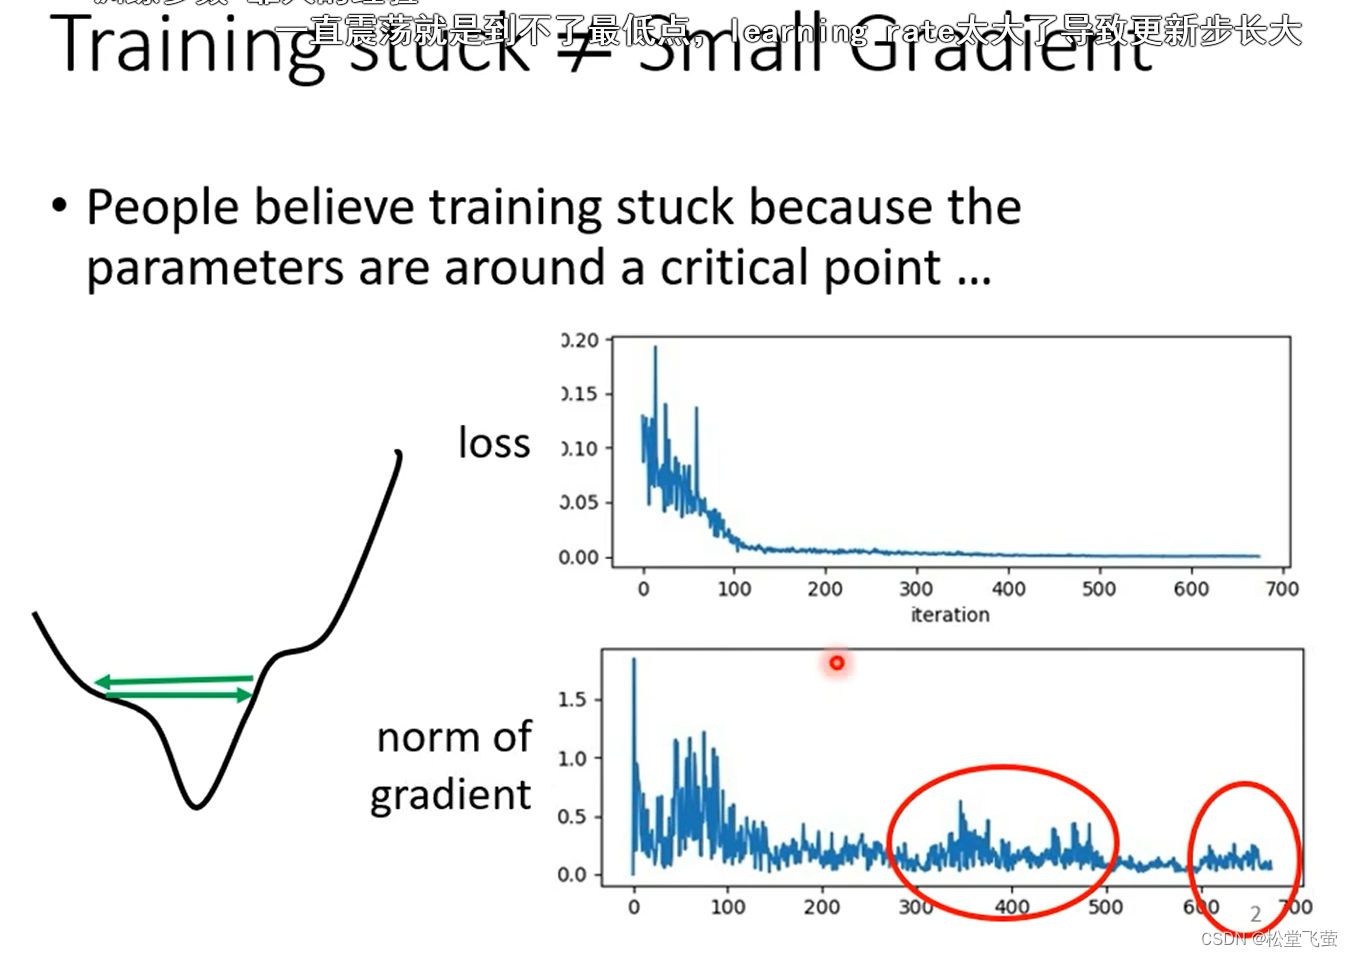
比驻点更麻烦的是,实际上很难达到critical points 附近,而是左右摇摆,如下图
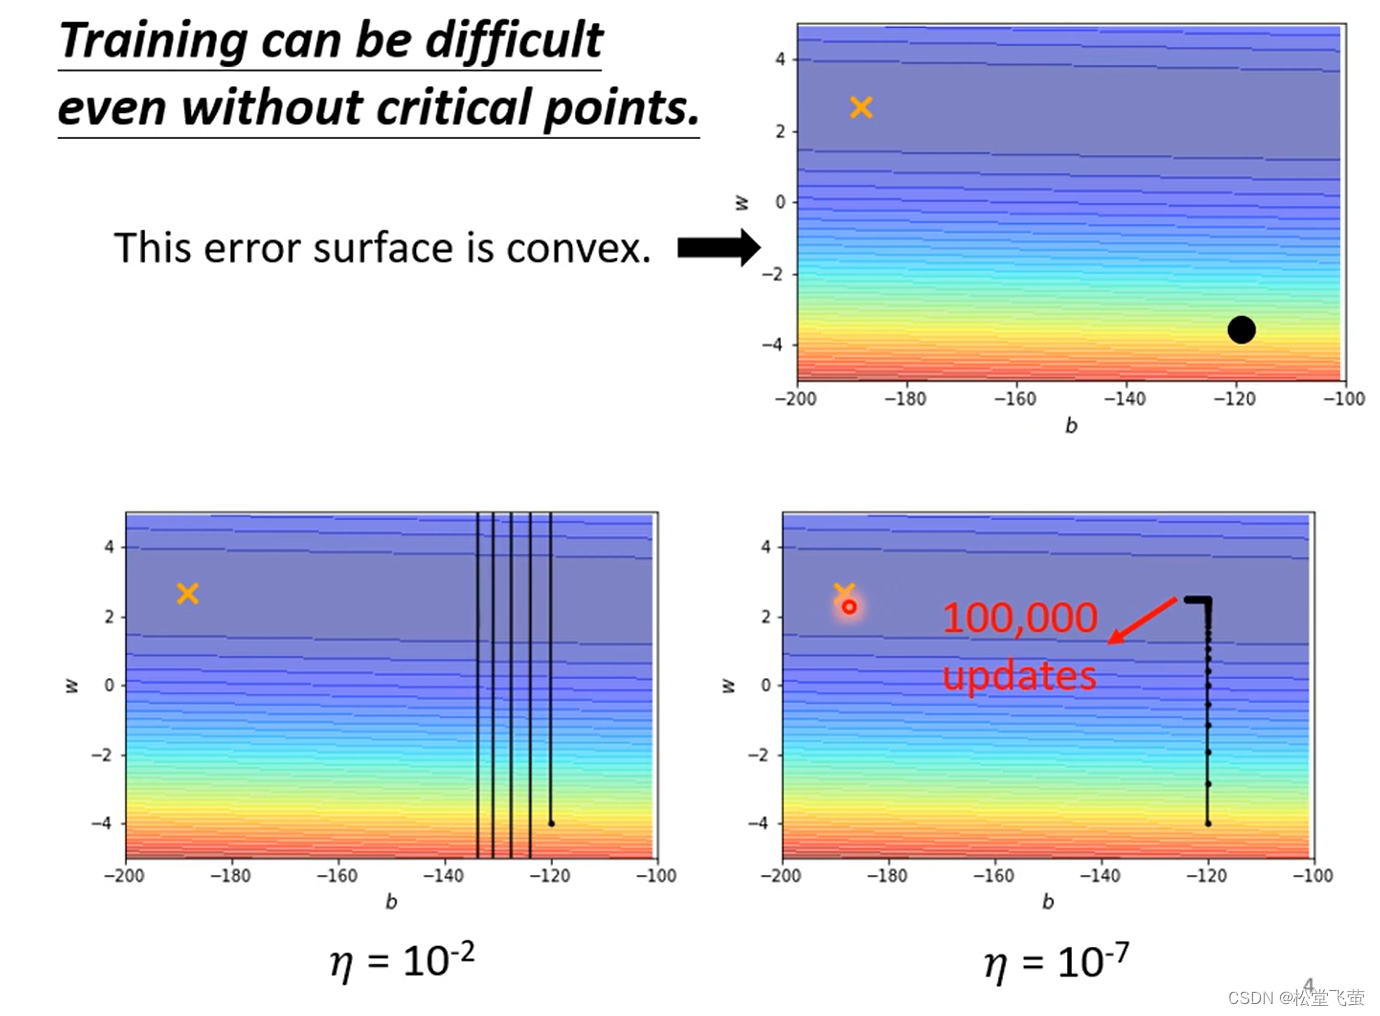
特制化学习率
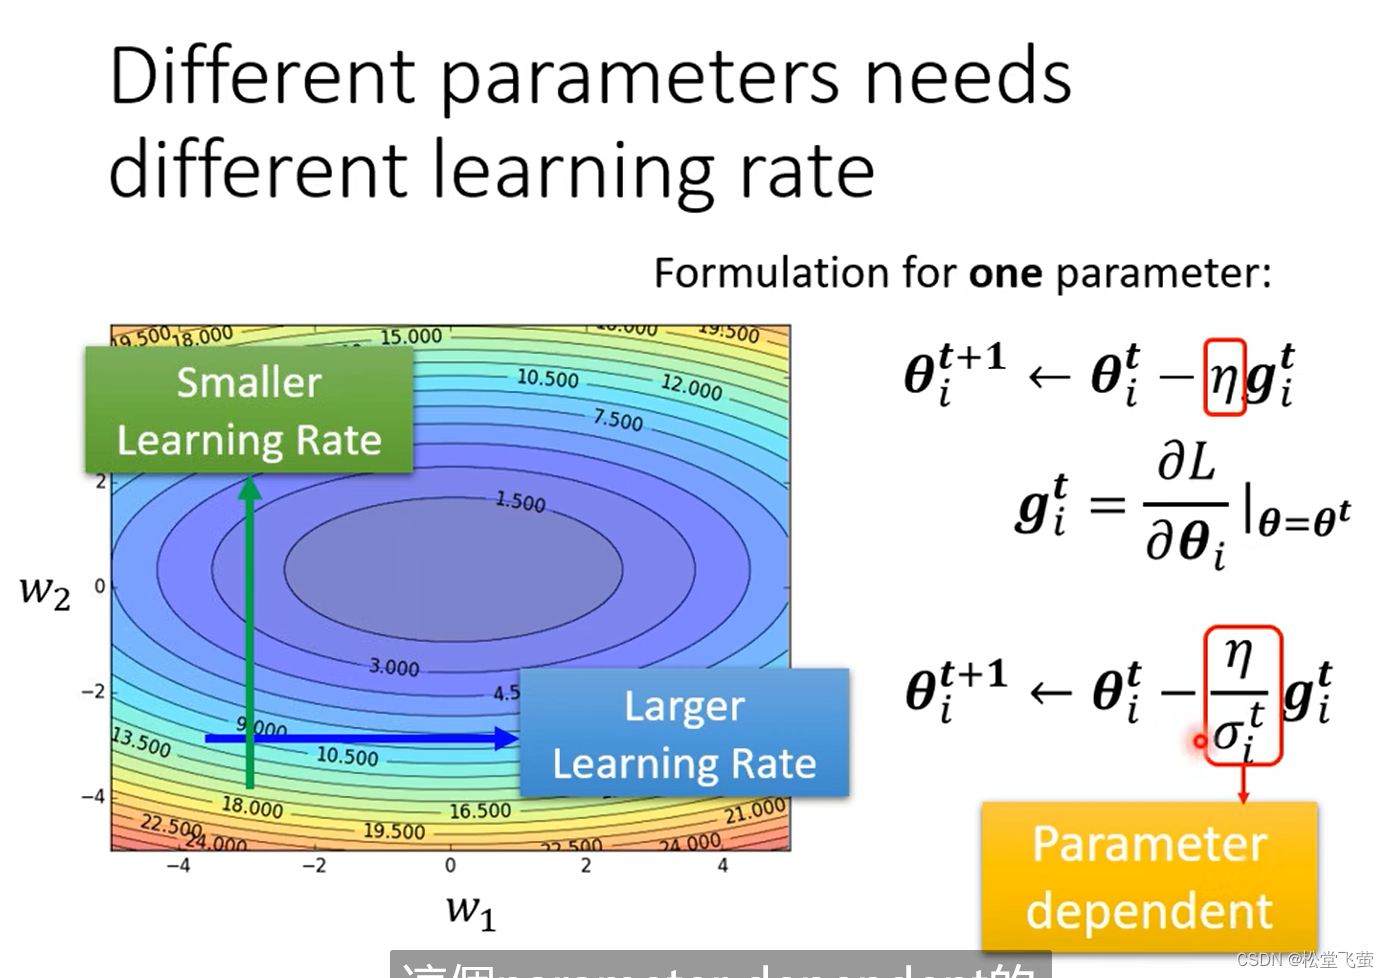
学习率也会改变
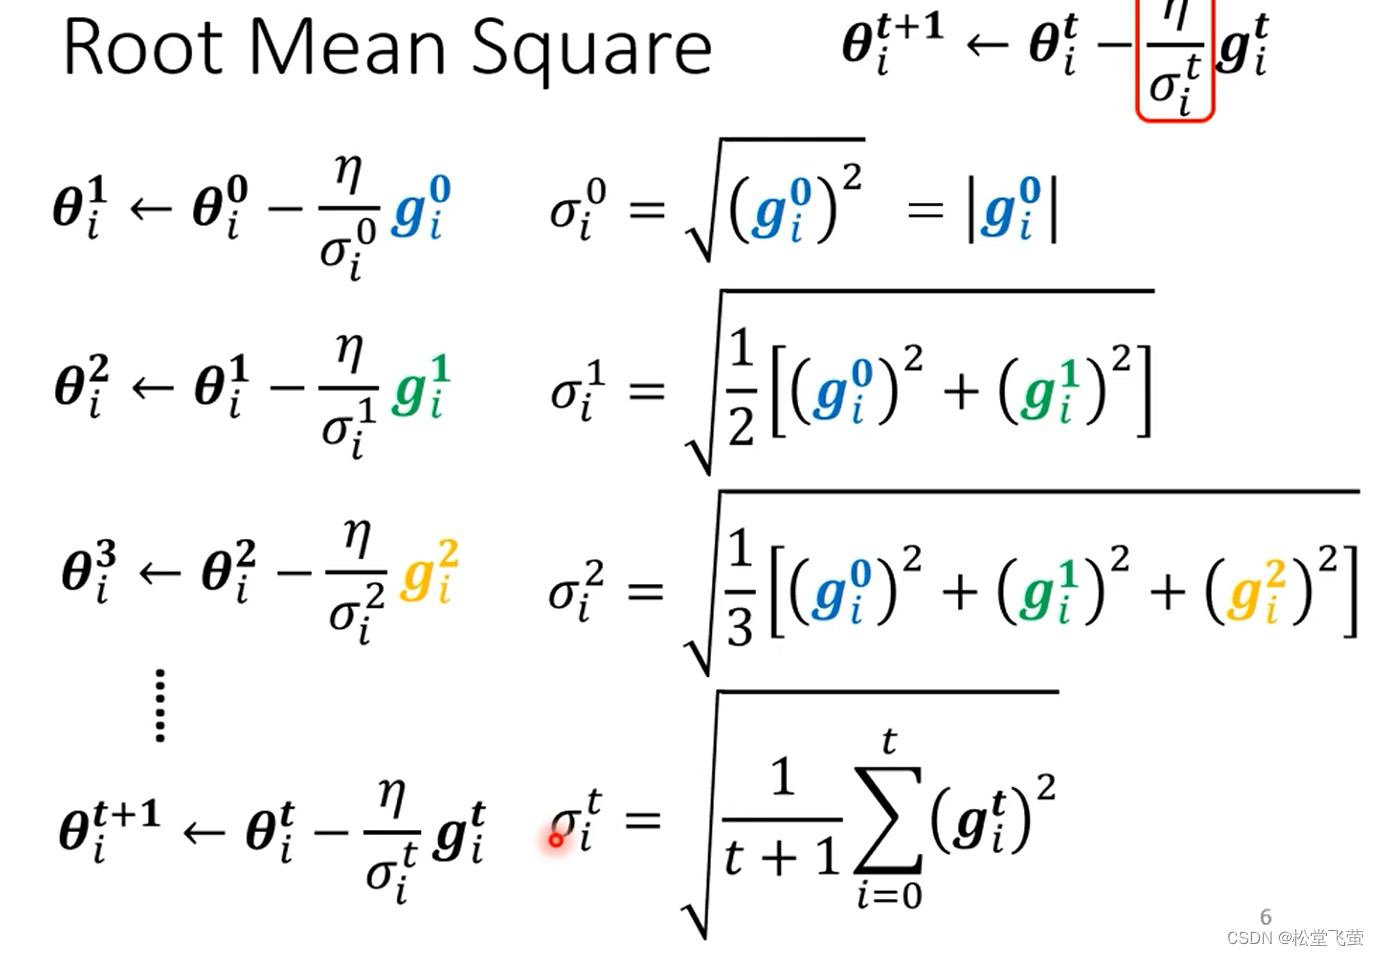
最终结果:大梯度,学习率小,小梯度,学习率大。
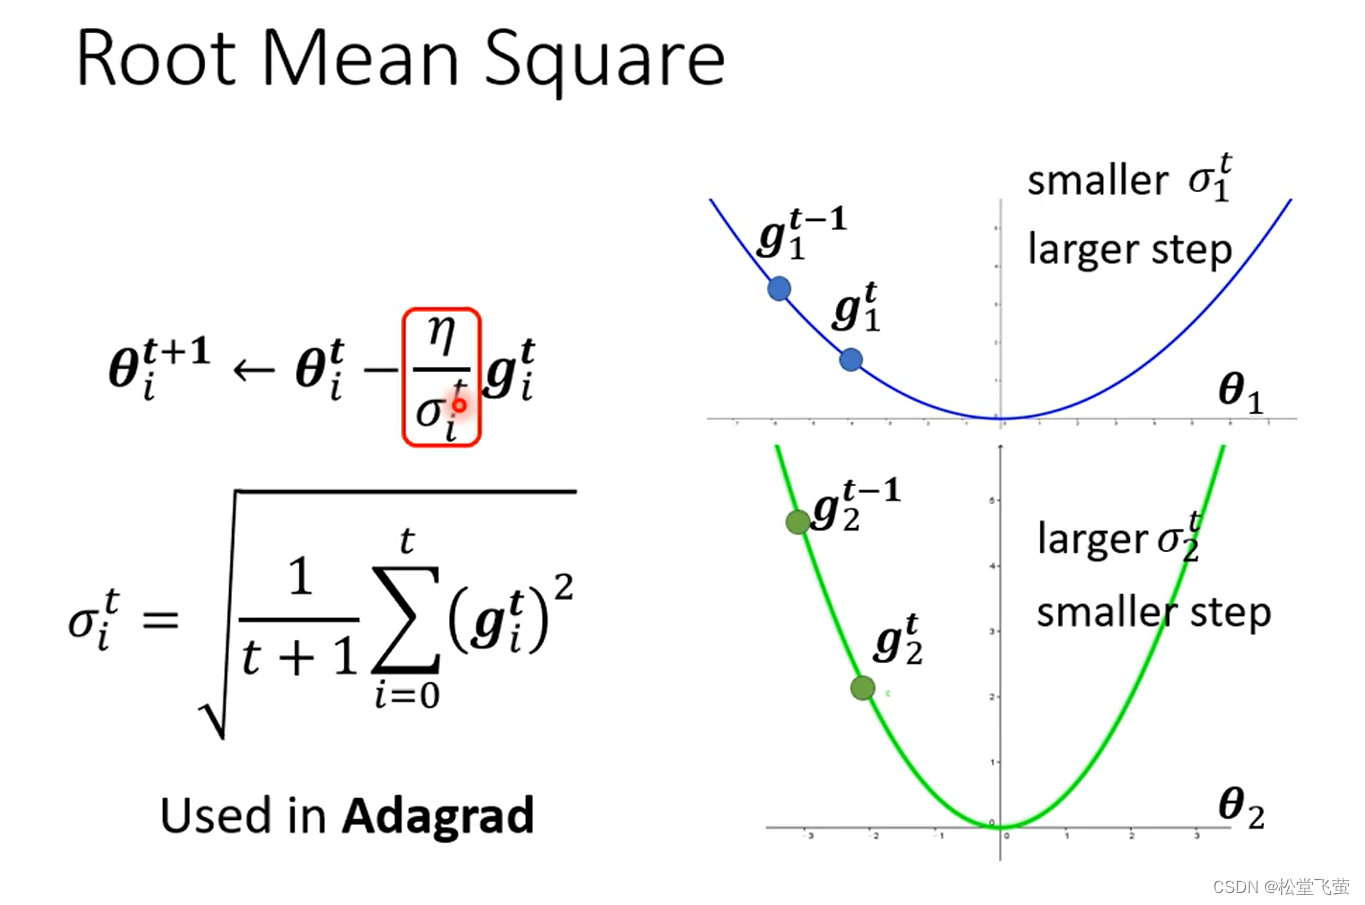
但是仍不够,我们期待:学习率在同一个参数,同一个方向上,也可以动态的调整。
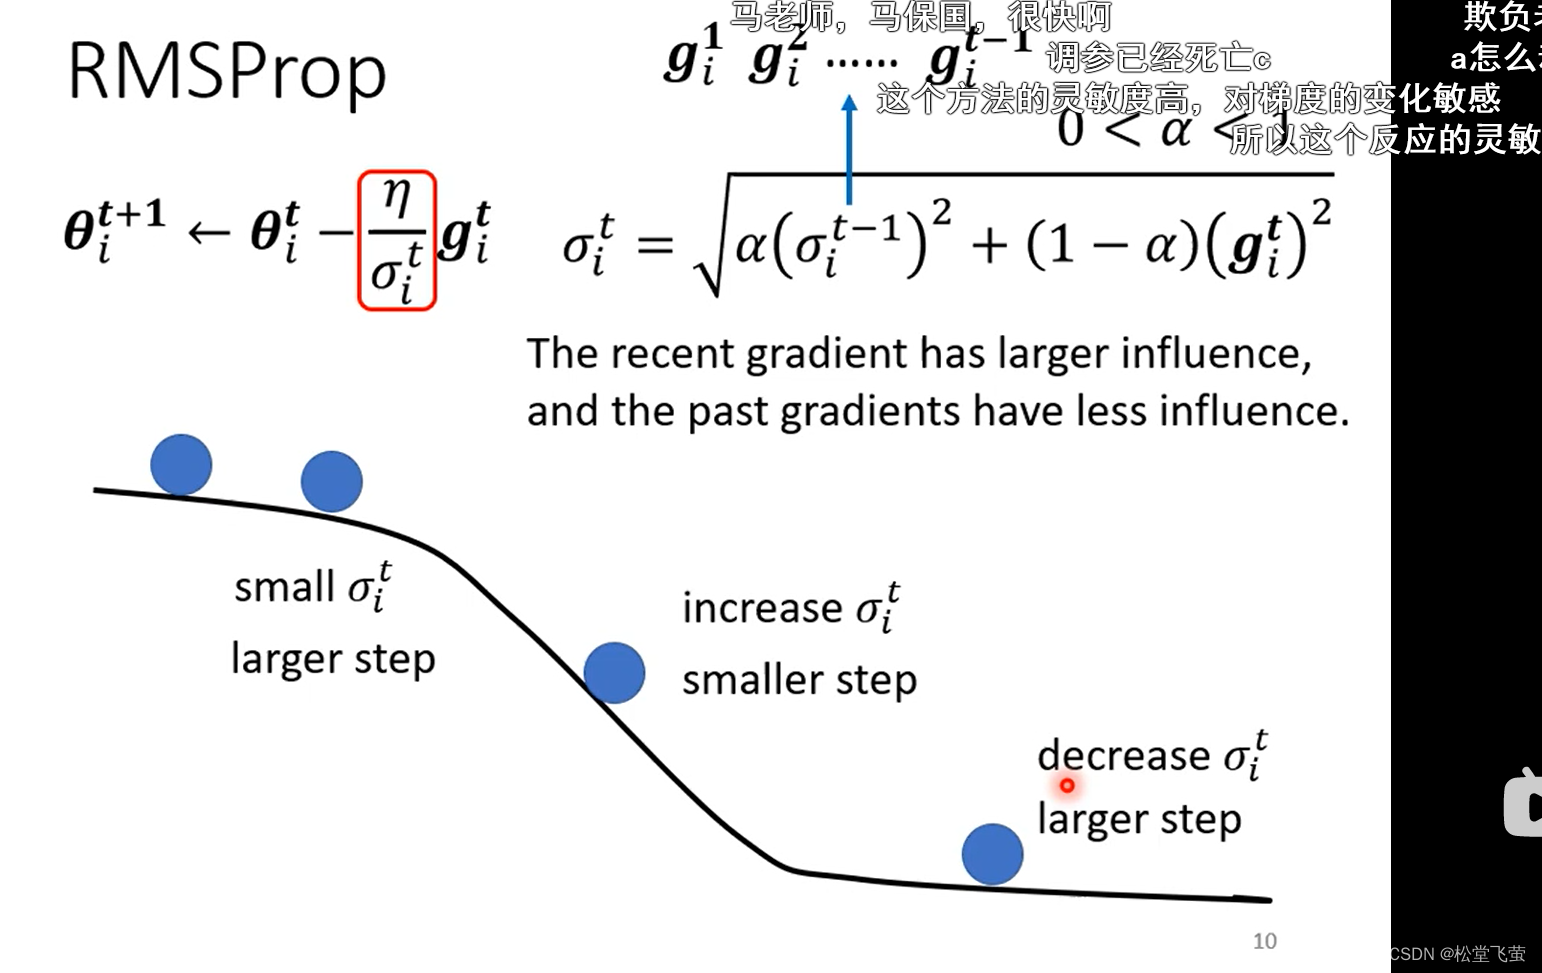
RMS Prop
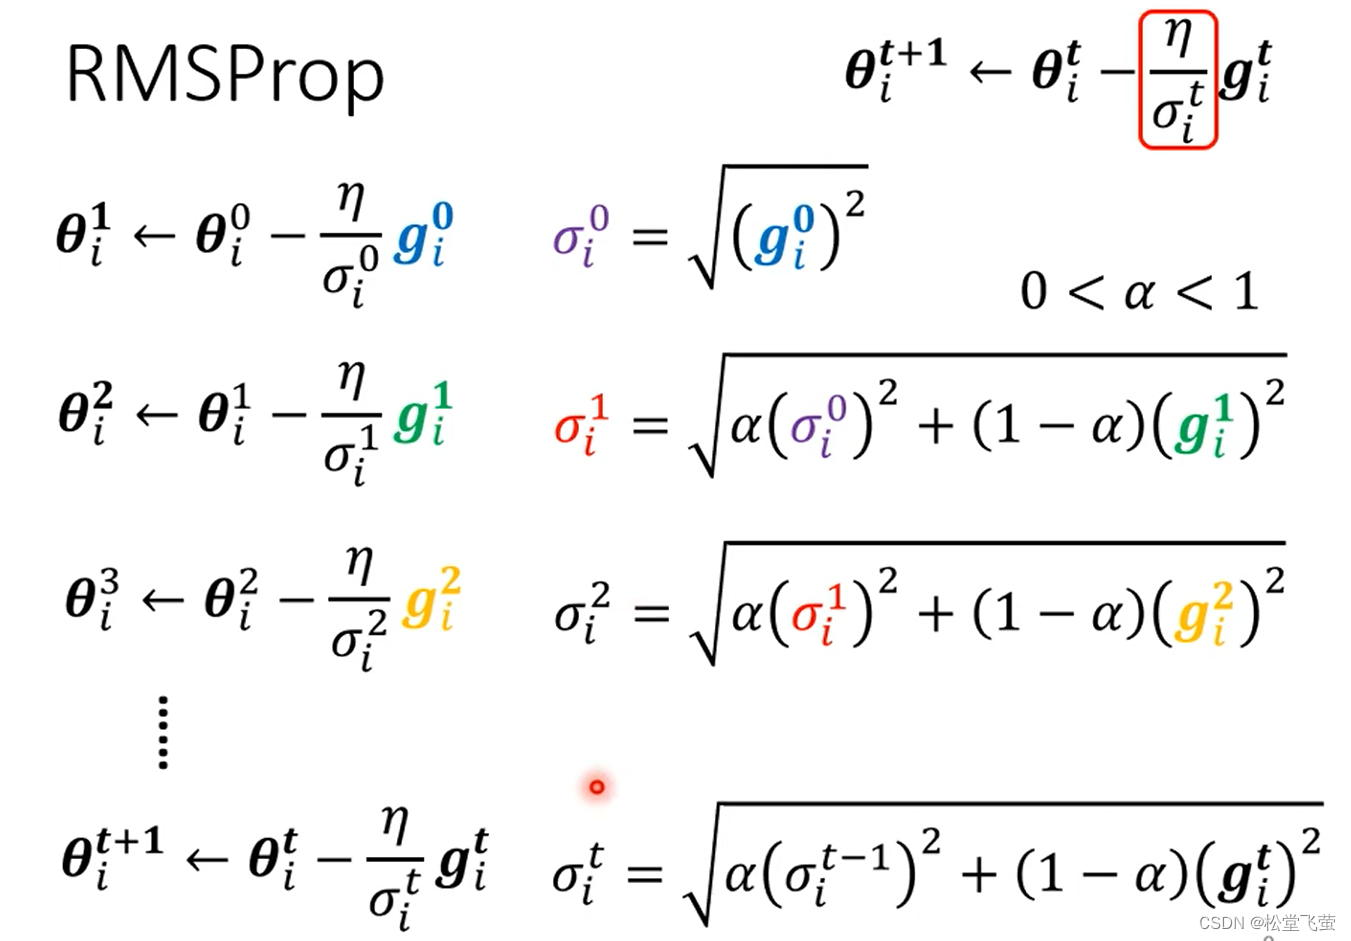
举例:
杀死比赛的优化方法:Adam
Adam= RMS Prop + Momentum
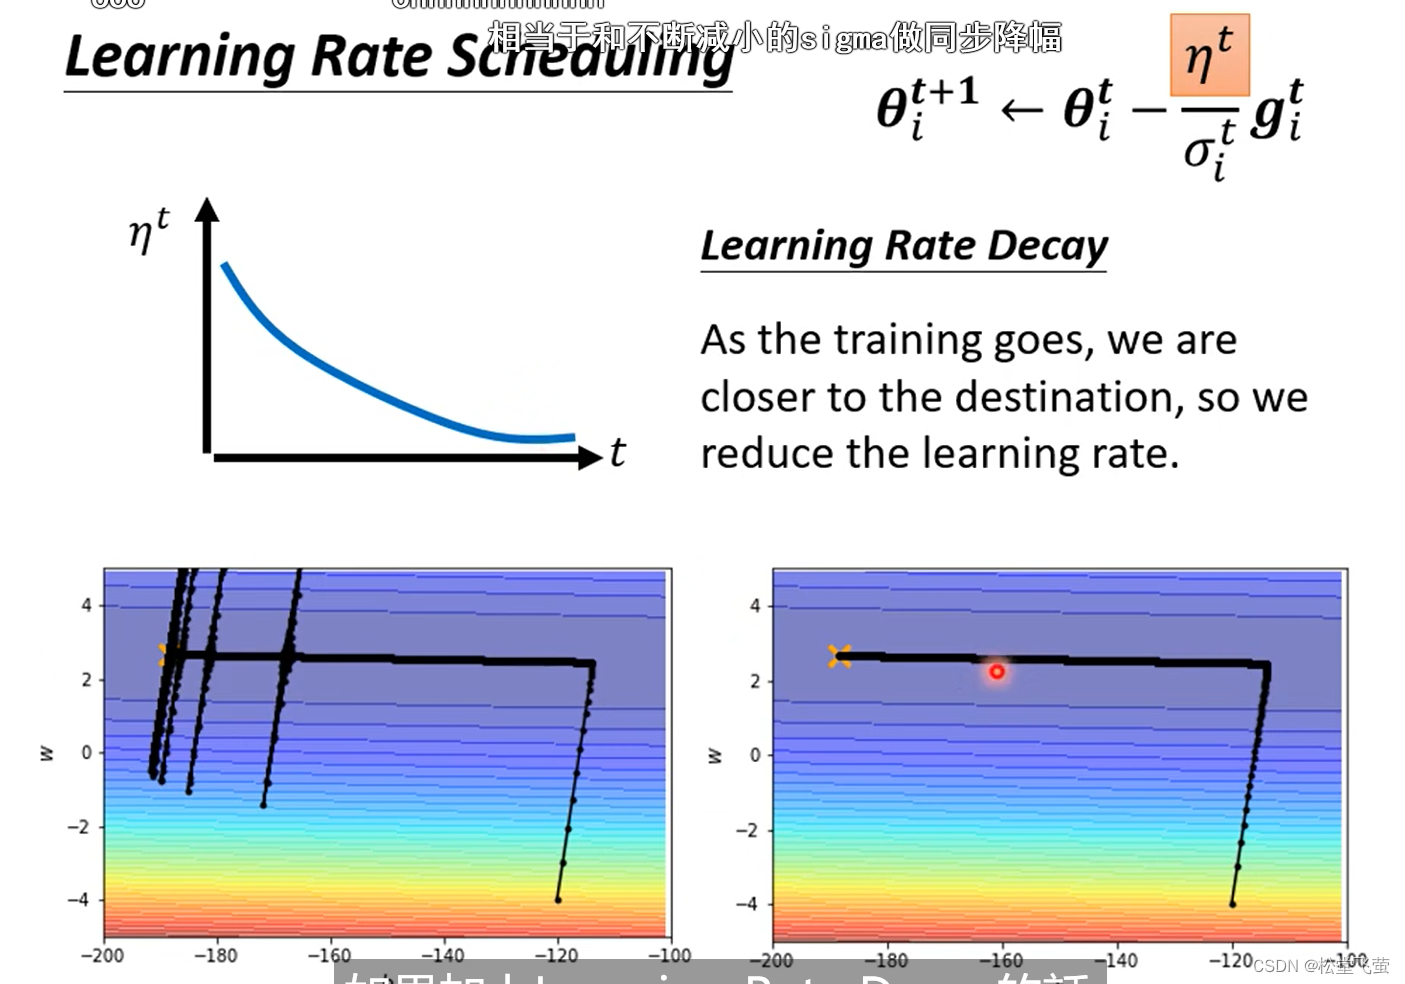
learning rate scheduling
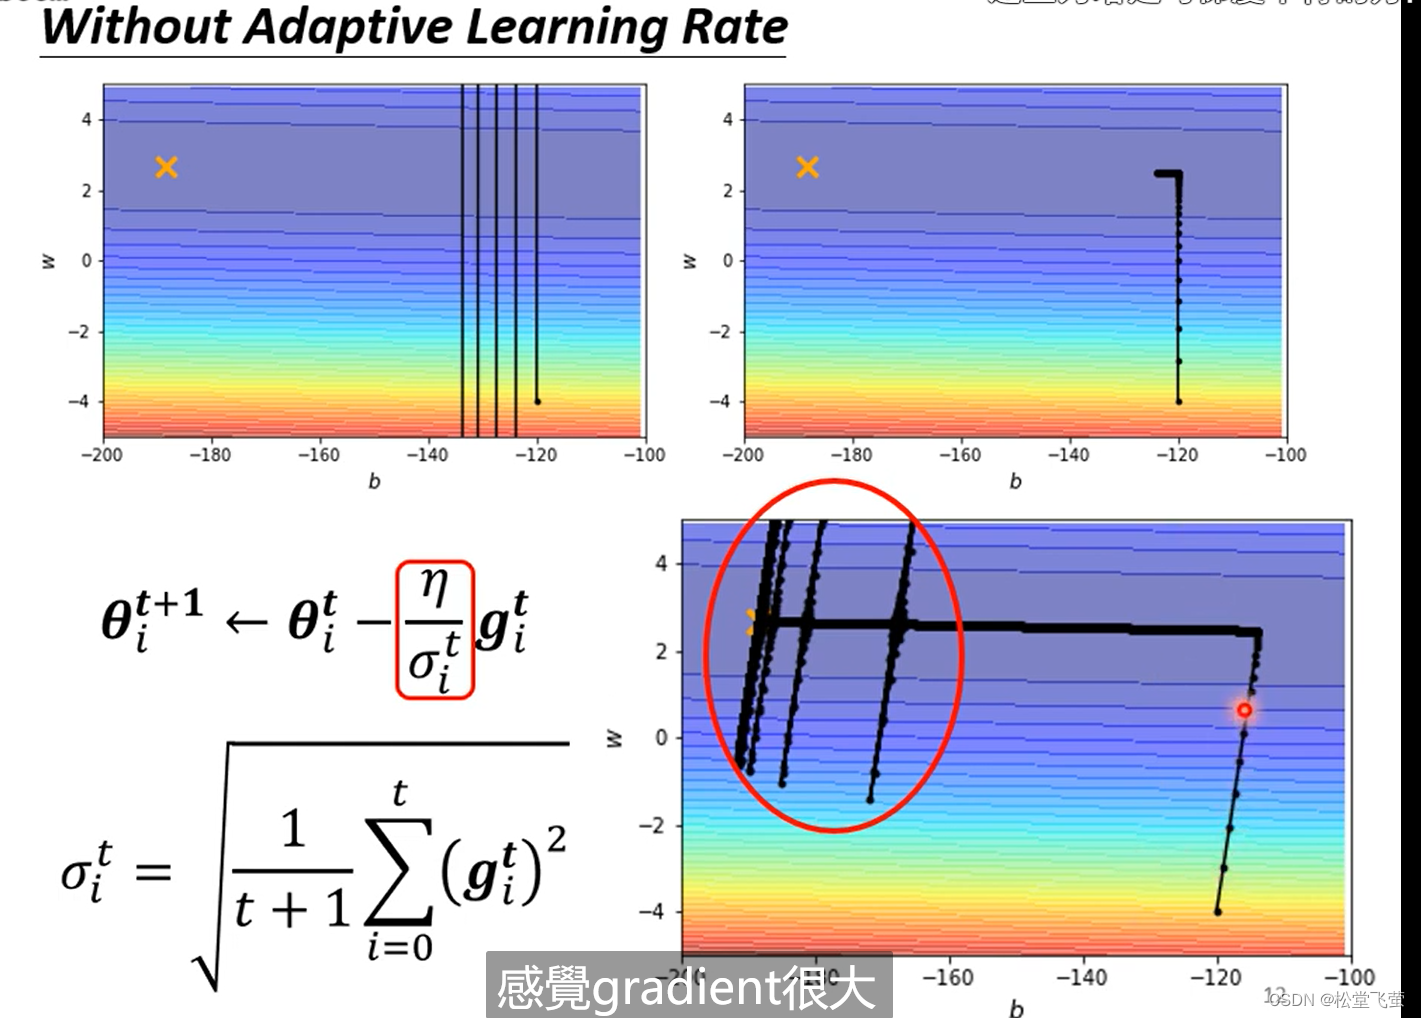
采用Adagrad:
喷的地方是从平滑突然到了陡峭的区域,斜率变大的同时学习率不能及时下降引发的问题
learning rate decay
随着时间来限制学习率的大小
warm up
学习率先增大,后减小
(hyperparameter)
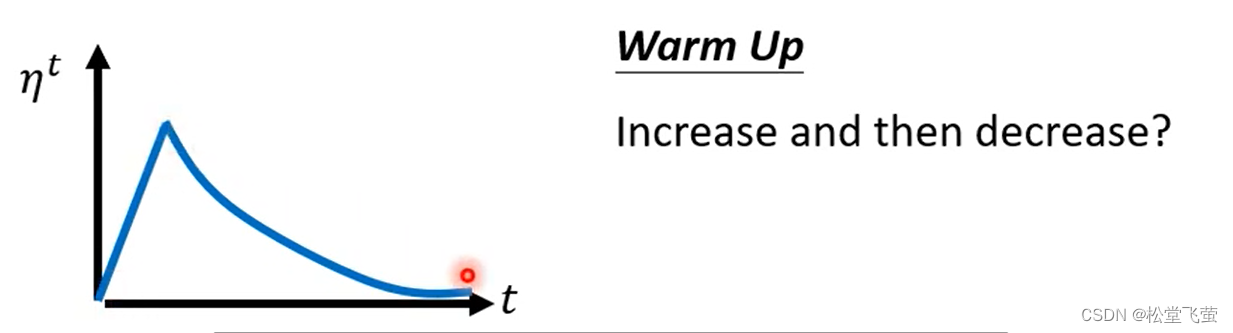
解释:开始时候,先收集sigma的统计数据,大致了解error surface
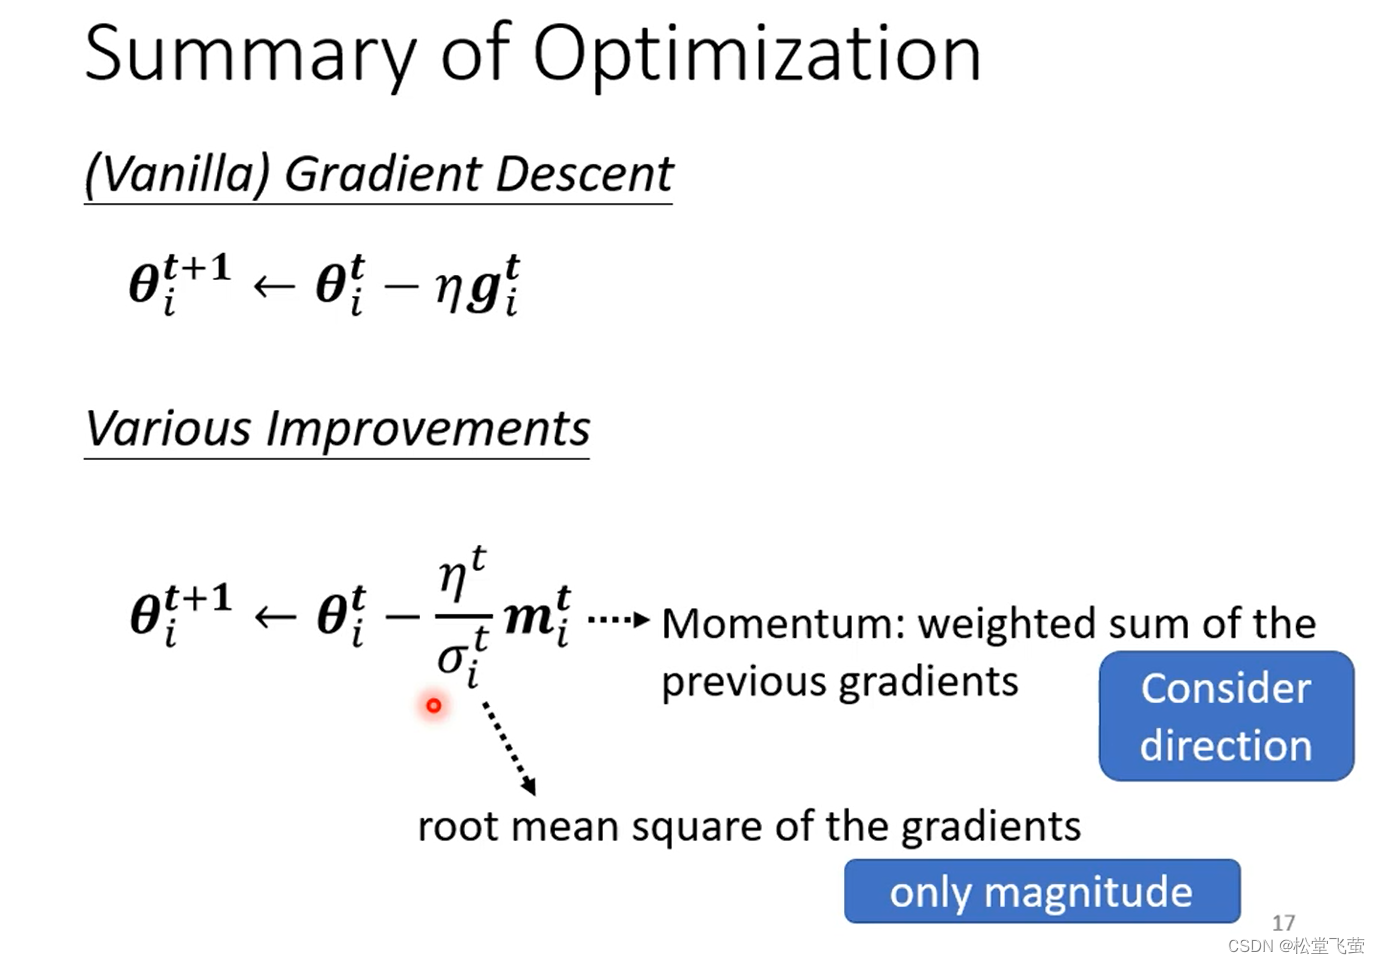
总结
m和sigma都考虑了过去所有的gradient。
区别:
momentum主要考虑方向
sigma主要考虑大小
momentus是为了增加历史运动的惯性,RMS是为了缓和步伐的大小,变得更平缓
分类
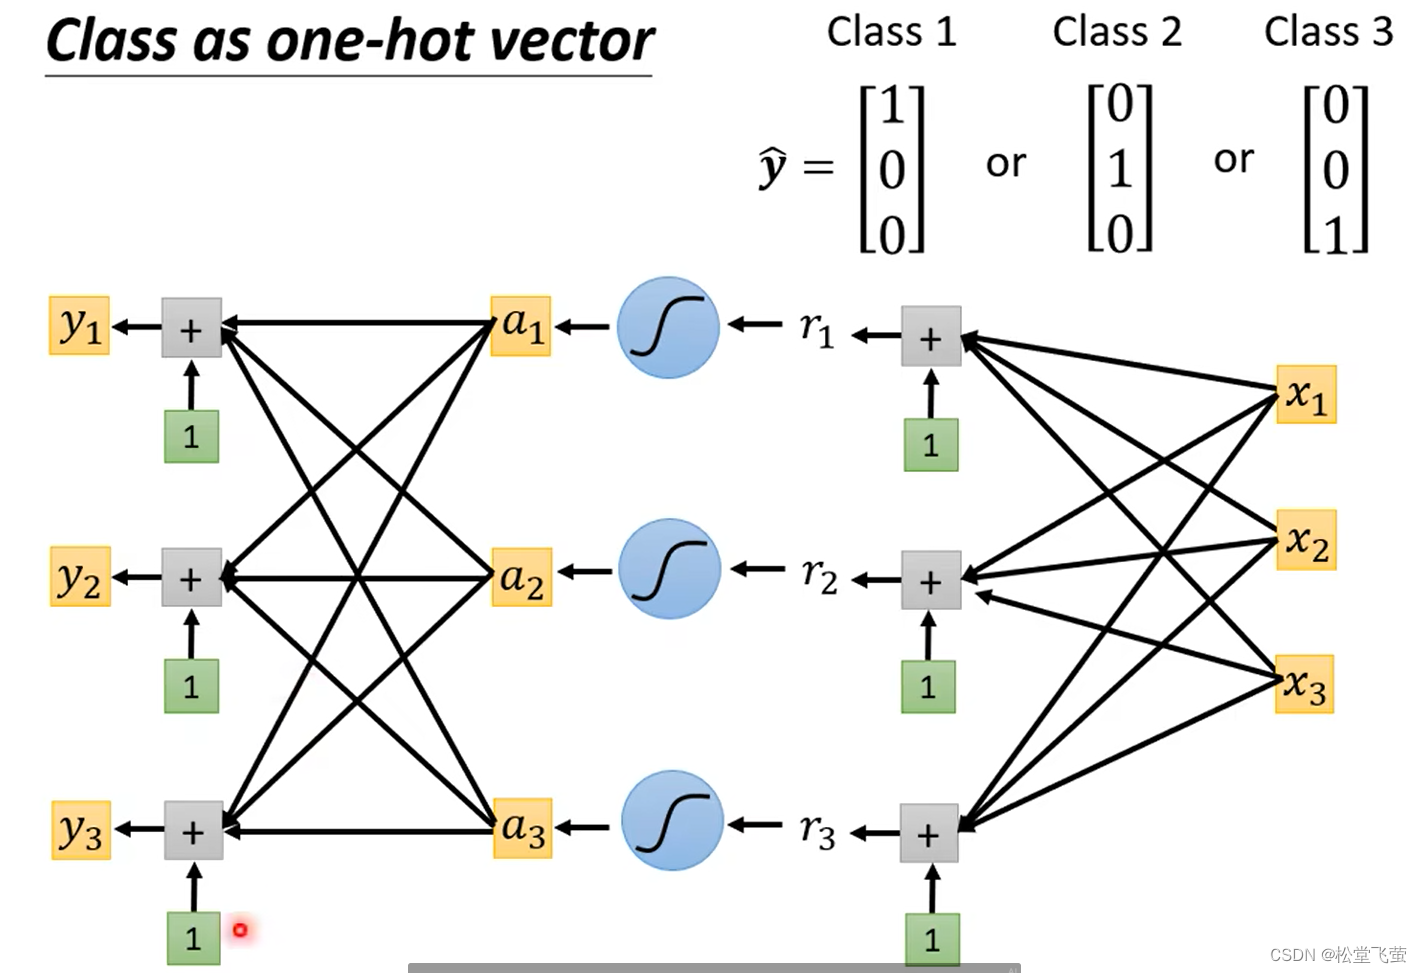
回归和分类比较
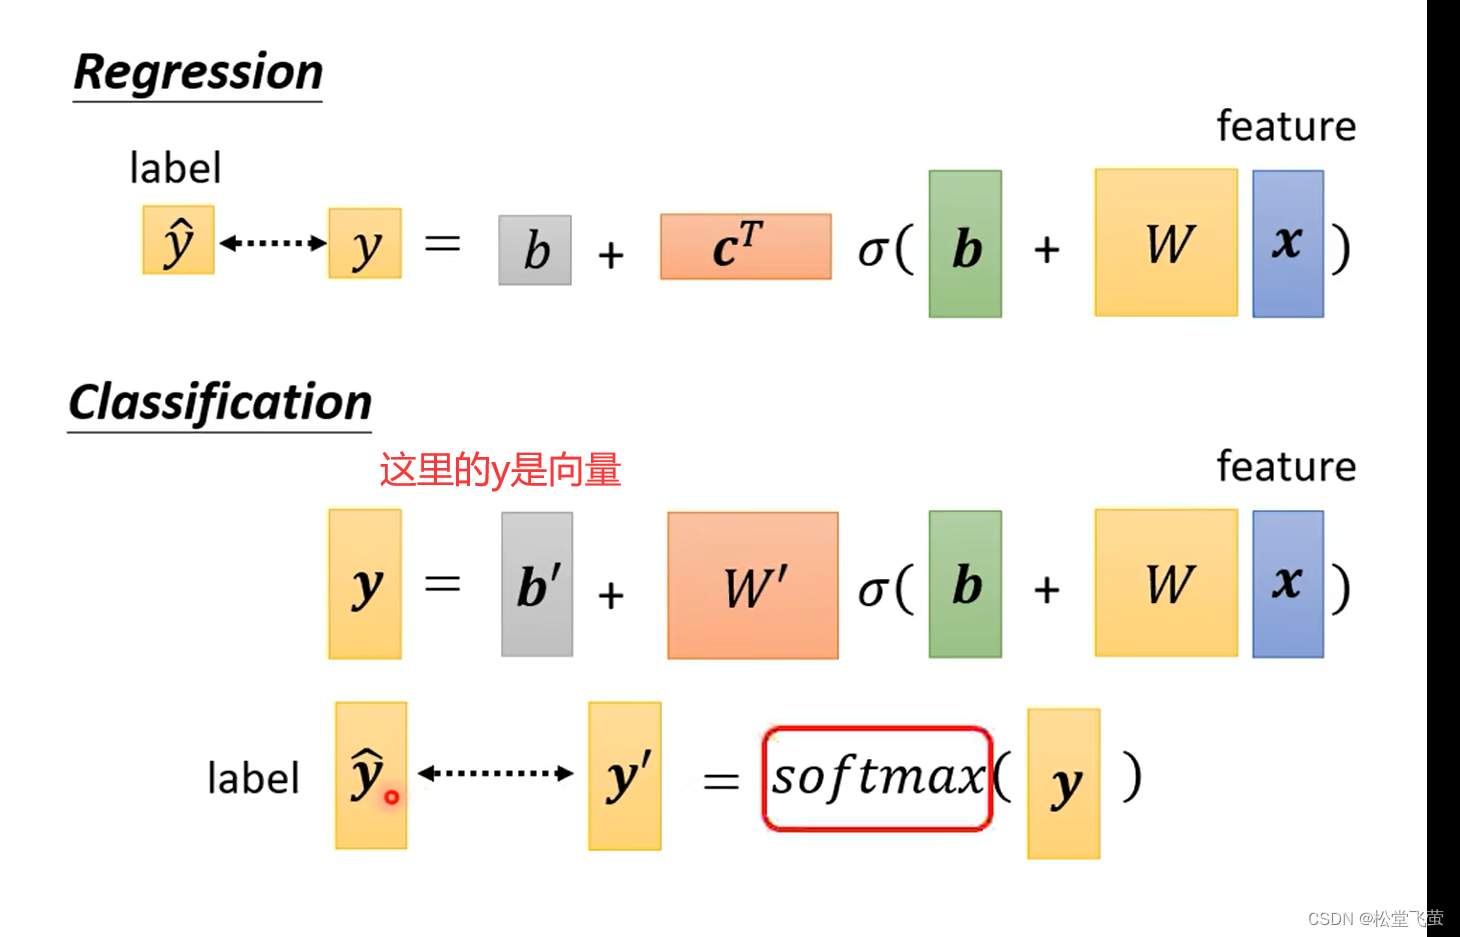
softmax:归一化。
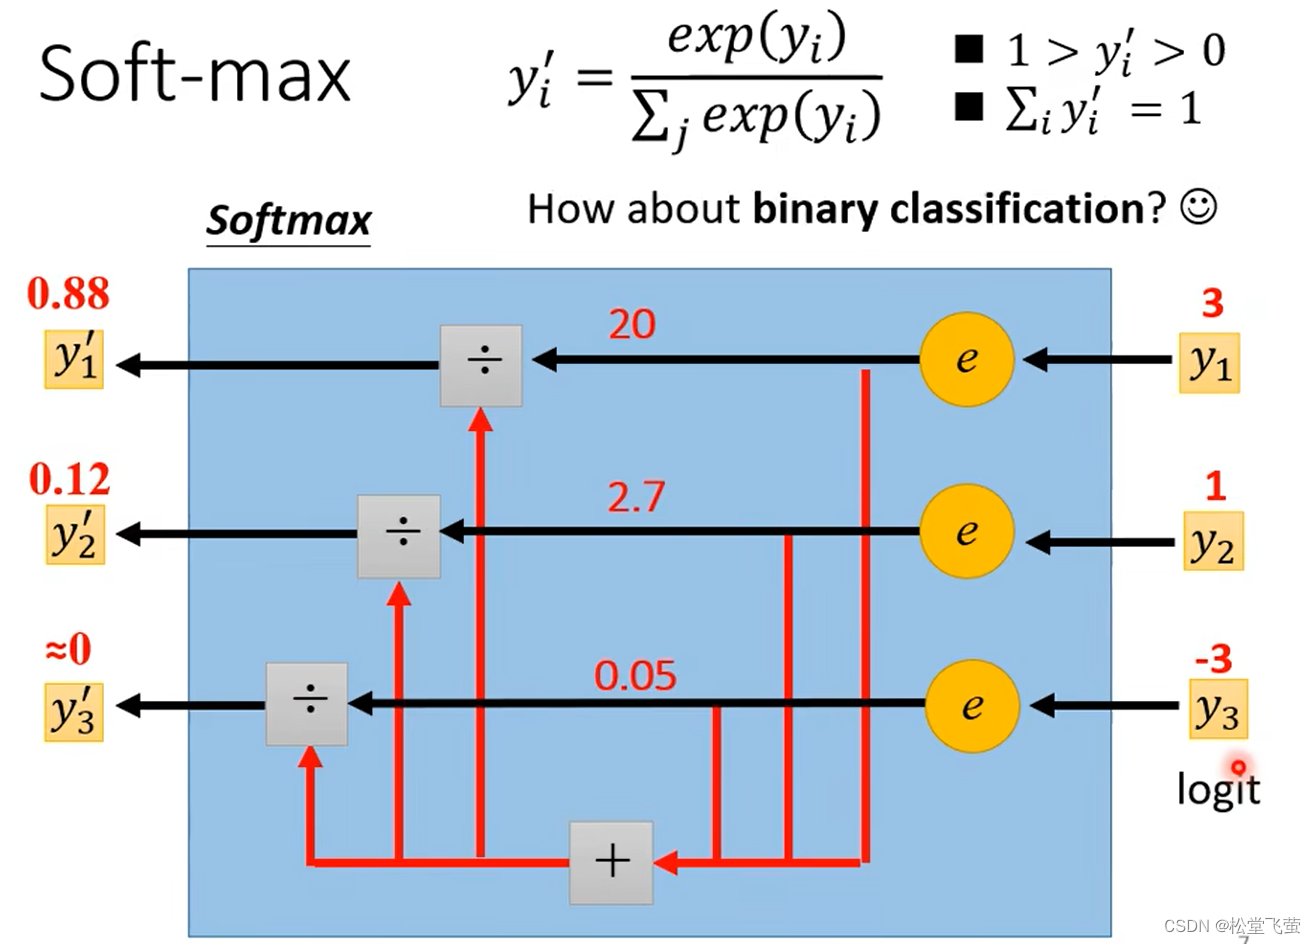
当有两个时,直接套用sigmoid函数
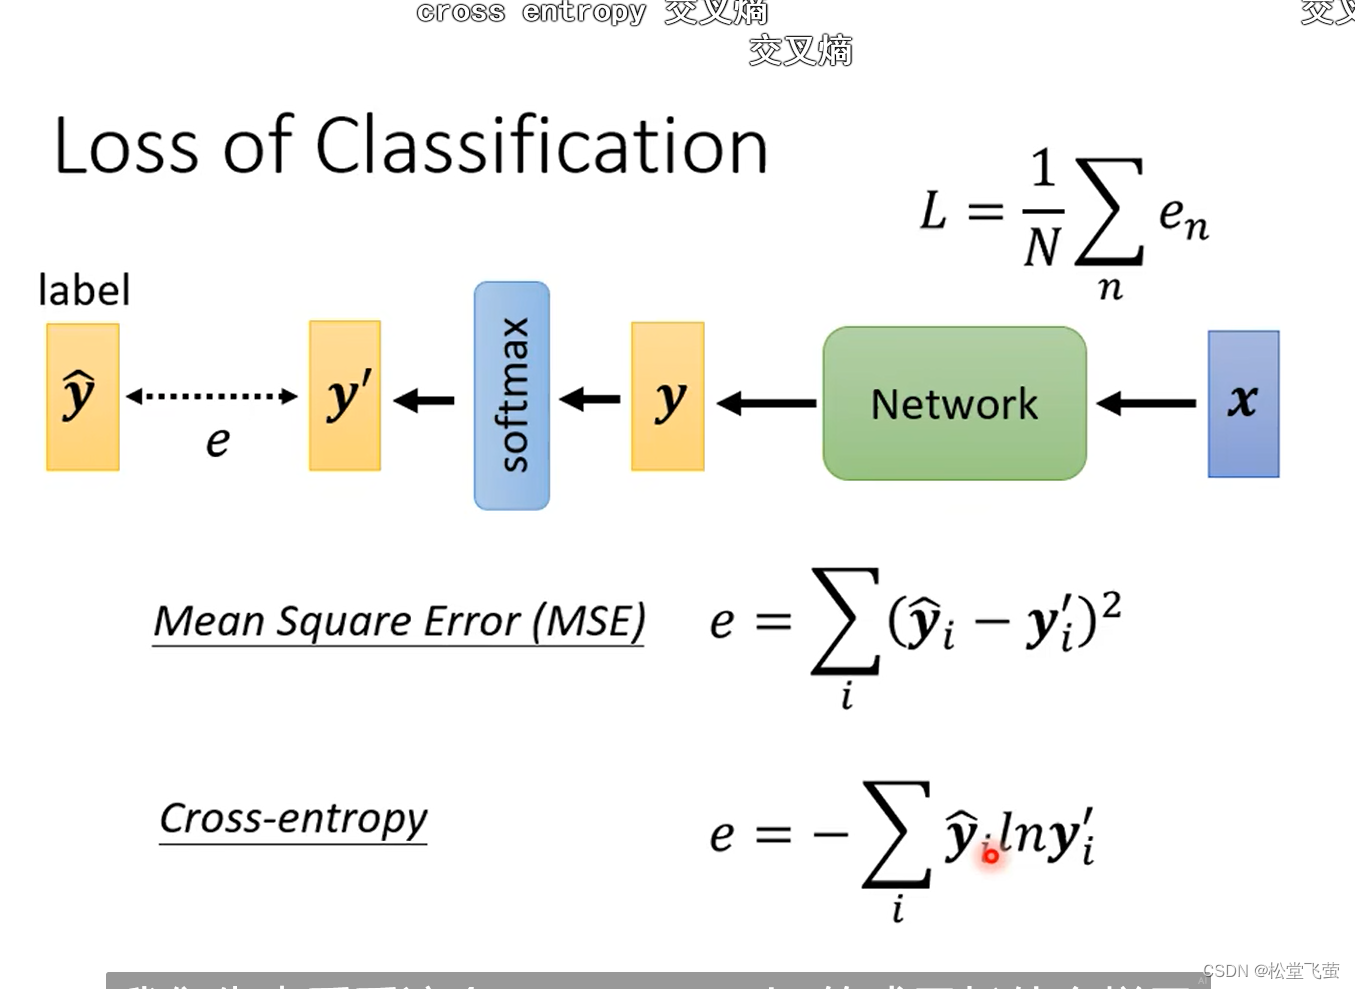
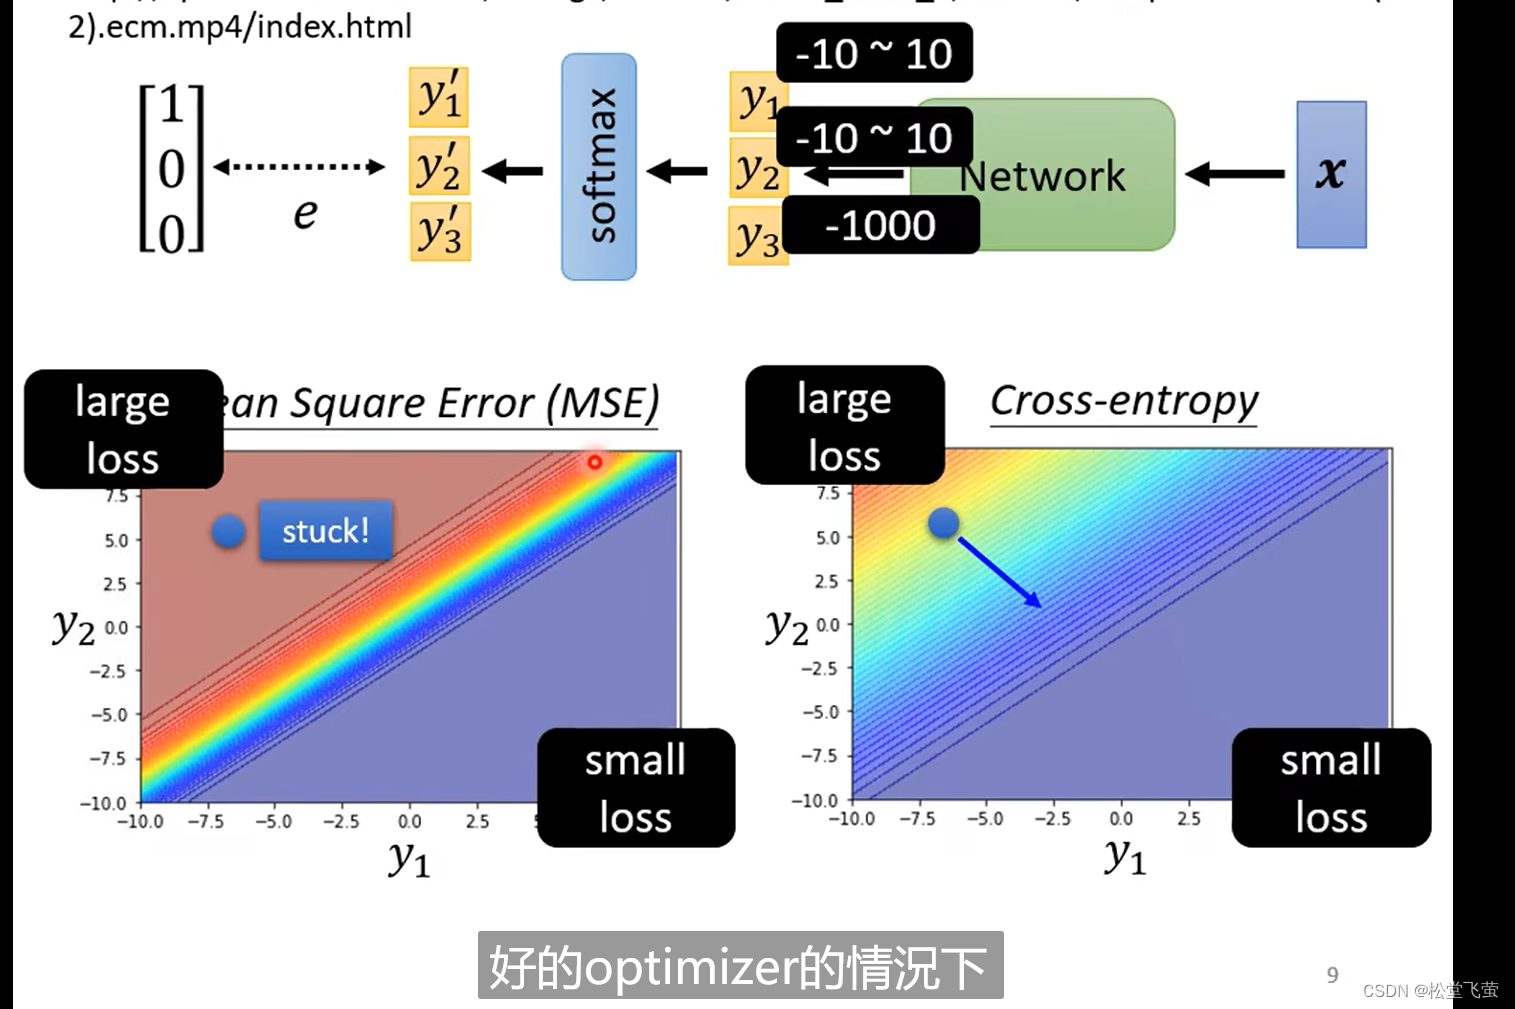
交叉熵为什么好——极大似然估计。
或者举个例子,如下图,在loss比较大的时候
use validation set but overfitting
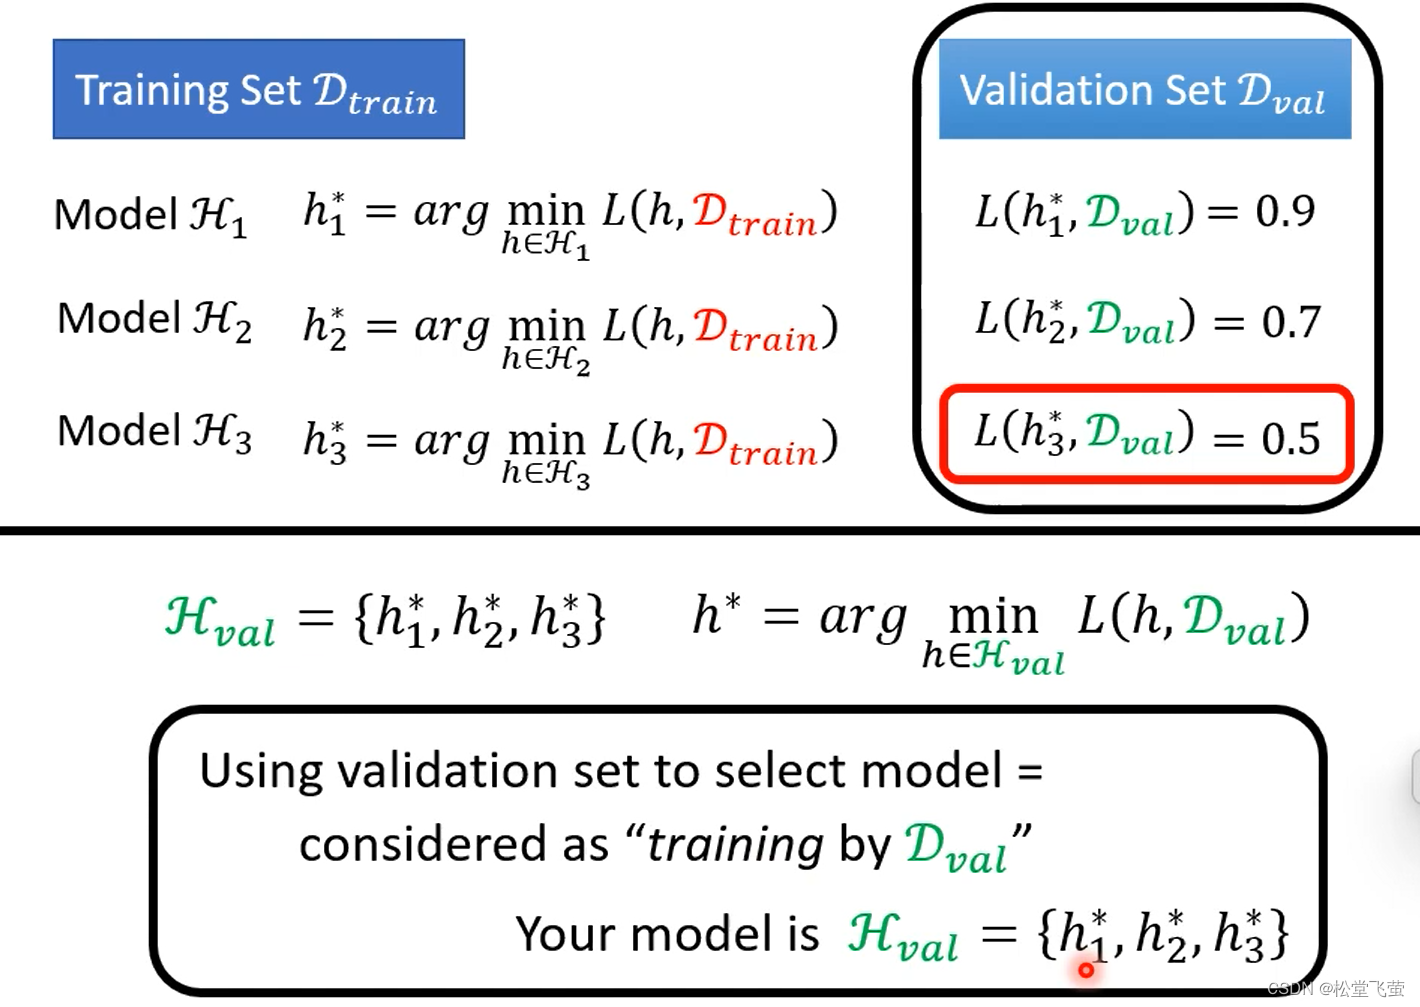
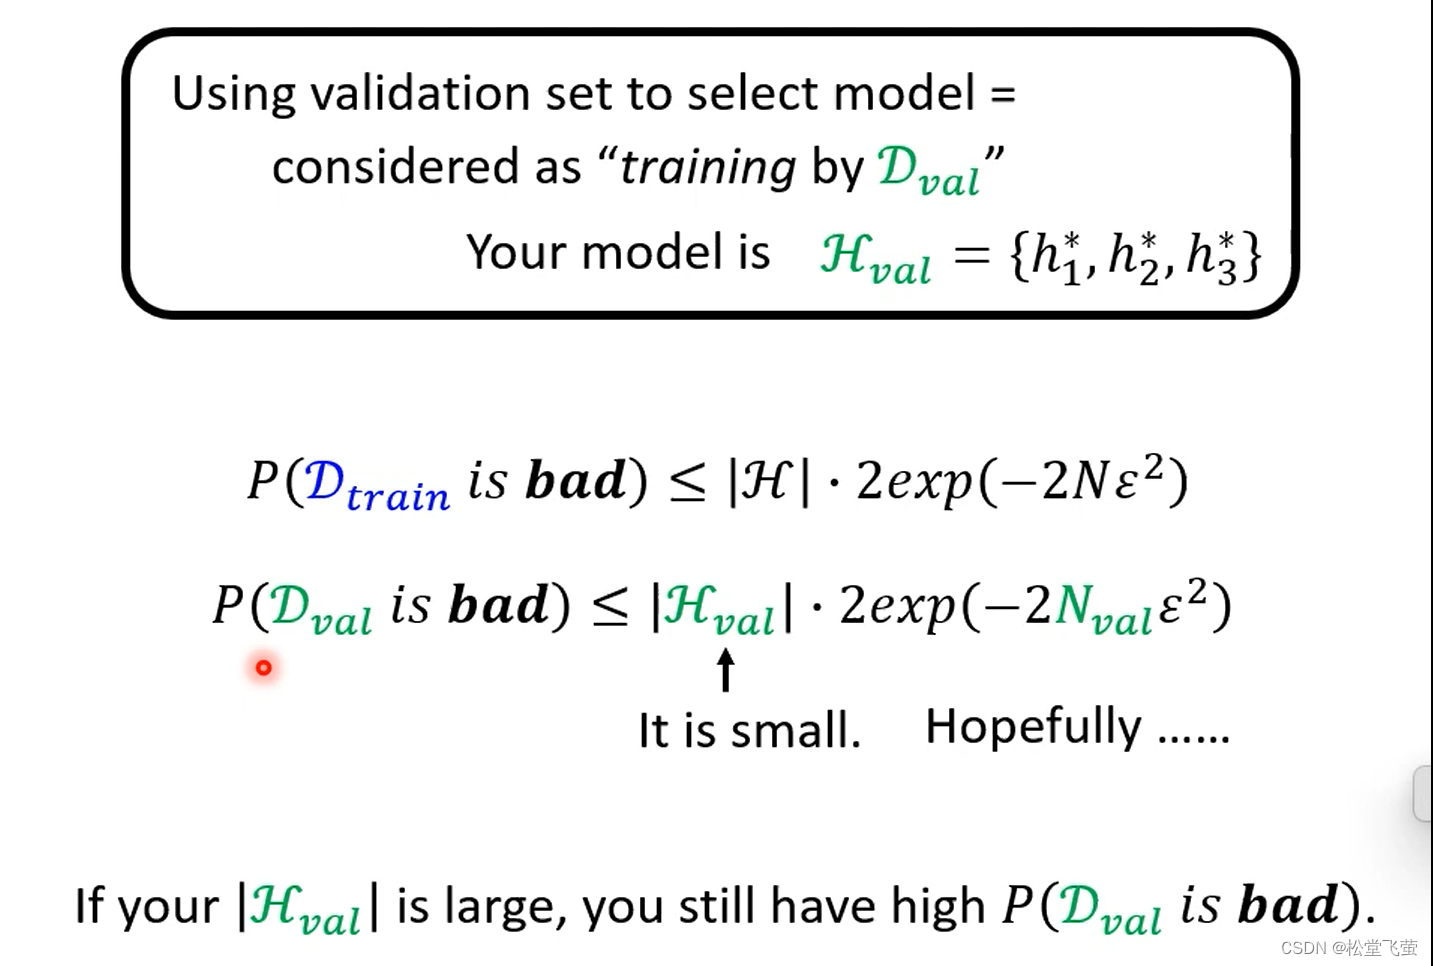
模型选择
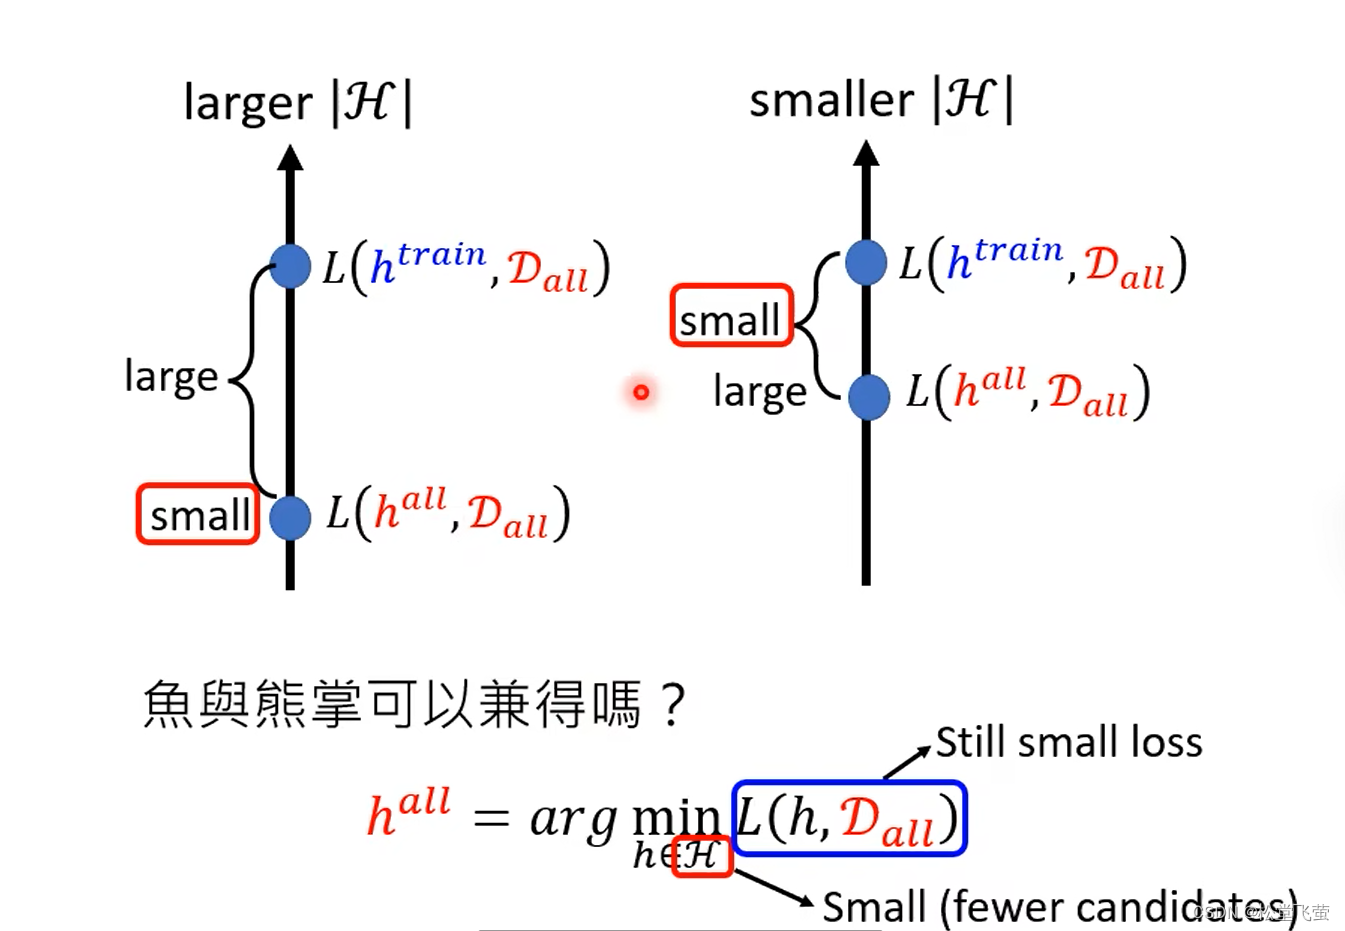
large H表示大模型,它的训练的loss可能和实际的loss差距很大;
相反表示小模型,它的训练的loss和实际的loss差距小,但两者都很大
H太大,理想与现实差距很大,但loss较小;H太小,理想与现实差距小,但loss大。
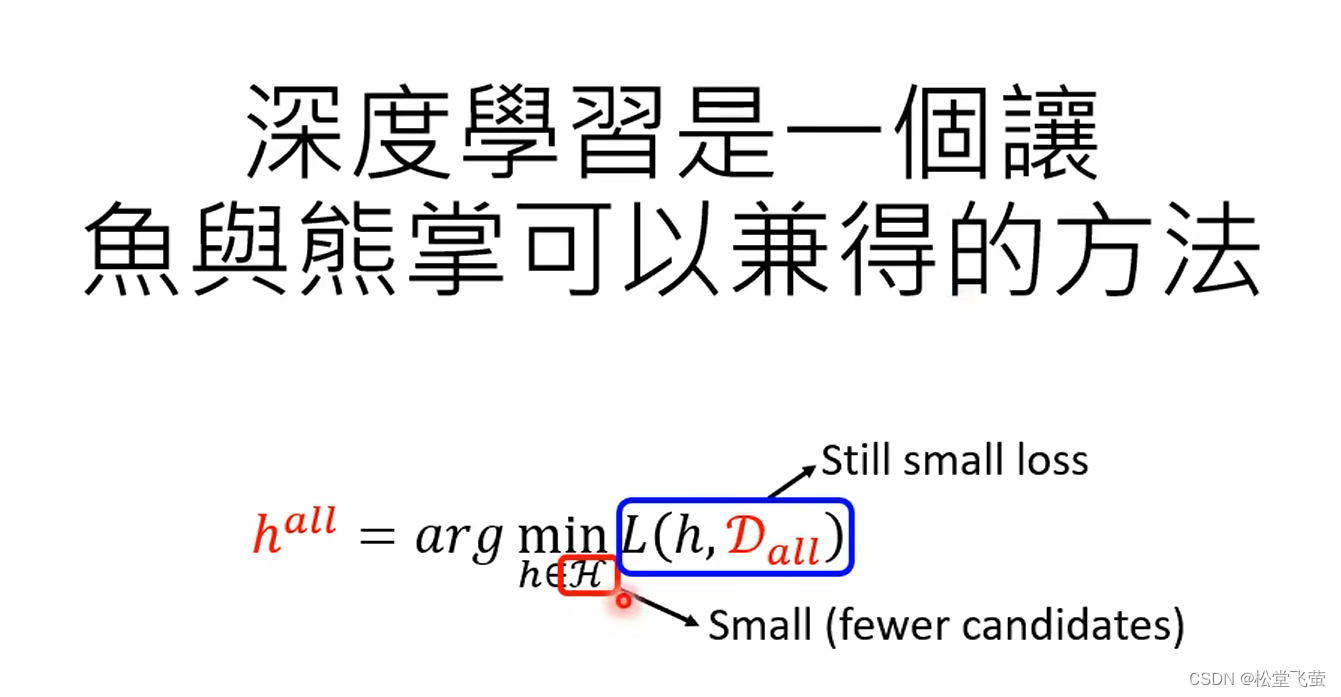
这个地方可以这样理解,相当于我们希望能在更小范围的H中找到最好的h使得Loss最小。
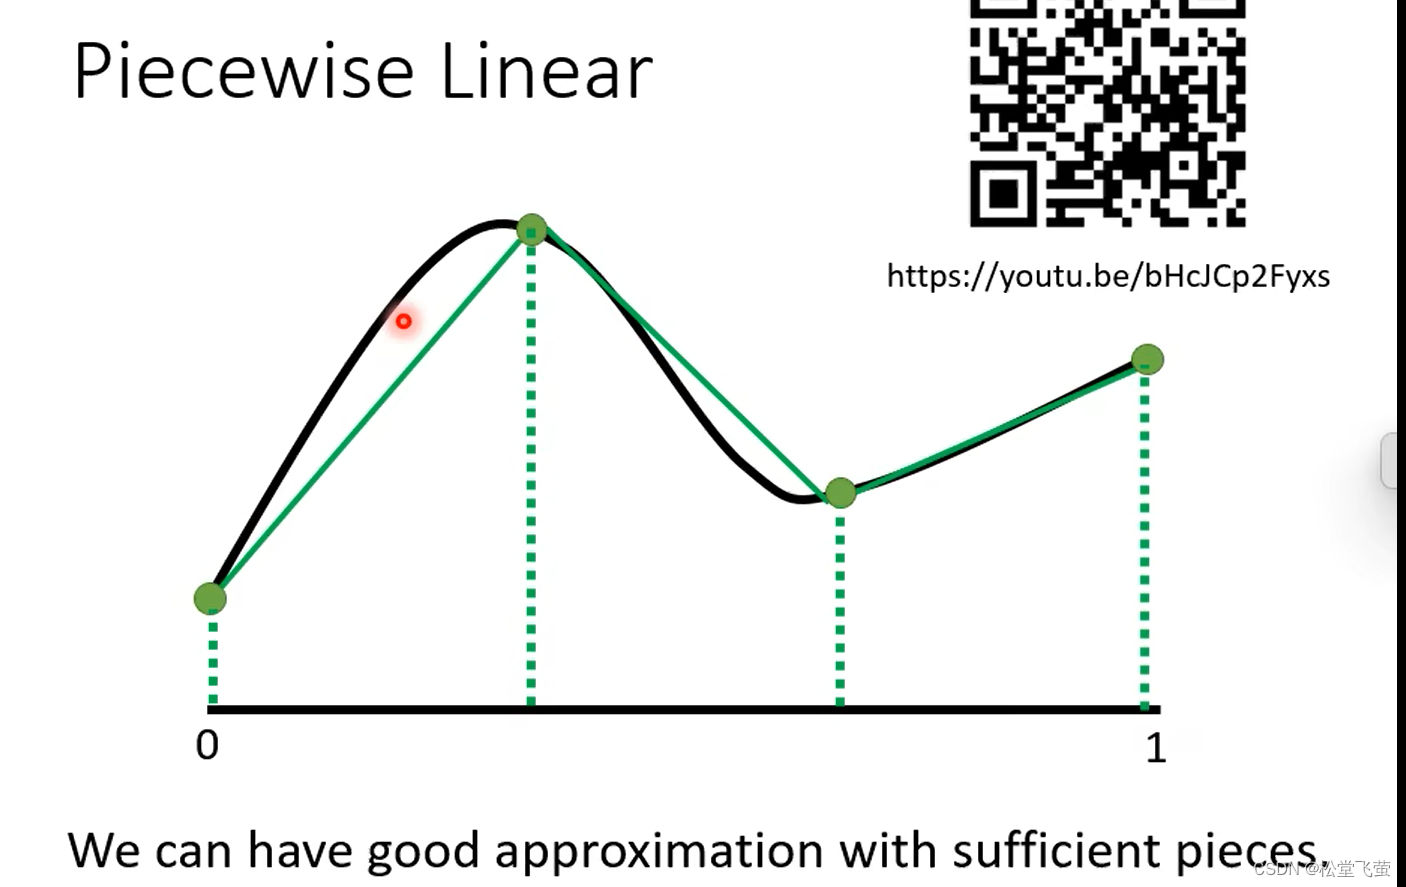
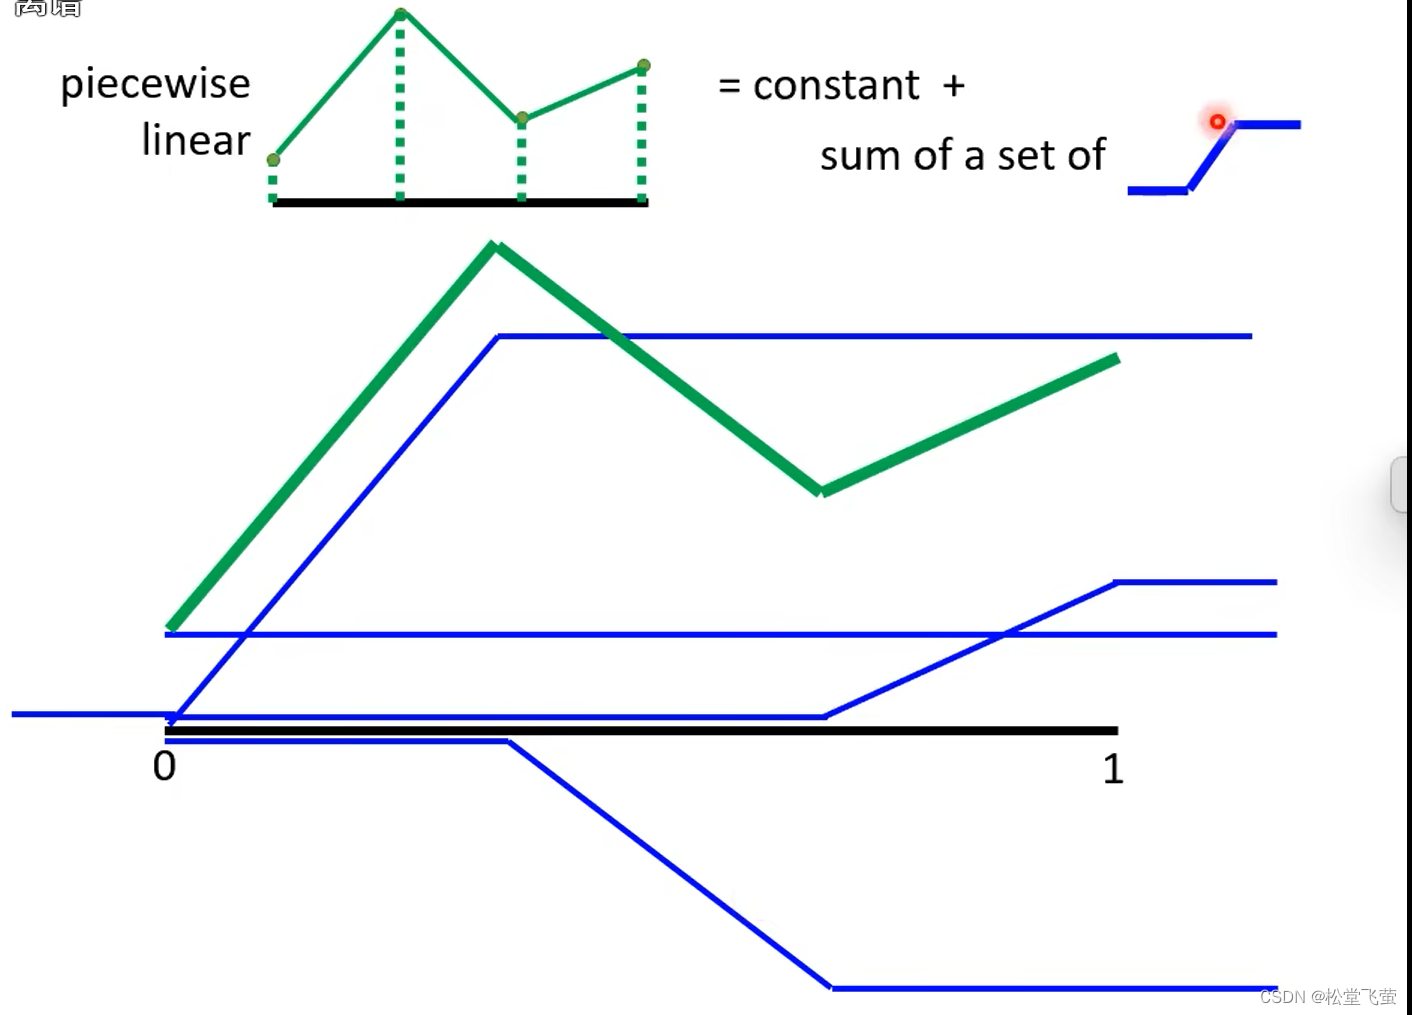
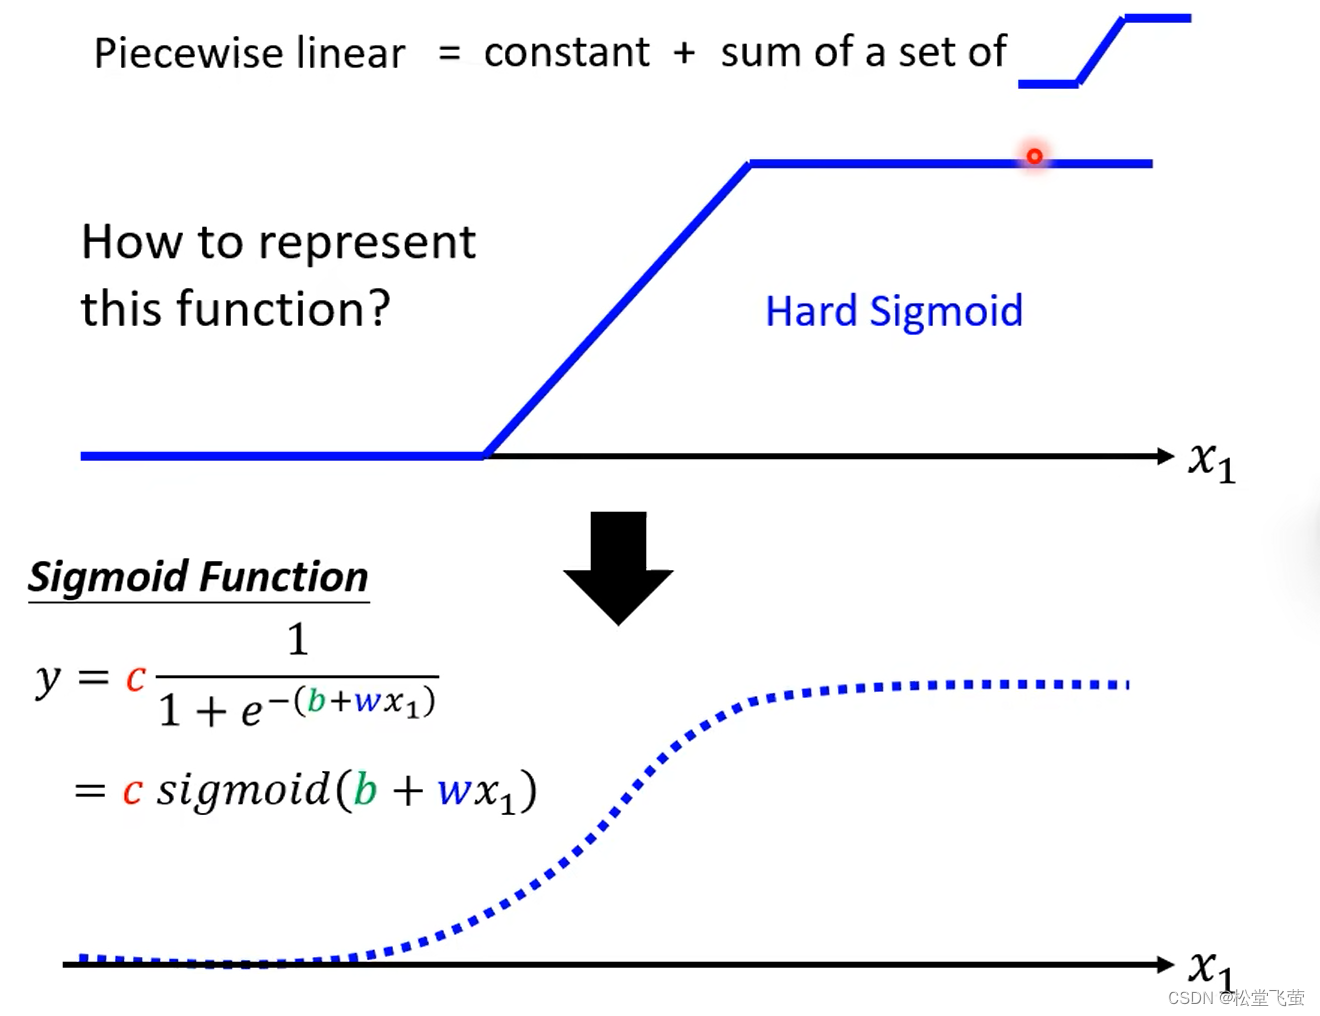
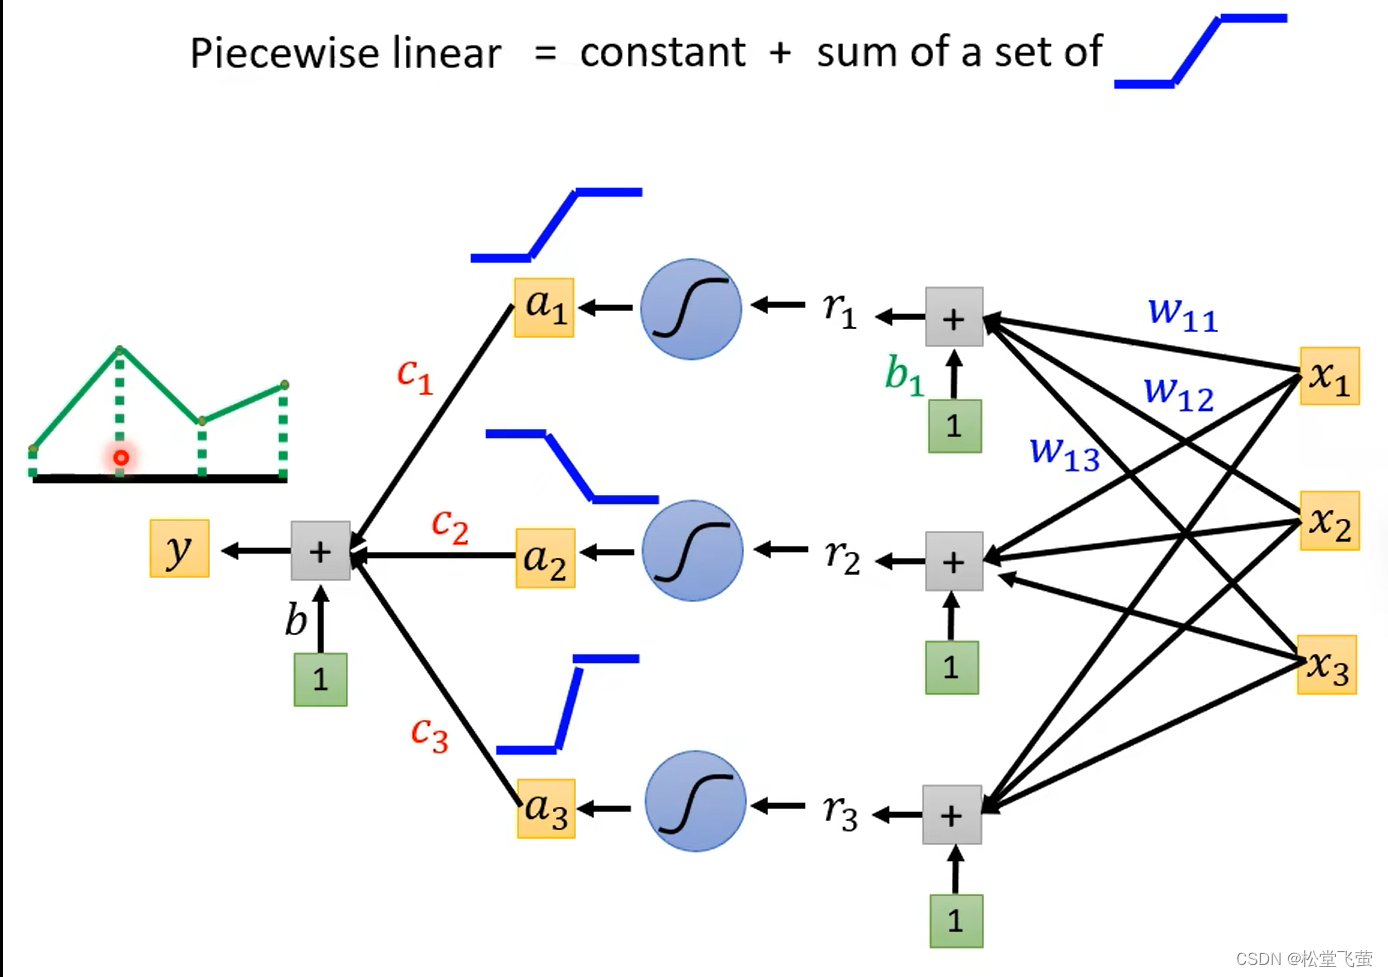
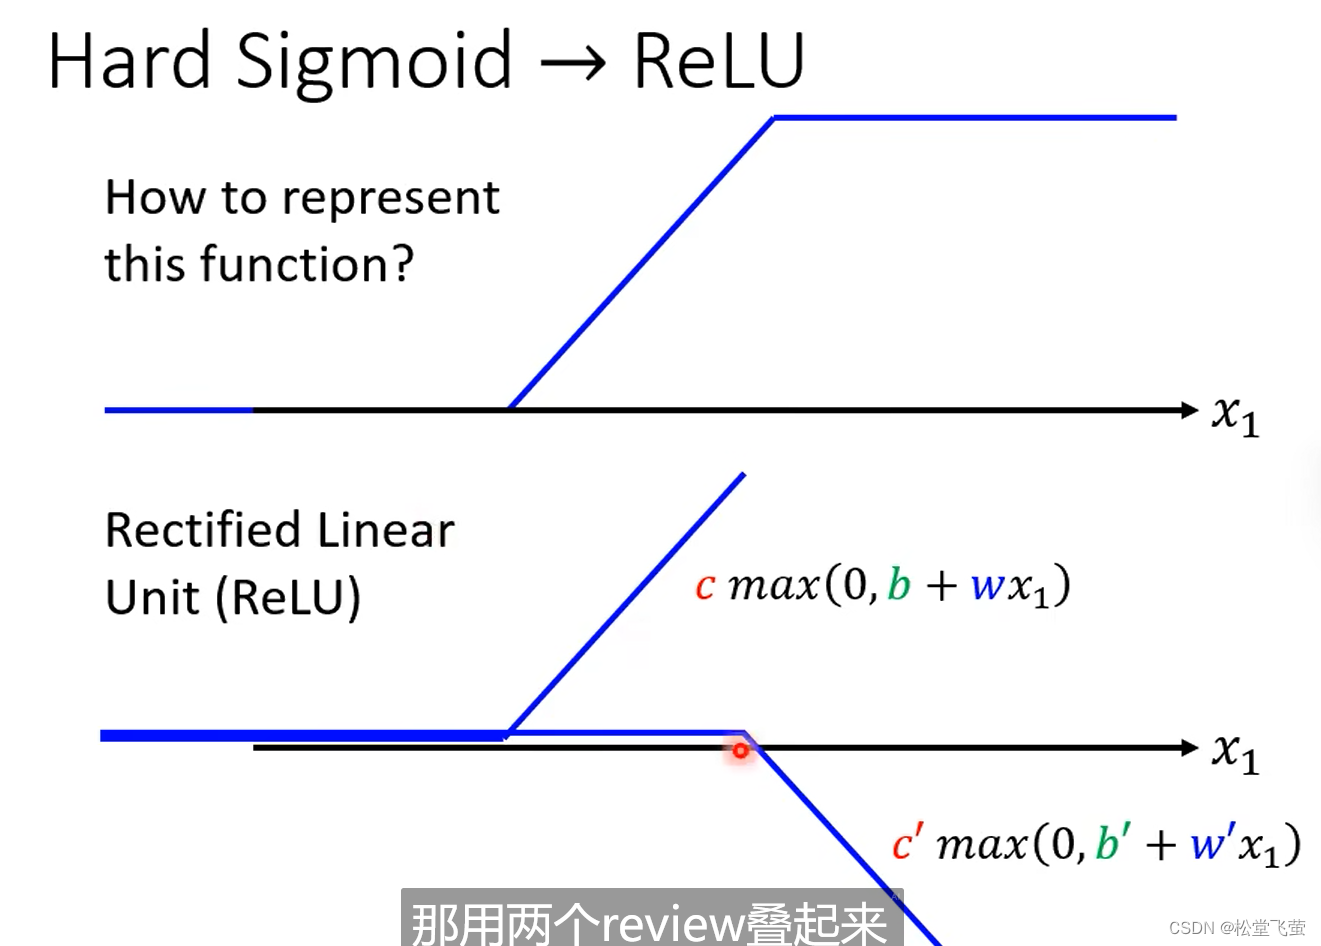
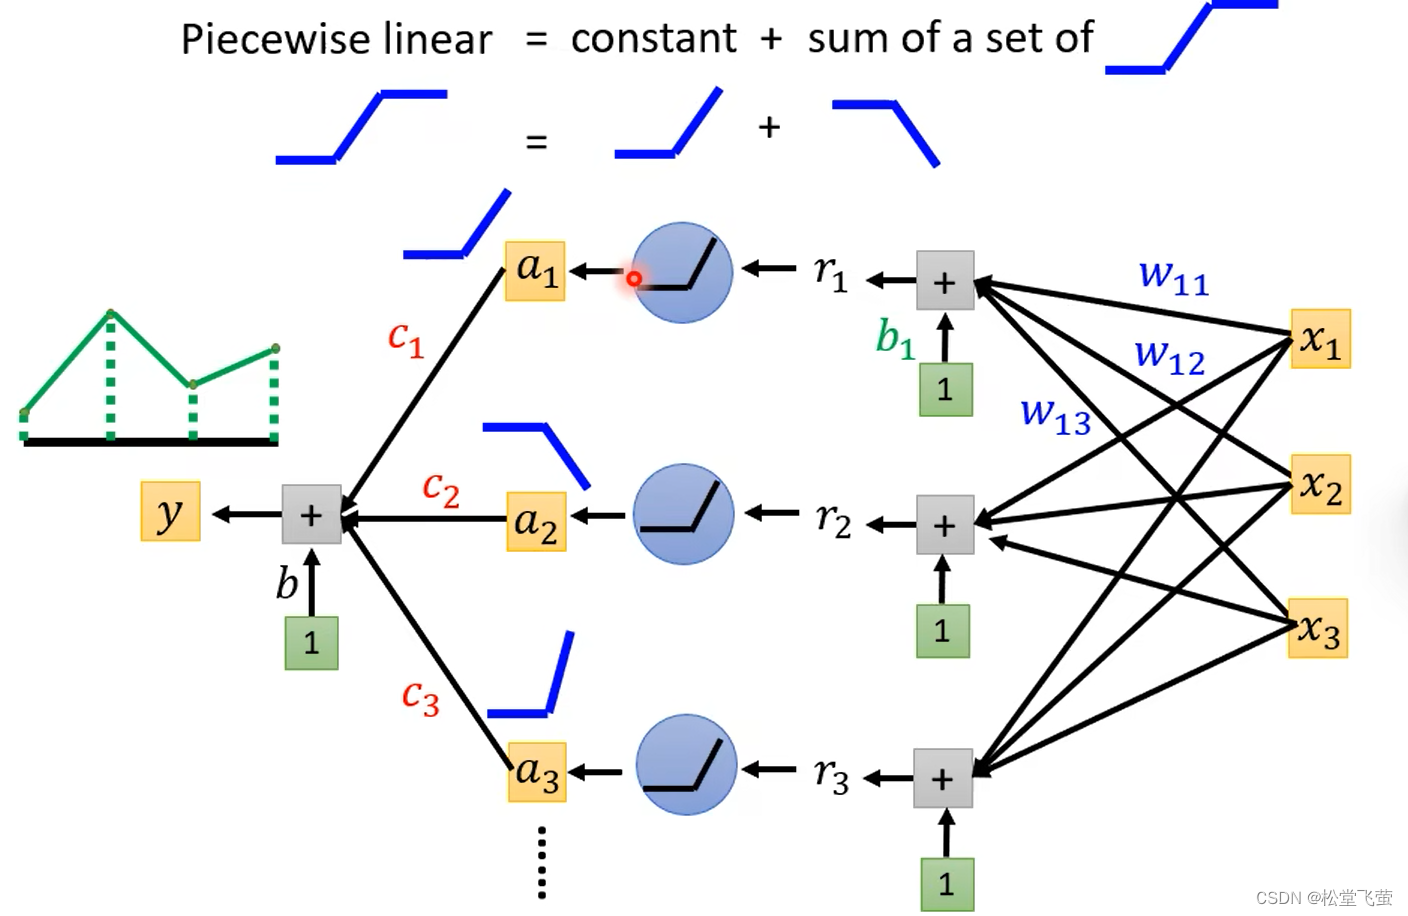
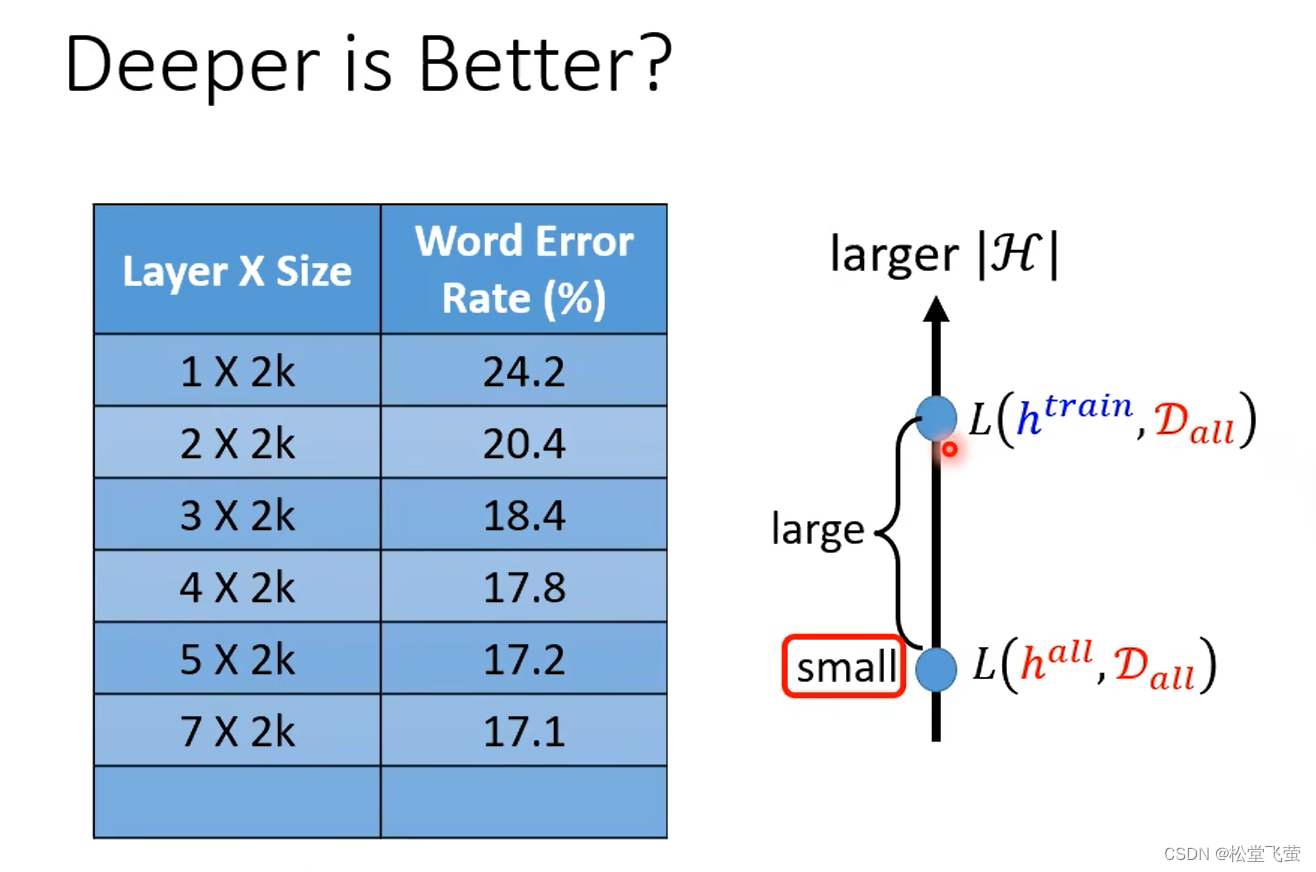
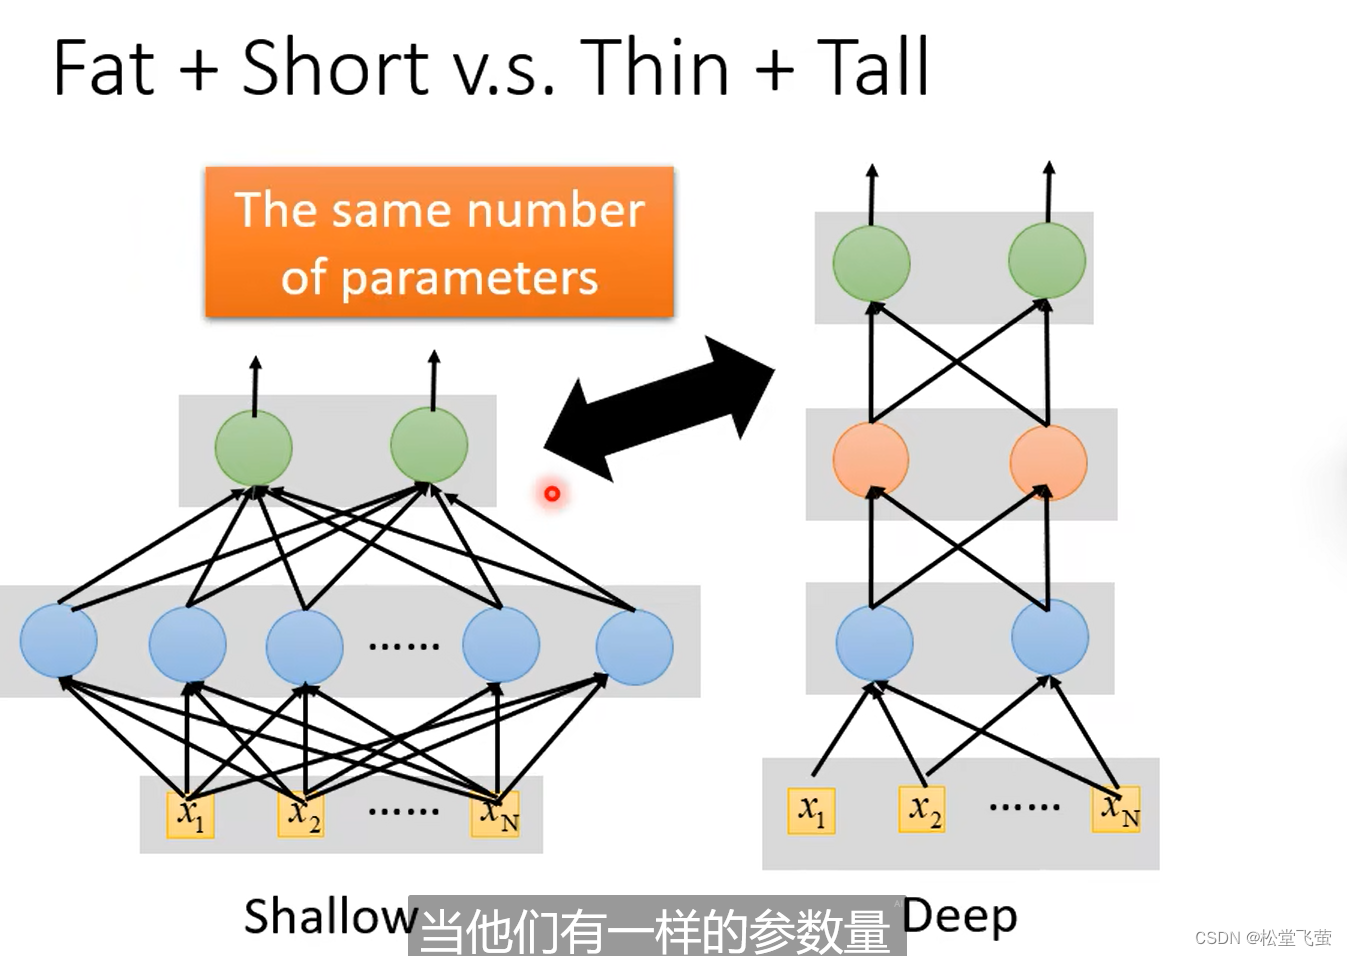
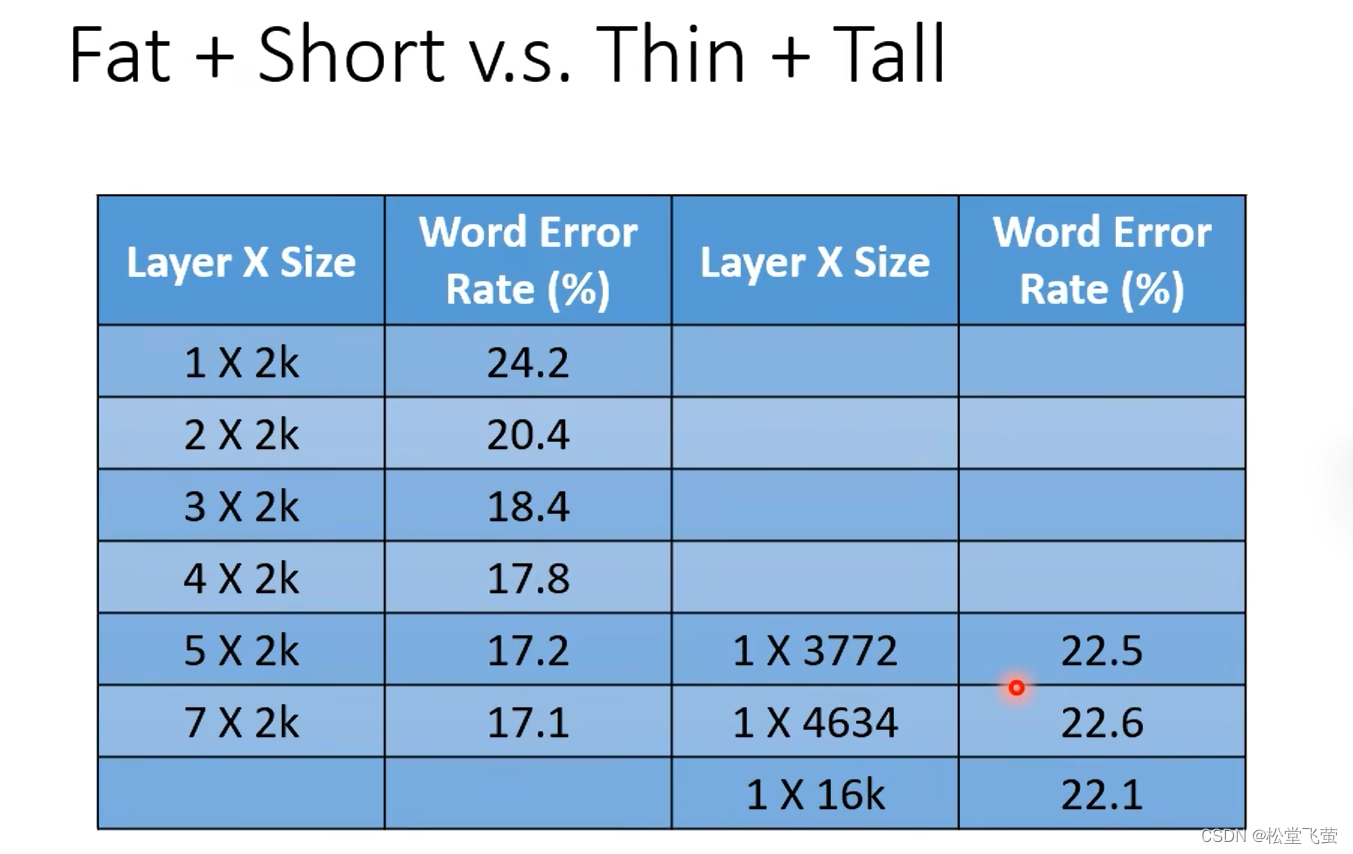
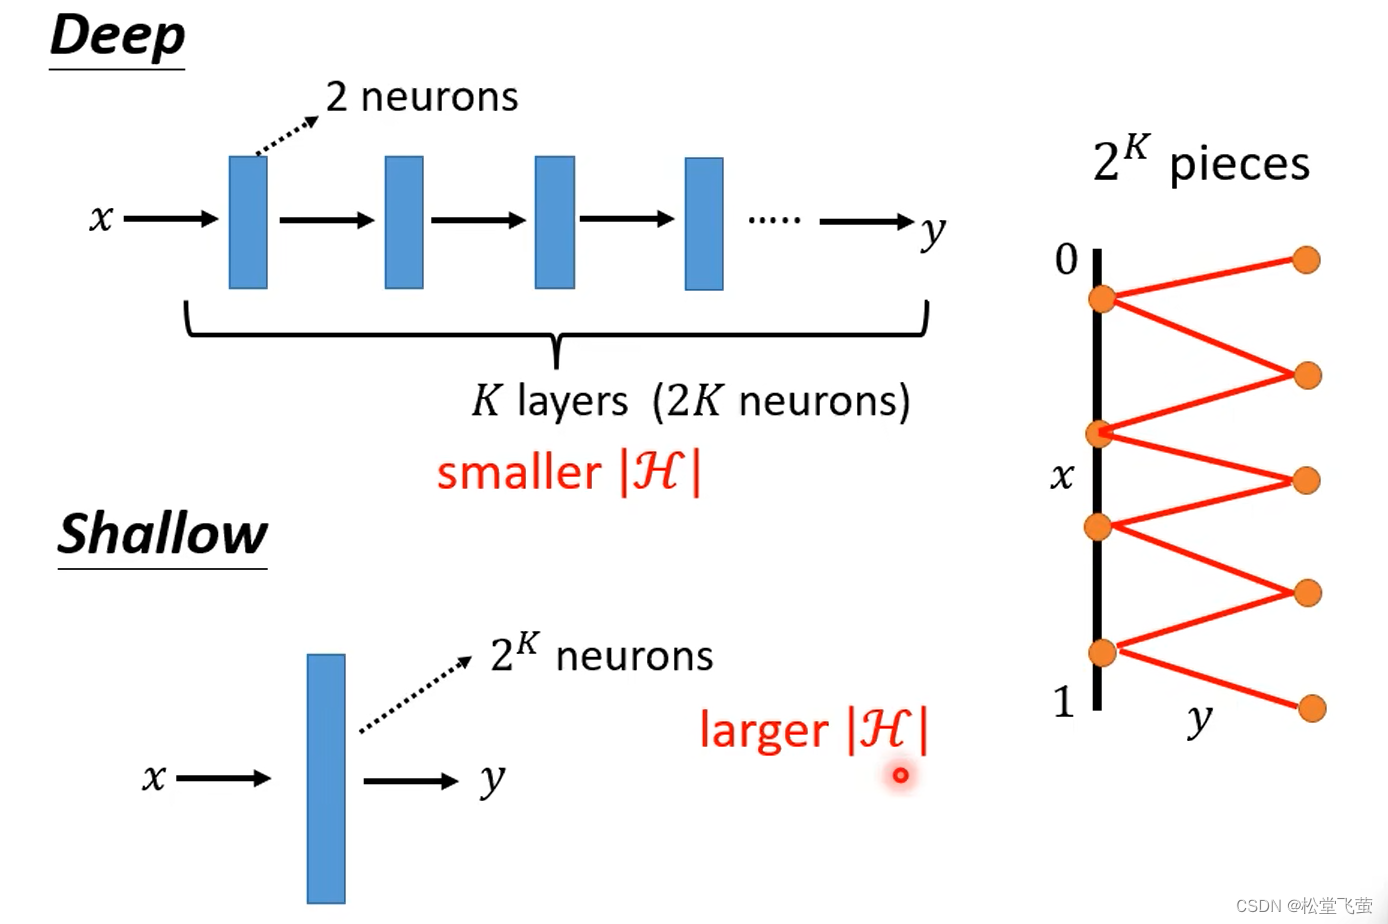
deep learning 真正的强项是不容易overfitting
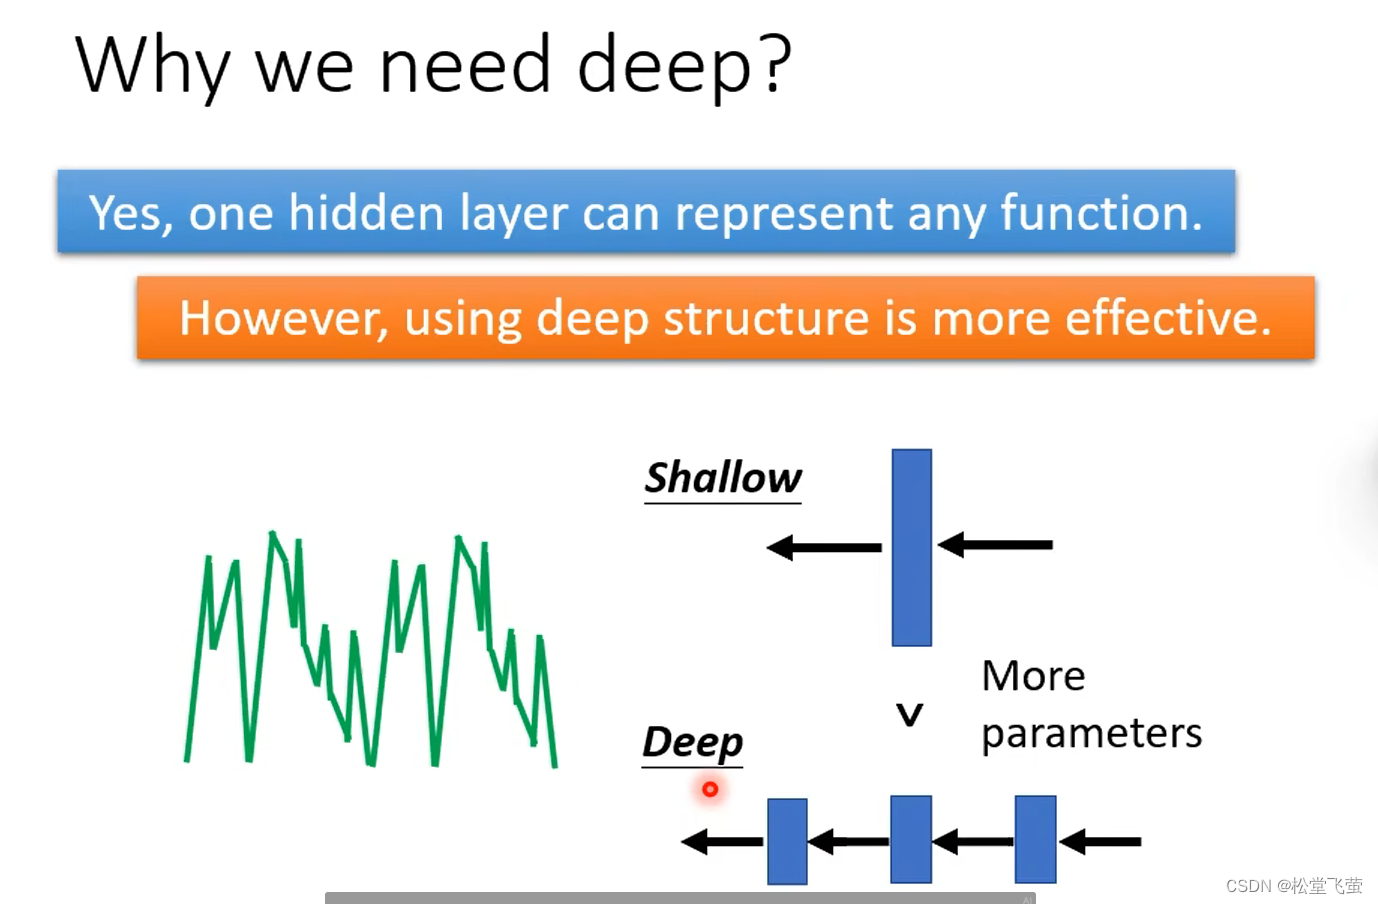
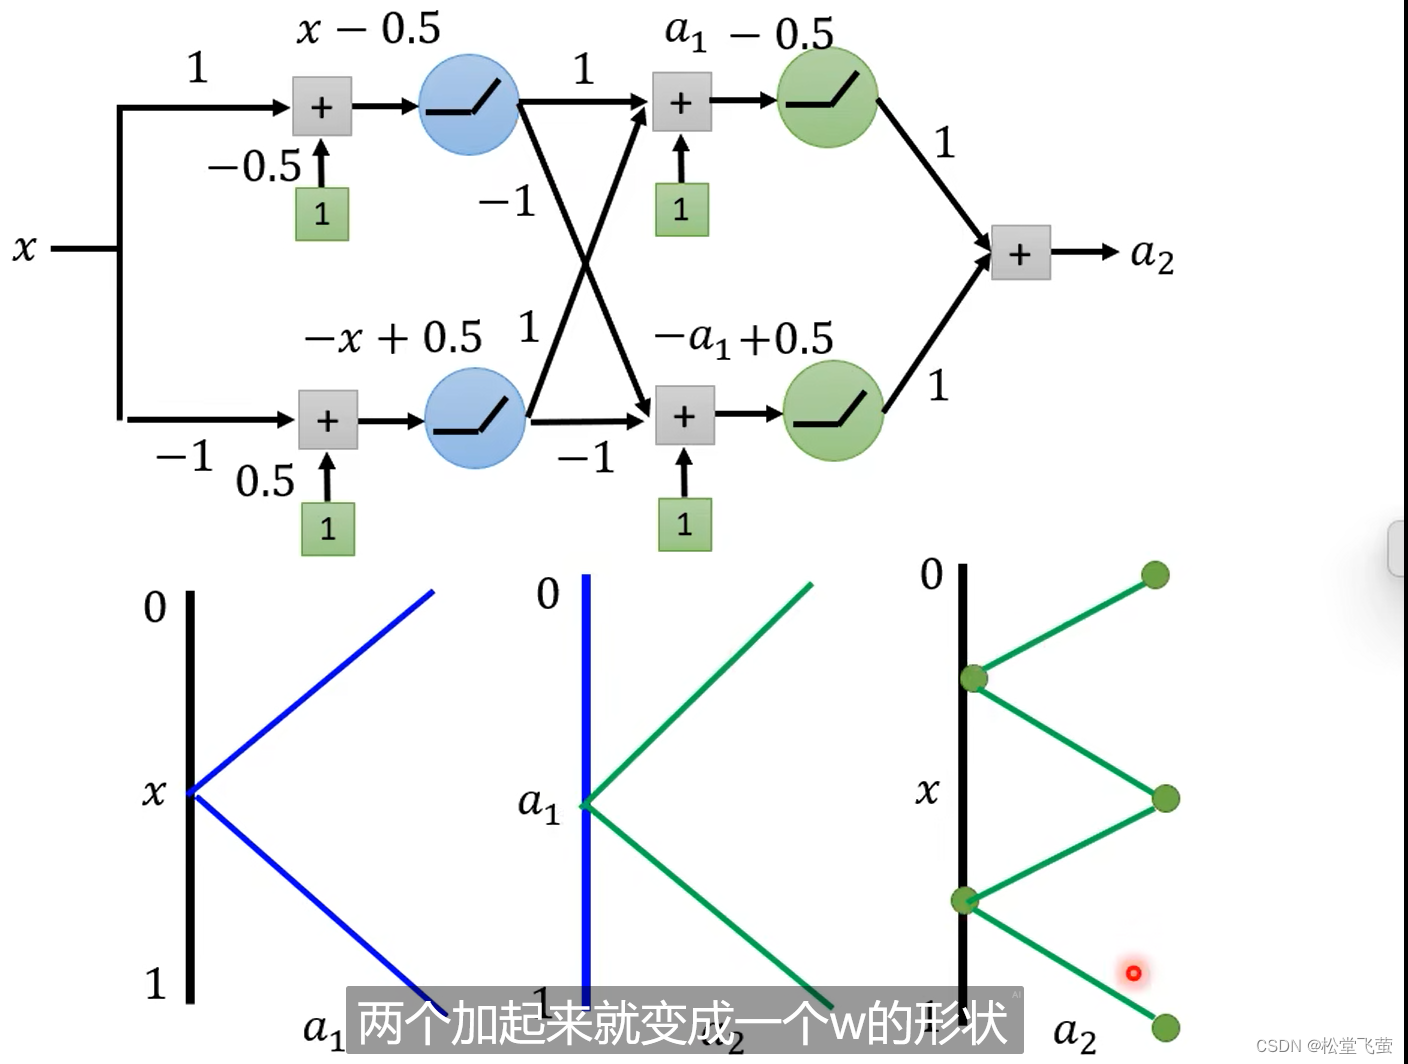
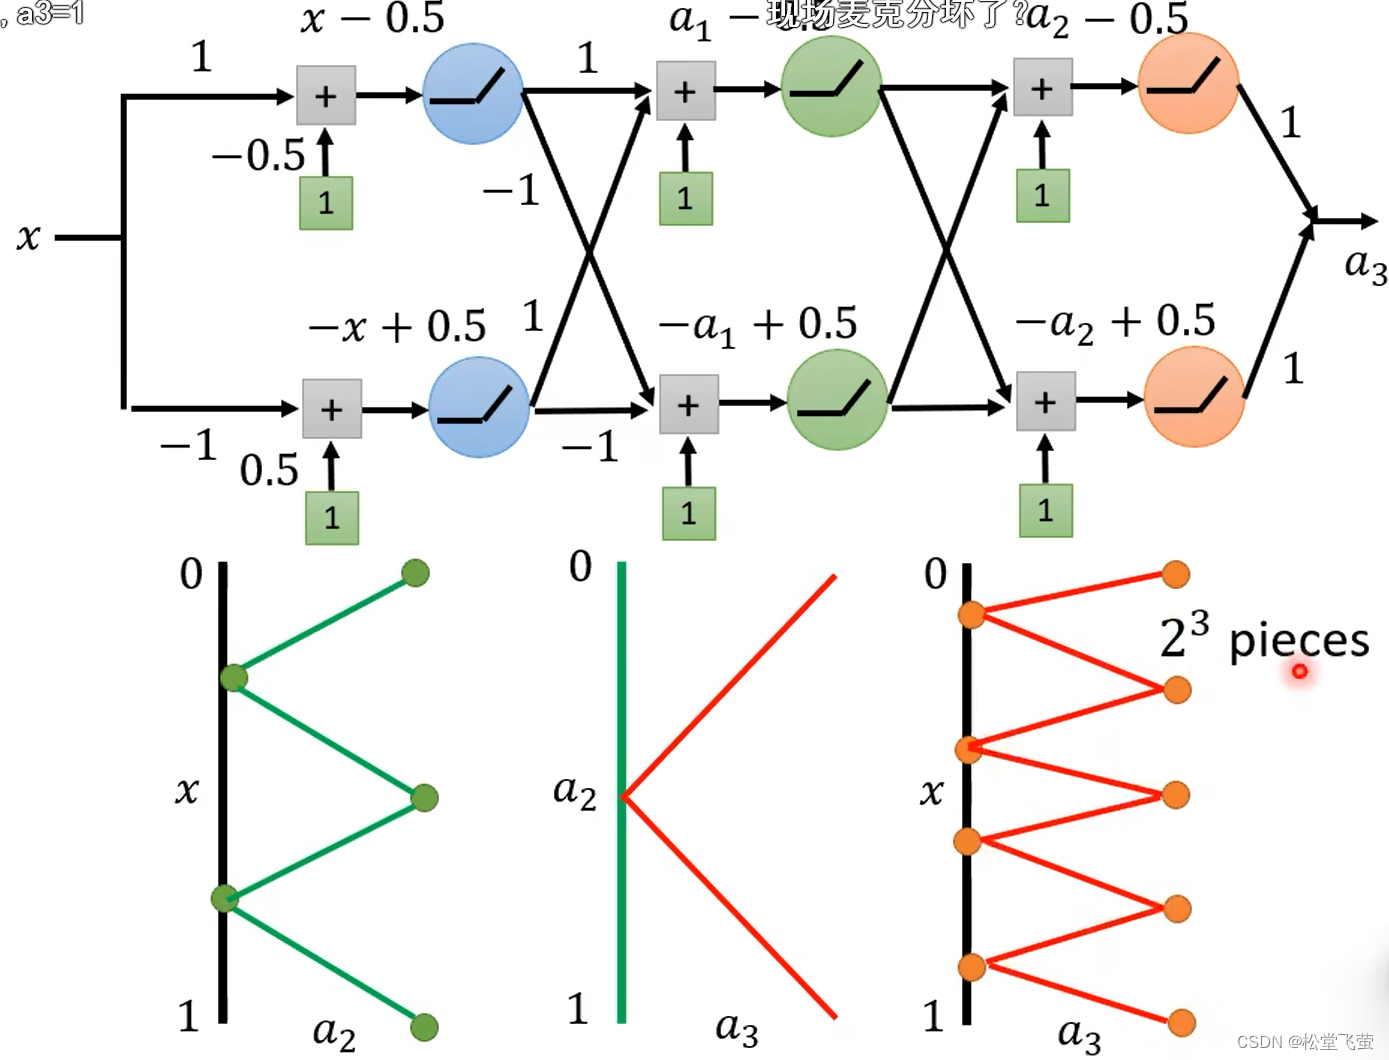
深度学习比宽度学习好的例子
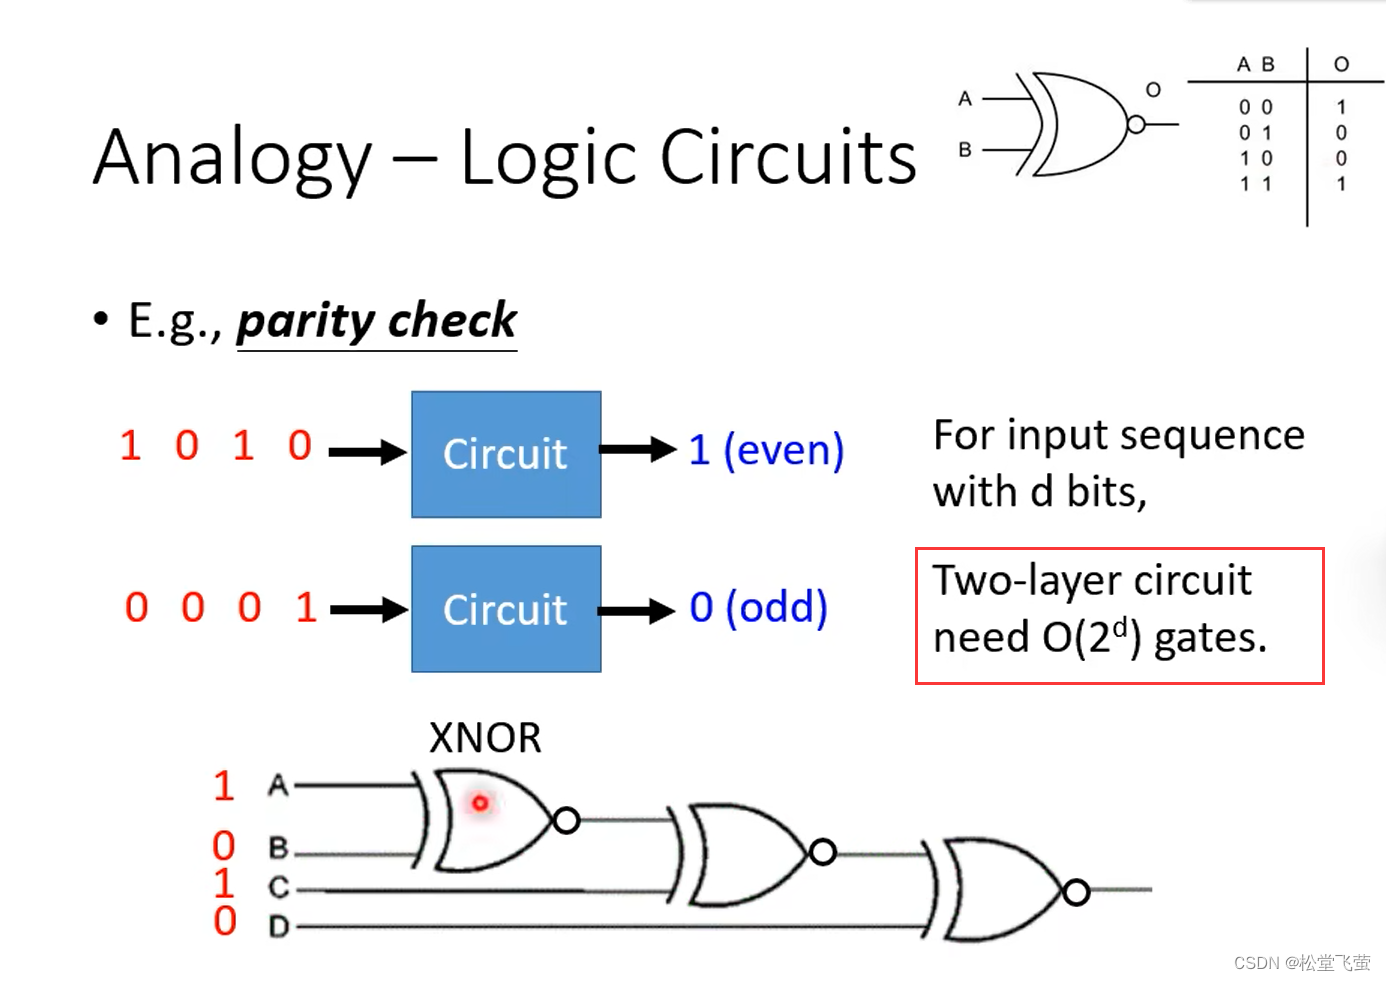
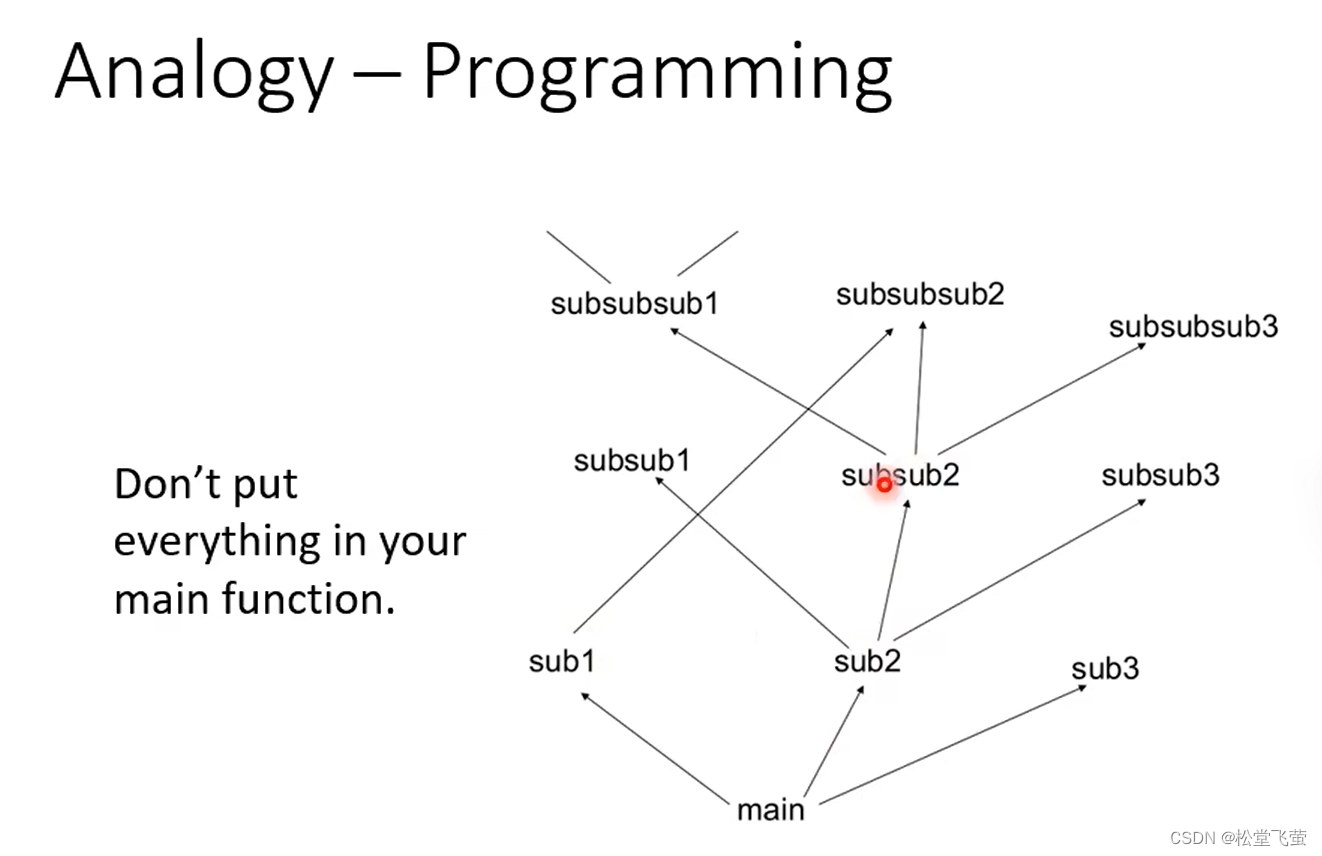
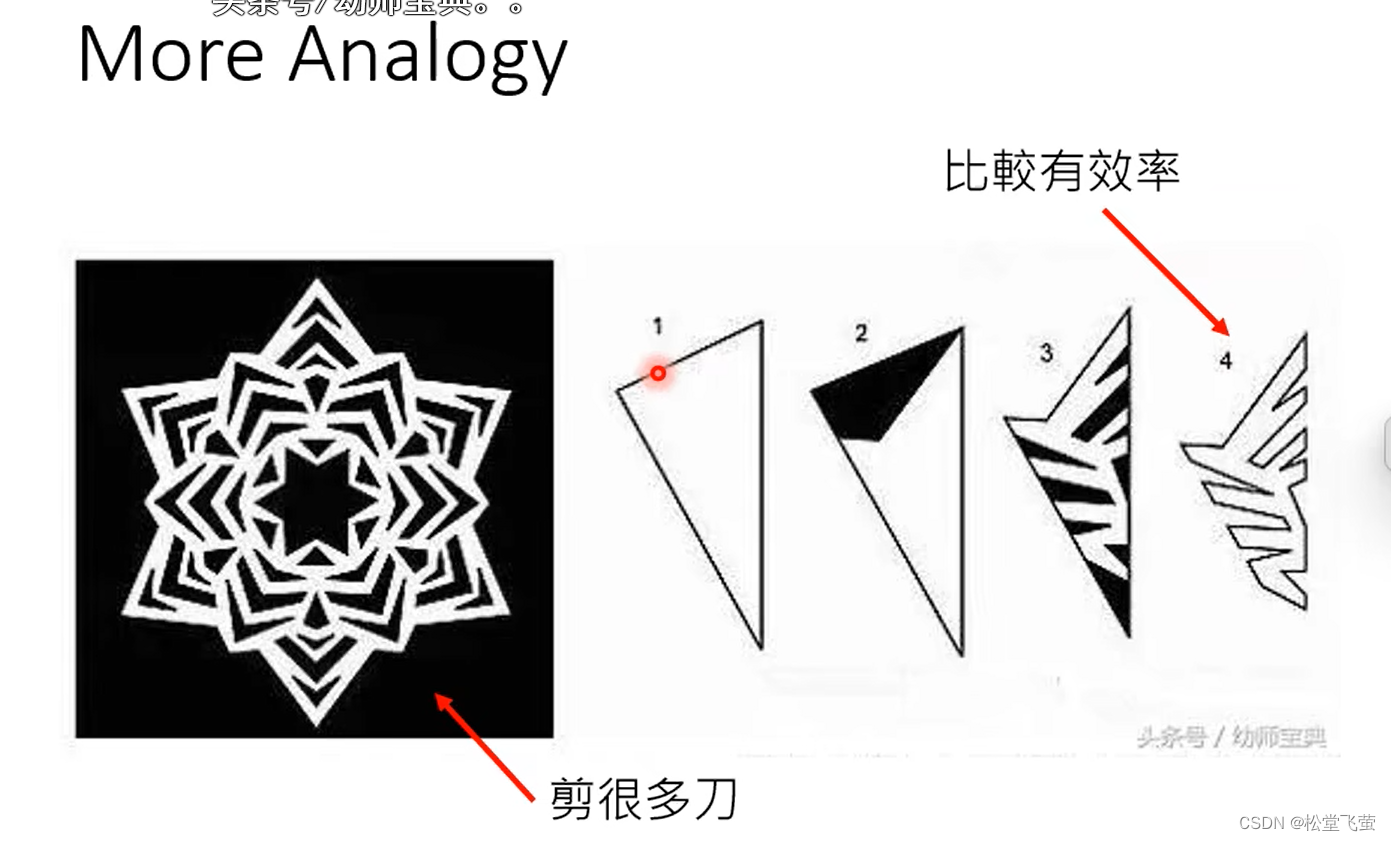
deep learning 过程
图中有误,weight为2,即乘以2
确实讲错了,老师在课程主页上的PDF课件中做出了修正,第二层以后的weight每一项都要乘2(不包括bias项)
PPT写错了,第一个RELU层的权重是2不是1
因为这里的relu后应该是y=2f(x)(f(x)>0),y=0(f(x)<0)图中写错了
Convolutional Neural Network
CNN,卷积神经网络
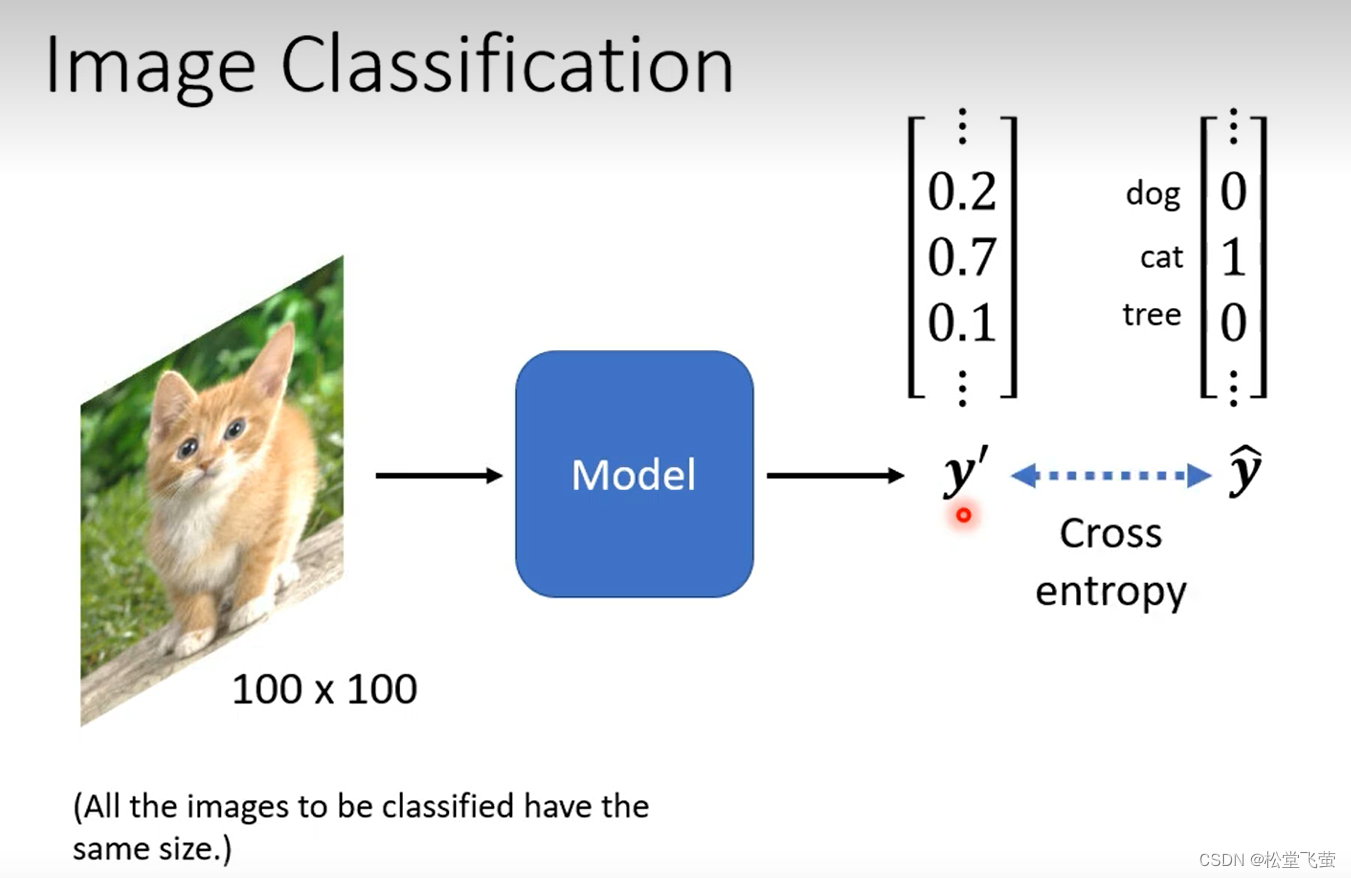
图片分类
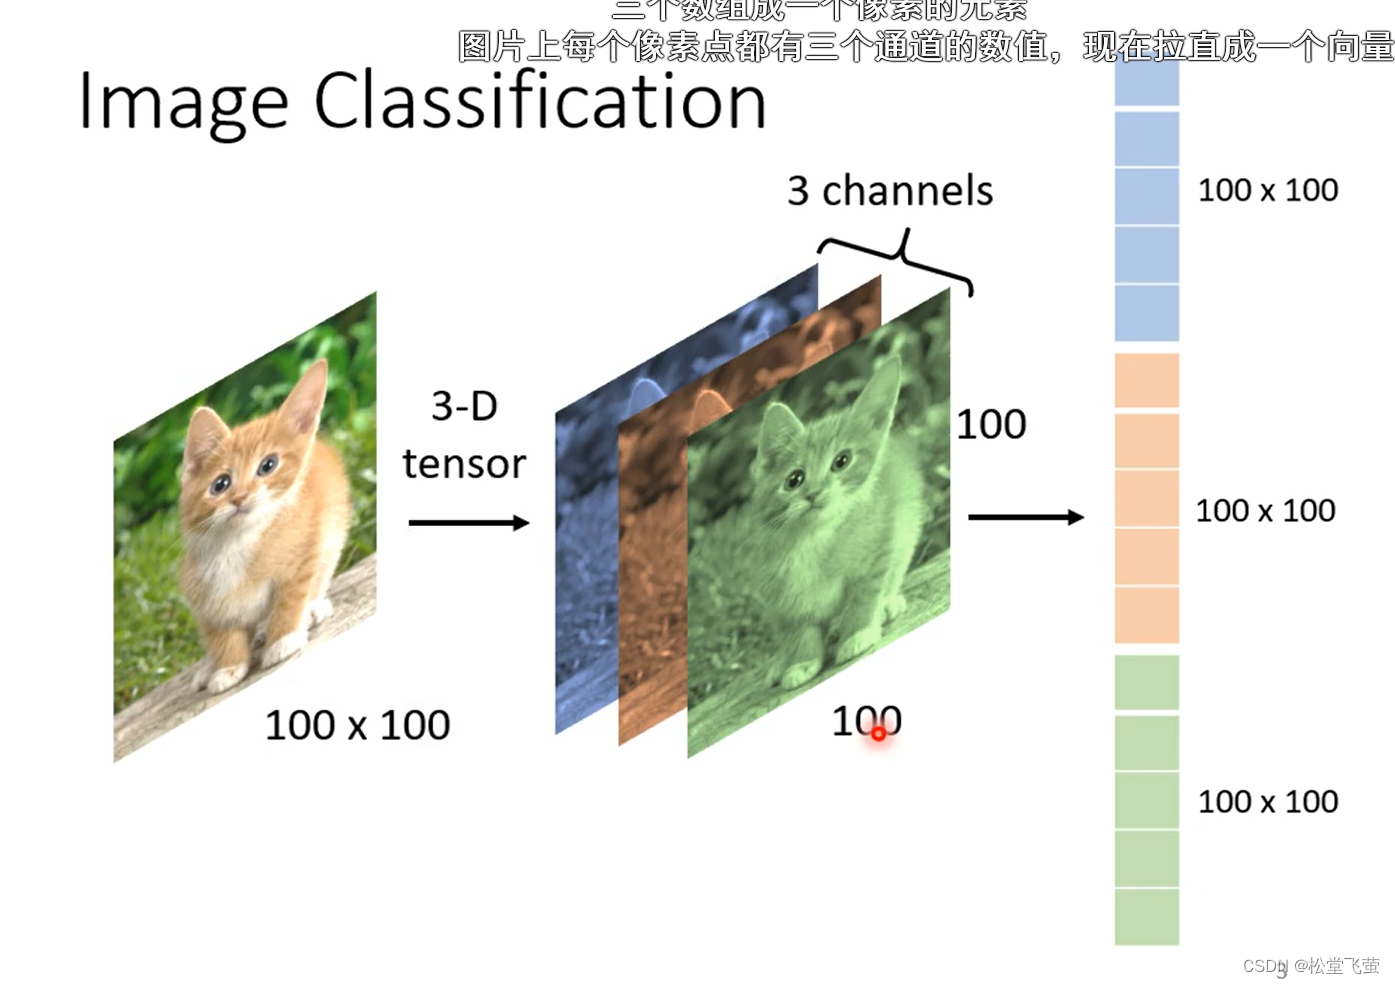
三维的tensor
长宽和channels(R,G,B)
简化1 receptive field
不需要fully connected network,一些特别重要的细节只占整个图片的很小一部分。
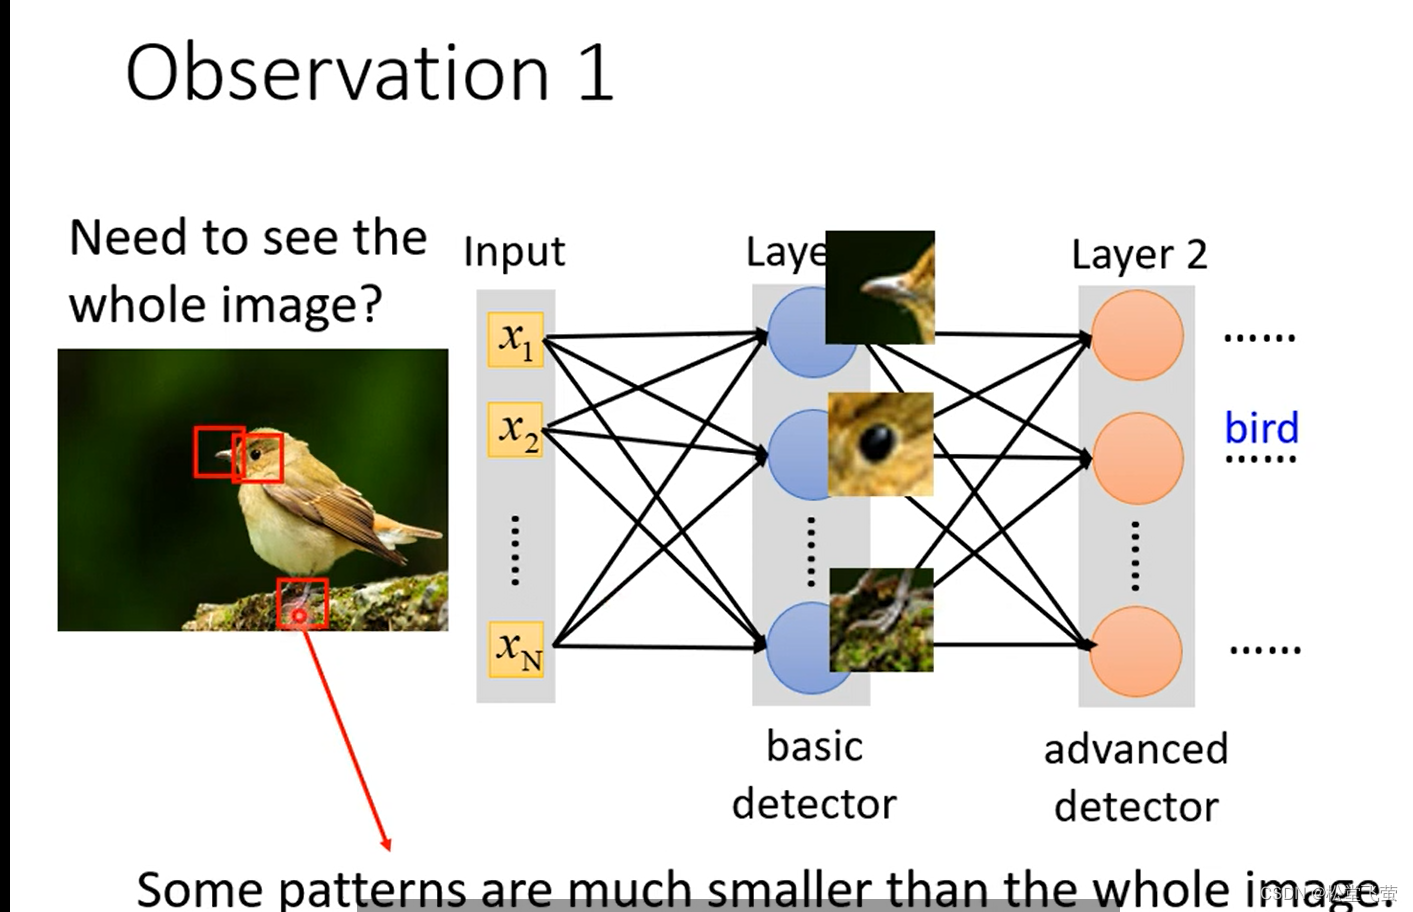
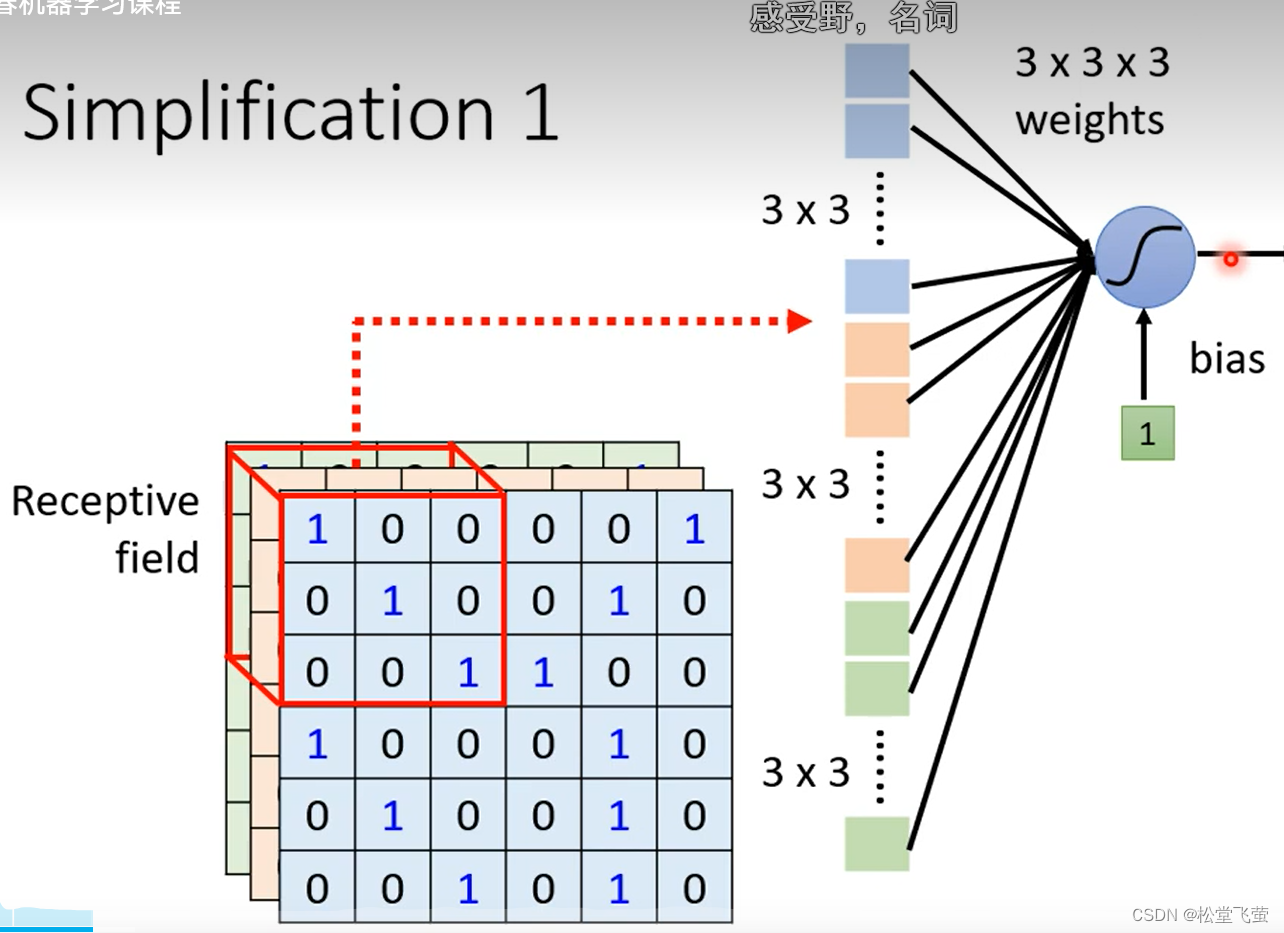
receptive field:每个neruon只关心自己的感受野即可。
-
互相可重叠。
-
同个范围可以有多个感知野。
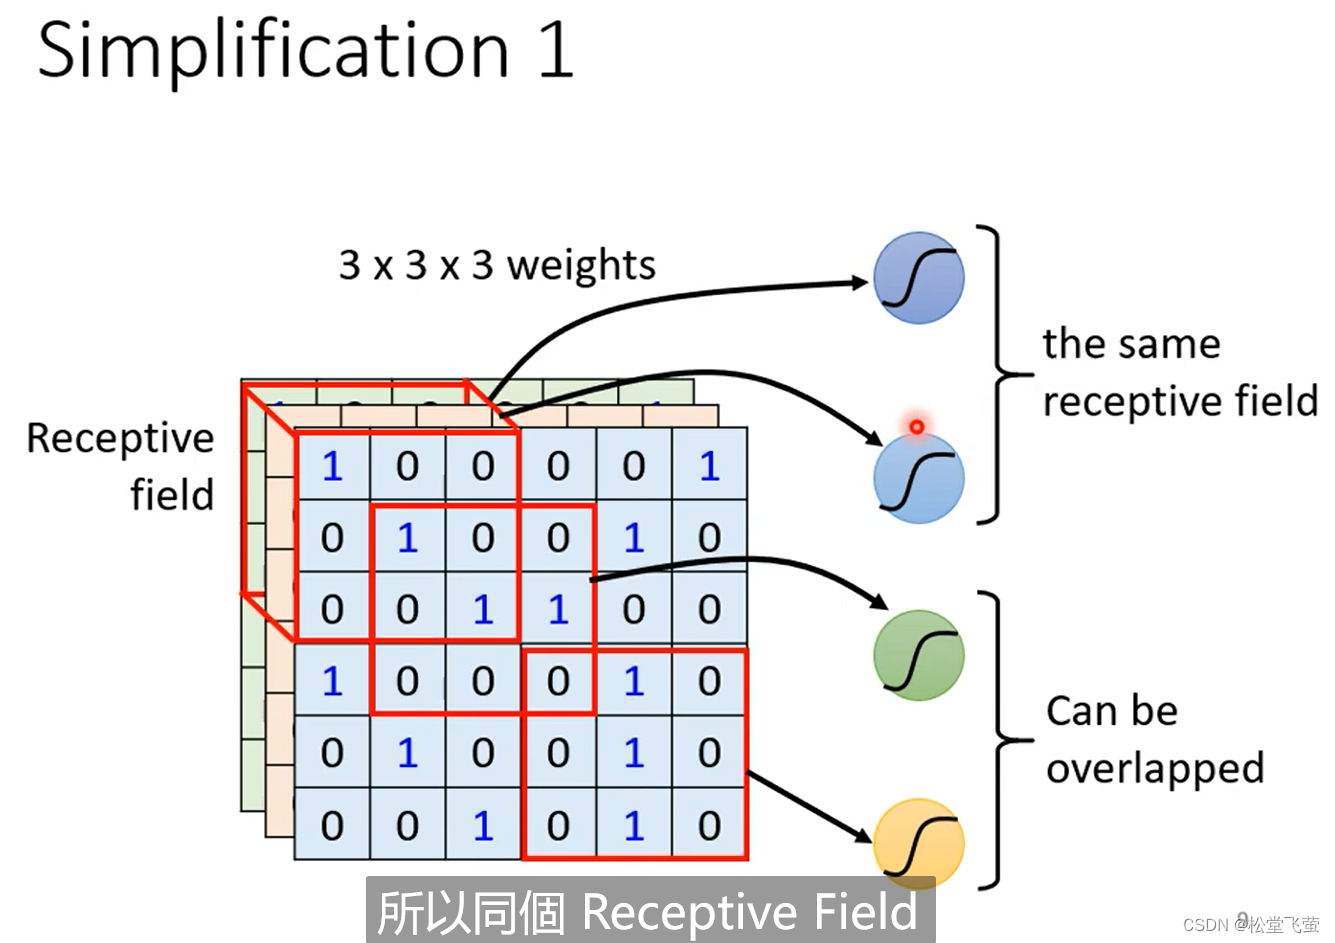
通常选择相邻的一块,来找一个pattern
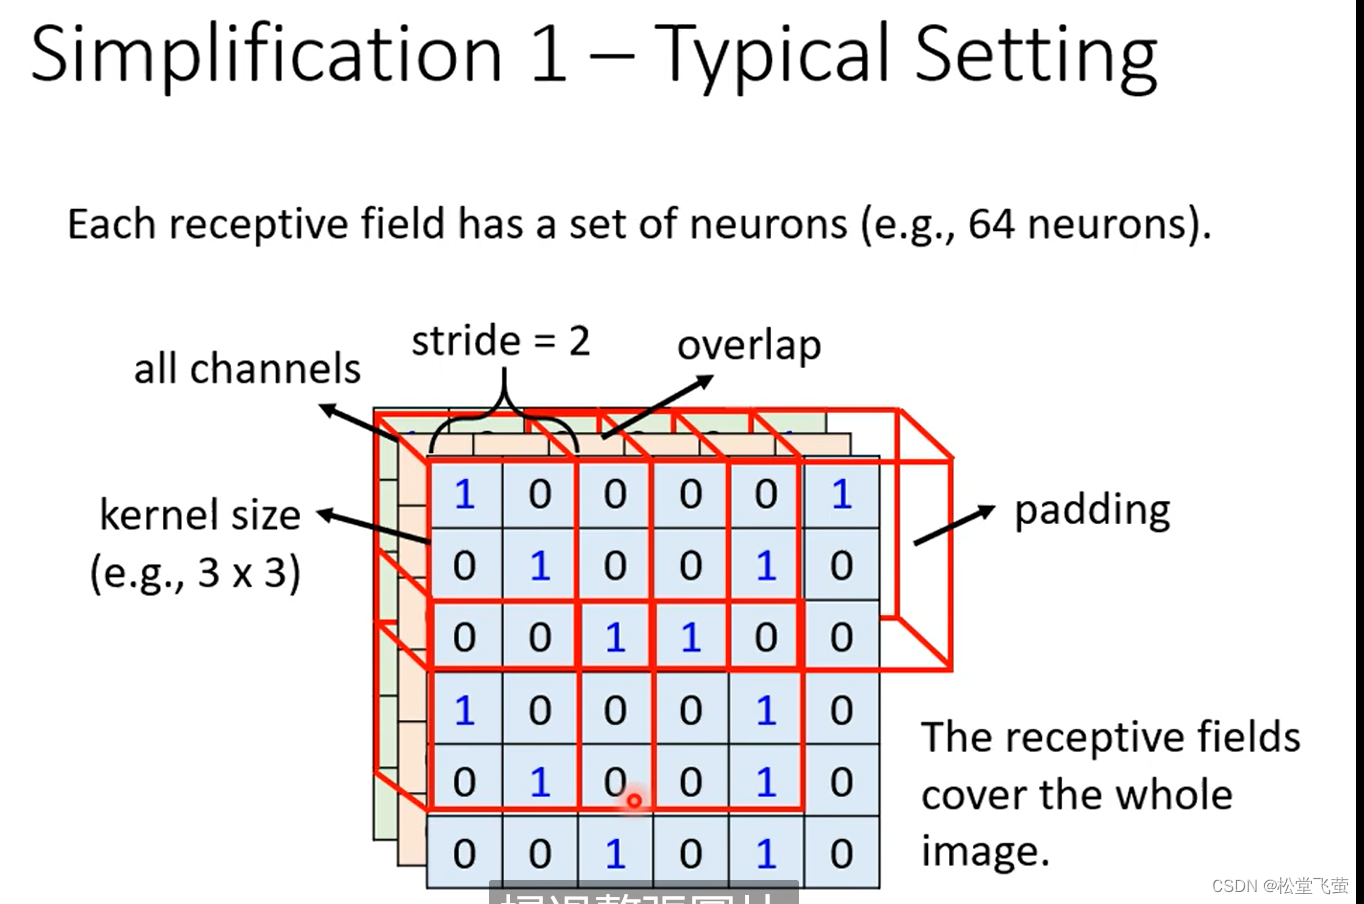
简化1 typical setting
- 通常会看所有的channels,所以只需要关注长宽,称之为kernel size。
kernel size:一般不会设置太大,如3X3。
-
每一个receptive field有一组神经元去关注它,如64个。
-
stride: receptive field的移动的量,步幅,往往设为1或2(需要重叠),自己决定的参数。可以上下,左右移动。
需要重叠R:有一个pattern处在两个receptive field的交界上面,则完全没有一个neuron去侦测它,会错过这个pattern。
- 超出范围:
padding:补充超出位置
1.用0填充
2.补整张图片value 的平均
简化2 parameter sharing
如下图,同样的pattern会出现在不同的位置。比如鸟嘴。
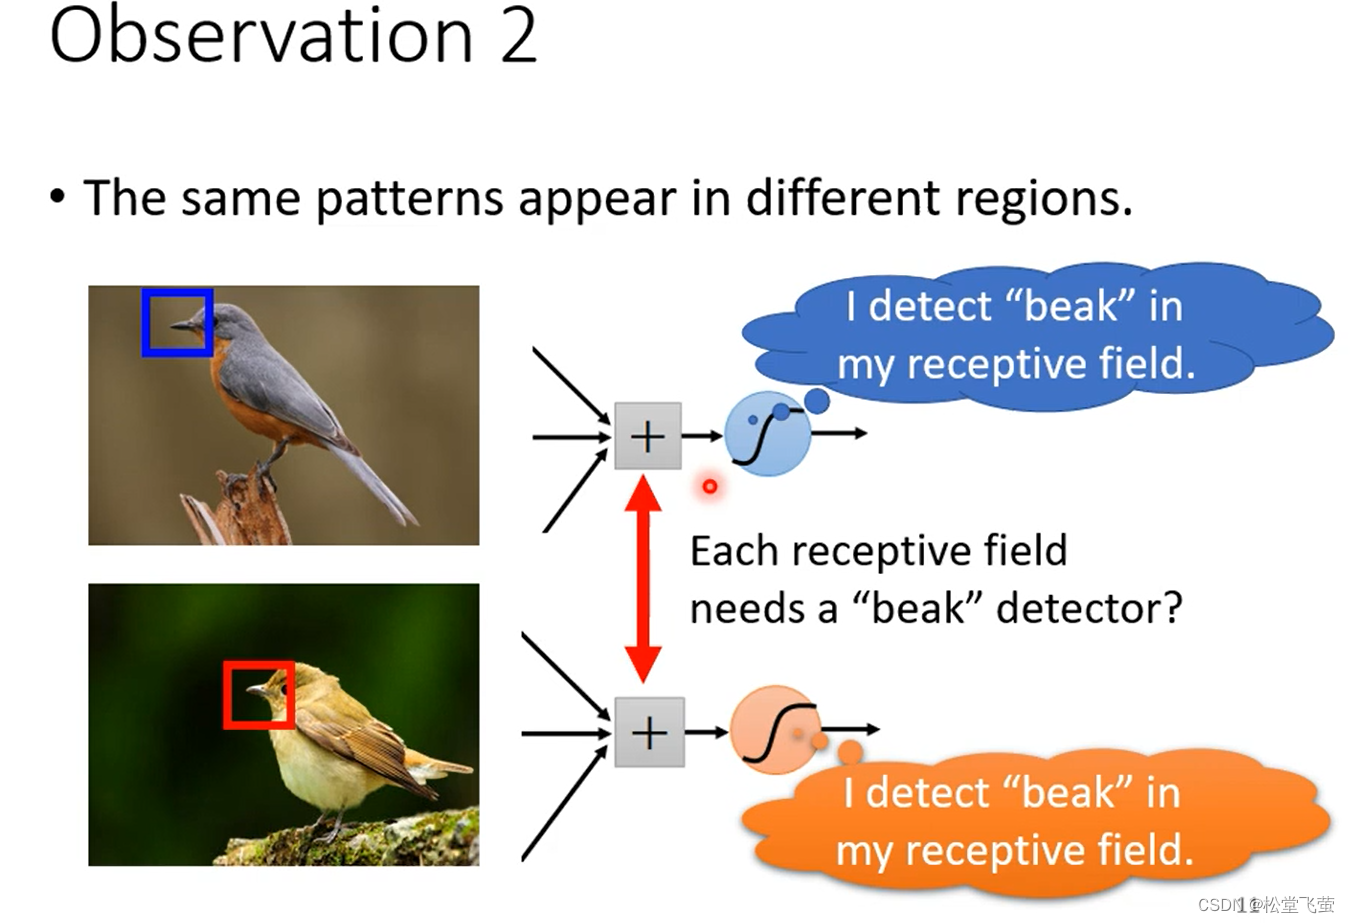
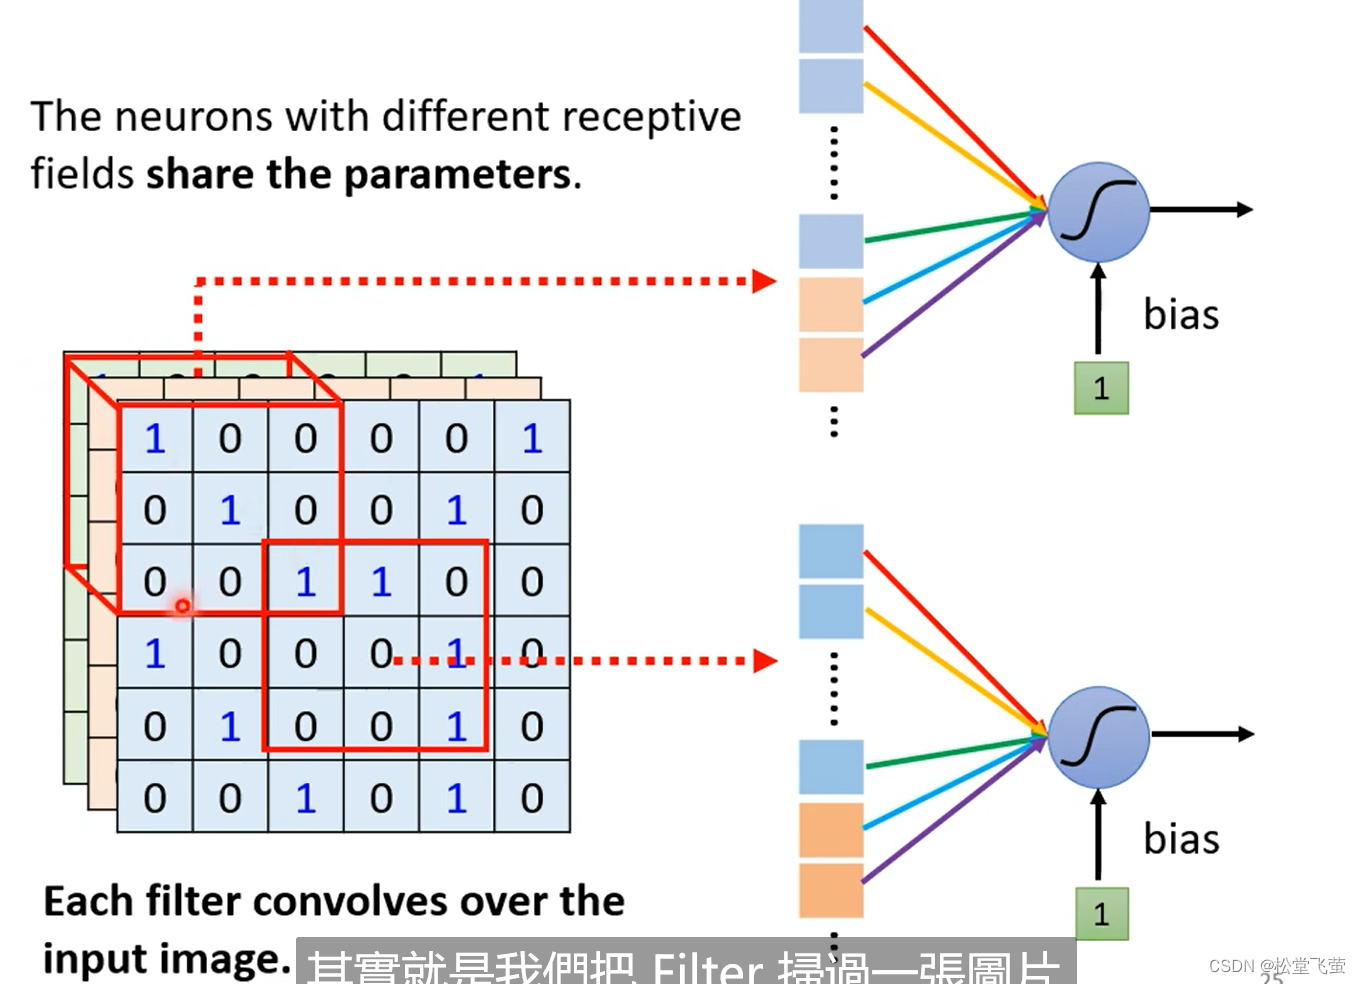
共享参数:虽然receptive field不同,但weight完全相同。同样完全由自己决定。
PS1:由于输入不一样,output也不一样。
PS2:不会让两个receptive field 一样的neuron共享参数。
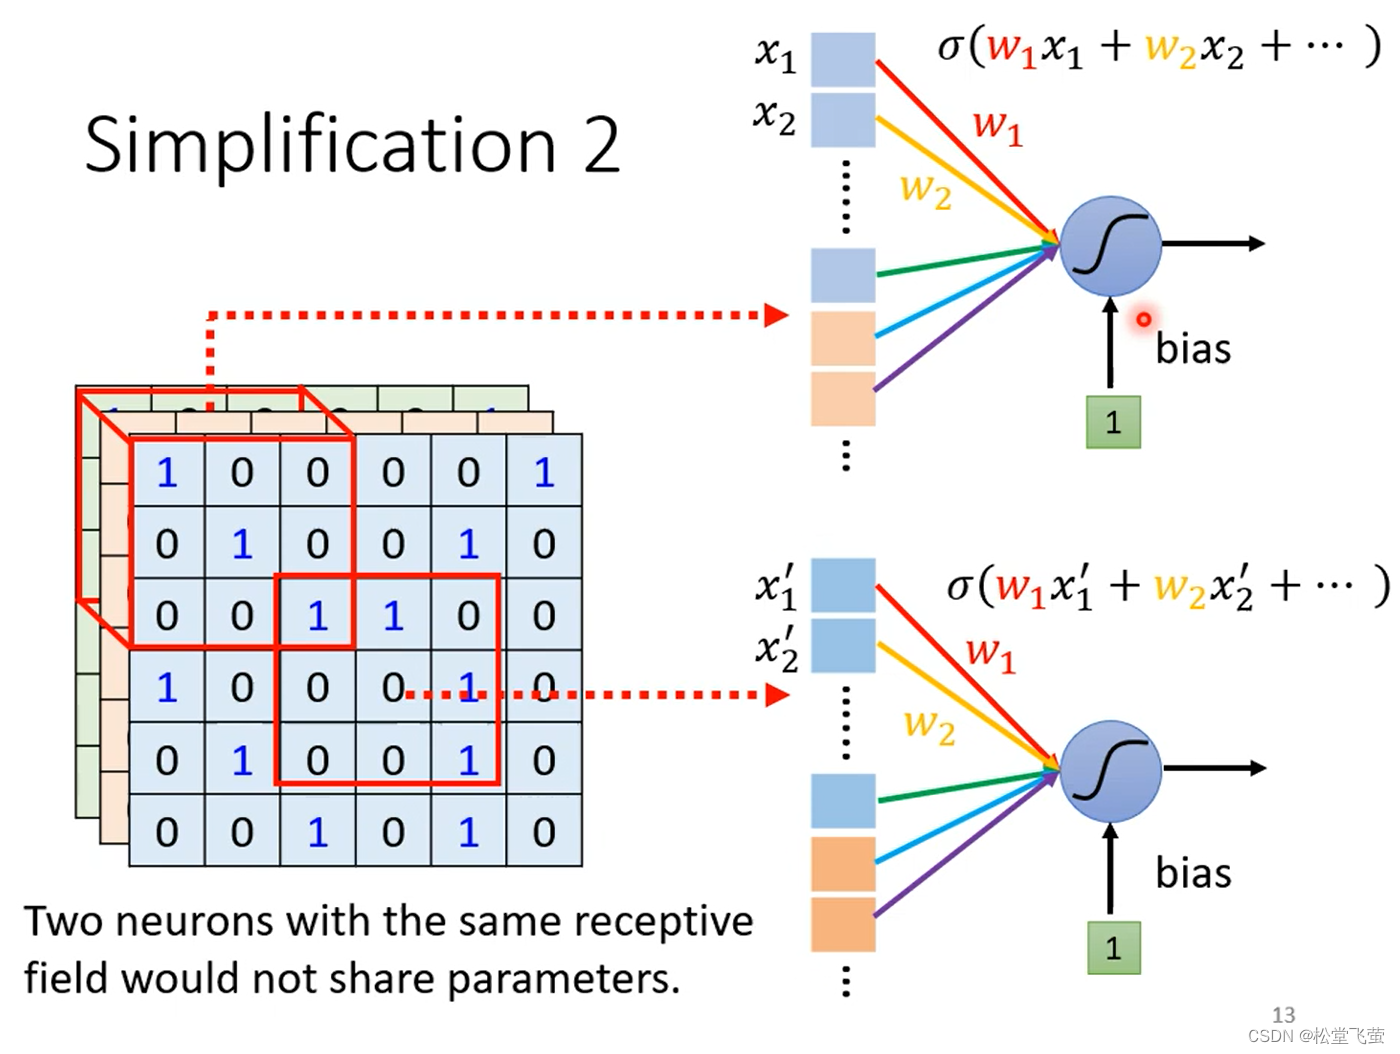
简化2 typical setting
如下图,每一组的相同颜色的neuron共享参数。
共用同一组参数叫filter。
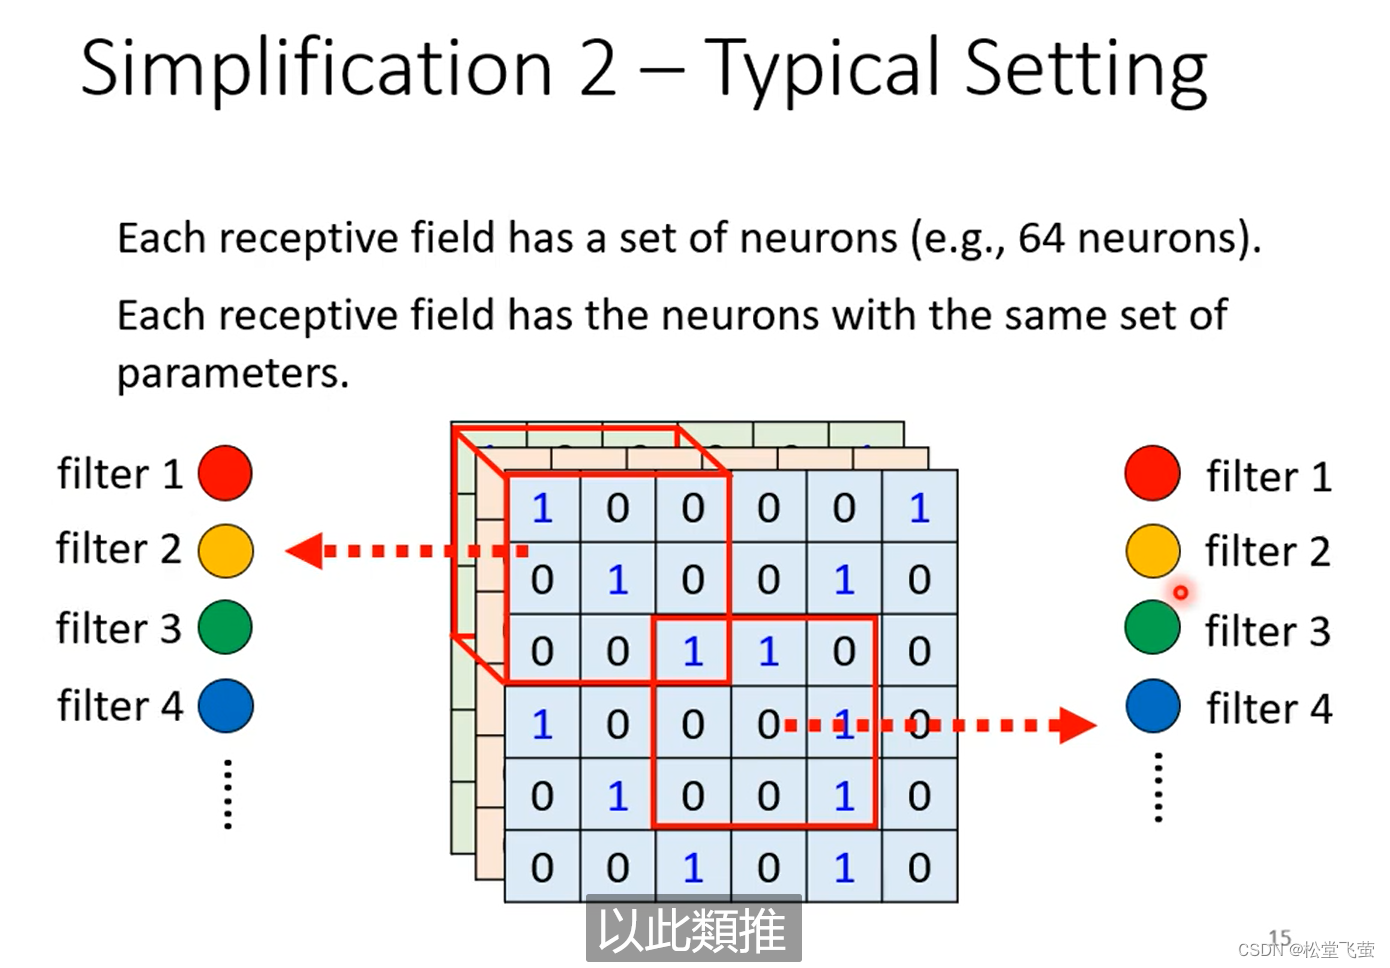
总结
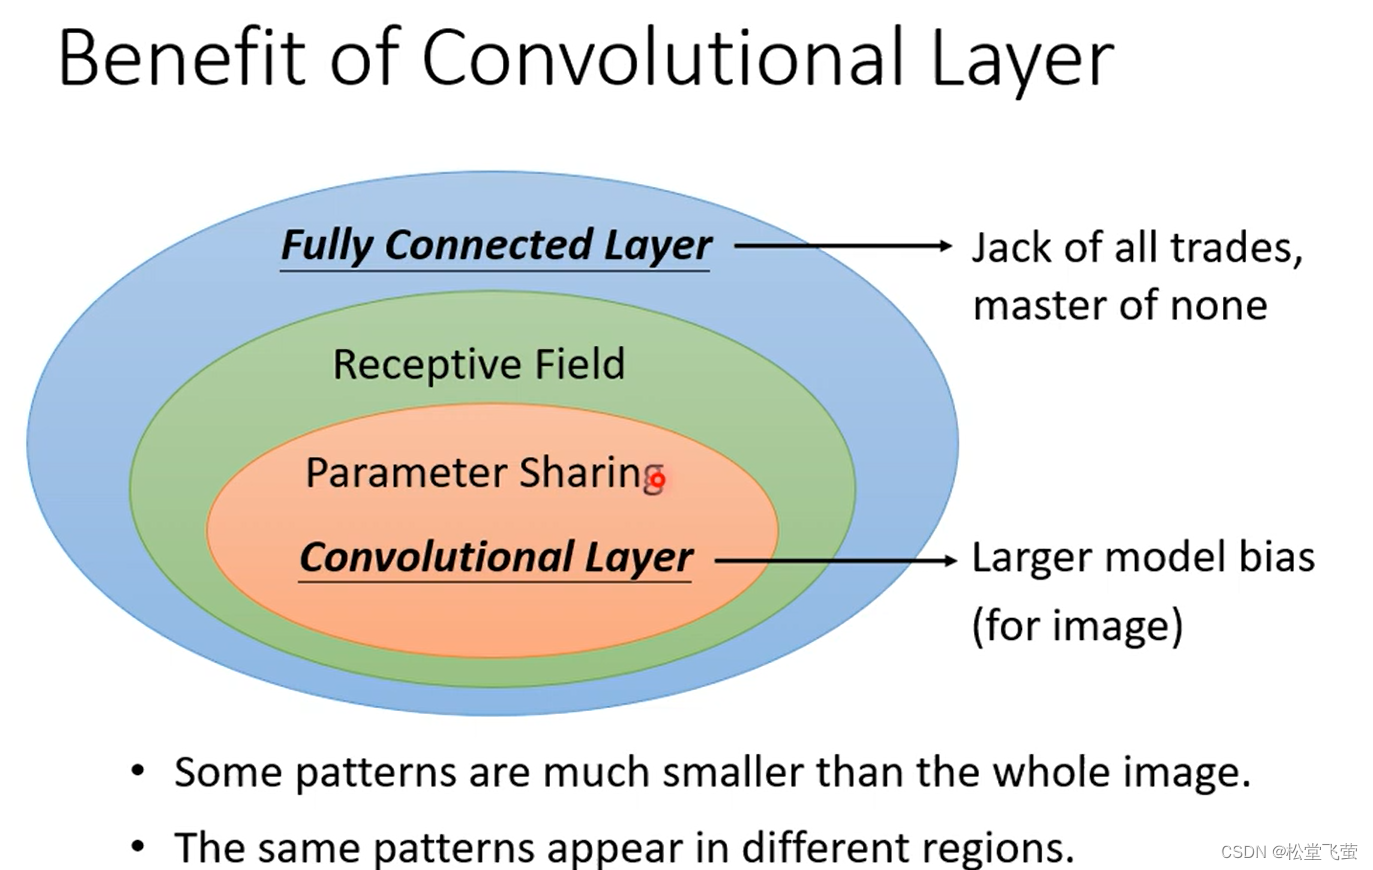
network弹性逐渐变小。
receptive field + parameter share 即为 convolutional layer。
使用卷积层的神经网络即为CNN。
CNN有比较大的bias,但是是专门为影像设计,所以在这方面做的很好
另外一种介绍方式
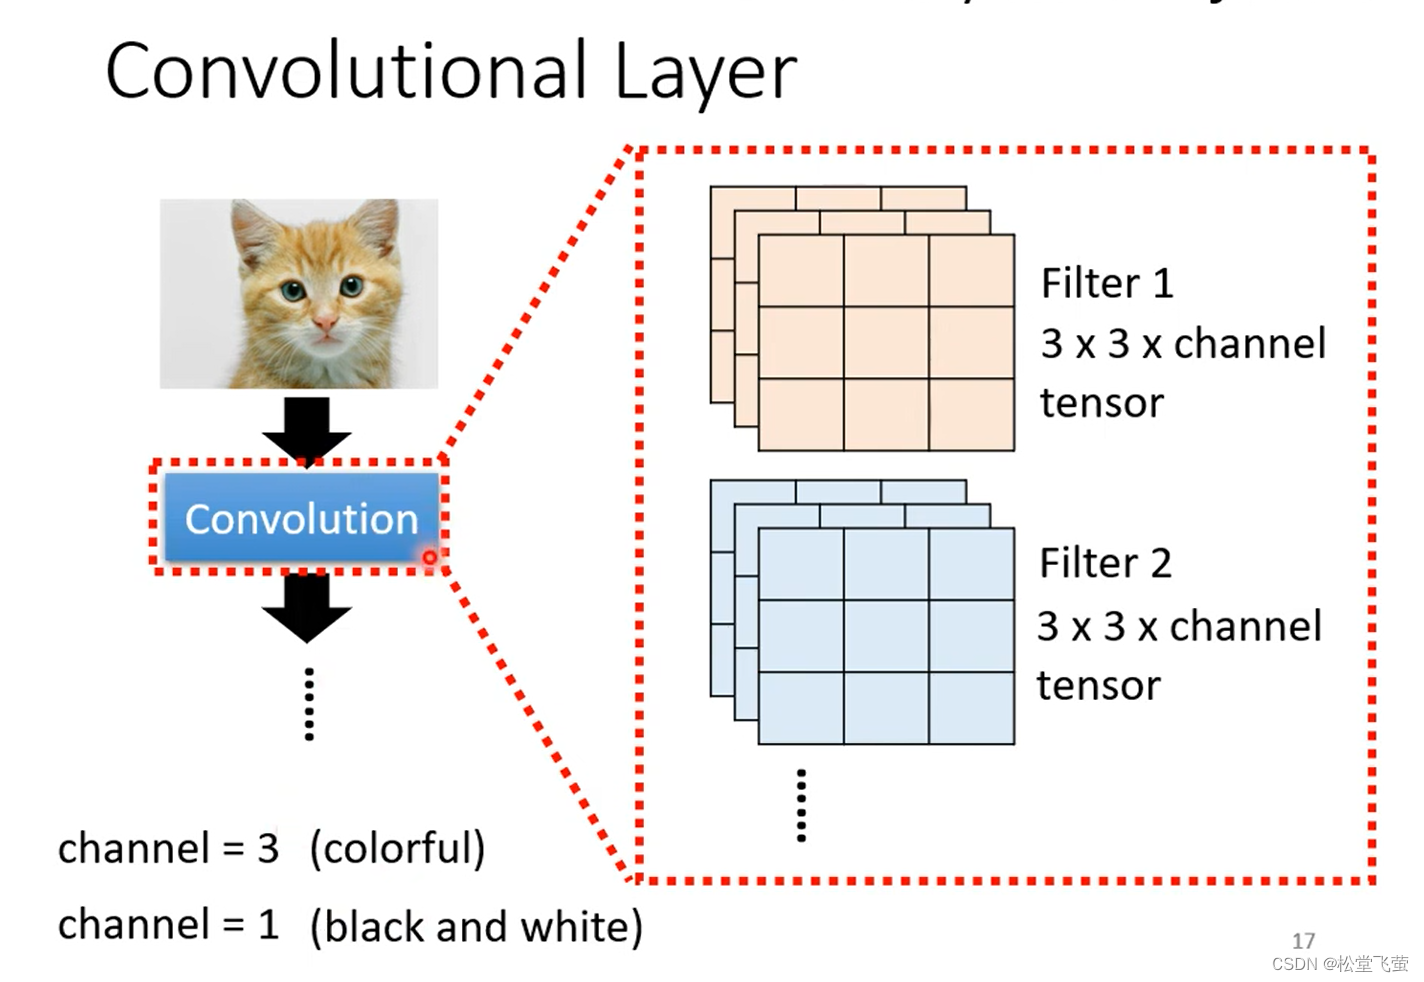
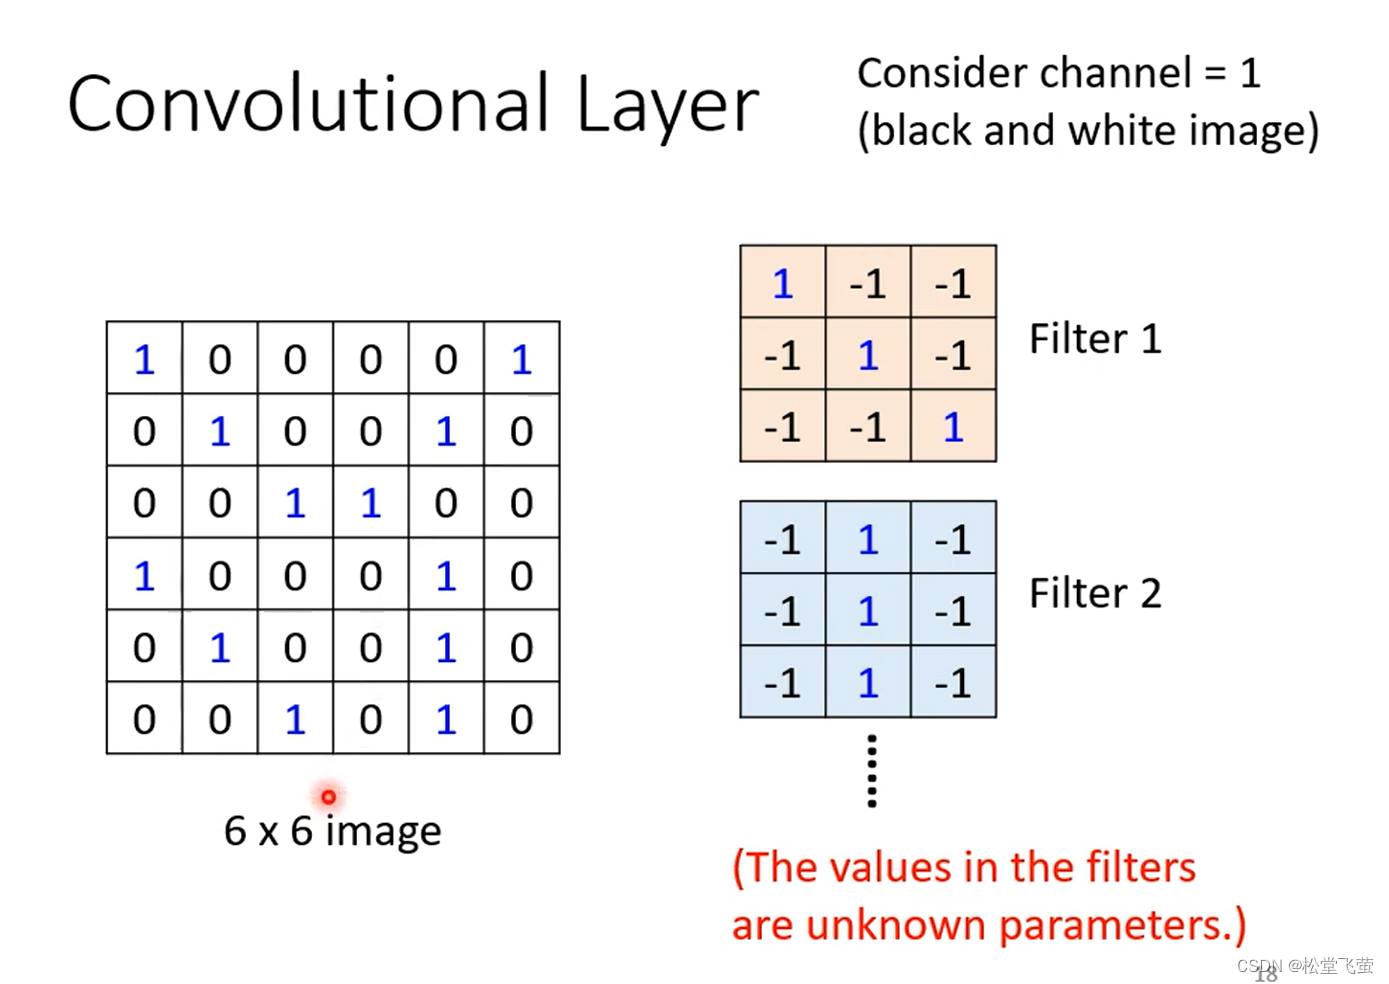
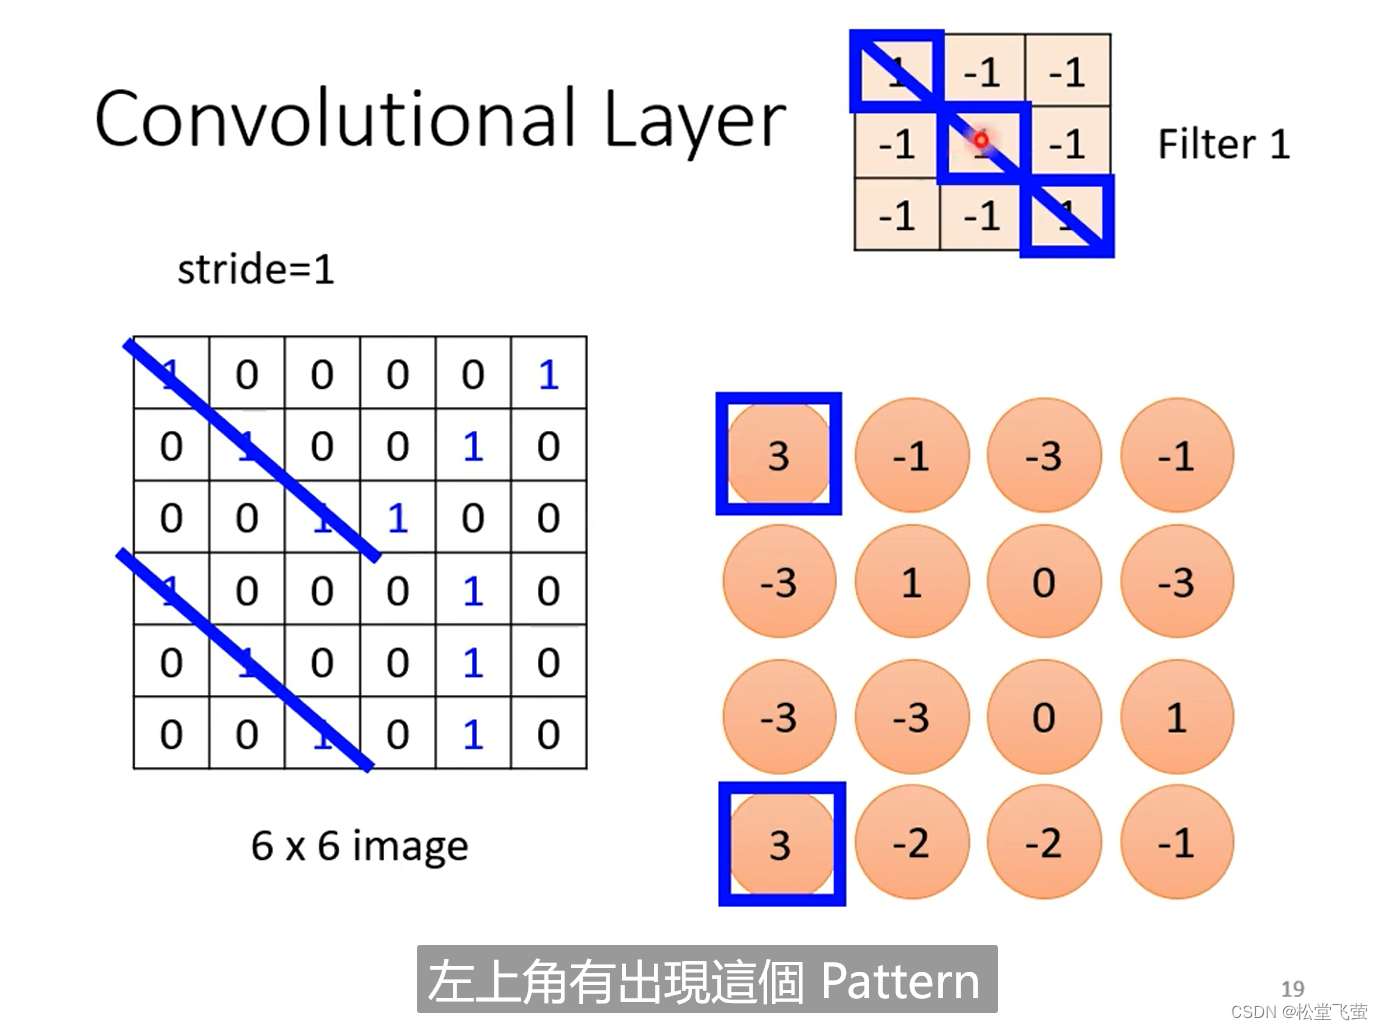
每个filter和一个receptive field做inner product(内积)
filter里面的值是经验定义的,要求filter里面的值和为一,也可以定义其他的,如:九个格都设置为九分之一。
filter里的值就是神经网络的权重参数 是要训练得到
每次移动stride,再次相乘。
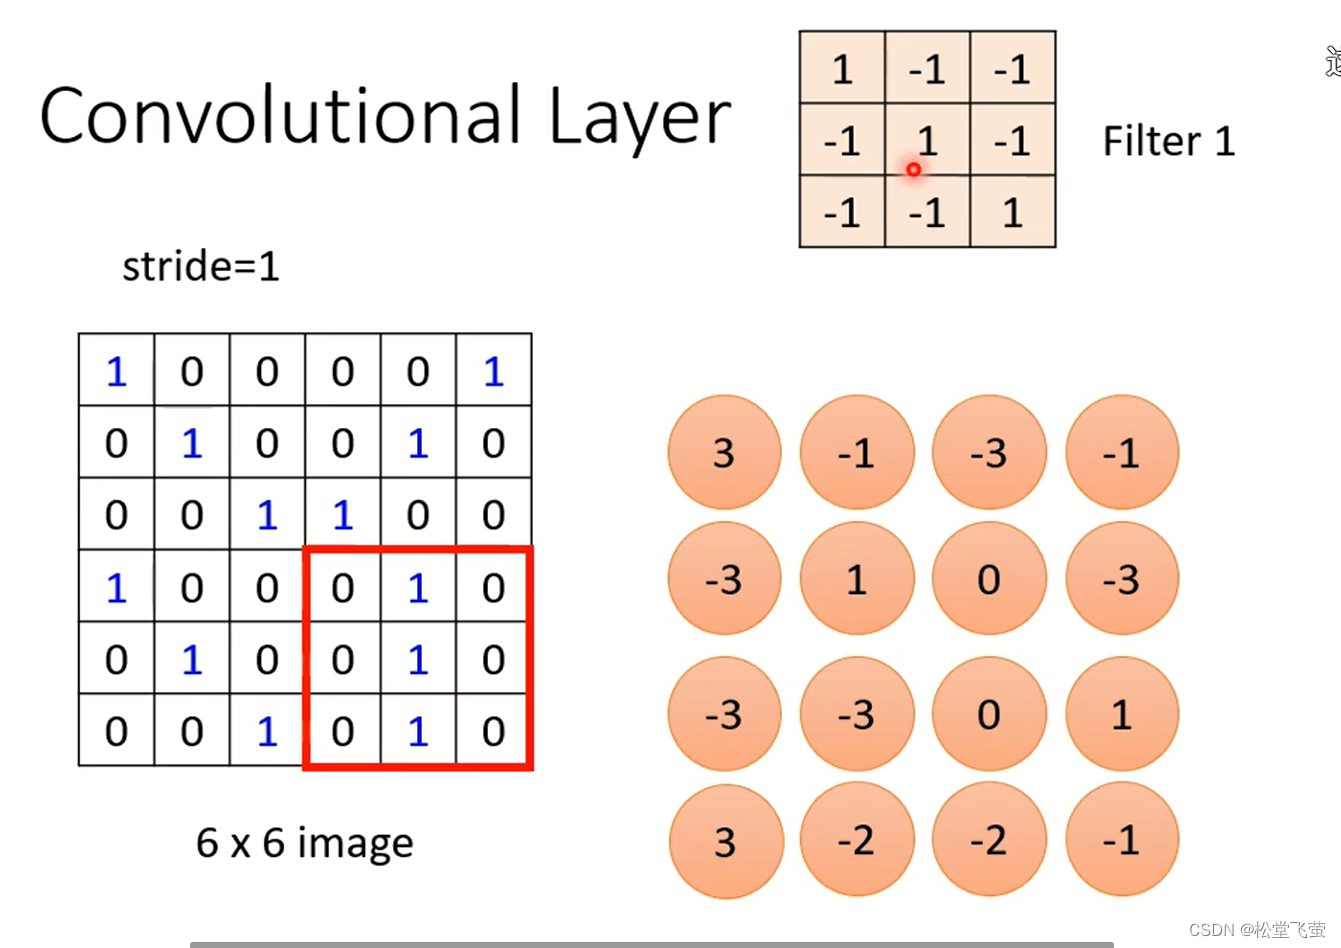
查看最大值,抓取三个1,即为pattern,这就是第一个filter。
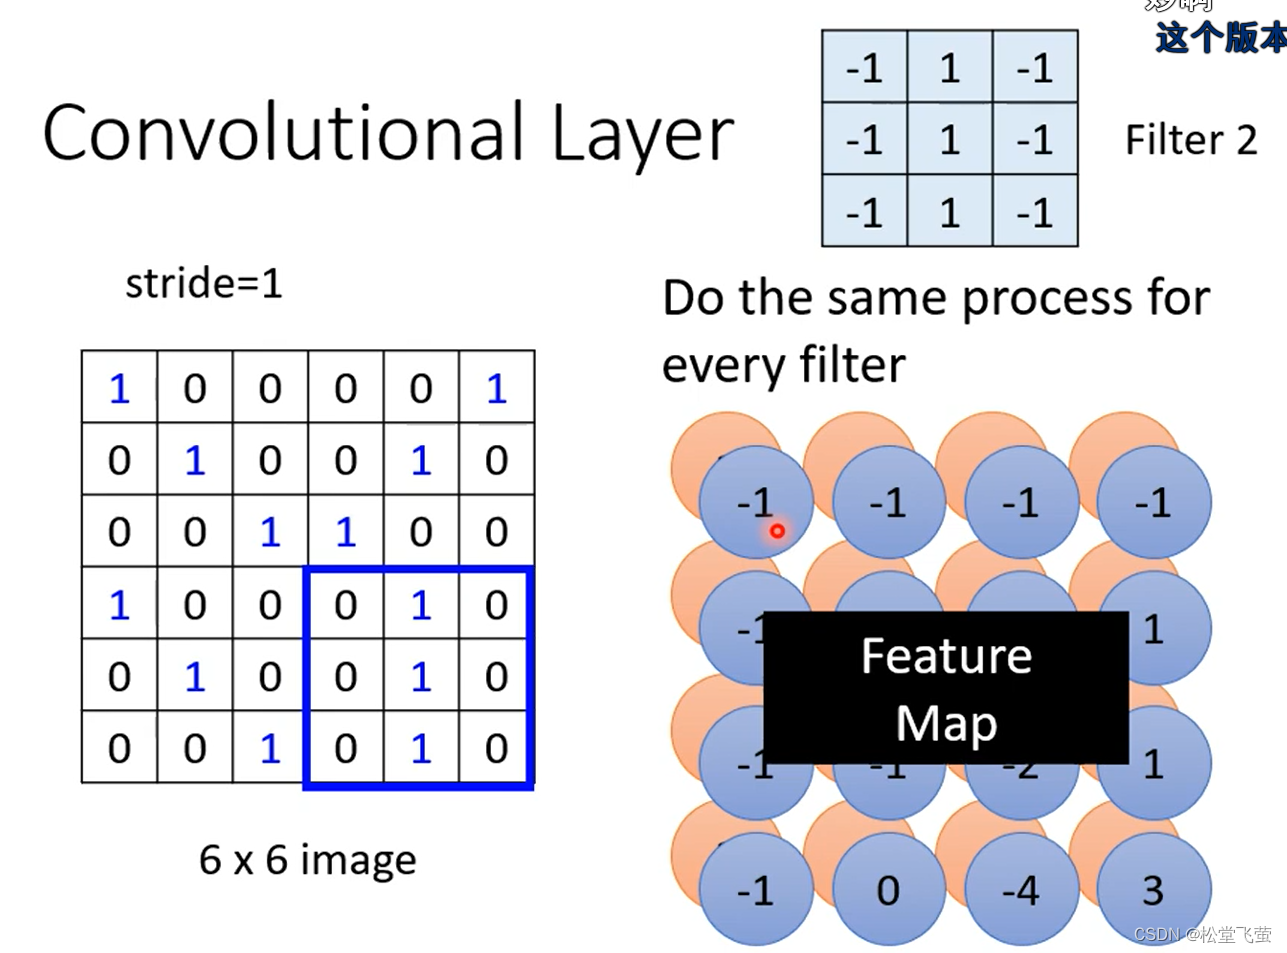
第二个filter抓取中间为1的情况。
这群数字叫feature map。
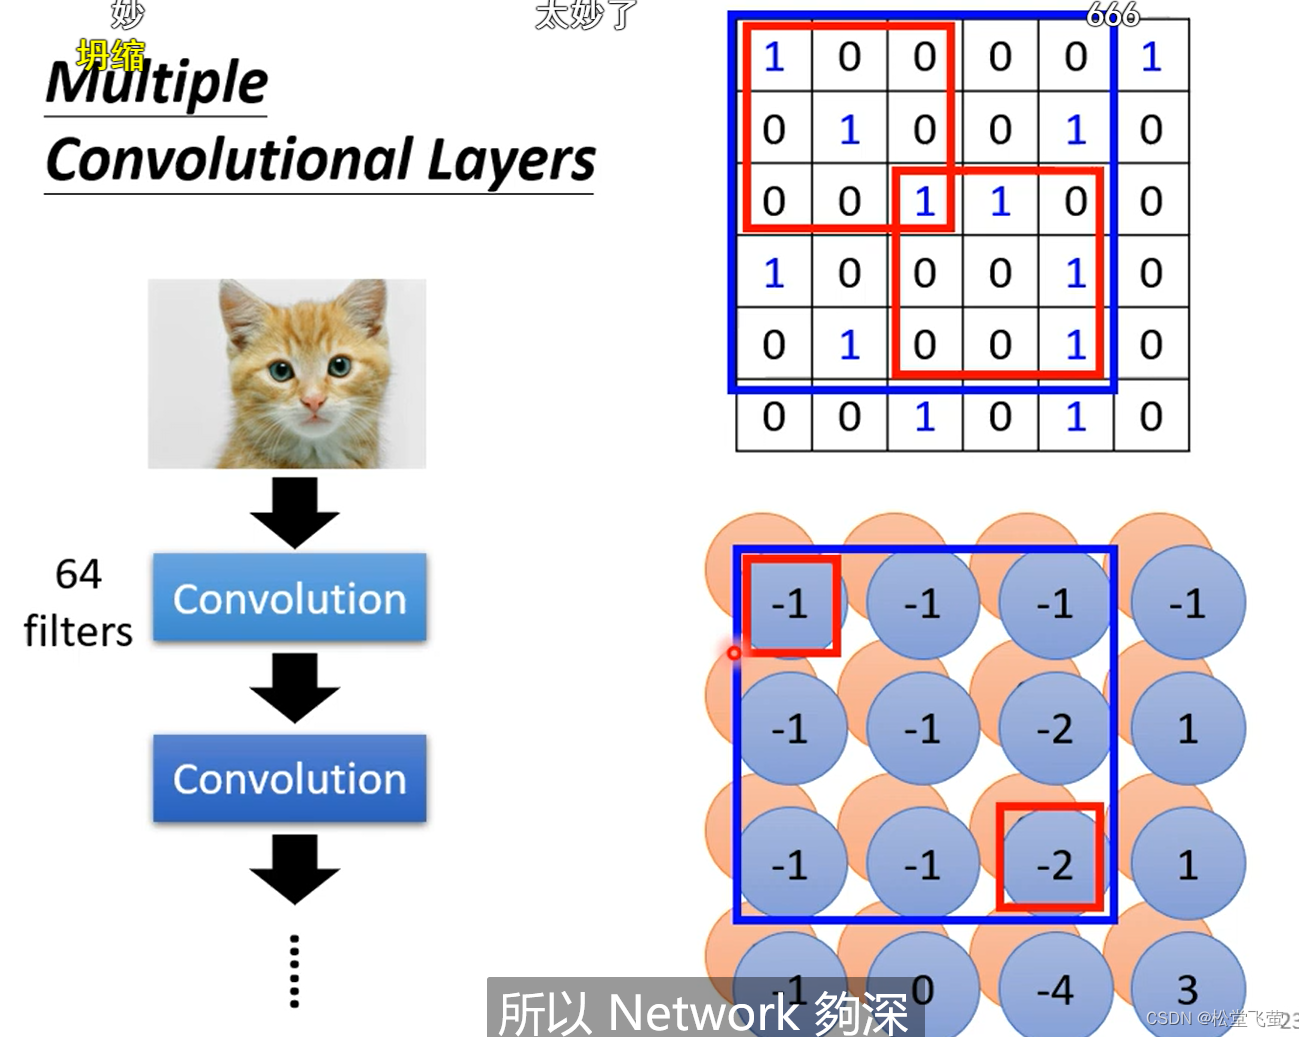
多层convolutional layer
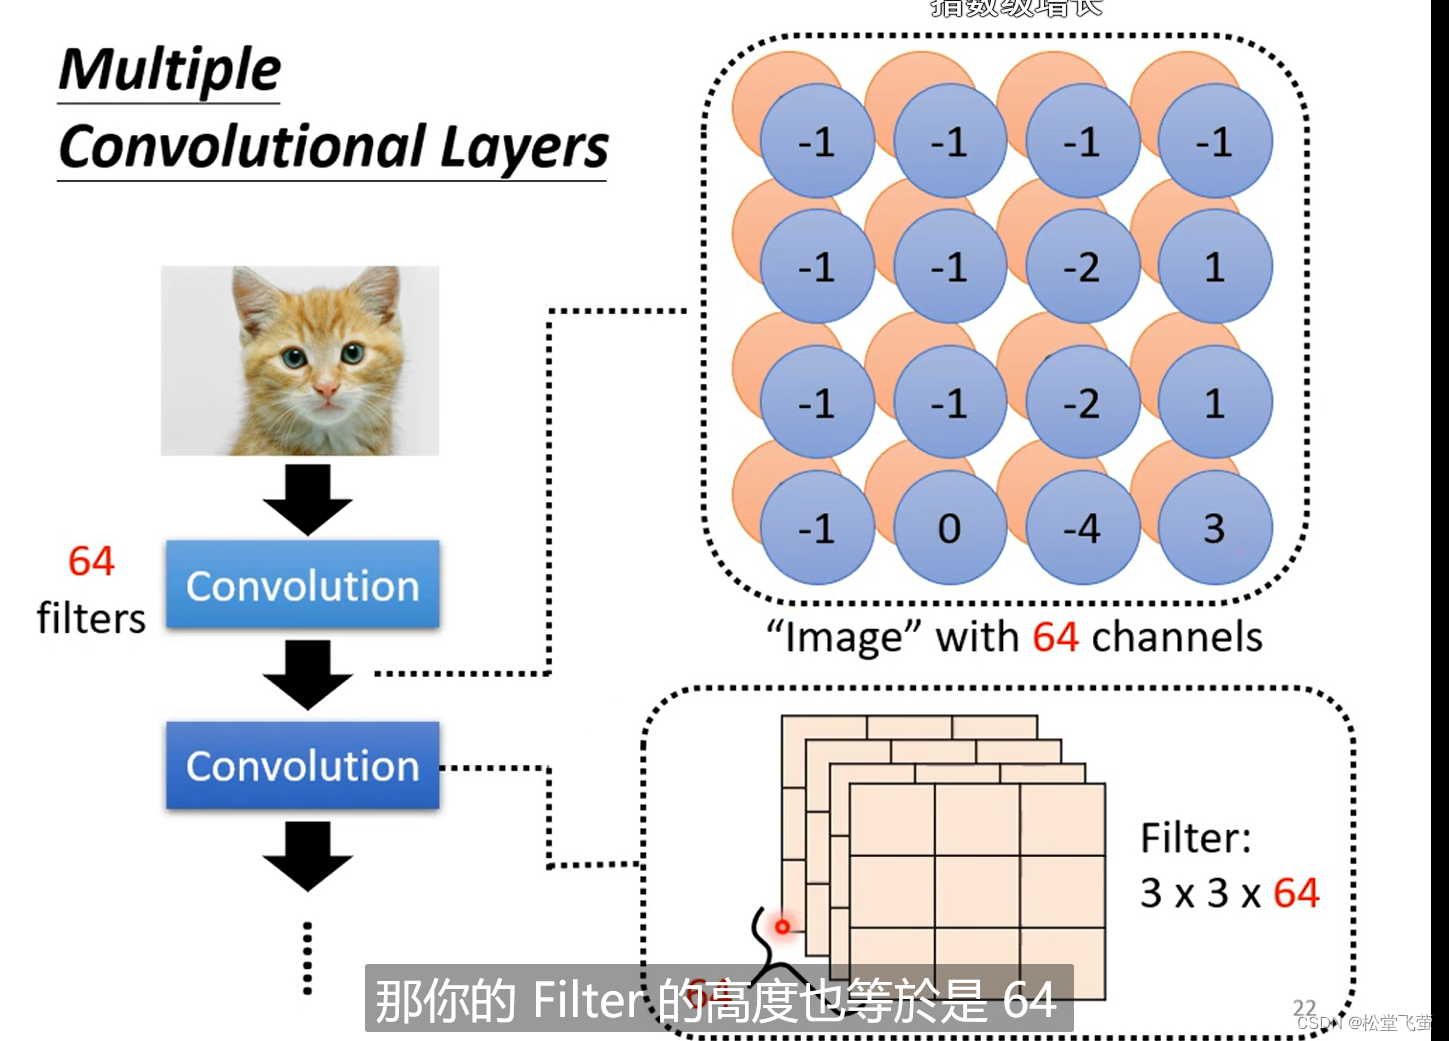
以第二层为例,当我们看左上角的时候,对应原来的3*3,如下图。
总之第二层3*3,对应原来的5 * 5
两种的总结
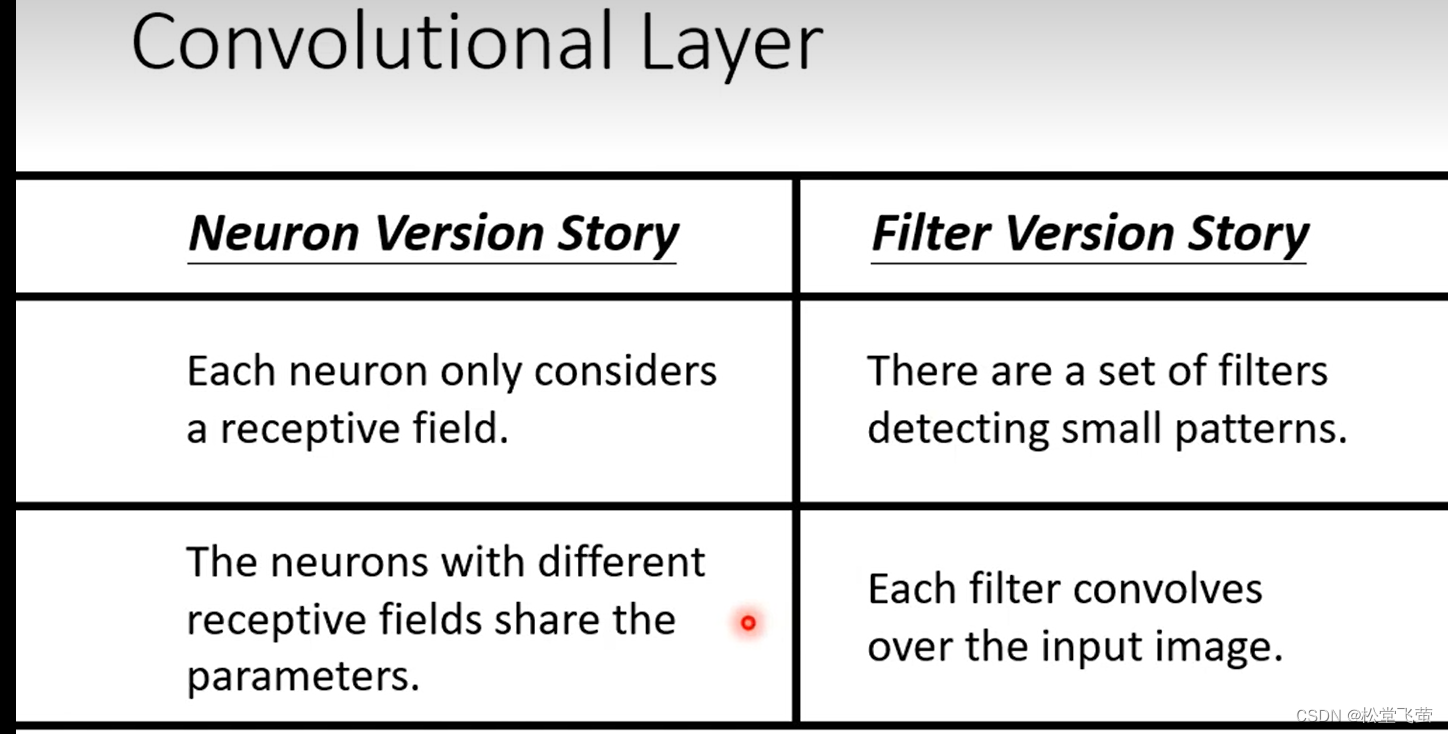
每个filter扫过一张图片,的过程,即为convolution,也就是不同receptive field的neuron的parameter sharing
简化3 pooling
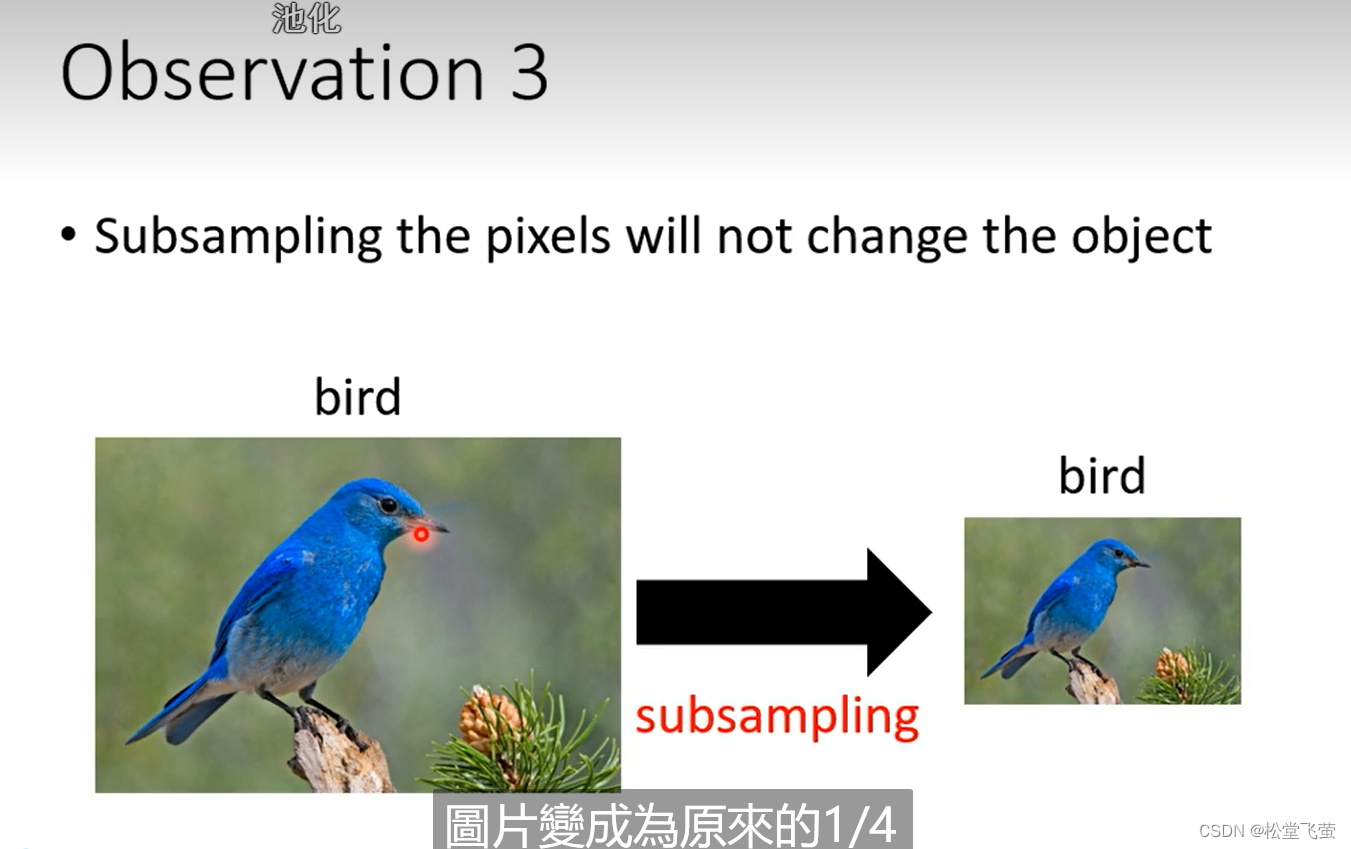
subsampling:下抽样,如图。
pooling:池化
本身没有参数,不是一个layer,也没有要learn的东西。
比较像activation function,是一个operator
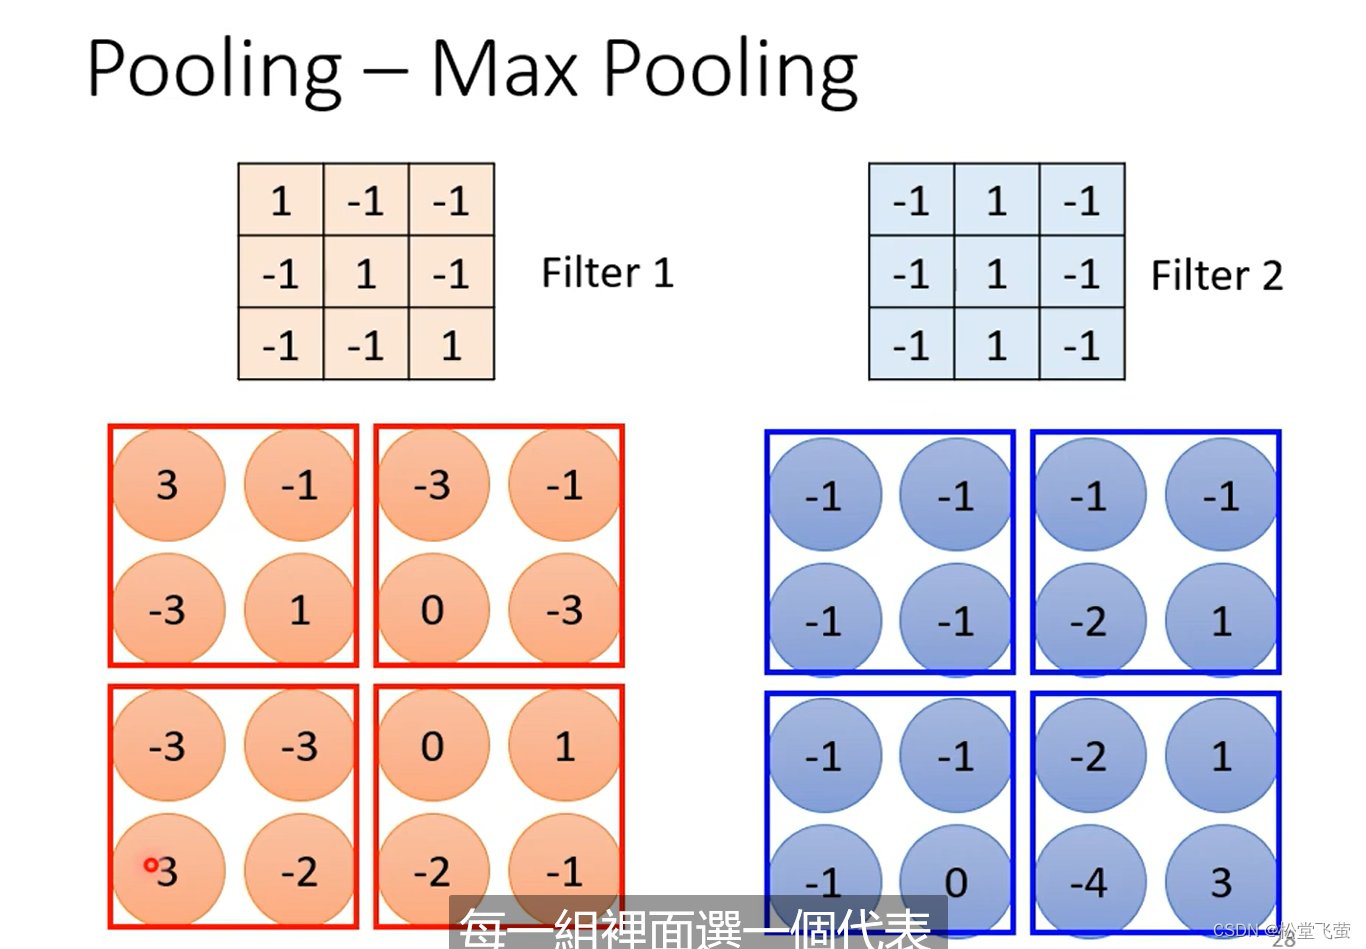
max pooling:最大池化
每组里面选一个代表(最大的那个)
不一定要2*2个一组
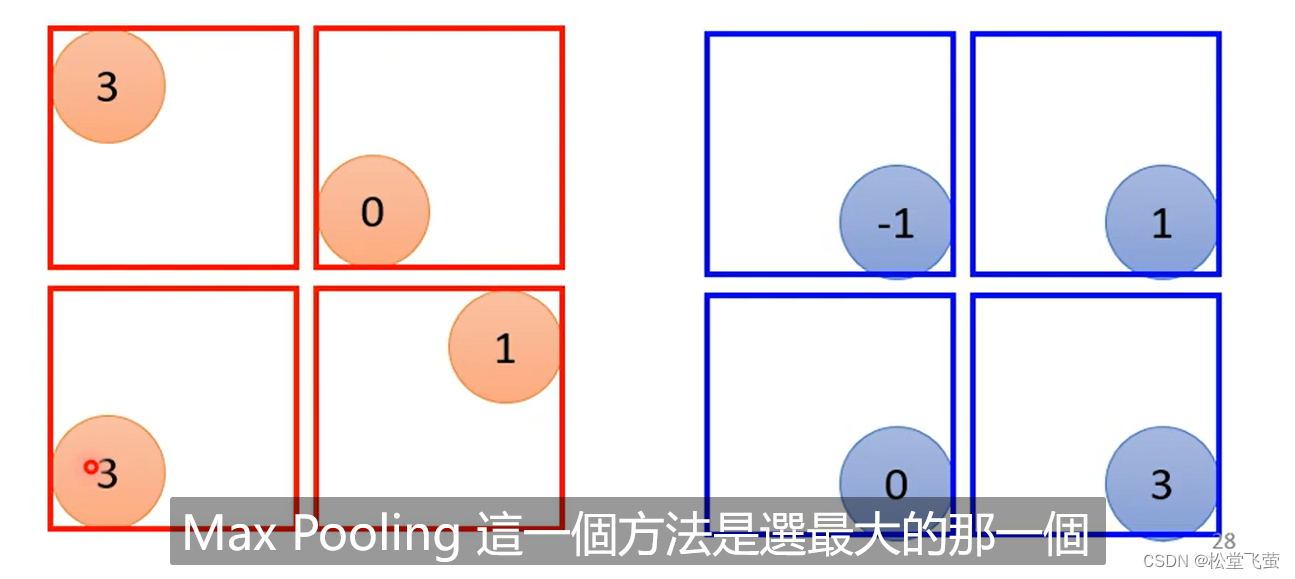
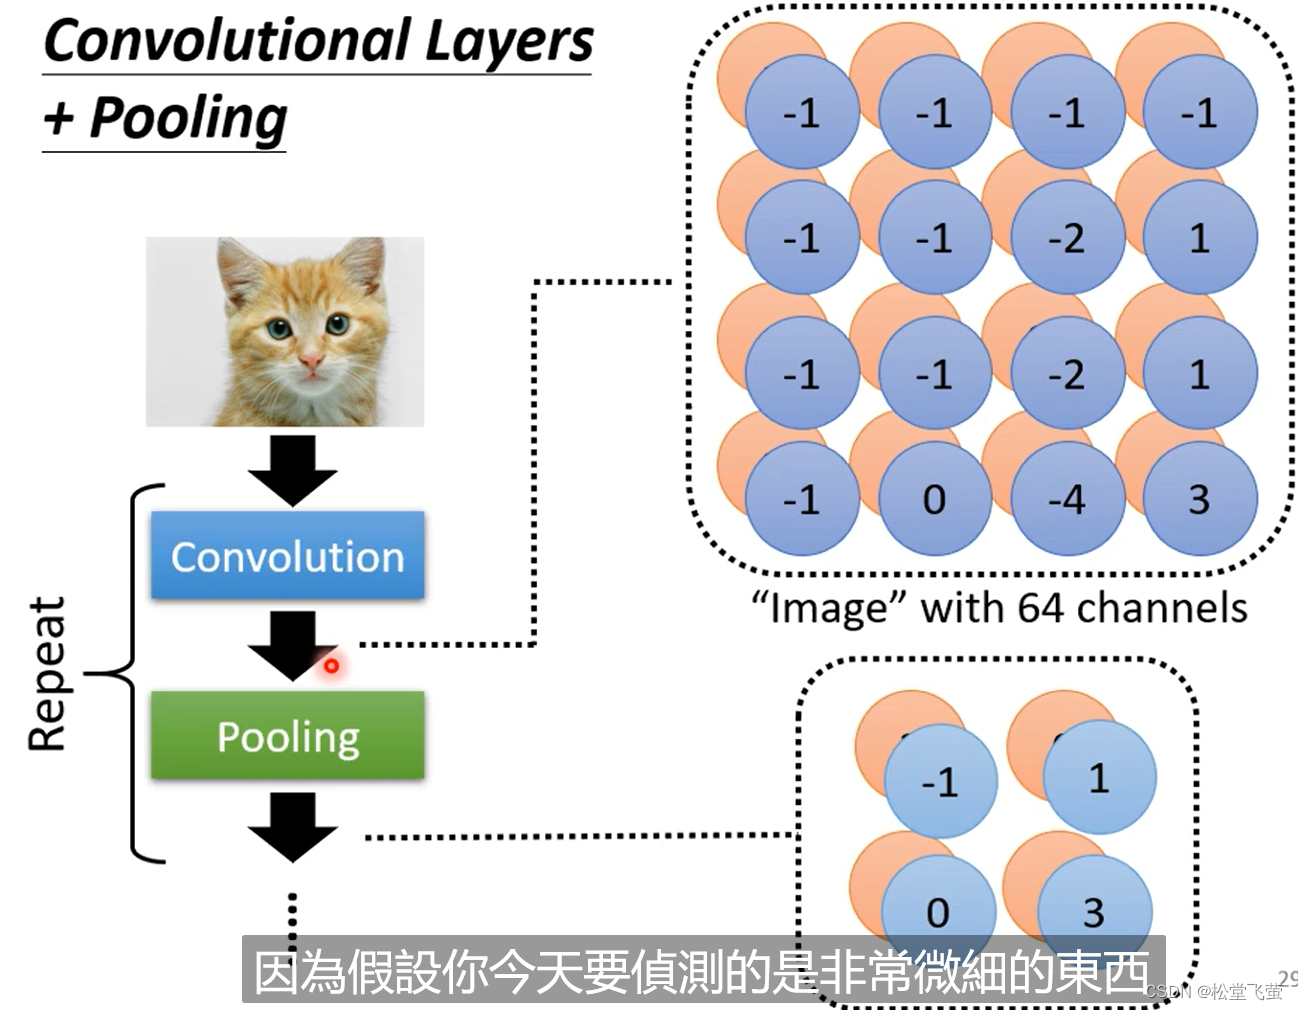
如果要找细微的特征,pooling会损害细节。
pooling主要是减少运算量。
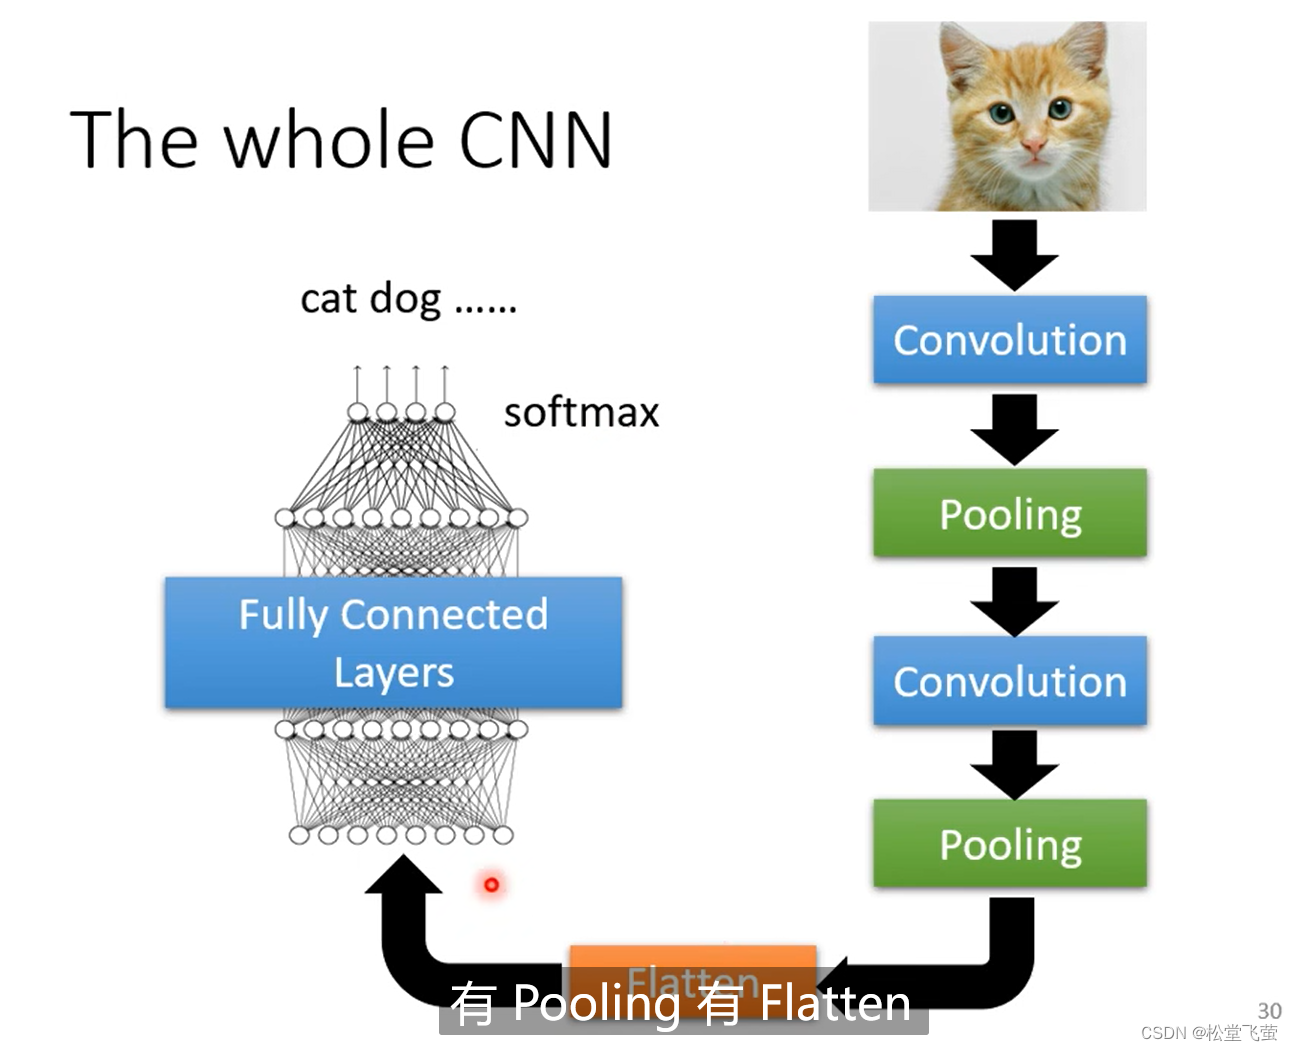
最终模型
flatten:将本来排成矩阵的数据拉直成为变成一个向量。
后序把这个向量丢进fully connected layer中训练。
应用——阿尔法狗
48 chnanels:这个位置是不是要被叫吃,是不是有相同颜色的子等。
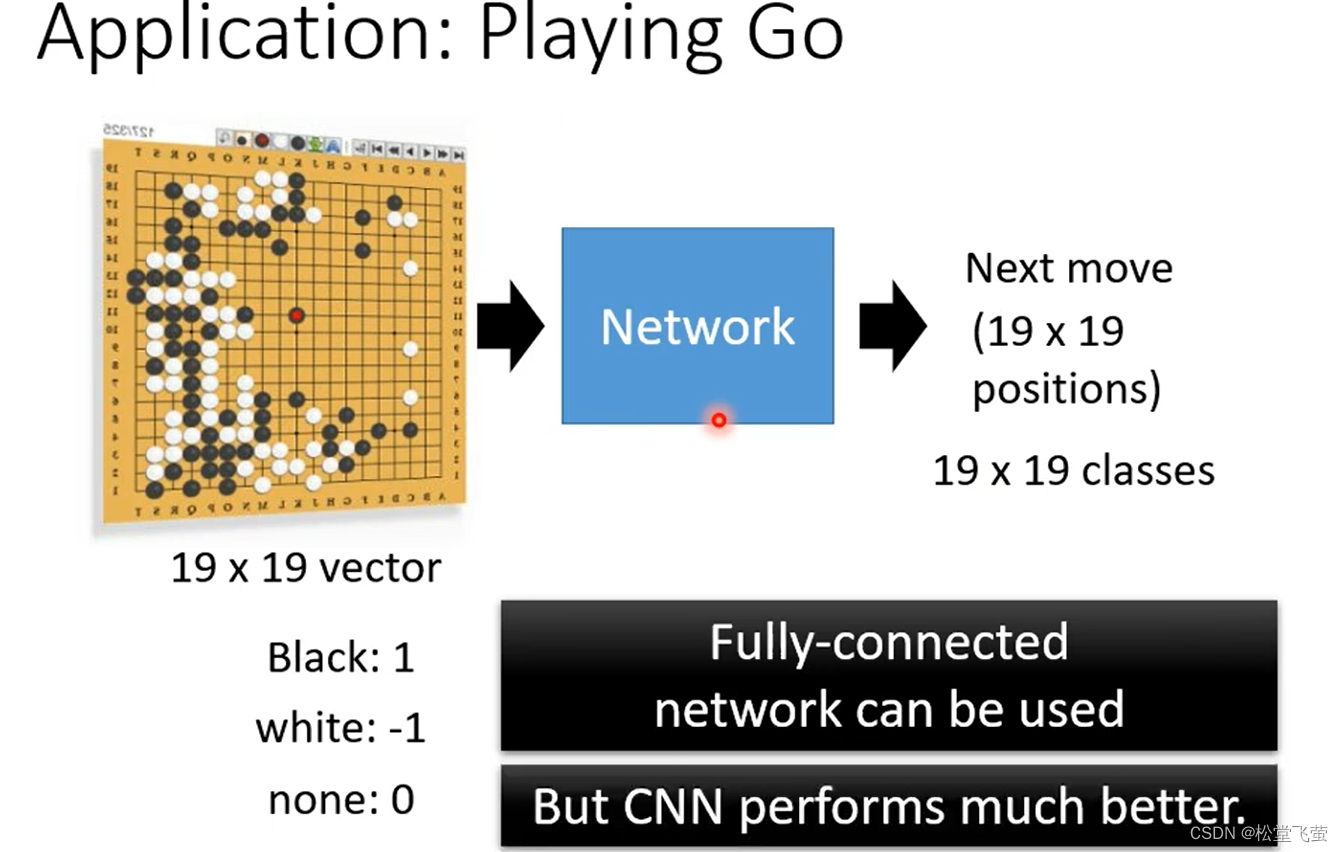
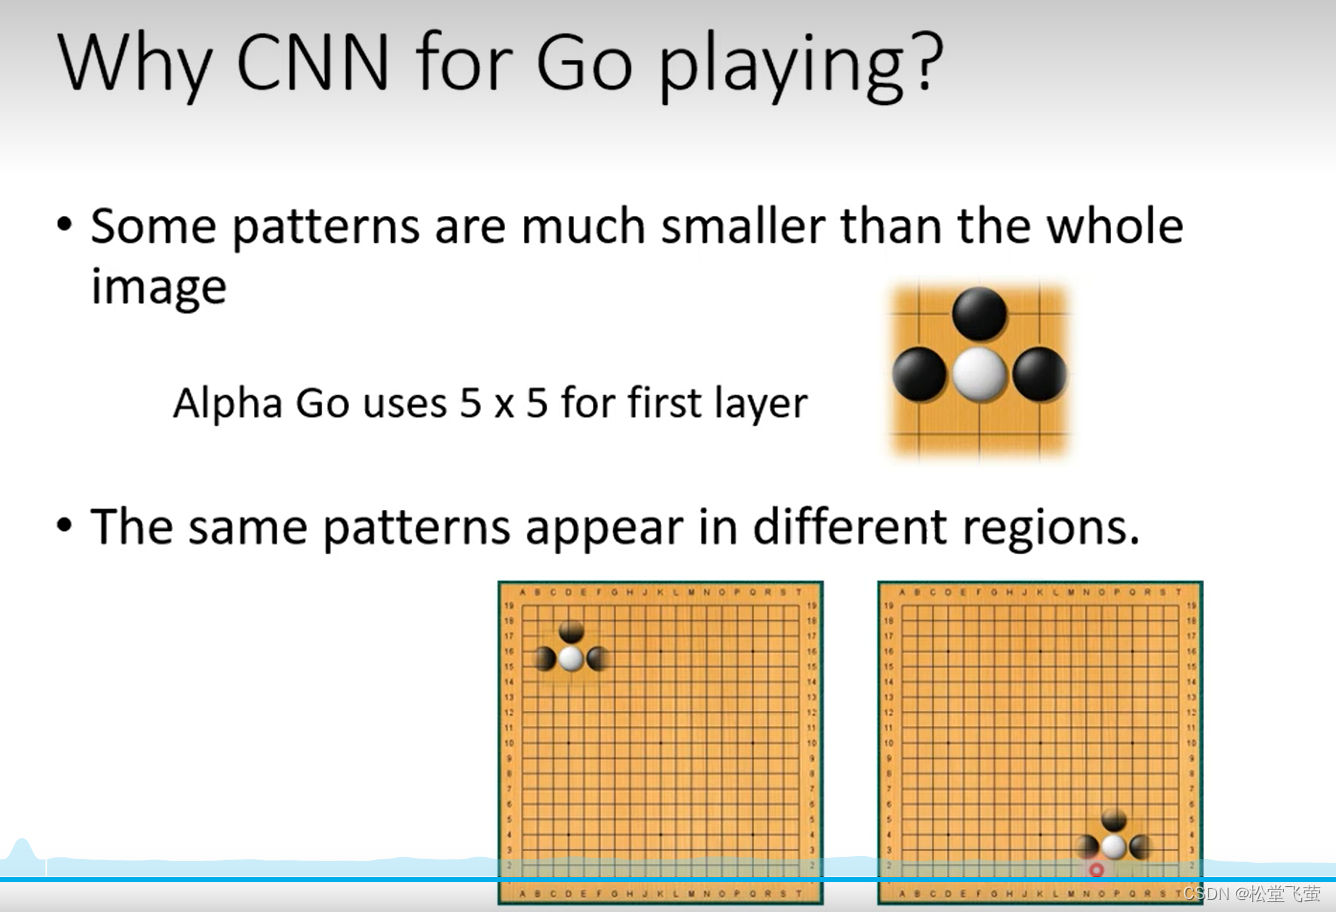
意味着围棋和影像有共同的特性
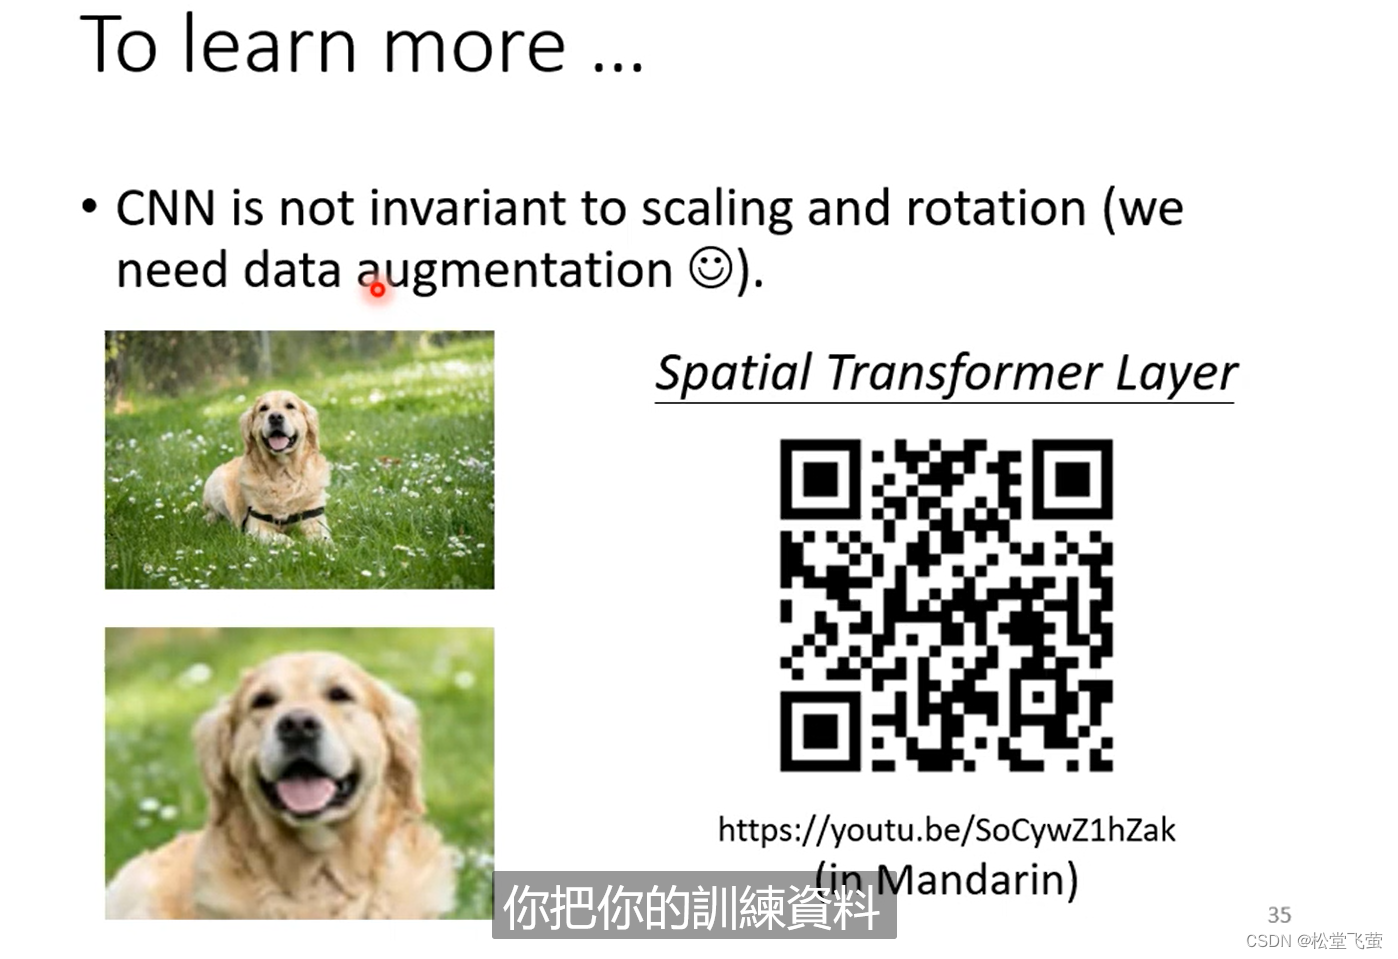
缺点
CNN不能处理影像放大缩小旋转的问题。
PS:pooling是对已经被filter处理过后的数据进行缩小化的,这里说的是原图片输入有缩小和放大
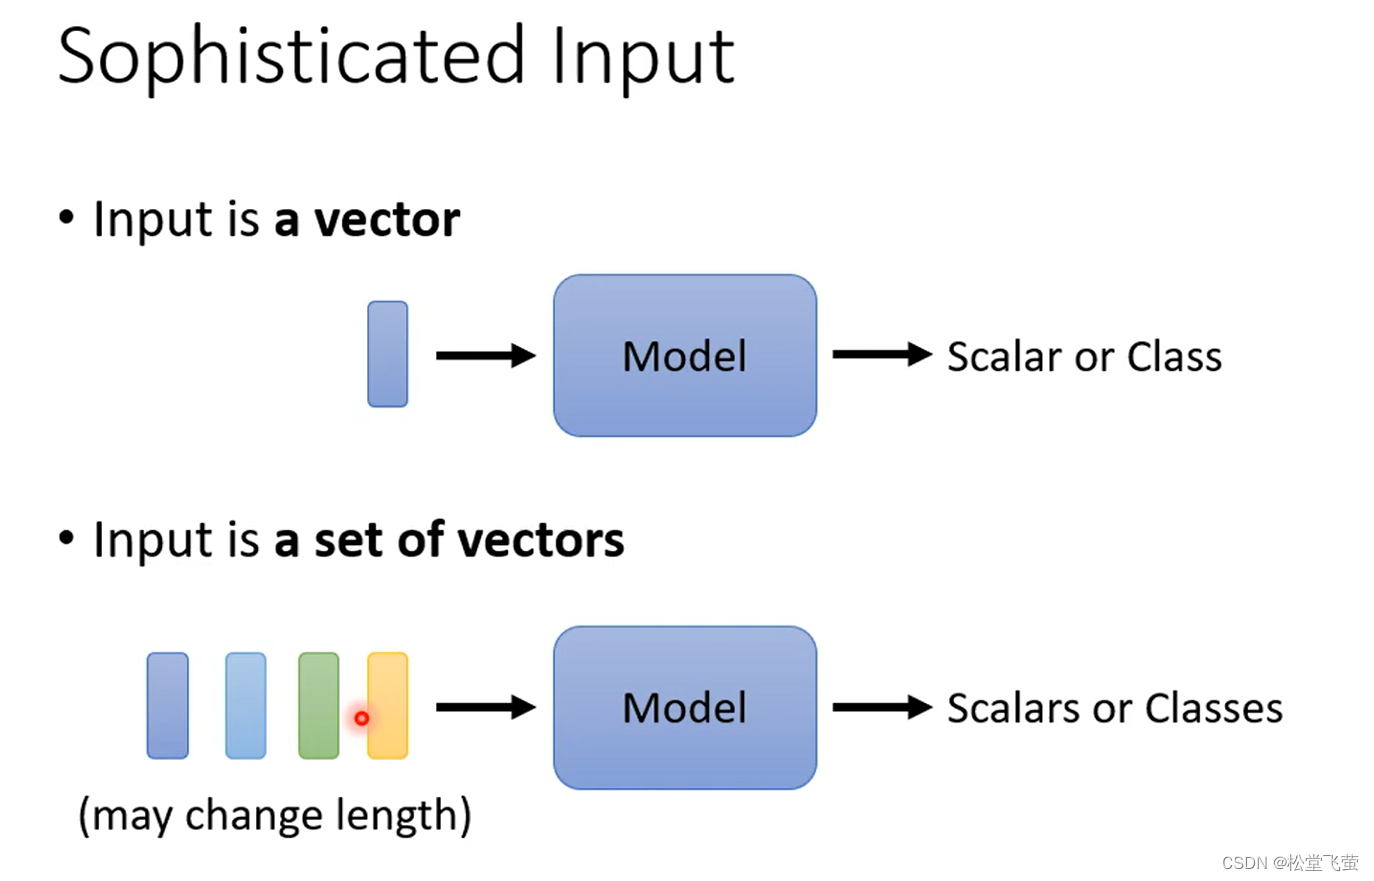
self-attention
一系列向量的输入
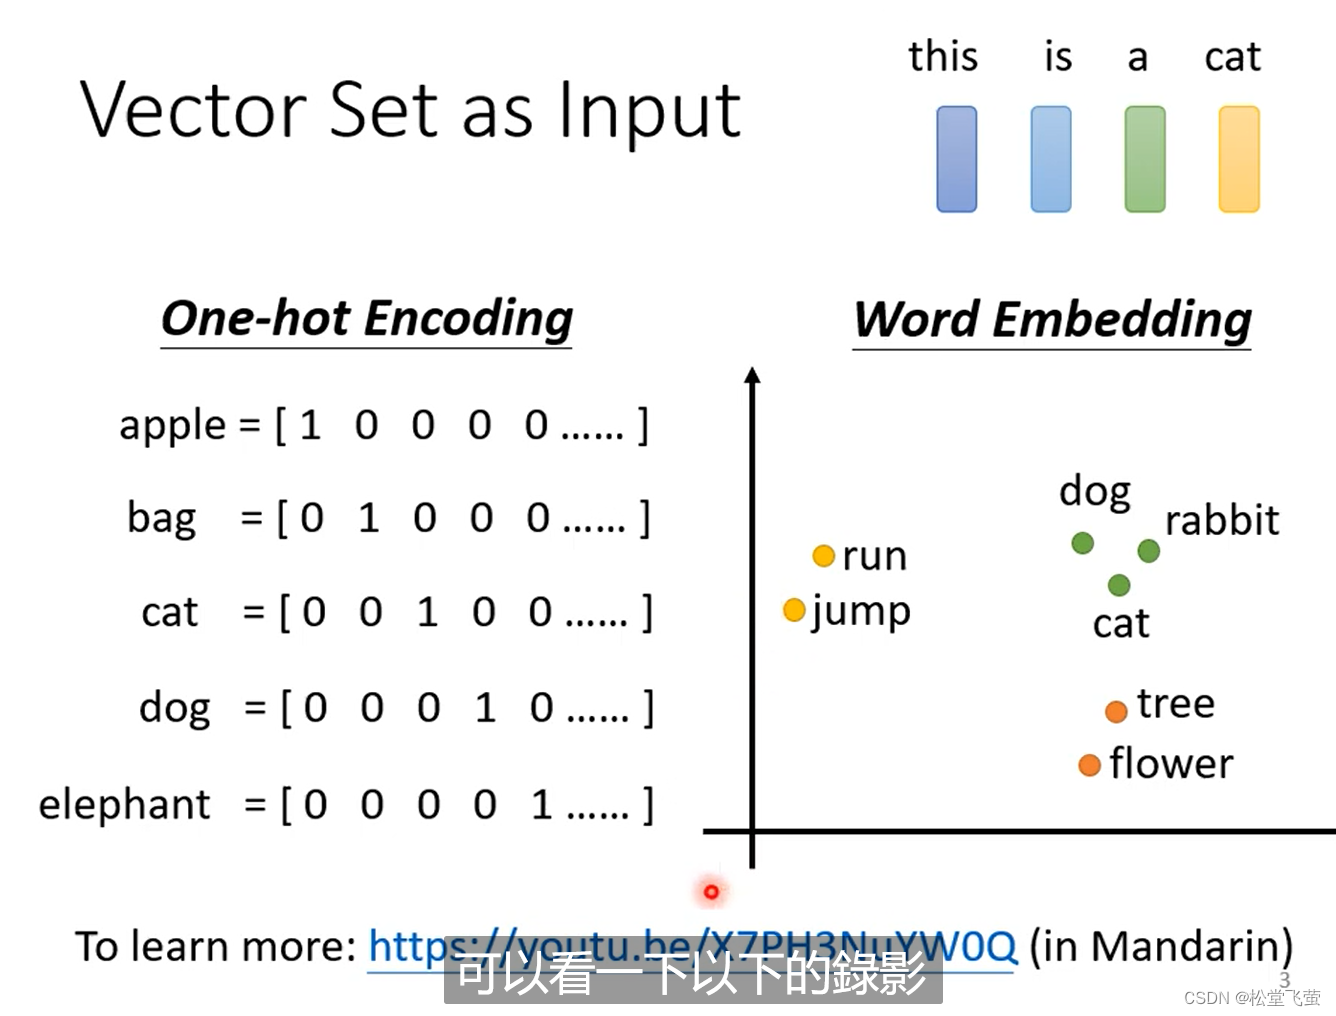
one-hot encoding和word embedding
one-hot encoding 比较难确定两个向量之间的关系
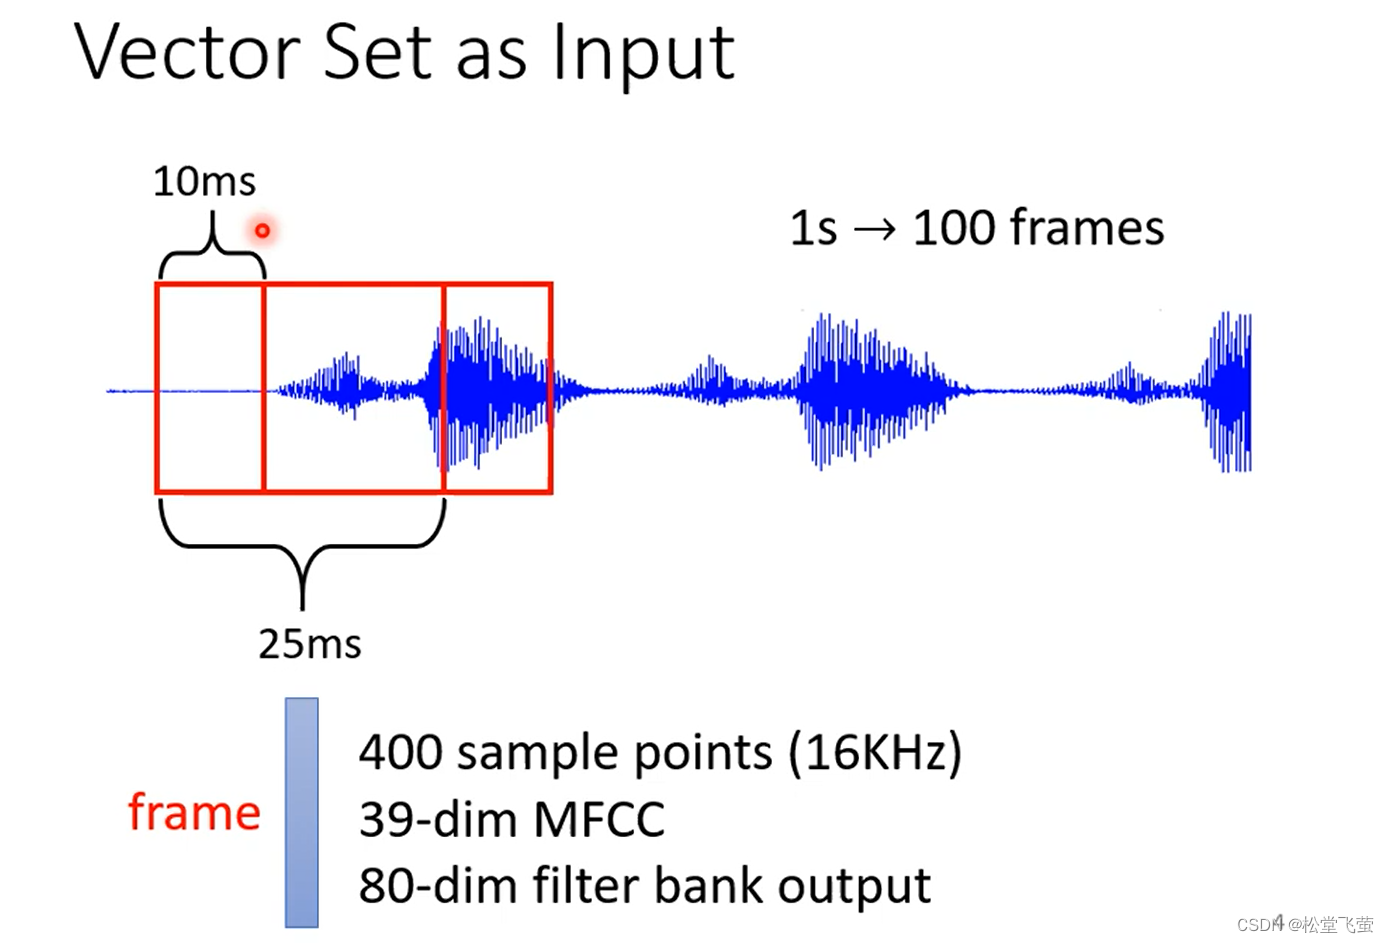
声音信号,每25ms看成一个向量(frame)
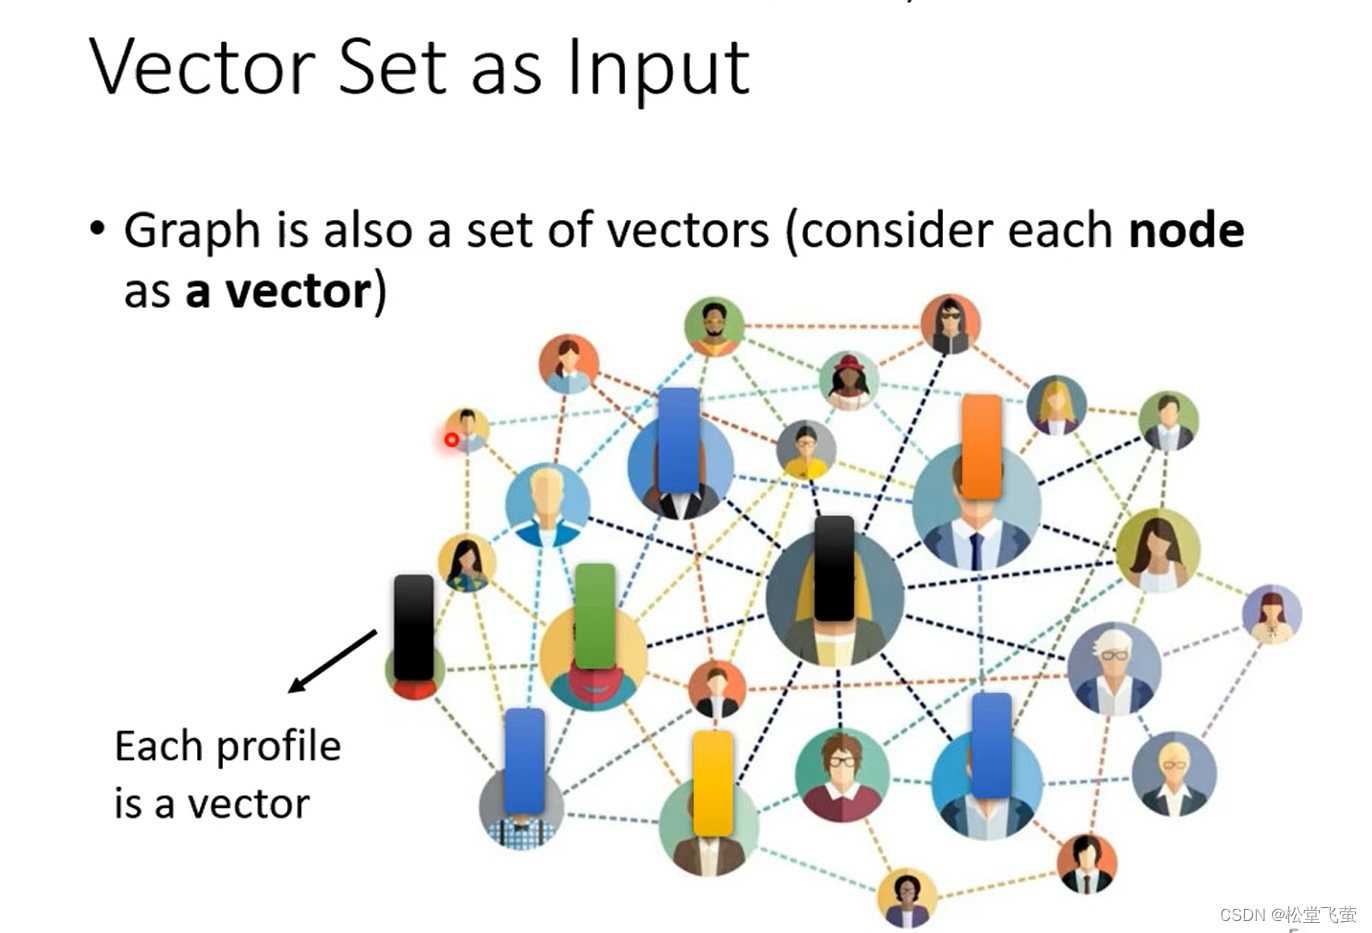
图、分子等
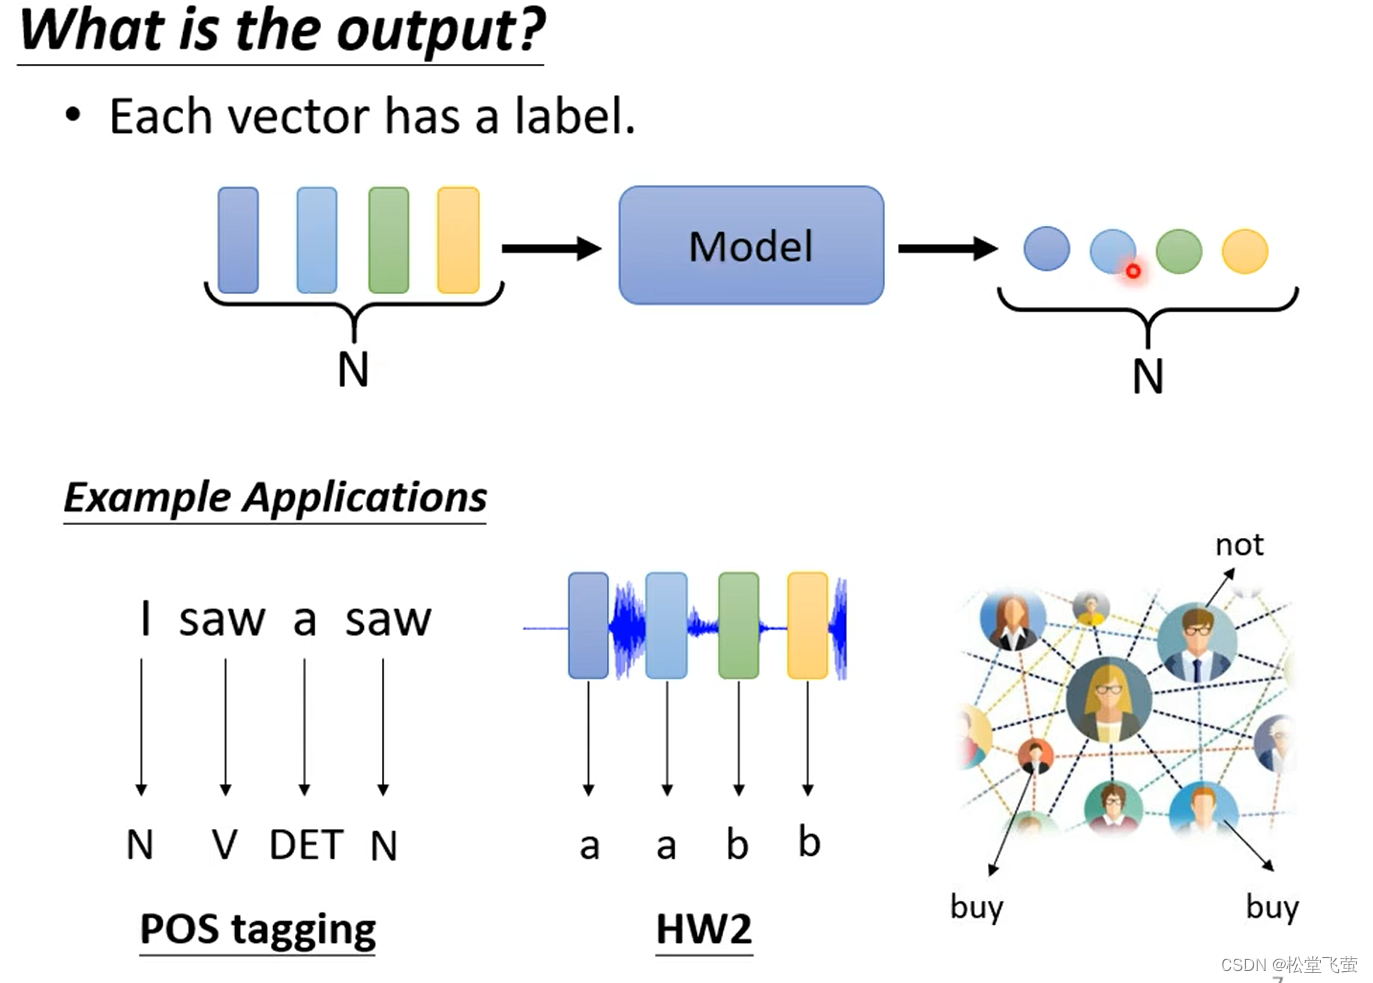
- 输入和输出长度相同的例子:
比如POS tagging(词性标注)等。
2 . 整个句子只需要一个输出
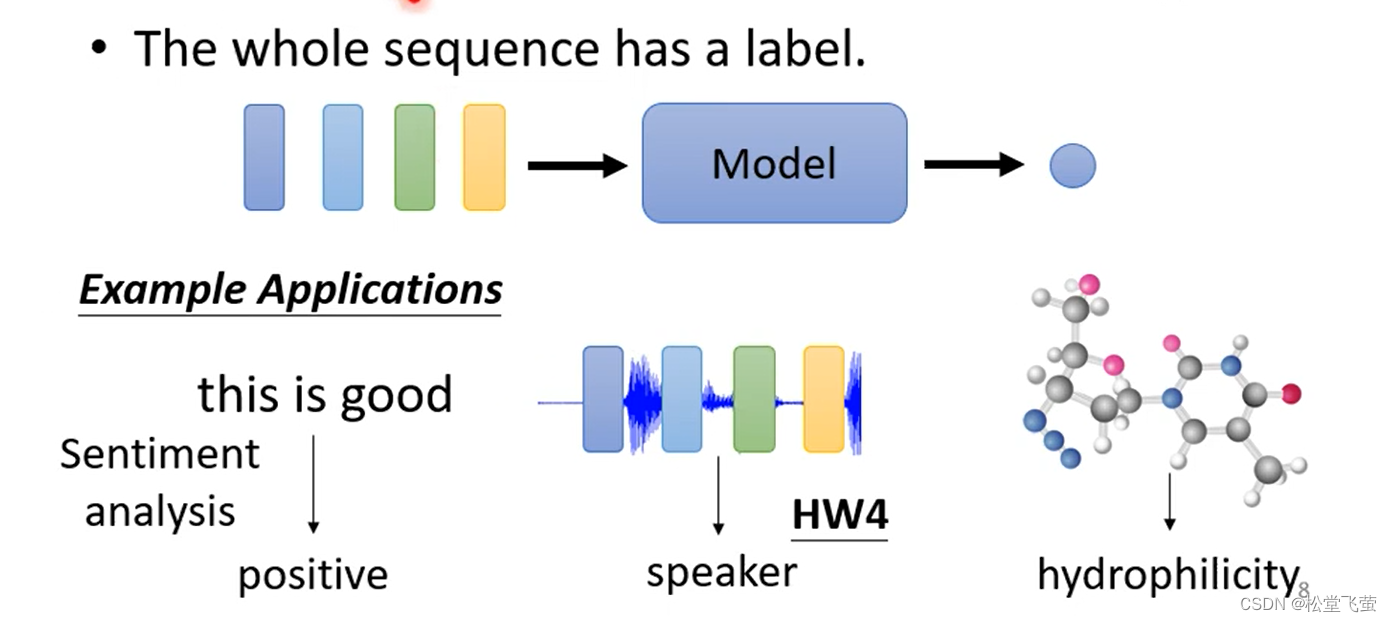
- 不知道输出多少,机器自己决定输出
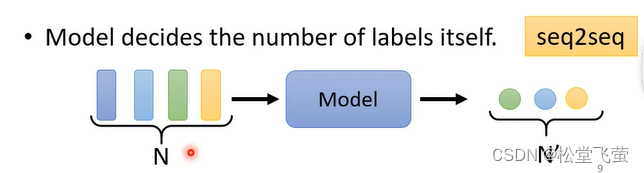
input = output(length)
先看第一种类型,input = output
不好看整个句子,因为句子长度不确定,而且太长。
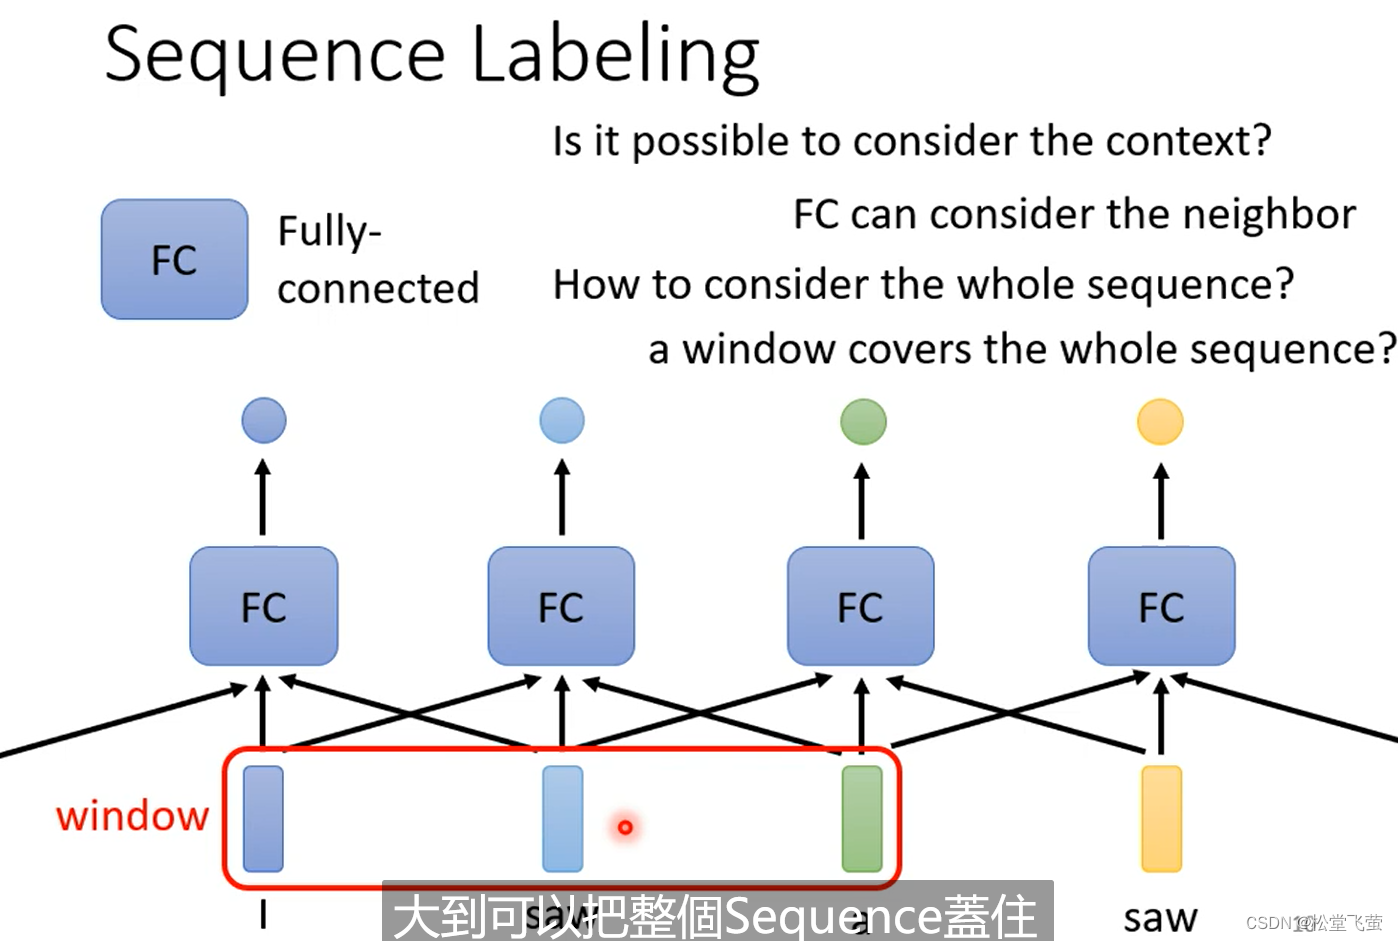
加一个self-attention的机制,它考虑整个sequence的咨询。
self- attention可以叠加多次,如下图,FC指 fully connected network。
self- attention处理整个句子的咨询,FC关注某一个位置的咨询。
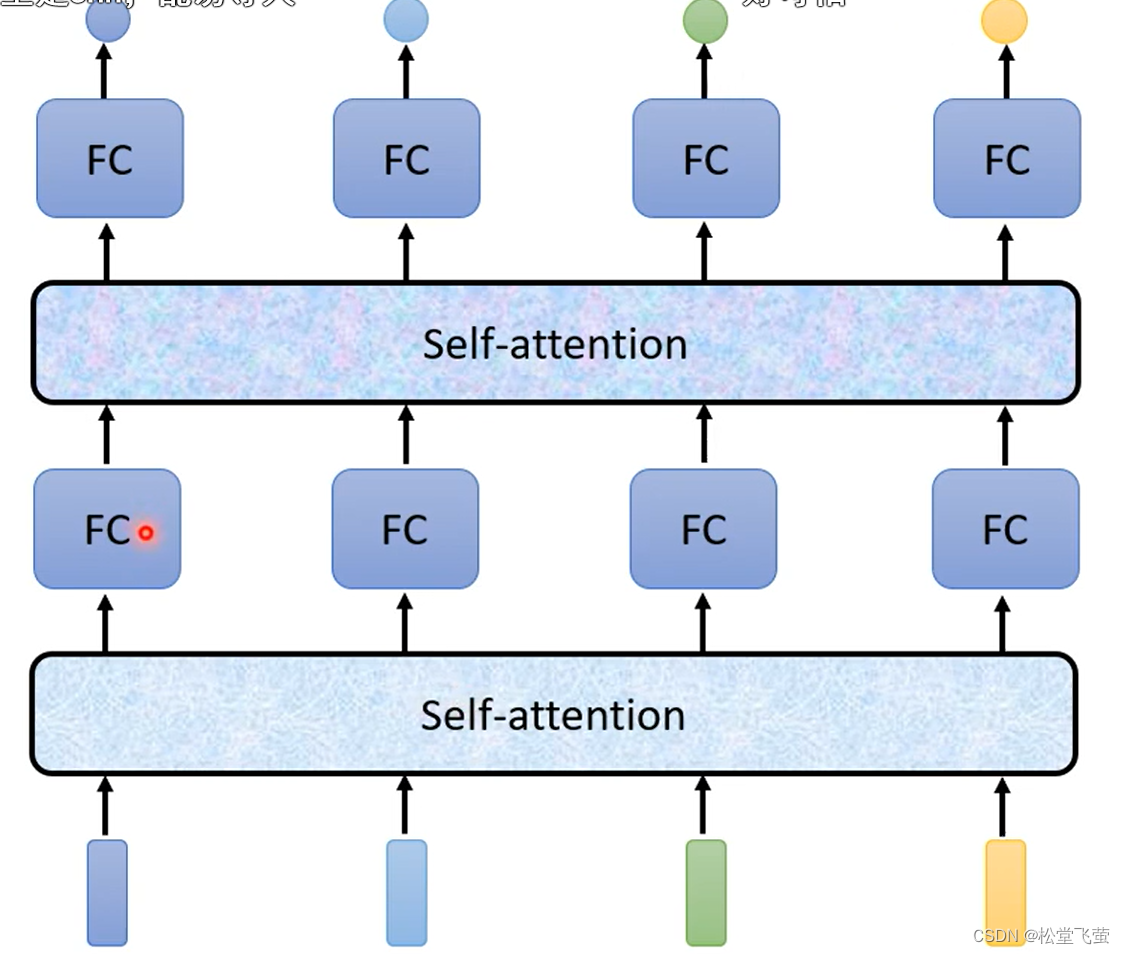
详细如下图,每一个都考虑所有输入的情况。
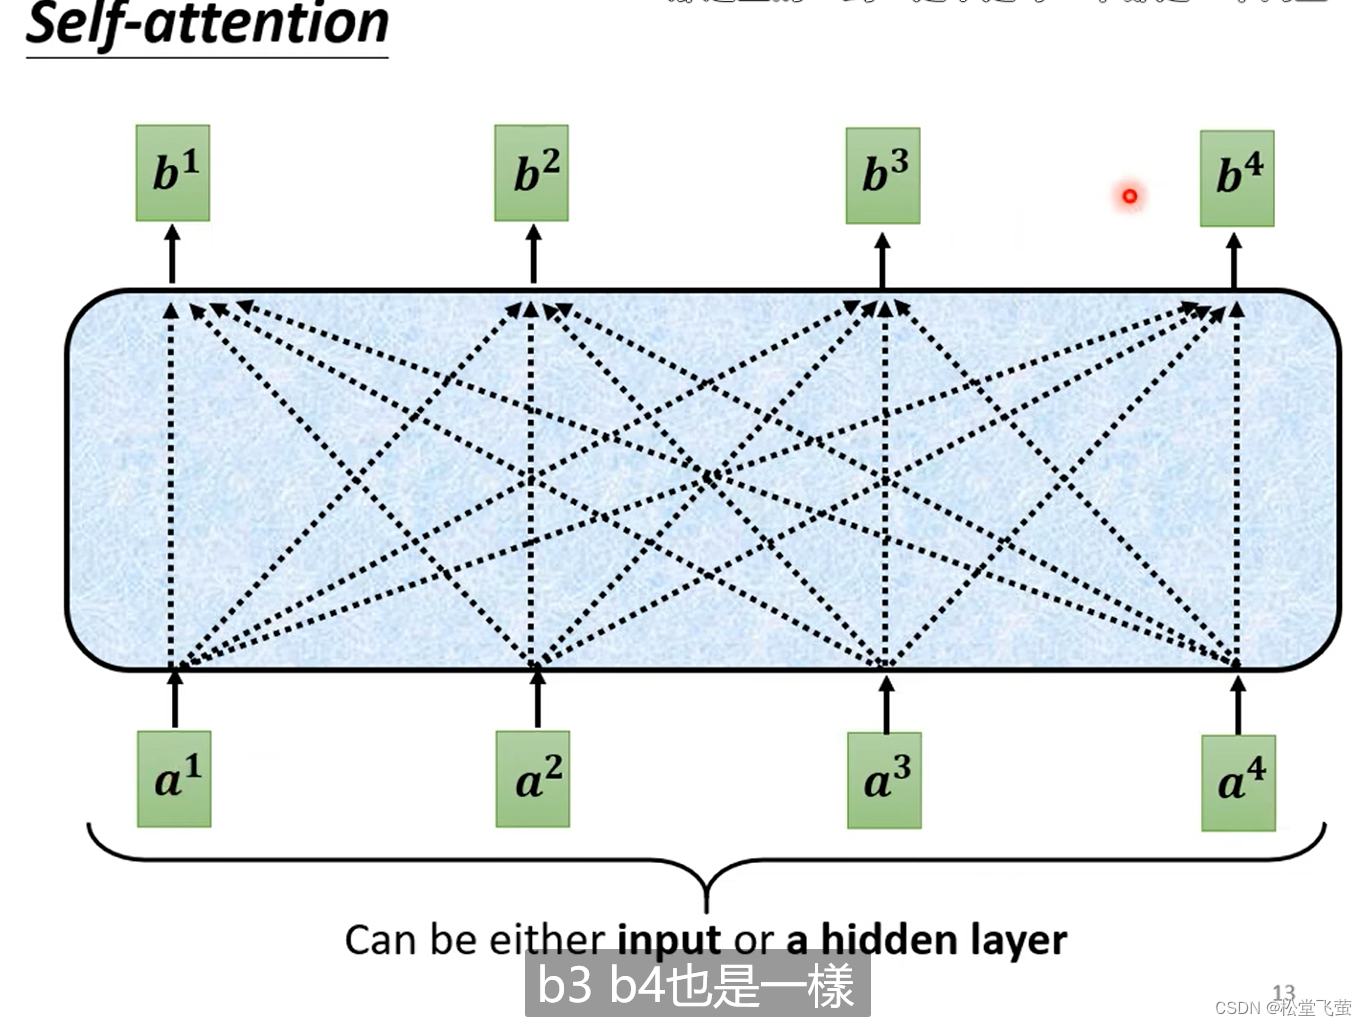
具体例子来说,需要根据a1找到句子中和a1相关的向量,即找到需要决定a1输出的class或者regression的数值 所需要的咨询。
用一个符号alpha来表示和a1的相关性。
https://blog.csdn.net/Zosse/article/details/124838923

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 59
 0
- 0


 已为社区贡献2条内容

所有评论(0)