[CV - Image Classification]图像分类之数据增强Mixup方法 - 超越经验风险最小化
大型深度神经网络(VGG、ResNet、DenseNet等网络)在计算机视觉成功应用中,这些神经网络有两个共同点:
首先,它们进行训练以将其训练数据的平均误差最小化,这种学习规则也被称为经验风险最小化,这些当前最先进的神经网络的大小与训练样本的数量呈线性关系。(比方说训练样本越多,可能达到的效果就更好,但往往训练样本多起来就会有过拟合的现象)
避免这种情况的做法就是弄一些防止过拟合的手段:
1)数据增强:平移、旋转、翻转等等
2)经验风险最小化:
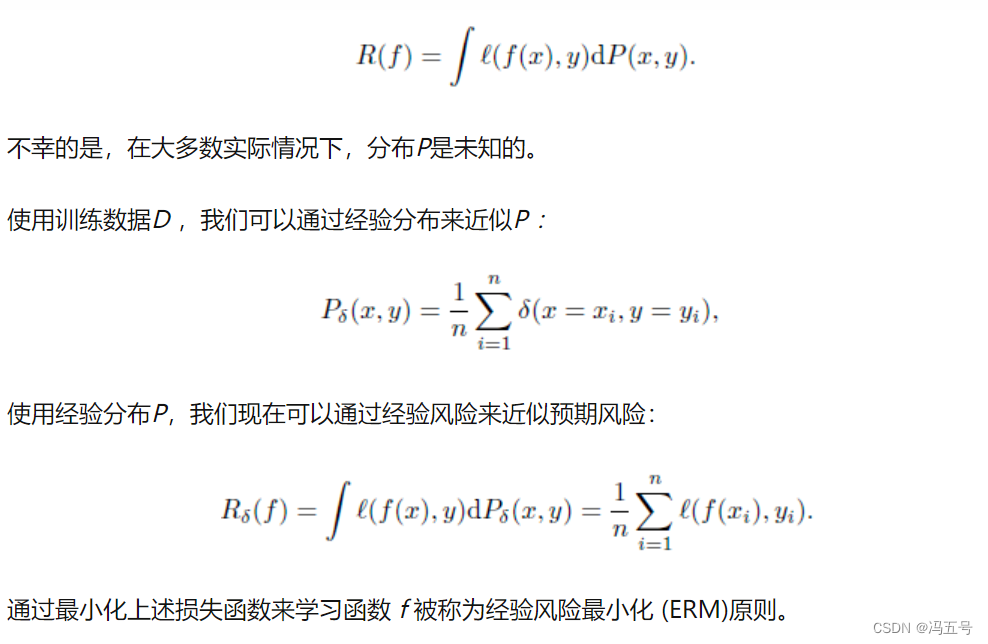
即使用已知的经验数据(训练样本)训练得到的学习器的误差或风险,也叫作“经验误差”或“训练误差”。相对的,在新样本(未知样本)上的误差称为“泛化误差,我们的要求就是把这泛华误差越小越好
目标就是找到f映射X与Y的关系,定义了一个损失函数与目标Y的差异,然后损失函数的平均值在数据分布P最小化:也就是预期风险:
3)领域风险最小化:
为了解决“泛化性”,我们可以通过一些传统的数据增强的方法:“加噪”,翻转,缩放等,但是这种做饭比较依赖特定的数据集和人类的先验知识
4)resnet和densenet模型
ResNet网络模型,提出了残差模块的跳接结构,网络学习残差映射 ( )− ,每1个残差模块里有2个相同输出通道的3××3卷积层,每个卷积层后接1个BN(Batch normalization)层和ReLU激活函数。跳接结构可以使数据更快地向前传播,保证网络沿着正确的方向深化,准确率可以不断提高。
DenseNet块的目标不仅仅是学习残差映射,而且是学习类似泰勒展开的更高阶的项。DenseNet的跳接结构没有用加法,而是用了联结。
当普通网络更深(层数增加)时,会出现梯度消失/爆炸的问题。
mixup究竟做了什么?
mixup混合邻近分布,可它令模型在处理样本和样本之间的区域时表现为线性。我们认为,这种线性建模减少了在预测训练样本以外的数据时的不适应性。从奥卡姆剃刀的原理出发,线性是一个很好的归纳偏见,因为它是最简单的可能的几种行为之一。
mixup的基本思想是将数据混合构建虚拟样本,如上图有两个数据点A、B,其中A是class 0,而B是class 1,Label对应就是一个one hot向量。mixup就是通过混合AB来构建虚拟数据点,同时标签也进行混合得到概率分布,这样就得到了新的样本。
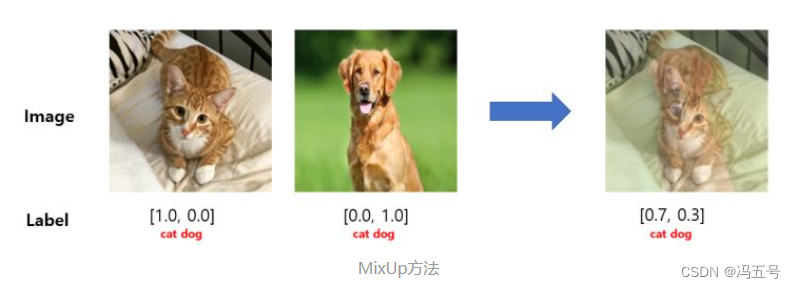 PS:相对于传统的DA,MIX有点类似于蒸馏的软标签化,这对于增量学习来说,这是妥妥能够连接新旧类的好方法啊!!

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 1
 0
- 0


 已为社区贡献1条内容

所有评论(0)