关于神经网络模型的简单了解
神经网络与机器学习的关系

M-P模型
概念:
M-P模型是一个简化的神经元模型,它模拟了生物神经元的基本工作原理。在这个模型中,神经元被视为一个阈值逻辑单元,它接收多个输入信号,通过一个加权和的过程产生一个输出。具体来说:
输入信号:每个神经元有多个输入,每个输入都有一个权重(weight)。
阈值:神经元有一个固定的阈值(threshold)。
模式:
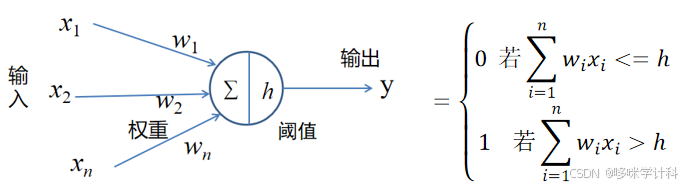
公式:
f 是STEP激活函数,其规则为: s大于阈值h,则输出y=1,否则输出y=0。 其中xi取值为0或1,wi和h根据情况自行设置(先设置再计算)。
补充:六种常见激活函数展示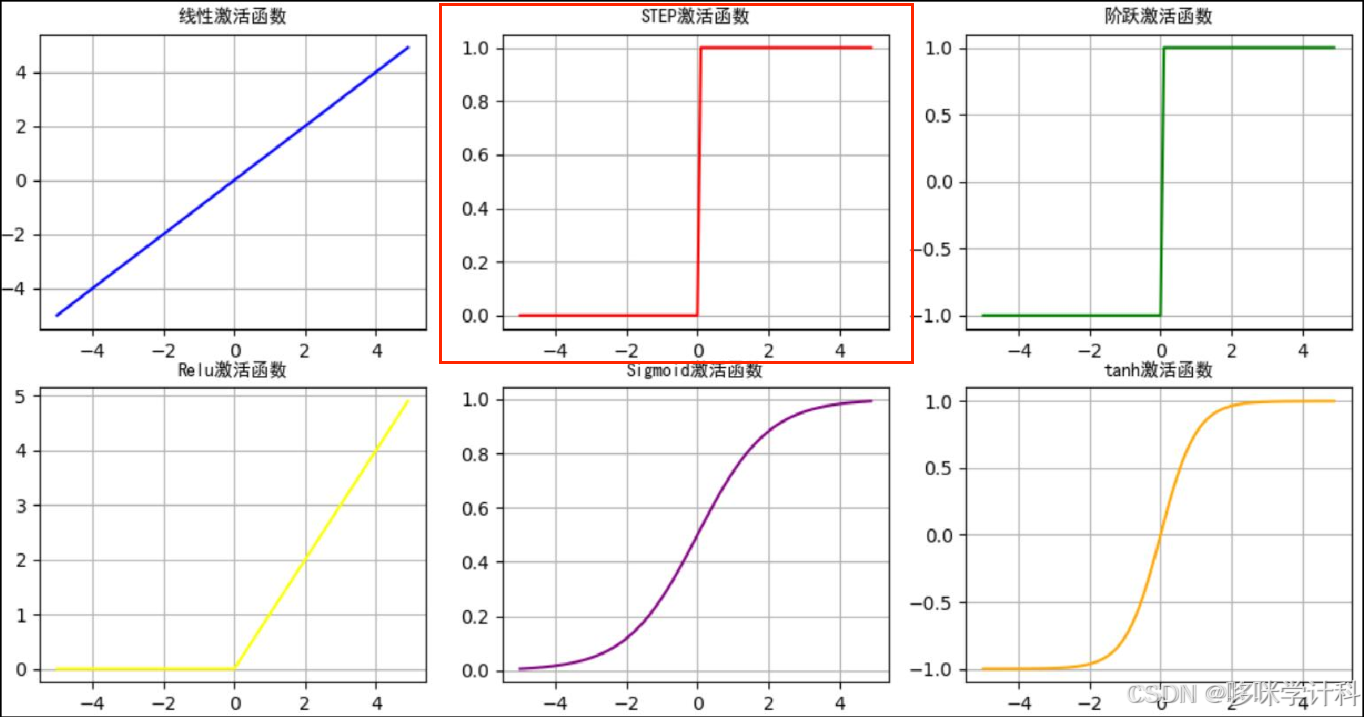
STEP激活函数python实现:
import numpy as np   # 导入NumPy库,一个强大的数值计算库
import matplotlib.pyplot as plt  # 导入matplotlib.pyplot,用于绘图

# 创建一个从-5到5,步长为0.1的数组
x = np.arange(-5, 5, 0.1)

#构建一个STEP激活函数
# 当x大于0时,fx2的值为1;否则为0
fx2 = np.where(x > 0, 1, 0)

# 使用matplotlib创建一个子图,subplot(232)表示在2行3列的布局中占据第2个位置
plt.subplot(232)

# 绘制x和fx2的曲线,使用红色'red'作为线条颜色
plt.plot(x, fx2, c='red')

# 添加网格线,使图表更容易读取和理解
plt.grid(True)

# 设置子图的标题为"STEP激活函数",使用'SimHei'字体来显示中文字符
plt.title("STEP激活函数", fontproperties='SimHei')
应用场景:
1. 基础逻辑运算:M-P模型可以用来实现基础的逻辑运算,如与,或,非。但无法实现异或。
1)拿“与”来举例:
当x1=0时,x2=0时,y=0; 代入f函数可得,0<h
当x1=0时,x2=1时,y=0; 代入f函数可得,

当x1=1时,x2=0时,y=0; 代入f函数可得,

当x1=1时,x2=1时,y=1。代入f函数可得,
若要满足上述结果,可取
,故可得
2)拿“异或”来举例:
当x1=0时,x2=0时,y=0; 代入f函数可得,0<h
当x1=0时,x2=1时,y=1; 代入f函数可得,

当x1=1时,x2=0时,y=1; 代入f函数可得,

当x1=1时,x2=1时,y=0;代入f函数可得,
无法同时满足以上结果,所以无法实现逻辑异或运算
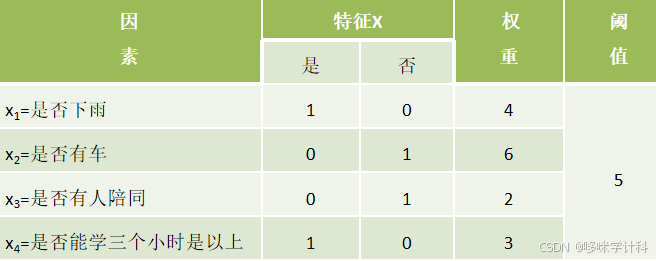
2. 对于多条件问题做出判断:如今天是否去学习
代入公式可得f=(1*4+0*6+0*2+1*3)-5=2>0,所以y=1,最终要去学习。
3. 神经网络基础:尽管M-P模型相对简单,但它为后来的神经网络模型(如感知机、多层神经网络等)奠定了基础。
需要注意的点:
1. 模型局限性:M-P模型过于简化,不能很好地模拟生物神经元的复杂行为,例如阈值并不是固定的,而是可以变化的。
2. 线性可分问题:M-P模型只能处理线性可分的问题,对于复杂非线性问题,它的性能有限。
3. 泛化能力:M-P模型缺乏泛化能力,即它无法很好地推广到未见过的数据上。
4. 学习机制:M-P模型没有明确的学习机制,因此它不能通过经验来调整权重,以改进其性能。
5. 现代应用限制:在现代神经网络和深度学习中,M-P模型的应用非常有限,因为它无法提供与现代网络(如卷积神经网络、循环神经网络等)相同级别的复杂性和性能。
感知器模型
概念:
感知器(perceptron)是二类分类的线性分类模型,其输入为实例的特征向量,输出为实例的类别。
模型:
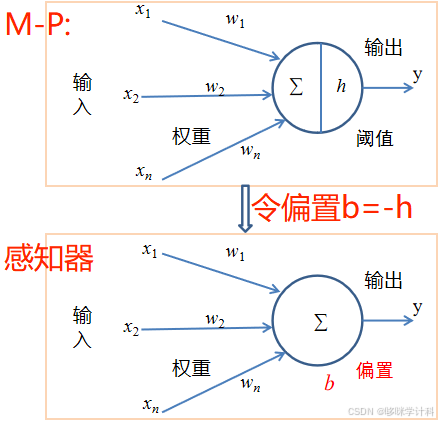
感知器模型和M-P模型的不同点在于:感知器模型的权重和偏置是要机器学习来的,而不是自行确定。
公式:
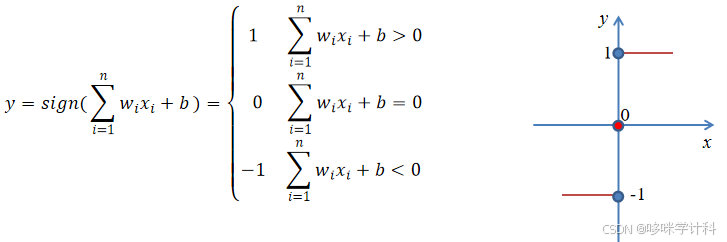
如果令
,则可得
那么感知器的几何解释就可为线性方程:W∙X=0
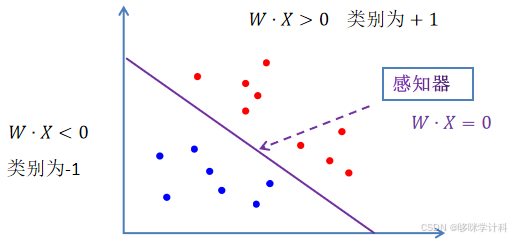
如何找到最佳权重和偏置:
1. 初始化
1)权重初始化:为每个输入特征分配一个小的随机权重,或者将所有权重初始化为零。
2)偏置初始化:为偏置分配一个小的随机值,或者将其初始化为零。
3)学习率:选择一个正数作为学习率,这个值通常很小,例如0.01或0.1,用来控制权重更新的幅度。2.学习过程
1)选取样本集:从训练集中随机选择一定数量的样本集。
2)计算预测类别Y=sign(W·X)
3)计算真实类别T与预测类别Y的误差E=T-Y3.权重和偏置更新(b=w0)
1)基于误差确定权重的变化2)更新权重W=W+∆W
4. 重复步骤1到4,直到T和Y相同结束。#注意
- 感知器算法只有在训练数据集线性可分的情况下才能保证收敛。
- 学习率的选择对模型的收敛速度和稳定性有重要影响。如果学习率太大,可能会导致权重更新过快而越过最佳点;如果学习率太小,则可能导致收敛速
代码实现
import numpy as np
#X的第一列要全部为1,因为我们这里设的x0=1,w0=b,设有两个实列特性
X=np.array([[1,3,3],
[1,3,4],
[1,4,4],
[1,1,1],
[1,2,1],
[1,2,2]])
#真实类别
T=np.array([[1],
[1],
[1],
[-1],
[-1],
[-1]])
# 1. 随机生成权重W=[[w0],[w1],[w2]]的初值
W=np.random.random([3,1]) #random([3,1]):随机生成表示三行一列
print("随机生成的W值为:",W)
eta=0.1 # 学习率,指的是权重更新的速度
for i in range(100):
# 2. 计算预测类别𝑌=𝑠𝑖𝑔𝑛(𝑊·𝑋)
Y=np.sign(np.dot(X,W))
# 3. 计算真实类别与预测类别的误差E=T-Y
E=T-Y
# 4. 基于误差确定权重的变化∆𝑊=·E·𝑋
delta_W=eta*(np.dot(X.T,E))
# 5. 更新权重𝑊=𝑊+∆𝑊
W=delta_W+W
Y=np.sign(np.dot(X,W))
#6. 重复第2-5步,直到T和Y相同结束
if(Y==T).all():
break应用:
1.用于根据实例特征划分实例类别
2.实现基础逻辑运算
自适应线性模型
概念:自适应线性模型是感知器的一种更高级的形式。常用于处理回归和分类的问题,感知器只能进行二分法,而自适应可以进行多类别分类。
模型:

梯度下降法
概念:
1)梯度下降法是一种优化算法。在机器学习中,这个函数通常是损失函数,它量化了模型的预测值与真实值之间的差异。
2)梯度,指的是损失函数在当前参数下的斜率或导数,指向函数增长最快的方向。
3)梯度下降法的目标就是找到一组参数,使得损失函数的值达到最小。
公式:
一次函数:
二次函数:
1)
指向函数值减少最快的方向
2)
可以将函数值向函数值减少最快的方向移动一段距离
3)学习率η用来控制移动的速度
BP模型:
概念:
BP神经网络是一种利用反向传播算法训练的多层前馈神经网络。它通过最小化损失函数来调整网络的权重和偏置,以实现对给定数据的最佳拟合。
模型:
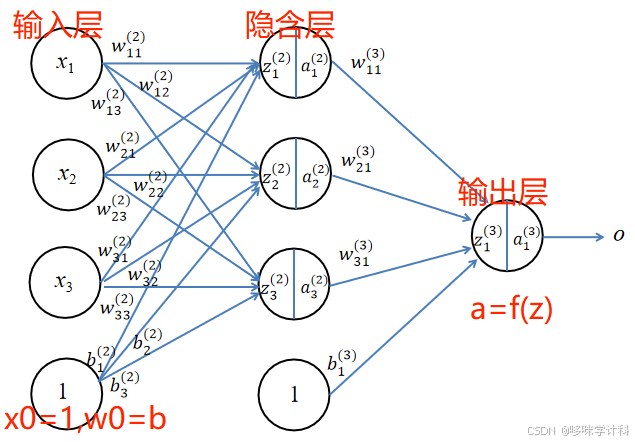
n表示第几层;b:表示偏置;w表示权重;z表示神经元的值;a表示神经元的激活值;f()表示激活函数
BP模型的算法流程为:
1)先计算每一层的状态和激活值,直到最后一层(即信号是前向传播的);
2)再反向计算每一层的误差,误差的计算过程是从最后一层向前推进的(这就是反向传播BP名字的由来);
3)更新参数(目标是误差变小)。迭代前面两个步骤,直到满足停止条件。
数学推导:
1.信息前向传播:
(从第一层开始往后算)
2.计算真实结果y和预测结果0的差别:(仅与权重矩阵和偏置有关)
代价函数:
3.反向推理:
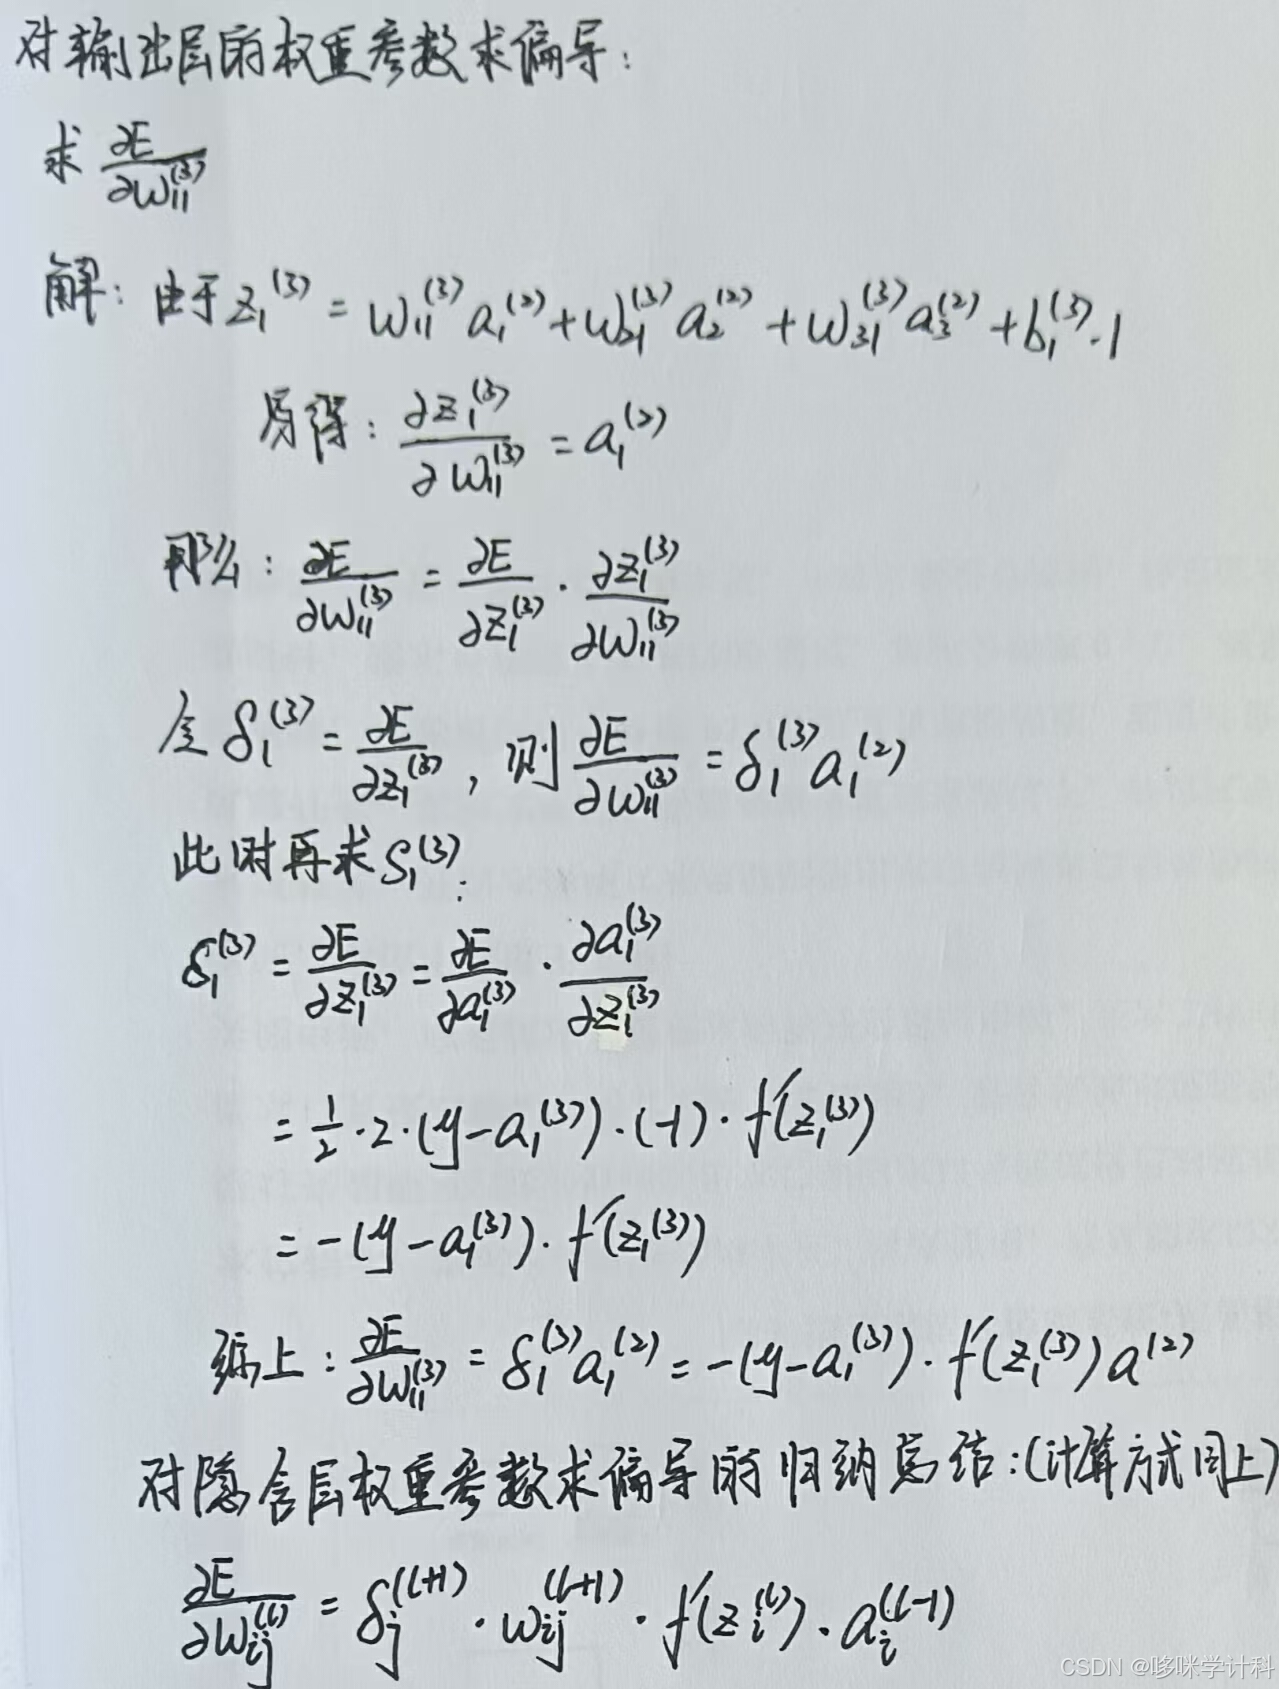
应用:
1 图像识别: BP神经网络广泛用于图像识别任务,尤其是在复杂的图像处理中。
- 例子: 面部识别系统,BP神经网络能够从图像中识别出不同的面部特征。2. 语音识别:BP神经网络在处理音频信号和语音模式识别中也非常有效。
-例子: 语音助手中的语音识别模块,将用户的语音转化为文本。3. 自然语言处理:在NLP领域,BP神经网络用于处理和生成语言。
-例子: 机器翻译系统,BP神经网络可以用于理解和生成不同语言之间的翻译。
代码展示:
import numpy as np
import random

#生成区间[a,b]内的随机数
def random_number(a,b):
    return (b-a)*random.random()+a
# 创建m行n列的初始化矩阵
def makematrix(m,n,fill=0.0):
    a=[]
    for i in range(m): # 对于每一行
        a.append([fill]*n) # 将0.0复制n次
    return a
# S型函数的公式: f(x) = 1 / (1 + e^(-x))
def sigmoid(x):
    return 1 / (1 + np.exp(-x))
# S型函数f(x)的导数: f'(x) = f(x) * (1 - f(x))
def derived_sigmoid(x):
    fx = sigmoid(x)
    return fx * (1 - fx)

# 构造三层BP神经网络
class BPNN:
    def __init__(self,num_in,num_hidden,num_out): # BPNN(3,3,1)
        # 设置输入层、隐含层、输出层的节点个数
        self.num_in=num_in +1 # 在输入层增加一个偏置节点
        self.num_hidden=num_hidden+1  # 在隐含层增加一个偏置节点
        self.num_out=num_out # 输出层没有偏置节点不增加

        #初始化输入层、隐含层、输出层的节点,均为1
        self.active_in=[1.0]*self.num_in  # [1.0, 1.0, 1.0]
        self.active_hidden=[1.0]*self.num_hidden
        self.active_out=[1.0]*self.num_out

        # 创建权重矩阵
        self.weight_in=makematrix(self.num_in,self.num_hidden)#4*4矩阵,对应的是输入层到隐含层的16个权重(包括4个偏置)
        self.weight_out=makematrix(self.num_hidden,self.num_out)#4*1矩阵,对应的是隐含层到输出层的4个权重(包括1个偏置)

        # 初始化权重矩阵,两个4*4矩阵,矩阵里每个元素都是-0.2至0.2之间的随机数
        for i in range(self.num_in):
            for j in range(self.num_hidden):
                self.weight_in[i][j]=random_number(-0.2,0.2)
        for i in range(self.num_hidden):
            for j in range(self.num_out):
                self.weight_out[i][j]=random_number(-0.2,0.2)

    # 信号正向传播
    def forwardpropagate(self,inputs):
        # 处理输入层数据
        for i in range(self.num_in-1): # num_in=4,包括了一个偏置,所以减去偏置
            self.active_in[i]=inputs[i] # active_in是输入数据的矩阵,a1^(1)
        # 处理隐含层数据
        for i in range(self.num_hidden-1): # num_hidden=4,也包括了一个偏置,减去偏置
            # i=0、1、2,分别对应z1^(2),z2^(2),z3^(2)
            sum=0.0
            for j in range(self.num_in):
                # 计算隐含层神经元的状态
                # z1^(2)=w11^(2)*x1+w21^(2)*x2+w31^(2)*x3+b1^(2)*1
                sum=sum+self.weight_in[j][i]*self.active_in[i]
            # 计算隐含层神经元的激活值
            # a1^2=f(z1^(2))
            self.active_hidden[i]=sigmoid(sum)

        # 处理输出层数据
        for i in range(self.num_out):
            sum=0.0
            for j in range(self.num_hidden):
                # 计算输出层神经元的状态
                # z1^(3)=w11^(3)*a1+w21^(3)*a2+w31^(3)*a3+b1^(3)*1
                sum=sum+self.weight_out[j][i]*self.active_hidden[j]
            # 计算输出层神经元的激活值  a1^3=f(z1^(3))
            self.active_out[i]=sigmoid(sum)
        return self.active_out[:] # 输出a1^(3)

    # 误差反向传播
    def errorbackpropagate(self,targets,lr):
        # 计算输出层的误差
        out_deltas=[0.0]*self.num_out
        for i in range(self.num_out):
            error=targets[i]-self.active_out[i] # 真实类别-输出类别
            # i=0时,error=y1-a1^(3)
            out_deltas[i]=-1*error*derived_sigmoid(self.active_out[i])
            # δ1^(3)=-(y1-a1^(3))f'(z1^(3)) ,对应课件第11页

        # 计算隐含层的误差
        hidden_deltas=[0.0]*self.num_hidden
        for i in range(self.num_hidden): # i是隐含层(上标为2)的下标i=1,2,3,4,
            error=0.0
            for j in range(self.num_out): # j是输出层(上标为3)的下标
                error=out_deltas[j]*self.weight_out[i][j] # δ_j^(l+1)*w_ij^(l+1)
            hidden_deltas[i]=error*derived_sigmoid(self.active_hidden[i])
            #δi^(l) =  δ_j^(l + 1)*w_ij^(l+1))∙f'(z_i^(l)),对应课件第14页

        # 首先更新输出层权值
        for i in range(self.num_hidden):
            for j in range(self.num_out):
                change = out_deltas[j] * self.active_hidden[i] # 对应课件第10页右边公式
                self.weight_out[i][j] = self.weight_out[i][j] - lr * change

        # 然后更新输入层权值
        for i in range(self.num_in):
            for i in range(self.num_hidden):
                change = hidden_deltas[j] * self.active_in[i]
                self.weight_in[i][j] = self.weight_in[i][j] - lr * change

        # 计算总误差
        error = 0.0
        for i in range(len(targets)):
            error = error + 0.5 * (targets[i] - self.active_out[i])**2
            # E=1/2(y1-a1^(3))^2  # 课件第8页
        return error

# 训练已知数据
    def train(self,data,itera=50000,lr=0.1):
        for i in range(itera): # 对于每一次迭代
            error = 0.0
            for j in data: # 依次取出来数据集的每一行
                inputs=j[0] # 每一行的第一个元素就是输入x1,x2,x3
                self.forwardpropagate(inputs) # 执行信息正向传播过程
                targets = j[1]
                error = error + self.errorbackpropagate(targets, lr)
            if i % 100 == 0:
                print("第",i,"次迭代,误差:",error)

    def printTrainingProcess(self, data):
        for i in data:
            print(i[0], '->', self.forwardpropagate(i[0]))

#计算最终隐含层和输出层的权重
    def weights(self):
        print("隐含层权重")
        for i in range(self.num_in):
            print(self.weight_in[i])
        print("输出层权重")
        for i in range(self.num_hidden):
            print(self.weight_out[i])

# 预测未知数据
    def predit(self, preditdata):
        for line in preditdata:
            output=self.forwardpropagate(line)
            result=output[0]
            print("result=",result)
            if result>0.5:
                print(line, '->', '预测结果为1')
            elif result<0.5:
                print(line, '->', '预测结果为0')
            else:
                print("无法判断")
Elman模型
概念:
Elman神经网络是一种动态递归神经网络,它特别适用于处理动态系统或时序数据的预测。
模型:
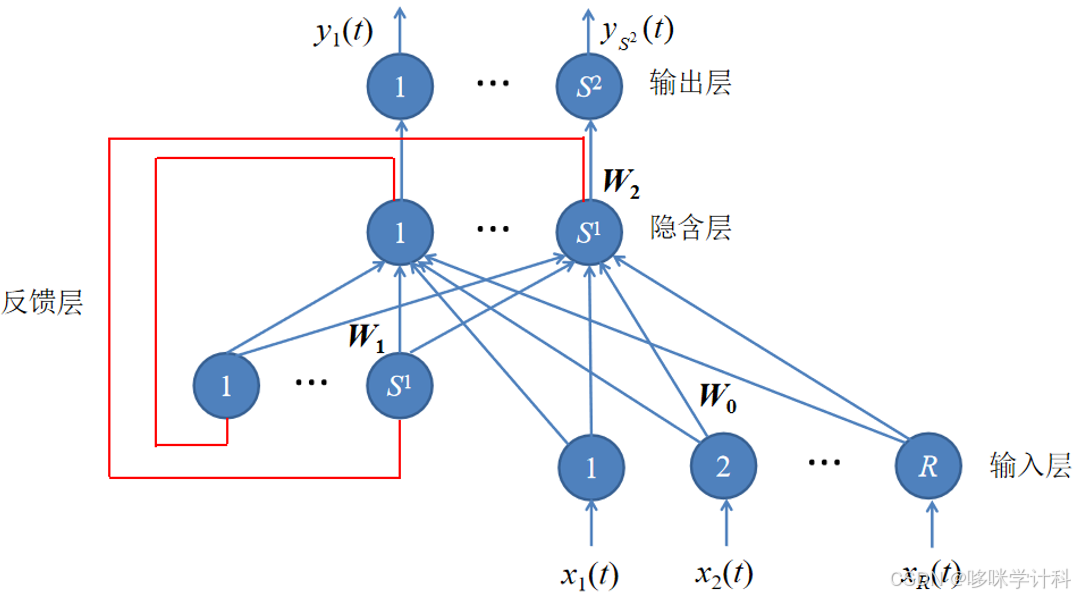
输入层:接收外部输入数据。
隐含层:通常包含一个或多个隐藏层,可以采用线性或非线性激活函数。
隐含层(或称为承接层、状态层):用于存储和反馈隐含层前一时刻的输出,起到记忆的作用。
输出层:根据网络的预测任务,输出所需的预测值或分类结果。
算法原理:
初始化:随机初始化网络的权值和阈值。
前向传播:输入样本通过输入层传播到隐含层,隐含层的输出一方面传递到输出层产生预测结果,另一方面反馈到承接层存储。
误差计算:计算网络输出与实际值之间的误差。
权重调整:通过反向传播算法,根据误差信号调整隐含层到输出层的权重,以及隐含层内部的权重。
相关代码和工作原理请看这位up主:Elman 神经网络算法详解_elman神经网络-CSDN博客
径向基神经网络:
概念:
径向基神经网络(Radial Basis Function Networks,RBFN)是一种前馈神经网络,它使用径向基函数作为隐层的激活函数。径向基函数对输入向量与该隐层中心之间的欧几里得距离非线性的函数,通常选择高斯函数作为隐层的径向基函数
模型: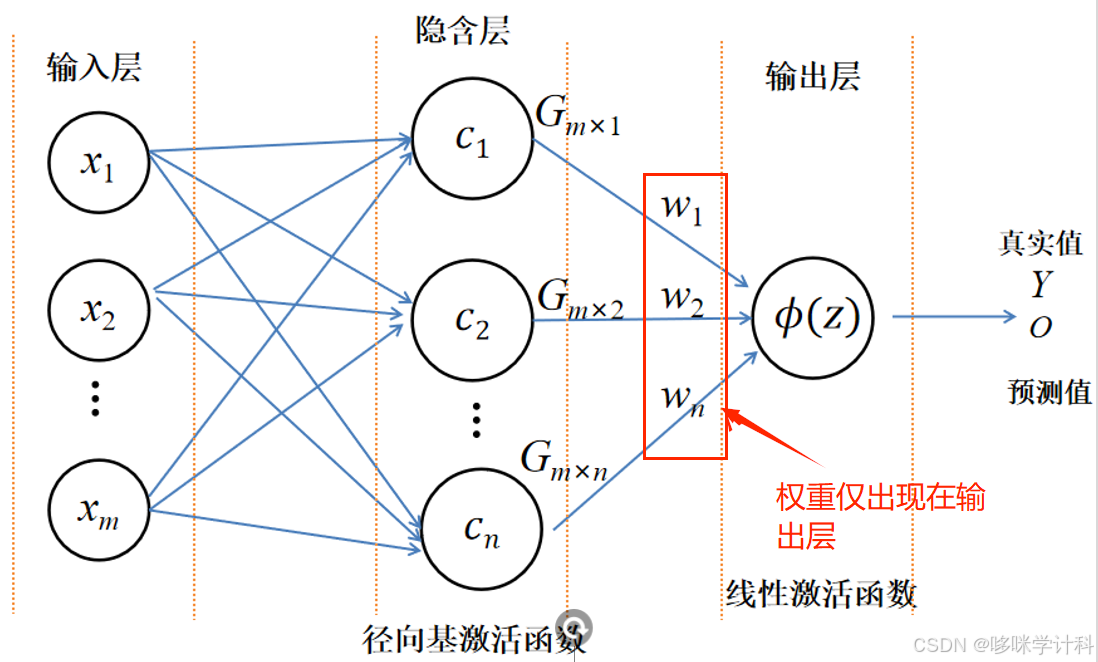
1.输入层:接收输入向量。
2.隐含层:每个隐层都有一个中心,输入向量与中心之间的距离决定了隐层激活的程度。
3.输出层:输出层神经元的激活是隐层激活的线性组合。4.径向基函数
径向基函数的形式如下(最常用的径向基函数是高斯函数):
其中x是输入数据, c是中心点, γ是控制函数宽度的参数,
是输入向量与隐层中心之间的欧几里得距离的平方。
5.算法学习:
1)选择隐层中心:中心的选择可以基于数据聚类的方法,例如k-means聚类。
2)宽度参数:宽度参数可以通过交叉验证来选择,也可以使用经验公式。
3)权重学习:权重连接输入层和隐层以及隐层和输出层的权重通常使用最小二乘法或其他优化算法学习。
应用:
1. 非线性函数逼近:当需要逼近一个非线性函数时,RBFN可以提供非常好的效果。
- 例子:在工程和物理学中,模拟复杂系统的动态行为时,RBFN可以用来逼近系统的不确定性或未知的动力学。2. 分类问题:RBFN特别适合于分类问题,尤其是当类别边界是圆形或椭圆形时。
- 例子:在医学诊断中,RBFN可以用来对病人的生物标记数据进行分类,从而预测疾病风险。3. 时间序列预测:RBFN在时间序列预测中也很有效,尤其是在短期预测中。
- 例子:股票市场预测,使用RBFN来预测短期内股票价格的涨跌。
代码展示:
import numpy as np
import neurolab as nl
import matplotlib.pyplot as plt

# 生成数据
input_data = np.random.uniform(-5, 5, (100, 1))
target_data = np.sin(input_data) + 0.1 * np.random.randn(100, 1)

# 创建RBFN网络
net = nl.net.newrb(input_data, target_data, [10], [0, 1])

# 训练网络
net.train(input_data, target_data, epochs=100, show=10)

# 生成预测数据
test_data = np.linspace(-5, 5, 100)
test_data = test_data.reshape(100, 1)
output_data = net.sim(test_data)

# 绘制结果
plt.plot(input_data, target_data, 'ro', label='Target data')
plt.plot(test_data, output_data, 'b-', label='Network output')
plt.legend()
plt.show()
卷积神经网络(深度学习中专门处理图像和视频的子类)
深度学习:是机器学习(Machine Learning,ML)的一个子领域,深度学习则通过增加隐藏层的数量来提高模型的表示能力和学习能力。这些深层网络能够学习更加复杂的数据特征,从而在图像识别、自然语言处理等领域取得了显著的成果。
神经网络:模仿人脑神经元连接方式的计算模型,它由大量的节点(或称为“神经元”)相互连接而成。这些节点被组织成不同的层,包括输入层、隐藏层和输出层。神经网络通过学习数据中的模式来进行分类、回归或其他任务。
图像卷积
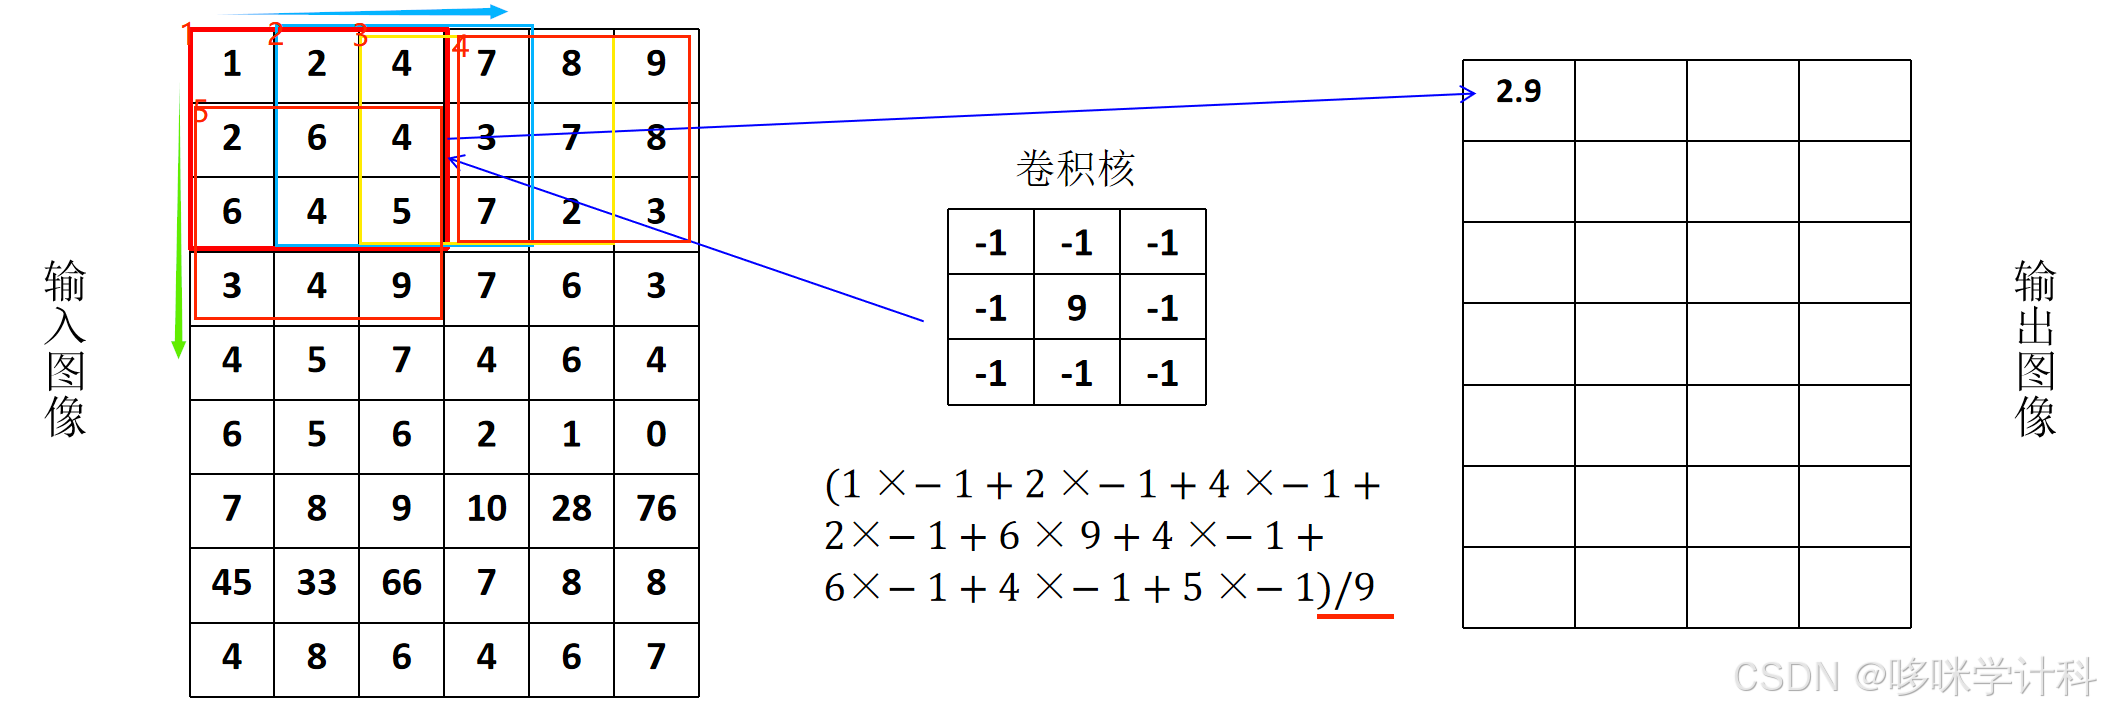
1.卷积核:
1)一张图片进行卷积后的显示效果,绝大部分取决于它的卷积核。
2)卷积核矩阵的行数和列数相同并且数值为奇数,同时它里面的元素值代表不同的权值。
3)卷积核大小和数值的确定是一个综合了理论,经验和实验结果的过程。
4)一般而言,卷积核里面所有元素之和等于 1。也可以不让它等于 1,大于 1时生成的图片亮度会增加,小于 0 时生成的图片亮度会降低。
2. 卷积核在移动是不能移出特征矩阵,故所得输入图像要大于输出图像。如果要输入图像核输出图像尺寸保持一致,经常的做法是在卷积之前扩大输入图像的尺寸,也就是在输入图像外围补 0。
三维卷积:
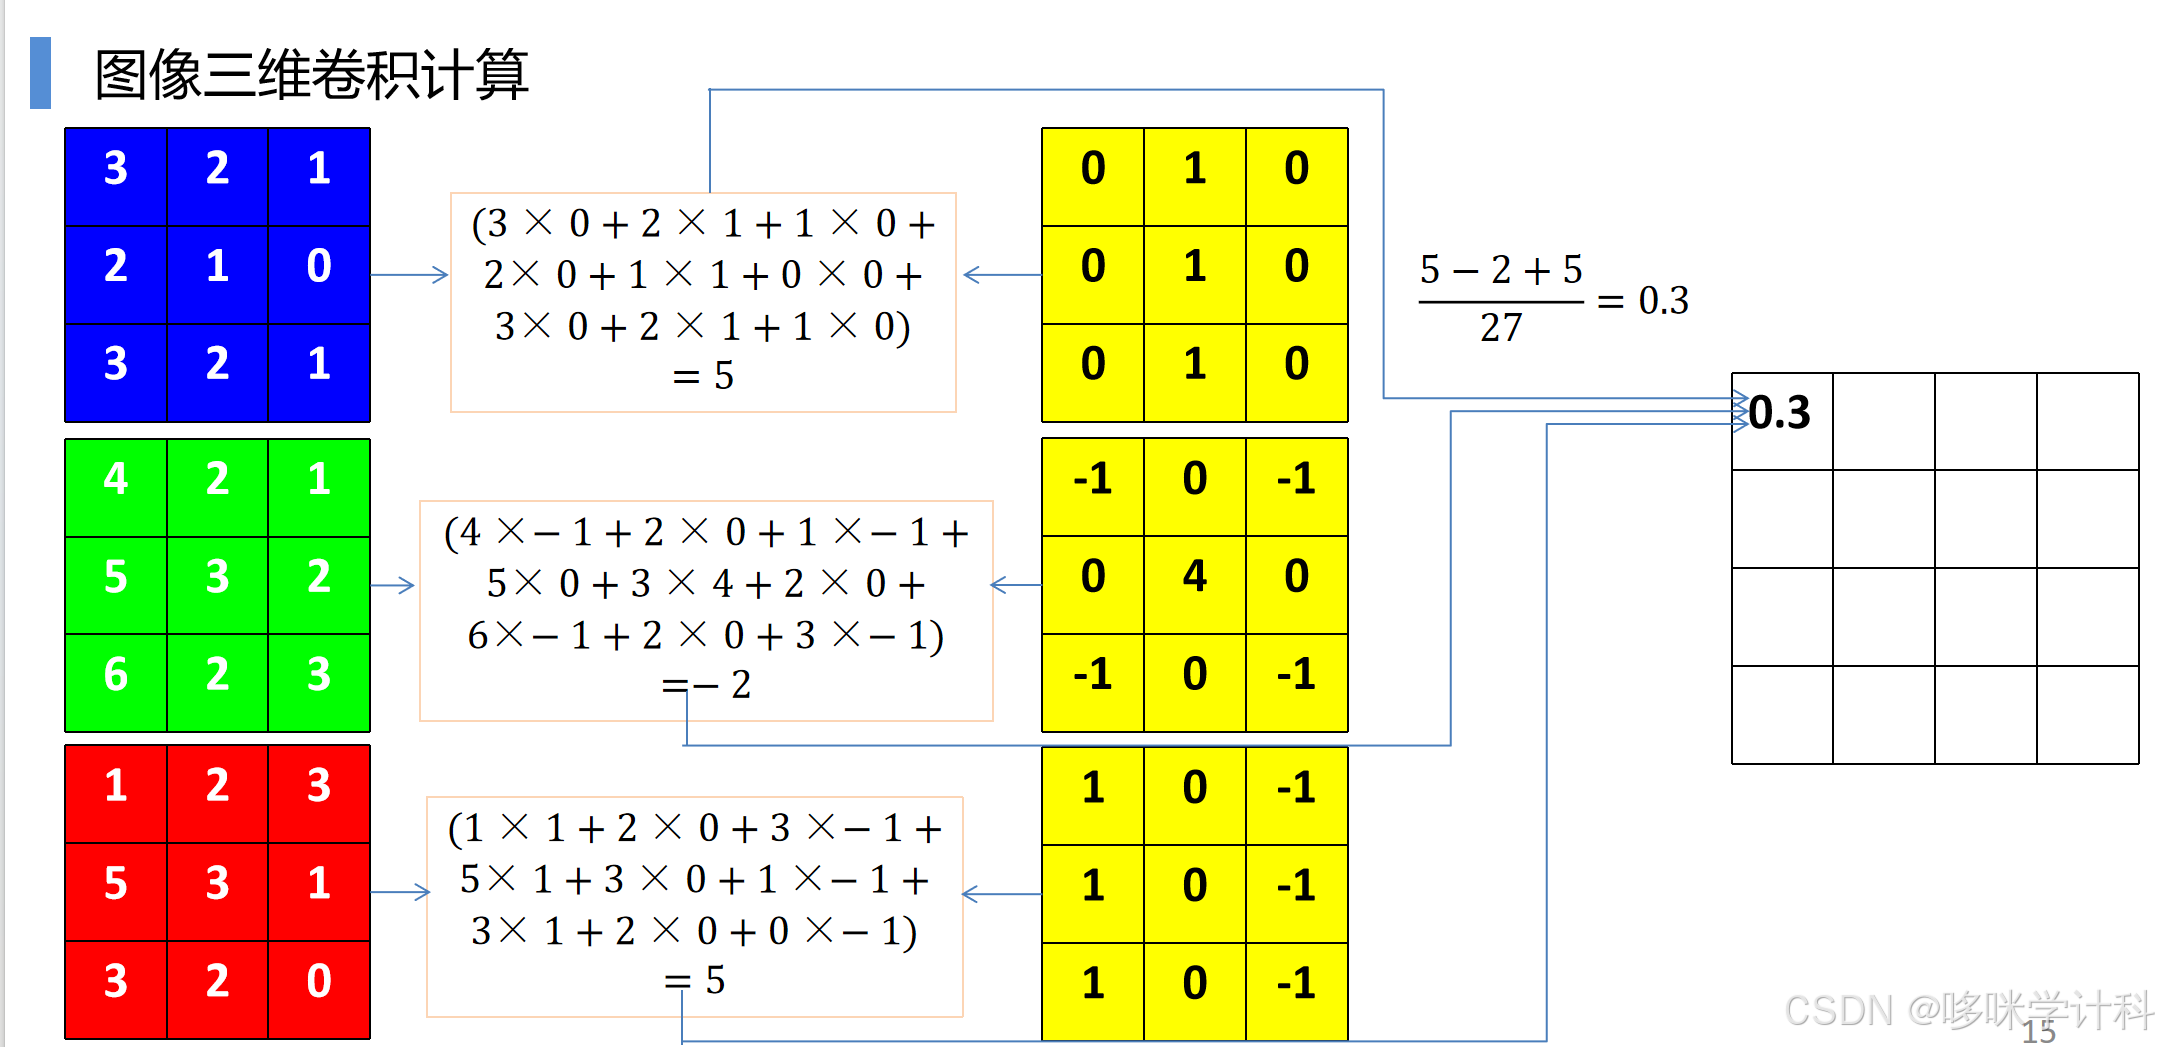
图像池化:
概念: 池化能够减少图像的特征维数,降低存储空间和计算量。
类型:
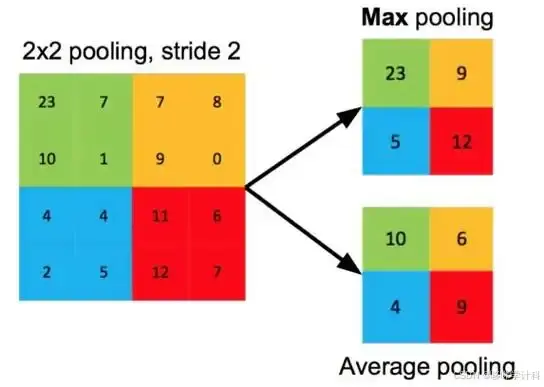
一共有五种池化方式,这两种是最常见的。
1. 最大池化(Max Pooling):
1)原理:在每个局部区域(如2x2的像素块)内,选择最大的像素值作为该区域的代表值。
2)优点:能够保留最重要的特征,如边缘和角点。
3)应用:适用于大多数需要特征保留的场景。2. 平均池化(Average Pooling):
1)原理:在每个局部区域内部,计算所有像素值的平均值作为该区域的代表值。
2)优点:平滑效果好,可以减少噪声。
3)应用:适用于需要平滑特征图并减少计算复杂度的场景。
图像边缘
概念:在图像处理中,边缘通常指的是图像中亮度或颜色发生显著变化的区域,这些区域往往对应于物体轮廓或图像中的重要特征。图像通过卷积核提取特征图,非线性激活函数强化边缘效应,池化操作降低计算量。这对于图像分类、目标检测和其他视觉任务至关重要。
生成式对抗神经网络(GAN)
模型:
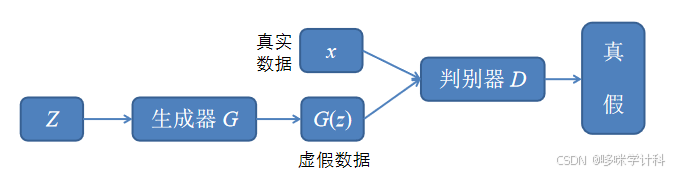
生成器(G)的目标是生成看起来像真实数据的数据,而判别器(D)的目标是区分数据的来源是真实数据还是生成器生成的数据。在训练过程中,生成器不断学习生成能够欺骗判别器的数据,判别器则不断学习如何识别生成器生成的假数据。这种对抗性训练使得两个网络都能够不断进步,最终生成器能够生成非常逼真的数据。
应用:
GANs的应用非常广泛,几乎涵盖了所有涉及数据生成的领域:
1. 图像生成:GANs可以生成高质量的合成图像,包括人脸、风景、动物等。
2. 图像修复和超分辨率:GANs可以用来恢复损坏的图像或提高图像的分辨率。
3. 风格迁移:GANs可以将一幅图像的风格转换成另一幅图像的风格,同时保留原图像的内容。
4. 视频生成:GANs可以生成连贯的视频序列。
5. 自然语言处理:GANs可以用来生成文本,例如撰写文章、生成对话等。
不是很懂,作为期末复习课简单归纳一下,如有问题还望批评指正哈

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 17
 0
- 0


 已为社区贡献1条内容

所有评论(0)