深度学习04
参数初始化
神经网络的参数初始化是训练深度学习模型的关键步骤之一。初始化参数(通常是权重和偏置)会对模型的训练速度、收敛性以及最终的性能产生重要影响。下面是关于神经网络参数初始化的一些常见方法及其相关知识点。
官方文档参考:torch.nn.init — PyTorch 2.6 documentation
1. 固定值初始化
固定值初始化是指在神经网络训练开始时,将所有权重或偏置初始化为一个特定的常数值。这种初始化方法虽然简单,但在实际深度学习应用中通常并不推荐。
1.1 全零初始化
将神经网络中的所有权重参数初始化为0。
方法:将所有权重初始化为零。
缺点:导致对称性破坏,每个神经元在每一层中都会执行相同的计算,模型无法学习。
应用场景:通常不用来初始化权重,但可以用来初始化偏置。
对称性问题
-
现象:同一层的所有神经元具有完全相同的初始权重和偏置。
-
后果:
-
在反向传播时,所有神经元会收到相同的梯度,导致权重更新完全一致。
-
无论训练多久,同一层的神经元本质上会保持相同的功能(相当于“一个神经元”的多个副本),极大降低模型的表达能力。
-
示例
# 3. 全0参数初始化
    linear = nn.Linear(in_features=6, out_features=4)
    # 初始化权重参数
    nn.init.zeros_(linear.weight)
    # 打印权重参数
    print(linear.weight)
1.2 全1初始化
全1初始化会导致网络中每个神经元接收到相同的输入信号,进而输出相同的值,这就无法进行学习和收敛。所以全1初始化只是一个理论上的初始化方法,但在实际神经网络的训练中并不适用。
示例
# 3. 全1参数初始化
    linear = nn.Linear(in_features=6, out_features=4)
    # 初始化权重参数
    nn.init.ones_(linear.weight)
Xavier 初始化
前置知识:
均匀分布:
均匀分布的概率密度函数(PDF):
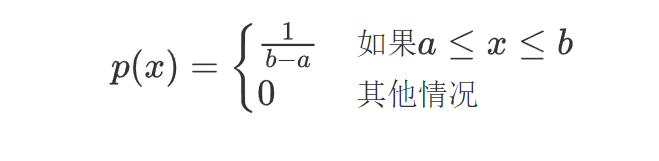
Xavier 初始化(由 Xavier Glorot 在 2010 年提出)是一种自适应权重初始化方法,专门为解决神经网络训练初期的梯度消失或爆炸问题而设计。Xavier 初始化也叫做Glorot初始化。Xavier 初始化的核心思想是根据输入和输出的维度来初始化权重,使得每一层的输出的方差保持一致。具体来说,权重的初始化范围取决于前一层的神经元数量(输入维度)和当前层的神经元数量(输出维度)。
方法:根据输入和输出神经元的数量来选择权重的初始值。
He初始化
也叫kaiming 初始化。He 初始化的核心思想是调整权重的初始化范围,使得每一层的输出的方差保持一致。与 Xavier 初始化不同,He 初始化专门针对 ReLU 激活函数的特性进行了优化。
两种模式
-
fan_in模式(默认):优先保证前向传播稳定,方差
-
fan_out模式:优先保证反向传播稳定,方差
方法:专门为 ReLU 激活函数设计。
优点:适用于ReLU 和 Leaky ReLU 激活函数。
应用场景:深度网络,尤其是使用 ReLU 激活函数时。
示例
def test006():
    # He初始化:正态分布
    linear = nn.Linear(in_features=6, out_features=4)
    nn.init.kaiming_normal_(linear.weight, nonlinearity="relu", mode='fan_in')
    print(linear.weight)

    # He初始化:均匀分布
    linear = nn.Linear(in_features=6, out_features=4)
    nn.init.kaiming_uniform_(linear.weight, nonlinearity="relu", mode='fan_out')
    print(linear.weight)
损失函数
1. 线性回归损失函数
1.1 MAE损失
MAE(Mean Absolute Error,平均绝对误差)通常也被称为 L1-Loss,通过对预测值和真实值之间的绝对差取平均值来衡量他们之间的差异。
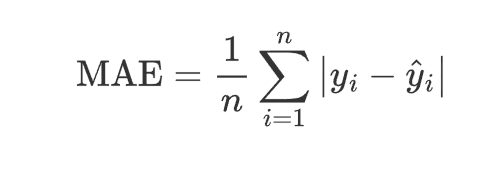
其中:
-
n 是样本的总数。
-
y_i 是第 i 个样本的真实值。
-
\hat{y}_i 是第 i 个样本的预测值。
-
\left| y_i - \hat{y}_i \right| 是真实值和预测值之间的绝对误差。
特点:
-
鲁棒性:与均方误差(MSE)相比,MAE对异常值(outliers)更为鲁棒,因为它不会像MSE那样对较大误差平方敏感。
-
物理意义直观:MAE以与原始数据相同的单位度量误差,使其易于解释。
应用场景: MAE通常用于需要对误差进行线性度量的情况,尤其是当数据中可能存在异常值时,MAE可以避免对异常值的过度惩罚。
1.2 MSE损失
均方差损失,也叫L2Loss。
MSE(Mean Squared Error,均方误差)通过对预测值和真实值之间的误差平方取平均值,来衡量预测值与真实值之间的差异。
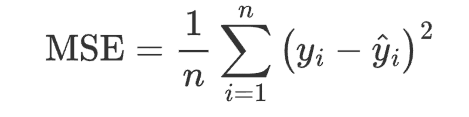
其中:
-
n 是样本的总数。
-
y_i 是第 i 个样本的真实值。
-
\hat{y}_i 是第 i 个样本的预测值。
-
\left( y_i - \hat{y}_i \right)^2 是真实值和预测值之间的误差平方。
特点:
-
平方惩罚:因为误差平方,MSE 对较大误差施加更大惩罚,所以 MSE 对异常值更为敏感。
-
凸性:MSE 是一个凸函数(国际的叫法,国内叫凹函数),这意味着它具有一个唯一的全局最小值,有助于优化问题的求解。
应用场景:
MSE被广泛应用在神经网络中。
交叉熵
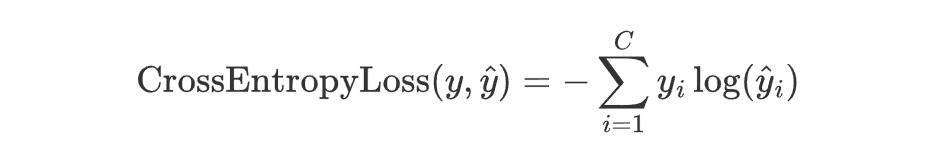
其中:
-
C 是类别的总数。
-
y 是真实标签的one-hot编码向量,表示真实类别。
-
\hat{y} 是模型的输出(经过 softmax 后的概率分布)。
-
y_i 是真实类别的第 i 个元素(0 或 1)。
-
\hat{y}_i 是预测的类别概率分布中对应类别 i 的概率。
特点:
-
概率输出:CrossEntropyLoss 通常与 softmax 函数一起使用,使得模型的输出表示为一个概率分布(即所有类别的概率和为 1)。PyTorch 的 nn.CrossEntropyLoss 已经内置了 Softmax 操作。如果我们在输出层显式地添加 Softmax,会导致重复应用 Softmax,从而影响模型的训练效果。
-
惩罚错误分类:该损失函数在真实类别的预测概率较低时,会施加较大的惩罚,这样模型在训练时更注重提升正确类别的预测概率。
-
多分类问题中的标准选择:在大多数多分类问题中,CrossEntropyLoss 是首选的损失函数。
应用场景:
CrossEntropyLoss 广泛应用于各种分类任务,包括图像分类、文本分类等,尤其是在神经网络模型中。
反向传播算法
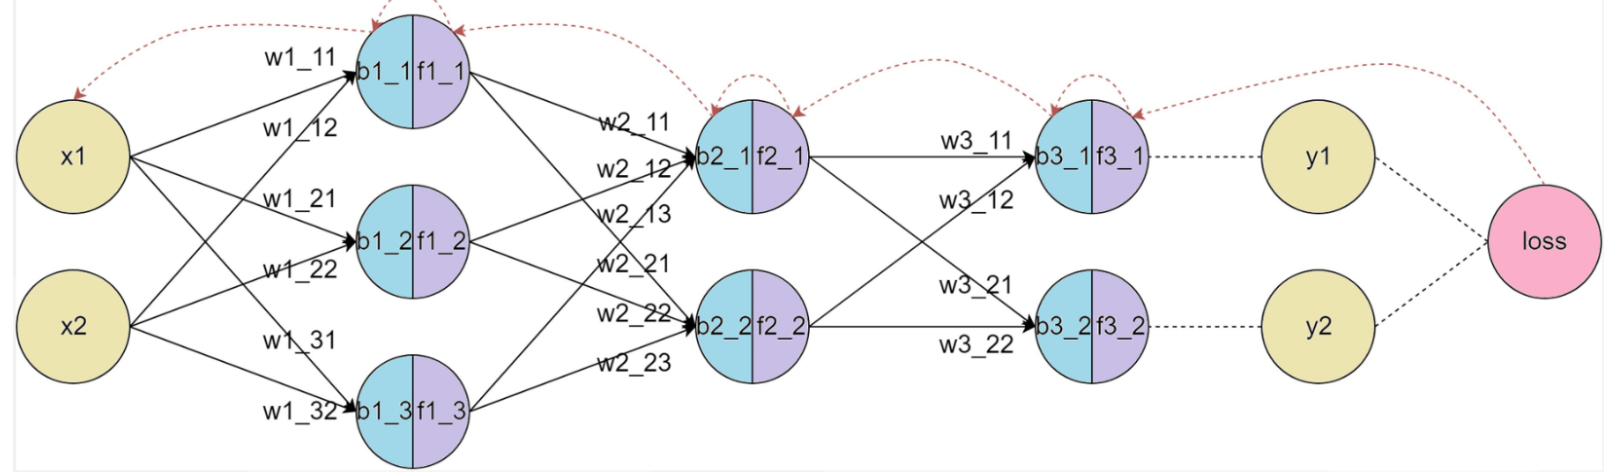
反向传播(Back Propagation,简称BP)算法是用于训练神经网络的核心算法之一,它通过计算损失函数(如均方误差或交叉熵)相对于每个权重参数的梯度,来优化神经网络的权重。
2.2 传统下降方式
根据计算梯度时数据量不同,常见的方式有:
2. 2.1 批量梯度下降
Batch Gradient Descent BGD
-
特点:
-
每次更新参数时,使用整个训练集来计算梯度。
-
-
优点:
-
收敛稳定,能准确地沿着损失函数的真实梯度方向下降。
-
适用于小型数据集。
-
-
缺点:
-
对于大型数据集,计算量巨大,更新速度慢。
-
需要大量内存来存储整个数据集。
-
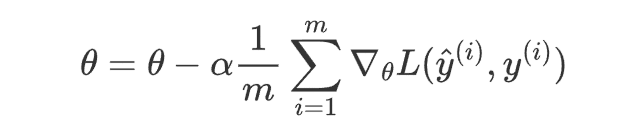
2.2.2 随机梯度下降
Stochastic Gradient Descent, SGD
-
特点:
-
每次更新参数时,仅使用一个样本来计算梯度。
-
-
优点:
-
更新频率高,计算快,适合大规模数据集。
-
能够跳出局部最小值,有助于找到全局最优解。
-
-
缺点:
-
收敛不稳定,容易震荡,因为每个样本的梯度可能都不完全代表整体方向。
-
需要较小的学习率来缓解震荡。
-
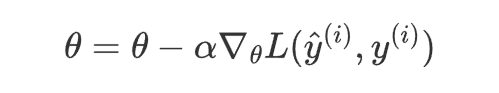
2.2.3 小批量梯度下降
Mini-batch Gradient Descent MGBD
-
特点:
-
每次更新参数时,使用一小部分训练集(小批量)来计算梯度。
-
-
优点:
-
在计算效率和收敛稳定性之间取得平衡。
-
能够利用向量化加速计算,适合现代硬件(如GPU)。
-
-
缺点:
-
选择适当的批量大小比较困难;批量太小则接近SGD,批量太大则接近批量梯度下降。
-
通常会根据硬件算力设置为32\64\128\256等2的次方。
-
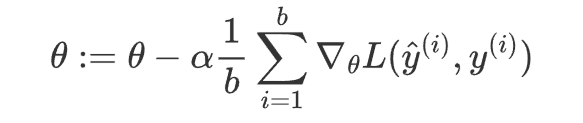

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 52
 0
- 0


 已为社区贡献1条内容

所有评论(0)