卷积神经网络基础概念与YOLOv5代码讲解
目录
特征提取:卷积层的主要作用是通过卷积核(或滤波器)运算提取输入数据(如图像)中的特征。编辑
卷积核:卷积层由多个卷积核组成,每个卷积核负责检测输入数据中的特定特征。编辑
局部连接:与全连接层不同,卷积层中的神经元只与输入数据的一个局部区域相连接,这个局部区域对应于卷积核的大小。
共享权重:卷积层中的卷积核在整个输入数据上滑动时,使用的是相同的权重(即卷积核的值),这意味着网络可以学习到在整个输入数据中通用的特征。编辑
稀疏连接:由于局部连接的特性,卷积层的连接数远少于全连接层,这使得卷积层在参数数量上更加稀疏,有助于减少计算量和过拟合的风险。
步长和填充:卷积操作可以通过调整步长(stride)和填充(padding)来控制输出特征图的大小。编辑左上角+pad 1:边缘填充全为0的数一圈 生成一个7*7的长度与宽度的输入数据编辑
输出特征图:每个卷积核都会生成一个特征图(Feature Map),表示输入数据在该卷积核下的特征响应。一个卷积层可以有多个卷积核,因此会产生多个特征图。编辑编辑编辑
多通道和多特征图:在处理彩色图像时,输入数据可能有多个通道,每个卷积核可以独立地在每个通道上操作,然后将结果相加,以生成特征图。
卷积操作:在神经网络中,卷积操作可以定义为将卷积核与输入数据的局部区域进行元素乘积后求和,这个过程在输入数据的每个位置重复进行,直到覆盖整个输入数据
空间金字塔池化(Spatial Pyramid Pooling)
1.神经网络基础定义:
神经网络是一种模仿人脑神经元处理和传递信息方式的计算模型,它由大量的节点(或称为“神经元”)组成,这些节点通常被组织成层。神经网络通过学习输入数据之间的复杂关系和模式来执行任务,如分类、识别、预测等。
基本组成部分
- 神经元(Neurons):神经网络的基本单元,负责处理信息。
- 层(Layers):神经元被组织成层,包括输入层、隐藏层和输出层。
- 连接(Connections):神经元之间的连接,它们决定了信息如何在网络中流动。
- 权重(Weights):连接的强度,决定了输入对输出的影响程度。
- 偏置(Biases):加在神经元输入上的常数,用于调整激活函数的输出。
- 激活函数(Activation Functions):决定一个神经元是否应该被激活的函数,常见的有Sigmoid、ReLU等。
工作流程
- 前向传播(Forward Propagation):输入数据通过网络,每层神经元计算其输出并传递给下一层。
- 损失函数(Loss Function):衡量模型预测与实际结果之间的差异。
- 反向传播(Backpropagation):根据损失函数计算的梯度,通过网络反向传播,更新权重和偏置。
- 优化算法(Optimization Algorithms):如梯度下降,用于更新权重和偏置以最小化损失函数。
2.卷积层(卷积定义)【CONV】:
在神经网络中,特别是在卷积神经网络(Convolutional Neural Networks, CNNs)中,卷积是一种数学运算,用于提取输入数据(通常是图像)的特征。以下是神经网络中卷积的定义和关键概念:
卷积层(Convolutional Layer)
卷积层是CNN中的基本构建块,它使用卷积运算来处理输入数据。每个卷积层由多个卷积核(或滤波器)组成,每个卷积核负责检测输入数据中的特定特征。
-
特征提取:卷积层的主要作用是通过卷积核(或滤波器)运算提取输入数据(如图像)中的特征。

-
卷积核:卷积层由多个卷积核组成,每个卷积核负责检测输入数据中的特定特征。

-
局部连接:与全连接层不同,卷积层中的神经元只与输入数据的一个局部区域相连接,这个局部区域对应于卷积核的大小。
-
共享权重:卷积层中的卷积核在整个输入数据上滑动时,使用的是相同的权重(即卷积核的值),这意味着网络可以学习到在整个输入数据中通用的特征。

-
稀疏连接:由于局部连接的特性,卷积层的连接数远少于全连接层,这使得卷积层在参数数量上更加稀疏,有助于减少计算量和过拟合的风险。
-
步长和填充:卷积操作可以通过调整步长(stride)和填充(padding)来控制输出特征图的大小。
 左上角+pad 1:边缘填充全为0的数一圈 生成一个7*7的长度与宽度的输入数据

-
输出特征图:每个卷积核都会生成一个特征图(Feature Map),表示输入数据在该卷积核下的特征响应。一个卷积层可以有多个卷积核,因此会产生多个特征图。


-
激活函数:卷积操作后通常会跟一个非线性激活函数,如ReLU,以引入非线性,使网络能够学习更复杂的特征关系。
 如红色矩阵框最下面的,Bias b0的置是1,计算过程中要加上这个1,这个就是激活函数,偏置函数
-
多通道和多特征图:在处理彩色图像时,输入数据可能有多个通道,每个卷积核可以独立地在每个通道上操作,然后将结果相加,以生成特征图。
-
卷积操作:在神经网络中,卷积操作可以定义为将卷积核与输入数据的局部区域进行元素乘积后求和,这个过程在输入数据的每个位置重复进行,直到覆盖整个输入数据
重要参数:
1.输入图像宽度,长度,深度(w,h,c)
2.有多少个不同的卷积核(filter)
3.步长(每次横向,纵向移动的长度)
4.边界填充(边界填充的数值都为0)
5.激活函数(偏置函数)

卷积核(Convolutional Kernel)
卷积核是一个小型的矩阵(通常为正方形),它在输入数据上滑动(或卷积),并在每个位置计算卷积核与输入数据的元素乘积之和。这个操作会产生一个新的二维数组,称为特征图(Feature Map)。

特征图(Feature Map)
特征图是卷积操作的输出,它代表了输入数据在特定卷积核下的特征。每个卷积核都会产生一个特征图,而一个卷积层可以有多个卷积核,因此会产生多个特征图。
步长(Stride)
步长定义了卷积核在输入数据上滑动的间隔。如果步长为1,卷积核会在每个像素上滑动;如果步长大于1,卷积核会在每隔一个像素上滑动。
填充(Padding)
填充是在输入数据的边缘添加额外的像素,以控制输出特征图的大小。填充可以是零填充(Zero Padding),即添加零值像素,或者可以是反射填充(Reflect Padding),即添加输入数据的边缘像素的反射。
卷积操作
在神经网络中,卷积操作可以定义为:
- 定义卷积核:选择一个小型矩阵(卷积核),用于检测输入数据中的特定特征。
- 滑动窗口:将卷积核作为滑动窗口在输入数据上移动。
- 元素乘积:在每个位置,计算卷积核与输入数据的元素对应位置的乘积。
- 求和:将上一步得到的乘积求和,得到一个单一的数值。
- 生成特征图:重复上述步骤,直到覆盖整个输入数据,生成一个新的二维数组(特征图)。
多通道和多特征图
在处理彩色图像时,输入数据可能有多个通道(如RGB)。每个卷积核可以独立地在每个通道上操作,然后将结果相加,以生成特征图。此外,一个卷积层可以有多个卷积核,每个卷积核生成一个特征图,从而产生多个特征图。
激活函数
在卷积操作之后,通常会应用一个非线性激活函数(如ReLU),以引入非线性,使网络能够学习更复杂的特征。
卷积神经网络通过堆叠多个卷积层、池化层(Pooling Layers)和全连接层(Fully Connected Layers)来构建,以实现对输入数据的深度特征提取和分类。

3.池化层(POOL):
池化(Pooling)是卷积神经网络(CNN)中的一种操作,它通常跟在卷积层之后,用于降低特征图的空间维度,同时保留重要的特征信息。池化操作有助于减少模型的参数数量和计算量,同时也增加了模型的抽象能力,使其对输入数据的微小变化更加鲁棒。以下是池化的几种常见类型:
最大池化(Max Pooling)
用的最多

最大池化是最常见的池化类型。在最大池化中,每个池化窗口(通常为2x2或3x3)覆盖输入特征图的一个区域,然后输出该区域内的最大值。这种操作可以有效地保留最显著的特征,同时减少特征图的尺寸。
平均池化(Average Pooling)
平均池化与最大池化类似,但它输出的是池化窗口内所有元素的平均值。平均池化可以平滑特征图,减少噪声的影响。
求和池化(Sum Pooling)
求和池化输出的是池化窗口内所有元素的总和。这种池化方式不如最大池化和平均池化常见。
全局池化(Global Pooling)
全局池化是一种特殊的池化操作,它将整个特征图作为一个池化窗口。全局最大池化和全局平均池化分别输出整个特征图中的最大值和平均值。全局池化常用于网络的末端,以减少特征图的尺寸,为全连接层做准备。
空间金字塔池化(Spatial Pyramid Pooling)
空间金字塔池化是一种多尺度的池化方法,它将不同尺度的特征图组合起来,以捕获不同尺度的特征信息。
自适应池化(Adaptive Pooling)
自适应池化可以根据输出特征图的期望尺寸动态调整池化窗口的大小,以确保输出特征图的尺寸是固定的。
池化操作的参数通常包括:
- 窗口大小(Window Size):池化窗口的尺寸,决定了每个池化操作覆盖的输入特征图区域的大小。
- 步长(Stride):池化窗口在输入特征图上滑动的间隔。如果步长等于窗口大小,池化操作不会重叠;如果步长小于窗口大小,池化操作会重叠。
4.全连接层(FC):
-
定义: 全连接层是神经网络的一种基本层类型,通常位于网络的最后几层,用于分类任务的输出层。在全连接层中,每一个神经元与前一层的每一个神经元都相连接,这意味着每个输入都影响每个输出。
-
基本结构: 全连接层由输入层、隐藏层和输出层组成。输入层接收原始数据,隐藏层进行特征提取和非线性变换,输出层产生最终的分类或回归结果。
-
参数详解:
- 权重参数:全连接层中的每个连接都有一个对应的权重参数,这些权重在训练过程中学习得到。
- 偏置参数:每个神经元都有一个偏置项,用于调整神经元的激活值。
-
计算方式: 全连接层的核心操作是矩阵向量乘积,即 y=Wx+by=Wx+b,其中 yy 为输出向量,WW 为权重矩阵,xx 为输入向量,bb 为偏置向量。
-
作用:
- 全连接层在整个网络中起到“分类器”的作用,将卷积层、池化层和激活函数等操作映射到的隐层特征空间,进一步映射到样本标记空间。
- 在分类任务中,全连接层通常作为网络的最后一层,直接将全连接层的维度设为类别数量或通过Softmax函数输出每个类别的概率分布,从而实现对输入数据的分类
5.几层神经网络如何计算:
CONV(Convolutional Layer) - 卷积层:
- 卷积层是CNN中用于提取输入数据特征的层。它包含多个卷积核(或滤波器),每个卷积核在输入数据上滑动(卷积操作),并在每个位置计算卷积核与输入数据的元素乘积之和,生成新的特征图。
- 卷积层能够捕捉输入数据的局部特征,如边缘、纹理等,并且通过共享权重减少模型参数。
ReLU(Rectified Linear Unit) - 修正线性单元:
- ReLU是一种常用的激活函数,定义为 f(x)=max(0,x)f(x)=max(0,x),即当输入x小于0时输出0,大于0时输出x本身。
- ReLU能够引入非线性到模型中,使得网络能够学习复杂的函数映射,同时它也有助于缓解梯度消失问题,加快训练速度。
POOL(Pooling Layer) - 池化层:
- 池化层用于降低特征图的空间维度,减少参数数量和计算量,同时提取重要特征。
- 常见的池化操作包括最大池化(Max Pooling)和平均池化(Average Pooling)。最大池化输出池化窗口内的最大值,而平均池化输出池化窗口内的平均值。
FC(Fully Connected Layer) - 全连接层:
- 全连接层是神经网络中的一种层,其中每个神经元都与前一层的所有神经元相连。
- 在CNN中,全连接层通常位于网络的末端,用于整合卷积层和池化层提取的特征,进行最终的分类或回归任务。
- 全连接层的每个神经元对输入特征进行加权求和,并通过激活函数(如ReLU或Softmax)生成输出
只有CONV,FC算作神经网络层数,RELU,POOL不算


6.感受野:

7.图像分类应用的教学视频:
八分钟精通 ResNet 残差网络(思想,公式,代码)--计算机视觉系列 01【推荐】_哔哩哔哩_bilibili
Resnet , Densenet , ResNext , Squeezenet ......
8.软件下载:
(1)minianconda下载:
【手把手教程】miniconda安装教程_哔哩哔哩_bilibili
官网:Download Anaconda Distribution | Anaconda
运行:
(2)Pytorch的下载(最好使用清华镜像换下源)
PyTorch深度学习快速入门教程(绝对通俗易懂!)【小土堆】_哔哩哔哩_bilibili
pytorch下载时用清华镜像:Anaconda之conda换国内清华源,切换官方与国内源【Anaconda为24版】_哔哩哔哩_bilibili
清华源:BY UP主:Galaxfy(这部分内容为这个up主的,有视频教程)
Anaconda之conda换源,添加源【国内清华源】.zip - 蓝奏云
Step1:生成.condarc文件
conda config --set show_channel_urls yesStep2:使用everything找到.condarc文件
强烈推荐下载使用everything进行检索,超级快!!
默认位置:C:\Users\<YourUserName>\.condarcStep3:复制下列清华源到.condarc文件
channels:
- https://mirrors.tuna.tsinghua.edu.cn/anaconda/pkgs/main
- https://mirrors.tuna.tsinghua.edu.cn/anaconda/pkgs/r
- https://mirrors.tuna.tsinghua.edu.cn/anaconda/pkgs/msys2
show_channel_urls: trueStep4:查看是否添加成功
conda infoStep5:清除旧索引的干扰
conda clean -i其他:还原默认官方源
清空.condarc内的内容
pytorch下载(在cmd中下载):PyTorch
下载是要注意英伟达GPU是否适配
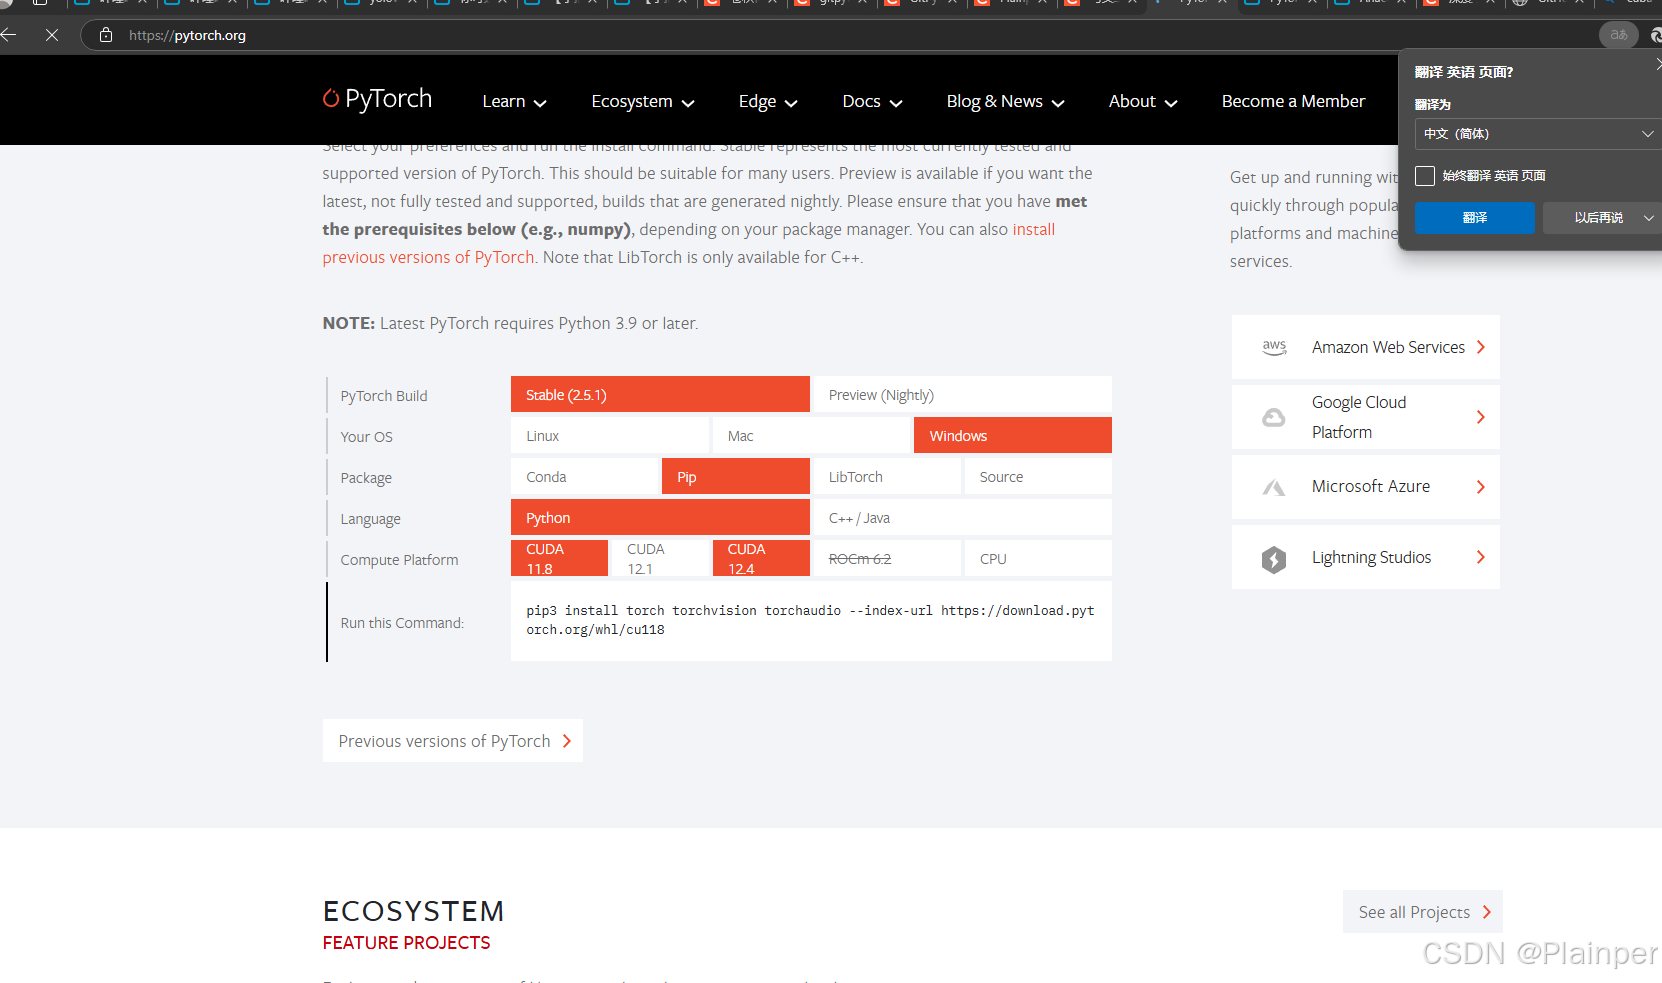
教程链接:
Pytorch下载安装并运行测试【Windows,Anaconda虚拟环境下】_哔哩哔哩_bilibili
下载成功

如果conda环境下载了cpu与gpu,如何删除cpu?
Anaconda 更改 cpu 版本的 pytorch 为gpu版本_conda如何暗转gpu版本torch-CSDN博客
cpu与gpu在模型训练中的区别:
什么是GPU?跟CPU有什么区别?终于有人讲明白了_tensorflowcpu和gpu区别-CSDN博客
cpu:
gpu:

(4)Pycharm下载:
视频讲解:【计算机视觉 车牌识别 卷积神经网络】python实战项目(包含深度学习的概念、python环境配置及车牌识别实战,附配套代码、数据集、课件~)_哔哩哔哩_bilibili
社区版就行:Download PyCharm: The Python IDE for data science and web development by JetBrains
(5)VSCODE的下载:
【手把手带你实战YOLOv5-拓展篇】Vscode基本使用与AutoDL服务器连接_哔哩哔哩_bilibili
(6)全部过程以及环境配置:
【手把手带你实战YOLOv5-拓展篇】Vscode基本使用与AutoDL服务器连接_哔哩哔哩_bilibili
一定要从重置版看,yolov5不要下载master要7.0
(7)虚拟环境的下载与删除:
Conda 创建和删除虚拟环境_conda删除虚拟环境-CSDN博客
删除:
conda remove -n yolov5 --all9.YOLOv5的网络结构:
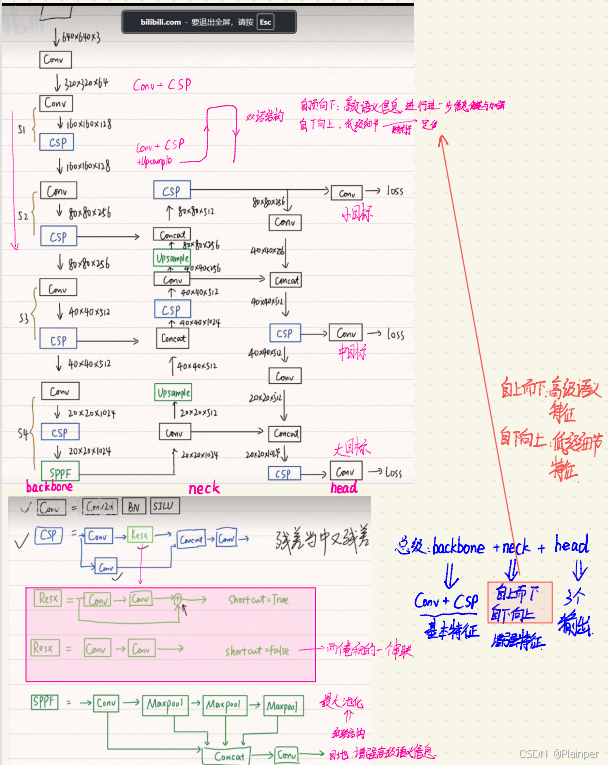
-
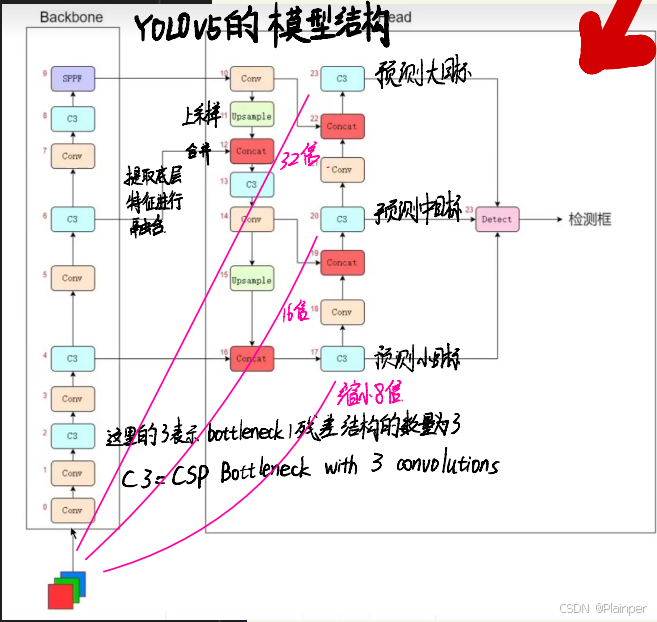
C3模型: C3是YOLOv5中的一个网络结构模块,它结合了残差网络(ResNet)的思想。C3模块由三个卷积层组成,其中第一层和第三层使用1x1的卷积核来减少和增加通道数,而第二层使用3x3的卷积核来扩大感受野。C3模块的特点是它有两种处理输入特征图的方式:一种是通过残差分支,另一种是直接通过卷积层。这两种处理方式的输出结果会合并,以增强特征的表达能力。C3模块在YOLOv5中用于主干网络(backbone)和检测头(head)中,以提高模型的特征提取能力。
-
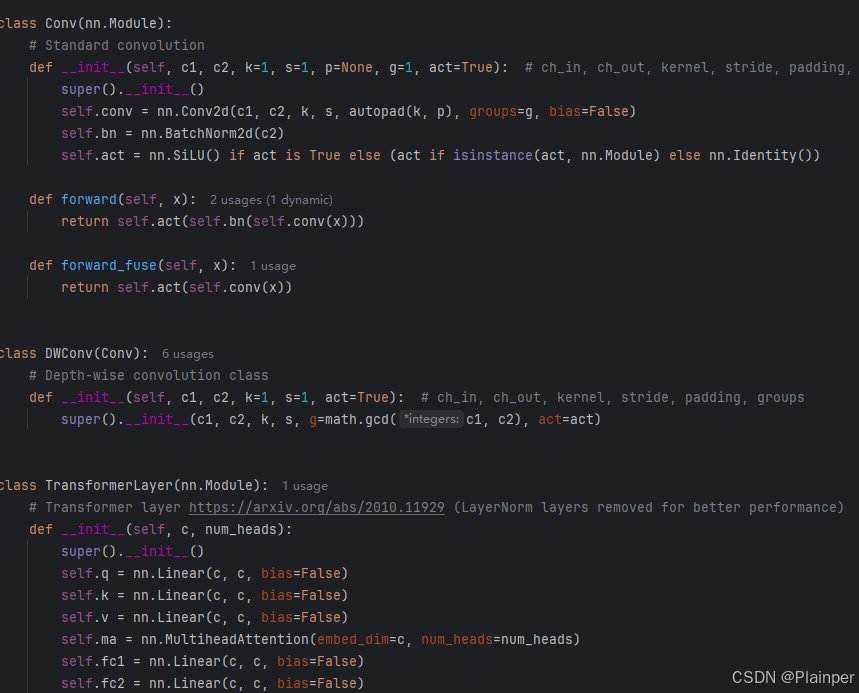
Conv模型: Conv模型指的是卷积神经网络(Convolutional Neural Network)中的卷积层,它通过卷积核在输入数据上滑动来提取特征。在YOLOv5中,Conv层通常指一个标准的卷积操作,后接批量归一化(Batch Normalization)和激活函数(如SiLU)。Conv层是构建深度神经网络的基本构件,用于提取图像中的局部特征。
-
CSP模型: CSP(Cross Stage Partial)模型是一种网络结构,它通过在不同阶段共享特征来减少计算量并提高性能。CSP结构包含多个阶段(stage),每个阶段由一系列卷积层组成,并且不同阶段之间会进行特征的合并。CSP结构的一个变种是C3模块,它在YOLOv5的某些版本中取代了传统的CSP结构。CSP模型通过减少冗余计算和促进特征重用,提高了网络的效率
10.YOLOv5代码讲解:
yolov5源码(github)网址:
最下面source code(zip)
Release v7.0 - YOLOv5 SOTA Realtime Instance Segmentation · ultralytics/yolov5 · GitHub
1. detect.py(目标检测)
detect.py是 YOLOv5 用于推理(目标检测)的脚本。它能够处理多种输入源,包括图片、视频、文件夹以及网络流等。以下是一些关键参数和它们的作用:
--weights:指定模型权重文件的路径。--source:指定输入源,可以是文件、文件夹或者摄像头。--img-size:指定推理时的图像尺寸。--conf-thres:对象置信度阈值。--iou-thres:非极大值抑制(NMS)的 IOU 阈值。--device:指定运行设备,例如 CPU 或 GPU。--view-img:显示结果。--save-txt:将结果保存为文本文件。--classes:指定类别进行过滤。--agnostic-nms:执行类别不可知的 NMS。--augment:增强推理。--project和--name:指定保存结果的项目和名称。
detect.py通过解析这些参数来执行目标检测任务,并输出检测结果。2.
train.py(模型训练)
train.py是 YOLOv5 用于训练模型的脚本。以下是一些关键步骤和参数:
- 数据准备:需要准备训练和验证数据集,并创建对应的
.yaml文件,其中包含数据集的路径、类别数量和类别名称。- 模型训练:使用
train.py脚本启动训练过程,可以指定模型权重、图像尺寸、批次大小、训练周期等参数。--img:指定输入图像的尺寸。--batch:指定批次大小。--epochs:指定训练周期数。--data:指定包含数据集信息的.yaml文件。--weights:指定预训练权重文件。--nosave和--cache:控制是否保存训练过程中的权重和缓存信息。训练完成后,模型的权重和训练结果会被保存在指定的路径下。
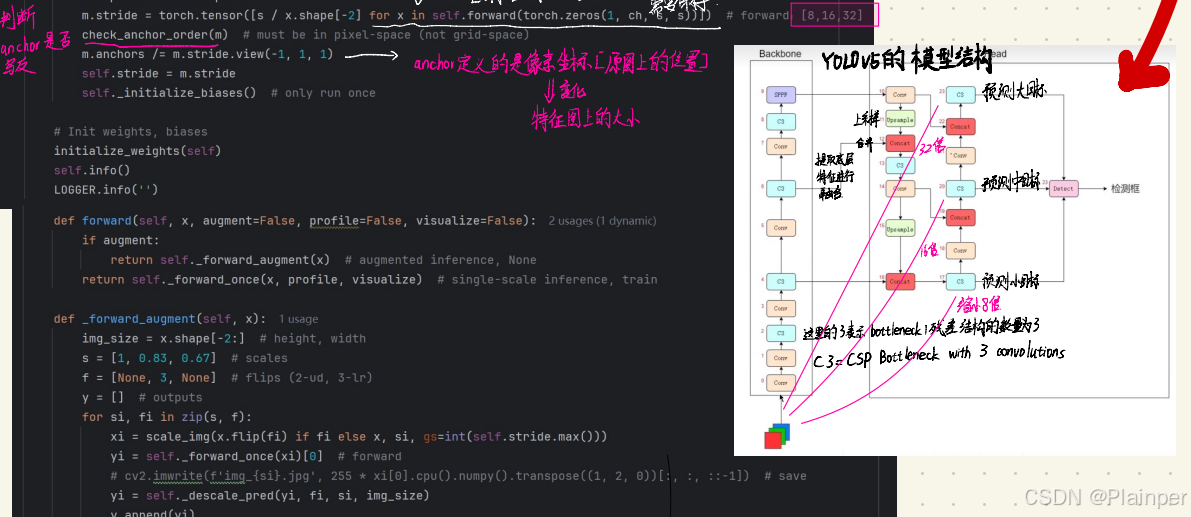
3. YOLOv5 模型结构
YOLOv5 模型结构可以分为以下几个部分:
- 输入端:包括 Mosaic 数据增强和自适应锚框计算等。
- Backbone:(骨干网络)特征提取部分,包含 Focus 结构、CBL 结构、CSP 结构和 SPP 结构。
定义与作用:
- Backbone指的是深度神经网络中用于特征提取的主要部分。它通常由多个卷积层或其他特征提取层组成,负责从输入数据中逐渐提取高级特征。在图像处理任务中,Backbone用于提取图像的全局和局部特征,例如边缘、纹理和形状等。
实现方法:
- Backbone的实现通常包括定义网络结构、构建基本模块、重复模块以及添加全连接层。这些步骤共同构建了一个能够从输入数据中提取有用特征的网络结构。
应用场景:
- Backbone的应用非常广泛,包括但不限于图像分类、目标检测、人脸识别、语音识别和自然语言处理等领域。例如,在图像分类任务中,常用的Backbone包括CNN(卷积神经网络),而在自然语言处理任务中,常用的Backbone包括RNN(循环神经网络)。
常见的Backbone架构:
- 在计算机视觉中,常见的Backbone架构包括VGGNet、ResNet、Inception等,这些架构能够有效地提取图像的特征,并传递给神经网络的其余部分。
重要性:
- Backbone是深度学习模型的核心组成部分,它为后续的下游任务(如分类、生成等)提供了基础。因此,Backbone的设计和选择对整个模型的性能有着直接的影响。
预训练与微调:
- 在使用Backbone时,通常会直接加载官方已经训练好的模型参数,然后在具体的训练过程中对其进行微调,使其更适应特定的任务
- Neck:特征融合部分,通常包含 FPN(特征金字塔网络)和 PAN(路径聚合网络)结构。
"Neck"是指位于骨干网络(Backbone)和检测头(Head)之间的特征融合部分,主要负责对特征图进行多尺度特征融合,并把这些特征传递给预测层。以下是对YOLOv5中Neck的详细解释:
FPN(Feature Pyramid Network):
- FPN结构通过自顶向下的路径,将高层的语义特征传递给低层,增强了低层特征图的语义信息。它允许模型在不同尺度的特征图上进行目标检测,提高了对不同大小目标的检测能力。
PAN(Path Aggregation Network):
- PAN结构通过自底向上的路径,将低层的细节特征传递给高层,实现了特征的双向融合。这种结构有助于提升模型对小目标的检测能力。
CSP(Cross Stage Partial Connections):
- 在YOLOv5中,Neck部分采用了CSP结构,这是一种有效的特征融合技术,可以加强网络特征融合的能力。
特征融合:
- Neck的主要作用是进一步融合和增强特征。通过FPN和PAN的混合结构,YOLOv5实现了多尺度特征的融合和传递。
多尺度目标检测:
- 由于物体在图像中的大小和位置是不确定的,Neck模块通过特征金字塔结构来处理不同尺度和大小的目标,这对于目标检测算法来说至关重要。
提高检测性能:
- Neck模块的引入,使得YOLOv5在保持高效性的同时提升了模型的性能,尤其是在处理多尺度目标时。
结构组成:
- YOLOv5的Neck由FPN和PAN结构组成,其中FPN层自顶向下可以捕获强语义特征,而PAN则通过自底向上传达强定位特征,通过组合这两个模块,可以很好地完成目标定位的功能
- Prediction:预测头,负责输出最终的检测结果,包括 CIOU_Loss 等。
YOLOv5 根据不同的网络宽度和深度,分为 YOLOv5s、YOLOv5m、YOLOv5l 和 YOLOv5x 四个版本
(1)detect.py
推理部分之detect.py文件_哔哩哔哩_bilibili
# YOLOv5 🚀 by Ultralytics, GPL-3.0 license
"""
Run inference on images, videos, directories, streams, etc.

Usage - sources:
    $ python path/to/detect.py --weights yolov5s.pt --source 0              # webcam
                                                             img.jpg        # image
                                                             vid.mp4        # video
                                                             path/          # directory
                                                             path/*.jpg     # glob
                                                             'https://youtu.be/Zgi9g1ksQHc'  # YouTube
                                                             'rtsp://example.com/media.mp4'  # RTSP, RTMP, HTTP stream

Usage - formats:
    $ python path/to/detect.py --weights yolov5s.pt                 # PyTorch
                                         yolov5s.torchscript        # TorchScript
                                         yolov5s.onnx               # ONNX Runtime or OpenCV DNN with --dnn
                                         yolov5s.xml                # OpenVINO
                                         yolov5s.engine             # TensorRT
                                         yolov5s.mlmodel            # CoreML (macOS-only)
                                         yolov5s_saved_model        # TensorFlow SavedModel
                                         yolov5s.pb                 # TensorFlow GraphDef
                                         yolov5s.tflite             # TensorFlow Lite
                                         yolov5s_edgetpu.tflite     # TensorFlow Edge TPU
"""

import argparse
import os
import sys
from pathlib import Path

import torch
import torch.backends.cudnn as cudnn

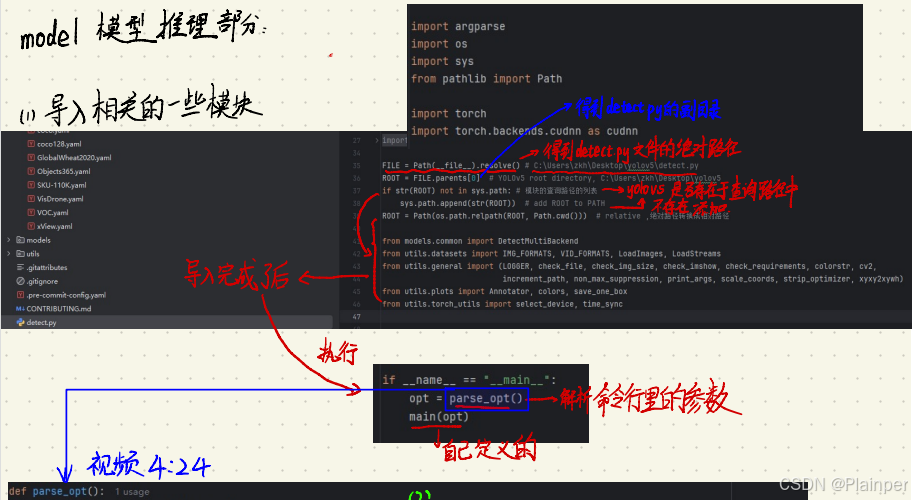
FILE = Path(__file__).resolve() # C:\Users\zkh\Desktop\yolov5\detect.py
ROOT = FILE.parents[0]  # YOLOv5 root directory, C:\Users\zkh\Desktop\yolov5
if str(ROOT) not in sys.path: # 模块的查询路径的列表
    sys.path.append(str(ROOT))  # add ROOT to PATH
ROOT = Path(os.path.relpath(ROOT, Path.cwd()))  # relative ,绝对路径转换成相对路径

from models.common import DetectMultiBackend
from utils.datasets import IMG_FORMATS, VID_FORMATS, LoadImages, LoadStreams
from utils.general import (LOGGER, check_file, check_img_size, check_imshow, check_requirements, colorstr, cv2,
                           increment_path, non_max_suppression, print_args, scale_coords, strip_optimizer, xyxy2xywh)
from utils.plots import Annotator, colors, save_one_box
from utils.torch_utils import select_device, time_sync


@torch.no_grad()
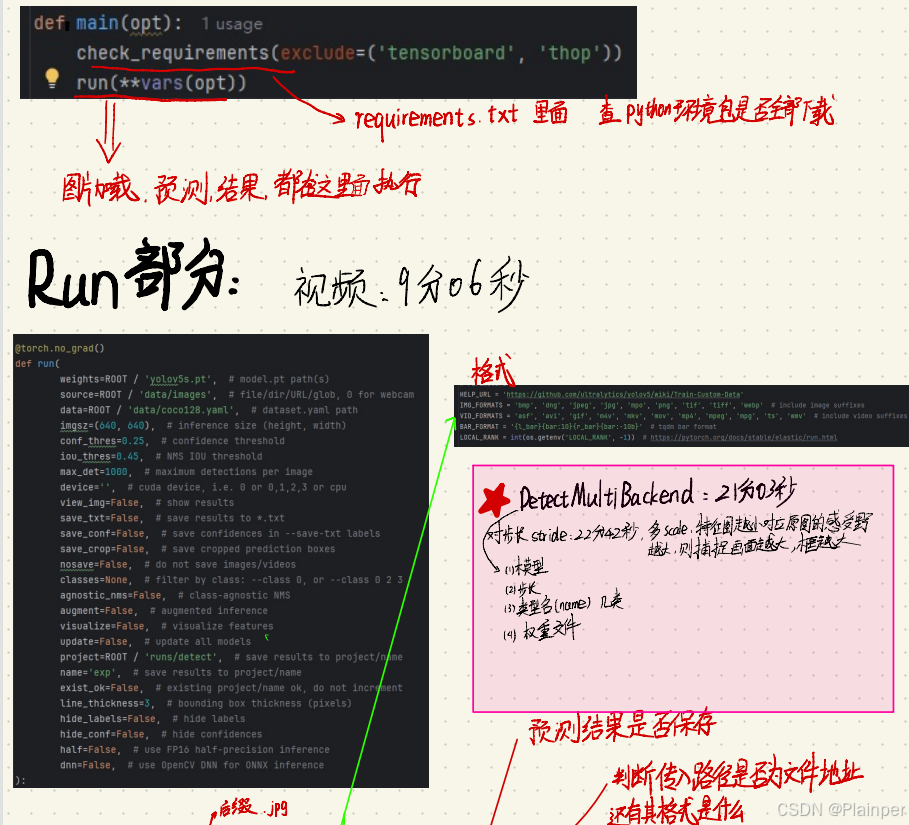
def run(
        weights=ROOT / 'yolov5s.pt',  # model.pt path(s)
        source=ROOT / 'data/images',  # file/dir/URL/glob, 0 for webcam
        data=ROOT / 'data/coco128.yaml',  # dataset.yaml path
        imgsz=(640, 640),  # inference size (height, width)
        conf_thres=0.25,  # confidence threshold
        iou_thres=0.45,  # NMS IOU threshold
        max_det=1000,  # maximum detections per image
        device='',  # cuda device, i.e. 0 or 0,1,2,3 or cpu
        view_img=False,  # show results
        save_txt=False,  # save results to *.txt
        save_conf=False,  # save confidences in --save-txt labels
        save_crop=False,  # save cropped prediction boxes
        nosave=False,  # do not save images/videos
        classes=None,  # filter by class: --class 0, or --class 0 2 3
        agnostic_nms=False,  # class-agnostic NMS
        augment=False,  # augmented inference
        visualize=False,  # visualize features
        update=False,  # update all models
        project=ROOT / 'runs/detect',  # save results to project/name
        name='exp',  # save results to project/name
        exist_ok=False,  # existing project/name ok, do not increment
        line_thickness=3,  # bounding box thickness (pixels)
        hide_labels=False,  # hide labels
        hide_conf=False,  # hide confidences
        half=False,  # use FP16 half-precision inference
        dnn=False,  # use OpenCV DNN for ONNX inference
):
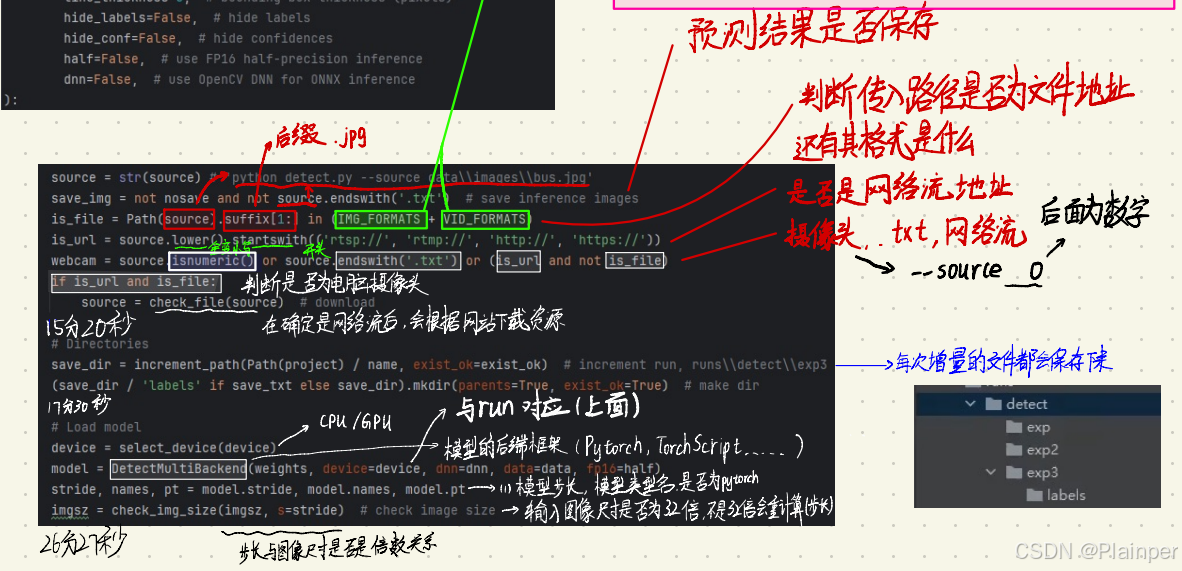
    source = str(source) # 'python detect.py --source data\\images\\bus.jpg'
    save_img = not nosave and not source.endswith('.txt')  # save inference images
    is_file = Path(source).suffix[1:] in (IMG_FORMATS + VID_FORMATS)
    is_url = source.lower().startswith(('rtsp://', 'rtmp://', 'http://', 'https://'))
    webcam = source.isnumeric() or source.endswith('.txt') or (is_url and not is_file)
    if is_url and is_file:
        source = check_file(source)  # download

    # Directories
    save_dir = increment_path(Path(project) / name, exist_ok=exist_ok)  # increment run, runs\\detect\\exp3
    (save_dir / 'labels' if save_txt else save_dir).mkdir(parents=True, exist_ok=True)  # make dir

    # Load model
    device = select_device(device)
    model = DetectMultiBackend(weights, device=device, dnn=dnn, data=data, fp16=half)
    stride, names, pt = model.stride, model.names, model.pt
    imgsz = check_img_size(imgsz, s=stride)  # check image size

    # Dataloader
    if webcam:
        view_img = check_imshow()
        cudnn.benchmark = True  # set True to speed up constant image size inference
        dataset = LoadStreams(source, img_size=imgsz, stride=stride, auto=pt)
        bs = len(dataset)  # batch_size
    else:
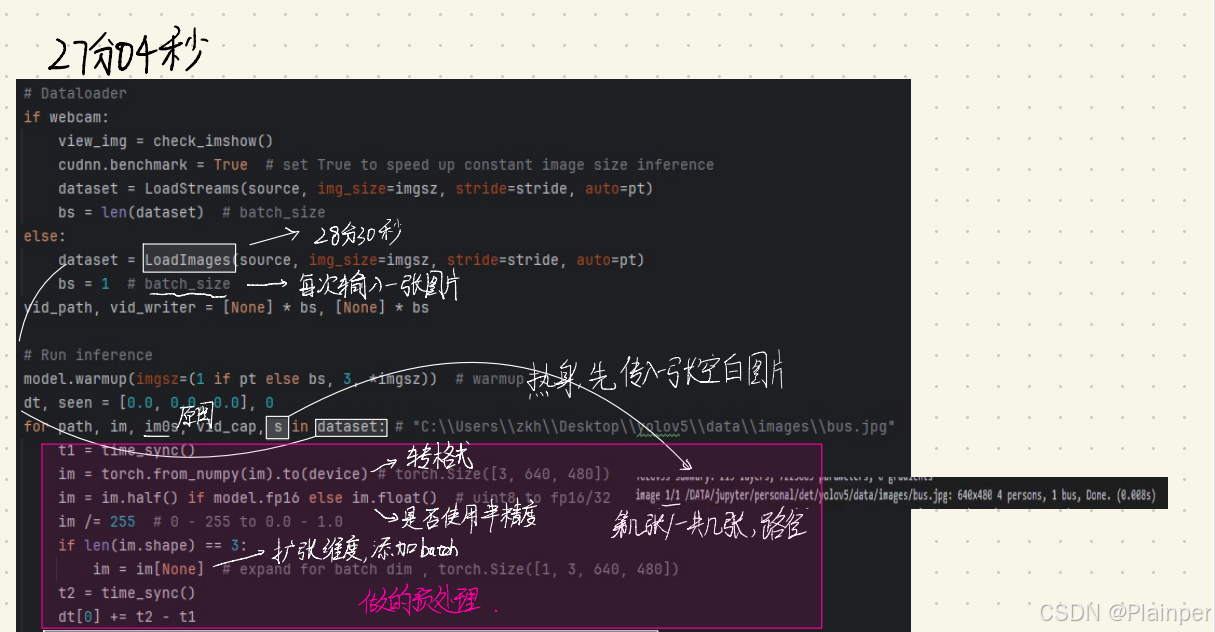
        dataset = LoadImages(source, img_size=imgsz, stride=stride, auto=pt)
        bs = 1  # batch_size
    vid_path, vid_writer = [None] * bs, [None] * bs

    # Run inference
    model.warmup(imgsz=(1 if pt else bs, 3, *imgsz))  # warmup
    dt, seen = [0.0, 0.0, 0.0], 0
    for path, im, im0s, vid_cap, s in dataset: # "C:\\Users\\zkh\\Desktop\\yolov5\\data\\images\\bus.jpg"
        t1 = time_sync()
        im = torch.from_numpy(im).to(device) # torch.Size([3, 640, 480])
        im = im.half() if model.fp16 else im.float()  # uint8 to fp16/32
        im /= 255  # 0 - 255 to 0.0 - 1.0
        if len(im.shape) == 3:
            im = im[None]  # expand for batch dim , torch.Size([1, 3, 640, 480])
        t2 = time_sync()
        dt[0] += t2 - t1

        # Inference
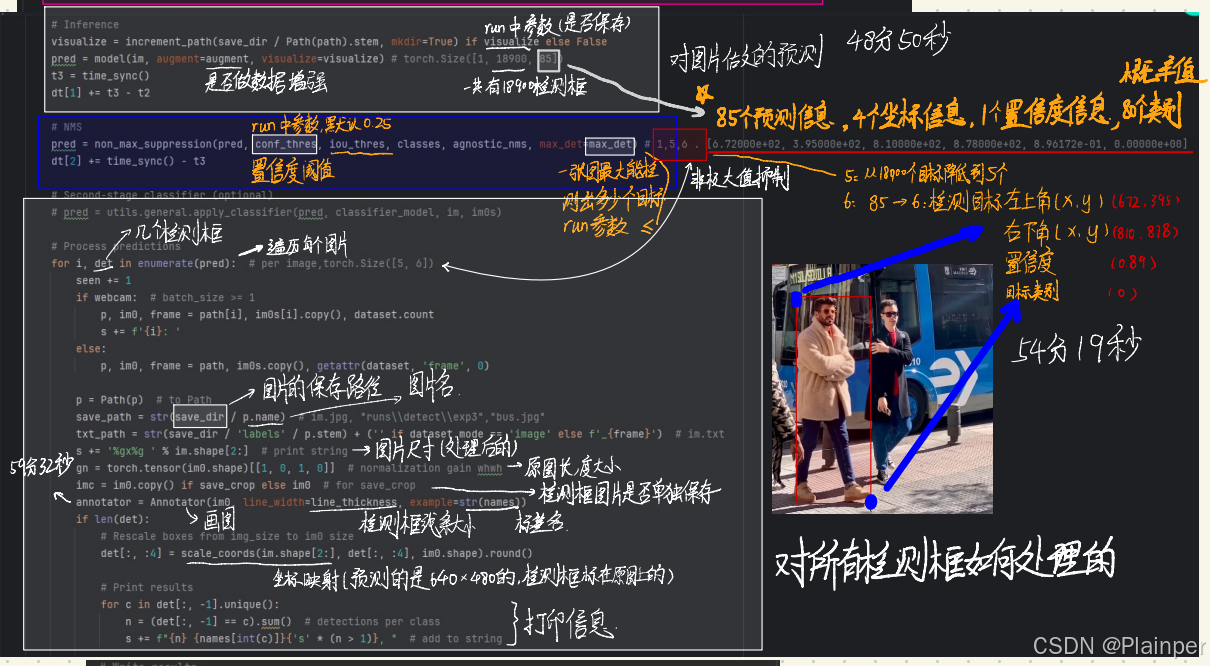
        visualize = increment_path(save_dir / Path(path).stem, mkdir=True) if visualize else False
        pred = model(im, augment=augment, visualize=visualize) # torch.Size([1, 18900, 85])
        t3 = time_sync()
        dt[1] += t3 - t2

        # NMS
        pred = non_max_suppression(pred, conf_thres, iou_thres, classes, agnostic_nms, max_det=max_det) # 1,5,6 . [6.72000e+02, 3.95000e+02, 8.10000e+02, 8.78000e+02, 8.96172e-01, 0.00000e+00]
        dt[2] += time_sync() - t3

        # Second-stage classifier (optional)
        # pred = utils.general.apply_classifier(pred, classifier_model, im, im0s)

        # Process predictions
        for i, det in enumerate(pred):  # per image,torch.Size([5, 6])
            seen += 1
            if webcam:  # batch_size >= 1
                p, im0, frame = path[i], im0s[i].copy(), dataset.count
                s += f'{i}: '
            else:
                p, im0, frame = path, im0s.copy(), getattr(dataset, 'frame', 0)

            p = Path(p)  # to Path
            save_path = str(save_dir / p.name)  # im.jpg, "runs\\detect\\exp3","bus.jpg"
            txt_path = str(save_dir / 'labels' / p.stem) + ('' if dataset.mode == 'image' else f'_{frame}')  # im.txt
            s += '%gx%g ' % im.shape[2:]  # print string
            gn = torch.tensor(im0.shape)[[1, 0, 1, 0]]  # normalization gain whwh
            imc = im0.copy() if save_crop else im0  # for save_crop
            annotator = Annotator(im0, line_width=line_thickness, example=str(names))
            if len(det):
                # Rescale boxes from img_size to im0 size
                det[:, :4] = scale_coords(im.shape[2:], det[:, :4], im0.shape).round()

                # Print results
                for c in det[:, -1].unique():
                    n = (det[:, -1] == c).sum()  # detections per class
                    s += f"{n} {names[int(c)]}{'s' * (n > 1)}, "  # add to string

                # Write results
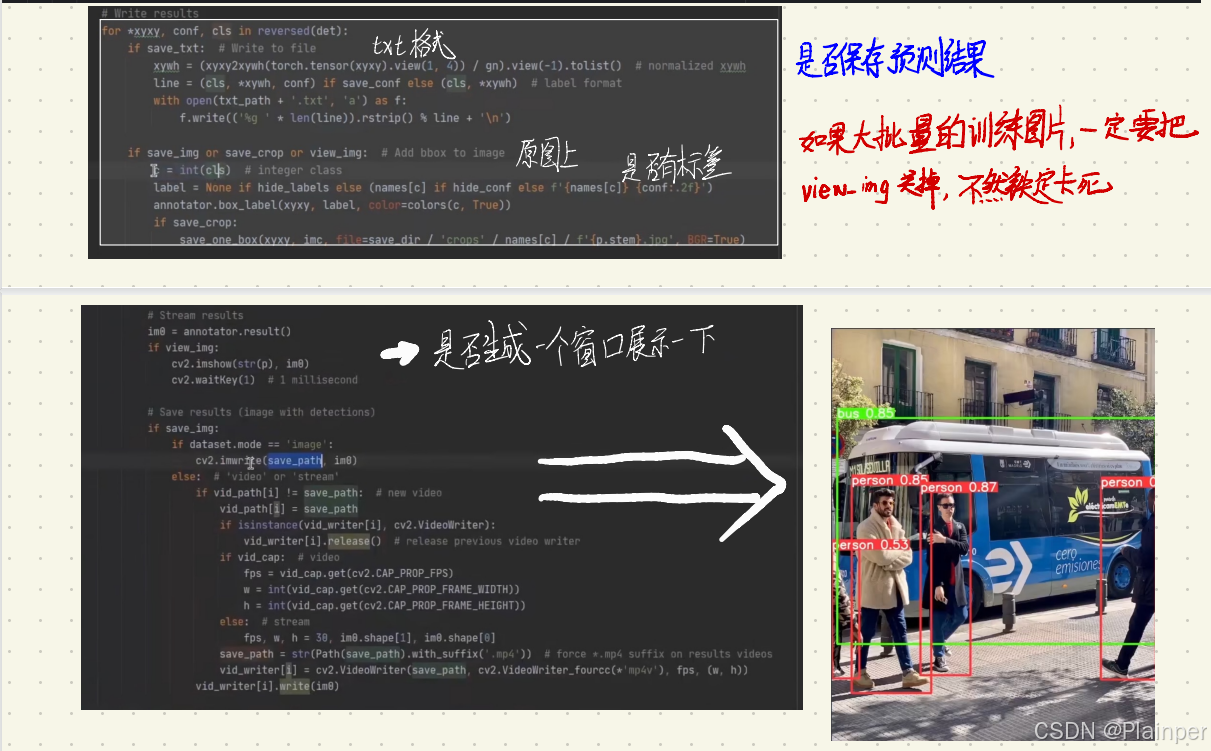
                for *xyxy, conf, cls in reversed(det):
                    if save_txt:  # Write to file
                        xywh = (xyxy2xywh(torch.tensor(xyxy).view(1, 4)) / gn).view(-1).tolist()  # normalized xywh
                        line = (cls, *xywh, conf) if save_conf else (cls, *xywh)  # label format
                        with open(txt_path + '.txt', 'a') as f:
                            f.write(('%g ' * len(line)).rstrip() % line + '\n')

                    if save_img or save_crop or view_img:  # Add bbox to image
                        c = int(cls)  # integer class
                        label = None if hide_labels else (names[c] if hide_conf else f'{names[c]} {conf:.2f}')
                        annotator.box_label(xyxy, label, color=colors(c, True))
                        if save_crop:
                            save_one_box(xyxy, imc, file=save_dir / 'crops' / names[c] / f'{p.stem}.jpg', BGR=True)

            # Stream results
            im0 = annotator.result()
            if view_img:
                cv2.imshow(str(p), im0)
                cv2.waitKey(1)  # 1 millisecond

            # Save results (image with detections)
            if save_img:
                if dataset.mode == 'image':
                    cv2.imwrite(save_path, im0)
                else:  # 'video' or 'stream'
                    if vid_path[i] != save_path:  # new video
                        vid_path[i] = save_path
                        if isinstance(vid_writer[i], cv2.VideoWriter):
                            vid_writer[i].release()  # release previous video writer
                        if vid_cap:  # video
                            fps = vid_cap.get(cv2.CAP_PROP_FPS)
                            w = int(vid_cap.get(cv2.CAP_PROP_FRAME_WIDTH))
                            h = int(vid_cap.get(cv2.CAP_PROP_FRAME_HEIGHT))
                        else:  # stream
                            fps, w, h = 30, im0.shape[1], im0.shape[0]
                        save_path = str(Path(save_path).with_suffix('.mp4'))  # force *.mp4 suffix on results videos
                        vid_writer[i] = cv2.VideoWriter(save_path, cv2.VideoWriter_fourcc(*'mp4v'), fps, (w, h))
                    vid_writer[i].write(im0)

        # Print time (inference-only)
        LOGGER.info(f'{s}Done. ({t3 - t2:.3f}s)')

    # Print results
    t = tuple(x / seen * 1E3 for x in dt)  # speeds per image
    LOGGER.info(f'Speed: %.1fms pre-process, %.1fms inference, %.1fms NMS per image at shape {(1, 3, *imgsz)}' % t)
    if save_txt or save_img:
        s = f"\n{len(list(save_dir.glob('labels/*.txt')))} labels saved to {save_dir / 'labels'}" if save_txt else ''
        LOGGER.info(f"Results saved to {colorstr('bold', save_dir)}{s}")
    if update:
        strip_optimizer(weights)  # update model (to fix SourceChangeWarning)


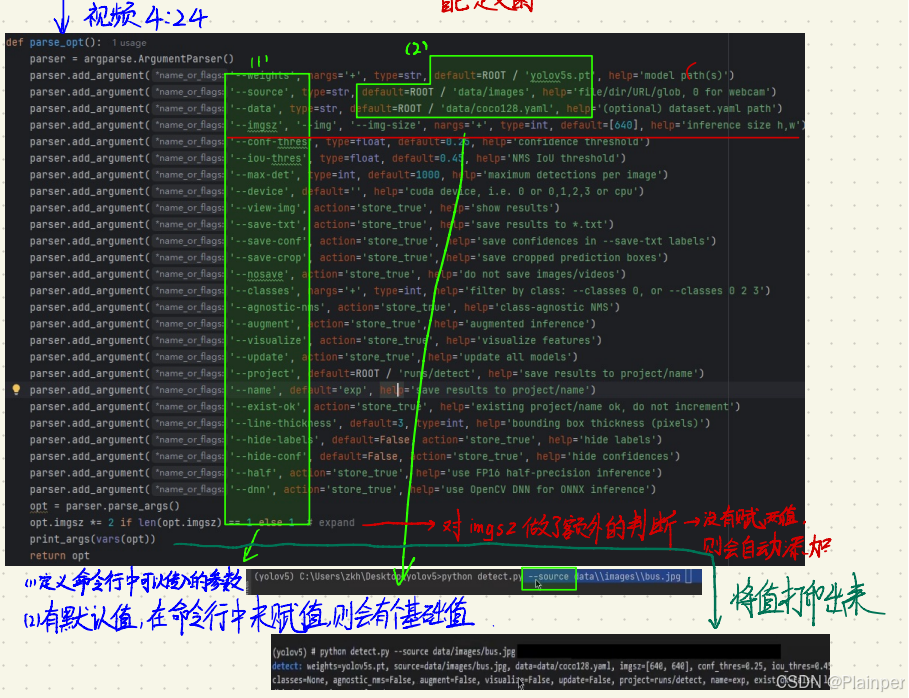
def parse_opt():
    parser = argparse.ArgumentParser()
    parser.add_argument('--weights', nargs='+', type=str, default=ROOT / 'yolov5s.pt', help='model path(s)')
    parser.add_argument('--source', type=str, default=ROOT / 'data/images', help='file/dir/URL/glob, 0 for webcam')
    parser.add_argument('--data', type=str, default=ROOT / 'data/coco128.yaml', help='(optional) dataset.yaml path')
    parser.add_argument('--imgsz', '--img', '--img-size', nargs='+', type=int, default=[640], help='inference size h,w')
    parser.add_argument('--conf-thres', type=float, default=0.25, help='confidence threshold')
    parser.add_argument('--iou-thres', type=float, default=0.45, help='NMS IoU threshold')
    parser.add_argument('--max-det', type=int, default=1000, help='maximum detections per image')
    parser.add_argument('--device', default='', help='cuda device, i.e. 0 or 0,1,2,3 or cpu')
    parser.add_argument('--view-img', action='store_true', help='show results')
    parser.add_argument('--save-txt', action='store_true', help='save results to *.txt')
    parser.add_argument('--save-conf', action='store_true', help='save confidences in --save-txt labels')
    parser.add_argument('--save-crop', action='store_true', help='save cropped prediction boxes')
    parser.add_argument('--nosave', action='store_true', help='do not save images/videos')
    parser.add_argument('--classes', nargs='+', type=int, help='filter by class: --classes 0, or --classes 0 2 3')
    parser.add_argument('--agnostic-nms', action='store_true', help='class-agnostic NMS')
    parser.add_argument('--augment', action='store_true', help='augmented inference')
    parser.add_argument('--visualize', action='store_true', help='visualize features')
    parser.add_argument('--update', action='store_true', help='update all models')
    parser.add_argument('--project', default=ROOT / 'runs/detect', help='save results to project/name')
    parser.add_argument('--name', default='exp', help='save results to project/name')
    parser.add_argument('--exist-ok', action='store_true', help='existing project/name ok, do not increment')
    parser.add_argument('--line-thickness', default=3, type=int, help='bounding box thickness (pixels)')
    parser.add_argument('--hide-labels', default=False, action='store_true', help='hide labels')
    parser.add_argument('--hide-conf', default=False, action='store_true', help='hide confidences')
    parser.add_argument('--half', action='store_true', help='use FP16 half-precision inference')
    parser.add_argument('--dnn', action='store_true', help='use OpenCV DNN for ONNX inference')
    opt = parser.parse_args()
    opt.imgsz *= 2 if len(opt.imgsz) == 1 else 1  # expand
    print_args(vars(opt))
    return opt


def main(opt):
    check_requirements(exclude=('tensorboard', 'thop'))
    run(**vars(opt))


if __name__ == "__main__":
    opt = parse_opt()
    main(opt)
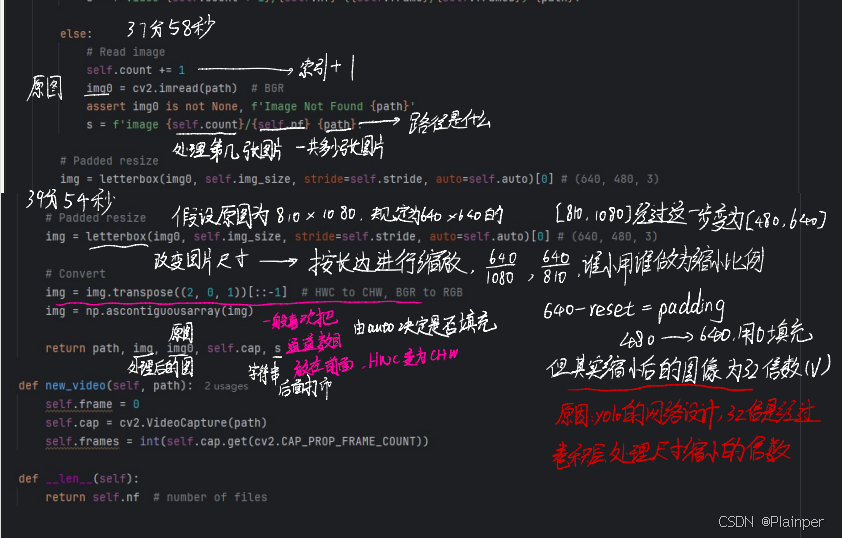
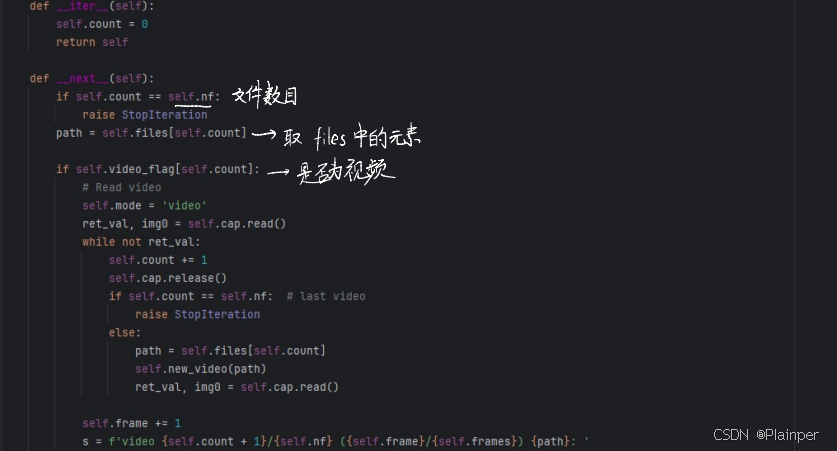
LoadImages:
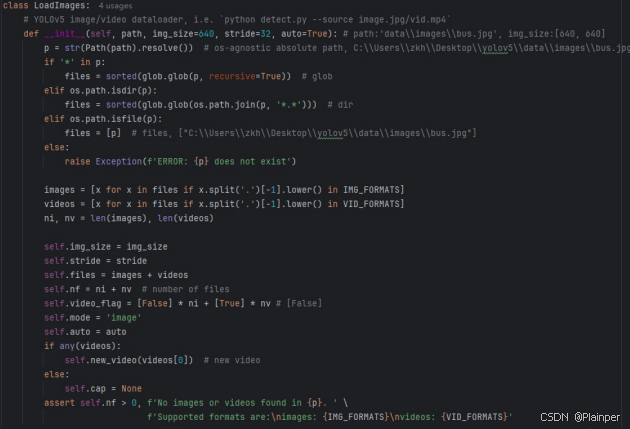
yolo中 LoadImages, LoadScreenshots, LoadStreams-CSDN博客
主要功能
- 加载图像和视频:
LoadImages类可以从给定的图像路径、目录或文件中加载图像,并将其转换为模型可处理的格式。它支持加载本地图像、视频文件以及摄像头数据。- 图像预处理:该类提供了对输入图像进行缩放、裁剪和填充等操作的方法,以适应不同的训练和推理需求。
- 迭代器特性:
LoadImages类实现了__iter__和__next__魔法方法,使其具有迭代器的特性,可以逐个处理数据集中的图像或视频帧。参数说明
path:路径地址,可以是图像文件夹、文件、视频文件夹、文件,或者两者混合。img_size:转换后的图像大小,用于letterbox函数中,对图像进行缩放和填充。stride:letterbox转换参数,用于确保图像尺寸是该值的倍数。auto:letterbox转换参数,用于自动调整图像大小和填充。transforms:可选参数,允许用户自定义图像转换操作。vid_stride:视频文件帧率步长,用于控制从视频中读取帧的频率。
(2)yolo.py:
参数:
--weights:指定模型权重文件的路径。这是开始训练时加载预训练权重的地方,可以是本地文件路径或者Triton URL。
--cfg:模型配置文件的路径,通常是一个.yaml文件,描述了模型的结构。
--data:数据集配置文件的路径,也是一个.yaml文件,包含了数据集的路径、类别信息等。
--hyp:超参数配置文件的路径,包含了训练过程中的超参数设置,如学习率、动量等。
--epochs:总的训练周期数。
--batch-size:每个批次中的图像数量,对于所有GPU的总批次大小。
--imgsz或--img或--img-size:训练和验证时图像的大小(像素)。
--rect:是否进行矩形训练。
--resume:是否从最近的检查点恢复训练。
--nosave:是否只保存最终的检查点。
--noval:是否只在最后一个epoch进行验证。
--noautoanchor:是否禁用自动锚点调整。
--device:指定CUDA设备,例如0或0,1,2,3代表GPU设备编号,cpu代表使用CPU。
--multi-scale:是否变化图像大小±50%进行训练。
--single-cls:是否将多类别数据作为单类别数据进行训练。
--optimizer:选择优化器,如SGD、Adam或AdamW。
--cos-lr:是否使用余弦退火学习率调度器。
--label-smoothing:标签平滑策略的epsilon值。
--patience:早停策略的耐心值,即在多少个epoch没有改进后停止训练。
--freeze:冻结网络中特定层的参数。
--save-period:每多少个epoch保存一次检查点。
--seed:全局训练种子,用于确保结果的可重复性
# YOLOv5 🚀 by Ultralytics, GPL-3.0 license
"""
YOLO-specific modules

Usage:
    $ python path/to/models/yolo.py --cfg yolov5s.yaml
"""

import argparse
import os
import platform
import sys
from copy import deepcopy
from pathlib import Path

FILE = Path(__file__).resolve()
ROOT = FILE.parents[1]  # YOLOv5 root directory
if str(ROOT) not in sys.path:
    sys.path.append(str(ROOT))  # add ROOT to PATH
if platform.system() != 'Windows':
    ROOT = Path(os.path.relpath(ROOT, Path.cwd()))  # relative

from models.common import *
from models.experimental import *
from utils.autoanchor import check_anchor_order
from utils.general import LOGGER, check_version, check_yaml, make_divisible, print_args
from utils.plots import feature_visualization
from utils.torch_utils import (fuse_conv_and_bn, initialize_weights, model_info, profile, scale_img, select_device,
                               time_sync)

try:
    import thop  # for FLOPs computation
except ImportError:
    thop = None


class Detect(nn.Module):
    stride = None  # strides computed during build
    onnx_dynamic = False  # ONNX export parameter
    export = False  # export mode

    def __init__(self, nc=80, anchors=(), ch=(), inplace=True):  # detection layer
        super().__init__()
        self.nc = nc  # number of classes
        self.no = nc + 5  # number of outputs per anchor
        self.nl = len(anchors)  # number of detection layers
        self.na = len(anchors[0]) // 2  # number of anchors
        self.grid = [torch.zeros(1)] * self.nl  # init grid
        self.anchor_grid = [torch.zeros(1)] * self.nl  # init anchor grid
        self.register_buffer('anchors', torch.tensor(anchors).float().view(self.nl, -1, 2))  # shape(nl,na,2)
        self.m = nn.ModuleList(nn.Conv2d(x, self.no * self.na, 1) for x in ch)  # output conv
        self.inplace = inplace  # use in-place ops (e.g. slice assignment)

    def forward(self, x):
        z = []  # inference output
        for i in range(self.nl):
            x[i] = self.m[i](x[i])  # conv
            bs, _, ny, nx = x[i].shape  # x(bs,255,20,20) to x(bs,3,20,20,85)
            x[i] = x[i].view(bs, self.na, self.no, ny, nx).permute(0, 1, 3, 4, 2).contiguous()

            if not self.training:  # inference
                if self.onnx_dynamic or self.grid[i].shape[2:4] != x[i].shape[2:4]:
                    self.grid[i], self.anchor_grid[i] = self._make_grid(nx, ny, i)

                y = x[i].sigmoid()
                if self.inplace:
                    y[..., 0:2] = (y[..., 0:2] * 2 + self.grid[i]) * self.stride[i]  # xy
                    y[..., 2:4] = (y[..., 2:4] * 2) ** 2 * self.anchor_grid[i]  # wh
                else:  # for YOLOv5 on AWS Inferentia https://github.com/ultralytics/yolov5/pull/2953
                    xy, wh, conf = y.split((2, 2, self.nc + 1), 4)  # y.tensor_split((2, 4, 5), 4)  # torch 1.8.0
                    xy = (xy * 2 + self.grid[i]) * self.stride[i]  # xy
                    wh = (wh * 2) ** 2 * self.anchor_grid[i]  # wh
                    y = torch.cat((xy, wh, conf), 4)
                z.append(y.view(bs, -1, self.no))

        return x if self.training else (torch.cat(z, 1),) if self.export else (torch.cat(z, 1), x)

    def _make_grid(self, nx=20, ny=20, i=0):
        d = self.anchors[i].device
        t = self.anchors[i].dtype
        shape = 1, self.na, ny, nx, 2  # grid shape
        y, x = torch.arange(ny, device=d, dtype=t), torch.arange(nx, device=d, dtype=t)
        if check_version(torch.__version__, '1.10.0'):  # torch>=1.10.0 meshgrid workaround for torch>=0.7 compatibility
            yv, xv = torch.meshgrid(y, x, indexing='ij')
        else:
            yv, xv = torch.meshgrid(y, x)
        grid = torch.stack((xv, yv), 2).expand(shape) - 0.5  # add grid offset, i.e. y = 2.0 * x - 0.5
        anchor_grid = (self.anchors[i] * self.stride[i]).view((1, self.na, 1, 1, 2)).expand(shape)
        return grid, anchor_grid


class Model(nn.Module):
    # YOLOv5 model
    def __init__(self, cfg='yolov5s.yaml', ch=3, nc=None, anchors=None):  # model, input channels, number of classes
        super().__init__()
        if isinstance(cfg, dict):
            self.yaml = cfg  # model dict
        else:  # is *.yaml
            import yaml  # for torch hub
            self.yaml_file = Path(cfg).name
            with open(cfg, encoding='ascii', errors='ignore') as f:
                self.yaml = yaml.safe_load(f)  # model dict

        # Define model
        ch = self.yaml['ch'] = self.yaml.get('ch', ch)  # input channels, 3
        if nc and nc != self.yaml['nc']:
            LOGGER.info(f"Overriding model.yaml nc={self.yaml['nc']} with nc={nc}")
            self.yaml['nc'] = nc  # override yaml value
        if anchors:
            LOGGER.info(f'Overriding model.yaml anchors with anchors={anchors}')
            self.yaml['anchors'] = round(anchors)  # override yaml value
        self.model, self.save = parse_model(deepcopy(self.yaml), ch=[ch])  # model, savelist:[4, 6, 10, 14, 17, 20, 23]
        self.names = [str(i) for i in range(self.yaml['nc'])]  # default names
        self.inplace = self.yaml.get('inplace', True)

        # Build strides, anchors
        m = self.model[-1]  # Detect()
        if isinstance(m, Detect):
            s = 256  # 2x min stride
            m.inplace = self.inplace
            m.stride = torch.tensor([s / x.shape[-2] for x in self.forward(torch.zeros(1, ch, s, s))])  # forward:[8,16,32]
            check_anchor_order(m)  # must be in pixel-space (not grid-space)
            m.anchors /= m.stride.view(-1, 1, 1)
            self.stride = m.stride
            self._initialize_biases()  # only run once

        # Init weights, biases
        initialize_weights(self)
        self.info()
        LOGGER.info('')

    def forward(self, x, augment=False, profile=False, visualize=False):
        if augment:
            return self._forward_augment(x)  # augmented inference, None
        return self._forward_once(x, profile, visualize)  # single-scale inference, train

    def _forward_augment(self, x):
        img_size = x.shape[-2:]  # height, width
        s = [1, 0.83, 0.67]  # scales
        f = [None, 3, None]  # flips (2-ud, 3-lr)
        y = []  # outputs
        for si, fi in zip(s, f):
            xi = scale_img(x.flip(fi) if fi else x, si, gs=int(self.stride.max()))
            yi = self._forward_once(xi)[0]  # forward
            # cv2.imwrite(f'img_{si}.jpg', 255 * xi[0].cpu().numpy().transpose((1, 2, 0))[:, :, ::-1])  # save
            yi = self._descale_pred(yi, fi, si, img_size)
            y.append(yi)
        y = self._clip_augmented(y)  # clip augmented tails
        return torch.cat(y, 1), None  # augmented inference, train

    def _forward_once(self, x, profile=False, visualize=False):
        y, dt = [], []  # outputs
        for m in self.model:
            if m.f != -1:  # if not from previous layer
                x = y[m.f] if isinstance(m.f, int) else [x if j == -1 else y[j] for j in m.f]  # from earlier layers
            if profile:
                self._profile_one_layer(m, x, dt)
            x = m(x)  # run
            y.append(x if m.i in self.save else None)  # save output
            if visualize:
                feature_visualization(x, m.type, m.i, save_dir=visualize)
        return x

    def _descale_pred(self, p, flips, scale, img_size):
        # de-scale predictions following augmented inference (inverse operation)
        if self.inplace:
            p[..., :4] /= scale  # de-scale
            if flips == 2:
                p[..., 1] = img_size[0] - p[..., 1]  # de-flip ud
            elif flips == 3:
                p[..., 0] = img_size[1] - p[..., 0]  # de-flip lr
        else:
            x, y, wh = p[..., 0:1] / scale, p[..., 1:2] / scale, p[..., 2:4] / scale  # de-scale
            if flips == 2:
                y = img_size[0] - y  # de-flip ud
            elif flips == 3:
                x = img_size[1] - x  # de-flip lr
            p = torch.cat((x, y, wh, p[..., 4:]), -1)
        return p

    def _clip_augmented(self, y):
        # Clip YOLOv5 augmented inference tails
        nl = self.model[-1].nl  # number of detection layers (P3-P5)
        g = sum(4 ** x for x in range(nl))  # grid points
        e = 1  # exclude layer count
        i = (y[0].shape[1] // g) * sum(4 ** x for x in range(e))  # indices
        y[0] = y[0][:, :-i]  # large
        i = (y[-1].shape[1] // g) * sum(4 ** (nl - 1 - x) for x in range(e))  # indices
        y[-1] = y[-1][:, i:]  # small
        return y

    def _profile_one_layer(self, m, x, dt):
        c = isinstance(m, Detect)  # is final layer, copy input as inplace fix
        o = thop.profile(m, inputs=(x.copy() if c else x,), verbose=False)[0] / 1E9 * 2 if thop else 0  # FLOPs
        t = time_sync()
        for _ in range(10):
            m(x.copy() if c else x)
        dt.append((time_sync() - t) * 100)
        if m == self.model[0]:
            LOGGER.info(f"{'time (ms)':>10s} {'GFLOPs':>10s} {'params':>10s}  {'module'}")
        LOGGER.info(f'{dt[-1]:10.2f} {o:10.2f} {m.np:10.0f}  {m.type}')
        if c:
            LOGGER.info(f"{sum(dt):10.2f} {'-':>10s} {'-':>10s}  Total")

    def _initialize_biases(self, cf=None):  # initialize biases into Detect(), cf is class frequency
        # https://arxiv.org/abs/1708.02002 section 3.3
        # cf = torch.bincount(torch.tensor(np.concatenate(dataset.labels, 0)[:, 0]).long(), minlength=nc) + 1.
        m = self.model[-1]  # Detect() module
        for mi, s in zip(m.m, m.stride):  # from
            b = mi.bias.view(m.na, -1)  # conv.bias(255) to (3,85)
            b.data[:, 4] += math.log(8 / (640 / s) ** 2)  # obj (8 objects per 640 image)
            b.data[:, 5:] += math.log(0.6 / (m.nc - 0.999999)) if cf is None else torch.log(cf / cf.sum())  # cls
            mi.bias = torch.nn.Parameter(b.view(-1), requires_grad=True)

    def _print_biases(self):
        m = self.model[-1]  # Detect() module
        for mi in m.m:  # from
            b = mi.bias.detach().view(m.na, -1).T  # conv.bias(255) to (3,85)
            LOGGER.info(
                ('%6g Conv2d.bias:' + '%10.3g' * 6) % (mi.weight.shape[1], *b[:5].mean(1).tolist(), b[5:].mean()))

    # def _print_weights(self):
    #     for m in self.model.modules():
    #         if type(m) is Bottleneck:
    #             LOGGER.info('%10.3g' % (m.w.detach().sigmoid() * 2))  # shortcut weights

    def fuse(self):  # fuse model Conv2d() + BatchNorm2d() layers
        LOGGER.info('Fusing layers... ')
        for m in self.model.modules():
            if isinstance(m, (Conv, DWConv)) and hasattr(m, 'bn'):
                m.conv = fuse_conv_and_bn(m.conv, m.bn)  # update conv
                delattr(m, 'bn')  # remove batchnorm
                m.forward = m.forward_fuse  # update forward
        self.info()
        return self

    def info(self, verbose=False, img_size=640):  # print model information
        model_info(self, verbose, img_size)

    def _apply(self, fn):
        # Apply to(), cpu(), cuda(), half() to model tensors that are not parameters or registered buffers
        self = super()._apply(fn)
        m = self.model[-1]  # Detect()
        if isinstance(m, Detect):
            m.stride = fn(m.stride)
            m.grid = list(map(fn, m.grid))
            if isinstance(m.anchor_grid, list):
                m.anchor_grid = list(map(fn, m.anchor_grid))
        return self


def parse_model(d, ch):  # model_dict:yolov5s.yaml, input_channels(3):[3]
    LOGGER.info(f"\n{'':>3}{'from':>18}{'n':>3}{'params':>10}  {'module':<40}{'arguments':<30}")
    anchors, nc, gd, gw = d['anchors'], d['nc'], d['depth_multiple'], d['width_multiple'] # gd:0.33, gw:0.5
    na = (len(anchors[0]) // 2) if isinstance(anchors, list) else anchors  # number of anchors
    no = na * (nc + 5)  # number of outputs = anchors * (classes + 5) = 255

    layers, save, c2 = [], [], ch[-1]  # layers, savelist, ch out
    for i, (f, n, m, args) in enumerate(d['backbone'] + d['head']):  # from:-1, number:1, module:'Conv', args:[64, 6, 2, 2]
        m = eval(m) if isinstance(m, str) else m  # eval strings, m:<class 'models.common.Conv'>
        for j, a in enumerate(args):
            try:
                args[j] = eval(a) if isinstance(a, str) else a  # eval strings, [64, 6, 2, 2]
            except NameError:
                pass

        n = n_ = max(round(n * gd), 1) if n > 1 else n  # depth gain
        if m in (Conv, GhostConv, Bottleneck, GhostBottleneck, SPP, SPPF, DWConv, MixConv2d, Focus, CrossConv,
                 BottleneckCSP, C3, C3TR, C3SPP, C3Ghost):
            c1, c2 = ch[f], args[0] # c1:3, c2:64
            if c2 != no:  # if not output
                c2 = make_divisible(c2 * gw, 8) # c2:32

            args = [c1, c2, *args[1:]] # args[3, 32, 6, 2, 2]
            if m in [BottleneckCSP, C3, C3TR, C3Ghost]:
                args.insert(2, n)  # number of repeats
                n = 1
        elif m is nn.BatchNorm2d:
            args = [ch[f]]
        elif m is Concat:
            c2 = sum(ch[x] for x in f)
        elif m is Detect:
            args.append([ch[x] for x in f])
            if isinstance(args[1], int):  # number of anchors
                args[1] = [list(range(args[1] * 2))] * len(f)
        elif m is Contract:
            c2 = ch[f] * args[0] ** 2
        elif m is Expand:
            c2 = ch[f] // args[0] ** 2
        else:
            c2 = ch[f]

        m_ = nn.Sequential(*(m(*args) for _ in range(n))) if n > 1 else m(*args)  # module
        t = str(m)[8:-2].replace('__main__.', '')  # module type
        np = sum(x.numel() for x in m_.parameters())  # number params
        m_.i, m_.f, m_.type, m_.np = i, f, t, np  # attach index, 'from' index, type, number params
        LOGGER.info(f'{i:>3}{str(f):>18}{n_:>3}{np:10.0f}  {t:<40}{str(args):<30}')  # print
        save.extend(x % i for x in ([f] if isinstance(f, int) else f) if x != -1)  # append to savelist
        layers.append(m_)
        if i == 0:
            ch = []
        ch.append(c2) # [32],[32,64],[32,64,64]
    return nn.Sequential(*layers), sorted(save) # [6, 4, 14, 10, 17, 20, 23] -> [4, 6, 10, 14, 17, 20, 23]


if __name__ == '__main__':
    parser = argparse.ArgumentParser()
    parser.add_argument('--cfg', type=str, default='yolov5s.yaml', help='model.yaml')
    parser.add_argument('--batch-size', type=int, default=1, help='total batch size for all GPUs')
    parser.add_argument('--device', default='', help='cuda device, i.e. 0 or 0,1,2,3 or cpu')
    parser.add_argument('--profile', action='store_true', help='profile model speed')
    parser.add_argument('--line-profile', action='store_true', help='profile model speed layer by layer')
    parser.add_argument('--test', action='store_true', help='test all yolo*.yaml')
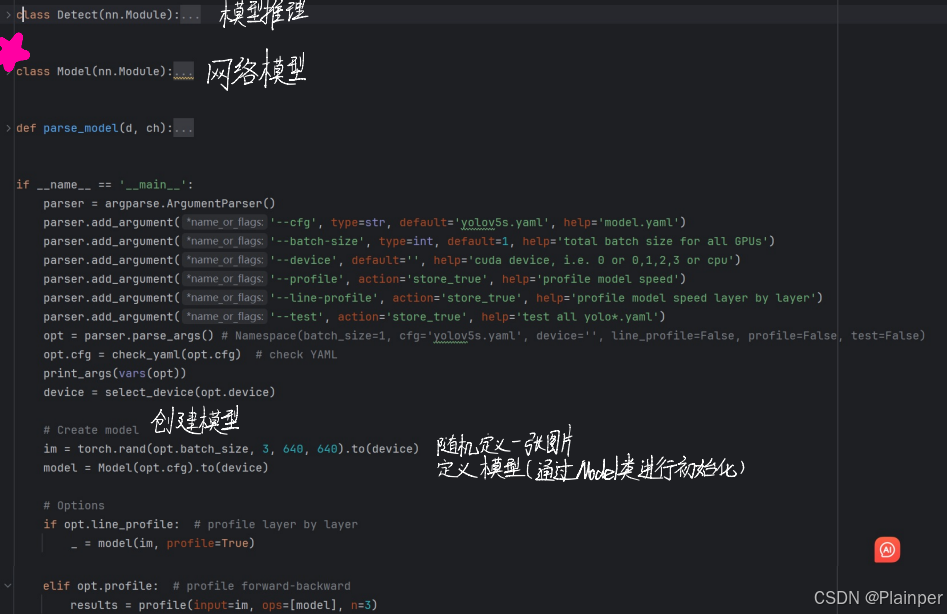
    opt = parser.parse_args() # Namespace(batch_size=1, cfg='yolov5s.yaml', device='', line_profile=False, profile=False, test=False)
    opt.cfg = check_yaml(opt.cfg)  # check YAML
    print_args(vars(opt))
    device = select_device(opt.device)

    # Create model
    im = torch.rand(opt.batch_size, 3, 640, 640).to(device)
    model = Model(opt.cfg).to(device)

    # Options
    if opt.line_profile:  # profile layer by layer
        _ = model(im, profile=True)

    elif opt.profile:  # profile forward-backward
        results = profile(input=im, ops=[model], n=3)

    elif opt.test:  # test all models
        for cfg in Path(ROOT / 'models').rglob('yolo*.yaml'):
            try:
                _ = Model(cfg)
            except Exception as e:
                print(f'Error in {cfg}: {e}')

    else:  # report fused model summary
        model.fuse()
//////////////////////////////////////////
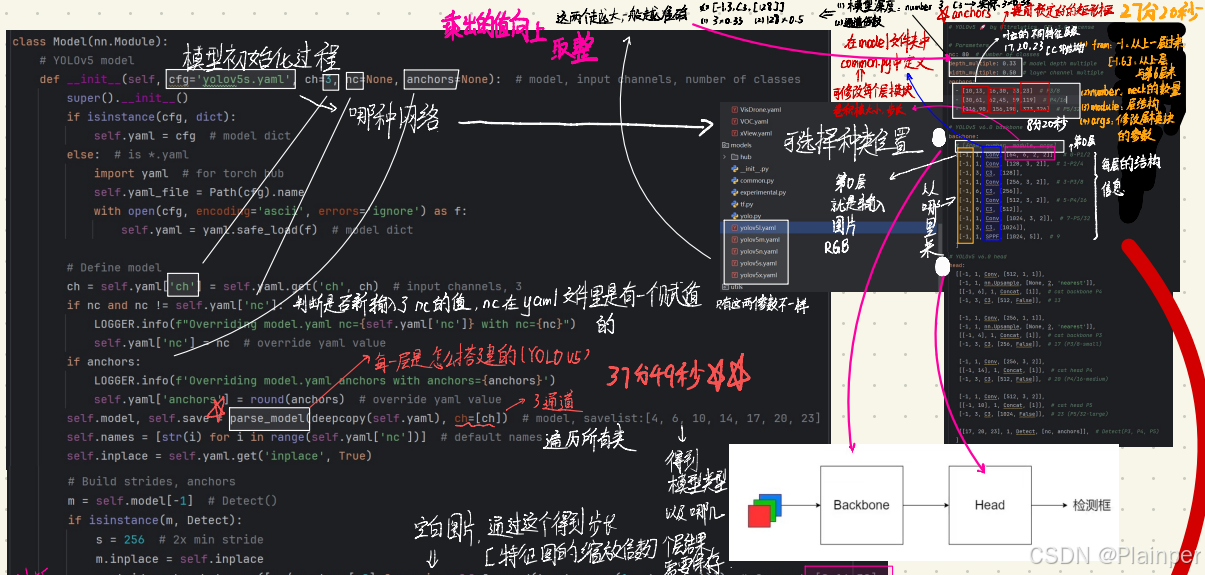
网络模型的具体储存文件--common.py:
不展示全部,可以自己根据代码查看
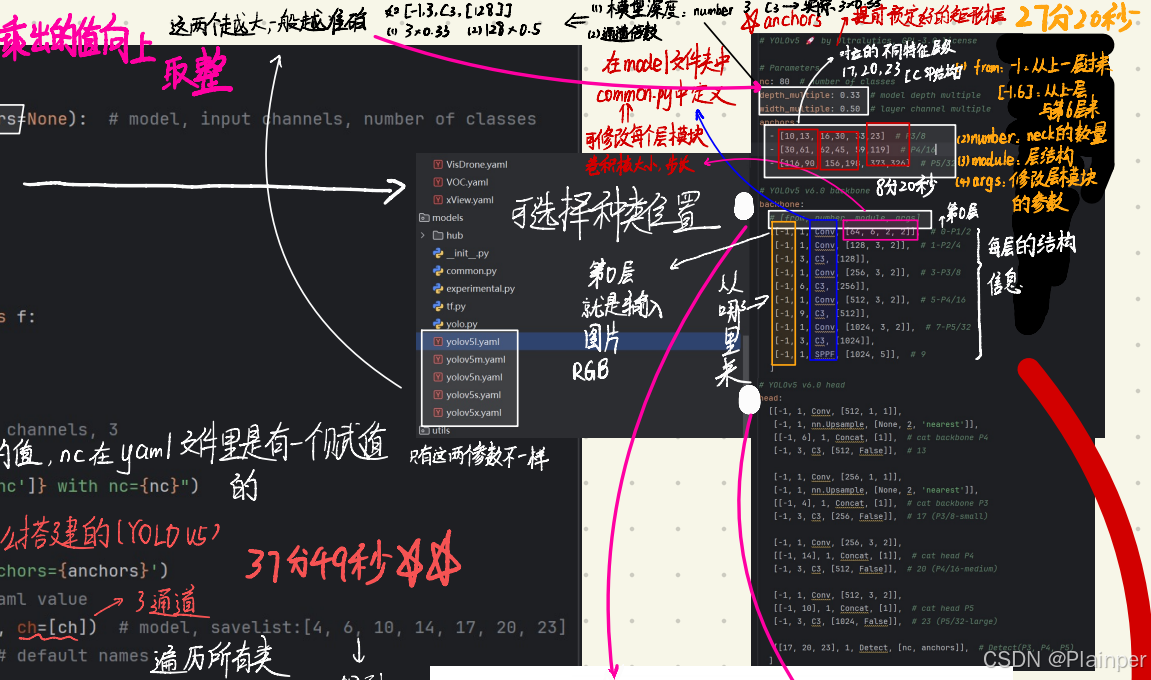
以yolov5s.yaml为例:
YAML(YAML Ain't Markup Language)是一种用于配置文件的人可读的数据序列化格式
anchor:是检测框的大小(原图的像素点坐标)(有三个,每个里面又有多个参数组合,三个分别对应检测大,中,小)
类别概率 不等于 置信度
(置信度:检测框中存在目标的概率)
# YOLOv5 🚀 by Ultralytics, GPL-3.0 license

# Parameters
nc: 80  # number of classes
//nc 参数代表“number of classes”,即数据集中的类别数量。这个参数告诉模型在进行目标检测时需要识别多少个不同的目标类别。
以下是对nc: 80参数的解释:
nc:类别数量。
80:具体数值,表示模型被训练来识别80个不同的目标类别。
例如,在目标检测任务中,如果数据集包含了80个不同的目标类别,如各种类型的车辆、动物、物体等,那么nc就应该设置为80。模型会为每个类别输出一个概率分数,用于确定检测到的目标属于哪个类别。

depth_multiple: 0.33  # model depth multiple
width_multiple: 0.50  # layer channel multiple
//会乘以number作为实际neck数量,每个yolo(.x,.s.等)只有这个参数的大小不同
depth multiple
含义:模型深度倍数(depth multiple),用于控制模型的深度,即网络层的数量。
作用:通过调整depth_multiple的值,可以增加或减少模型中层的数量。较小的值会减少层数,从而降低模型的复杂度和计算量,适合在资源受限的环境中使用。较大的值会增加层数,可能提高模型的性能,但同时也会提高计算资源的需求。

width_multiple:
含义:层通道倍数(layer channel multiple),用于控制模型中每层的通道数。
作用:通过调整width_multiple的值,可以增加或减少模型中每层的通道数。较小的值会减少通道数,从而降低模型的参数数量和计算量。较大的值会增加通道数,可能提高模型的性能,但同时也会提高计算资源的需求

anchors:
  - [10,13, 16,30, 33,23]  # P3/8
  - [30,61, 62,45, 59,119]  # P4/16
  - [116,90, 156,198, 373,326]  # P5/32
//检测框大小(三个)
在YOLOv5模型中,anchors参数定义了用于目标检测的锚点(anchor)尺寸。这些锚点用于预测目标的边界框(bounding boxes),它们是模型在训练过程中学习到的先验知识,用于初始化边界框的尺寸。
每个YOLOv5模型都有多个尺度的特征图(例如P3、P4、P5),这些特征图对应于不同大小的目标检测。anchors列表中的每个子列表对应于一个特定的特征图,包含了该特征图上每个单元格(anchor box)的宽度和高度。
# YOLOv5 v6.0 backbone backbone: # [from, number, module, args] [[-1, 1, Conv, [64, 6, 2, 2]], # 0-P1/2 [-1, 1, Conv, [128, 3, 2]], # 1-P2/4 [-1, 3, C3, [128]], [-1, 1, Conv, [256, 3, 2]], # 3-P3/8 [-1, 6, C3, [256]], [-1, 1, Conv, [512, 3, 2]], # 5-P4/16 [-1, 9, C3, [512]], [-1, 1, Conv, [1024, 3, 2]], # 7-P5/32 [-1, 3, C3, [1024]], [-1, 1, SPPF, [1024, 5]], # 9 ] //[-1, 1, Conv, [64, 6, 2, 2]]:第0层是一个卷积层,输入来自前一层(-1表示前一层),重复1次,参数为[64, 6, 2, 2],分别表示输出通道数为64,卷积核大小为6x6,步长为2,填充为2。 [-1, 1, Conv, [128, 3, 2]]:第1层是一个卷积层,输入来自前一层,重复1次,参数为[128, 3, 2],表示输出通道数为128,卷积核大小为3x3,步长为2。 [-1, 3, C3, [128]]:第2层是一个C3模块,输入来自前一层,重复3次,参数为[128],表示该模块的输入通道数为128。 [-1, 1, Conv, [256, 3, 2]]:第3层是一个卷积层,输入来自前一层,重复1次,参数为[256, 3, 2],表示输出通道数为256,卷积核大小为3x3,步长为2。 [-1, 6, C3, [256]]:第4层是一个C3模块,输入来自前一层,重复6次,参数为[256],表示该模块的输入通道数为256。 [-1, 1, Conv, [512, 3, 2]]:第5层是一个卷积层,输入来自前一层,重复1次,参数为[512, 3, 2],表示输出通道数为512,卷积核大小为3x3,步长为2。 [-1, 9, C3, [512]]:第6层是一个C3模块,输入来自前一层,重复9次,参数为[512],表示该模块的输入通道数为512。 [-1, 1, Conv, [1024, 3, 2]]:第7层是一个卷积层,输入来自前一层,重复1次,参数为[1024, 3, 2],表示输出通道数为1024,卷积核大小为3x3,步长为2。 [-1, 3, C3, [1024]]:第8层是一个C3模块,输入来自前一层,重复3次,参数为[1024],表示该模块的输入通道数为1024。 [-1, 1, SPPF, [1024, 5]]:第9层是一个SPPF层,输入来自前一层,重复1次,参数为[1024, 5],表示该层的输入通道数为1024,使用了5x5的空间金字塔池化 from:是从哪里来。-1就是上一层,[-1,6]从上一层于第六层传入数据 number:表示重复次数,即当前类型的层将会连续堆叠的次数。 module:指定了层的类型,例如Conv表示卷积层,C3表示C3模块(一种YOLOv5中使用的复合层), SPPF表示空间金字塔池化和特征融合层。 args:是传递给module的参数列表,具体含义取决于module的类型 # YOLOv5 v6.0 head head: [[-1, 1, Conv, [512, 1, 1]], [-1, 1, nn.Upsample, [None, 2, 'nearest']], [[-1, 6], 1, Concat, [1]], # cat backbone P4 [-1, 3, C3, [512, False]], # 13 [-1, 1, Conv, [256, 1, 1]], [-1, 1, nn.Upsample, [None, 2, 'nearest']], [[-1, 4], 1, Concat, [1]], # cat backbone P3 [-1, 3, C3, [256, False]], # 17 (P3/8-small) [-1, 1, Conv, [256, 3, 2]], [[-1, 14], 1, Concat, [1]], # cat head P4 [-1, 3, C3, [512, False]], # 20 (P4/16-medium) [-1, 1, Conv, [512, 3, 2]], [[-1, 10], 1, Concat, [1]], # cat head P5 [-1, 3, C3, [1024, False]], # 23 (P5/32-large) [[17, 20, 23], 1, Detect, [nc, anchors]], # Detect(P3, P4, P5) ] [-1, 1, Conv, [512, 1, 1]]:第0层是一个卷积层,输入来自前一层,重复1次,参数为[512, 1, 1],表示输出通道数为512,卷积核大小为1x1,步长为1。 [-1, 1, nn.Upsample, [None, 2, 'nearest']]:第1层是一个上采样层,输入来自前一层,重复1次,参数为[None, 2, 'nearest'],表示将特征图的尺寸放大两倍,使用最近邻插值。 [[-1, 6], 1, Concat, [1]]:第2层是一个连接层,输入来自前一层和第6层的输出,重复1次,参数为[1],表示沿着通道维度(维度1)进行连接。 [-1, 3, C3, [512, False]]:第3层是一个C3模块,输入来自前一层,重复3次,参数为[512, False],表示该模块的输入通道数为512,不使用SE模块(Squeeze-and-Excitation)。 [-1, 1, Conv, [256, 1, 1]]:第4层是一个卷积层,输入来自前一层,重复1次,参数为[256, 1, 1],表示输出通道数为256,卷积核大小为1x1,步长为1。 [-1, 1, nn.Upsample, [None, 2, 'nearest']]:第5层是一个上采样层,输入来自前一层,重复1次,参数为[None, 2, 'nearest'],表示将特征图的尺寸放大两倍,使用最近邻插值。 [[-1, 4], 1, Concat, [1]]:第6层是一个连接层,输入来自前一层和第4层的输出,重复1次,参数为[1],表示沿着通道维度进行连接。 [-1, 3, C3, [256, False]]:第7层是一个C3模块,输入来自前一层,重复3次,参数为[256, False],表示该模块的输入通道数为256,不使用SE模块。 [-1, 1, Conv, [256, 3, 2]]:第8层是一个卷积层,输入来自前一层,重复1次,参数为[256, 3, 2],表示输出通道数为256,卷积核大小为3x3,步长为2。 [[-1, 14], 1, Concat, [1]]:第9层是一个连接层,输入来自前一层和第14层的输出,重复1次,参数为[1],表示沿着通道维度进行连接。 [-1, 3, C3, [512, False]]:第10层是一个C3模块,输入来自前一层,重复3次,参数为[512, False],表示该模块的输入通道数为512,不使用SE模块。 [-1, 1, Conv, [512, 3, 2]]:第11层是一个卷积层,输入来自前一层,重复1次,参数为[512, 3, 2],表示输出通道数为512,卷积核大小为3x3,步长为2。 [[-1, 10], 1, Concat, [1]]:第12层是一个连接层,输入来自前一层和第10层的输出,重复1次,参数为[1],表示沿着通道维度进行连接。 [-1, 3, C3, [1024, False]]:第13层是一个C3模块,输入来自前一层,重复3次,参数为[1024, False],表示该模块的输入通道数为1024,不使用SE模块。 [[17, 20, 23], 1, Detect, [nc, anchors]]:第14层是一个检测层,输入来自第17层、第20层和第23层的输出,重复1次,参数为[nc, anchors],表示类别数为nc,使用的锚点尺寸为anchors。
11.YOLOv5中需要调节参数:
(1)detect.py:
run部分参数:
def run(
weights=ROOT / 'yolov5s.pt', # 模型权重文件的路径
source=ROOT / 'data/images', # 输入源路径,可以是文件、目录、URL或通配符,0表示使用摄像头
data=ROOT / 'data/coco128.yaml', # 数据集配置文件路径
imgsz=(640, 640), # 推理时的图像尺寸(高度,宽度)与LoadImages里面的转化对应
imgsz参数确保了所有输入图像都被调整到模型期望的尺寸,以便进行有效的推理参数im处理后的图像,im0z:原图
conf_thres=0.25, # 置信度阈值只有当模型对其检测到的目标的置信度高于25%时,该检测结果才会被考虑为有效。这个阈值的作用是过滤掉那些模型不太确定的预测,从而减少误检并提高检测的准确性。通过调整这个阈值,可以在检测的精确度和召回率之间进行权衡:提高阈值可以减少误检,但可能会错过一些实际存在的目标;降低阈值可以增加检测到的目标数量,但同时也会引入更多的误检
iou_thres=0.45, # 非最大抑制(NMS)的IOU阈值IOU计算:IOU是衡量两个边界框重叠程度的指标,计算公式为两个边界框的交集面积除以它们的并集面积。IOU值的范围在0到1之间,值越接近1表示重叠程度越高。
NMS过程:
在目标检测模型输出一系列边界框后,NMS会根据iou_thres参数来决定哪些框应该被保留或抑制。NMS首先会根据置信度(confidence score)对所有边界框进行排序,保留置信度最高的框,然后检查与该框IOU值超过iou_thres的其他框。如果某个框与已保留框的IOU值超过iou_thres,则该框会被抑制(即从结果中移除)
阈值选择:iou_thres的值对NMS的效果有很大影响。
较高的iou_thres值(如0.5或更高)会使得只有高度重叠的框被抑制,这可能导致更多的框被保留,但也可能保留了一些不必要的重叠框。
较低的iou_thres值(如0.3或更低)会使得更多的框被抑制,这有助于去除更多的重叠框,但也可能错误地抑制了一些实际上包含不同目标的框。
max_det=1000, # 每张图片最大检测数量参数用于限制每张图片上检测到的目标数量
device='', # 指定使用的设备,例如GPU('0' 或 '0,1,2,3')或CPU('cpu')
view_img=False, # 是否显示结果
save_txt=False, # 是否将结果保存到*.txt文件
save_conf=False, # 是否在保存的txt文件中包含置信度
save_crop=False, # 是否保存裁剪的预测框
nosave=False, # 是否不保存图像/视频
classes=None, # 按类别过滤,例如 --classes 0 或 --classes 0 2 3用户可以通过指定
classes参数来选择模型应该检测的目标类别。例如,如果数据集中有80个类别,用户只想检测类别ID为0、2和3的目标,可以将classes设置为[0, 2, 3]。在检测过程中,模型会根据classes参数的值来过滤检测结果,只保留指定类别的检测框。agnostic_nms=False, # 无类别NMS
augment=False, # 增强推理
visualize=False, # 特征可视化
update=False, # 更新所有模型
project=ROOT / 'runs/detect', # 保存结果的项目/名称
name='exp', # 保存结果的项目/名称
exist_ok=False, # 如果项目/名称已存在,是否不增加编号
line_thickness=3, # 边界框线条厚度(像素)
hide_labels=False, # 隐藏标签
hide_conf=False, # 隐藏置信度
half=False, # 使用FP16半精度推理FP32(全精度):标准的单精度浮点数,提供较高的数值精度。
FP16(半精度):使用一半的比特数来表示浮点数,因此数值精度较低,但计算速度更快,内存占用更少。
dnn=False # 使用OpenCV DNN进行ONNX推理
dnn:一个布尔值参数,用于控制是否通过OpenCV的DNN模块进行ONNX模型的推理。
False:默认值,表示不使用OpenCV的DNN模块,而是可能使用其他推理引擎,如直接使用ONNX Runtime、TensorRT或其他深度学习框架的原生推理引擎。OpenCV DNN模块:OpenCV提供了一个DNN模块,可以加载和执行多种深度学习框架训练的模型,包括Caffe、TensorFlow、Torch/PyTorch和ONNX等格式。
ONNX推理:ONNX(Open Neural Network Exchange)是一个开放的格式,用于表示深度学习模型,允许模型在不同的框架和工具之间转换和使用。
):
(2)yolo.py:
基本很少调
parser = argparse.ArgumentParser()
parser.add_argument('--cfg', type=str, default='yolov5s.yaml', help='model.yaml')
'yolov5s.yaml'选择哪个模型
parser.add_argument('--batch-size', type=int, default=1, help='total batch size for all GPUs')
批次大小(batch size),指的是在机器学习训练过程中,每次迭代(iteration)或每次梯度更新时用于计算损失函数和更新模型参数的样本数量,如果是图片就为每次输入为一张图片
parser.add_argument('--device', default='', help='cuda device, i.e. 0 or 0,1,2,3 or cpu')
parser.add_argument('--profile', action='store_true', help='profile model speed')
parser.add_argument('--line-profile', action='store_true', help='profile model speed layer by layer')
parser.add_argument('--test', action='store_true', help='test all yolo*.yaml')
yolov5s.yaml:
基本不调,但需要注意:
# YOLOv5 模型配置参数
# nc (number of classes): 表示模型被训练来识别的类别数量。
# 在COCO数据集中,有80个不同的类别,例如人、汽车、椅子等。
nc: 80nc (类别数量):这个参数设置了模型需要识别的目标类别总数。例如,在COCO数据集中,有80个类别,所以这里设置为80。
# depth_multiple (model depth multiple): 用于调整模型的深度。
# 这是一个乘数,用于缩放模型中所有层的深度。
# 较小的值意味着模型更浅,可能会减少计算量和模型大小,但也可能影响性能。
depth_multiple: 0.33depth_multiple (模型深度倍数):用于调整模型的深度。它是一个缩放因子,用于改变模型中所有层的深度。通过调整这个值,可以创建不同深度的模型版本,从而影响模型的复杂度和性能。
# width_multiple (layer channel multiple): 用于调整模型的宽度,即每层的通道数。
# 与depth_multiple类似,它也是一个乘数,用于缩放模型中所有层的通道数。
# 调整这个值可以改变模型的复杂度和计算需求。
width_multiple: 0.50width_multiple (层通道倍数):这个参数用于调整模型的宽度,即每层的通道数。它也是一个缩放因子,用于改变模型中所有层的通道数。调整这个值可以改变模型的复杂度和计算需求。
# anchors (锚点): YOLOv5用于目标检测的关键组件,它们是预定义的边界框,用于预测目标的位置和尺寸。
# 锚点的尺寸通常根据数据集中目标的尺寸分布来选择。
anchors:
# P3/8层的特征图上使用的锚点尺寸。
# 每个数字代表一个锚点的宽度和高度。
- [10,13, 16,30, 33,23] # P3/8
# P4/16层的特征图上使用的锚点尺寸。
# 这些锚点尺寸较大,用于检测更大尺寸的目标。
- [30,61, 62,45, 59,119] # P4/16
# P5/32层的特征图上使用的锚点尺寸。
# 这些锚点尺寸最大,用于检测图像中最大的目标。
- [116,90, 156,198, 373,326] # P5/32anchors (锚点):锚点是YOLOv5用于目标检测的关键组件,它们是预定义的边界框,用于预测目标的位置和尺寸。这些锚点的尺寸通常根据数据集中目标的尺寸分布来选择,以提高检测的准确性。
- P3/8层的锚点:这些锚点用于P3/8层的特征图,每个数字代表一个锚点的宽度和高度。
- P4/16层的锚点:这些锚点用于P4/16层的特征图,尺寸较大,用于检测更大尺寸的目标。
- P5/32层的锚点:这些锚点用于P5/32层的特征图,尺寸最大,用于检测图像中最大的目标
coco128.yaml
# YOLOv5 🚀 by Ultralytics, GPL-3.0 license
# COCO128 dataset https://www.kaggle.com/ultralytics/coco128 (first 128 images from COCO train2017) by Ultralytics
# Example usage: python train.py --data coco128.yaml
# parent
# ├── yolov5
# └── datasets
#     └── coco128  ← downloads here (7 MB)


# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: ../datasets/coco128  # dataset root dir
train: images/train2017  # train images (relative to 'path') 128 images
val: images/train2017  # val images (relative to 'path') 128 images
test:  # test images (optional)

# Classes
nc: 80  # number of classes
names: ['person', 'bicycle', 'car', 'motorcycle', 'airplane', 'bus', 'train', 'truck', 'boat', 'traffic light',
        'fire hydrant', 'stop sign', 'parking meter', 'bench', 'bird', 'cat', 'dog', 'horse', 'sheep', 'cow',
        'elephant', 'bear', 'zebra', 'giraffe', 'backpack', 'umbrella', 'handbag', 'tie', 'suitcase', 'frisbee',
        'skis', 'snowboard', 'sports ball', 'kite', 'baseball bat', 'baseball glove', 'skateboard', 'surfboard',
        'tennis racket', 'bottle', 'wine glass', 'cup', 'fork', 'knife', 'spoon', 'bowl', 'banana', 'apple',
        'sandwich', 'orange', 'broccoli', 'carrot', 'hot dog', 'pizza', 'donut', 'cake', 'chair', 'couch',
        'potted plant', 'bed', 'dining table', 'toilet', 'tv', 'laptop', 'mouse', 'remote', 'keyboard', 'cell phone',
        'microwave', 'oven', 'toaster', 'sink', 'refrigerator', 'book', 'clock', 'vase', 'scissors', 'teddy bear',
        'hair drier', 'toothbrush']  # class names


# Download script/URL (optional)
download: https://ultralytics.com/assets/coco128.zip
(3)train.py:
opt:
def parse_opt(known=False):
    parser = argparse.ArgumentParser()
    parser.add_argument('--weights', type=str, default=ROOT / 'yolov5s.pt', help='initial weights path')
--weights:模型初始权重的路径。

    parser.add_argument('--cfg', type=str, default='', help='model.yaml path')
--cfg:模型配置文件的路径,通常是 .yaml

    parser.add_argument('--data', type=str, default=ROOT / 'data/coco128.yaml', help='dataset.yaml path')
--data:数据集配置文件的路径,也是 .yaml 文件

    parser.add_argument('--hyp', type=str, default=ROOT / 'data/hyps/hyp.scratch-low.yaml', help='hyperparameters path')
--hyp:超参数配置文件的路径

    parser.add_argument('--epochs', type=int, default=300)
--epochs:训练的总周期数

    parser.add_argument('--batch-size', type=int, default=16, help='total batch size for all GPUs, -1 for autobatch')
--batch-size:所有GPU的总批次大小,设置为 -1 时会自动调整批次大小

    parser.add_argument('--imgsz', '--img', '--img-size', type=int, default=640, help='train, val image size (pixels)')
--imgsz 或 --img 或 --img-size:训练和验证时图像的大小(像素)

    parser.add_argument('--rect', action='store_true', help='rectangular training')
    parser.add_argument('--resume', nargs='?', const=True, default=False, help='resume most recent training')
--resume:是否从最近的检查点恢复训练
这个很有用,如果电脑训练到一半死机了,在这个是True时可以接着训练之前没有训练完的

    parser.add_argument('--nosave', action='store_true', help='only save final checkpoint')
--nosave:是否只保存最终的检查点。

    parser.add_argument('--noval', action='store_true', help='only validate final epoch')
--noval:是否只在最后一个周期进行验证

    parser.add_argument('--noautoanchor', action='store_true', help='disable AutoAnchor')
--noautoanchor:是否禁用自动锚点调整

    parser.add_argument('--noplots', action='store_true', help='save no plot files')
--noplots:是否不保存绘图文件

    parser.add_argument('--evolve', type=int, nargs='?', const=300, help='evolve hyperparameters for x generations')
--evolve:用于进化算法,进化超参数的代数

    parser.add_argument('--bucket', type=str, default='', help='gsutil bucket')
--bucket:用于 gsutil 的存储桶

    parser.add_argument('--cache', type=str, nargs='?', const='ram', help='--cache images in "ram" (default) or "disk"')
--cache:图像缓存的位置,可以是内存(ram)或硬盘

    parser.add_argument('--image-weights', action='store_true', help='use weighted image selection for training')
--image-weights:是否使用加权图像选择进行训练

    parser.add_argument('--device', default='', help='cuda device, i.e. 0 or 0,1,2,3 or cpu')
--device:指定使用的设备,如 cpu 或 GPU编号

    parser.add_argument('--multi-scale', action='store_true', help='vary img-size +/- 50%%')
--multi-scale:是否在训练中变化图像大小±50%

    parser.add_argument('--single-cls', action='store_true', help='train multi-class data as single-class')
--single-cls:是否将多类别数据作为单类别数据训练

    parser.add_argument('--optimizer', type=str, choices=['SGD', 'Adam', 'AdamW'], default='SGD', help='optimizer')
--optimizer:选择优化器,如SGD、Adam或AdamW

    parser.add_argument('--sync-bn', action='store_true', help='use SyncBatchNorm, only available in DDP mode')
--sync-bn:是否使用同步批量归一化

    parser.add_argument('--workers', type=int, default=8, help='max dataloader workers (per RANK in DDP mode)')
--workers:数据加载器的最大工作线程数

    parser.add_argument('--project', default=ROOT / 'runs/train', help='save to project/name')
--project:保存项目的路径

    parser.add_argument('--name', default='exp', help='save to project/name')
--name:实验的名称

    parser.add_argument('--exist-ok', action='store_true', help='existing project/name ok, do not increment')
--exist-ok:如果项目/名称已存在,是否允许继续使用

    parser.add_argument('--quad', action='store_true', help='quad dataloader')
--quad:是否使用四倍数据加载器

    parser.add_argument('--cos-lr', action='store_true', help='cosine LR scheduler')
--cos-lr:是否使用余弦学习率调度器

    parser.add_argument('--label-smoothing', type=float, default=0.0, help='Label smoothing epsilon')
--label-smoothing:标签平滑的epsilon值

    parser.add_argument('--patience', type=int, default=100, help='EarlyStopping patience (epochs without improvement)')
--patience:早停策略的耐心值

    parser.add_argument('--freeze', nargs='+', type=int, default=[0], help='Freeze layers: backbone=10, first3=0 1 2')
--freeze:冻结特定层的参数

    parser.add_argument('--save-period', type=int, default=-1, help='Save checkpoint every x epochs (disabled if < 1)')
--save-period:每多少周期保存一次检查点。每 x 个训练周期保存一次模型检查点;如果值小于 1,则该功能被禁用。

    parser.add_argument('--local_rank', type=int, default=-1, help='DDP parameter, do not modify')
--local_rank:分布式数据并行(DDP)的局部排名,通常不需要手动设置

    # Weights & Biases arguments
    parser.add_argument('--entity', default=None, help='W&B: Entity')
    parser.add_argument('--upload_dataset', nargs='?', const=True, default=False, help='W&B: Upload data, "val" option')
    parser.add_argument('--bbox_interval', type=int, default=-1, help='W&B: Set bounding-box image logging interval')
    parser.add_argument('--artifact_alias', type=str, default='latest', help='W&B: Version of dataset artifact to use')

    opt = parser.parse_known_args()[0] if known else parser.parse_args()
    return opt
hyp超参数:
lr0: 0.01  # initial learning rate (SGD=1E-2, Adam=1E-3)
初始学习率。对于SGD优化器通常设置为1E-2,对于Adam优化器设置为1E-3
初始学习率是训练开始时用于更新模型权重的步长。如果初始学习率设置得太高,可能会导致训练过程中的不稳定性,模型可能无法收敛。如果初始学习率太低,则可能导致训练过程缓慢,甚至陷入局部最优解
影响:
收敛速度:初始学习率直接影响模型的收敛速度。适当的初始学习率可以加快收敛速度,而不适当的初始学习率可能导致训练过程缓慢或不收敛。
模型性能:初始学习率的选择也会影响模型的最终性能。一个合适的初始学习率可以帮助模型更好地学习数据特征,提高模型的泛化能力


lrf: 0.01  # final OneCycleLR learning rate (lr0 * lrf)
最终OneCycleLR学习率,通常为初始学习率lr0的一个分数

momentum: 0.937  # SGD momentum/Adam beta1
SGD优化器的动量参数,或者Adam优化器的beta1参数

weight_decay: 0.0005  # optimizer weight decay 5e-4
优化器的权重衰减参数,用于正则化以减少过拟合

warmup_epochs: 3.0  # warmup epochs (fractions ok)
热身训练周期数,用于在训练初期逐渐增加学习率和动量

warmup_momentum: 0.8  # warmup initial momentum
热身训练初期的动量值

warmup_bias_lr: 0.1  # warmup initial bias lr
热身训练初期的偏置学习率

box: 0.05  # box loss gain
边界框损失的权重
含义:box指的是边界框损失(bounding box loss)的权重,它控制了边界框预测误差在总损失中的比重。
作用:边界框损失通常涉及到预测框(predicted bounding box)和真实框(ground truth bounding box)之间的差异,包括中心点坐标、宽度和高度。通过调整box的值,可以影响模型在训练过程中对边界框精确度的关注程度。

cls: 0.5  # cls loss gain
分类损失的权重
含义:cls指的是分类损失(classification loss)的权重,它控制了类别预测误差在总损失中的比重。
作用:分类损失涉及到模型对于每个边界框内物体类别的预测准确性。调整cls的值可以影响模型在训练过程中对类别分类准确性的关注程度

cls_pw: 1.0  # cls BCELoss positive_weight
分类损失中正样本的权重

obj: 1.0  # obj loss gain (scale with pixels)
目标损失的权重,与像素值成比例

obj_pw: 1.0  # obj BCELoss positive_weight
目标损失中正样本的权重

iou_t: 0.20  # IoU training threshold
IoU训练阈值,用于确定正负样本

anchor_t: 4.0  # anchor-multiple threshold
锚点多重阈值

# anchors: 3  # anchors per output layer (0 to ignore)
锚点(Anchors):在目标检测中,锚点是一组预定义的边界框,它们具有不同的尺寸和比例。模型通过调整这些锚点来预测目标的真实边界框。
多尺度检测:不同的输出层可能对应于不同的尺度(例如,YOLOv5中的P3、P4、P5层),每个层级负责检测不同大小的目标。因此,每个输出层可能需要不同尺寸的锚点来适应该层级的目标尺寸。

fl_gamma: 0.0  # focal loss gamma (efficientDet default gamma=1.5)
Focal Loss的gamma参数,用于解决类别不平衡问题

hsv_h: 0.015  # image HSV-Hue augmentation (fraction)
hsv_s: 0.7  # image HSV-Saturation augmentation (fraction)
hsv_v: 0.4  # image HSV-Value augmentation (fraction)
HSV色彩空间中的色调、饱和度、亮度增强参数

degrees: 0.0  # image rotation (+/- deg)
图像旋转增强的度数范围

translate: 0.1  # image translation (+/- fraction)
图像平移增强的比例范围

scale: 0.5  # image scale (+/- gain)
图像缩放增强的增益范围

shear: 0.0  # image shear (+/- deg)
图像剪切增强的度数范围

perspective: 0.0  # image perspective (+/- fraction), range 0-0.001
图像透视增强的分数范围

flipud: 0.0  # image flip up-down (probability)
图像上下翻转的概率

fliplr: 0.5  # image flip left-right (probability)
图像左右翻转的概率

mosaic: 1.0  # image mosaic (probability)
图像马赛克增强的概率

mixup: 0.0  # image mixup (probability)
图像混合增强的概率

copy_paste: 0.0  # segment copy-paste (probability)
图像复制粘贴增强的概率
12.YOLOv5具体操作流程以及边缘检测:

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 21
 0
- 0


 已为社区贡献2条内容

所有评论(0)