JS数据结构和算法(第五天)
一、树
1. 树结构对比于数组/链表/哈希表有哪些优势呢?
数组:
- 优点:可以通过下标值访问,效率高;
- 缺点:查找数据时需要先对数据进行排序,生成有序数组,才能提高查找效率;并且在插入和删除元素时,需要大量的位移操作;
链表:
- 优点:数据的插入和删除操作效率都很高;
- 缺点:查找效率低,需要从头开始依次查找,直到找到目标数据为止;当需要在链表中间位置插入或删除数据时,插入或删除的效率都不高。
哈希表:
- 优点:哈希表的插入/查询/删除效率都非常高;
- 缺点:空间利用率不高,底层使用的数组中很多单元没有被利用;并且哈希表中的元素是无序的,不能按照固定顺序遍历哈希表中的元素;而且不能快速找出哈希表中最大值或最小值这些特殊值。
树结构:
- 优点:树结构综合了上述三种结构的优点,同时也弥补了它们存在的缺点(虽然效率不一定都比它们高),比如树结构中数据都是有序的,查找效率高;空间利用率高;并且可以快速获取最大值和最小值等。
总的来说:每种数据结构都有自己特定的应用场景。
树结构:
树(Tree):由 n(n ≥ 0)个节点构成的有限集合。当 n = 0 时,称为空树。
对于任意一棵非空树(n > 0),它具备以下性质:
- 数中有一个称为根(Root)的特殊节点,用 r 表示;
- 其余节点可分为 m(m > 0)个互不相交的有限集合T1,T2,…,Tm,其中每个集合本身又是一棵树,称为原来树的子树(SubTree)。
树的常用术语:
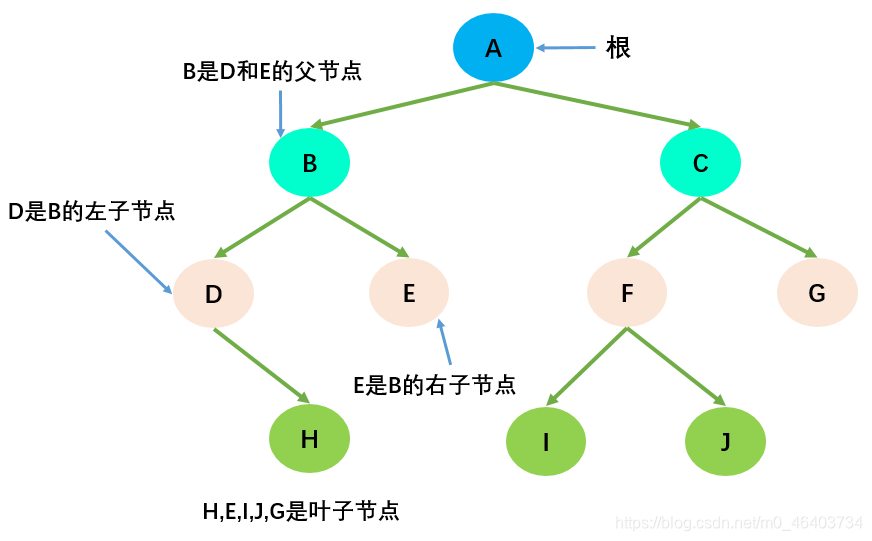
- 节点的度(Degree):节点的子树个数,比如节点 B 的度为 2;
- 树的度:树的所有节点中最大的度数,如上图树的度为 2;
- 叶节点(Leaf):度为 0 的节点(也称为叶子节点),如上图的 H,I 等;
- 父节点(Parent):度不为 0 的节点称为父节点,如上图节点 B 是节点 D 和 E 的父节点;
- 子节点(Child):若 B 是 D 的父节点,那么 D 就是 B 的子节点;
- 兄弟节点(Sibling):具有同一父节点的各节点彼此是兄弟节点,比如上图的 B 和 C,D 和 E 互为兄弟节点;
- 路径和路径长度:路径指的是一个节点到另一节点的通道,路径所包含边的个数称为路径长度,比如 A->H 的路径长度为 3;
- 节点的层次(Level):规定根节点在 1 层,其他任一节点的层数是其父节点的层数加 1。如 B 和 C 节点的层次为 2;
- 树的深度(Depth):树种所有节点中的最大层次是这棵树的深度,如上图树的深度为 4;
2. 二叉树
二叉树的概念:如果树中的每一个节点最多只能由两个子节点,这样的树就称为二叉树;
二叉树的组成:
- 二叉树可以为空,也就是没有节点;
- 若二叉树不为空,则它由根节点和称为其左子树 TL 和右子树 TR 的两个不相交的二叉树组成;
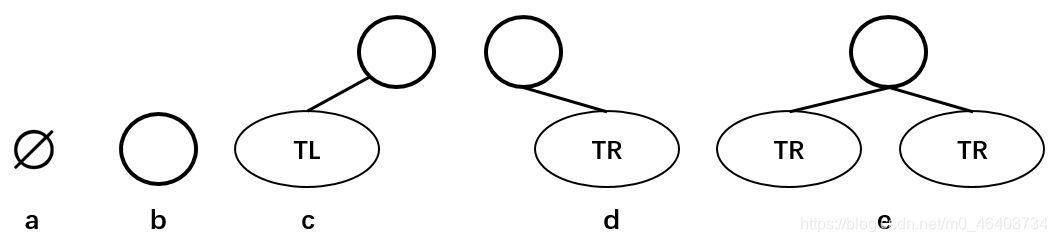
二叉树的五种形态:
上图分别表示:空的二叉树、只有一个节点的二叉树、只有左子树 TL 的二叉树、只有右子树 TR 的二叉树和有左右两个子树的二叉树。
二叉树的特性:
- 一个二叉树的第 i 层的最大节点树为:2(i-1),i >= 1;
- 深度为 k 的二叉树的最大节点总数为:2k - 1 ,k >= 1;
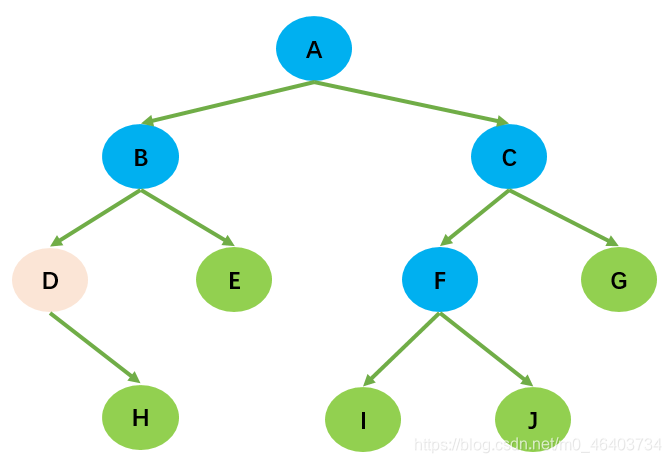
- 对任何非空二叉树,若 n0 表示叶子节点的个数,n2表示度为 2 的非叶子节点个数,那么两者满足关系:n0 = n2 + 1;如下图所示:H,E,I,J,G 为叶子节点,总数为 5;A,B,C,F 为度为 2 的非叶子节点,总数为 4;满足 n0 = n2 +
1 的规律。
特殊的二叉树
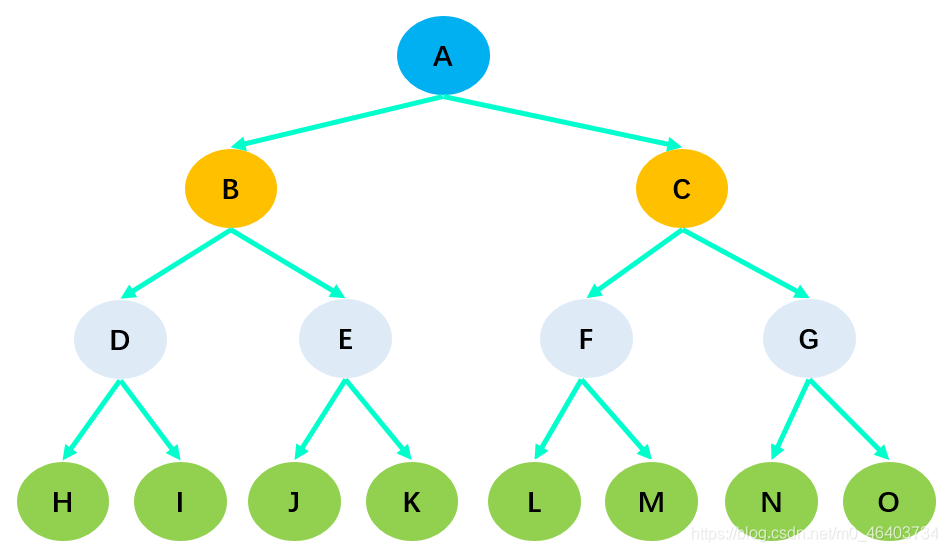
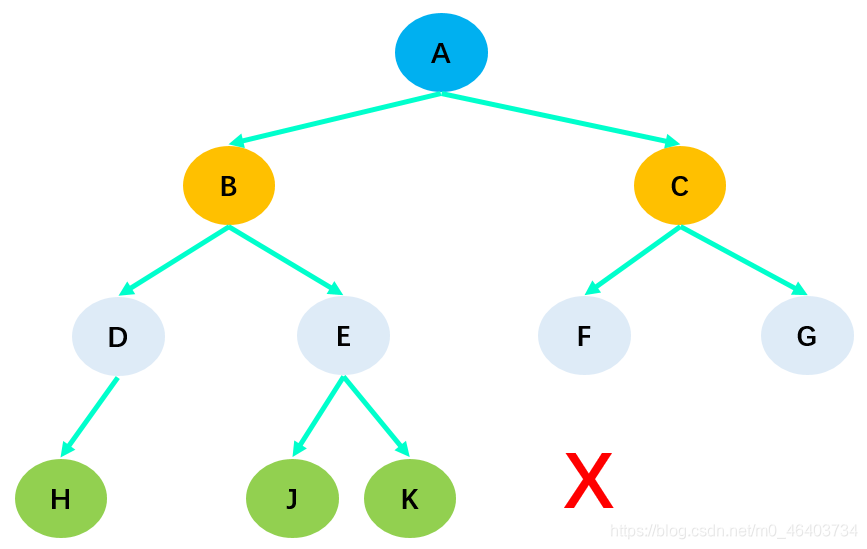
- 完美二叉树(Perfect Binary Tree):也成为满二叉树(Full Binary Tree),在二叉树中,除了最下一层的叶子节点外,每层节点都有 2 个子节点,这就构成了完美二叉树。
- 完全二叉树(Complete Binary Tree):除了二叉树最后一层外,其他各层的节点数都达到了最大值; 并且,最后一层的叶子节点从左向右是连续存在,只缺失右侧若干叶子节点; 完美二叉树是特殊的完全二叉树;
在上图中,由于 H 缺失了右子节点,所以它不是完全二叉树。
二叉树的数据存储方式:数组和链表(这2种较常用):
(1) 使用数组
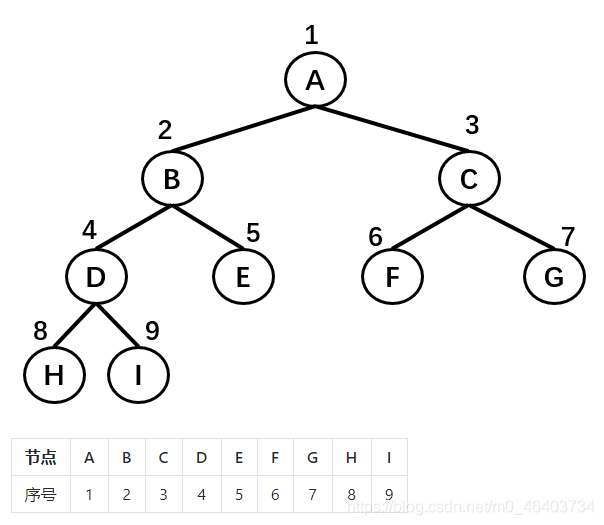
- 完全二叉树:按从上到下,从左到右的方式存储数据。
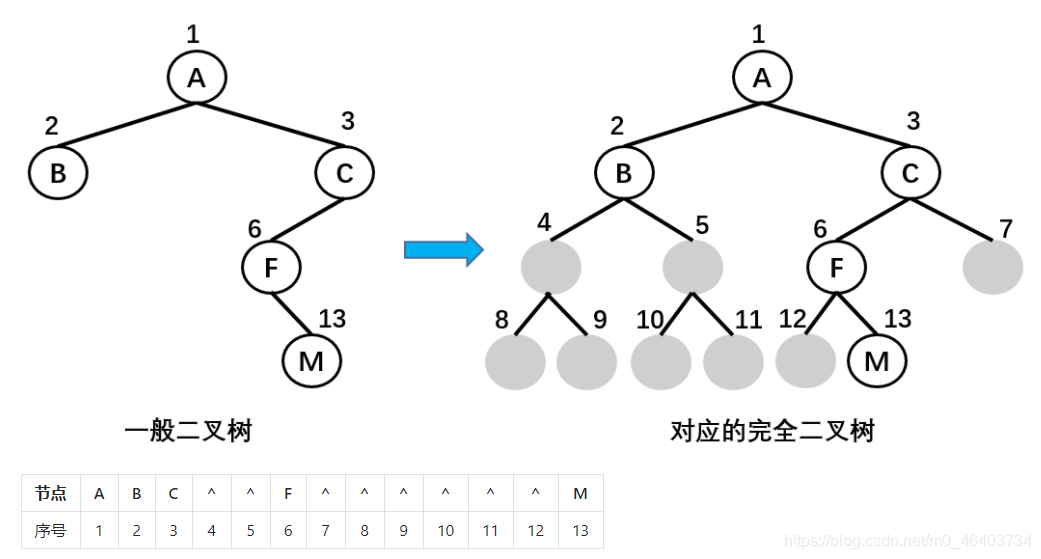
使用数组存储时,取数据的时候也很方便:左子节点的序号等于父节点序号 * 2,右子节点的序号等于父节点序号* 2 + 1 。- 非完全二叉树:非完全二叉树需要转换成完全二叉树才能按照上面的方案存储,这样会浪费很大的存储空间。
(2)使用链表
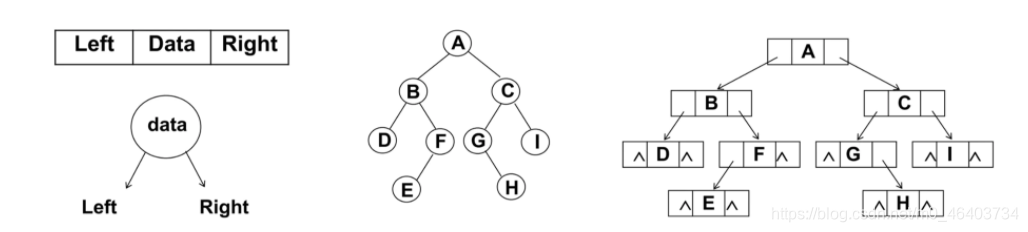
二叉树最常见的存储方式为链表:每一个节点封装成一个 Node,Node 中包含存储的数据、左节点的引用和右节点的引用。
二叉搜索树
二叉搜索树(BST,Binary Search Tree):也称为二叉排序树和二叉查找树。
二叉搜索树是一棵二叉树,可以为空。
如果不为空,则满足以下性质:
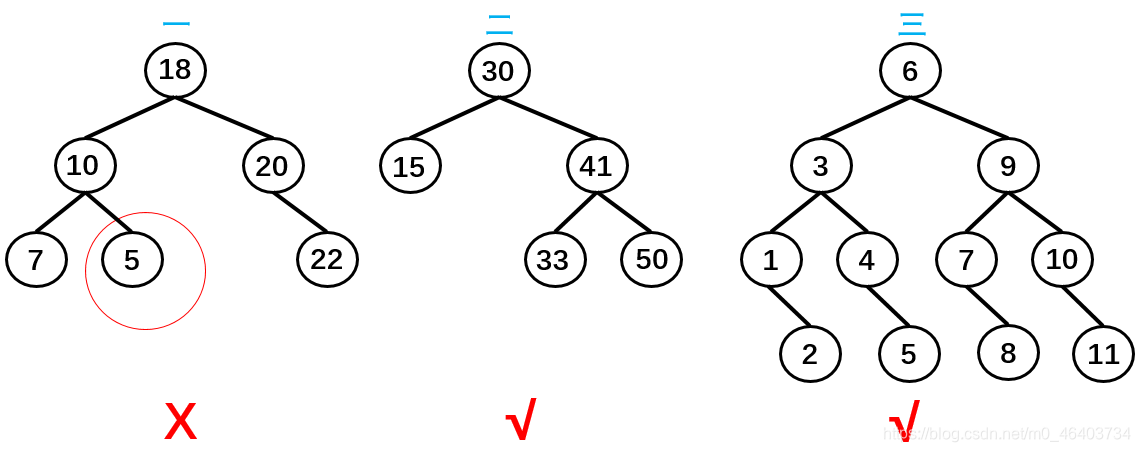
- 条件 1:非空左子树的所有键值小于其根节点的键值。比如三中节点 6 的所有非空左子树的键值都小于 6;
- 条件2:非空右子树的所有键值大于其根节点的键值;比如三中节点 6 的所有非空右子树的键值都大于 6;
- 条件 3:左、右子树本身也都是二叉搜索树;
如上图所示,树二和树三符合 3 个条件属于二叉搜索树,树一不满足条件所以不是二叉搜索树。总结:二叉搜索树的特点主要是较小的值总是保存在左节点上,相对较大的值总是保存在右节点上。这种特点使得二叉搜索树的查询效率非常高,这也就是二叉搜索树中“搜索”的来源。
二叉搜索树的封装
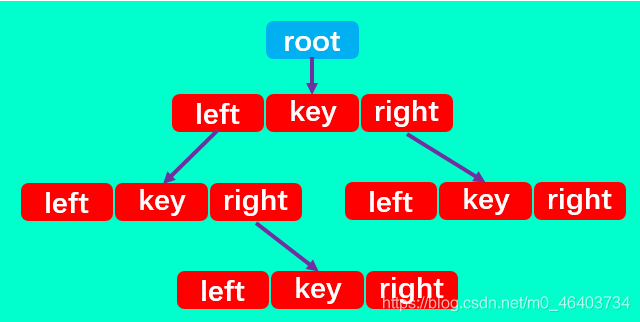
二叉搜索树有四个最基本的属性:指向节点的根(root),节点中的键(key)、左指针(right)、右指针(right)。
所以,二叉搜索树中除了定义root属性外,还应定义一个节点内部类,里面包含每个节点中的left、right和key三个属性。// 节点类 function Node(key){ this.key = key; this.left = null; this.right = null; } this.root = null;``
二叉搜索树的常见操作:
- insert(key):向树中插入一个新的键;
- search(key):在树中查找一个键,如果节点存在,则返回true;如果不存在,则返回false;
- inOrderTraverse:通过中序遍历方式遍历所有节点;
- preOrderTraverse:通过先序遍历方式遍历所有节点;
- postOrderTraverse:通过后序遍历方式遍历所有节点;
- min:返回树中最小的值/键;
- max:返回树中最大的值/键;
- remove(key):从树中移除某个键;
二叉树插入函数的封装:
    <script>
        function BinarySearchTree() {
            function Node(key) {
                this.key = key;
                this.left = null;
                this.right = null;
            }
            this.root = null;

            // 插入数据
            BinarySearchTree.prototype.insert = function (key) {
                var newNode = new Node(key);
                if (this.root == null) {
                    this.root = newNode;
                } else {
                    this.insertTree(this.root, newNode);
                }

            }

            BinarySearchTree.prototype.insertTree = function (node, newNode) {
                if (newNode.key < node.key) { //向左查找
                    if (node.left == null) {
                        node.left = newNode;
                    } else {
                        this.insertTree(node.left, newNode);
                    }
                } else { //向右查找
                    if (node.right == null) {
                        node.right = newNode;
                    } else {
                        this.insertTree(node.right, newNode);
                    }
                }
            }
        }

        var bst = new BinarySearchTree();
        // 插入数据
        bst.insert(11);
        bst.insert(7);
        bst.insert(15);
        bst.insert(5);
        bst.insert(3);
        bst.insert(9);
        bst.insert(8);
        bst.insert(10);
        bst.insert(13);
        bst.insert(12);
        bst.insert(14);
        bst.insert(20);
        bst.insert(18);
        bst.insert(25);
        bst.insert(6);
    </script>
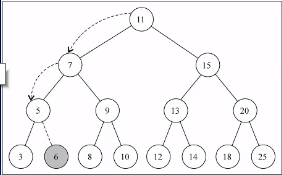
生成的二叉树如下图所示:
3. 遍历数据
这里所说的树的遍历不仅仅针对二叉搜索树,而是适用于所有的二叉树。由于树结构不是线性结构,所以遍历方式有多种选择,常见的三种二叉树遍历方式为:
- 先序遍历;
- 中序遍历;
- 后序遍历;
(1)先序遍历
- 实现思路:
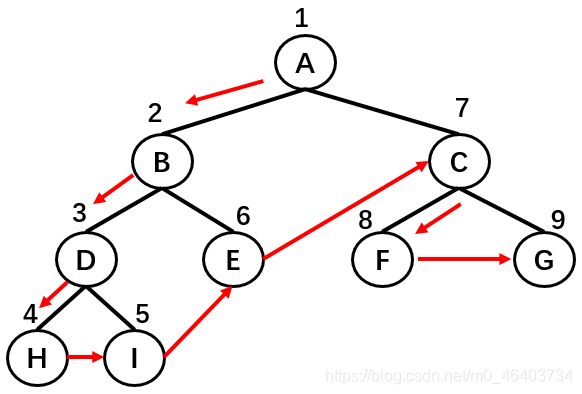
首先,遍历根节点; 然后,遍历其左子树; 最后,遍历其右子树;
输出节点的顺序应为:A -> B -> D -> H -> I -> E -> C -> F -> G。
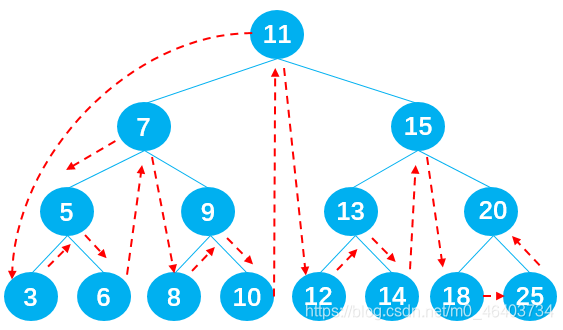
(2)中序遍历
实现思路:与先序遍历原理相同,只不过是遍历的顺序不一样。
首先,遍历其左子树; 然后,遍历根(父)节点; 最后,遍历其右子树;
输出节点的顺序应为:3 -> 5 -> 6 -> 7 -> 8 -> 9 -> 10 -> 11 -> 12 -> 13 -> 14 -> 15 -> 18 -> 20 -> 25 。
(3)后序遍历
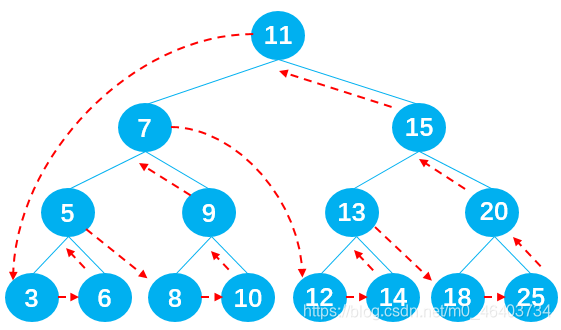
实现思路:与先序遍历原理相同,只不过是遍历的顺序不一样了。
首先,遍历其左子树; 然后,遍历其右子树; 最后,遍历根(父)节点;
输出节点的顺序应为:3 -> 6 -> 5 -> 8 -> 10 -> 9 -> 7 -> 12 -> 14 -> 13 -> 18 -> 25 -> 20 -> 15 -> 11 。
总结
以遍历根(父)节点的顺序来区分三种遍历方式。比如:先序遍历先遍历根节点、中序遍历第二遍历根节点、后续遍历最后遍历根节点。
JavaScript实现以上3种遍历:
<script>
    function BinarySearchTree() {
        function Node(key) {
            this.key = key;
            this.left = null;
            this.right = null;
        }
        this.root = null;

        // 插入数据
        BinarySearchTree.prototype.insert = function (key) {
            var newNode = new Node(key);
            if (this.root == null) {
                this.root = newNode;
            } else {
                this.insertTree(this.root, newNode);
            }
        }
        BinarySearchTree.prototype.insertTree = function (node, newNode) {
            if (newNode.key < node.key) { //向左查找
                if (node.left == null) {
                    node.left = newNode;
                } else {
                    this.insertTree(node.left, newNode);
                }
            } else { //向右查找
                if (node.right == null) {
                    node.right = newNode;
                } else {
                    this.insertTree(node.right, newNode);
                }
            }
        }


        // 先序遍历
        BinarySearchTree.prototype.preOrderTranversal = function (handler) {
            this.preOrderTranversalNode(this.root, handler);
        }
        BinarySearchTree.prototype.preOrderTranversalNode = function (node, handler) {
            if (node != null) {
                // 处理经过的节点
                handler(node.key);
                // 查找经过节点的左子节点
                this.preOrderTranversalNode(node.left, handler);
                // 查找经过节点的右子节点
                this.preOrderTranversalNode(node.right, handler);
            }

        }

        // 中序遍历
        BinarySearchTree.prototype.midOrderTranversal = function (handler) {
            this.midOrderTranversalNode(this.root, handler);
        }
        BinarySearchTree.prototype.midOrderTranversalNode = function (node, handler) {
            if (node != null) {
                // 查找经过节点的左子节点
                this.midOrderTranversalNode(node.left, handler);
                // 处理节点
                handler(node.key);
                // 查找经过节点的右子节点
                this.midOrderTranversalNode(node.right, handler);
            }
        }

        // 后序遍历
        BinarySearchTree.prototype.postOrderTranversal = function (handler) {
            this.postOrderTranversalNode(this.root, handler);
        }
        BinarySearchTree.prototype.postOrderTranversalNode = function (node, handler) {
            if (node != null) {
                // 查找经过节点的左子节点
                this.postOrderTranversalNode(node.left, handler);
                // 查找经过节点的右子节点
                this.postOrderTranversalNode(node.right, handler);
                // 处理节点
                handler(node.key);
            }
        }
    }


    var bst = new BinarySearchTree();

    // 插入数据
    bst.insert(11);
    bst.insert(7);
    bst.insert(15);
    bst.insert(5);
    bst.insert(3);
    bst.insert(9);
    bst.insert(8);
    bst.insert(10);
    bst.insert(13);
    bst.insert(12);
    bst.insert(14);
    bst.insert(20);
    bst.insert(18);
    bst.insert(25);
    bst.insert(6);


    // 测试先序遍历
    var resultString = "";
    bst.preOrderTranversal(function (key) {
        resultString += key + " ";
    })
    console.log(resultString); // 11 7 5 3 6 9 8 10 15 13 12 14 20 18 25


    // 测试中序遍历
    var resultString1 = "";
    bst.midOrderTranversal(function (key) {
        resultString1 += key + " ";
    })
    console.log(resultString1); // 3 5 6 7 8 9 10 11 12 13 14 15 18 20 25


    // 测试后序遍历
    var resultString2 = "";
    bst.postOrderTranversal(function (key) {
        resultString2 += key + " ";
    })
    console.log(resultString2); // 3 6 5 8 10 9 7 12 14 13 18 25 20 15 11
</script>
4. 查找数据
查找最大值或最小值
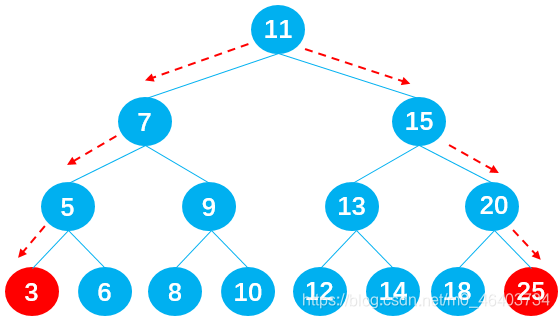
- 在二叉搜索树中查找最值非常简单,最小值在二叉搜索树的最左边,最大值在二叉搜索树的最右边。只需要一直向左/右查找就能得到最值,如下图所示:
JavaScript实现二叉树的最值:
<!DOCTYPE html>
<html lang="en">

<head>
    <meta charset="UTF-8">
    <meta name="viewport" content="width=device-width, initial-scale=1.0">
    <title>Document</title>
</head>

<body>
    <script>
        function BinarySearchTree() {
            function Node(key) {
                this.key = key;
                this.left = null;
                this.right = null;
            }
            this.root = null;

            // 插入数据
            BinarySearchTree.prototype.insert = function (key) {
                var newNode = new Node(key);
                if (this.root == null) {
                    this.root = newNode;
                } else {
                    this.insertTree(this.root, newNode);
                }
            }
            BinarySearchTree.prototype.insertTree = function (node, newNode) {
                if (newNode.key < node.key) { //向左查找
                    if (node.left == null) {
                        node.left = newNode;
                    } else {
                        this.insertTree(node.left, newNode);
                    }
                } else { //向右查找
                    if (node.right == null) {
                        node.right = newNode;
                    } else {
                        this.insertTree(node.right, newNode);
                    }
                }
            }


            // 查找二叉树中的最小值
            BinarySearchTree.prototype.min = function () {
                var node = this.root;
                var key = null;
                while (node != null) {
                    key = node.key;
                    node = node.left;

                }
                return key;
            }

            // 查找二叉树中的最大值
            BinarySearchTree.prototype.max = function () {
                var node = this.root;
                var key = null;
                while (node != null) {
                    key = node.key;
                    node = node.right;
                }
                return key;
            }
        }


        var bst = new BinarySearchTree();

        // 插入数据
        bst.insert(11);
        bst.insert(7);
        bst.insert(15);
        bst.insert(5);
        bst.insert(3);
        bst.insert(9);
        bst.insert(8);
        bst.insert(10);
        bst.insert(13);
        bst.insert(12);
        bst.insert(14);
        bst.insert(20);
        bst.insert(18);
        bst.insert(25);
        bst.insert(6);


        // 测试最值
        var minNumber = bst.min();
        console.log(minNumber); // 3
        var maxNumber = bst.max();
        console.log(maxNumber); //25

    </script>
</body>

</html>
5. 查找特定值
查找二叉搜索树当中的特定值效率也非常高。只需要从根节点开始将需要查找节点的 key 值与之比较,若 node.key < root
则向左查找,若 node.key > root 就向右查找,直到找到或查找到 null 为止。这里可以使用递归实现,也可以采用循环来实现。
JavaScript实现二叉树查找特定的key值:
<!DOCTYPE html>
<html lang="en">

<head>
    <meta charset="UTF-8">
    <meta name="viewport" content="width=device-width, initial-scale=1.0">
    <title>Document</title>
</head>

<body>
    <script>
        function BinarySearchTree() {
            function Node(key) {
                this.key = key;
                this.left = null;
                this.right = null;
            }
            this.root = null;

            // 插入数据
            BinarySearchTree.prototype.insert = function (key) {
                var newNode = new Node(key);
                if (this.root == null) {
                    this.root = newNode;
                } else {
                    this.insertTree(this.root, newNode);
                }
            }
            BinarySearchTree.prototype.insertTree = function (node, newNode) {
                if (newNode.key < node.key) { //向左查找
                    if (node.left == null) {
                        node.left = newNode;
                    } else {
                        this.insertTree(node.left, newNode);
                    }
                } else { //向右查找
                    if (node.right == null) {
                        node.right = newNode;
                    } else {
                        this.insertTree(node.right, newNode);
                    }
                }
            }


            // 查找某个特定的key值
            BinarySearchTree.prototype.search = function (key) {
                var node = this.root;
                while (node != null) {
                    if (key < node.key) {
                        node = node.left;
                    } else if (key > node.key) {
                        node = node.right;
                    } else {
                        return true;
                    }
                }
                return false;
            }
        }


        var bst = new BinarySearchTree();

        // 插入数据
        bst.insert(11);
        bst.insert(7);
        bst.insert(15);
        bst.insert(5);
        bst.insert(3);
        bst.insert(9);
        bst.insert(8);
        bst.insert(10);
        bst.insert(13);
        bst.insert(12);
        bst.insert(14);
        bst.insert(20);
        bst.insert(18);
        bst.insert(25);
        bst.insert(6);

        // 测试搜索方法
        console.log(bst.search(25)); // true
        console.log(bst.search(24)); // fasle
        console.log(bst.search(2)); // false
    </script>
</body>

</html>
6. 删除数据
实现思路:
第一步:先找到需要删除的节点,若没找到,则不需要删除;
- 首先定义变量 current 用于保存需要删除的节点、变量 parent 用于保存它的父节点、变量 isLeftChild 保存
current 是否为 parent 的左节点,这样方便之后删除节点时改变相关节点的指向。第二步:删除找到的指定节点,后分 3 种情况:
- 删除的是叶子节点;
- 删除的是只有一个子节点的节点;
- 删除的是有两个子节点的节点;
(1)删除的是叶子节点
分两种情况:
叶子节点也是根节点
当该叶子节点为根节点时,如下图所示,此时 current == this.root,直接通过:this.root = null,删除根节点。
叶子节点不为根节点
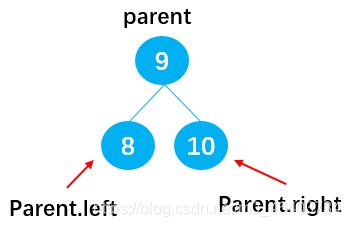
当该叶子节点不为根节点时也有两种情况,如下图所示
若 current = 8,可以通过:parent.left = null,删除节点 8;若 current = 10,可以通过:parent.right = null,删除节点 10;
(2)删除的是只有一个子节点的节点
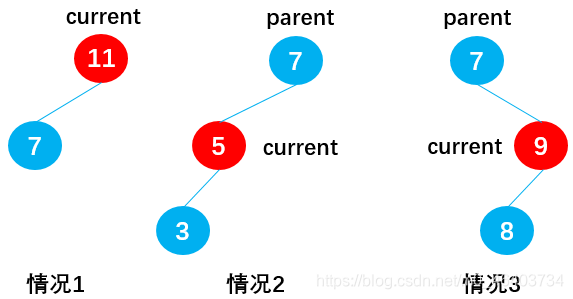
有六种情况:当 current 存在左子节点时(current.right == null):
情况 1:current 为根节点(current == this.root),如节点 11,此时通过:this.root = current.left,删除根节点 11;
情况 2:current 为父节点 parent 的左子节点(isLeftChild == true),如节点 5,此时通过:parent.left = current.left,删除节点 5;
情况 3:current 为父节点 parent 的右子节点(isLeftChild == false),如节点 9,此时通过:parent.right = current.left,删除节点 9;
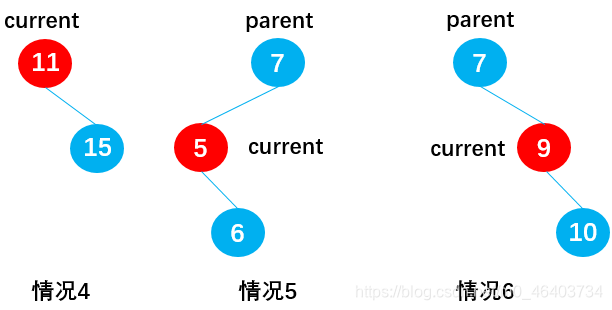
当 current 存在右子节点时(current.left = null):
情况 4:current 为根节点(current == this.root),如节点 11,此时通过:this.root = current.right,删除根节点 11。
情况 5:current 为父节点 parent 的左子节点(isLeftChild == true),如节点 5,此时通过:parent.left = current.right,删除节点 5;
情况 6:current 为父节点 parent 的右子节点(isLeftChild == false),如节点 9,此时通过:parent.right = current.right,删除节点 9;
(3)删除的是有两个子节点的节点
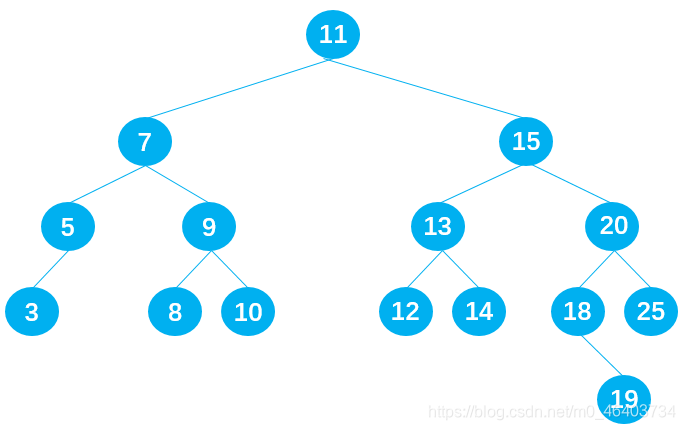
这种情况很复杂,首先依据以下二叉搜索树,讨论这样的问题:
【1】删除节点 9在保证删除节点 9 后原二叉树仍为二叉搜索树的前提下,有两种方式:
- 方式 1:从节点 9 的左子树中选择一合适的节点替代节点 9,可知节点 8 符合要求;
- 方式 2:从节点 9 的右子树中选择一合适的节点替代节点 9,可知节点 10 符合要求;
【2】删除节点 7
在保证删除节点 7 后原二叉树仍为二叉搜索树的前提下,也有两种方式:
- 方式 1:从节点 7 的左子树中选择一合适的节点替代节点 7,可知节点 5 符合要求;
- 方式 2:从节点 7 的右子树中选择一合适的节点替代节点 7,可知节点 8 符合要求;
【3】删除节点 15
在保证删除节点 15 后原树二叉树仍为二叉搜索树的前提下,同样有两种方式:
- 方式 1:从节点 15 的左子树中选择一合适的节点替代节点 15,可知节点 14 符合要求;
- 方式 2:从节点 15 的右子树中选择一合适的节点替代节点 15,可知节点 18 符合要求;
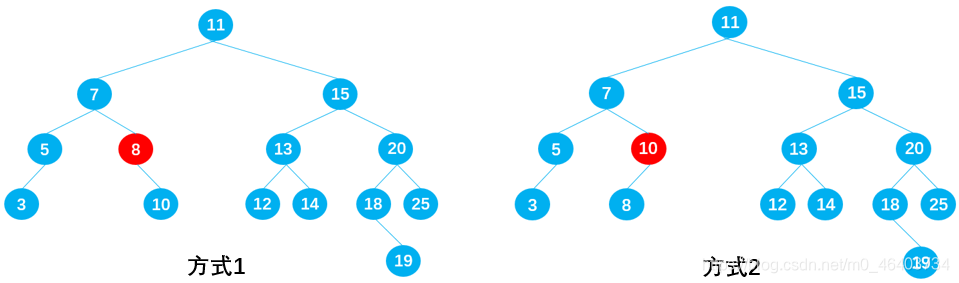
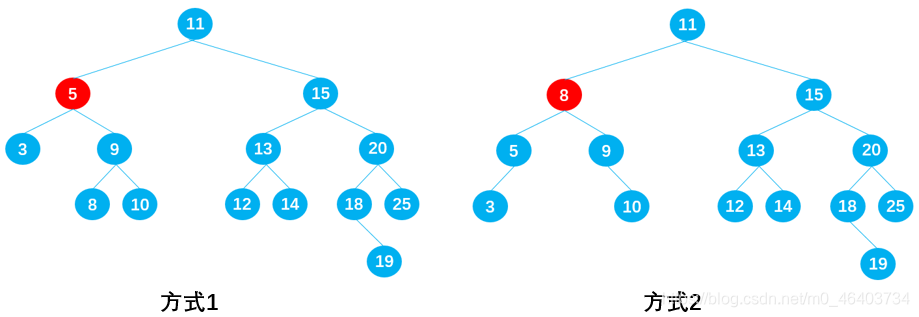
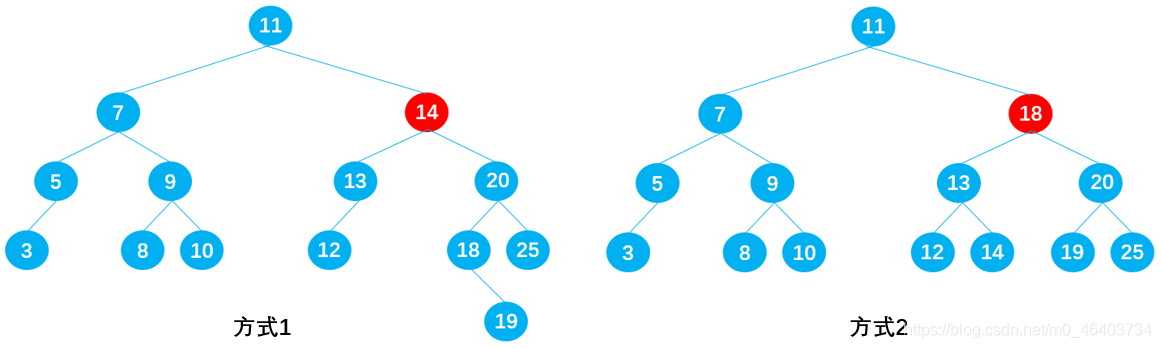
相信你已经发现其中的规律了!
规律总结:如果要删除的节点有两个子节点,甚至子节点还有子节点,这种情况下需要从要删除节点下面的子节点中找到一个合适的节点,来替换当前的节点。
若用 current 表示需要删除的节点,则合适的节点指的是:
- current 左子树中比 current 小一点点的节点,即 current 左子树中的最大值;
- current 右子树中比 current 大一点点的节点,即 current 右子树中的最小值;
前驱&后继
在二叉搜索树中,这两个特殊的节点有特殊的名字:
比 current 小一点点的节点,称为 current 节点的前驱。比如下图中的节点 5 就是节点 7 的前驱;
比 current大一点点的节点,称为 current 节点的后继。比如下图中的节点 8 就是节点 7 的后继;
查找需要被删除的节点 current 的后继时,需要在 current 的右子树中查找最小值,即在 current的右子树中一直向左遍历查找;
查找前驱时,则需要在 current 的左子树中查找最大值,即在 current 的左子树中一直向右遍历查找。
下面代码只讨论查找 current 后继的情况,查找前驱的原理相同,这里暂不讨论。
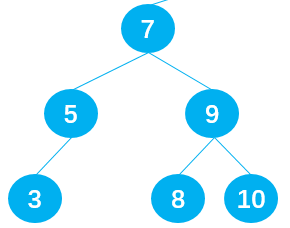
JavaScript实现二叉搜索树删除节点:
<!DOCTYPE html>
<html lang="en">

<head>
    <meta charset="UTF-8">
    <meta name="viewport" content="width=device-width, initial-scale=1.0">
    <title>Document</title>
</head>

<body>
    <script>
        function BinarySearchTree() {
            function Node(key) {
                this.key = key;
                this.left = null;
                this.right = null;
            }
            this.root = null;

            // 插入数据
            BinarySearchTree.prototype.insert = function (key) {
                var newNode = new Node(key);
                if (this.root == null) {
                    this.root = newNode;
                } else {
                    this.insertTree(this.root, newNode);
                }
            }
            BinarySearchTree.prototype.insertTree = function (node, newNode) {
                if (newNode.key < node.key) { //向左查找
                    if (node.left == null) {
                        node.left = newNode;
                    } else {
                        this.insertTree(node.left, newNode);
                    }
                } else { //向右查找
                    if (node.right == null) {
                        node.right = newNode;
                    } else {
                        this.insertTree(node.right, newNode);
                    }
                }
            }

            // 先序遍历
            BinarySearchTree.prototype.preOrderTranversal = function (handler) {
                this.preOrderTranversalNode(this.root, handler);
            }
            BinarySearchTree.prototype.preOrderTranversalNode = function (node, handler) {
                if (node != null) {
                    // 处理经过的节点
                    handler(node.key);
                    // 查找经过节点的左子节点
                    this.preOrderTranversalNode(node.left, handler);
                    // 查找经过节点的右子节点
                    this.preOrderTranversalNode(node.right, handler);
                }
            }

            // 删除节点
            BinarySearchTree.prototype.remove = function (key) {
                //1.寻找要删除的节点
                var current = this.root;
                var parent = null;
                var isLeftChild = true;

                while (current.key != key) {
                    parent = current;
                    if (key < current.key) {
                        isLeftChild = true;
                        current = current.left;
                    } else {
                        isLeftChild = false;
                        current = current.right;
                    }
                    // 某种情况:已经找到了最后的节点,依然没有找到与之相等的key值,直接返回false即可
                    if (current == null) return false;
                }

                //2.找到了,current.key==key;根据对应的情况删除节点
                //2.1删除的节点是叶子节点(没有子节点)
                if (current.left == null && current.right == null) {
                    if (current == this.root) {
                        current = null;
                    } else if (isLeftChild) {
                        parent.left = null;
                    } else {
                        parent.right = null;
                    }
                }

                //2.2删除的节点有一个子节点
                else if (current.right == null) {
                    if (current == this.root) {
                        this.root = current.left;
                    } else if (isLeftChild) {
                        parent.left = current.left;
                    } else {
                        parent.right = current.left;
                    }
                } else if (current.left == null) {
                    if (current == this.root) {
                        this.root = current.right;
                    } else if (isLeftChild) {
                        parent.left = current.right;
                    } else {
                        parent.right = current.right;
                    }
                }

                //2.3删除的节点有两个子节点
                else {
                    //2.3.1获取后继节点
                    var successor = this.getSuccessor(current);

                    //2.3.2判断是否根节点
                    if (current == this.root) {
                        this.root = successor;
                    } else if (isLeftChild) {
                        parent.left = successor;
                    } else {
                        parent.right = successor;
                    }

                    // 2.3.3将删除节点的左子树=current.left
                    successor.left = current.left;
                }
            }

            // 找后继的方法
            BinarySearchTree.prototype.getSuccessor = function (delNode) {
                // 1.定义变量,找到保存的后继
                var successor = delNode;
                var current = delNode.right;
                var successorParent = delNode;
                // 2.循环查找
                while (current != null) {
                    successorParent = successor;
                    successor = current;
                    current = current.left;
                }
                // 3.判断寻找的后继节点是否直接就是delNode的right节点
                if (successor != delNode.right) {
                    successorParent.left = successor.right;
                    successor.right = delNode.right;
                }
                return successor;
            }
        }


        var bst = new BinarySearchTree();

        // 插入数据
        bst.insert(11);
        bst.insert(7);
        bst.insert(15);
        bst.insert(5);
        bst.insert(3);
        bst.insert(9);
        bst.insert(8);
        bst.insert(10);
        bst.insert(13);
        bst.insert(12);
        bst.insert(14);
        bst.insert(20);
        bst.insert(18);
        bst.insert(25);
        bst.insert(6);

        //测试删除节点
        bst.remove(9);
        bst.remove(7);
        bst.remove(15);
        var resultString = "";
        bst.preOrderTranversal(function (key) {
            resultString += key + " ";
        })
        console.log(resultString); // 11 8 5 3 6 10 18 13 12 14 20 25
    </script>
</body>

</html>
7. 平衡树
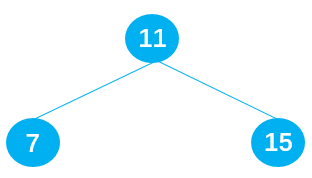
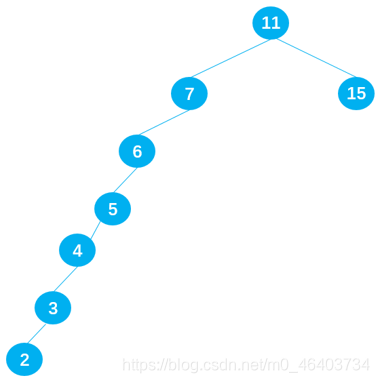
二叉搜索树的缺陷:当插入的数据是有序的数据,就会造成二叉搜索树的深度过大。比如原二叉搜索树由 11 7 15 组成,如下图所示:
当插入一组有序数据:6 5 4 3 2 就会变成深度过大的搜索二叉树,会严重影响二叉搜索树的性能。
非平衡树
- 比较好的二叉搜索树,它的数据应该是左右均匀分布的。
- 但是插入连续数据后,二叉搜索树中的数据分布就变得不均匀了,我们称这种树为非平衡树。
- 对于一棵平衡二叉树来说,插入/查找等操作的效率是 O(log n)。
- 而对于一棵非平衡二叉树来说,相当于编写了一个链表,查找效率变成了 O(n)。
树的平衡性
为了能以较快的时间 O(log n)来操作一棵树,我们需要保证树总是平衡的;
起码大部分是平衡的,此时的时间复杂度也是接近 O(log n) 的;
这就要求树中每个节点左边的子孙节点的个数,应该尽可能地等于右边的子孙节点的个数;
常见的平衡树
- AVL 树:是最早的一种平衡树,它通过在每个节点多存储一个额外的数据来保持树的平衡。由于 AVL 树是平衡树,所以它的时间复杂度也是 O(log n)。但是它的整体效率不如红黑树,开发中比较少用。
- 红黑树:同样通过一些特性来保持树的平衡,时间复杂度也是 O(log n)。进行插入/删除等操作时,性能优于 AVL 树,所以平衡树的应用基本都是红黑树。
8.红黑树(难点)
(1)红黑树的五条规则
红黑树除了符合二叉搜索树的基本规则外,还添加了以下特性:
- 规则1:节点是红色或黑色的;
- 规则2:根节点是黑色的;
- 规则3:每个叶子节点都是黑色的空节点(NIL节点);
- 规则4:每个红色节点的两个子节点都是黑色的(从每个叶子到根的所有路径上不可能有两个连续的红色节点);
- 规则5:从任一节点到其每个叶子节点的所有路径都包含相同数目的黑色节点;
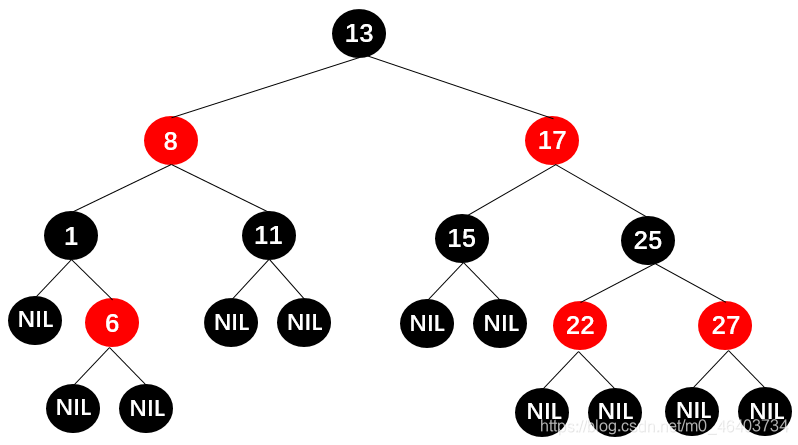
红黑树的相对平衡
前面5条规则的约束确保了以下红黑树的关键特性:
- 从根到叶子节点的最长路径,不会超过最短路径的两倍;
- 结果就是这棵树基本是平衡的;
- 虽然没有做到绝对的平衡,但是可以保证在最坏的情况下,该树依然是高效的;
为什么可以做到最长路径不超过最短路径的两倍呢?
- 性质4决定了路径上不能有两个相连的红色节点; 所以,最长路径一定是红色节点和黑色节点交替而成的;
- 由于根节点和叶子节点都是黑色的,最短路径可能都是黑色节点,并且最长路径中一定是黑色节点多于红色节点;
- 性质5决定了所有路径上都有相同数目的黑色节点; 这就表明了没有路径能多于其他任何路径两倍长。
(2)红黑树的三种变换
插入一个新节点时,有可能树不再平衡,可以通过三种方式的变换使树保持平衡:
- 变色;
- 左旋转;
- 右旋转;
a.变色
为了重新符合红黑树的规则,需要把红色节点变为黑色,或者把黑色节点变为红色;
插入的新节点通常都是红色节点:
当插入的节点为红色的时候,大多数情况不违反红黑树的任何规则;
而插入黑色节点,必然会导致一条路径上多了一个黑色节点,这是很难调整的;
红色节点虽然可能导致红红相连的情况,但是这种情况可以通过颜色调换和旋转来调整;
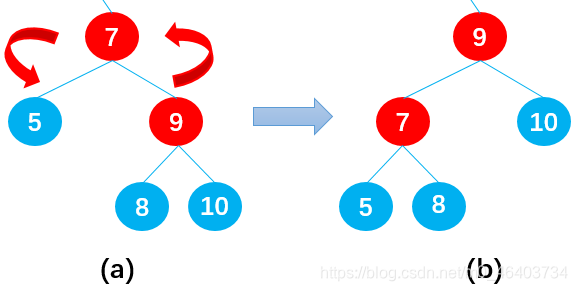
b.左旋转
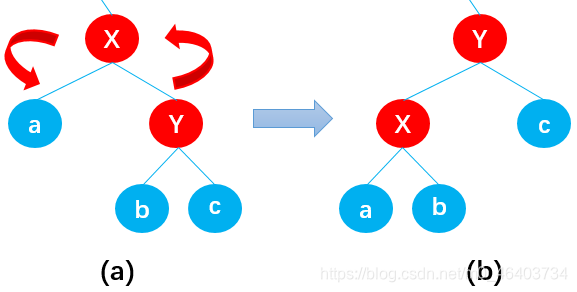
以节点X为根逆时针旋转二叉搜索树,使得父节点原来的位置被自己的右子节点替代,左子节点的位置被父节点替代;
如上图所示,左旋转之后:
- 节点X取代了节点a原来的位置;
- 节点Y取代了节点X原来的位置;
- 节点X的左子树 a 仍然是节点X的左子树(这里X的左子树只有一个节点,有多个节点时同样适用,以下同理);
- 节点Y的右子树 c 仍然是节点Y的右子树;
- 节点Y的左子树 b 向左平移成为了节点X的右子树;
除此之外,左旋转之后仍为二叉搜索树:
c.右旋转
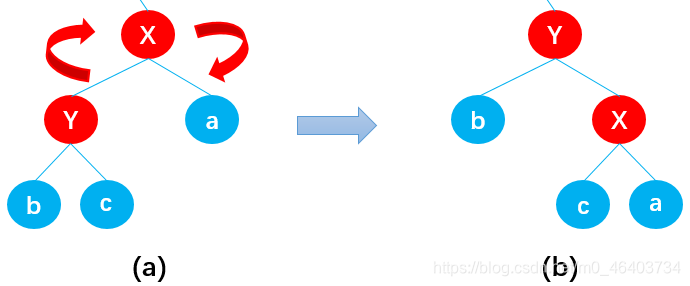
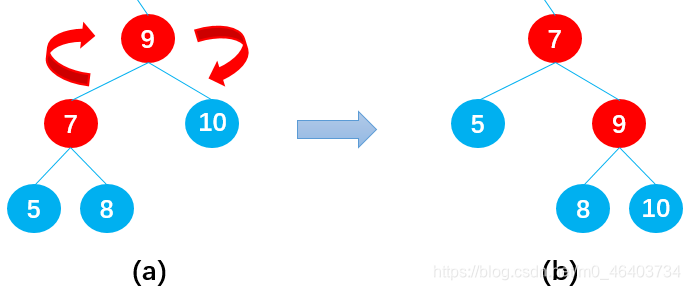
以节点X为根顺时针旋转二叉搜索树,使得父节点原来的位置被自己的左子节点替代,右子节点的位置被父节点替代;
如上图所示,右旋转之后:
- 节点X取代了节点a原来的位置;
- 节点Y取代了节点X原来的位置;
- 节点X的右子树 a 仍然是节点X的右子树(这里X的右子树虽然只有一个节点,但是多个节点时同样适用,以下同理);
- 节点Y的左子树 b 仍然是节点Y的左子树;
- 节点Y的右子树 c 向右平移成为了节点X的左子树;
除此之外,右旋转之后仍为二叉搜索树:
(3)红黑树的插入操作
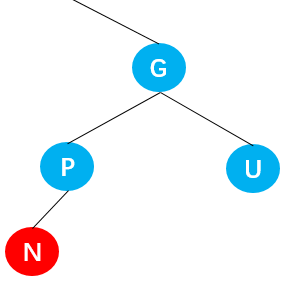
首先需要明确,在保证满足红黑树5条规则的情况下,新插入的节点必然是红色节点。
为了方便说明,规定以下四个节点:新插入节点为N(Node),N的父节点为P(Parent),P的兄弟节点为U(Uncle),U的父节点为G(Grandpa),如下图所示:
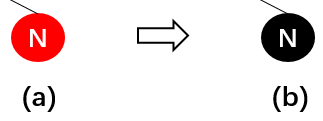
情况1 :
当插入的新节点N位于树的根上时,没有父节点。
这种情况下,只需要将红色节点变为黑色节点即可满足规则2。
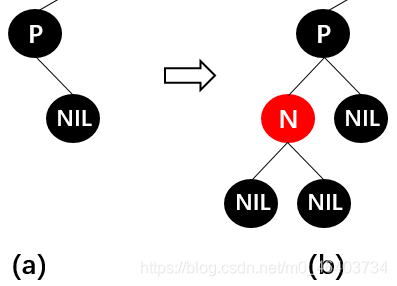
情况2:
新节点N的父节点P为黑色节点,此时不需要任何变化。
此时既满足规则4也满足规则5。尽管新节点是红色的,但是新节点N有两个黑色节点NIL,所以通向它的路径上黑色节点的个数依然相等,因此满足规则5。
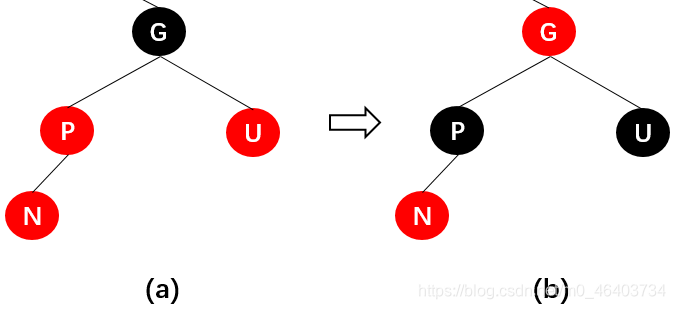
情况3:
节点P为红色,节点U也为红色,此时节点G必为黑色,即父红叔红祖黑。
在这种情况下需要:
- 先将父节点P变为黑色;
- 再将叔叔节点U变为黑色;
- 最后将祖父节点G变为红色; 即变为父黑叔黑祖红,如下图所示:
可能出现的问题:
- N的祖父节点G的父节点也可能是红色,这就违反了规则4,此时可以通过递归调整节点颜色;
- 当递归调整到根节点时就需要旋转了,具体情况后面会介绍;
情况4:
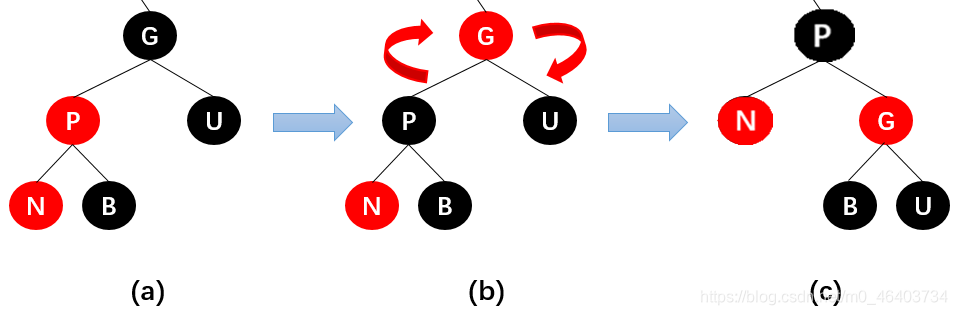
节点P是红色节点,节点U是黑色节点,并且节点N为节点P的左子节点,此时节点G一定是黑色节点,即父红叔黑祖黑。
在这种情况下需要:
- 先变色:将父节点P变为黑色,将祖父节点G变为红色;
- 后旋转:以祖父节点G为根进行右旋转;
情况5:
节点P是红色节点,节点U是黑色节点,并且节点N为节点P的右子节点,此时节点G一定是黑色节点,即父红叔黑祖黑。
在这种情况下需要:
- 先以节点P为根进行左旋转,旋转后如图b所示;
- 随后将红色节点P和黑色节点B看成一个整体的红色节点N1,将新插入的红色节点N看成红色节点P1 如图c所示。此时整体就转换为了情况4。
接着可以按照情况4进行处理:
先变色:将N1节点的父节点P1变为黑色,将祖父节点G变为红色;
后旋转:以祖父节点G为根进行右旋转,旋转后如图 e 所示;
最后将节点N1和P1变换回来,完成节点N的插入,如图 f 所示;
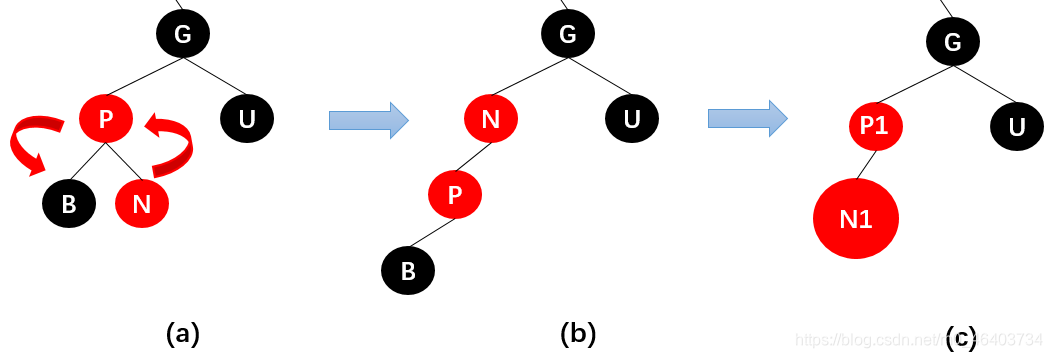
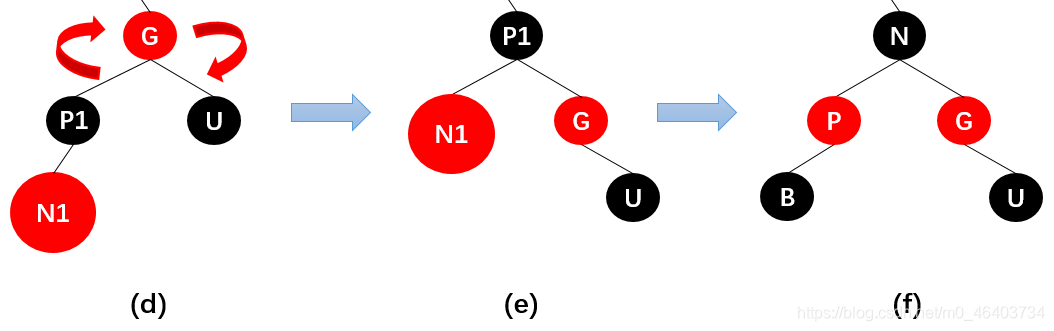
9.红黑树案例
案例:在二叉树中依次插入节点:10,9,8,7,6,5,4,3,2,1 。
如果直接采用普通的二叉搜索树,节点全部插入后是这样的:
是一个严重的不平衡树,相当于一个链表,不能体现出二叉搜索树的高效率。而按照红黑树的五条规则插入节点就能最大程度保证搜索二叉树是一棵平衡树。
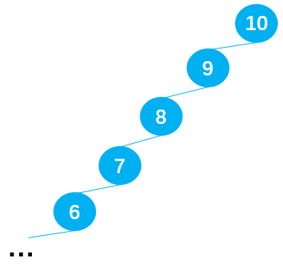
以下为过程详解:为了方便解释省略了部分红黑树的叶子节点(NIL)。
(1)插入10
符合情况1:
- 插入节点10;
- 将节点10的颜色变为黑色;
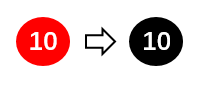
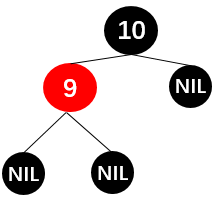
(2)插入9
符合情况2:
- 不需要任何变化;
(3)插入8
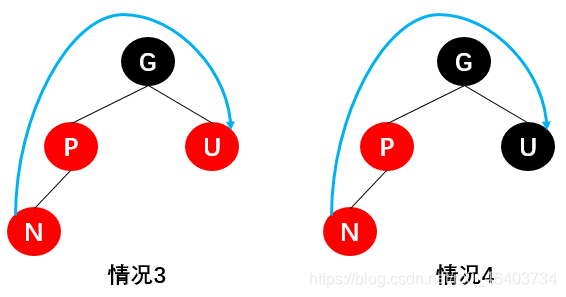
快速判断属于情况3还是情况4的方法:
从新插入的节点N出发,按图示箭头经过的四个节点,若为红红黑红3个红色节点则为情况3,若为红红黑黑两个红色节点则为情况4;
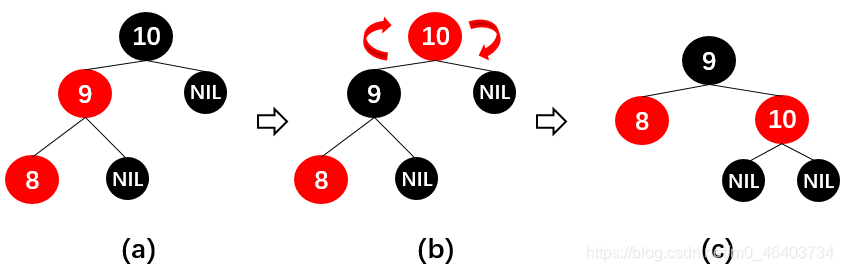
分析,得出符合情况4:
- 父节点9变成黑,祖父节点10变为红;
- 以祖父节点为根进行右旋转;
(4)插入7
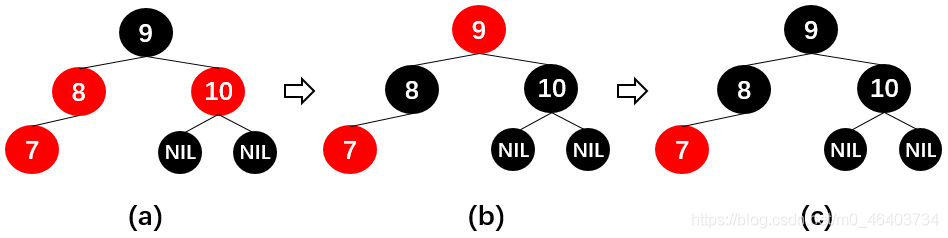
符合情况3:
- 父节点8和叔节点10变为黑,祖父节点9变为红;
- 此时会出现问题:不符合规则2,即根节点不为黑,此时可以把以9为根节点的二叉搜索树当作一个整体作为一个新插入的节点N,而此时又符合情况1,只需要把9变回黑色即可。
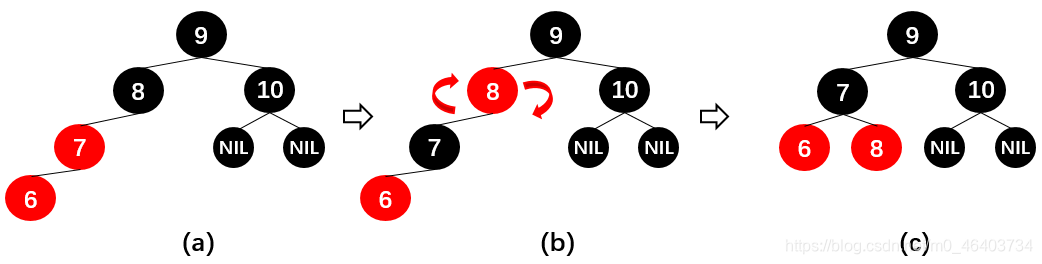
(5)插入6
符合情况4:
- 父节点7变为黑,祖父节点8变为红;
- 以祖父节点8为根进行右旋转;
(6)插入5
符合情况3:
- 父节点6和叔节点8变为黑,祖父节点7变为红;
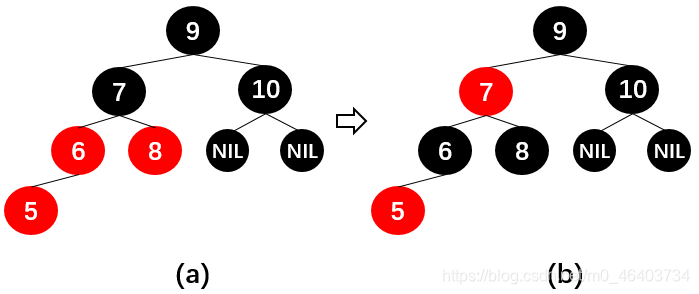
(7)插入4
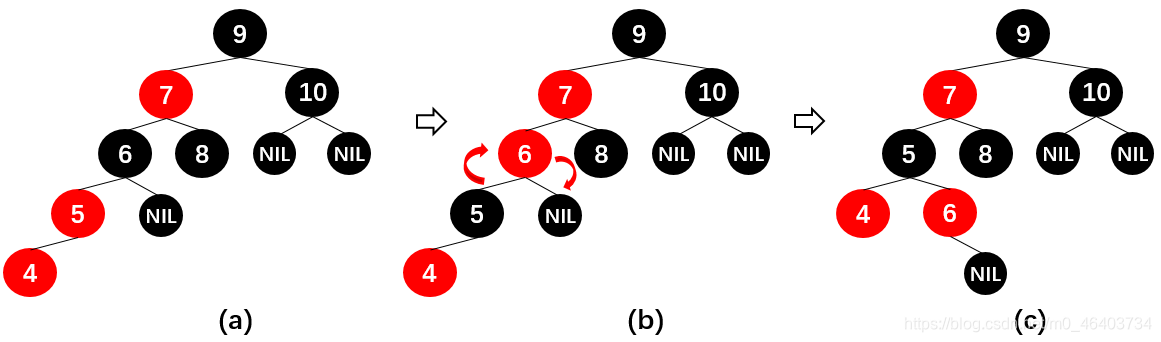
符合情况4:
- 父节点5变为黑,祖父节点6变为红;
- 以祖父节点6为根进行右旋转;
(8)插入3
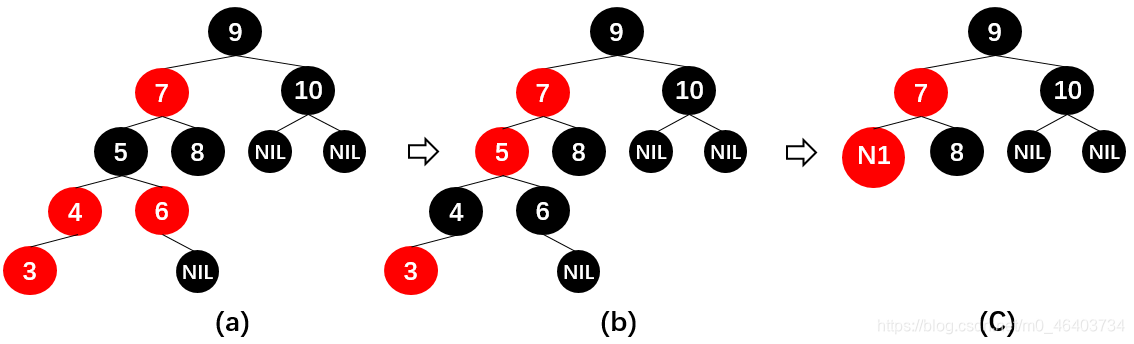
第一次变换:符合情况3:
- 父节点4和叔节点6变为黑,祖父节点5变为红;
- 变换之后发现5和7为相连的两个红色节点,于是把以5为根的整个子树看成一个新插入的节点N1,再进行第二次变换。
第二次变换:符合情况4:
- 父节点7变为黑,祖父节点9变为红;
- 以祖父节点9为根进行右旋转;
最后复原N1得到变换后的红黑树:
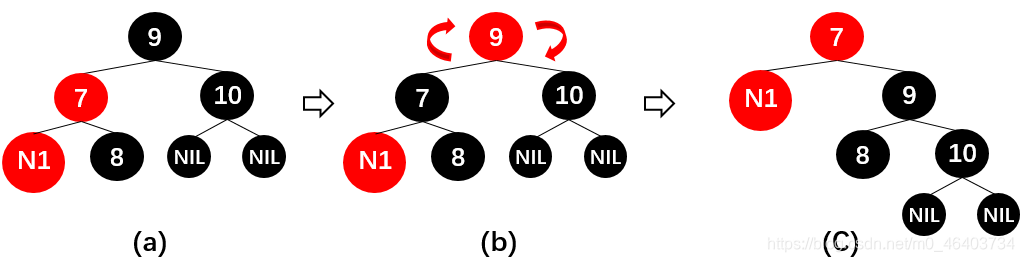
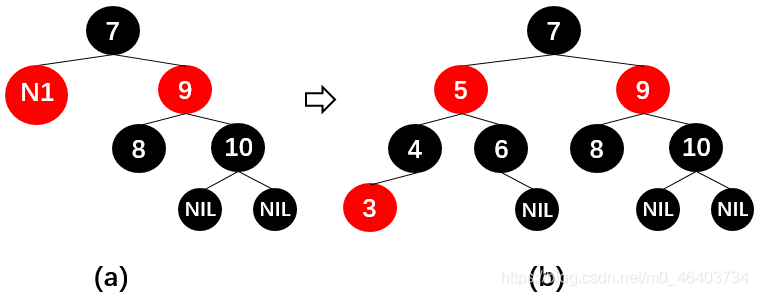
(9)插入2
符合情况4:
- 父节点3变为黑,祖父节点4变为红;
- 以祖父节点4为根进行右旋转;
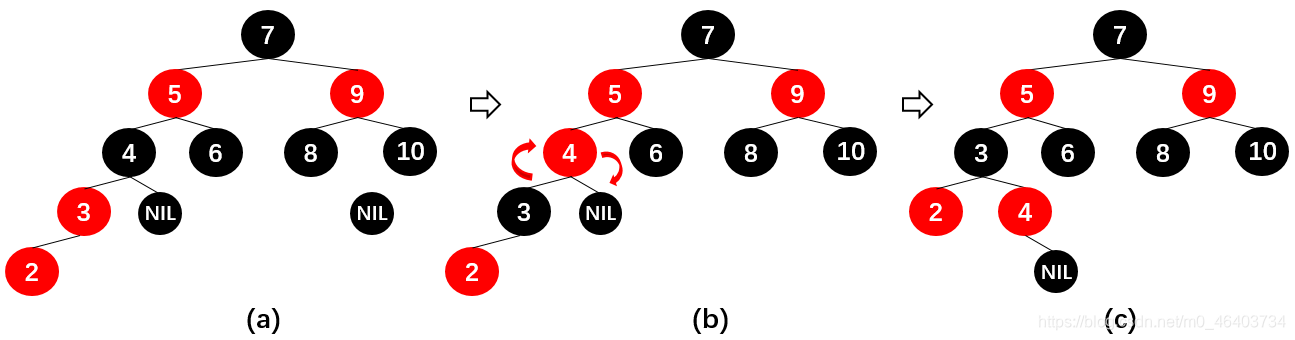
(10)插入1
第一次变换:符合情况3:
- 父节点2和叔节点4变为黑,祖父节点3变为红;
- 变换之后发现3和5为相连的两个红色节点,于是把以3为根的整个子树看成一个新插入的节点N1,再进行第二次变换。
第二次变换:符合情况3:
- 父节点5和叔节点9变为黑,祖父节点7变为红;
- 变换之后发现根节点7为红色不符合规则2,所以把以7为根节点的红黑树看成一个新插入的节点N2,再进行第三次变换。
第三次变换:符合情况1:
- 直接将根节点7变为黑色即可。
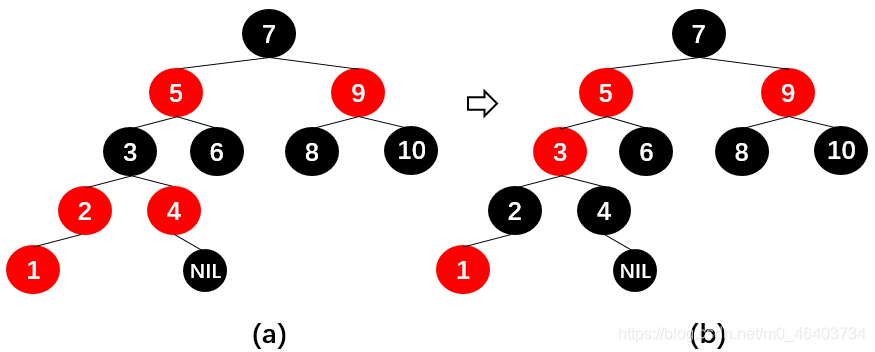
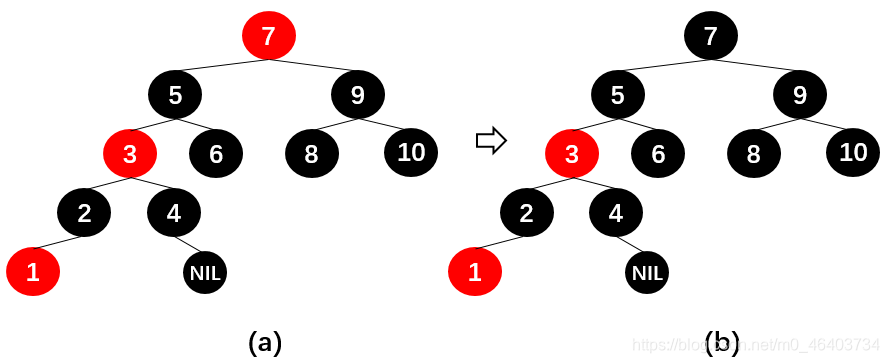
由此,完成了1~10节点的插入,虽然没有遇到情况5,不过情况5经过左旋转的操作便可转换为情况4,原理一样。如下图所示,将这棵红黑树的叶子节点NIL补全之后,经检验满足红黑树的五条规则,并且基本属于平衡树,效率较高。
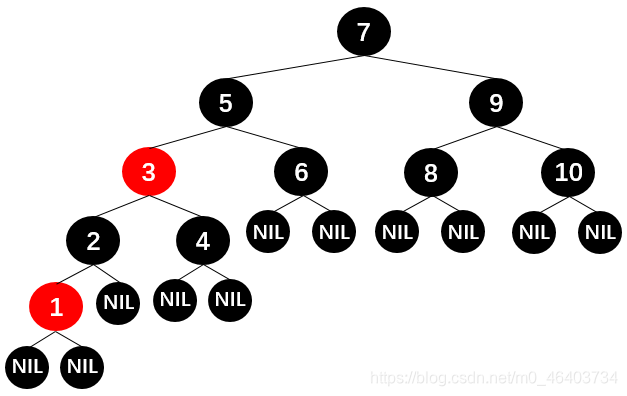
10、红黑树的删除操作
红黑树的删除操作结合了复杂的二叉树的删除操作和复杂的红黑树的插入规则,整体来说难度非常大,篇幅较长,这里暂不进行探讨。

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 1
 0
- 0


 已为社区贡献2条内容

所有评论(0)