十大经典排序算法大梳理 (动图+代码)
一、冒泡排序
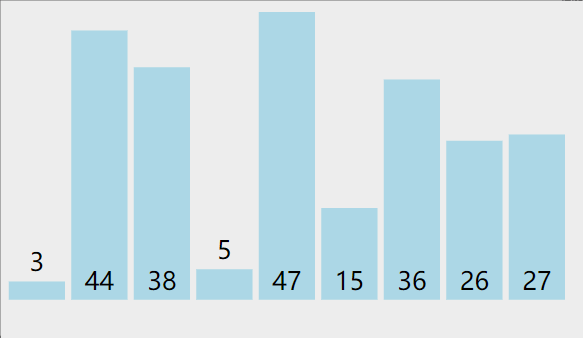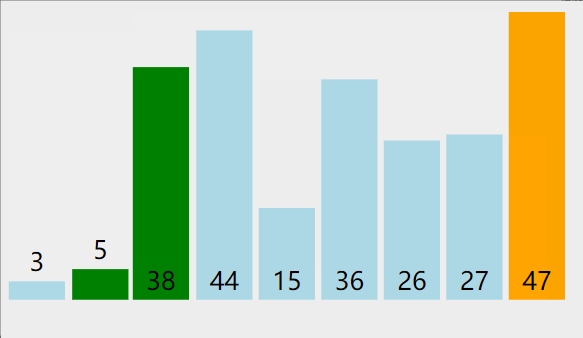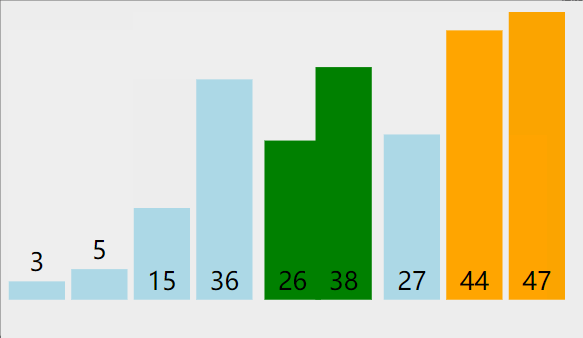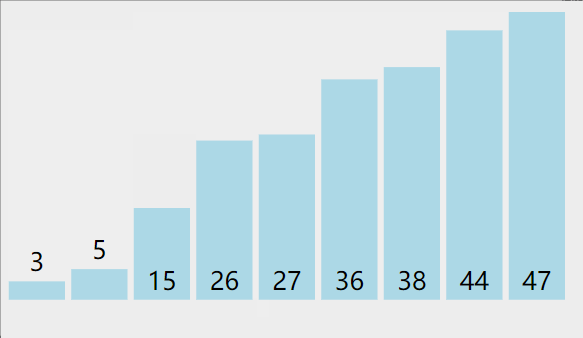
冒泡排序(Bubble Sort)也是一种简单直观的排序算法。它重复地走访过要排序的数列,一次比较两个元素,如果他们的顺序错误就把他们交换过来。走访数列的工作是重复地进行直到没有再需要交换,也就是说该数列已经排序完成。这个算法的名字由来是因为越小的元素会经由交换慢慢“浮”到数列的顶端。
作为最简单的排序算法之一,冒泡排序给我的感觉就像 Abandon 在单词书里出现的感觉一样,每次都在第一页第一位,所以最熟悉。冒泡排序还有一种优化算法,就是立一个 flag,当在一趟序列遍历中元素没有发生交换,则证明该序列已经有序。但这种改进对于提升性能来说并没有什么太大作用。
算法步骤:
1.比较相邻的元素。如果第一个比第二个打,就交换他们两个。
2.对每一对相邻元素做同样的工作,从开始第一对到结尾的最后一对。这步做完之后,最后的元素会是最大的数
3.针对所有的元素重复以上的步骤,除了最后一个
4.持续每次对越来越少的元素重复上面的步骤。直到没有任何一对数字需要比较。
def bubble_sort_pro(our_list):
    lastExchangeIndex = 0  # 记录最后一次交换元素的位置
    sortBorder = len(our_list)-1  # 无序数组边界
    for _ in range(len(our_list)-1):
        flag = True  # 有序标记,每轮开始初始值均为True
        for j in range(0,sortBorder):
            if our_list[j] > our_list[j+1]:
                our_list[j],our_list[j+1] = our_list[j+1],our_list[j]
                flag = False # 有元素交换,所以不跳出循环
                lastExchangeIndex = j
        sortBorder = lastExchangeIndex
        if flag:  # 当没有元素交换时 可以直接跳出循环
            break
    return our_list

# 测试
lis = [1, 3, 2, 9, 5, 4, 6, 19, 17, 21, 14]
print(bubble_sort_pro(lis))  # [1, 2, 3, 4, 5, 6, 9, 14, 17, 19, 21]
2、选择排序
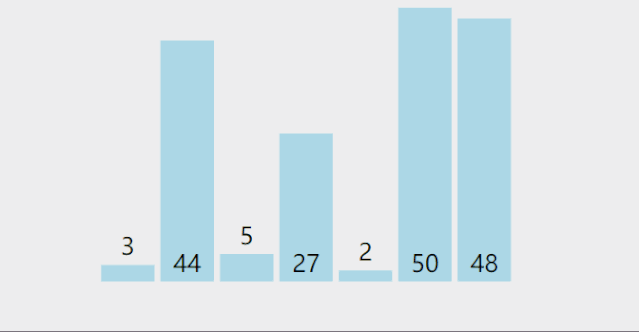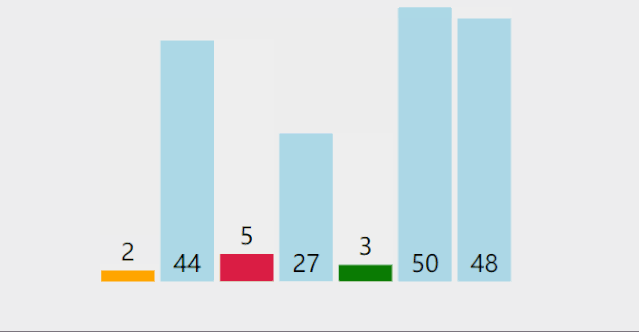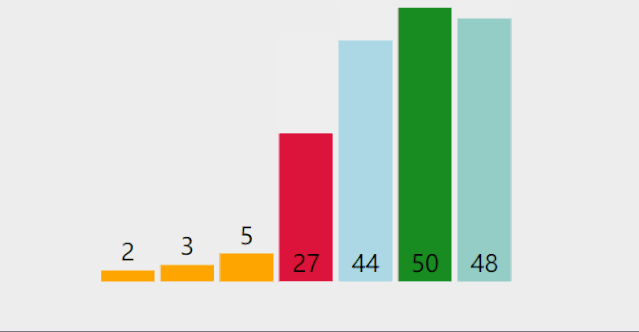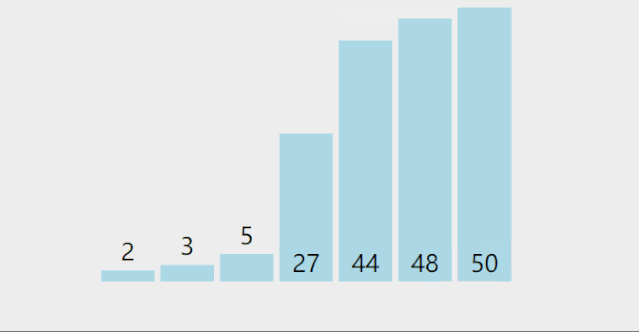
选择排序是一种简单直观的排序算法,无论什么数据进去都是 O(n²) 的时间复杂度。所以用到它的时候,数据规模越小越好。唯一的好处可能就是不占用额外的内存空间了吧。
算法步骤:
1.在未排序序列中找到最小(大)元素,存放到排序序列的起始位置
2.从剩余未排序元素中继续寻找最小(大)元素,然后放到已排序序列的末尾
3.以此类推,直到所有元素均排序完毕
3、插入排序
插入排序的代码实现虽然没有冒泡排序和选择排序那么简单粗暴,但它的原理应该是最容易理解的了,因为只要打过扑克牌的人都应该能够秒懂。插入排序是一种最简单直观的排序算法,它的工作原理是通过构建有序序列,对于未排序数据,在已排序序列中从后向前扫描,找到相应位置并插入。
插入排序和冒泡排序一样,也有一种优化算法,叫做拆半插入。
算法步骤:
1.从第一个元素开始,该元素可以认为已经被排序
2.取出下一个元素,在已经排序的元素序列中从后向前扫描
3.如果该元素(已排序)大于新元素,将该元素移到下一位置
4.重复步骤3,直到找到已排序的元素小于或者等于新元素的位置
5.将新元素插入到该位置后
6.重复步骤2~5
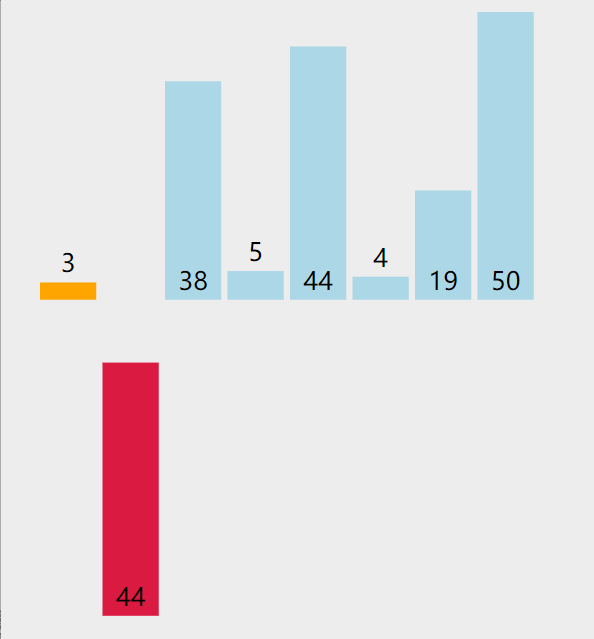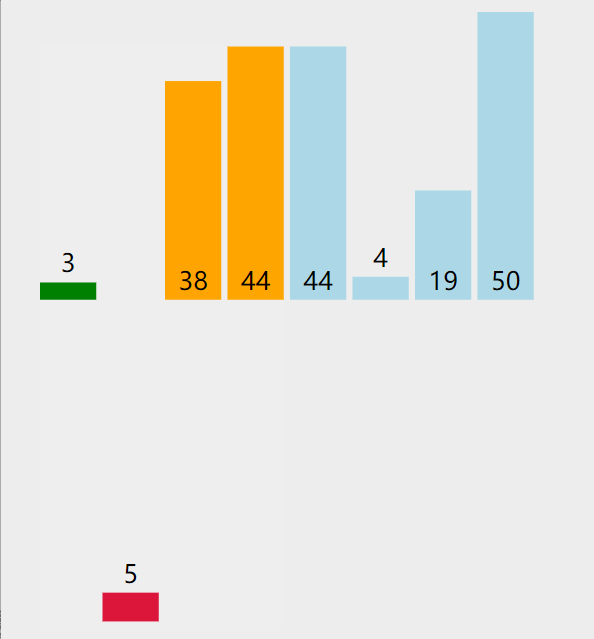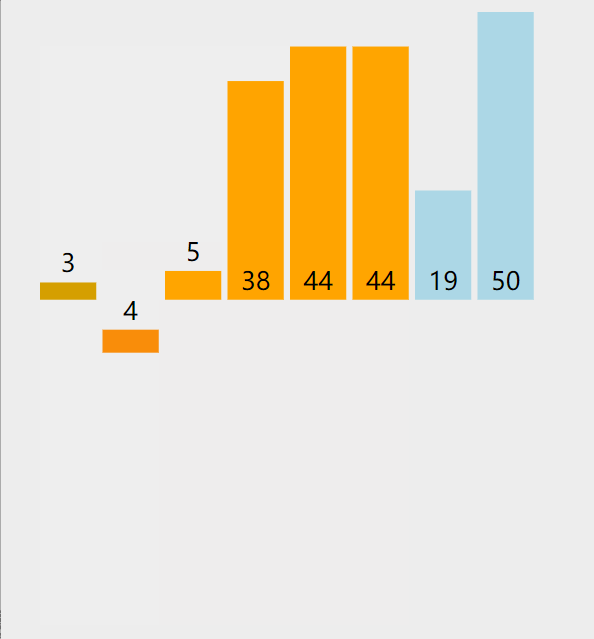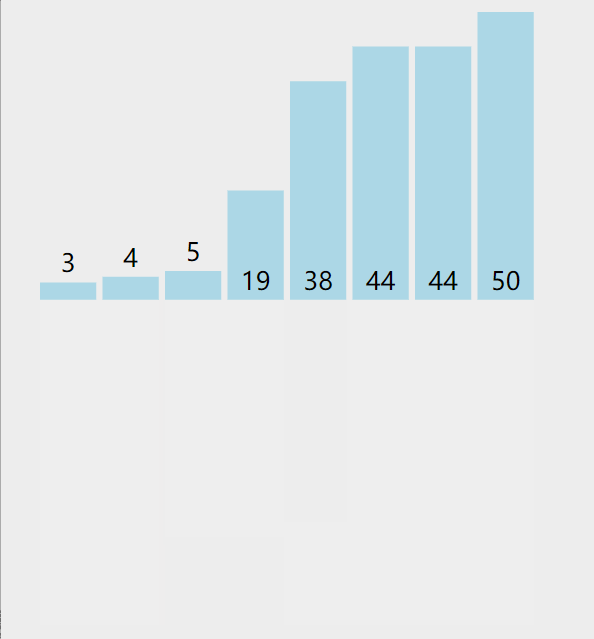
# 算法思想:
# 1.从第一个元素开始,该元素可以认为已经被排序
# 2.取出下一个元素,在已经排序的元素序列中从后向前扫描
# 3.如果该元素(已排序)大于新元素,将该元素移到下一位置
# 4.重复步骤3,直到找到已排序的元素小于或者等于新元素的位置
# 5.将新元素插入到该位置后
# 6.重复步骤2~5

def InsertSort(lst):
    n = len(lst)
    if n <= 1:
        return lst
    for i in range(1, n):
        j = i
        target = lst[i]  # 每次循环的一个待插入的数
        while j > 0 and target < lst[j - 1]:  # 比较、后移,给target腾位置
            lst[j] = lst[j - 1]
            j = j - 1
        lst[j] = target  # 把target插到空位
    return lst


arr = [1, 3, 2, 9, 5, 4, 6, 19, 17, 21, 14]
arr = InsertSort(arr)
print(arr)  # [1, 2, 3, 4, 5, 6, 9, 14, 17, 19, 21]
4、希尔排序
希尔排序,也称递减增量排序算法,是插入排序的一种更高效的改进版本。但希尔排序是非稳定排序算法。
希尔排序是基于插入排序的以下两点性质而提出改进方法的:
-
插入排序在对几乎已经排好序的数据操作时,效率高,即可以达到线性排序的效率;
-
但插入排序一般来说是低效的,因为插入排序每次只能将数据移动一位;
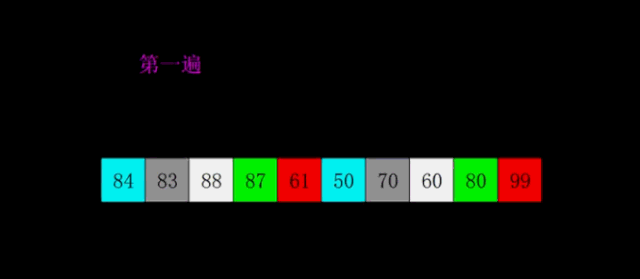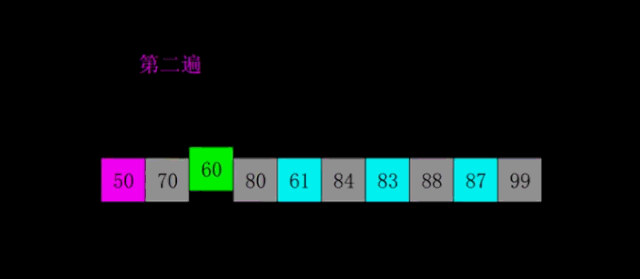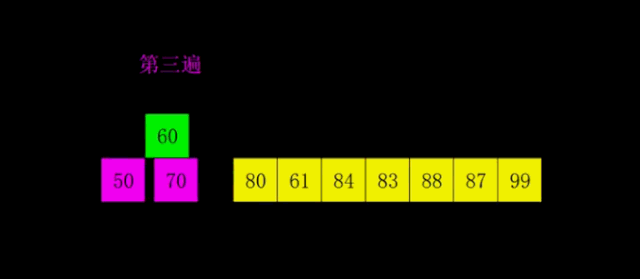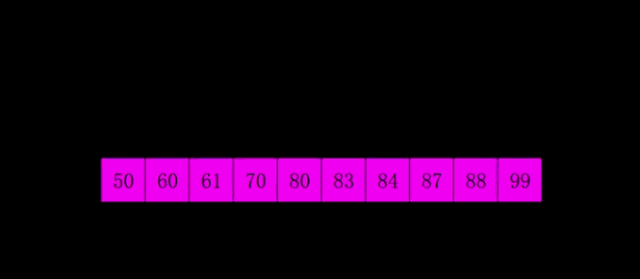
希尔排序的基本思想是:先将整个待排序的记录序列分割成为若干子序列分别进行直接插入排序,待整个序列中的记录“基本有序”时,再对全体记录进行依次直接插入排序。
算法步骤:
-
选择一个增量序列 t1,t2,……,tk,其中 ti > tj, tk = 1;
-
按增量序列个数 k,对序列进行 k 趟排序;
-
每趟排序,根据对应的增量 ti,将待排序列分割成若干长度为 m 的子序列,分别对各子表进行直接插入排序。仅增量因子为 1 时,整个序列作为一个表来处理,表长度即为整个序列的长度。
import math

def shellSort(arr):
    gap=1
    while(gap < len(arr)/3):
        gap = gap*3+1
    while gap > 0:
        for i in range(gap,len(arr)):
            temp = arr[i]
            j = i-gap
            while j >=0 and arr[j] > temp:
                arr[j+gap]=arr[j]
                j-=gap
            arr[j+gap] = temp
        gap = math.floor(gap/3)
    return arr
5、归并排序
归并排序(Merge sort)是建立在归并操作上的一种有效的排序算法。该算法是采用分治法(Divide and Conquer)的一个非常典型的应用。
作为一种典型的分而治之思想的算法应用,归并排序的实现由两种方法:
-
自上而下的递归(所有递归的方法都可以用迭代重写,所以就有了第 2 种方法);
-
自下而上的迭代;
和选择排序一样,归并排序的性能不受输入数据的影响,但表现比选择排序好的多,因为始终都是 O(nlogn) 的时间复杂度。代价是需要额外的内存空间。
算法步骤:
-
申请空间,使其大小为两个已经排序序列之和,该空间用来存放合并后的序列;
-
设定两个指针,最初位置分别为两个已经排序序列的起始位置;
-
比较两个指针所指向的元素,选择相对小的元素放入到合并空间,并移动指针到下一位置;
-
重复步骤 3 直到某一指针达到序列尾;
-
将另一序列剩下的所有元素直接复制到合并序列尾

def mergeSort(arr):
    import math
    if(len(arr)<2):
        return arr
    middle = math.floor(len(arr)/2)
    left, right = arr[0:middle], arr[middle:]
    return merge(mergeSort(left), mergeSort(right))

def merge(left,right):
    result = []
    while left and right:
        if left[0] <= right[0]:
            result.append(left.pop(0));
        else:
            result.append(right.pop(0));
    while left:
        result.append(left.pop(0));
    while right:
        result.append(right.pop(0));
    return result
6、快速排序
快速排序是由东尼·霍尔所发展的一种排序算法。在平均状况下,排序 n 个项目要 Ο(nlogn) 次比较。在最坏状况下则需要 Ο(n2) 次比较,但这种状况并不常见。事实上,快速排序通常明显比其他 Ο(nlogn) 算法更快,因为它的内部循环(inner loop)可以在大部分的架构上很有效率地被实现出来。
快速排序使用分治法(Divide and conquer)策略来把一个串行(list)分为两个子串行(sub-lists)。
快速排序又是一种分而治之思想在排序算法上的典型应用。本质上来看,快速排序应该算是在冒泡排序基础上的递归分治法。
快速排序的名字起的是简单粗暴,因为一听到这个名字你就知道它存在的意义,就是快,而且效率高!它是处理大数据最快的排序算法之一了。虽然 Worst Case 的时间复杂度达到了 O(n²),但是人家就是优秀,在大多数情况下都比平均时间复杂度为 O(n logn) 的排序算法表现要更好,可是这是为什么呢,我也不知道。好在我的强迫症又犯了,查了 N 多资料终于在《算法艺术与信息学竞赛》上找到了满意的答案:
快速排序的最坏运行情况是 O(n²),比如说顺序数列的快排。但它的平摊期望时间是 O(nlogn),且 O(nlogn) 记号中隐含的常数因子很小,比复杂度稳定等于 O(nlogn) 的归并排序要小很多。所以,对绝大多数顺序性较弱的随机数列而言,快速排序总是优于归并排序。
算法步骤:
-
从数列中挑出一个元素,称为 “基准”(pivot);
-
重新排序数列,所有元素比基准值小的摆放在基准前面,所有元素比基准值大的摆在基准的后面(相同的数可以到任一边)。在这个分区退出之后,该基准就处于数列的中间位置。这个称为分区(partition)操作;
-
递归地(recursive)把小于基准值元素的子数列和大于基准值元素的子数列排序;
递归的最底部情形,是数列的大小是零或一,也就是永远都已经被排序好了。虽然一直递归下去,但是这个算法总会退出,因为在每次的迭代(iteration)中,它至少会把一个元素摆到它最后的位置去。

def quickSort(arr, left=None, right=None):
    left = 0 if not isinstance(left,(int, float)) else left
    right = len(arr)-1 if not isinstance(right,(int, float)) else right
    if left < right:
        partitionIndex = partition(arr, left, right)
        quickSort(arr, left, partitionIndex-1)
        quickSort(arr, partitionIndex+1, right)
    return arr

def partition(arr, left, right):
    pivot = left
    index = pivot+1
    i = index
    while  i <= right:
        if arr[i] < arr[pivot]:
            swap(arr, i, index)
            index+=1
        i+=1
    swap(arr,pivot,index-1)
    return index-1

def swap(arr, i, j):
    arr[i], arr[j] = arr[j], arr[i]
7、堆排序
堆排序(Heapsort)是指利用堆这种数据结构所设计的一种排序算法。堆积是一个近似完全二叉树的结构,并同时满足堆积的性质:即子结点的键值或索引总是小于(或者大于)它的父节点。堆排序可以说是一种利用堆的概念来排序的选择排序。分为两种方法:
-
大顶堆:每个节点的值都大于或等于其子节点的值,在堆排序算法中用于升序排列;
-
小顶堆:每个节点的值都小于或等于其子节点的值,在堆排序算法中用于降序排列;
堆排序的平均时间复杂度为 Ο(nlogn)。
算法步骤:
-
创建一个堆 H[0……n-1];
-
把堆首(最大值)和堆尾互换;
-
把堆的尺寸缩小 1,并调用 shift_down(0),目的是把新的数组顶端数据调整到相应位置;
-
重复步骤 2,直到堆的尺寸为 1。

def buildMaxHeap(arr):
    import math
    for i in range(math.floor(len(arr)/2),-1,-1):
        heapify(arr,i)

def heapify(arr, i):
    left = 2*i+1
    right = 2*i+2
    largest = i
    if left < arrLen and arr[left] > arr[largest]:
        largest = left
    if right < arrLen and arr[right] > arr[largest]:
        largest = right

    if largest != i:
        swap(arr, i, largest)
        heapify(arr, largest)

def swap(arr, i, j):
    arr[i], arr[j] = arr[j], arr[i]

def heapSort(arr):
    global arrLen
    arrLen = len(arr)
    buildMaxHeap(arr)
    for i in range(len(arr)-1,0,-1):
        swap(arr,0,i)
        arrLen -=1
        heapify(arr, 0)
    return arr
8、计数排序
计数排序的核心在于将输入的数据值转化为键存储在额外开辟的数组空间中。作为一种线性时间复杂度的排序,计数排序要求输入的数据必须是有确定范围的整数。

def countingSort(arr, maxValue):
    bucketLen = maxValue+1
    bucket = [0]*bucketLen
    sortedIndex =0
    arrLen = len(arr)
    for i in range(arrLen):
        if not bucket[arr[i]]:
            bucket[arr[i]]=0
        bucket[arr[i]]+=1
    for j in range(bucketLen):
        while bucket[j]>0:
            arr[sortedIndex] = j
            sortedIndex+=1
            bucket[j]-=1
    return arr
9、桶排序
桶排序是计数排序的升级版。它利用了函数的映射关系,高效与否的关键就在于这个映射函数的确定。为了使桶排序更加高效,我们需要做到这两点:
-
在额外空间充足的情况下,尽量增大桶的数量
-
使用的映射函数能够将输入的 N 个数据均匀的分配到 K 个桶中
同时,对于桶中元素的排序,选择何种比较排序算法对于性能的影响至关重要。
什么时候最快
当输入的数据可以均匀的分配到每一个桶中。
什么时候最慢
当输入的数据被分配到了同一个桶中。
算法步骤:
-
设置一个定量的数组当作空桶子。
-
寻访序列,并且把项目一个一个放到对应的桶子去。
-
对每个不是空的桶子进行排序。
-
从不是空的桶子里把项目再放回原来的序列中。

def bucket_sort(s):
    """桶排序"""
    min_num = min(s)
    max_num = max(s)
    # 桶的大小
    bucket_range = (max_num-min_num) / len(s)
    # 桶数组
    count_list = [ [] for i in range(len(s) + 1)]
    # 向桶数组填数
    for i in s:
        count_list[int((i-min_num)//bucket_range)].append(i)
    s.clear()
    # 回填,这里桶内部排序直接调用了sorted
    for i in count_list:
        for j in sorted(i):
            s.append(j)

if __name__ == __main__ :
    a = [3.2,6,8,4,2,6,7,3]
    bucket_sort(a)
    print(a) # [2, 3, 3.2, 4, 6, 6, 7, 8]
10、基数排序
基数排序是一种非比较型整数排序算法,其原理是将整数按位数切割成不同的数字,然后按每个位数分别比较。由于整数也可以表达字符串(比如名字或日期)和特定格式的浮点数,所以基数排序也不是只能使用于整数。
基数排序 vs 计数排序 vs 桶排序
基数排序有两种方法:
这三种排序算法都利用了桶的概念,但对桶的使用方法上有明显差异:
-
基数排序:根据键值的每位数字来分配桶;
-
计数排序:每个桶只存储单一键值;
-
桶排序:每个桶存储一定范围的数值;
算法步骤:
-
取得数组中的最大数,并取得位数;
-
arr为原始数组,从最低位开始取每个位组成radix数组;
-
对radix进行计数排序(利用计数排序适用于小范围数的特点)

def RadixSort(list):
    i = 0                                    #初始为个位排序
    n = 1                                     #最小的位数置为1(包含0)
    max_num = max(list) #得到带排序数组中最大数
    while max_num > 10**n: #得到最大数是几位数
        n += 1
    while i < n:
        bucket = {} #用字典构建桶
        for x in range(10):
            bucket.setdefault(x, []) #将每个桶置空
        for x in list: #对每一位进行排序
            radix =int((x / (10**i)) % 10) #得到每位的基数
            bucket[radix].append(x) #将对应的数组元素加入到相 #应位基数的桶中
        j = 0
        for k in range(10):
            if len(bucket[k]) != 0: #若桶不为空
                for y in bucket[k]: #将该桶中每个元素
                    list[j] = y #放回到数组中
                    j += 1
        i += 1
    return  list

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 2
 0
- 0


 已为社区贡献1条内容

所有评论(0)