python时间序列异常检测库ADTK,风控算法工程师的福音
adtk简介
智能运维数据基本上都是时间序列形成的,时间序列数据的异常检测是风控算法的重要组成部分,而可以调用ADTK库完成基本的算法,和大家分享该库的使用。
adtk(Anomaly Detection Toolkit)是无监督异常检测的python工具包,它提供常用算法和处理函数:
- 简单有效的异常检测算法
- 异常特征加工
- 处理流程控制
安装:
pip install sdtk
数据要求
时间序列的数据主要包括时间和相应的指标(cpu,内存等),python做数据分析一般都是pandas 的DataFrame,adtk要求输入数据的索引必须是DateimeIndex。
pandas提供了时间序列的时间生成和处理方法。
时间生成:
-
pd.date_range
-
pd.Timestamp
时间处理:
- pd.to_datetime
adtk提供是validate_series来验证时间序列数据的有效性,如是否按时间顺序
import pandas as pd
from adtk.data import validate_series
from adtk.visualization import plot
df=pd.read.read_csv('./data/nyc_taxi.csv', index_col="timestamp", parse_dates=True)
df = validate_series(df)
plot(df)
异常特征加工
时间序列特征加工方法包括:
1,对滑动窗口中的数据进行特征统计
2,对季节性趋势做分解,区分哪些是季节性的部分,哪些是趋势的部分
3,时间序列降维映射:主要应用于多维度时间序列
1.滑动窗口
adtk提供单个宽口RollingAggregate和2个窗口DoubleRollingAggregate的滑动方式。统计特征支持均值,中位数,汇总,最大值,最小值,分位数, 方差,标准差,偏度,峰度,直方图 等,[‘mean’, ‘median’, ‘sum’, ‘min’, ‘max’, ‘quantile’, ‘iqr’, ‘idr’, ‘count’, ‘nnz’, ‘nunique’, ‘std’, ‘var’, ‘skew’, ‘kurt’, ‘hist’]其中
‘iqr’: 是分位数 75% 和 25%差值
‘idr’: 是分位数 90% 和 10%插值
- RollingAggregate
 import pandas as pd
from adtk.data import validate_series
from adtk.transformer import RollingAggregate
from adtk.transformer import DoubleRollingAggregate
s = pd.read_csv('./data/nyc_taxi.csv', index_col="timestamp", parse_dates=True)
s = validate_series(s)

s_transformed = RollingAggregate(agg='quantile',agg_params={"q": [0.25, 0.75]}, window=5).transform(s)
- DoubleRollingAggregate
计算两个窗口之间统计特征之间的差异特征,如前5分钟和后5分钟,均值的差值等。特征的二次加工和利用,参数diff主要衡量差距的函数:
import pandas as pd
from adtk.data import validate_series
from adtk.transformer import DoubleRollingAggregate
s = pd.read_csv('./data/ec2_cpu_utilization_53ea38.csv', index_col="timestamp", parse_dates=True)
s = validate_series(s)

s_transformed = DoubleRollingAggregate(
    agg="median",
    window=5,
    diff="diff").transform(s)
参数:
diff:
rel_diff:
l1:
l2:
2.季节性拆解
时间序列可拆解成趋势性,季节性和残差部分。atdk中ClassicSeasonalDecomposition提供了这三个部分拆解,并移除趋势和季节性部分,返回残差部分。
freq: 设置季节性的周期
trend:可以设置是否保留趋势性
s_transformed = ClassicSeasonalDecomposition(trend=True).fit_transform(s)
3.降维和重构
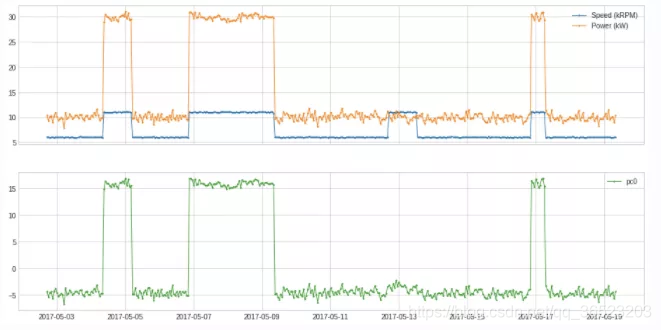
adtk提供的pca对数据进行降维到主成分PcaProjection和重构方法PcaReconstruction。
df = pd.read_csv('./data/generator.csv', index_col="Time", parse_dates=True)
df = validate_series(df)

from adtk.transformer import PcaProjection
s = PcaProjection(k=1).fit_transform(df)
plot(pd.concat([df, s], axis=1), ts_linewidth=1, ts_markersize=3, curve_group=[("Speed (kRPM)", "Power (kW)"), "pc0"]);
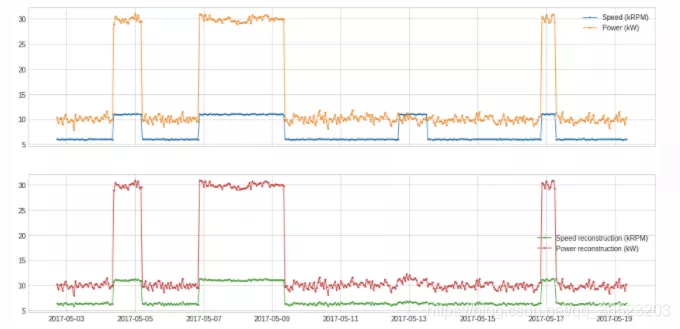
重构
from adtk.transformer import PcaReconstruction
df_transformed = PcaReconstruction(k=1).fit_transform(df).rename(columns={"Speed (kRPM)": "Speed reconstruction (kRPM)", "Power (kW)": "Power reconstruction (kW)"})
plot(pd.concat([df, df_transformed], axis=1), ts_linewidth=1, ts_markersize=3, curve_group=[("Speed (kRPM)", "Power (kW)"), ("Speed reconstruction (kRPM)", "Power reconstruction (kW)")]);
../_images/notebooks_demo_99_0.png
异常检测算法
提供的主要是无监督或基于规则的时间序列检测算法,可以用于常规的异常检测。
1.离群点检测
1,ThresholdAD 阈值 根据设置的上下限找出异常点
2.QuantileAD 根据历史值计算出对应的上下阈值
3.InterQuartileRangeAD 箱线图算法,确定上下限
2.突变点检测
Spike and Level Shift 异常的表现形式不是离群点,而是通过和临近点的比较,即突增或者突降。adtk提供adtk.detector.PersistAD 和 adtk.detector.LevelShiftAD检测方法:
- PersistAD
adtk.detector.PersistAD(window=1, c=3.0, side=‘both’, min_periods=None, agg=‘median’)
参数:
window:参考窗长度,可为int, str
c:分位距倍数,用于确定上下限范围
side:检测范围,为’positive’时检测突增,为’negative’时检测突降,为’both’时突增突降都检测
min_periods:参考窗中最小个数,小于此个数将会报异常,默认为None,表示每个时间点都得有值
agg:参考窗中的统计量计算方式,因为当前值是与参考窗中产生的统计量作比较,所以得将参考窗中的数据计算成统计量,默认’median’,表示去参考窗的中位值
原理:
用滑动窗口遍历历史数据,将窗口后的一位数据与参考窗中的统计量做差,得到一个新的时间序列s1;
计算s1的(Q1-cIQR, Q3+cIQR) 作为正常范围;
若当前值与它参考窗中的统计量之差,不在2中的正常范围内,视为异常。
调参:
window:越大,模型越不敏感,不容易被突刺干扰
c:越大,对于波动大的数据,正常范围放大较大,对于波动较小的数据,正常范围放大较小
min_periods:对缺失值的容忍程度,越大,越不允许有太多的缺失值
agg:统计量的聚合方式,跟统计量的特性有关,如 'median’不容易受极端值影响
总结:先计算一条新的时间序列,再用箱线图作异常检测
from adtk.detector import PersistAD
persist_ad = PersistAD(c=3.0, side='positive')
anomalies = persist_ad.fit_detect(s)
- LevelShiftAD
adtk.detector.LevelShiftAD(window, c=6.0, side=‘both’, min_periods=None)
参数:window:支持(10,5),表示使用两个相邻的滑动窗,左侧的窗中的中位值表示参考值,右侧窗中的中位值表示当前值
c:越大,对于波动大的数据,正常范围放大较大,对于波动较小的数据,正常范围放大较小,默认6.0
side:检测范围,为’positive’时检测突增,为’negative’时检测突降,为’both’时突增突降都检测
min_periods:参考窗中最小个数,小于此个数将会报异常,默认为None,表示每个时间点都得有值
原理:该模型用于检测突变情况,相比于PersistAD,其抗抖动能力较强,不容易出现误报
from adtk.detector import LevelShiftAD
level_shift_ad = LevelShiftAD(c=6.0, side='both', window=5)
anomalies = level_shift_ad.fit_detect(s)
3.季节性检测(检测出不符合季节性周期的点)
正常数据满足周期性变化,异常点不满足周期变化。
- adtk.detector.SeasonalAD
adtk.detector.SeasonalAD(freq=None, side=‘both’, c=3.0, trend=False)
SeasonalAD主要是根据ClassicSeasonalDecomposition来处理,判断。
参数: - freq:季节性周期
- c:越大,对于波动大的数据,正常范围放大较大,对于波动较小的数据,正常范围放大较小,默认6.0
side:检测范围,为’positive’时检测突增,为’negative’时检测突降,为’both’时突增突降都检测 - trend: 是否考虑趋势
from adtk.detector import SeasonalAD
seasonal_ad = SeasonalAD(c=3.0, side="both")
anomalies = seasonal_ad.fit_detect(s)
plot(s, anomaly=anomalies, ts_markersize=1, anomaly_color='red', anomaly_tag="marker", anomaly_markersize=2);
4.pipe组合算法
将多个异常检测算法组合使用。
from adtk.pipe import Pipeline
steps = [
    ("deseasonal", ClassicSeasonalDecomposition()),
    ("quantile_ad", QuantileAD(high=0.995, low=0.005))
]
pipeline = Pipeline(steps)
anomalies = pipeline.fit_detect(s)
plot(s, anomaly=anomalies, ts_markersize=1, anomaly_markersize=2, anomaly_tag="marker", anomaly_color='red');

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 1
 0
- 0


 已为社区贡献1条内容

所有评论(0)