depth-anythingv2用自己的数据集做绝对深度微调尝试
·
按照官方的metric_depth文档进行微调。
metric_depth/train.py
import argparse
import logging
import os
import pprint
import random

import warnings
import numpy as np
import torch
import torch.backends.cudnn as cudnn
import torch.distributed as dist
from torch.utils.data import DataLoader
from torch.optim import AdamW
import torch.nn.functional as F
from torch.utils.tensorboard import SummaryWriter

from dataset.hypersim import Hypersim
from dataset.kitti import KITTI
from dataset.vkitti2 import VKITTI2
from depth_anything_v2.dpt import DepthAnythingV2
from util.dist_helper import setup_distributed
from util.loss import SiLogLoss
from util.metric import eval_depth
from util.utils import init_log


parser = argparse.ArgumentParser(description='Depth Anything V2 for Metric Depth Estimation')

parser.add_argument('--encoder', default='vitl', choices=['vits', 'vitb', 'vitl', 'vitg'])
parser.add_argument('--dataset', default='hypersim', choices=['hypersim', 'vkitti'])
parser.add_argument('--img-size', default=518, type=int)
parser.add_argument('--min-depth', default=0.001, type=float)
parser.add_argument('--max-depth', default=20, type=float)
parser.add_argument('--epochs', default=100, type=int)
parser.add_argument('--bs', default=1, type=int)
parser.add_argument('--lr', default=0.000005, type=float)
parser.add_argument('--pretrained-from',  default="./checkpoints/depth_anything_v2_vitl.pth",type=str)
parser.add_argument('--save-path', type=str, required=True)
parser.add_argument('--local-rank', default=0, type=int)
parser.add_argument('--port', default=None, type=int)


def main():
    args = parser.parse_args()

    warnings.simplefilter('ignore', np.RankWarning)

    logger = init_log('global', logging.INFO)
    logger.propagate = 0

    rank, world_size = setup_distributed(port=args.port)

    if rank == 0:
        all_args = {**vars(args), 'ngpus': world_size}
        logger.info('{}\n'.format(pprint.pformat(all_args)))
        writer = SummaryWriter(args.save_path)

    cudnn.enabled = True
    cudnn.benchmark = True

    size = (args.img_size, args.img_size)
    if args.dataset == 'hypersim':
        trainset = Hypersim('dataset/splits/hypersim/train.txt', 'train', size=size)
    elif args.dataset == 'vkitti':
        trainset = KITTI('dataset/splits/vkitti2/train.txt', 'train', size=size)
    else:
        raise NotImplementedError
    trainsampler = torch.utils.data.distributed.DistributedSampler(trainset)
    trainloader = DataLoader(trainset, batch_size=args.bs, pin_memory=True, num_workers=4, drop_last=True, sampler=trainsampler)

    if args.dataset == 'hypersim':
        valset = Hypersim('dataset/splits/hypersim/val.txt', 'val', size=size)
    elif args.dataset == 'vkitti':
        valset = KITTI('dataset/splits/kitti/val.txt', 'train', size=size)
    else:
        raise NotImplementedError
    valsampler = torch.utils.data.distributed.DistributedSampler(valset)
    valloader = DataLoader(valset, batch_size=1, pin_memory=True, num_workers=4, drop_last=True, sampler=valsampler)

    local_rank = int(os.environ["LOCAL_RANK"])

    model_configs = {
        'vits': {'encoder': 'vits', 'features': 64, 'out_channels': [48, 96, 192, 384]},
        'vitb': {'encoder': 'vitb', 'features': 128, 'out_channels': [96, 192, 384, 768]},
        'vitl': {'encoder': 'vitl', 'features': 256, 'out_channels': [256, 512, 1024, 1024]},
        'vitg': {'encoder': 'vitg', 'features': 384, 'out_channels': [1536, 1536, 1536, 1536]}
    }
    model = DepthAnythingV2(**{**model_configs[args.encoder], 'max_depth': args.max_depth})

    if args.pretrained_from:
        model.load_state_dict({k: v for k, v in torch.load(args.pretrained_from, map_location='cpu').items() if 'pretrained' in k}, strict=False)

    model = torch.nn.SyncBatchNorm.convert_sync_batchnorm(model)
    model.cuda(local_rank)
    model = torch.nn.parallel.DistributedDataParallel(model, device_ids=[local_rank], broadcast_buffers=False,
                                                      output_device=local_rank, find_unused_parameters=True)

    criterion = SiLogLoss().cuda(local_rank)

    optimizer = AdamW([{'params': [param for name, param in model.named_parameters() if 'pretrained' in name], 'lr': args.lr},
                       {'params': [param for name, param in model.named_parameters() if 'pretrained' not in name], 'lr': args.lr * 10.0}],
                      lr=args.lr, betas=(0.9, 0.999), weight_decay=0.01)

    total_iters = args.epochs * len(trainloader)

    previous_best = {'d1': 0, 'd2': 0, 'd3': 0, 'abs_rel': 100, 'sq_rel': 100, 'rmse': 100, 'rmse_log': 100, 'log10': 100, 'silog': 100}

    for epoch in range(args.epochs):
        if rank == 0:
            logger.info('===========> Epoch: {:}/{:}, d1: {:.3f}, d2: {:.3f}, d3: {:.3f}'.format(epoch, args.epochs, previous_best['d1'], previous_best['d2'], previous_best['d3']))
            logger.info('===========> Epoch: {:}/{:}, abs_rel: {:.3f}, sq_rel: {:.3f}, rmse: {:.3f}, rmse_log: {:.3f}, '
                        'log10: {:.3f}, silog: {:.3f}'.format(
                            epoch, args.epochs, previous_best['abs_rel'], previous_best['sq_rel'], previous_best['rmse'],
                            previous_best['rmse_log'], previous_best['log10'], previous_best['silog']))

        trainloader.sampler.set_epoch(epoch + 1)

        model.train()
        total_loss = 0

        for i, sample in enumerate(trainloader):
            optimizer.zero_grad()

            img, depth, valid_mask = sample['image'].cuda(), sample['depth'].cuda(), sample['valid_mask'].cuda()
            print(f"[DEBUG] img shape: {img.shape}")
            print(f"[DEBUG] depth shape: {depth.shape}")
            print(f"[DEBUG] valid_mask shape: {valid_mask.shape}")

            if random.random() < 0.5:
                img = img.flip(-1)
                depth = depth.flip(-1)
                valid_mask = valid_mask.flip(-1)

            pred = model(img)
            print(f"[DEBUG] pred shape: {pred.shape}")
            loss = criterion(pred, depth, (valid_mask == 1) & (depth >= args.min_depth) & (depth <= args.max_depth))

            loss.backward()
            optimizer.step()

            total_loss += loss.item()

            iters = epoch * len(trainloader) + i

            lr = args.lr * (1 - iters / total_iters) ** 0.9

            optimizer.param_groups[0]["lr"] = lr
            optimizer.param_groups[1]["lr"] = lr * 10.0

            if rank == 0:
                writer.add_scalar('train/loss', loss.item(), iters)

            if rank == 0 and i % 100 == 0:
                logger.info('Iter: {}/{}, LR: {:.7f}, Loss: {:.3f}'.format(i, len(trainloader), optimizer.param_groups[0]['lr'], loss.item()))

        model.eval()

        results = {'d1': torch.tensor([0.0]).cuda(), 'd2': torch.tensor([0.0]).cuda(), 'd3': torch.tensor([0.0]).cuda(),
                   'abs_rel': torch.tensor([0.0]).cuda(), 'sq_rel': torch.tensor([0.0]).cuda(), 'rmse': torch.tensor([0.0]).cuda(),
                   'rmse_log': torch.tensor([0.0]).cuda(), 'log10': torch.tensor([0.0]).cuda(), 'silog': torch.tensor([0.0]).cuda()}
        nsamples = torch.tensor([0.0]).cuda()

        for i, sample in enumerate(valloader):

            img, depth, valid_mask = sample['image'].cuda().float(), sample['depth'].cuda()[0], sample['valid_mask'].cuda()[0]


            with torch.no_grad():
                pred = model(img)
                print(f"[DEBUG] val pred shape: {pred.shape}")
                pred = F.interpolate(pred[:, None], depth.shape[-2:], mode='bilinear', align_corners=True)[0, 0]

            valid_mask = (valid_mask == 1) & (depth >= args.min_depth) & (depth <= args.max_depth)
            print(f"[DEBUG] val depth shape: {depth.shape}")
            print(f"[DEBUG] val valid_mask shape: {valid_mask.shape}")
            if valid_mask.sum() < 10:
                continue

            cur_results = eval_depth(pred[valid_mask], depth[valid_mask])

            for k in results.keys():
                results[k] += cur_results[k]
            nsamples += 1

        torch.distributed.barrier()

        for k in results.keys():
            dist.reduce(results[k], dst=0)
        dist.reduce(nsamples, dst=0)

        if rank == 0:
            logger.info('==========================================================================================')
            logger.info('{:>8}, {:>8}, {:>8}, {:>8}, {:>8}, {:>8}, {:>8}, {:>8}, {:>8}'.format(*tuple(results.keys())))
            logger.info('{:8.3f}, {:8.3f}, {:8.3f}, {:8.3f}, {:8.3f}, {:8.3f}, {:8.3f}, {:8.3f}, {:8.3f}'.format(*tuple([(v / nsamples).item() for v in results.values()])))
            logger.info('==========================================================================================')
            print()

            for name, metric in results.items():
                writer.add_scalar(f'eval/{name}', (metric / nsamples).item(), epoch)

        for k in results.keys():
            if k in ['d1', 'd2', 'd3']:
                previous_best[k] = max(previous_best[k], (results[k] / nsamples).item())
            else:
                previous_best[k] = min(previous_best[k], (results[k] / nsamples).item())

        if rank == 0:
            checkpoint = {
                'model': model.state_dict(),
                'optimizer': optimizer.state_dict(),
                'epoch': epoch,
                'previous_best': previous_best,
            }
            torch.save(checkpoint, os.path.join(args.save_path, 'latest.pth'))


if __name__ == '__main__':
    main()
metric_depth/dataset/kitti.py
import cv2
import torch
from torch.utils.data import Dataset
from torchvision.transforms import Compose

from dataset.transform import Resize, NormalizeImage, PrepareForNet


class KITTI(Dataset):
    def __init__(self, filelist_path, mode, size=(518, 518)):
        #if mode != 'val':
        #    raise NotImplementedError

        self.mode = mode
        self.size = size

        with open(filelist_path, 'r') as f:
            self.filelist = f.read().splitlines()

        net_w, net_h = size
        self.transform = Compose([
            Resize(
                width=net_w,
                height=net_h,
                resize_target=True if mode == 'train' else False,
                keep_aspect_ratio=True,
                ensure_multiple_of=14,
                resize_method='lower_bound',
                image_interpolation_method=cv2.INTER_CUBIC,
            ),
            NormalizeImage(mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225]),
            PrepareForNet(),
        ])

    def __getitem__(self, item):
        img_path = self.filelist[item].split(' ')[0]
        depth_path = self.filelist[item].split(' ')[1]

        image = cv2.imread(img_path)
        image = cv2.cvtColor(image, cv2.COLOR_BGR2RGB) / 255.0

        depth = cv2.imread(depth_path, 0).astype('float32')

        sample = self.transform({'image': image, 'depth': depth})

        sample['image'] = torch.from_numpy(sample['image'])
        sample['depth'] = torch.from_numpy(sample['depth'])
        sample['depth'] = sample['depth'] / 256.0  # convert in meters

        sample['valid_mask'] = sample['depth'] > 0

        sample['image_path'] = self.filelist[item].split(' ')[0]

        return sample

    def __len__(self):
        return len(self.filelist)
数据集就按照正常的彩色图和深度图(单通道)来,train.txt和val.txt中写入自己的数据集图片(彩色图路径 深度图路径),分别放在metric_depth/dataset/splits/vkitti2和metric_depth/dataset/splits/kitti中,如图所示。

训练指令为
RANK=0 WORLD_SIZE=1 LOCAL_RANK=0 MASTER_ADDR=localhost MASTER_PORT=10002 python train.py --save-path ./checkpoints --dataset vkitti
训练好之后测试指令为
python run.py --img-path /home/liu/Depth-Anything-V2-main/metric_depth/test/rgb --encoder vitl --load-from checkpoints/latest.pth
我这里训练完成后图像有棋盘格状伪影,查阅相关资料是ConvTranspose2d的原因,在metric_depth/depth_anything_v2/dpt.py中将其替换。
class DPTHead(nn.Module):
    def __init__(
        self,
        in_channels,
        features=256,
        use_bn=False,
        out_channels=[256, 512, 1024, 1024],
        use_clstoken=False
    ):
        super(DPTHead, self).__init__()

        self.use_clstoken = use_clstoken

        self.projects = nn.ModuleList([
            nn.Conv2d(
                in_channels=in_channels,
                out_channels=out_channel,
                kernel_size=1,
                stride=1,
                padding=0,
            ) for out_channel in out_channels
        ])

        self.resize_layers = nn.ModuleList([
            # 替换第一个转置卷积 (4x上采样)
            nn.Sequential(
                 nn.Upsample(scale_factor=4, mode='bilinear', align_corners=True),
                 nn.Conv2d(out_channels[0], out_channels[0], kernel_size=3, padding=1)
                 ),
    # 替换第二个转置卷积 (2x上采样)
            nn.Sequential(
                nn.Upsample(scale_factor=2, mode='bilinear', align_corners=True),
                nn.Conv2d(out_channels[1], out_channels[1], kernel_size=3, padding=1)
                ),
            nn.Identity(),
            nn.Conv2d(
                in_channels=out_channels[3],
                out_channels=out_channels[3],
                kernel_size=3,
                stride=2,
                padding=1)
        ])
最终结果如图


微调前模型输出的相对深度图如下图
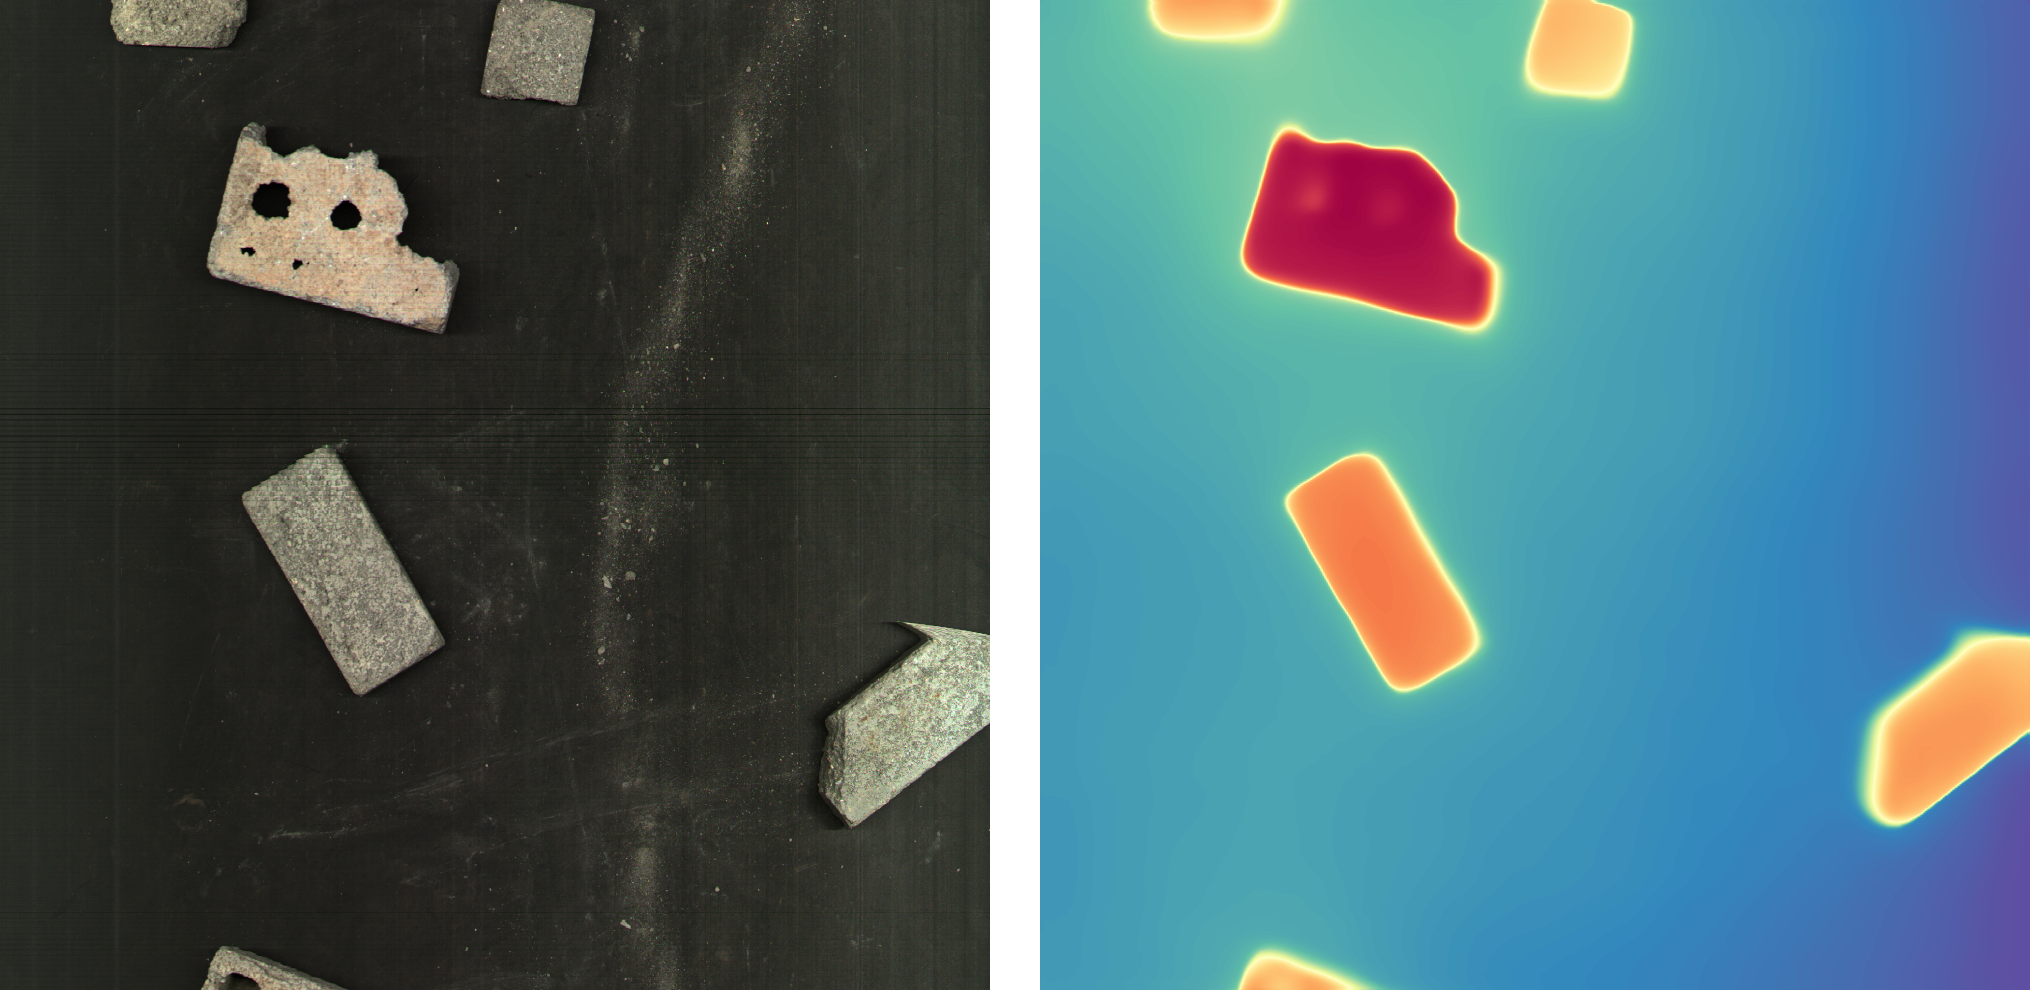
实际深度图为

简单尝试了一下,不确定是否有操作错误,仅作一个参考。

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 11
 0
- 0


 已为社区贡献2条内容

所有评论(0)