mysql开窗函数over使用分析
·
背景
自mysql8.0之后支持了开窗函数,开窗函数主要解决了,明细数据列表增加一列展示聚合后的值,如分数score表,有所有学生的分数,在我们想看每位学生分数的同时还想查看这门课的平均分,或者最大分,或者最小分,没有开窗函数之前解决起来比较麻烦,有了开窗函数之后可以很方便的解决如下:
select
    student_name, -- 学生姓名
    score,avg(score) over(partition by class_id) -- 根据课程id分组后取分数平均值
from score_table -- 分数表
常用开窗函数
除了和max,min,avg,count,sum搭配之外,还支持和以下函数组合:
| 分类 | 函数 | 作用 |
| 序号函数 | ROW_NUMBER() | (添加序号)会为结果集中的每一行分配一个唯一的连续整数序号,不会有重复的序号。当有相同排序值时,每行都会有不同的序号。 |
| RANK() | (排名)会为结果集中的每一行分配一个排名,如果有相同的排序值,则会跳过相同的排名,下一个排名会按照跳过的数量递增。 | |
| DENSE_RANK() | (排名)也会为结果集中的每一行分配一个排名,但不会跳过相同的排名,相同的排序值会有相同的排名,排名是连续的。 | |
| 分布函数 | PERCENT_RANK() | 用于计算某一行在结果集中的相对排名百分比。它返回一个介于0和1之间的值,表示当前行在整个结果集中的相对位置。(rank-1)/(rows-1) |
| CUME_DIST() | 用于计算某一行在结果集中的累积分布值。它返回一个介于0和1之间的值,表示当前行在整个结果集中的累积分布比例。<=当前rank值的行数/总行数 | |
| 前后函数 | LAG(expr,n) | 返回当前行的前n行的expr的值 |
| LEAD(expr,n) | 返回当前行的后n行的expr的值 | |
| 头尾函数 | FIRST_VALUE(expr) | 返回第一个expr的值 |
| LAST_VALUE(expr) | 返回最后一个expr的值 | |
| 其他函数 | NTH_VALUE(expr,n) | 返回第n个expr的值 |
| NTILE (n) | 将有序数据分为n个桶,记录等级数 |
初始化表结构
CREATE TABLE `score_test` (
  `id` bigint unsigned NOT NULL AUTO_INCREMENT COMMENT '主键id【updt:0】【Sec:D】【STD:Num】',
  `score` int NOT NULL COMMENT 'score【updt:n】【Sec:D】【STD:date】',
  `class_id` int NOT NULL COMMENT 'class_id【updt:n】【Sec:D】【STD:date】',
  PRIMARY KEY (`id`)
) ENGINE=InnoDB AUTO_INCREMENT=16 DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_0900_ai_ci COMMENT='score_test';

INSERT INTO score_test (score, class_id) VALUES(100, 1);
INSERT INTO score_test (score, class_id) VALUES(90, 1);
INSERT INTO score_test (score, class_id) VALUES(59, 1);
INSERT INTO score_test (score, class_id) VALUES(30, 1);
INSERT INTO score_test (score, class_id) VALUES(40, 1);
INSERT INTO score_test (score, class_id) VALUES(20, 2);
INSERT INTO score_test (score, class_id) VALUES(25, 2);
INSERT INTO score_test (score, class_id) VALUES(35, 2);
INSERT INTO score_test (score, class_id) VALUES(55, 2);
INSERT INTO score_test (score, class_id) VALUES(65, 2);
INSERT INTO score_test (score, class_id) VALUES(100, 2);
INSERT INTO score_test (score, class_id) VALUES(85, 3);
INSERT INTO score_test (score, class_id) VALUES(95, 3);
INSERT INTO score_test (score, class_id) VALUES(58, 3);
INSERT INTO score_test (score, class_id) VALUES(58, 4);
原始数据如下

执行开窗函数效果
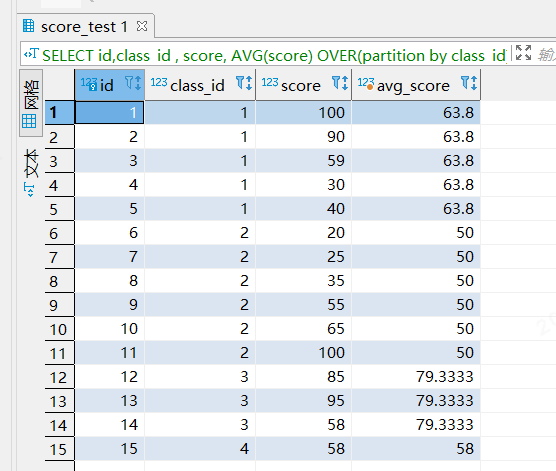
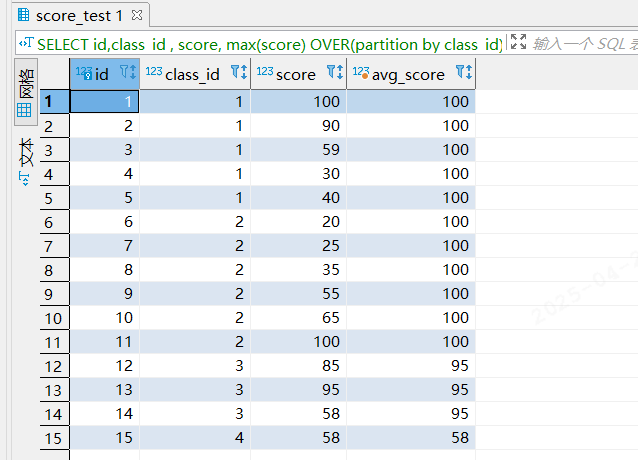
如果开窗函数中存在partition那么聚合函数将根据分区进行聚合,不同分区聚合结果不一样
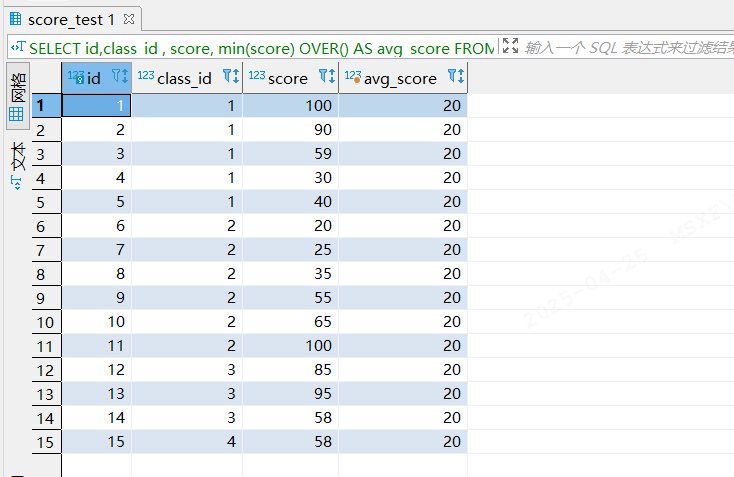
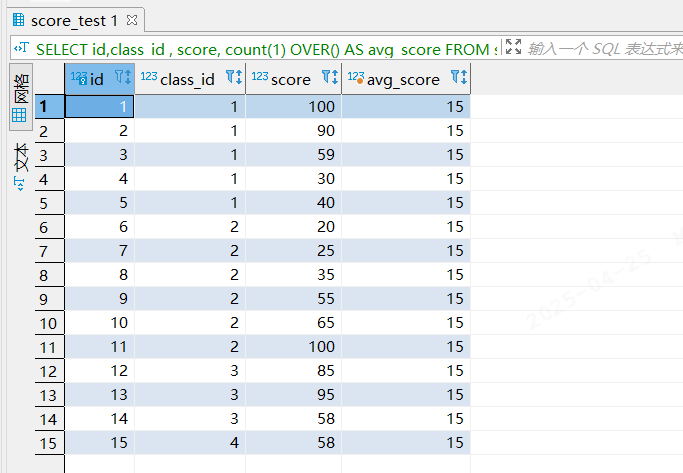
如果没有partition那么将对整个结果进行聚合
avg+over+partition
SELECT id,class_id , score, AVG(score) OVER(partition by class_id) AS avg_score
FROM score_test
max+over+partition
SELECT id,class_id , score, max(score) OVER(partition by class_id) AS avg_score
FROM score_test
min+over+partition
SELECT id,class_id , score, min(score) OVER(partition by class_id) AS avg_score
FROM score_test

min+over
SELECT id,class_id , score, min(score) OVER() AS avg_score
FROM score_test
count+over
SELECT id,class_id , score, count(1) OVER() AS avg_score
FROM score_test
sum+over+partition
SELECT id,class_id , score, sum(score) OVER(partition by class_id) AS avg_score
FROM score_test

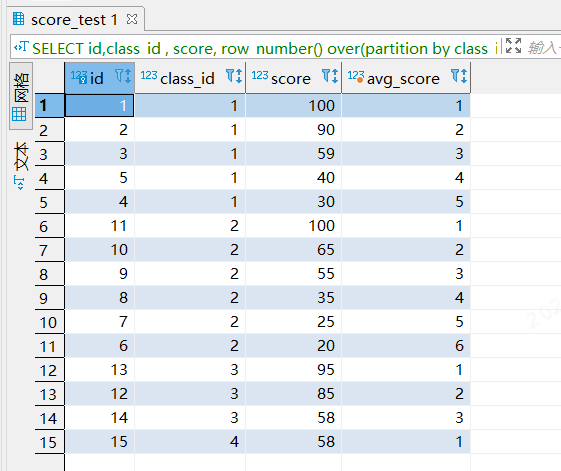
row_number+over+partition+orderby
SELECT id,class_id , score, row_number() over(partition by class_id order by score desc) AS avg_score
FROM score_test
rank,dense_rank,lead,lag,first_value,last_value
SELECT id,class_id ,score,
rank() over( order by score desc) as '<所有数据>排名',
rank() over(partition by class_id order by score desc) as '<当前分区>排名',
dense_rank() over(partition by class_id order by score desc) as '<当前分区>稠密排名',
lead(score,3) over(partition by class_id order by score desc) as '<当前分区>当前分数后两行分数',
lag(score,2) over(partition by class_id order by score desc) as '<当前分区>当前分数前两行分数',
first_value(score) over(partition by class_id order by score desc) as '<当前分区>第一个值',
last_value(score) over(partition by class_id order by score desc) as '<当前分区>最后一个值',
last_value(score) over(partition by class_id order by score desc ROWS BETWEEN UNBOUNDED PRECEDING AND UNBOUNDED FOLLOWING) as '<当前分区>最后一个值' -- 注意:LAST_VALUE函数需要指定ROWS BETWEEN UNBOUNDED PRECEDING AND UNBOUNDED FOLLOWING,以确保获取到最后一个值。
FROM score_test


魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 5
 0
- 0


 已为社区贡献1条内容

所有评论(0)