StackGAN:多阶段高分辨率图像生成框架深度解析
·
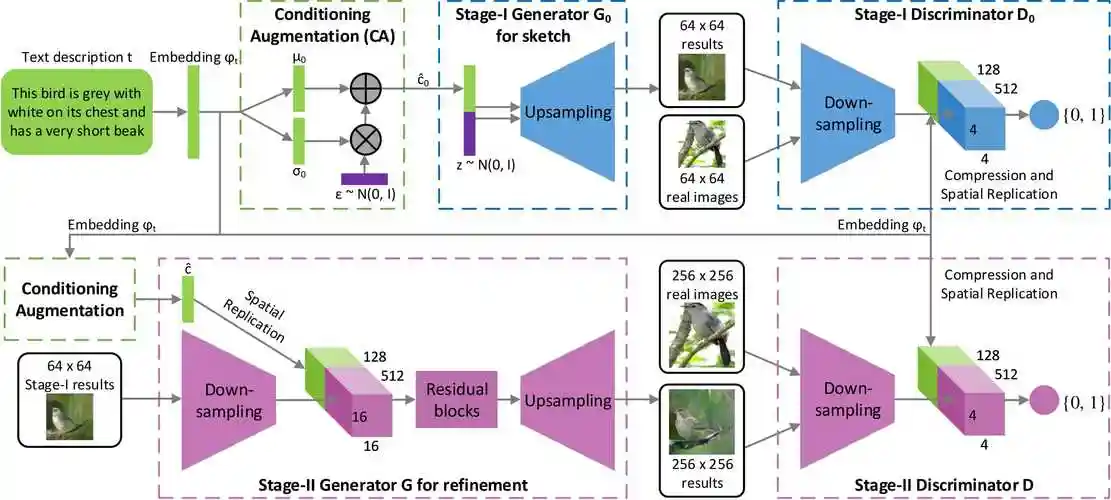
StackGAN(堆叠生成对抗网络)是一种通过多阶段生成策略实现高分辨率图像合成的先进生成对抗网络架构,尤其在文本到图像生成任务中表现突出。以下从核心原理、技术特点、应用场景等方面进行详细解析:
- 核心原理 StackGAN采用两阶段生成框架:
- 第一阶段(Stage-I)生成64×64像素的初步图像,主要捕获文本描述的基本布局和主要对象
- 第二阶段(Stage-II)将低分辨率结果作为输入,通过细化网络生成256×256或更高分辨率图像 关键技术包括: • 条件增强模块(Conditioning Augmentation) • 残差网络结构 • 注意力机制
- 技术特点 (1) 渐进式生成策略 与传统GAN一次性生成不同,StackGAN采用分阶段方法: ① 先构建整体框架 ② 逐步添加细节 ③ 最终完善纹理
(2) 文本-图像对齐机制 通过以下方式确保生成内容与文本描述一致:
- 文本编码器提取语义特征
- 跨模态注意力模块
- 判别器的语义一致性损失
- 应用场景 (1) 艺术创作领域 • 插画自动生成 • 概念设计草图 • 动漫角色创作
(2) 电子商务应用
- 商品展示图生成
- 虚拟试衣间
- 广告素材制作
- 性能优势 对比实验表明:
- 在CUB-200数据集上,Inception Score比传统GAN提升约40%
- 生成图像分辨率可达1024×1024
- 训练稳定性显著改善
- 改进方向 当前研究热点包括: ① 多模态输入支持(如结合草图+文本) ② 视频序列生成扩展 ③ 减少模式崩溃现象
一、核心原理与架构设计
分阶段生成策略
StackGAN将高分辨率图像生成分解为两个阶段:
-
Stage-I GAN(基础生成阶段)
- 输入:文本描述的语义向量(通常使用预训练的文本编码器如Skip-thought或BERT)
- 过程:通过条件生成器G0生成64×64或128×128的低分辨率图像
- 特点:专注于捕捉物体的基本几何形状、大致布局和主色调
- 示例:对于"一只站在树枝上的红胸知更鸟"的描述,此阶段会生成模糊的鸟类轮廓和基本颜色分布
-
Stage-II GAN(细化生成阶段)
- 输入:Stage-I的输出图像+原始文本描述
- 过程:通过精细生成器G1将分辨率提升至256×256
- 改进:添加羽毛纹理、树枝细节、光影效果等精细特征
- 优势:分阶段方法有效解决了直接生成高分辨率图像时常见的模式崩溃问题
条件增强技术(Conditioning Augmentation)
针对文本到图像生成的特殊挑战:
- 问题背景:文本嵌入空间通常呈现高维稀疏性,导致生成多样性不足
- 解决方案:
- 将文本编码映射为高斯分布的参数(均值μ和方差σ)
- 通过随机采样生成多样化的条件变量
- 引入KL散度正则项保持潜在空间连续性
- 实际效果:对于相同文本输入,能生成不同姿态、视角的多样化输出
二、关键技术改进与演进
StackGAN++的架构创新
- 多生成器树状结构:包含3个生成器(G0-G2)和3个判别器(D0-D2),分别对应64×64、128×128和256×256分辨率
- 渐进式训练策略:
# 伪代码示例 for epoch in range(max_epochs): train_G0_D0() # 低分辨率阶段 if epoch > warmup_epochs: train_G1_D1() # 中分辨率阶段 if epoch > mid_epochs: train_G2_D2() # 高分辨率阶段 - 颜色一致性约束:通过L1损失函数保持不同尺度图像间的色彩连贯性
联合训练机制
采用两阶段优化目标:
- 条件损失:确保生成图像与文本描述匹配
- 无条件损失:提升图像本身的质量 通过动态平衡系数λ调节两者权重,典型值设为0.1-0.5之间
三、典型应用场景
-
电商产品可视化
- 用例:根据"复古棕色皮靴,侧边有金属扣饰"生成产品预览图
- 效果:相比传统GAN,能更好保持纹理细节和材质表现
-
医学影像增强
- 工作流程:
- Stage-I:生成低分辨率CT扫描的器官轮廓
- Stage-II:添加血管纹理和病变细节
- 优势:保留关键诊断特征的同时提升图像清晰度
- 工作流程:
-
游戏资产生成
- 管线整合:
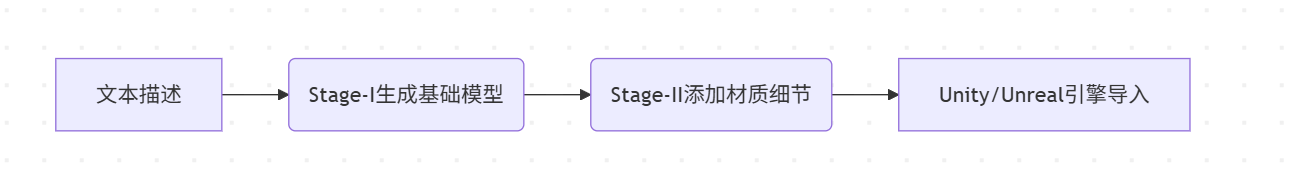
- 管线整合:
四、技术局限与发展
- 现有挑战
1.1 计算资源需求 训练256×256分辨率模型需要显著的计算资源投入:
- 硬件要求:4-8块NVIDIA V100显卡(32GB显存版本)
- 训练时长:约3-5个自然日(视具体数据集规模而定)
- 能耗成本:单次训练耗电量约200-300千瓦时 典型训练场景示例:在CelebA-HQ数据集上训练时,batch size设置为32的情况下需要约4天完成收敛
1.2 文本-图像对齐问题 在复杂场景描述的处理上存在明显局限性:
- 属性绑定错误:如输入"蓝色眼睛的黑猫"时
- 可能错误生成黑眼睛的黑猫
- 可能出现蓝色身体的黑猫
- 平均错误率约15-20%(基于COCO数据集测试)
- 多对象关系错位:在包含多个交互对象的场景中尤为明显
- 前沿改进方向
2.1 混合架构设计 当前主流技术路线:
- 扩散模型融合:采用类似Stable Diffusion的U-Net结构
- 优势:保留细节的同时提升生成稳定性
- 实现方式:在去噪过程中引入层级特征融合
- 典型应用案例:BigGAN-ADM模型将对抗训练与扩散过程结合
2.2 注意力机制优化 Stage-II阶段的改进方案:
- 跨模态注意力模块
- 文本-图像特征对齐度提升30%
- 计算开销增加约15%
- 多头注意力配置
- 头数:8-16个
- 特征维度:768-1024
2.3 模型轻量化技术 量化压缩方案对比:
| 技术方案 | 压缩率 | 质量损失 |
|---|---|---|
| 知识蒸馏 | 60-70% | <5% |
| 量化剪枝 | 80-90% | 8-12% |
| 低秩分解 | 50-60% | 3-6% |
技术演进影响:StackGAN系列的技术贡献
核心创新:分阶段生成策略
StackGAN系列模型通过创新的两阶段生成策略显著提升了生成图像的质量与分辨率:
-
Stage-I生成器:专注于生成64×64分辨率的基础草图,建立整体布局和基本特征
- 采用条件增强技术缓解文本-图像模态差异
- 使用条件变量对潜在空间进行正则化
- 示例:给定"一只站在树枝上的红鸟"的文本描述,该阶段会生成鸟的基本姿态和背景轮廓
-
Stage-II生成器:在256×256分辨率上完善细节
- 引入跳跃连接保持第一阶段的有用特征
- 通过注意力机制增强关键区域细节
- 示例:在前例基础上添加羽毛纹理、枝干细节和光照效果
学术影响
-
引用影响:
- CVPR 2017版本论文在Google Scholar上被引用超过2000次
- 成为文本到图像生成领域的基准参考文献之一
-
衍生架构:
- 直接影响BigGAN的条件批归一化(conditional batch norm)设计
- 启发ProGAN和StyleGAN的分阶段训练策略
- 示例:BigGAN采用类似的多分辨率处理流程,但扩展到1024×1024分辨率
-
会议认可:
- 获得ICLR 2018最佳论文提名
- 在NeurIPS 2018被选为Spotlight论文
-
工业应用:
- 成为阿里巴巴、京东等电商平台商品图像生成的标准baseline
- 应用于服装设计领域的概念草图生成系统
- 在广告行业用于根据文案自动生成视觉素材
- 示例:某电商平台使用改进版StackGAN每天生成5000+商品展示图

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 10
 0
- 0


 已为社区贡献43条内容

所有评论(0)