大数据面试题记录
Hadoop面试题
Hadoop面试题(一)
1、集群的最主要瓶颈
磁盘IO
2、Hadoop运行模式
单机版、伪分布式模式、完全分布式模式
3、Hadoop生态圈的组件并做简要描述
1)Zookeeper:是一个开源的分布式应用程序协调服务,基于zookeeper可以实现同步服务,配置维护,命名服务。
2)Flume:一个高可用的,高可靠的,分布式的海量日志采集、聚合和传输的系统。
3)Hbase:是一个分布式的、面向列的开源数据库, 利用Hadoop HDFS作为其存储系统。
4)Hive:基于Hadoop的一个数据仓库工具,可以将结构化的数据档映射为一张数据库表,并提供简单的sql 查询功能,可以将sql语句转换为MapReduce任务进行运行。
5)Sqoop:将一个关系型数据库中的数据导进到Hadoop的 HDFS中,也可以将HDFS的数据导进到关系型数据库中。
4、解释“hadoop”和“hadoop 生态系统”两个概念
Hadoop是指Hadoop框架本身;hadoop生态系统,不仅包含hadoop,还包括保证hadoop框架正常高效运行其他框架,比如zookeeper、Flume、Hbase、Hive、Sqoop等辅助框架。
5、请列出正常工作的Hadoop集群中Hadoop都分别需要启动哪些进程,它们的作用分别是什么?
1)NameNode:它是hadoop中的主服务器,管理着文件系统的命名空间,维护着文件系统树及整棵树的所有文件和目录。这些信息以两个文件的形式保存于内存或者磁盘,这两个文件是:命名空间镜像文件fsimage和编辑日志文件edit logs ,同时namenode也记录着每个文件中各个块所在的数据节点信息。
2)SecondaryNameNode:它不是namenode的冗余守护进程,而是定期通过编辑日志文件合并命名空间镜像,以防止编辑日志文件过大。SecondaryNameNode一般要在另一台机器上运行,因为它需要占用大量的CPU时间与namenode相同容量的内存才可以进行合并操作。它会保存合并后的命名空间镜像的副本,并在namenode发生故障时启用
3)DataNode:它负责管理连接到节点的存储(一个集群中可以有多个节点)。每个存储数据的节点运行一个datanode守护进程。
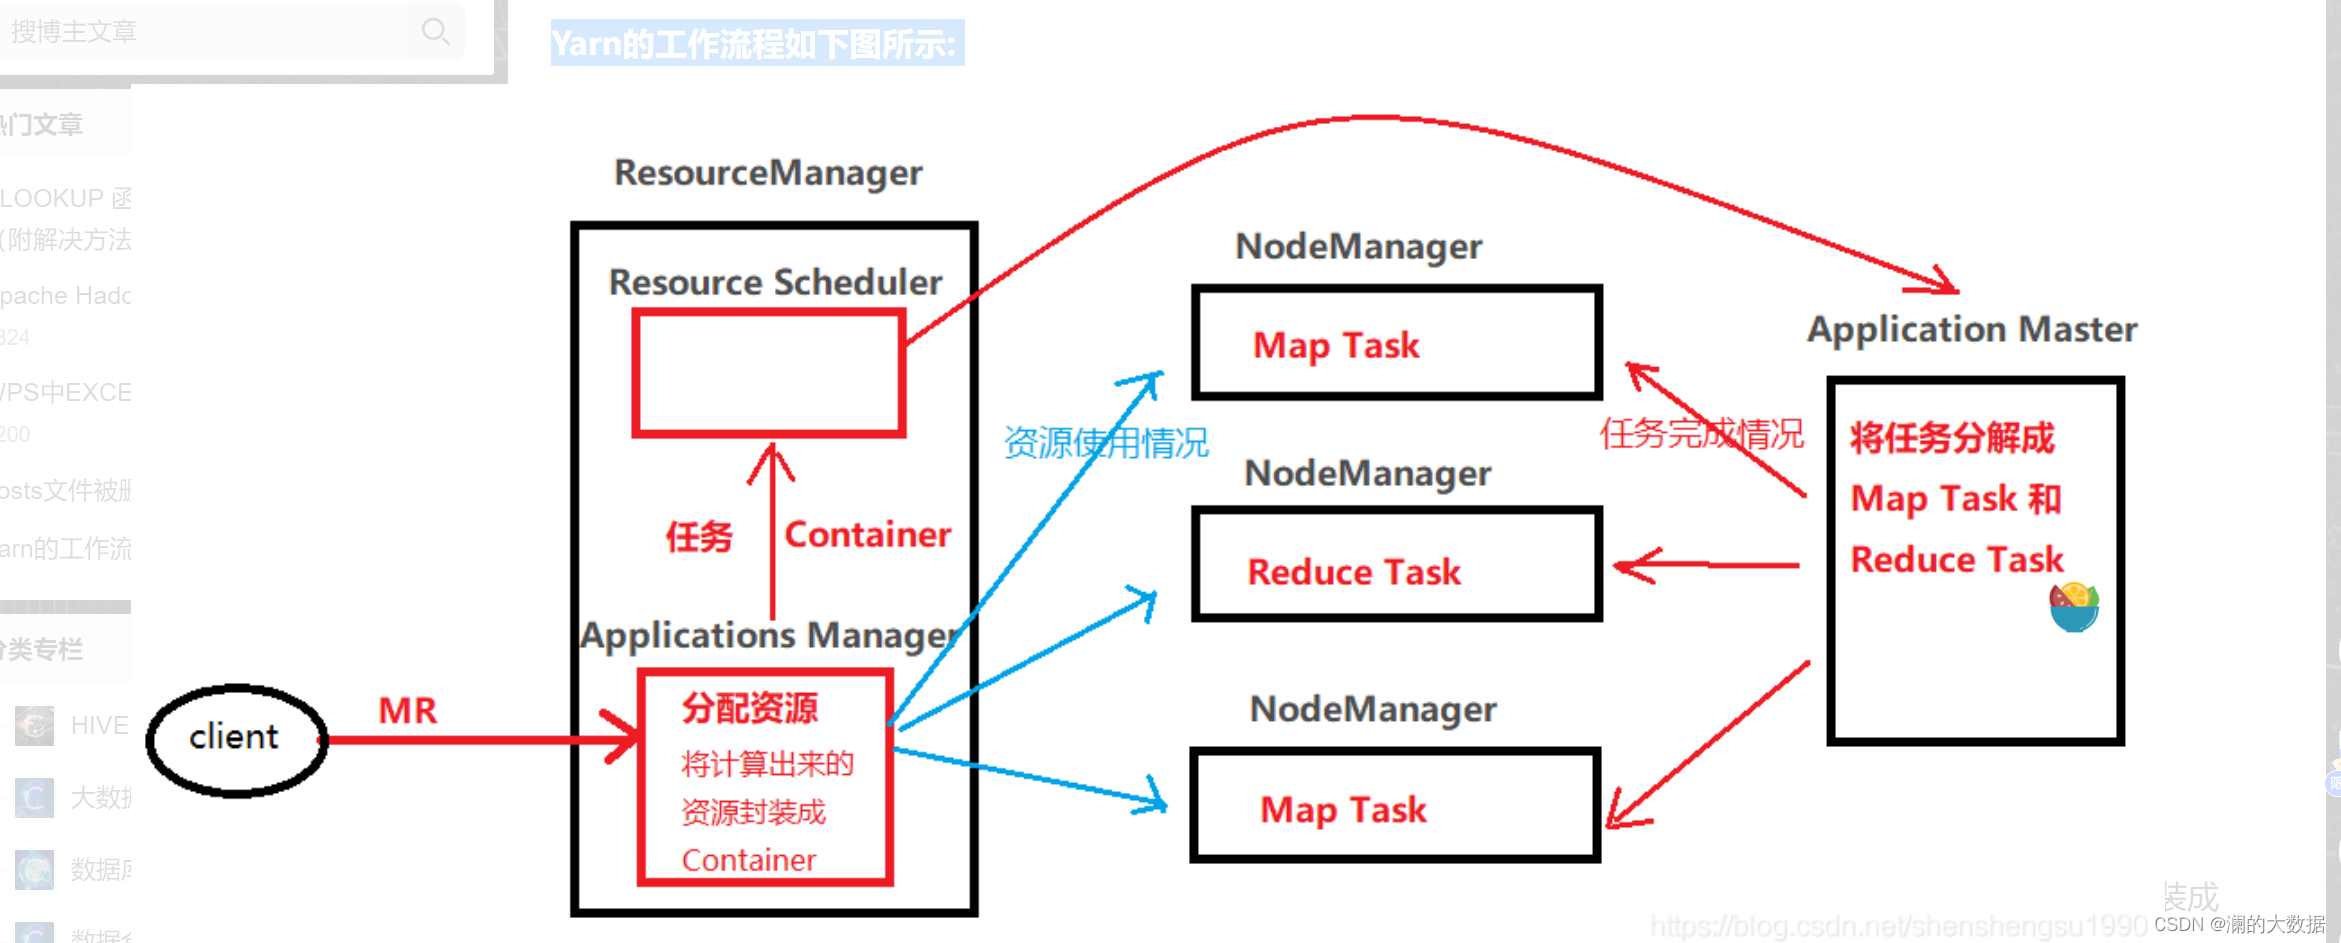
4)ResourceManager(JobTracker):JobTracker负责调度DataNode上的工作。每个DataNode有一个TaskTracker,它们执行实际工作。ResourceManager负责集群中所有资源的统一管理和分配,它接收来自各个节点的资源汇报信息,并把这些信息按照一定的策略分配给各个应用程序
5)NodeManager:(TaskTracker)执行任务。负责单个节点的资源管理与任务启动。
6)DFSZKFailoverController:
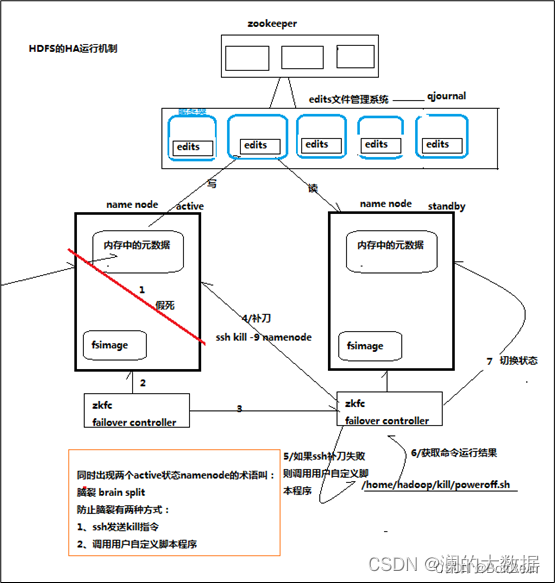
高可用时它负责监控NN的状态,并及时的把状态信息写入ZK。它通过一个独立线程周期性的调用NN上的一个特定接口来获取NN的健康状态。FC也有选择谁作为Active NN的权利,因为最多只有两个节点,目前选择策略还比较简单(先到先得,轮换)。
7)JournalNode:
高可用情况下存放namenode的editlog文件。
8)HDFS的HA机制详解
hadoop-ha严格来说应该分成各个组件的HA机制——HDFS的HA、YARN的HA
通过双namenode消除单点故障
双namenode协调工作的要点:
A、元数据管理方式需要改变:

内存中各自保存一份元数据

Edits日志只能有一份,只有Active状态的namenode节点可以做写操作

两个namenode都可以读取edits

共享的edits放在一个共享存储中管理(qjournal和NFS两个主流实现)

B、需要一个状态管理功能模块

实现了一个zkfailover,常驻在每一个namenode所在的节点

每一个zkfailover负责监控自己所在namenode节点,利用zk进行状态标识

当需要进行状态切换时,由zkfailover来负责切换
9)YARN的HA机制
ResourceManager HA通过主动/备用架构实现 - 在任何时间点,其中一个RM处于活动状态,并且一个或多个RM处于待机模式,等待活动RM出现故障或者宕机时机。转换为活动的触发器来自管理员(通过CLI)或启用自动故障转移时的集成故障转移控制器。
Hadoop面试题总结(二)——HDFS
1、 HDFS 中的 block 默认保存几份?
默认保存3份
2、HDFS 默认 BlockSize 是多大?
1.x默认64MB,2.x,3.x默认为128MB
3、负责HDFS数据存储的是哪一部分?
DataNode负责数据存储
4、SecondaryNameNode的目的是什么?
他的目的使帮助NameNode合并编辑日志,减少NameNode 启动时间
5、文件大小设置,增大有什么影响?
HDFS中的文件在物理上是分块存储(block),块的大小可以通过配置参数( dfs.blocksize)来规定,默认大小在hadoop2.x版本中是128M,老版本中是64M。
思考:为什么块的大小不能设置的太小,也不能设置的太大?
原理:
文件块越大,寻址时间越短,但磁盘传输时间越长;
文件块越小,寻址时间越长,但磁盘传输时间越短。
-
如果块设置过大,
一方面,从磁盘传输数据的时间会明显大于寻址时间,导致程序在处理这块数据时,变得非常慢;
另一方面,mapreduce中的map任务通常一次只处理一个块中的数据,如果块过大运行速度也会很慢。
-
如果块设置过小,
一方面存放大量小文件会占用NameNode中大量内存来存储元数据,而NameNode的内存是有限的,不可取;
另一方面文件块过小,寻址时间增大,导致程序一直在找block的开始位置。
因而,块适当设置大一些,减少寻址时间,那么传输一个由多个块组成的文件的时间主要取决于磁盘的传输速率。
如果寻址时间约为10ms,而传输速率为100MB/s,为了使寻址时间仅占传输时间的1%,我们要将块大小设置约为100MB。默认的块大小128MB。
块的大小:10ms×100×100M/s = 100M; 增加文件块大小,需要增加磁盘的传输速率。
6、hadoop的块大小,从哪个版本开始是128M
Hadoop1.x都是64M,hadoop2.x开始都是128M。
7、HDFS的存储机制(☆☆☆☆☆)
HDFS存储机制,包括HDFS的写入数据过程和读取数据过程两部分
HDFS写数据过程
1)客户端通过Distributed FileSystem模块向NameNode请求上传文件,NameNode检查目标文件是否已存在,父目录是否存在。
2)NameNode返回是否可以上传。
3)客户端请求第一个 block上传到哪几个datanode服务器上。
4)NameNode返回3个datanode节点,分别为dn1、dn2、dn3。
5)客户端通过FSDataOutputStream模块请求dn1上传数据,dn1收到请求会继续调用dn2,然后dn2调用dn3,将这个通信管道建立完成。
6)dn1、dn2、dn3逐级应答客户端。
7)客户端开始往dn1上传第一个block(先从磁盘读取数据放到一个本地内存缓存),以packet为单位,dn1收到一个packet就会传给dn2,dn2传给dn3;
dn1每传一个packet会放入一个应答队列等待应答。
8)当一个block传输完成之后,客户端再次请求NameNode上传第二个block的服务器。(重复执行3-7步)。
HDFS读数据过程
1)客户端通过Distributed FileSystem向NameNode请求下载文件,NameNode通过查询元数据,找到文件块所在的DataNode地址。
2)挑选一台DataNode(就近原则,然后随机)服务器,请求读取数据。
3)DataNode开始传输数据给客户端(从磁盘里面读取数据输入流,以packet为单位来做校验)。
4)客户端以packet为单位接收,先在本地缓存,然后写入目标文件。
8、secondary namenode工作机制(☆☆☆☆☆)
1)第一阶段:NameNode启动
(1)第一次启动NameNode格式化后,创建fsimage和edits文件。如果不是第一次启动,直接加载编辑日志和镜像文件到内存。
(2)客户端对元数据进行增删改的请求。
(3)NameNode记录操作日志,更新滚动日志。
(4)NameNode在内存中对数据进行增删改查。
2)第二阶段:Secondary NameNode工作
(1)Secondary NameNode询问NameNode是否需要checkpoint。直接带回NameNode是否检查结果。
(2)Secondary NameNode请求执行checkpoint。
(3)NameNode滚动正在写的edits日志。
(4)将滚动前的编辑日志和镜像文件拷贝到Secondary NameNode。
(5)Secondary NameNode加载编辑日志和镜像文件到内存,并合并。
(6)生成新的镜像文件fsimage.chkpoint。
(7)拷贝fsimage.chkpoint到NameNode。
(8)NameNode将fsimage.chkpoint重新命名成fsimage。
9、NameNode与SecondaryNameNode 的区别与联系?(☆☆☆☆☆)
机制流程看第7题
1)区别
(1)NameNode负责管理整个文件系统的元数据,以及每一个路径(文件)所对应的数据块信息。
(2)SecondaryNameNode主要用于定期合并命名空间镜像和命名空间镜像的编辑日志。
2)联系:
(1)SecondaryNameNode中保存了一份和namenode一致的镜像文件(fsimage)和编辑日志(edits)。
(2)在主namenode发生故障时(假设没有及时备份数据),可以从SecondaryNameNode恢复数据。
10、HDFS组成架构(☆☆☆☆☆)
架构主要由四个部分组成,分别为HDFS Client、NameNode、DataNode和Secondary NameNode。下面我们分别介绍这四个组成部分。
1)Client:就是客户端。
(1)文件切分。文件上传HDFS的时候,Client将文件切分成一个一个的Block,然后进行存储;
(2)与NameNode交互,获取文件的位置信息;
(3)与DataNode交互,读取或者写入数据;
(4)Client提供一些命令来管理HDFS,比如启动或者关闭HDFS;
(5)Client可以通过一些命令来访问HDFS;
2)NameNode:就是Master,它是一个主管、管理者。
(1)管理HDFS的名称空间;
(2)管理数据块(Block)映射信息;
(3)配置副本策略;
(4)处理客户端读写请求。
3)DataNode:就是Slave。NameNode下达命令,DataNode执行实际的操作。
(1)存储实际的数据块;
(2)执行数据块的读/写操作。
4)Secondary NameNode:并非NameNode的热备。当NameNode挂掉的时候,它并不能马上替换NameNode并提供服务。
(1)辅助NameNode,分担其工作量;
(2)定期合并Fsimage和Edits,并推送给NameNode;
(3)在紧急情况下,可辅助恢复NameNode。
11、HAnamenode 是如何工作的? (☆☆☆☆☆)
ZKFailoverController主要职责
1)健康监测:周期性的向它监控的NN发送健康探测命令,从而来确定某个NameNode是否处于健康状态,如果机器宕机,心跳失败,那么zkfc就会标记它处于一个不健康的状态。
2)会话管理:如果NN是健康的,zkfc就会在zookeeper中保持一个打开的会话,如果NameNode同时还是Active状态的,那么zkfc还会在Zookeeper中占有一个类型为短暂类型的znode,当这个NN挂掉时,这个znode将会被删除,然后备用的NN,将会得到这把锁,升级为主NN,同时标记状态为Active。 0
3)当宕机的NN新启动时,它会再次注册zookeper,发现已经有znode锁了,便会自动变为Standby状态,如此往复循环,保证高可靠,需要注意,目前仅仅支持最多配置2个NN。
4)master选举:如上所述,通过在zookeeper中维持一个短暂类型的znode,来实现抢占式的锁机制,从而判断那个NameNode为Active状态
Hadoop面试题总结(三)——MapReduce
1、谈谈Hadoop序列化和反序列化及自定义bean对象实现序列化?
1)序列化和反序列化
(1)序列化就是把内存中的对象,转换成字节序列(或其他数据传输协议)以便于存储(持久化)和网络传输。
(2)反序列化就是将收到字节序列(或其他数据传输协议)或者是硬盘的持久化数据,转换成内存中的对象。
(3)Java的序列化是一个重量级序列化框架(Serializable),一个对象被序列化后,会附带很多额外的信息(各种校验信息,header,继承体系等),不便于在网络中高效传输。所以,hadoop自己开发了一套序列化机制(Writable),精简、高效。
2)自定义bean对象要想序列化传输步骤及注意事项:
(1)必须实现Writable接口
(2)反序列化时,需要反射调用空参构造函数,所以必须有空参构造
(3)重写序列化方法
(4)重写反序列化方法
(5)注意反序列化的顺序和序列化的顺序完全一致
(6)要想把结果显示在文件中,需要重写toString(),且用"\t"分开,方便后续用
(7)如果需要将自定义的bean放在key中传输,则还需要实现comparable接口,因为mapreduce框中的shuffle过程一定会对key进行排序
2、FileInputFormat切片机制(☆☆☆☆☆)
job提交流程源码详解
waitForCompletion()
submit();
// 1、建立连接
connect();
// 1)创建提交job的代理
new Cluster(getConfiguration());
// (1)判断是本地yarn还是远程
initialize(jobTrackAddr, conf);
// 2、提交job
submitter.submitJobInternal(Job.this, cluster)
// 1)创建给集群提交数据的Stag路径
Path jobStagingArea = JobSubmissionFiles.getStagingDir(cluster, conf);
// 2)获取jobid ,并创建job路径
JobID jobId = submitClient.getNewJobID();
// 3)拷贝jar包到集群
copyAndConfigureFiles(job, submitJobDir);
rUploader.uploadFiles(job, jobSubmitDir);
// 4)计算切片,生成切片规划文件
writeSplits(job, submitJobDir);
maps = writeNewSplits(job, jobSubmitDir);
input.getSplits(job);
// 5)向Stag路径写xml配置文件
writeConf(conf, submitJobFile);
conf.writeXml(out);
// 6)提交job,返回提交状态
status = submitClient.submitJob(jobId, submitJobDir.toString(), job.getCredentials());
3、在一个运行的Hadoop 任务中,什么是InputSplit?(☆☆☆☆☆)
FileInputFormat源码解析(input.getSplits(job))
(1)找到你数据存储的目录。
(2)开始遍历处理(规划切片)目录下的每一个文件。
(3)遍历第一个文件ss.txt。
a)获取文件大小fs.sizeOf(ss.txt);。
b)计算切片大小computeSliteSize(Math.max(minSize,Math.min(maxSize,blocksize)))=blocksize=128M。
c)默认情况下,切片大小=blocksize。
d)开始切,形成第1个切片:ss.txt—0:128M 第2个切片ss.txt—128:256M 第3个切片ss.txt—256M:300M(每次切片时,都要判断切完剩下的部分是否大于块的1.1倍,不大于1.1倍就划分一块切片)。
e)将切片信息写到一个切片规划文件中。
f)整个切片的核心过程在getSplit()方法中完成。
g)数据切片只是在逻辑上对输入数据进行分片,并不会再磁盘上将其切分成分片进行存储。InputSplit只记录了分片的元数据信息,比如起始位置、长度以及所在的节点列表等。
h)注意:block是HDFS上物理上存储的存储的数据,切片是对数据逻辑上的划分。
(4)提交切片规划文件到yarn上,yarn上的MrAppMaster就可以根据切片规划文件计算开启maptask个数。
4、如何判定一个job的map和reduce的数量?
1)map数量
splitSize=max{minSize,min{maxSize,blockSize}}
map数量由处理的数据分成的block数量决定default_num = total_size / split_size;
2)reduce数量
reduce的数量job.setNumReduceTasks(x);x 为reduce的数量。不设置的话默认为 1。
5、 Maptask的个数由什么决定?
一个job的map阶段MapTask并行度(个数),由客户端提交job时的切片个数决定。
6、MapTask和ReduceTask工作机制(☆☆☆☆☆)(也可回答MapReduce工作原理)
MapTask工作机制
(1)Read阶段:Map Task通过用户编写的RecordReader,从输入InputSplit中解析出一个个key/value。
(2)Map阶段:该节点主要是将解析出的key/value交给用户编写map()函数处理,并产生一系列新的key/value。
(3)Collect收集阶段:在用户编写map()函数中,当数据处理完成后,一般会调用OutputCollector.collect()输出结果。在该函数内部,它会将生成的key/value分区(调用Partitioner),并写入一个环形内存缓冲区中。
(4)Spill阶段:即“溢写”,当环形缓冲区满后,MapReduce会将数据写到本地磁盘上,生成一个临时文件。需要注意的是,将数据写入本地磁盘之前,先要对数据进行一次本地排序,并在必要时对数据进行合并、压缩等操作。
(5)Combine阶段:当所有数据处理完成后,MapTask对所有临时文件进行一次合并,以确保最终只会生成一个数据文件。
ReduceTask工作机制
(1)Copy阶段:ReduceTask从各个MapTask上远程拷贝一片数据,并针对某一片数据,如果其大小超过一定阈值,则写到磁盘上,否则直接放到内存中。
(2)Merge阶段:在远程拷贝数据的同时,ReduceTask启动了两个后台线程对内存和磁盘上的文件进行合并,以防止内存使用过多或磁盘上文件过多。
(3)Sort阶段:按照MapReduce语义,用户编写reduce()函数输入数据是按key进行聚集的一组数据。为了将key相同的数据聚在一起,Hadoop采用了基于排序的策略。 由于各个MapTask已经实现对自己的处理结果进行了局部排序,因此,ReduceTask只需对所有数据进行一次归并排序即可。
(4)Reduce阶段:reduce()函数将计算结果写到HDFS上。
7、描述mapReduce有几种排序及排序发生的阶段(☆☆☆☆☆)
1)排序的分类:
(1)部分排序:
MapReduce根据输入记录的键对数据集排序。保证输出的每个文件内部排序。
(2)全排序:
如何用Hadoop产生一个全局排序的文件?最简单的方法是使用一个分区。但该方法在处理大型文件时效率极低,因为一台机器必须处理所有输出文件,从而完全丧失了MapReduce所提供的并行架构。
替代方案:首先创建一系列排好序的文件;其次,串联这些文件;最后,生成一个全局排序的文件。主要思路是使用一个分区来描述输出的全局排序。例如:可以为待分析文件创建3个分区,在第一分区中,记录的单词首字母a-g,第二分区记录单词首字母h-n, 第三分区记录单词首字母o-z。
(3)辅助排序:(GroupingComparator分组)
Mapreduce框架在记录到达reducer之前按键对记录排序,但键所对应的值并没有被排序。甚至在不同的执行轮次中,这些值的排序也不固定,因为它们来自不同的map任务且这些map任务在不同轮次中完成时间各不相同。一般来说,大多数MapReduce程序会避免让reduce函数依赖于值的排序。但是,有时也需要通过特定的方法对键进行排序和分组等以实现对值的排序。
(4)二次排序:
在自定义排序过程中,如果compareTo中的判断条件为两个即为二次排序。
2)自定义排序WritableComparable
bean对象实现WritableComparable接口重写compareTo方法,就可以实现排序
@Override
public int compareTo(FlowBean o) {
// 倒序排列,从大到小
return this.sumFlow > o.getSumFlow() ? -1 : 1;
}
3)排序发生的阶段:
(1)一个是在map side发生在spill后partition前。
(2)一个是在reduce side发生在copy后 reduce前。
8、描述mapReduce中shuffle阶段的工作流程,如何优化shuffle阶段(☆☆☆☆☆)
分区,排序,溢写,拷贝到对应reduce机器上,增加combiner,压缩溢写的文件。
9、描述mapReduce中combiner的作用是什么,一般使用情景,哪些情况不需要,及和reduce的区别?
1)Combiner的意义就是对每一个maptask的输出进行局部汇总,以减小网络传输量。
2)Combiner能够应用的前提是不能影响最终的业务逻辑,而且,Combiner的输出kv应该跟reducer的输入kv类型要对应起来。
3)Combiner和reducer的区别在于运行的位置。
Combiner是在每一个maptask所在的节点运行;
Reducer是接收全局所有Mapper的输出结果。
10、如果没有定义partitioner,那数据在被送达reducer前是如何被分区的?
如果没有自定义的 partitioning,则默认的 partition 算法,即根据每一条数据的 key 的 hashcode 值摸运算(%)reduce 的数量,得到的数字就是“分区号“。
11、MapReduce 出现单点负载多大,怎么负载平衡? (☆☆☆☆☆)
通过Partitioner实现
12、MapReduce 怎么实现 TopN? (☆☆☆☆☆)
可以自定义groupingcomparator,对结果进行最大值排序,然后再reduce输出时,控制只输出前n个数。就达到了topn输出的目的。
13、Hadoop的缓存机制(Distributedcache)(☆☆☆☆☆)
分布式缓存一个最重要的应用就是在进行join操作的时候,如果一个表很大,另一个表很小,我们就可以将这个小表进行广播处理,即每个计算节点上都存一份,然后进行map端的连接操作,经过我的实验验证,这种情况下处理效率大大高于一般的reduce端join,广播处理就运用到了分布式缓存的技术。
DistributedCache将拷贝缓存的文件到Slave节点在任何Job在节点上执行之前,文件在每个Job中只会被拷贝一次,缓存的归档文件会被在Slave节点中解压缩。将本地文件复制到HDFS中去,接着Client会通过addCacheFile() 和addCacheArchive()方法告诉DistributedCache在HDFS中的位置。当文件存放到文地时,JobClient同样获得DistributedCache来创建符号链接,其形式为文件的URI加fragment标识。当用户需要获得缓存中所有有效文件的列表时,JobConf 的方法 getLocalCacheFiles() 和getLocalArchives()都返回一个指向本地文件路径对象数组。
14、如何使用mapReduce实现两个表的join?(☆☆☆☆☆)
1)reduce side join : 在map阶段,map函数同时读取两个文件File1和File2,为了区分两种来源的key/value数据对,对每条数据打一个标签(tag),比如:tag=0 表示来自文件File1,tag=2 表示来自文件File2。
2)map side join : Map side join 是针对以下场景进行的优化:两个待连接表中,有一个表非常大,而另一个表非常小,以至于小表可以直接存放到内存中。这样,我们可以将小表复制多份,让每个map task 内存中存在一份(比如存放到hash table 中),然后只扫描大表:对于大表中的每一条记录key/value,在hash table 中查找是否有相同的key 的记录,如果有,则连接后输出即可。
15、什么样的计算不能用mr来提速?
1)数据量很小。
2)繁杂的小文件。
3)索引是更好的存取机制的时候。
4)事务处理。
5)只有一台机器的时候。
16、ETL是哪三个单词的缩写
Extraction-Transformation-Loading的缩写,中文名称为数据提取、转换和加载。
Hadoop面试题(四)——YARN
1、简述hadoop1与hadoop2 的架构异同
1)加入了yarn解决了资源调度的问题。
2)加入了对zookeeper的支持实现比较可靠的高可用。
2、为什么会产生 yarn,它解决了什么问题,有什么优势?
1)Yarn最主要的功能就是解决运行的用户程序与yarn框架完全解耦。
2)Yarn上可以运行各种类型的分布式运算程序(mapreduce只是其中的一种),比如mapreduce、storm程序,spark程序……
3、HDFS的数据压缩算法?(☆☆☆☆☆)
Hadoop中常用的压缩算法有bzip2、gzip、lzo、snappy,其中lzo、snappy需要操作系统安装native库才可以支持。
数据可以压缩的位置如下所示。
企业开发用的比较多的是snappy。
4、Hadoop的调度器总结(☆☆☆☆☆)
(1)默认的调度器FIFO
Hadoop中默认的调度器,它先按照作业的优先级高低,再按照到达时间的先后选择被执行的作业。
(2)计算能力调度器Capacity Scheduler
支持多个队列,每个队列可配置一定的资源量,每个队列采用FIFO调度策略,为了防止同一个用户的作业独占队列中的资源,该调度器会对同一用户提交的作业所占资源量进行限定。调度时,首先按以下策略选择一个合适队列:计算每个队列中正在运行的任务数与其应该分得的计算资源之间的比值,选择一个该比值最小的队列;然后按以下策略选择该队列中一个作业:按照作业优先级和提交时间顺序选择,同时考虑用户资源量限制和内存限制。
(3)公平调度器Fair Scheduler
同计算能力调度器类似,支持多队列多用户,每个队列中的资源量可以配置,同一队列中的作业公平共享队列中所有资源。实际上,Hadoop的调度器远不止以上三种,最近,出现了很多针对新型应用的Hadoop调度器。
5、MapReduce 2.0 容错性(☆☆☆☆☆)
1)MRAppMaster容错性
一旦运行失败,由YARN的ResourceManager负责重新启动,最多重启次数可由用户设置,默认是2次。一旦超过最高重启次数,则作业运行失败。
2)Map Task/Reduce
Task Task周期性向MRAppMaster汇报心跳;一旦Task挂掉,则MRAppMaster将为之重新申请资源,并运行之。最多重新运行次数可由用户设置,默认4次。
6、mapreduce推测执行算法及原理(☆☆☆☆☆)
1)作业完成时间取决于最慢的任务完成时间
一个作业由若干个Map 任务和Reduce 任务构成。因硬件老化、软件Bug 等,某些任务可能运行非常慢。
典型案例:系统中有99%的Map任务都完成了,只有少数几个Map老是进度很慢,完不成,怎么办?
2)推测执行机制
发现拖后腿的任务,比如某个任务运行速度远慢于任务平均速度。为拖后腿任务启动一个备份任务,同时运行。谁先运行完,则采用谁的结果。
3)不能启用推测执行机制情况
(1)任务间存在严重的负载倾斜;
(2)特殊任务,比如任务向数据库中写数据。
4)算法原理
假设某一时刻,任务T的执行进度为progress,则可通过一定的算法推测出该任务的最终完成时刻estimateEndTime。另一方面,如果此刻为该任务启动一个备份任务,则可推断出它可能的完成时刻estimateEndTime,于是可得出以下几个公式:     estimateEndTime=estimatedRunTime+taskStartTime     estimatedRunTime=(currentTimestamp-taskStartTime)/progress     estimateEndTime= currentTimestamp+averageRunTime
其中,currentTimestamp为当前时刻;taskStartTime为该任务的启动时刻;averageRunTime为已经成功运行完成的任务的平均运行时间。这样,MRv2总是选择(estimateEndTime- estimateEndTime·)差值最大的任务,并为之启动备份任务。为了防止大量任务同时启动备份任务造成的资源浪费,MRv2为每个作业设置了同时启动的备份任务数目上限。
推测执行机制实际上采用了经典的算法优化方法:以空间换时间,它同时启动多个相同任务处理相同的数据,并让这些任务竞争以缩短数据处理时间。显然,这种方法需要占用更多的计算资源。在集群资源紧缺的情况下,应合理使用该机制,争取在多用少量资源的情况下,减少作业的计算时间。
Hadoop面试题总结(五)——优化问题
1、MapReduce跑得慢的原因?(☆☆☆☆☆)
Mapreduce 程序效率的瓶颈在于两点:
1)计算机性能
CPU、内存、磁盘健康、网络
2)I/O 操作优化
(1)数据倾斜
(2)map和reduce数设置不合理
(3)reduce等待过久
(4)小文件过多
(5)大量的不可分块的超大文件
(6)spill次数过多
(7)merge次数过多等
2、MapReduce优化方法(☆☆☆☆☆)
1)数据输入
(1)合并小文件:在执行mr任务前将小文件进行合并,大量的小文件会产生大量的map任务,增大map任务装载次数,而任务的装载比较耗时,从而导致mr运行较慢。
(2)采用ConbinFileInputFormat来作为输入,解决输入端大量小文件场景。
2)map阶段
(1)减少spill次数:通过调整io.sort.mb及sort.spill.percent参数值,增大触发spill的内存上限,减少spill次数,从而减少磁盘 IO。
(2)减少merge次数:通过调整io.sort.factor参数,增大merge的文件数目,减少merge的次数,从而缩短mr处理时间。
(3)在 map 之后先进行combine处理,减少I/O。
3)reduce阶段
(1)合理设置map和reduce数:两个都不能设置太少,也不能设置太多。太少,会导致task等待,延长处理时间;太多,会导致 map、reduce任务间竞争资源,造成处理超时等错误。
(2)设置map、reduce共存:调整slowstart.completedmaps参数,使map运行到一定程度后,reduce也开始运行,减少reduce的等待时间。
(3)规避使用reduce,因为Reduce在用于连接数据集的时候将会产生大量的网络消耗。
(4)合理设置reduce端的buffer,默认情况下,数据达到一个阈值的时候,buffer中的数据就会写入磁盘,然后reduce会从磁盘中获得所有的数据。也就是说,buffer和reduce是没有直接关联的,中间多个一个写磁盘->读磁盘的过程,既然有这个弊端,那么就可以通过参数来配置,使得buffer中的一部分数据可以直接输送到reduce,从而减少IO开销:mapred.job.reduce.input.buffer.percent,默认为0.0。当值大于0的时候,会保留指定比例的内存读buffer中的数据直接拿给reduce使用。这样一来,设置buffer需要内存,读取数据需要内存,reduce计算也要内存,所以要根据作业的运行情况进行调整。
4)IO传输
(1)采用数据压缩的方式,减少网络IO的的时间。安装Snappy和LZOP压缩编码器。
(2)使用SequenceFile二进制文件
5)数据倾斜问题
(1)数据倾斜现象
数据频率倾斜——某一个区域的数据量要远远大于其他区域。
数据大小倾斜——部分记录的大小远远大于平均值。
(2)如何收集倾斜数据
在reduce方法中加入记录map输出键的详细情况的功能。
public static final String MAX_VALUES = "skew.maxvalues";
private int maxValueThreshold;

@Override
public void configure(JobConf job) {
     maxValueThreshold = job.getInt(MAX_VALUES, 100);
}

@Override
public void reduce(Text key, Iterator<Text> values,
                     OutputCollector<Text, Text> output,
                     Reporter reporter) throws IOException {
     int i = 0;
     while (values.hasNext()) {
         values.next();
         i++;
     }
     if (++i > maxValueThreshold) {
         log.info("Received " + i + " values for key " + key);
     }
}
(3)减少数据倾斜的方法
方法1:抽样和范围分区
可以通过对原始数据进行抽样得到的结果集来预设分区边界值。
方法2:自定义分区
另一个抽样和范围分区的替代方案是基于输出键的背景知识进行自定义分区。例如,如果map输出键的单词来源于一本书。其中大部分必然是省略词(stopword)。那么就可以将自定义分区将这部分省略词发送给固定的一部分reduce实例。而将其他的都发送给剩余的reduce实例。
方法3:Combine
使用Combine可以大量地减小数据频率倾斜和数据大小倾斜。在可能的情况下,combine的目的就是聚合并精简数据。
3、HDFS小文件优化方法(☆☆☆☆☆)
1)HDFS小文件弊端:
HDFS上每个文件都要在namenode上建立一个索引,这个索引的大小约为150byte,这样当小文件比较多的时候,就会产生很多的索引文件,一方面会大量占用namenode的内存空间,另一方面就是索引文件过大是的索引速度变慢。
2)解决的方式:
(1)Hadoop本身提供了一些文件压缩的方案。
(2)从系统层面改变现有HDFS存在的问题,其实主要还是小文件的合并,然后建立比较快速的索引。
3)Hadoop自带小文件解决方案
(1)Hadoop Archive:
是一个高效地将小文件放入HDFS块中的文件存档工具,它能够将多个小文件打包成一个HAR文件,这样在减少namenode内存使用的同时。
(2)Sequence file:
sequence file由一系列的二进制key/value组成,如果为key小文件名,value为文件内容,则可以将大批小文件合并成一个大文件。
(3)CombineFileInputFormat:
CombineFileInputFormat是一种新的inputformat,用于将多个文件合并成一个单独的split,另外,它会考虑数据的存储位置。
Hive面试题整理(一)
1、Hive表关联查询,如何解决数据倾斜的问题?(☆☆☆☆☆)
1)倾斜原因:map输出数据按key Hash的分配到reduce中,由于key分布不均匀、业务数据本身的特、建表时考虑不周、等原因造成的reduce 上的数据量差异过大。
(1)key分布不均匀;
(2)业务数据本身的特性;
(3)建表时考虑不周;
(4)某些SQL语句本身就有数据倾斜;
如何避免:对于key为空产生的数据倾斜,可以对其赋予一个随机值。
2)解决方案
(1)参数调节:
hive.map.aggr = true
hive.groupby.skewindata=true
有数据倾斜的时候进行负载均衡,当选项设定位true,生成的查询计划会有两个MR Job。第一个MR Job中,Map的输出结果集合会随机分布到Reduce中,每个Reduce做部分聚合操作,并输出结果,这样处理的结果是相同的Group By Key有可能被分发到不同的Reduce中,从而达到负载均衡的目的;第二个MR Job再根据预处理的数据结果按照Group By Key 分布到 Reduce 中(这个过程可以保证相同的 Group By Key 被分布到同一个Reduce中),最后完成最终的聚合操作。
(2)SQL 语句调节:
① 选用join key分布最均匀的表作为驱动表。做好列裁剪和filter操作,以达到两表做join 的时候,数据量相对变小的效果。
② 大小表Join:
使用map join让小的维度表(1000 条以下的记录条数)先进内存。在map端完成reduce。
③ 大表Join大表:
把空值的key变成一个字符串加上随机数,把倾斜的数据分到不同的reduce上,由于null 值关联不上,处理后并不影响最终结果。
④ count distinct大量相同特殊值:
count distinct 时,将值为空的情况单独处理,如果是计算count distinct,可以不用处理,直接过滤,在最后结果中加1。如果还有其他计算,需要进行group by,可以先将值为空的记录单独处理,再和其他计算结果进行union。
2、Hive的HSQL转换为MapReduce的过程?(☆☆☆☆☆)
HiveSQL ->AST(抽象语法树) -> QB(查询块) ->OperatorTree(操作树)->优化后的操作树->mapreduce任务树->优化后的mapreduce任务树
过程描述如下:
SQL Parser:Antlr定义SQL的语法规则,完成SQL词法,语法解析,将SQL转化为抽象语法树AST Tree;
Semantic Analyzer:遍历AST Tree,抽象出查询的基本组成单元QueryBlock;
Logical plan:遍历QueryBlock,翻译为执行操作树OperatorTree;
Logical plan optimizer: 逻辑层优化器进行OperatorTree变换,合并不必要的ReduceSinkOperator,减少shuffle数据量;
Physical plan:遍历OperatorTree,翻译为MapReduce任务;
Logical plan optimizer:物理层优化器进行MapReduce任务的变换,生成最终的执行计划。
3、Hive底层与数据库交互原理?(☆☆☆☆☆)
由于Hive的元数据可能要面临不断地更新、修改和读取操作,所以它显然不适合使用Hadoop文件系统进行存储。目前Hive将元数据存储在RDBMS中,比如存储在MySQL、Derby中。元数据信息包括:存在的表、表的列、权限和更多的其他信息。
4、Hive的两张表关联,使用MapReduce怎么实现?(☆☆☆☆☆)
如果其中有一张表为小表,直接使用map端join的方式(map端加载小表)进行聚合。
如果两张都是大表,那么采用联合key,联合key的第一个组成部分是join on中的公共字段,第二部分是一个flag,0代表表A,1代表表B,由此让Reduce区分客户信息和订单信息;在Mapper中同时处理两张表的信息,将join on公共字段相同的数据划分到同一个分区中,进而传递到一个Reduce中,然后在Reduce中实现聚合。
5、请谈一下Hive的特点,Hive和RDBMS有什么异同?
hive是基于Hadoop的一个数据仓库工具,可以将结构化的数据文件映射为一张数据库表,并提供完整的sql查询功能,可以将sql语句转换为MapReduce任务进行运行。其优点是学习成本低,可以通过类SQL语句快速实现简单的MapReduce统计,不必开发专门的MapReduce应用,十分适合数据仓库的统计分析,但是Hive不支持实时查询。
Hive与关系型数据库的区别:
6、请说明hive中 Sort By,Order By,Cluster By,Distrbute By各代表什么意思?
order by:会对输入做全局排序,因此只有一个reducer(多个reducer无法保证全局有序)。只有一个reducer,会导致当输入规模较大时,需要较长的计算时间。
sort by:不是全局排序,其在数据进入reducer前完成排序。
distribute by:按照指定的字段对数据进行划分输出到不同的reduce中。
cluster by:除了具有 distribute by 的功能外还兼具 sort by 的功能。
7、写出hive中split、coalesce及collect_list函数的用法(可举例)?
split将字符串转化为数组,即:split(‘a,b,c,d’ , ‘,’) ==> [“a”,“b”,“c”,“d”]。
coalesce(T v1, T v2, …) 返回参数中的第一个非空值;如果所有值都为 NULL,那么返回NULL。
collect_list列出该字段所有的值,不去重 => select collect_list(id) from table。
8、Hive有哪些方式保存元数据,各有哪些特点?
Hive支持三种不同的元存储服务器,分别为:内嵌式元存储服务器、本地元存储服务器、远程元存储服务器,每种存储方式使用不同的配置参数。
内嵌式元存储主要用于单元测试,在该模式下每次只有一个进程可以连接到元存储,Derby是内嵌式元存储的默认数据库。
在本地模式下,每个Hive客户端都会打开到数据存储的连接并在该连接上请求SQL查询。
在远程模式下,所有的Hive客户端都将打开一个到元数据服务器的连接,该服务器依次查询元数据,元数据服务器和客户端之间使用Thrift协议通信。
9、Hive内部表和外部表的区别?
创建表时:创建内部表时,会将数据移动到数据仓库指向的路径;若创建外部表,仅记录数据所在的路径,不对数据的位置做任何改变。
删除表时:在删除表的时候,内部表的元数据和数据会被一起删除, 而外部表只删除元数据,不删除数据。这样外部表相对来说更加安全些,数据组织也更加灵活,方便共享源数据。
10、Hive 中的压缩格式TextFile、SequenceFile、RCfile 、ORCfile各有什么区别?
1、TextFile
默认格式,存储方式为行存储,数据不做压缩,磁盘开销大,数据解析开销大。可结合Gzip、Bzip2使用(系统自动检查,执行查询时自动解压),但使用这种方式,压缩后的文件不支持split,Hive不会对数据进行切分,从而无法对数据进行并行操作。并且在反序列化过程中,必须逐个字符判断是不是分隔符和行结束符,因此反序列化开销会比SequenceFile高几十倍。
2、SequenceFile
SequenceFile是Hadoop API提供的一种二进制文件支持,存储方式为行存储,其具有使用方便、可分割、可压缩的特点。
SequenceFile支持三种压缩选择:NONE,RECORD,BLOCK。Record压缩率低,一般建议使用BLOCK压缩。
优势是文件和hadoop api中的MapFile是相互兼容的
3、RCFile
存储方式:数据按行分块,每块按列存储。结合了行存储和列存储的优点:
首先,RCFile 保证同一行的数据位于同一节点,因此元组重构的开销很低;
其次,像列存储一样,RCFile 能够利用列维度的数据压缩,并且能跳过不必要的列读取;
4、ORCFile
存储方式:数据按行分块 每块按照列存储。
压缩快、快速列存取。
效率比rcfile高,是rcfile的改良版本。
总结:相比TEXTFILE和SEQUENCEFILE,RCFILE由于列式存储方式,数据加载时性能消耗较大,但是具有较好的压缩比和查询响应。
数据仓库的特点是一次写入、多次读取,因此,整体来看,RCFILE相比其余两种格式具有较明显的优势。
11、所有的Hive任务都会有MapReduce的执行吗?
不是,从Hive0.10.0版本开始,对于简单的不需要聚合的类似SELECT from
LIMIT n语句,不需要起MapReduce job,直接通过Fetch task获取数据。12、Hive的函数:UDF、UDAF、UDTF的区别?
UDF:单行进入,单行输出
UDAF:多行进入,单行输出
UDTF:单行输入,多行输出
13、说说对Hive桶表的理解?
桶表是对数据进行哈希取值,然后放到不同文件中存储。
数据加载到桶表时,会对字段取hash值,然后与桶的数量取模。把数据放到对应的文件中。物理上,每个桶就是表(或分区)目录里的一个文件,一个作业产生的桶(输出文件)和reduce任务个数相同。
桶表专门用于抽样查询,是很专业性的,不是日常用来存储数据的表,需要抽样查询时,才创建和使用桶表。
Hive面试题整理(二)
1、Fetch抓取
Fetch抓取是指,Hive中对某些情况的查询可以不必使用MapReduce计算。例如:SELECT * FROM employees;在这种情况下,Hive可以简单地读取employee对应的存储目录下的文件,然后输出查询结果到控制台。
在hive-default.xml.template文件中hive.fetch.task.conversion默认是more,老版本hive默认是minimal,该属性修改为more以后,在全局查找、字段查找、limit查找等都不走mapreduce。
2、本地模式
大多数的Hadoop Job是需要Hadoop提供的完整的可扩展性来处理大数据集的。不过,有时Hive的输入数据量是非常小的。在这种情况下,为查询触发执行任务时消耗可能会比实际job的执行时间要多的多。对于大多数这种情况,Hive可以通过本地模式在单台机器上处理所有的任务。对于小数据集,执行时间可以明显被缩短。
用户可以通过设置hive.exec.mode.local.auto的值为true,来让Hive在适当的时候自动启动这个优化。
表的优化
3、小表、大表Join
将key相对分散,并且数据量小的表放在join的左边,这样可以有效减少内存溢出错误发生的几率;再进一步,可以使用Group让小的维度表(1000条以下的记录条数)先进内存。在map端完成reduce。
实际测试发现:新版的hive已经对小表JOIN大表和大表JOIN小表进行了优化。小表放在左边和右边已经没有明显区别。
4、大表Join大表
1)空KEY过滤
有时join超时是因为某些key对应的数据太多,而相同key对应的数据都会发送到相同的reducer上,从而导致内存不够。此时我们应该仔细分析这些异常的key,很多情况下,这些key对应的数据是异常数据,我们需要在SQL语句中进行过滤。例如key对应的字段为空。
2)空key转换
有时虽然某个key为空对应的数据很多,但是相应的数据不是异常数据,必须要包含在join的结果中,此时我们可以表a中key为空的字段赋一个随机的值,使得数据随机均匀地分不到不同的reducer上。
5、Group By
默认情况下,Map阶段同一Key数据分发给一个reduce,当一个key数据过大时就倾斜了。
并不是所有的聚合操作都需要在Reduce端完成,很多聚合操作都可以先在Map端进行部分聚合,最后在Reduce端得出最终结果。
1)开启Map端聚合参数设置
(1)是否在Map端进行聚合,默认为True
hive.map.aggr = true
(2)在Map端进行聚合操作的条目数目
hive.groupby.mapaggr.checkinterval = 100000
(3)有数据倾斜的时候进行负载均衡(默认是false)
hive.groupby.skewindata = true
当选项设定为 true,生成的查询计划会有两个MR Job。第一个MR Job中,Map的输出结果会随机分布到Reduce中,每个Reduce做部分聚合操作,并输出结果,这样处理的结果是相同的Group By Key有可能被分发到不同的Reduce中,从而达到负载均衡的目的;第二个MR Job再根据预处理的数据结果按照Group By Key分布到Reduce中(这个过程可以保证相同的Group By Key被分布到同一个Reduce中),最后完成最终的聚合操作。
6、Count(Distinct) 去重统计
数据量小的时候无所谓,数据量大的情况下,由于COUNT DISTINCT操作需要用一个Reduce Task来完成,这一个Reduce需要处理的数据量太大,就会导致整个Job很难完成,一般COUNT DISTINCT使用先GROUP BY再COUNT的方式替换
7、笛卡尔积
尽量避免笛卡尔积,join的时候不加on条件,或者无效的on条件,Hive只能使用1个reducer来完成笛卡尔积
8、行列过滤
列处理:在SELECT中,只拿需要的列,如果有,尽量使用分区过滤,少用SELECT *。
行处理:在分区剪裁中,当使用外关联时,如果将副表的过滤条件写在Where后面,那么就会先全表关联,之后再过滤。
数据倾斜
9、 Map数
1)通常情况下,作业会通过input的目录产生一个或者多个map任务。
主要的决定因素有:input的文件总个数,input的文件大小,集群设置的文件块大小。
2)是不是map数越多越好?
答案是否定的。如果一个任务有很多小文件(远远小于块大小128m),则每个小文件也会被当做一个块,用一个map任务来完成,而一个map任务启动和初始化的时间远远大于逻辑处理的时间,就会造成很大的资源浪费。而且,同时可执行的map数是受限的。
3)是不是保证每个map处理接近128m的文件块,就高枕无忧了?
答案也是不一定。比如有一个127m的文件,正常会用一个map去完成,但这个文件只有一个或者两个小字段,却有几千万的记录,如果map处理的逻辑比较复杂,用一个map任务去做,肯定也比较耗时。
针对上面的问题2和3,我们需要采取两种方式来解决:即减少map数和增加map数;
10、小文件进行合并
在map执行前合并小文件,减少map数:CombineHiveInputFormat具有对小文件进行合并的功能(系统默认的格式)。HiveInputFormat没有对小文件合并功能。
set hive.input.format= org.apache.hadoop.hive.ql.io.CombineHiveInputFormat;
11、复杂文件增加Map数
当input的文件都很大,任务逻辑复杂,map执行非常慢的时候,可以考虑增加Map数,来使得每个map处理的数据量减少,从而提高任务的执行效率。
增加map的方法为:根据computeSliteSize(Math.max(minSize,Math.min(maxSize,blocksize)))=blocksize=128M公式,调整maxSize最大值。让maxSize最大值低于blocksize就可以增加map的个数。
12、Reduce数
1)调整reduce个数方法一
(1)每个Reduce处理的数据量默认是256MB
hive.exec.reducers.bytes.per.reducer=256000000
(2)每个任务最大的reduce数,默认为1009
hive.exec.reducers.max=1009
(3)计算reducer数的公式
N=min(参数2,总输入数据量/参数1)
2)调整reduce个数方法二
在hadoop的mapred-default.xml文件中修改
设置每个job的Reduce个数
set mapreduce.job.reduces = 15;
3)reduce个数并不是越多越好
(1)过多的启动和初始化reduce也会消耗时间和资源;
(2)另外,有多少个reduce,就会有多少个输出文件,如果生成了很多个小文件,那么如果这些小文件作为下一个任务的输入,则也会出现小文件过多的问题;
在设置reduce个数的时候也需要考虑这两个原则:处理大数据量利用合适的reduce数;使单个reduce任务处理数据量大小要合适。
**==========================**
13、并行执行
Hive会将一个查询转化成一个或者多个阶段。这样的阶段可以是MapReduce阶段、抽样阶段、合并阶段、limit阶段。或者Hive执行过程中可能需要的其他阶段。默认情况下,Hive一次只会执行一个阶段。不过,某个特定的job可能包含众多的阶段,而这些阶段可能并非完全互相依赖的,也就是说有些阶段是可以并行执行的,这样可能使得整个job的执行时间缩短。不过,如果有更多的阶段可以并行执行,那么job可能就越快完成。
通过设置参数hive.exec.parallel值为true,就可以开启并发执行。不过,在共享集群中,需要注意下,如果job中并行阶段增多,那么集群利用率就会增加。
Zookeeper面试题总结
1、请简述Zookeeper的选举机制
假设有五台服务器组成的zookeeper集群,它们的id从1-5,同时它们都是最新启动的,也就是没有历史数据,在存放数据量这一点上,都是一样的。
假设这些服务器依序启动,来看看会发生什么。

(1)服务器1启动,此时只有它一台服务器启动了,它发出去的报没有任何响应,所以它的选举状态一直是LOOKING状态。
(2)服务器2启动,它与最开始启动的服务器1进行通信,互相交换自己的选举结果,由于两者都没有历史数据,所以id值较大的服务器2胜出,
但是由于没有达到超过半数以上的服务器都同意选举它(这个例子中的半数以上是3),所以服务器1、2还是继续保持LOOKING状态。
(3)服务器3启动,根据前面的理论分析,服务器3成为服务器1、2、3中的Leader,而与上面不同的是,此时有三台服务器选举了它,
所以它成为了这次选举的Leader。
(4)服务器4启动,根据前面的分析,理论上服务器4应该是服务器1、2、3、4中最大的,但是由于前面已经有半数以上的服务器选举了服务器3,
所以它成为Follower。
(5)服务器5启动,同4一样成为Follower。
注意,如果按照5,4,3,2,1的顺序启动,那么5将成为Leader,因为在满足半数条件后,ZooKeeper集群启动,5的Id最大,被选举为Leader。
2、客户端如何正确处理CONNECTIONLOSS(连接断开) 和 SESSIONEXPIRED(Session 过期)两类连接异常?
在ZooKeeper中,服务器和客户端之间维持的是一个长连接,在 SESSION_TIMEOUT 时间内,服务器会确定客户端是否正常连接(客户端会定时向服务器发送
heart_beat),服务器重置下次SESSION_TIMEOUT时间。因此,在正常情况下,Session一直有效,并且zk集群所有机器上都保存这个Session信息。在出现问题的情况下,
客户端与服务器之间连接断了(客户端所连接的那台zk机器挂了,或是其它原因的网络闪断),这个时候客户端会主动在地址列表(初始化的时候传入构造方法的那个
参数connectString)中选择新的地址进行连接。
以上即为服务器与客户端之间维持长连接的过程,在这个过程中,用户可能会看到两类异常CONNECTIONLOSS(连接断开) 和SESSIONEXPIRED(Session 过期)。
发生CONNECTIONLOSS后,此时用户不需要关心我的会话是否可用,应用所要做的就是等待客户端帮我们自动连接上新的zk机器,一旦成功连接上新的zk机器后,
确认之前的操作是否执行成功了。
3、一个客户端修改了某个节点的数据,其他客户端能够马上获取到这个最新数据吗?
ZooKeeper不能确保任何客户端能够获取(即Read Request)到一样的数据,除非客户端自己要求,方法是客户端在获取数据之前调用
org.apache.zookeeper.AsyncCallbac k.VoidCallback, java.lang.Object) sync。
通常情况下(这里所说的通常情况满足:1. 对获取的数据是否是最新版本不敏感,2. 一个客户端修改了数据,其它客户端是否需要立即能够获取最新数据),
可以不关心这点。
在其它情况下,最清晰的场景是这样:ZK客户端A对 /my_test 的内容从 v1->v2, 但是ZK客户端B对 /my_test 的内容获取,依然得到的是 v1. 请注意,
这个是实际存在的现象,当然延时很短。解决的方法是客户端B先调用 sync(), 再调用 getData()。
4、ZooKeeper对节点的watch监听是永久的吗?为什么?
不是。
官方声明:一个Watch事件是一个一次性的触发器,当被设置了Watch的数据发生了改变的时候,则服务器将这个改变发送给设置了Watch的客户端,
以便通知它们。
为什么不是永久的,举个例子,如果服务端变动频繁,而监听的客户端很多情况下,每次变动都要通知到所有的客户端,这太消耗性能了。
一般是客户端执行getData(“/节点A”,true),如果节点A发生了变更或删除,客户端会得到它的watch事件,但是在之后节点A又发生了变更,
而客户端又没有设置watch事件,就不再给客户端发送。
在实际应用中,很多情况下,我们的客户端不需要知道服务端的每一次变动,我只要最新的数据即可。
5、ZooKeeper中使用watch的注意事项有哪些?
使用watch需要注意的几点:
1)Watches通知是一次性的,必须重复注册。
2)发生CONNECTIONLOSS之后,只要在session_timeout之内再次连接上(即不发生SESSIONEXPIRED),那么这个连接注册的watches依然在。
3)节点数据的版本变化会触发NodeDataChanged,注意,这里特意说明了是版本变化。存在这样的情况,只要成功执行了setData()方法,
无论内容是否和之前一致,都会触发NodeDataChanged。
4)对某个节点注册了watch,但是节点被删除了,那么注册在这个节点上的watches都会被移除。
5)同一个zk客户端对某一个节点注册相同的watch,只会收到一次通知。
6)Watcher对象只会保存在客户端,不会传递到服务端。
6、能否收到每次节点变化的通知?
如果节点数据的更新频率很高的话,不能。
原因在于:当一次数据修改,通知客户端,客户端再次注册watch,在这个过程中,可能数据已经发生了许多次数据修改,因此,
千万不要做这样的测试:”数据被修改了n次,一定会收到n次通知”来测试server是否正常工作。
7、能否为临时节点创建子节点?
ZooKeeper中不能为临时节点创建子节点,如果需要创建子节点,应该将要创建子节点的节点创建为永久性节点。
8、是否可以拒绝单个IP对ZooKeeper的访问?
如何实现?ZK本身不提供这样的功能,它仅仅提供了对单个IP的连接数的限制。你可以通过修改iptables来实现对单个ip的限制。
9、创建的临时节点什么时候会被删除,是连接一断就删除吗?
延时是多少?连接断了之后,ZK不会马上移除临时数据,只有当SESSIONEXPIRED之后,才会把这个会话建立的临时数据移除。因此,
用户需要谨慎设置Session_TimeOut。
10、ZooKeeper是否支持动态进行机器扩容?如果目前不支持,那么要如何扩容呢?
ZooKeeper中的动态扩容其实就是水平扩容,Zookeeper对这方面的支持不太好,目前有两种方式:
全部重启:关闭所有Zookeeper服务,修改配置之后启动,不影响之前客户端的会话。
逐个重启:这是比较常用的方式。
11、ZooKeeper集群中服务器之间是怎样通信的?
Leader服务器会和每一个Follower/Observer服务器都建立TCP连接,同时为每个F/O都创建一个叫做LearnerHandler的实体。
LearnerHandler主要负责Leader和F/O之间的网络通讯,包括数据同步,请求转发和Proposal提议的投票等。Leader服务器保存了所有F/O的LearnerHandler。
12、ZooKeeper是否会自动进行日志清理?
如何进行日志清理?zk自己不会进行日志清理,需要运维人员进行日志清理。
13、谈谈你对ZooKeeper的理解?
Zookeeper 作为一个分布式的服务框架,主要用来解决分布式集群中应用系统的一致性问题。ZooKeeper提供的服务包括:分布式消息同步和协调机制、
服务器节点动态上下线、统一配置管理、负载均衡、集群管理等。
ZooKeeper提供基于类似于Linux文件系统的目录节点树方式的数据存储,即分层命名空间。Zookeeper 并不是用来专门存储数据的,
它的作用主要是用来维护和监控你存储的数据的状态变化,通过监控这些数据状态的变化,从而可以达到基于数据的集群管理,ZooKeeper节点的数据上限是1MB。
我们可以认为Zookeeper=文件系统+通知机制,对于ZooKeeper的数据结构,每个子目录项如 NameService 都被称作为 znode,这个 znode 是被它所在的
路径唯一标识,如 Server1 这个 znode 的标识为 /NameService/Server1;
znode 可以有子节点目录,并且每个 znode 可以存储数据,注意 EPHEMERAL 类型的目录节点不能有子节点目录(因为它是临时节点);
znode 是有版本的,每个 znode 中存储的数据可以有多个版本,也就是一个访问路径中可以存储多份数据;
znode 可以是临时节点,一旦创建这个 znode 的客户端与服务器失去联系,这个 znode 也将自动删除,Zookeeper 的客户端和服务器通信采用长连接方式,
每个客户端和服务器通过心跳来保持连接,这个连接状态称为 session,如果 znode 是临时节点,这个 session 失效,znode 也就删除了;
znode 的目录名可以自动编号,如 App1 已经存在,再创建的话,将会自动命名为 App2;
znode 可以被监控,包括这个目录节点中存储的数据的修改,子节点目录的变化等,一旦变化可以通知设置监控的客户端,这个是 Zookeeper 的核心特性,
Zookeeper 的很多功能都是基于这个特性实现的,后面在典型的应用场景中会有实例介绍。
14、ZooKeeper节点类型?
1)Znode有两种类型:
短暂(ephemeral):客户端和服务器端断开连接后,创建的节点自己删除。
持久(persistent):客户端和服务器端断开连接后,创建的节点不删除。
2)Znode有四种形式的目录节点(默认是persistent )
(1)持久化目录节点(PERSISTENT) 客户端与zookeeper断开连接后,该节点依旧存在。
(2)持久化顺序编号目录节点(PERSISTENT_SEQUENTIAL) 客户端与zookeeper断开连接后,该节点依旧存在,
只是Zookeeper给该节点名称进行顺序编号。
(3)临时目录节点(EPHEMERAL) 客户端与zookeeper断开连接后,该节点被删除。
(4)临时顺序编号目录节点(EPHEMERAL_SEQUENTIAL)客户端与zookeeper断开连接后,该节点被删除,只是Zookeeper给该节点名称进行顺序编号。
15、请说明ZooKeeper的通知机制?
ZooKeeper选择了基于通知(notification)的机制,即:客户端向ZooKeeper注册需要接受通知的znode,通过znode设置监控点(watch)来接受通知。
监视点是一个单次触发的操作,意即监视点会触发一个通知。为了接收多个通知,客户端必须在每次通知后设置一个新的监视点。在下图阐述的情况下,
当节点/task发生变化时,客户端会受到一个通知,并从ZooKeeper读取一个新值。

16、ZooKeeper的监听原理是什么?
在应用程序中,mian()方法首先会创建zkClient,创建zkClient的同时就会产生两个进程,即Listener进程(监听进程)和
connect进程(网络连接/传输进程),当zkClient调用getChildren()等方法注册监视器时,connect进程向ZooKeeper注册监听器,
注册后的监听器位于ZooKeeper的监听器列表中,监听器列表中记录了zkClient的IP,端口号以及要监控的路径,一旦目标文件发生变化,
ZooKeeper就会把这条消息发送给对应的zkClient的Listener()进程,Listener进程接收到后,就会执行process()方法,
在process()方法中针对发生的事件进行处理。

17、请说明ZooKeeper使用到的各个端口的作用?
2888:Follower与Leader交换信息的端口。
3888:万一集群中的Leader服务器挂了,需要一个端口来重新进行选举,选出一个新的Leader,而这个端口就是用来执行选举时服务器相互通信的端口。
18、ZooKeeper的部署方式有哪几种?集群中的角色有哪些?集群最少需要几台机器?
ZooKeeper的部署方式有单机模式和集群模式,集群中的角色有Leader和Follower,集群最少3(2N+1)台,根据选举算法,应保证奇数。
19、ZooKeeper集群如果有3台机器,挂掉一台是否还能工作?挂掉两台呢?
对于ZooKeeper集群,过半存活即可使用。
20、ZooKeeper使用的ZAB协议与Paxo算法的异同?
Paxos算法是分布式选举算法,Zookeeper使用的 ZAB协议(Zookeeper原子广播),两者的异同如下:
1)相同之处:
比如都有一个Leader,用来协调N个Follower的运行;Leader要等待超半数的Follower做出正确反馈之后才进行提案;
二者都有一个值来代表Leader的周期。
2)不同之处:
ZAB用来构建高可用的分布式数据主备系统(Zookeeper),Paxos是用来构建分布式一致性状态机系统。
21、请谈谈对ZooKeeper对事务性的支持?
ZooKeeper对于事务性的支持主要依赖于四个函数,zoo_create_op_init, zoo_delete_op_init, zoo_set_op_init以及zoo_check_op_init。
每一个函数都会在客户端初始化一个operation,客户端程序有义务保留这些operations。当准备好一个事务中的所有操作后,可以使用zoo_multi来提交所有的操作,
由zookeeper服务来保证这一系列操作的原子性。也就是说只要其中有一个操作失败了,相当于此次提交的任何一个操作都没有对服务端的数据造成影响。
Zoo_multi的返回值是第一个失败操作的状态信号。

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 25
 0
- 0


 已为社区贡献1条内容

所有评论(0)