fastapi结合Manticore Search、elasticsearch、mysql实现全文搜索
·
1、将数据写入到mysql中
- 创建测试表
CREATE TABLE `student` (
  `sno` varchar(10) COLLATE utf8mb4_unicode_ci NOT NULL,
  `sname` varchar(20) COLLATE utf8mb4_unicode_ci DEFAULT NULL,
  `sage` int(2) DEFAULT NULL,
  `ssex` varchar(5) COLLATE utf8mb4_unicode_ci DEFAULT NULL,
  `description` varchar(255) CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci DEFAULT NULL,
  PRIMARY KEY (`sno`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_unicode_ci;- 测试表插入数据
insert into student values ('s001','张三',23,'男','张三是个好学生');
insert into student values ('s002','李四',23,'男','张三是个好学生');
insert into student values ('s003','吴鹏',25,'男','张三是个好学生');
insert into student values ('s004','琴沁',20,'女','张三是个好学生');
insert into student values ('s005','王丽',20,'女','张三是个好学生');
insert into student values ('s006','李波',21,'男','张三是个好学生');
insert into student values ('s007','刘玉',21,'男','张三是个好学生');
insert into student values ('s008','萧蓉',21,'女','张三是个好学生');
insert into student values ('s009','陈萧晓',23,'女','张三是个好学生');
insert into student values ('s010','陈美',22,'女','张三是个好学生');- 表字段描述

- 字段意义
sno 学号
sname	学生姓名
sage	学生年龄
ssex	学生性别
description	学生描述
2、python安装fastapi、elasticsearch框架、Manticore Search框架和mysql客户端
pip install elasticsearch==8.8.2
pip install pymysql
pip install manticoresearch

# Uvicorn是一个ASGI服务器,用于运行FastAPI应用。
pip install uvicorn
pip install fastapi
3、将mysql的数据写入到elasticsearch中
- mysql数据同步到es
# mysql-to-es
# 本地es版本 8.8.2
# python es版本  8.8.2
import pymysql
from elasticsearch import Elasticsearch

def get_data():
    conn=pymysql.connect(host="localhost",port=3306,user="root",password="root",database="mydb")
    cursor=conn.cursor()
    sql="select * from student"
    t_header_sql = "desc student "
    cursor.execute(sql)
    results=cursor.fetchall()
    cursor.execute(t_header_sql)
    header_results = cursor.fetchall()
    conn.close()
    return results,header_results

def create_es_data():
    # es = Elasticsearch()
    es = Elasticsearch(
        [
            "https://192.168.10.1:9200",
        ],
        ca_certs="./path/to/http_ca.crt",	# es认证证书,8.0版本后开始使用
        basic_auth=("elastic", "U4mRQUoVeQ+YMzcCFD1t"),
        request_timeout=3600
    )
    try:
        data_results,cloumns_results = get_data()
        for row in data_results:
            message = {}
            for i in range(len(row)):
                # print(cloumns_results[i][0], row[i])
                message[cloumns_results[i][0]] = row[i]

            print(message)
            es.index(index="student", document=message)
    except Exception as e:
        print("Error:" + str(e))

if __name__=="__main__":
create_es_data()- es查看数据(Elasticvue插件)

4、将mysql的数据写入到Manticore中
- mysql数据同步到Manticore
注:Manticore 和 Mysql 使用pymysql即mysql客户端
import pymysql

def get_data():
    conn = pymysql.connect(host="localhost", port=3306, user="root", password="root", database="mydb")
    cursor = conn.cursor()
    sql = "select * from student"
    t_header_sql = "desc student "
    cursor.execute(sql)
    results = cursor.fetchall()
    cursor.execute(t_header_sql)
    header_results = cursor.fetchall()
    header_tuple = tuple(x[0] for x in header_results)
    conn.close()
    return results, header_tuple

def inster_data_to_manticore():
    try:
        db = pymysql.connect(host='localhost', port=9306)
        print('manticoredb 连接成功!')
    except:
        print('something wrong!')

    if db:
        cursor = db.cursor()
        rows, header_tuple = get_data()
        header_str = str(header_tuple).replace("\'","")
        sql = 'drop table if exists students'
        cursor.execute(sql)
        db.commit()

        for row in rows:
            sql = f'INSERT INTO students{header_str} VALUES {row}'
            print(sql)
            cursor.execute(sql)
            db.commit()

if __name__ == '__main__':
inster_data_to_manticore()- Manticore 数据查询(工具Webyog SQLyog)

5、elasticsearch查找类的封装
- es安全认证连接(参考官网)
- 按fields查询方法封装,输入参数fields 筛选器,query查询字符串
# elasticsearch_query_class.py
from elasticsearch import Elasticsearch
class elasticsearchself():
    def __init__(self,index_name,index_type = '_doc'):
        self.es = Elasticsearch(
        [
            "https://192.168.10.1:9200",
        ],
        ca_certs="./path/to/http_ca.crt",
        basic_auth=("elastic", "U4mRQUoVeQ+YMzcCFD1t"),
        request_timeout=3600
        )
        self.index_name=index_name
        self.index_type=index_type

    def search_by_fields(self,query,fields,count:int=30):
        ds = {"multi_match": {"query": query,"fields": fields}}
        fields = ['sname','description']
        match_data=self.es.search(index=self.index_name,query=ds,size=count)
        return match_data

es=elasticsearchself(index_name="student")
query = "张三"
fields= ['sname','description']
match_data = es.search_by_fields(query,fields)
print(match_data)
6、Manticoresearch查找类的封装
# manticoreself.py

import manticoresearch
from manticoresearch.api import search_api
from manticoresearch.model.search_request import SearchRequest

class manticoresearchself():
    def __init__(self, index_name):
        self.configuration = manticoresearch.Configuration(
        host = "http://127.0.0.1:9308"
        )
        self.index_name = index_name

    def search_all_text(self,query):
        with manticoresearch.ApiClient(self.configuration) as api_client:
            # Create an instance of the API class
            api_instance = search_api.SearchApi(api_client)

            # # Create SearchRequest
            # search_request = SearchRequest()
            # search_request.index='students'
            # # search_request.fulltext_filter=QueryFilter(23)
            # search_request.fulltext_filter =

            search_request = SearchRequest(
                index='students',
                query={
                    "match":
                        {
                            "*" : query
                        }
                },
            )

            # example passing only required values which don't have defaults set
            try:
                # Performs a search
                api_response = api_instance.search(search_request)
                # pprint(api_response)
                return api_response
            except manticoresearch.ApiException as e:
                print("Exception when calling SearchApi->search: %s\n" % e)


mc=manticoresearchself(index_name="student")
query = "s004"
match_data = mc.search_all_text(query)
match_data_dict = match_data.__dict__
print(match_data._hits._hits[0]["_source"])
7、fastapi实现elasticseach的全文检索模糊查询
# main.py
from fastapi import FastAPI
from elasticsearch_query_class import elasticsearchself
import json
import time

app = FastAPI()

@app.get("/get_es/{query}")
async def get_es(query):
    fields = ['*']
    es=elasticsearchself(index_name="student")
    time_start = time.time()  # 记录开始时间
    data=es.search_by_fields(query,fields)
    time_end = time.time()  # 记录结束时间
    address_data=data["hits"]["hits"]
    address_list=[]
    for item in address_data:
        address_list.append(item["_source"])
    time_sum = time_end - time_start  # 计算的时间差为程序的执行时间,单位为秒/s
    address_list.append({"time_sum":time_sum})
    new_json=json.dumps(address_list,ensure_ascii=False)
    return json.loads(new_json)
思路: es创建筛选器列表fields,[*]表示所有字段,查询体query
8、fastapi实现Manticoresearch的全文检索筛选查询
# main.py
from fastapi import FastAPI
from manticoreself import manticoresearchself
import json
import time

app = FastAPI()

@app.get('/get_mc/<query>')
async def get_mc(query):
    mc = manticoresearchself(index_name="student")
    time_start = time.time()  # 记录开始时间
    data = mc.search_all_text(query)
    time_end = time.time()  # 记录结束时间
    address_data = data._hits._hits
    address_list = []
    for item in address_data:
        address_list.append(item["_source"])

    time_sum = time_end - time_start  # 计算的时间差为程序的执行时间,单位为秒/s
    address_list.append({"time_sum": time_sum})
    new_json = json.dumps(address_list, ensure_ascii=False)
    return json.loads(new_json)
思路: Manticoresearch 支持openapi查询接口,使用search_all_text api接口查询结果,查询体query
9、fastapi实现的Mysql列表字段全文查询
# main.py
from fastapi import FastAPI
import json
import time
import pymysql

app = FastAPI()

@app.get('/get_mysql/<query>')
async def get_mysql(query):
    conn = pymysql.connect(host="localhost", port=3306, user="root", password="root", database="mydb")
    cursor = conn.cursor()
    fields = "(sname, description, sno,ssex)"

    try:
        create_full_index_sql = f"create fulltext index full_idx_to_table on student{fields} "
        cursor.execute(create_full_index_sql)
    except:
        pass

    query_sql = f"select * from student where match{fields} against('{query}')"
    time_start = time.time()  # 记录开始时间
    cursor.execute(query_sql)
    time_end = time.time()  # 记录结束时间
    results = cursor.fetchall()
    address_list = []
    for row in results:
        address_list.append(row)
    time_sum = time_end - time_start  # 计算的时间差为程序的执行时间,单位为秒/s
    address_list.append({"time_sum": time_sum})
    new_json = json.dumps(address_list, ensure_ascii=False)
    return json.loads(new_json)
思路: 先创建需要查找的字段即筛选器,利用筛选器列表创建全文检索index(full_idx_to_table ) 后,使用fts(Full-Text Search)查询
10、fastapi实现接口源码即验证
- fastapi源码
# main.py

from fastapi import FastAPI
from elasticsearch_query_class import elasticsearchself
import json
from manticoreself import manticoresearchself
import time
import pymysql

app = FastAPI()

@app.get("/get_es/{query}")
async def get_es(query):
    fields = ['*']
    es=elasticsearchself(index_name="student")
    time_start = time.time()  # 记录开始时间
    data=es.search_by_fields(query,fields)
    time_end = time.time()  # 记录结束时间
    address_data=data["hits"]["hits"]
    address_list=[]
    for item in address_data:
        address_list.append(item["_source"])
    time_sum = time_end - time_start  # 计算的时间差为程序的执行时间,单位为秒/s
    address_list.append({"time_sum":time_sum})
    new_json=json.dumps(address_list,ensure_ascii=False)
    return json.loads(new_json)

@app.get('/get_mc/<query>')
async def get_mc(query):
    mc = manticoresearchself(index_name="student")
    time_start = time.time()  # 记录开始时间
    data = mc.search_all_text(query)
    time_end = time.time()  # 记录结束时间
    address_data = data._hits._hits
    address_list = []
    for item in address_data:
        address_list.append(item["_source"])

    time_sum = time_end - time_start  # 计算的时间差为程序的执行时间,单位为秒/s
    address_list.append({"time_sum": time_sum})
    new_json = json.dumps(address_list, ensure_ascii=False)
    return json.loads(new_json)

@app.get('/get_mysql/<query>')
async def get_mysql(query):
    conn = pymysql.connect(host="localhost", port=3306, user="root", password="root", database="mydb")
    cursor = conn.cursor()
    fields = "(sname, description, sno,ssex)"

    try:
        create_full_index_sql = f"create fulltext index full_idx_to_table on student{fields} "
        cursor.execute(create_full_index_sql)
    except:
        pass

    query_sql = f"select * from student where match{fields} against('{query}')"
    time_start = time.time()  # 记录开始时间
    cursor.execute(query_sql)
    time_end = time.time()  # 记录结束时间
    results = cursor.fetchall()
    address_list = []
    for row in results:
        address_list.append(row)
    time_sum = time_end - time_start  # 计算的时间差为程序的执行时间,单位为秒/s
    address_list.append({"time_sum": time_sum})
    new_json = json.dumps(address_list, ensure_ascii=False)
return json.loads(new_json)- 验证(地址:http://127.0.0.1:8000/dcos)
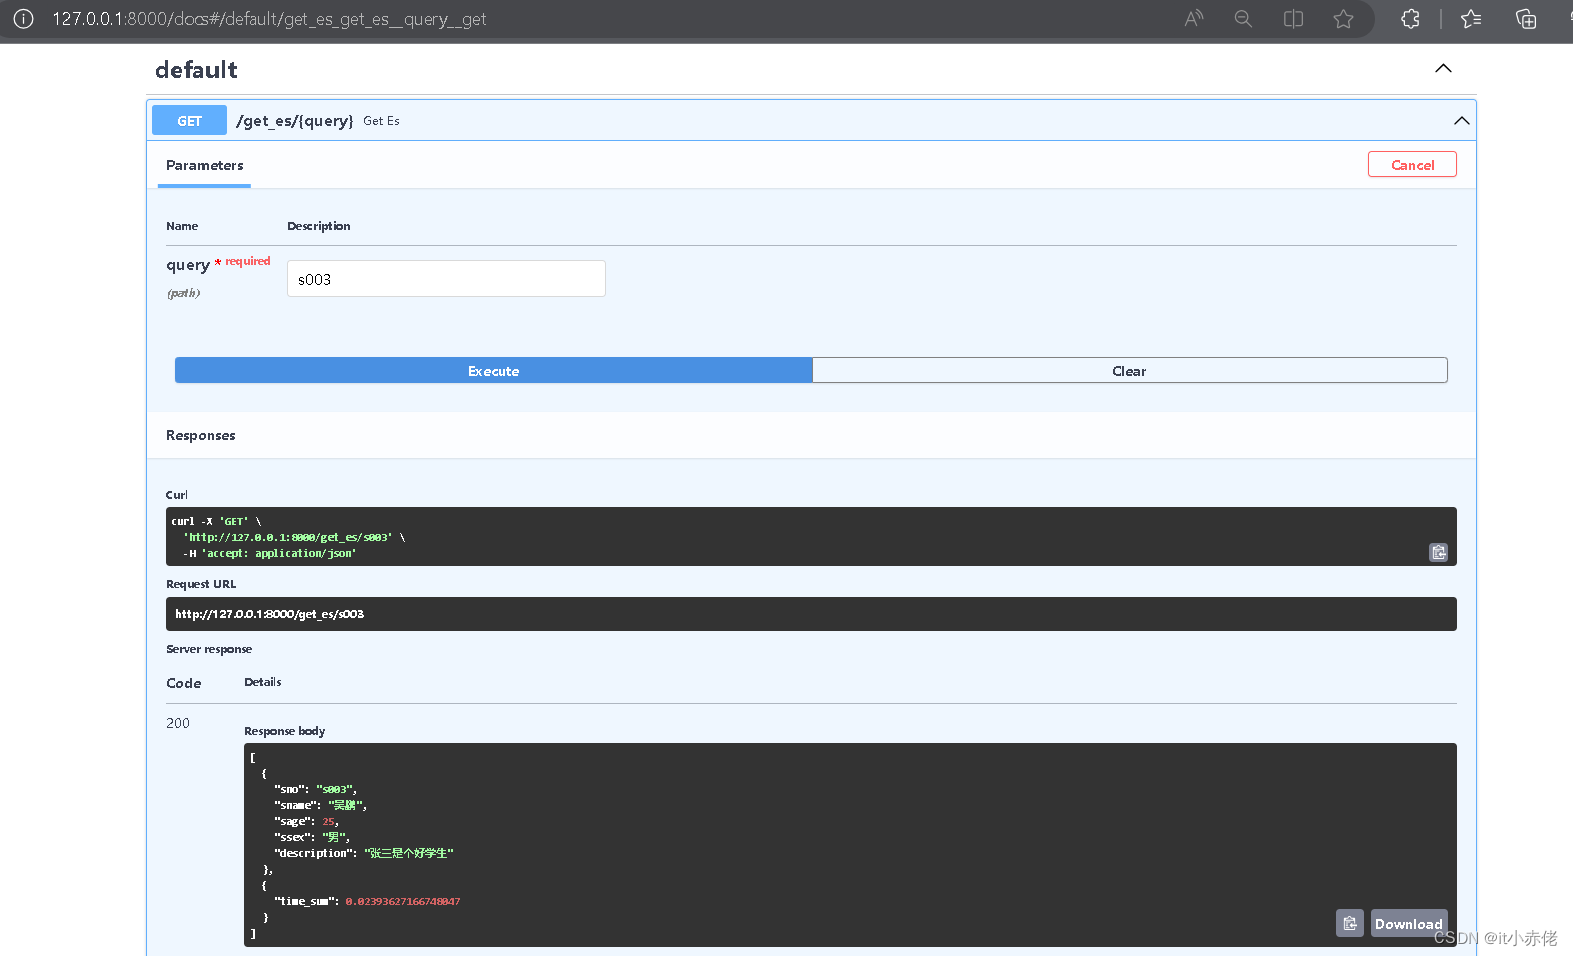

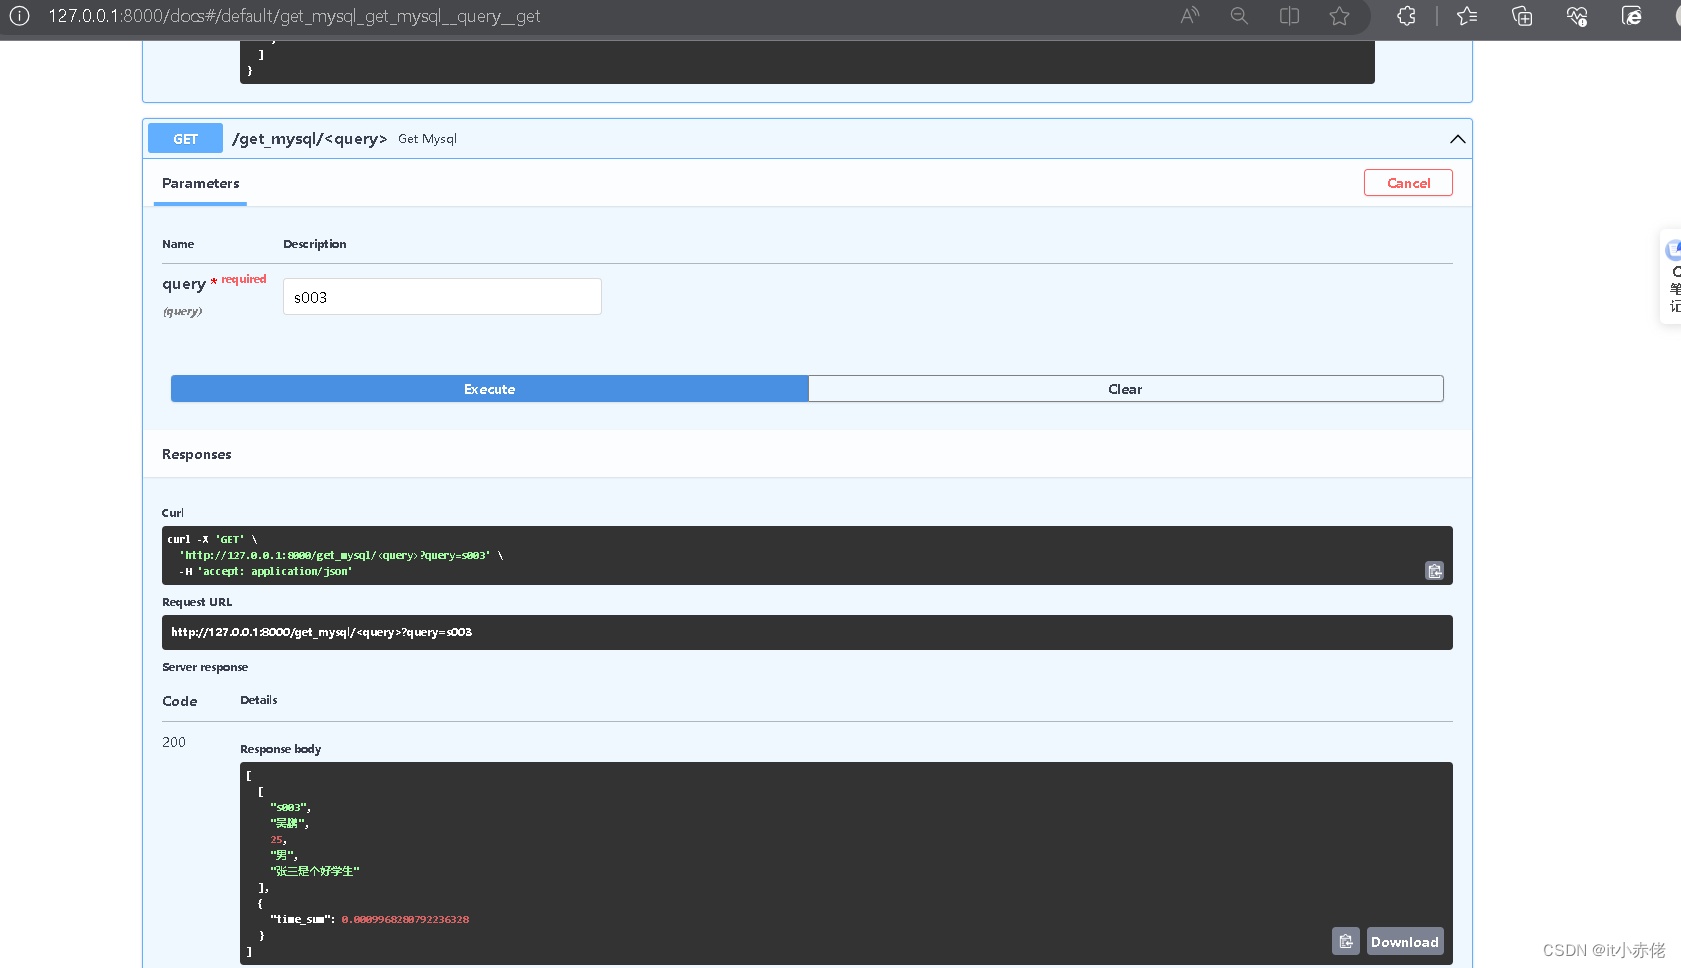
10、总结
- elasticsearch 全文搜索
- 支持中、英全文搜索
- 但速度没有mysql和Manticore Search快
- Manticore Search全文搜索
- 暂时只支持英文全文搜索
- 搜索速度快,相比es少量数据快,没有mysql少量数据快,但据官方显示大量数据时Manticore Search快于mysql
- Mysql全文搜索
- 支持中、英搜索,中文时sql against中加IN BOOLEAN MODE
- 少量数据时搜索极快,但全文搜索时需要创建搜索数据的全文索引,有些麻烦

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 18
 0
- 0


 已为社区贡献2条内容

所有评论(0)