监督学习分类学习模型简介
1.监督学习
根据已有的数据集,知道输入和输出结果之间的关系。根据这种已知的关系,训练得到一个最优的模型。监督学习可以分成分类学习和回归预测两类,下面我们主要简单介绍一下分类学习的模型。
2.线性分类器
线性分类器是一种假设特征和分类结果存在线性关系的模型,这个模型通过累加计算每个维度上的特征和各自权重的乘积来帮助类别决策。
这种线性关系可以表示为:
f(w,x,b)=wTx+bf(w,x,b)=w^Tx+bf(w,x,b)=wTx+b
其中x=[x1,x2,x3…xn]表示分类特征的n维列向量
w=[w1,w2,w3…wn]表示权重的n维列向量
b是截距
对于二分类问题,我们需要把f(w,x,b)f(w,x,b)f(w,x,b)映射到[0,1]区间上,因此我们引入逻辑斯蒂函数:
g(z)=11+e−zg(z)=\frac {1}{1+e^-z}g(z)=1+e−z1
函数图像如下:
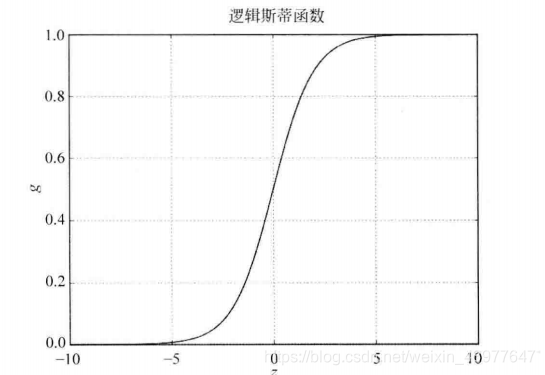
将上面的z替换成为f(w,x,b)f(w,x,b)f(w,x,b)就实现了将数据映射到[0,1]区间上。
from sklearn.linear_model import LogisticRegression
from sklearn.linear_model import SGDClassifier
from sklearn.metrics import classification_report

lr = LogisticRegression()
sgdc = SGDClassifier()

#输出LR的准确率和混淆矩阵
print('Accuracy of LR Classifier:', lr.score(X_test, y_test))
print(classification_report(y_test, lr_y_predict, target_names=['Benign', 'Malignant']))

#输出随机梯度下降的准确率和混淆矩阵
print('Accravy of SGD Classifier:', sgdc.score(X_test, y_test))
print(classification_report(y_test, sgdc_y_predict, target_names=['Benign', 'Malignant']))
classification_report
用于模型的结果评估
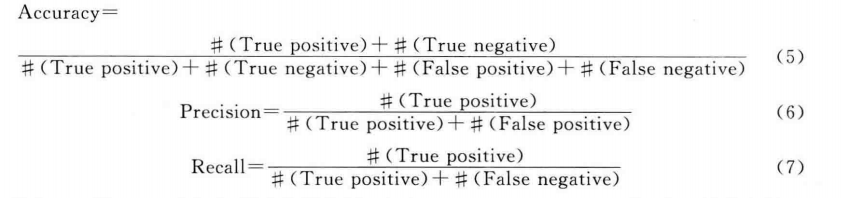
上面图片中5式表示准确性,6式是精确率(越大越好),7式是召回率(越大越好)。
综合考量精确率和召回率我们可以得到
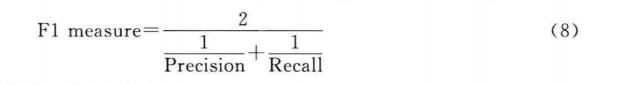
同样F1指标越大越好
3.支持向量机
支持向量机中拟合出来的线性分界线是由支持向量所决定,而不是像前面线性分类器中所有数据共同决定的。
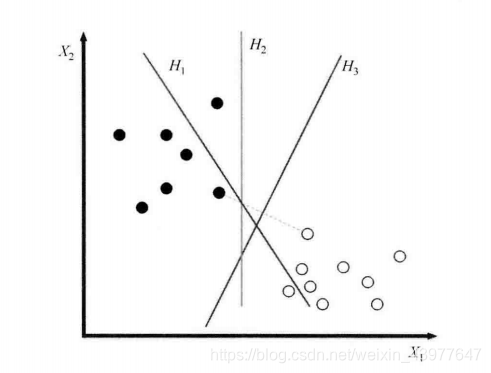
比如要划分黑球和白球,有H1,H2,H3等多种划分方式,支持向量这是是图中虚线连接的两个球所表示的向量,这两个向量对于划分的贡献是最大的。
from sklearn.svm import LinearSVC
4.朴素贝叶斯
朴素贝叶斯利用的是先验概率和后验概率的关系。
我们知道数学公式即在x的条件下发生y的概率和在y的条件下发生x的概率是一样的,公式表达如下:
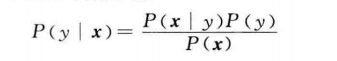
举一个例子,假如我们有一系列的数据,性别男女以及他们所对应的身高,体重,鞋码等,然后给你一个新的数据:身高“高”、体重“中”,鞋码“中”,请问这个人是男还是女?
男女就是类型,男y1,女y2;
属性条件:身高x1,体重x2,鞋码x3
那么我们想求在 x1、x2、x3 属性下,yi 的概率,用条件概率表示就是 P(yi|A1A2A3)。
因为一共有 2 个类别,所以我们只需要求得 P(y1|x1x2x3) 和P(y2|x1x2x3) 的概率即可,然后比较下哪个分类的可能性大,就是哪个分类结果是男还是女。
from sklearn.naive_bayes import MultinomialNB
该模型适用于文本识别等
5.K近邻
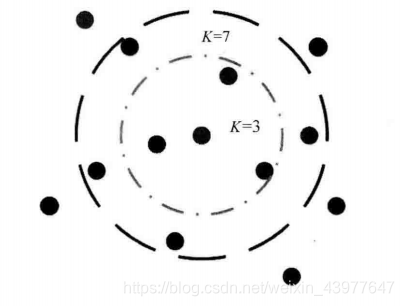
K近邻通俗来说就是“近朱者赤近墨者黑”,模型适用于物种识别
模型的参数可以用来规定用于分类的时候周围样本点的个数,下图表示周围有3个样本点和有7个样本点时的情况。
from sklearn.neighbors import KNeighborsClassifier
Kn = KNeighborsClassifier(n_neighbors=5)
6.决策树
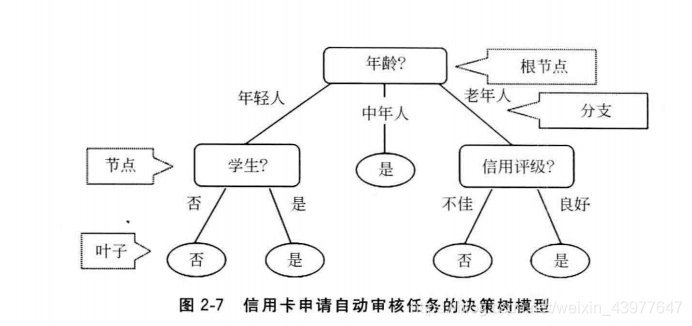
前面所涉及到的线性分类器和支持向量机在某种程度上都是需要特征和目标之间遵从线性假设,决策树则比较直观,它的决定由叶子节点完成,当然决策树也存在问题,就是对于特征节点的选择上,不同的选择会带来不同的结果。
from sklearn.tree import DecisionTreeClassifier
7.集成模型
综合考虑多个分类器的预测结果,主要集成模型可以分成两类。
一类是的训练数据来搭建多个独立的训练模型,以少数服从多数的方式来预测最终的结果,代表的有随机森林分类器,这是对上面决策树缺点的改进,可以随机选择特征来搭建从上到下的决策树,避免了决策树的一致性。
还有一类是遵循一定的次序来搭建多个分类模型,后面模型的加入对前面模型的综合能力有提示,代表的有梯度提升决策树。
from sklearn.ensemble import RandomForestClassifier
from sklearn.ensemble import GradientBoostingClassifier

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)