第G2周:人脸图像生成(DCGAN)
- 🍨 本文为🔗365天深度学习训练营 中的学习记录博客
- 🍖 原作者:K同学啊 | 接辅导、项目定制
- 🚀 文章来源:K同学的学习圈子
一、理论基础
1.什么是深度卷积对抗网络(Deep Convolutional Generative Adversarial Network,)
深度卷积对抗网络(Deep Convolutional Generative Adversarial Network,DCGAN)是一种生成对抗网络(GAN)的变体,它结合了深度卷积神经网络(CNN)的特性和生成对抗网络的架构。
生成对抗网络是由生成器(Generator)和判别器(Discriminator)组成的模型。生成器尝试生成与真实数据相似的样本,而判别器则尝试区分生成的样本和真实样本。两者通过博弈的方式不断优化,使生成器生成更逼真的样本。
DCGAN引入了卷积神经网络的结构,以处理图像生成任务。它的主要特点包括:
-
卷积层替代全连接层: DCGAN中的生成器和判别器都使用卷积层,这有助于模型学习图像中的空间层次特征,从而更好地捕捉图像的结构信息。
-
批归一化(Batch Normalization): 在生成器和判别器中广泛使用批归一化,有助于加速训练过程,同时提高模型的稳定性和生成效果。
-
去除全连接层: DCGAN中移除了全连接层,这有助于减少模型参数数量,降低过拟合的风险。
-
使用Leaky ReLU激活函数: 生成器和判别器中使用Leaky ReLU激活函数,以避免梯度消失的问题,同时引入一定的负斜率,促使模型更容易学习。
DCGAN的目标是通过训练生成器生成逼真的图像,同时训练判别器以有效地区分真实和生成的图像。这种架构的成功应用包括图像生成、图像编辑、图像超分辨率等领域。
2.DCGAN原理
DCGAN(Deep Convolutional Generative Adversarial Network)由GAN进行改进得到,它由两个子网络组成:生成器和判别器。
生成器网络接受一个随机噪声向量作为输入,并尝试生成看起来像真实数据的输出。具体来说,生成器网络通常由多个卷积层和反卷积层组成,这些层将随机噪声转换为具有现实特征的图像。
判别器网络则接受输入并尝试将其分类为“真实”或“生成”。判别器网络通常由多个卷积层组成,这些层将输入转换为具有现实特征的表示形式,并输出一个二进制数字,表示输入是否是真实数据。
在训练过程中,生成器和判别器交替进行预测和生成,以逐渐提高生成器输出的质量。生成器试图生成看起来像真实数据的输出,而判别器则试图将其与真实数据区分开来。通过不断地调整生成器和判别器,最终生成器可以生成非常逼真的数据。
3.DCGAN与GAN相同点与不同点
GAN(Generative Adversarial Network)和DCGAN(Deep Convolutional Generative Adversarial Network)都是生成对抗网络,它们的基本原理是相同的,即通过两个相互对抗的网络(生成器和判别器)来进行无监督的学习,以生成高质量的新数据。但是,DCGAN相对于GAN有一些改进和不同点,主要表现在以下方面:
相同点:
- 基本原理相同:DCGAN和GAN的基本原理都是生成对抗网络(Generative Adversarial Networks),其中两个子网络(生成器和判别器)在对抗中优化彼此。
- 判别器结构相同:在DCGAN和GAN中,判别器结构都是相同的,都是使用卷积神经网络(CNN)进行特征提取和分类。
不同点:
- 网络结构不同:DCGAN将卷积运算的思想引入到生成式模型当中,生成器和判别器模型都使用了卷积层,而GAN使用了全连接层。
训练方法不同:DCGAN使用正交标注(Orthogonal Annotation)来生成伪标签(Pseudo Labels),以用于半监督学习。而GAN通常使用真实标签(True Labels)进行监督学习。 - 输入输出不同:DCGAN输入的数据通常是3D体积,而GAN输入的数据通常是2D图像。此外,DCGAN输出的数据也是3D体积,而GAN输出的数据是2D图像。
- 判别器模型不同:在DCGAN中,判别器模型使用卷积步长取代了空间池化,以更好地提取图像特征。而在GAN中,判别器模型通常使用空间池化。
- 生成器模型不同:在DCGAN中,生成器模型中使用反卷积操作扩大数据维度,以更好地处理高分辨率的图像。而在GAN中,生成器模型通常使用上采样操作。
- 模型优化不同:在DCGAN中,整个网络去除了全连接层,直接使用卷积层连接生成器和判别器的输入层以及输出层。此外,DCGAN还使用了一些其他的技术,如Batch Normalization、Leaky ReLU激活函数和Tanh输出层,以帮助控制输出范围和提高生成质量。而在GAN中,这些技术并不常见。
4.训练原理
DCGAN的训练原理是基于半监督学习,利用已有的少量标注数据和大量无标注数据来生成新的数据。以下是DCGAN训练原理的主要步骤:
- 正交标注:首先,对一个标记的3D体积进行两个正交切片的标注,即正交标注。这样可以减少标注的负担,并且利用了不同方向的切片提供的互补信息。
- 注册模块:通过注册模块,将正交标注传播到整个体积,生成了伪标签。注册模块利用了正交标注的信息,将其传播到整个体积,从而生成了伪标签,用于半监督学习的训练过程中。
- 生成器训练:使用已经生成的伪标签和未标注的数据来训练生成器模型。生成器模型的目标是最小化判别器模型的输出,即让判别器无法区分生成器和真实数据之间的差异。
- 判别器训练:使用已经生成的伪标签和真实数据来训练判别器模型。判别器模型的目标是最小化生成器模型的输出,即让生成器无法生成看起来像真实数据的输出。
- 迭代训练:不断地迭代训练生成器和判别器模型,直到生成器能够生成看起来像真实数据的输出,并且判别器能够准确地区分生成数据和真实数据。
DCGAN的训练原理是基于半监督学习,通过生成伪标签和使用注册模块来减少标注负担,从而利用未标注数据来生成新的数据。在整个训练过程中,生成器和判别器相互对抗,以提高生成器的性能和生成数据的质量。
二、代码实现
1.准备工作
导入所需要的包,设置随机种子。
import random
import matplotlib.animation as animation
import matplotlib.pyplot as plt
import numpy as np
import torch.nn as nn
import torch.optim as optim
import torch.utils.data
import torchvision.datasets as dset
import torchvision.transforms as transforms
import torchvision.utils as vutils
from IPython.display import HTML
import os
os.environ["KMP_DUPLICATE_LIB_OK"]="TRUE"
if __name__ == '__main__':
    manualSeed = 999  # 随机种子
    print("Random Seed: ", manualSeed)
    random.seed(manualSeed)
    torch.manual_seed(manualSeed)
    torch.use_deterministic_algorithms(True)  # Needed for reproducible results
2.设置超参数
    dataroot = "E:/BaiduNetdiskDownload/GAN-Data/"  # 数据路径
    batch_size = 128  # 训练过程中的批次大小
    image_size = 64  # 图像的尺寸(宽度和高度)
    nz = 100  # z潜在向量的大小(生成器输入的尺寸)
    ngf = 64  # 生成器中的特征图大小
    ndf = 64  # 判别器中的特征图大小
    num_epochs = 50  # 训练的总轮数
    lr = 0.0002  # 学习率
    beta1 = 0.5
3.导入数据
    dataset = dset.ImageFolder(root=dataroot,
                               transform=transforms.Compose([
                                   transforms.Resize(image_size),  # 调整图像大小
                                   transforms.CenterCrop(image_size),  # 中心裁剪图像
                                   transforms.ToTensor(),  # 将图像转换为张量
                                   transforms.Normalize((0.5, 0.5, 0.5),  # 标准化图像张量
                                                        (0.5, 0.5, 0.5)),
                               ]))

# 创建数据加载器
    dataloader = torch.utils.data.DataLoader(dataset,
                                             batch_size=batch_size,  # 批量大小
                                             shuffle=True,  # 是否打乱数据集
                                             num_workers=5  # 使用多个线程加载数据的工作进程数
                                             )

    # 选择要在哪个设备上运行代码
    device = torch.device("cuda:0" if (torch.cuda.is_available()) else "cpu")
    print("使用的设备是:", device)

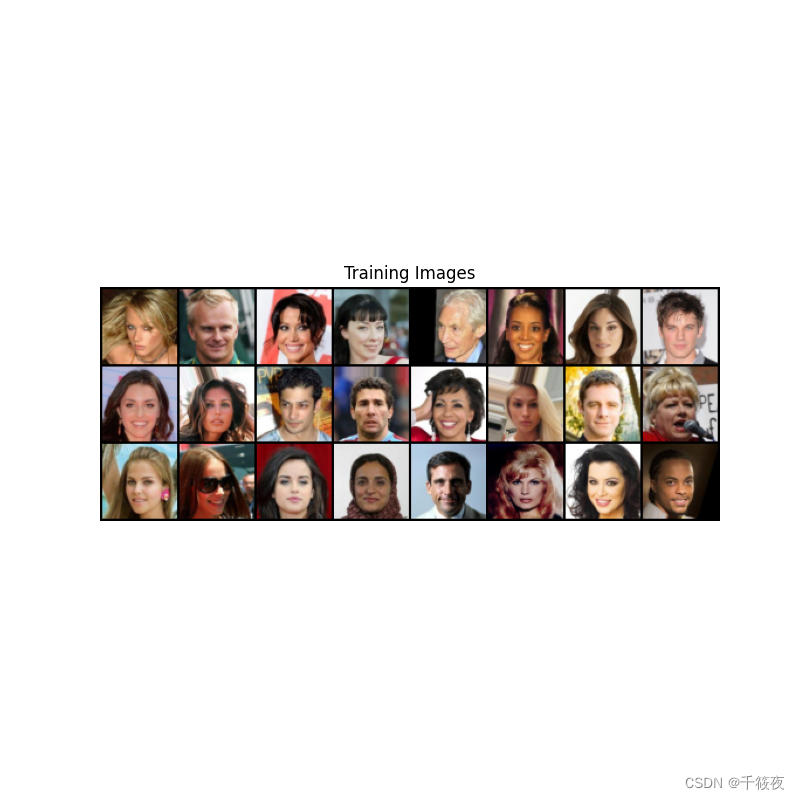
    # 绘制一些训练图像
    real_batch = next(iter(dataloader))
    plt.figure(figsize=(8, 8))
    plt.axis("off")
    plt.title("Training Images")
    plt.imshow(np.transpose(vutils.make_grid(real_batch[0].to(device)[:24],
                                             padding=2,
                                             normalize=True).cpu(), (1, 2, 0)))

    plt.savefig('Training Images.png')
使用的设备是: cpu
4.初始化权重
    def weights_init(m):
        # 获取当前层的类名
        classname = m.__class__.__name__
        # 如果类名中包含'Conv',即当前层是卷积层
        if classname.find('Conv') != -1:
            # 使用正态分布初始化权重数据,均值为0,标准差为0.02
            nn.init.normal_(m.weight.data, 0.0, 0.02)
        # 如果类名中包含'BatchNorm',即当前层是批归一化层
        elif classname.find('BatchNorm') != -1:
            # 使用正态分布初始化权重数据,均值为1,标准差为0.02
            nn.init.normal_(m.weight.data, 1.0, 0.02)
            # 使用常数初始化偏置项数据,值为0
            nn.init.constant_(m.bias.data, 0)
5.定义生成器
定义一个生成器并打印出其大致结构。
    class Generator(nn.Module):
        def __init__(self):
            super(Generator, self).__init__()
            self.main = nn.Sequential(
                # 输入为Z,经过一个转置卷积层
                nn.ConvTranspose2d(nz, ngf * 8, 4, 1, 0, bias=False),
                nn.BatchNorm2d(ngf * 8),  # 批归一化层,用于加速收敛和稳定训练过程
                nn.ReLU(True),  # ReLU激活函数
                # 输出尺寸:(ngf*8) x 4 x 4
                nn.ConvTranspose2d(ngf * 8, ngf * 4, 4, 2, 1, bias=False),
                nn.BatchNorm2d(ngf * 4),
                nn.ReLU(True),
                # 输出尺寸:(ngf*4) x 8 x 8
                nn.ConvTranspose2d(ngf * 4, ngf * 2, 4, 2, 1, bias=False),
                nn.BatchNorm2d(ngf * 2),
                nn.ReLU(True),
                # 输出尺寸:(ngf*2) x 16 x 16
                nn.ConvTranspose2d(ngf * 2, ngf, 4, 2, 1, bias=False),
                nn.BatchNorm2d(ngf),
                nn.ReLU(True),
                # 输出尺寸:(ngf) x 32 x 32
                nn.ConvTranspose2d(ngf, 3, 4, 2, 1, bias=False),
                nn.Tanh()  # Tanh激活函数
                # 输出尺寸:3 x 64 x 64
            )

        def forward(self, input):
            return self.main(input)


    # 创建生成器
    netG = Generator().to(device)
    # 使用 "weights_init" 函数对所有权重进行随机初始化,
    # 平均值(mean)设置为0,标准差(stdev)设置为0.02。
    netG.apply(weights_init)
    # 打印生成器模型
    print(netG)
Generator(
(main): Sequential(
(0): ConvTranspose2d(100, 512, kernel_size=(4, 4), stride=(1, 1), bias=False)
(1): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
(2): ReLU(inplace=True)
(3): ConvTranspose2d(512, 256, kernel_size=(4, 4), stride=(2, 2), padding=(1, 1), bias=False)
(4): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
(5): ReLU(inplace=True)
(6): ConvTranspose2d(256, 128, kernel_size=(4, 4), stride=(2, 2), padding=(1, 1), bias=False)
(7): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
(8): ReLU(inplace=True)
(9): ConvTranspose2d(128, 64, kernel_size=(4, 4), stride=(2, 2), padding=(1, 1), bias=False)
(10): BatchNorm2d(64, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
(11): ReLU(inplace=True)
(12): ConvTranspose2d(64, 3, kernel_size=(4, 4), stride=(2, 2), padding=(1, 1), bias=False)
(13): Tanh()
)
)
6.定义判别器
定义一个判别器并打印出其大致结构。
    class Discriminator(nn.Module):
        def __init__(self):
            super(Discriminator, self).__init__()

            # 定义判别器的主要结构,使用Sequential容器将多个层按顺序组合在一起
            self.main = nn.Sequential(
                # 输入大小为3 x 64 x 64
                nn.Conv2d(3, ndf, 4, 2, 1, bias=False),
                nn.LeakyReLU(0.2, inplace=True),
                # 输出大小为(ndf) x 32 x 32
                nn.Conv2d(ndf, ndf * 2, 4, 2, 1, bias=False),
                nn.BatchNorm2d(ndf * 2),
                nn.LeakyReLU(0.2, inplace=True),
                # 输出大小为(ndf*2) x 16 x 16
                nn.Conv2d(ndf * 2, ndf * 4, 4, 2, 1, bias=False),
                nn.BatchNorm2d(ndf * 4),
                nn.LeakyReLU(0.2, inplace=True),
                # 输出大小为(ndf*4) x 8 x 8
                nn.Conv2d(ndf * 4, ndf * 8, 4, 2, 1, bias=False),
                nn.BatchNorm2d(ndf * 8),
                nn.LeakyReLU(0.2, inplace=True),
                # 输出大小为(ndf*8) x 4 x 4
                nn.Conv2d(ndf * 8, 1, 4, 1, 0, bias=False),
                nn.Sigmoid()
            )

        def forward(self, input):
            # 将输入通过判别器的主要结构进行前向传播
            return self.main(input)


    # 创建判别器模型
    netD = Discriminator().to(device)

    # 应用 "weights_init" 函数来随机初始化所有权重
    # 使用 mean=0, stdev=0.2 的方式进行初始化
    netD.apply(weights_init)

    # 打印模型
    print(netD)
Discriminator(
(main): Sequential(
(0): Conv2d(3, 64, kernel_size=(4, 4), stride=(2, 2), padding=(1, 1), bias=False)
(1): LeakyReLU(negative_slope=0.2, inplace=True)
(2): Conv2d(64, 128, kernel_size=(4, 4), stride=(2, 2), padding=(1, 1), bias=False)
(3): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
(4): LeakyReLU(negative_slope=0.2, inplace=True)
(5): Conv2d(128, 256, kernel_size=(4, 4), stride=(2, 2), padding=(1, 1), bias=False)
(6): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
(7): LeakyReLU(negative_slope=0.2, inplace=True)
(8): Conv2d(256, 512, kernel_size=(4, 4), stride=(2, 2), padding=(1, 1), bias=False)
(9): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
(10): LeakyReLU(negative_slope=0.2, inplace=True)
(11): Conv2d(512, 1, kernel_size=(4, 4), stride=(1, 1), bias=False)
(12): Sigmoid()
)
)
7.训练模型
    # 初始化“BCELoss”损失函数
    criterion = nn.BCELoss()

    # 创建用于可视化生成器进程的潜在向量批次
    fixed_noise = torch.randn(64, nz, 1, 1, device=device)

    real_label = 1.
    fake_label = 0.

    # 为生成器(G)和判别器(D)设置Adam优化器
    optimizerD = optim.Adam(netD.parameters(), lr=lr, betas=(beta1, 0.999))
    optimizerG = optim.Adam(netG.parameters(), lr=lr, betas=(beta1, 0.999))
    img_list = []  # 用于存储生成的图像列表
    G_losses = []  # 用于存储生成器的损失列表
    D_losses = []  # 用于存储判别器的损失列表
    iters = 0  # 迭代次数

    print("Starting Training Loop...")  # 输出训练开始的提示信息
    # 对于每个epoch(训练周期)
    for epoch in range(num_epochs):
        # 对于dataloader中的每个batch
        for i, data in enumerate(dataloader, 0):

            ############################
            # (1) 更新判别器网络:最大化 log(D(x)) + log(1 - D(G(z)))
            ###########################
            ## 使用真实图像样本训练
            netD.zero_grad()  # 清除判别器网络的梯度
            # 准备真实图像的数据
            real_cpu = data[0].to(device)
            b_size = real_cpu.size(0)
            label = torch.full((b_size,), real_label, dtype=torch.float, device=device)  # 创建一个全是真实标签的张量
            # 将真实图像样本输入判别器,进行前向传播
            output = netD(real_cpu).view(-1)
            # 计算真实图像样本的损失
            errD_real = criterion(output, label)
            # 通过反向传播计算判别器的梯度
            errD_real.backward()
            D_x = output.mean().item()  # 计算判别器对真实图像样本的输出的平均值

            ## 使用生成图像样本训练
            # 生成一批潜在向量
            noise = torch.randn(b_size, nz, 1, 1, device=device)
            # 使用生成器生成一批假图像样本
            fake = netG(noise)
            label.fill_(fake_label)  # 创建一个全是假标签的张量
            # 将所有生成的图像样本输入判别器,进行前向传播
            output = netD(fake.detach()).view(-1)
            # 计算判别器对生成图像样本的损失
            errD_fake = criterion(output, label)
            # 通过反向传播计算判别器的梯度
            errD_fake.backward()
            D_G_z1 = output.mean().item()  # 计算判别器对生成图像样本的输出的平均值
            # 计算判别器的总损失,包括真实图像样本和生成图像样本的损失之和
            errD = errD_real + errD_fake
            # 更新判别器的参数
            optimizerD.step()

            ############################
            # (2) 更新生成器网络:最大化 log(D(G(z)))
            ###########################
            netG.zero_grad()  # 清除生成器网络的梯度
            label.fill_(real_label)  # 对于生成器成本而言,将假标签视为真实标签
            # 由于刚刚更新了判别器,再次将所有生成的图像样本输入判别器,进行前向传播
            output = netD(fake).view(-1)
            # 根据判别器的输出计算生成器的损失
            errG = criterion(output, label)
            # 通过反向传播计算生成器的梯度
            errG.backward()
            D_G_z2 = output.mean().item()  # 计算判别器对生成器输出的平均值
            # 更新生成器的参数
            optimizerG.step()

            # 输出训练统计信息
            if i % 400 == 0:
                print('[%d/%d][%d/%d]\tLoss_D: %.4f\tLoss_G: %.4f\tD(x): %.4f\tD(G(z)): %.4f / %.4f'
                      % (epoch, num_epochs, i, len(dataloader),
                         errD.item(), errG.item(), D_x, D_G_z1, D_G_z2))

            # 保存损失值以便后续绘图
            G_losses.append(errG.item())
            D_losses.append(errD.item())

            # 通过保存生成器在固定噪声上的输出来检查生成器的性能
            if (iters % 500 == 0) or ((epoch == num_epochs - 1) and (i == len(dataloader) - 1)):
                with torch.no_grad():
                    fake = netG(fixed_noise).detach().cpu()
                img_list.append(vutils.make_grid(fake, padding=2, normalize=True))

            iters += 1
这是实现一个简单的生成对抗网络(GAN)的训练过程。其中,判别器网络(netD)用于区分真实图像和生成图像,生成器网络(netG)用于生成新的图像。
首先,初始化了BCELoss损失函数,用于计算生成图像和真实图像的损失。接着,创建了一个潜在向量批次,用于可视化生成器的过程。然后,为生成器和判别器网络分别设置了Adam优化器,并初始化了损失列表和迭代次数。
接下来,进入训练循环,遍历数据加载器中的每个batch,分别进行判别器和生成器网络的训练。在判别器网络的训练中,使用真实图像训练判别器,计算判别器对真实图像的输出和损失,然后使用生成图像训练判别器,计算判别器对生成图像的输出和损失,最后将两者相加作为判别器网络的总损失。在生成器网络的训练中,使用判别器对生成图像的输出作为生成器网络的损失,通过反向传播更新生成器网络的参数。
在训练过程中,输出每个epoch的训练信息,包括判别器和生成器网络的损失以及判别器对真实图像和生成图像的输出平均值。同时,将生成器生成的图像保存到列表中,用于后续的可视化展示。
最后,随着迭代次数的增加,生成器网络的性能将不断提高,生成更加逼真的图像。
Starting Training Loop...
[0/50][0/36]	Loss_D: 1.7236	Loss_G: 5.1258	D(x): 0.5475	D(G(z)): 0.5840 / 0.0090
[1/50][0/36]	Loss_D: 0.2727	Loss_G: 10.0453	D(x): 0.9222	D(G(z)): 0.0001 / 0.0001
[2/50][0/36]	Loss_D: 0.2047	Loss_G: 11.1354	D(x): 0.9369	D(G(z)): 0.0954 / 0.0000
[3/50][0/36]	Loss_D: 1.0191	Loss_G: 6.3516	D(x): 0.6335	D(G(z)): 0.0012 / 0.0032
[4/50][0/36]	Loss_D: 0.6455	Loss_G: 7.9129	D(x): 0.9408	D(G(z)): 0.3743 / 0.0007
[5/50][0/36]	Loss_D: 0.8784	Loss_G: 8.2851	D(x): 0.9588	D(G(z)): 0.5024 / 0.0009
[6/50][0/36]	Loss_D: 1.7352	Loss_G: 13.7037	D(x): 0.9258	D(G(z)): 0.7441 / 0.0000
[7/50][0/36]	Loss_D: 0.3146	Loss_G: 4.6222	D(x): 0.8500	D(G(z)): 0.1087 / 0.0163
[8/50][0/36]	Loss_D: 0.4356	Loss_G: 4.0605	D(x): 0.8139	D(G(z)): 0.1473 / 0.0379
[9/50][0/36]	Loss_D: 0.6937	Loss_G: 2.8857	D(x): 0.6305	D(G(z)): 0.0251 / 0.1055
[10/50][0/36]	Loss_D: 0.4543	Loss_G: 4.4942	D(x): 0.8504	D(G(z)): 0.1943 / 0.0207
[11/50][0/36]	Loss_D: 0.6612	Loss_G: 7.7339	D(x): 0.9775	D(G(z)): 0.4189 / 0.0015
[12/50][0/36]	Loss_D: 0.5304	Loss_G: 5.7835	D(x): 0.9047	D(G(z)): 0.2898 / 0.0064
[13/50][0/36]	Loss_D: 0.5531	Loss_G: 7.5164	D(x): 0.9247	D(G(z)): 0.3266 / 0.0015
[14/50][0/36]	Loss_D: 0.3780	Loss_G: 4.9682	D(x): 0.8639	D(G(z)): 0.1539 / 0.0171
[15/50][0/36]	Loss_D: 0.4308	Loss_G: 4.8421	D(x): 0.8632	D(G(z)): 0.1891 / 0.0189
[16/50][0/36]	Loss_D: 0.5516	Loss_G: 6.8741	D(x): 0.9396	D(G(z)): 0.3086 / 0.0039
[17/50][0/36]	Loss_D: 0.5645	Loss_G: 4.4474	D(x): 0.6822	D(G(z)): 0.0409 / 0.0209
[18/50][0/36]	Loss_D: 0.4839	Loss_G: 3.6506	D(x): 0.7161	D(G(z)): 0.0395 / 0.0435
[19/50][0/36]	Loss_D: 0.3065	Loss_G: 5.2946	D(x): 0.9135	D(G(z)): 0.1709 / 0.0090
[20/50][0/36]	Loss_D: 0.3299	Loss_G: 3.6037	D(x): 0.8491	D(G(z)): 0.1151 / 0.0510
[21/50][0/36]	Loss_D: 0.9225	Loss_G: 2.7761	D(x): 0.5607	D(G(z)): 0.0338 / 0.1204
[22/50][0/36]	Loss_D: 0.3726	Loss_G: 4.8651	D(x): 0.8025	D(G(z)): 0.0769 / 0.0155
[23/50][0/36]	Loss_D: 0.3243	Loss_G: 5.8202	D(x): 0.7774	D(G(z)): 0.0051 / 0.0086
[24/50][0/36]	Loss_D: 0.2820	Loss_G: 6.9593	D(x): 0.8169	D(G(z)): 0.0161 / 0.0032
[25/50][0/36]	Loss_D: 0.8385	Loss_G: 11.0001	D(x): 0.9827	D(G(z)): 0.4938 / 0.0001
[26/50][0/36]	Loss_D: 0.3285	Loss_G: 5.3620	D(x): 0.8837	D(G(z)): 0.1548 / 0.0104
[27/50][0/36]	Loss_D: 1.0739	Loss_G: 8.7123	D(x): 0.9688	D(G(z)): 0.5622 / 0.0004
[28/50][0/36]	Loss_D: 0.5679	Loss_G: 5.1443	D(x): 0.8872	D(G(z)): 0.3025 / 0.0122
[29/50][0/36]	Loss_D: 1.8987	Loss_G: 8.7121	D(x): 0.9835	D(G(z)): 0.7635 / 0.0008
[30/50][0/36]	Loss_D: 0.3972	Loss_G: 5.3464	D(x): 0.9158	D(G(z)): 0.2161 / 0.0118
[31/50][0/36]	Loss_D: 0.6148	Loss_G: 4.9903	D(x): 0.6376	D(G(z)): 0.0140 / 0.0178
[32/50][0/36]	Loss_D: 0.5711	Loss_G: 4.6825	D(x): 0.8854	D(G(z)): 0.2983 / 0.0223
[33/50][0/36]	Loss_D: 0.8238	Loss_G: 4.1475	D(x): 0.5834	D(G(z)): 0.0090 / 0.0432
[34/50][0/36]	Loss_D: 0.7058	Loss_G: 2.6347	D(x): 0.5796	D(G(z)): 0.0176 / 0.1592
[35/50][0/36]	Loss_D: 0.3821	Loss_G: 4.4072	D(x): 0.8689	D(G(z)): 0.1733 / 0.0245
[36/50][0/36]	Loss_D: 0.8212	Loss_G: 3.2263	D(x): 0.5537	D(G(z)): 0.0269 / 0.0850
[37/50][0/36]	Loss_D: 0.9308	Loss_G: 7.3649	D(x): 0.9653	D(G(z)): 0.5092 / 0.0015
[38/50][0/36]	Loss_D: 0.3650	Loss_G: 4.5917	D(x): 0.9127	D(G(z)): 0.2059 / 0.0165
[39/50][0/36]	Loss_D: 0.4754	Loss_G: 5.4462	D(x): 0.9304	D(G(z)): 0.2779 / 0.0087
[40/50][0/36]	Loss_D: 0.8538	Loss_G: 7.1382	D(x): 0.9321	D(G(z)): 0.4363 / 0.0030
[41/50][0/36]	Loss_D: 0.4473	Loss_G: 4.8317	D(x): 0.8863	D(G(z)): 0.2361 / 0.0131
[42/50][0/36]	Loss_D: 1.3782	Loss_G: 0.3150	D(x): 0.3676	D(G(z)): 0.0194 / 0.7907
[43/50][0/36]	Loss_D: 0.3925	Loss_G: 4.2696	D(x): 0.8710	D(G(z)): 0.1981 / 0.0203
[44/50][0/36]	Loss_D: 0.3010	Loss_G: 3.9853	D(x): 0.8345	D(G(z)): 0.0874 / 0.0329
[45/50][0/36]	Loss_D: 0.4296	Loss_G: 6.1424	D(x): 0.9337	D(G(z)): 0.2695 / 0.0044
[46/50][0/36]	Loss_D: 0.5169	Loss_G: 5.4765	D(x): 0.8657	D(G(z)): 0.2641 / 0.0076
[47/50][0/36]	Loss_D: 0.5386	Loss_G: 5.0609	D(x): 0.8840	D(G(z)): 0.2875 / 0.0131
[48/50][0/36]	Loss_D: 0.3725	Loss_G: 4.1678	D(x): 0.8581	D(G(z)): 0.1668 / 0.0239
[49/50][0/36]	Loss_D: 0.1859	Loss_G: 3.8704	D(x): 0.8976	D(G(z)): 0.0593 / 0.0340

进程已结束,退出代码为 0
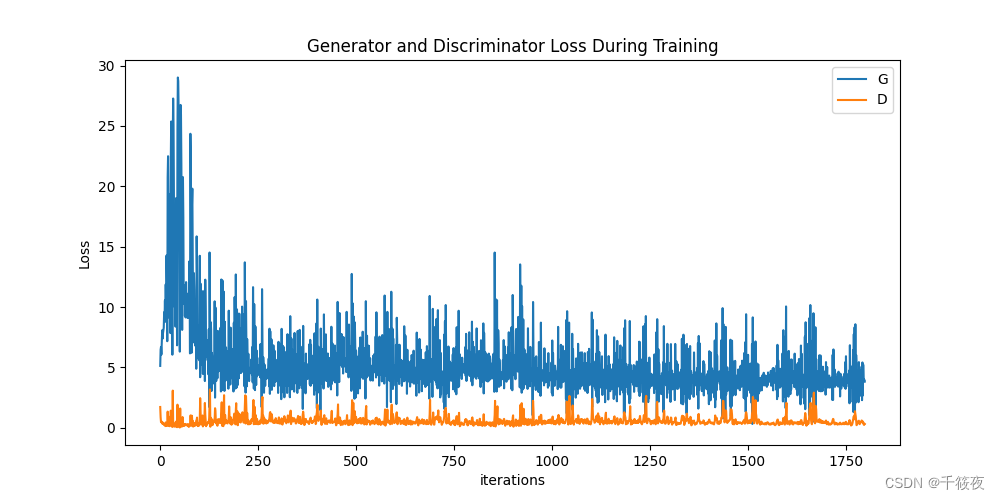
8.可视化
    plt.figure(figsize=(10, 5))
    plt.title("Generator and Discriminator Loss During Training")
    plt.plot(G_losses, label="G")
    plt.plot(D_losses, label="D")
    plt.xlabel("iterations")
    plt.ylabel("Loss")
    plt.legend()
    plt.savefig('Generator and Discriminator Loss During Training.png')
    plt.show()
    # 创建一个大小为8x8的图形对象
    fig = plt.figure(figsize=(8, 8))

    # 不显示坐标轴
    plt.axis("off")

    # 将图像列表img_list中的图像转置并创建一个包含每个图像的单个列表ims
    ims = [[plt.imshow(np.transpose(i, (1, 2, 0)), animated=True)] for i in img_list]

    # 使用图形对象、图像列表ims以及其他参数创建一个动画对象ani
    ani = animation.ArtistAnimation(fig, ims, interval=1000, repeat_delay=1000, blit=True)

    # 将动画以HTML形式呈现
    HTML(ani.to_jshtml())
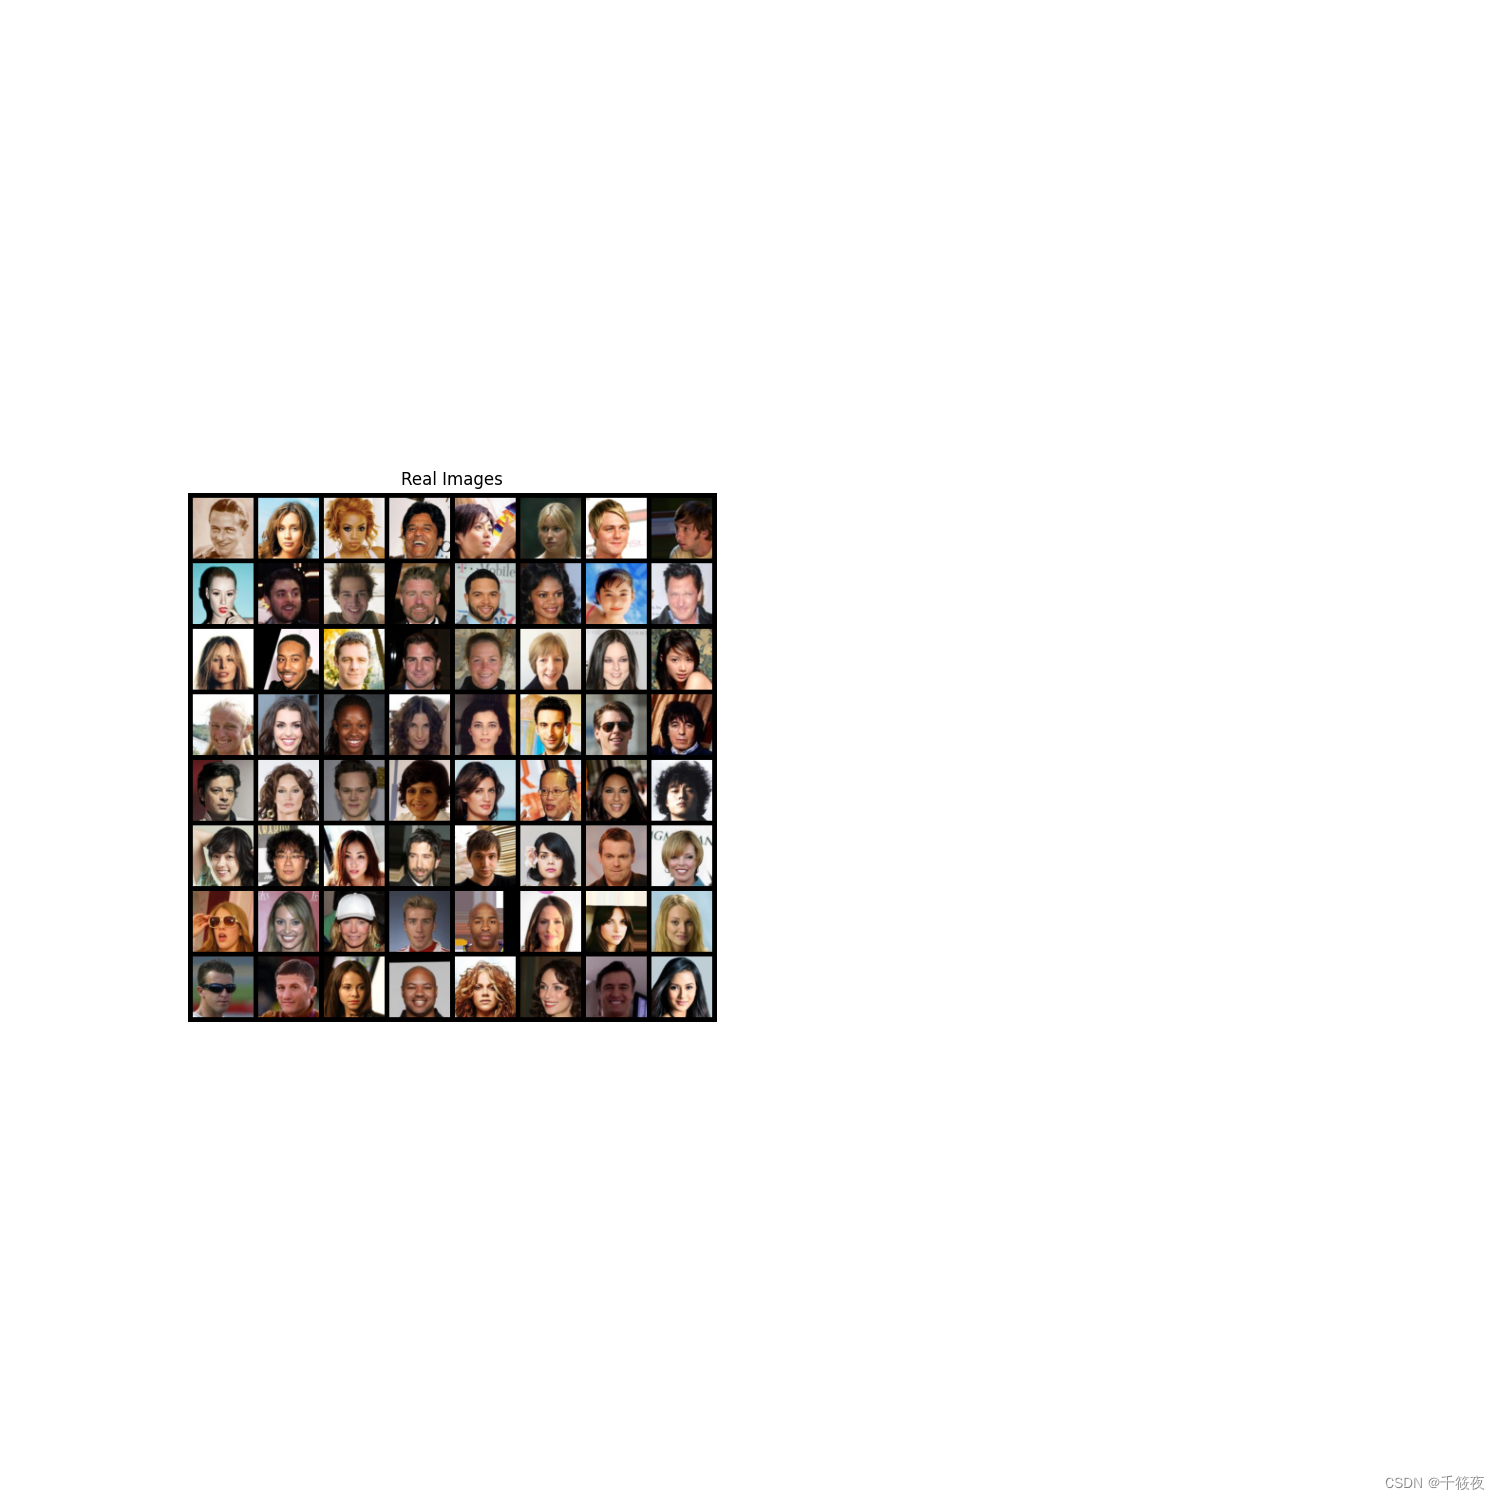
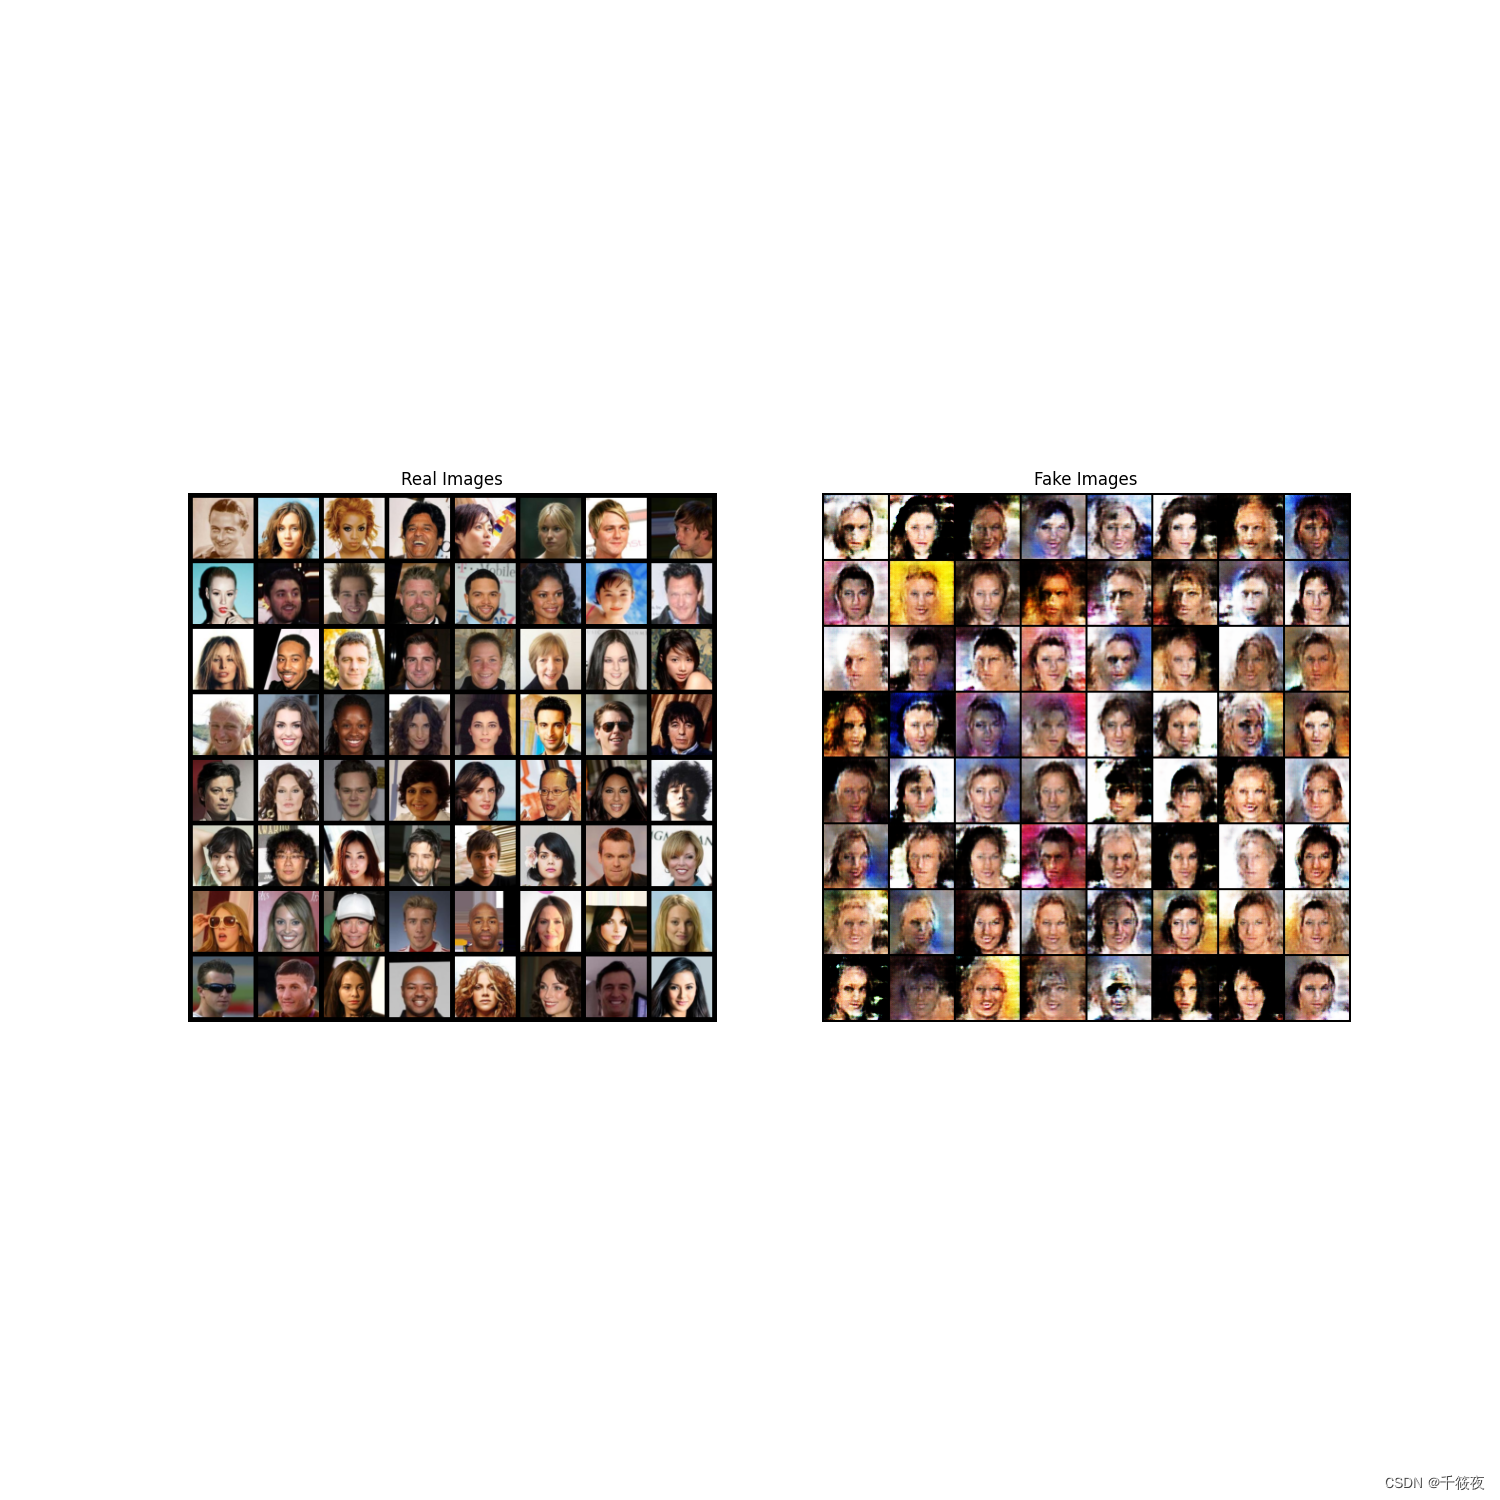
    # 从数据加载器中获取一批真实图像
    real_batch = next(iter(dataloader))

    # 绘制真实图像
    plt.figure(figsize=(15, 15))
    plt.subplot(1, 2, 1)
    plt.axis("off")
    plt.title("Real Images")
    plt.imshow(np.transpose(vutils.make_grid(real_batch[0].to(device)[:64], padding=5, normalize=True).cpu(), (1, 2, 0)))
    plt.savefig('Real Images.png')
    # 绘制上一个时期生成的假图像
    plt.subplot(1, 2, 2)
    plt.axis("off")
    plt.title("Fake Images")
    plt.imshow(np.transpose(img_list[-1], (1, 2, 0)))
    plt.savefig('Fake Images.png')
    plt.show()
可视化结果展示:

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 24
 0
- 0


 已为社区贡献1条内容

所有评论(0)