数学建模---预测模型---kmeans聚类分析
·
目录
聚类模型(Clustering):
- 目的:聚类是一种无监督学习方法,其目的是将数据点分组,使得同一组内的数据点彼此相似,而不同组的数据点尽可能不相似。
- 应用:聚类用于探索性数据分析,如市场细分、社交网络分析、基因数据分析等。
- 例子:K-均值(K-means),DBSCAN,层次聚类(Hierarchical Clustering)等。
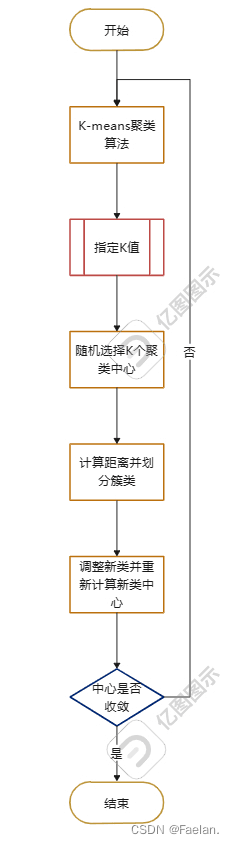
- 具体过程
-

缺点:
- 要求用户必须事先给出要生成的簇的数目k
- 对初值敏感,受单一值影响大
- 对于孤立点数据敏感
二、优化kmeans
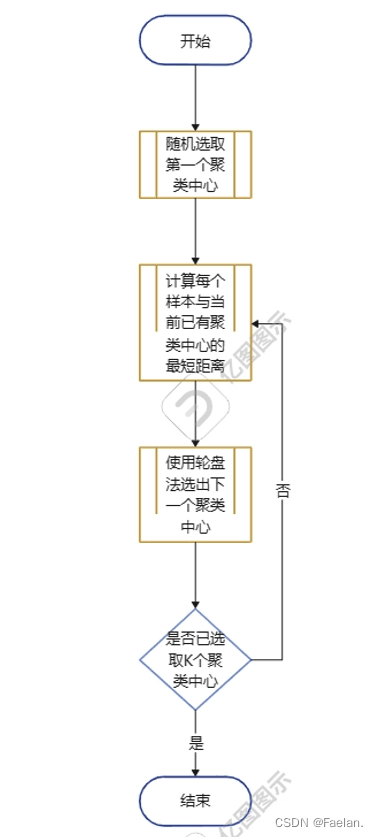
采用K-means++算法
中心原则:初始的聚类中心之间的相互距离要尽可能的远。
三、总结
当数模比赛中出现类似社区检测,图像处理,城市规划,风险管理等情境,使用kmeans聚类方法

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 5
 0
- 0


 已为社区贡献1条内容

所有评论(0)