基于k-means和谱聚类算法的数据分类matlab对比仿真
目录
数据分类是数据管理、数据挖掘和信息安全领域中的一项关键技术,它指的是根据数据的内在特性和业务需求,将大量、复杂的数据划分为多个有意义的类别或组别,以便于管理和处理。
1.K-means算法概述
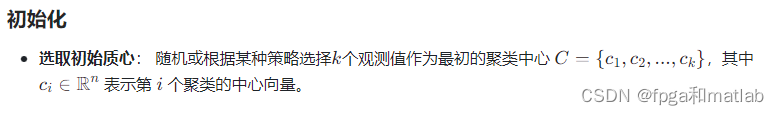
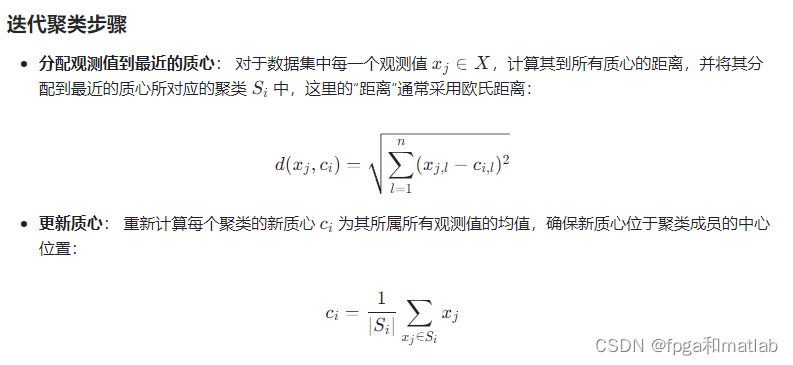
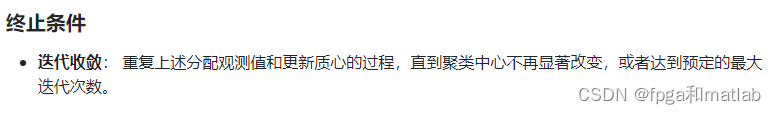
K-means算法是一种广泛应用的无监督机器学习聚类方法,旨在将数据集中的观测值分配到k个预定义的聚类中,使得每个聚类内的观测值彼此相似度尽可能大,而不同聚类间的相似度尽可能小。算法主要包括初始化、迭代聚类和终止条件三个主要阶段。
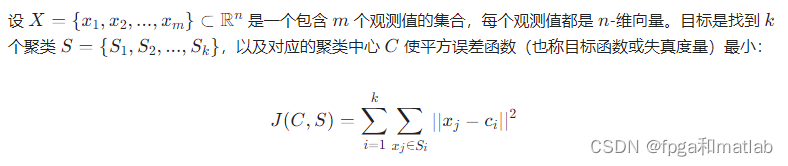
K-means算法通过迭代求解此优化问题,每次迭代都试图减小目标函数值,直至收敛。
综上所述,K-Means聚类算法的具体实现可以分为以下几个步骤:
初始化聚类中心点:随机选择K个数据点作为初始聚类中心点。
分配数据点到最近的聚类中心:计算每个数据点与K个聚类中心的距离,将其分配到距离最近的聚类中心所在的类别。
更新聚类中心点:计算每个类别的中心点,并更新聚类中心。
重复步骤2和3,直到聚类中心不再发生变化或达到最大迭代次数。
K-means算法存在一些局限性,如:
- 对初始质心敏感:不同的初始化可能导致不同的聚类结果。
- 假设簇形规则:算法假设数据分布呈现凸形状,对于复杂或不规则形状的聚类效果不佳。
- 必须预先指定聚类数目k,实际应用中可能难以确定最优的k 值。
- 使用欧氏距离作为相似性度量,不适用于具有不同尺度或非线性分布特征的数据。
data1=load('data1.mat');% 加载第一个数据集并提取变量 X
X=data1.X;

% 将原始数据转置
reshaped1=X';

% 对转置后的数据1执行 K-means 聚类,设置聚类数量为2,最大迭代次数为150,重复运行5次以提高稳定性
[idx1,C1]  = kmeans(reshaped1,4,'MaxIter',150,'replicates',5);

% 将 idx1 向量重新塑形回与原始数据相同的维度
idx1       = reshape(idx1,1,700);
测试结果如下:
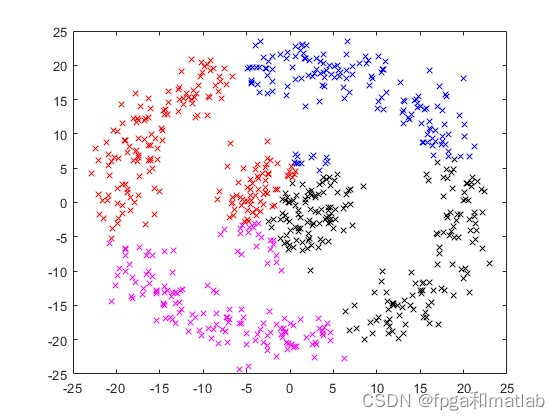
2.k-means谱聚类算法
谱聚类(Spectral Clustering)是一种基于图论和线性代数的聚类方法,尤其适用于发现数据集中的非凸形状聚类结构。谱聚类的核心思想是将聚类问题转化为图分割问题,然后通过图的拉普拉斯矩阵的特征分解来进行分析和聚类。
谱聚类算法将数据集中的每个对象看作是图的顶点V,将顶点间的相似度量化作为相应顶点连接边E的权值,这样就得到一个基于相似度的无向加权图G(V, E),于是聚类问题就可以转化为图的划分问题。基于图论的最优划分准则就是使划分成的子图内部相似度最大,子图之间的相似度最小。
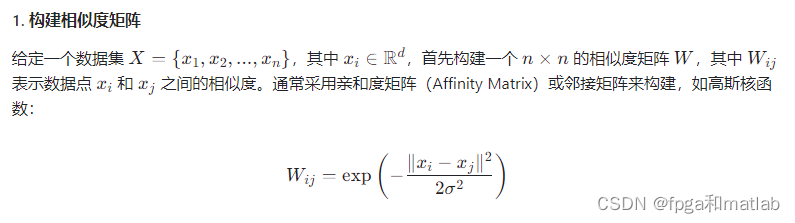
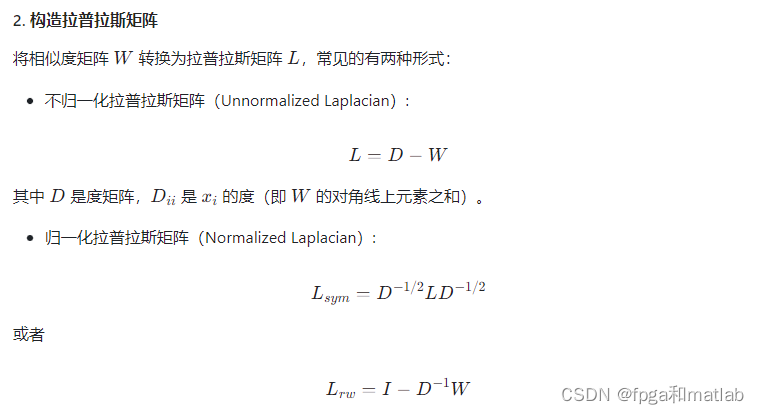
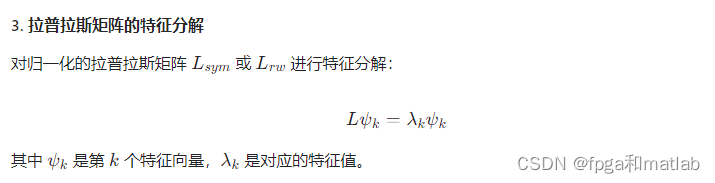
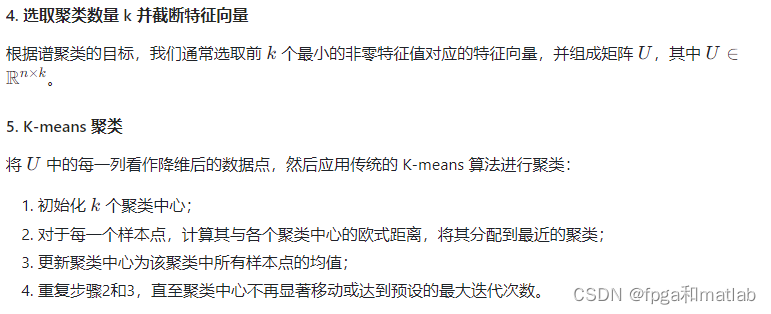 谱K-means聚类结合了谱聚类和K-means的优点,它首先通过谱聚类降维,然后再使用K-means算法进行聚类:

谱聚类的优势在于它能够捕捉到数据集中的全局结构,特别是对于非凸或者高度相连的数据分布,相比k-means这类依赖于原型或中心点的聚类方法,谱聚类更能揭示数据内在的拓扑结构和连通性。但是,谱聚类需要计算大型矩阵的特征分解,这在大数据集上可能会带来较高的计算成本。此外,正确选择聚类数量k 也是谱聚类中的一个重要挑战。
% 定义一个名为 specclustering 的函数,输入参数为数据矩阵 data,输出为两个聚类簇 cluster1 和 cluster2
function [cluster1,cluster2]=func_speccluster(data)
dim=size(data,2);% 获取数据矩阵的维度(列数)
W=zeros(dim); % 初始化相似度矩阵 W,大小为 dim x dim
% 计算每一对特征向量之间的相似度,并填充到 W 矩阵中
for i=1:dim
   for j=1:dim
        % 使用高斯核函数计算相似度,指数衰减因子为 0.1
        W(i,j)=exp(-(norm(data(:,i)-data(:,j))^2)*0.1);
   end
end

 %初始化度矩阵 D,大小也为 dim x dim
D=zeros(dim);
for i=1:dim % 计算每个节点的度(邻居节点相似度之和)
    sum=0;
    for j=1:dim
        sum=sum+W(i,j);
    end
    D(i,i)=sum;
end
L=D-W; % 计算拉普拉斯矩阵 L = D - W
K=0;
for i=1:dim% 计算拉普拉斯矩阵 L 的迹
    K=K+L(1,i);
end
% 计算归一化拉普拉斯矩阵 P
P=(D^-0.5)*L*(D^-0.5);
% 计算归一化拉普拉斯矩阵 P 的特征值和特征向量
[V,B]=eig(P);

% 对特征值按升序排序,并获取排序后的特征向量对应的列索引
[~, ind]=sort(diag(B),'ascend');
% 排序后的特征向量
V2=V(:,ind);
% 初始化两个聚类簇为空
cluster1=[];
cluster2=[];
for i=1:dim% 根据第二特征向量的正负性将特征向量分配到两个不同的聚类簇
    if(V2(i,2)<0)
          cluster1=[cluster1 data(:,i)];% 将特征向量添加到 cluster1
    else
          cluster2=[cluster2 data(:,i)]; % 将特征向量添加到 cluster2

    end

end

end
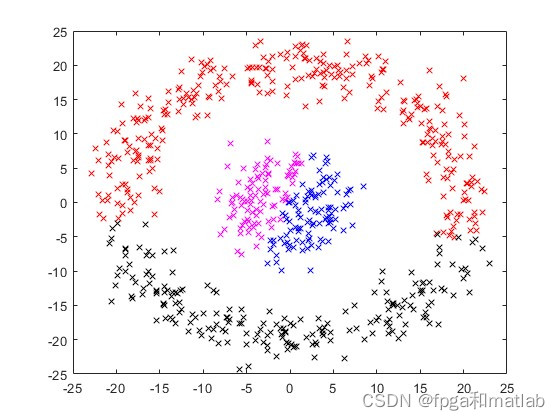
测试结果如下:

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 3
 0
- 0


 已为社区贡献175条内容

所有评论(0)