python--lxml.etree爬取html内容
·
转载自:悠悠博客园
前言
本篇继续lxml.etree学习,在线访问接口,通过接口返回的html,解析出想要的text文本内容
环境准备:
python 3.6
lxml
requets
定位目标
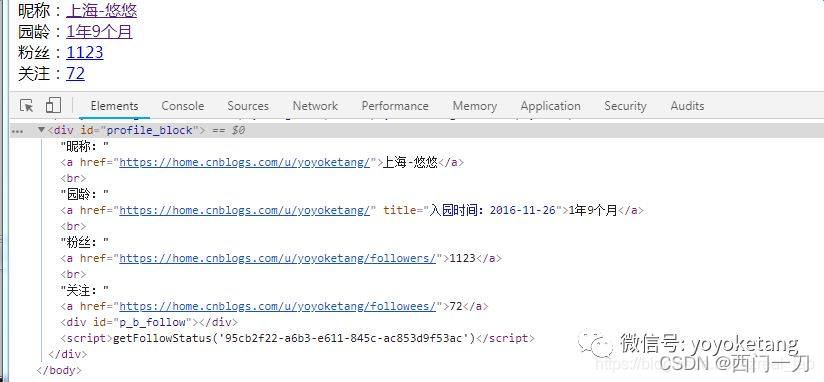
爬取我的博客首页https://www.cnblogs.com/yoyoketang/左侧栏个人基本信息
先f12抓包,找到该接口地址https://www.cnblogs.com/mvc/blog/news.aspx?blogApp=yoyoketang
# coding:utf-8
import requests
import urllib3
from lxml import etree
urllib3.disable_warnings()

url = "https://www.cnblogs.com/mvc/blog/news.aspx?blogApp=yoyoketang"
r = requests.get(url, verify=False)
# print(r.text)

dom = etree.HTML(r.content.decode("utf-8"))

block = dom.xpath("//*[@id='profile_block']")

# 打印提取到的结果
t = etree.tostring(block[0], encoding="utf-8", pretty_print=True)
print(t.decode("utf-8"))
运行结果
<div id="profile_block">昵称:
<a href="https://home.cnblogs.com/u/yoyoketang/">上海-悠悠</a><br/>园龄:
<a href="https://home.cnblogs.com/u/yoyoketang/" title="入园时间:2016-11-26">1年9个月</a><br/>粉丝:
<a href="https://home.cnblogs.com/u/yoyoketang/followers/">1123</a><br/>关注:
<a href="https://home.cnblogs.com/u/yoyoketang/followees/">72</a><div id="p_b_follow"/>
<script>getFollowStatus('95cb2f22-a6b3-e611-845c-ac853d9f53ac')</script></div>
提取内容
# coding:utf-8
import requests
import urllib3
from lxml import etree
urllib3.disable_warnings()

url = "https://www.cnblogs.com/mvc/blog/news.aspx?blogApp=yoyoketang"
r = requests.get(url, verify=False)
# print(r.text)

dom = etree.HTML(r.content.decode("utf-8"))

block = dom.xpath("//*[@id='profile_block']")

t1 = block[0].xpath('text()')    # 获取当前节点文本元素
print(t1)
t2 = block[0].xpath('a')    # 定位a标签

# 打印结果
for i, j in zip(t1, t2):
    print("%s%s" % (i, j.text))
运行结果
['昵称:', '园龄:', '粉丝:', '关注:']
昵称:上海-悠悠
园龄:1年9个月
粉丝:1123
关注:72
总结
- 获取当前节点标签名称.tag
print(block[0].tag)
运行结果
div
- 获取当前节点文本
print(block[0].text)
运行结果
昵称:
- 获取当前节点元素全部属性dict
print(block[0].attrib)
运行结果
{'id': 'profile_block'}
- 获取当前节点某个属性
print(block[0].get(“id”))
运行结果
profile_block
- 所有子节点
for i in block[0].iter():
   print(i.text)
运行结果
profile_block
昵称:
上海-悠悠
None
1年9个月
None
1123
None
72
None
getFollowStatus('95cb2f22-a6b3-e611-845c-ac853d9f53ac')
- 获取当前节点下全部文本
print(block[0].xpath(‘text()’))
运行结果
['昵称:', '园龄:', '粉丝:', '关注:']
- 获取本节点和子节点所有文本信息
print(block[0].xpath(‘.//text()’))
运行结果
['昵称:', '上海-悠悠', '园龄:', '1年9个月', '粉丝:', '1123',
'关注:', '72', "getFollowStatus('95cb2f22-a6b3-e611-845c-ac853d9f53ac')"]
- 获取父节点
print(block[0].getparent().tag)
运行结果
body

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)