CNN(卷积神经网络)
CNN 有2大特点:
- 能够有效的将大数据量的图片降维成小数据量
- 能够有效的保留图片特征,符合图片处理的原则
我们在大部分场景下,降维并不会影响结果。比如1000像素的图片缩小成200像素,并不影响肉眼认出来图片中是一只猫还是一只狗,机器也是如此。
灵感:模仿人类大脑的这个特点,构造多层的神经网络,较低层的识别初级的图像特征,若干底层特征组成更上一层特征,最终通过多个层级的组合,最终在顶层做出分类。
CNN的基本原理
典型的 CNN 由3个部分构成:
- 卷积层
- 负责提取图像中的局部特征
- 卷积层的通过卷积核的过滤提取出图片中局部的特征
- 池化层
- 用来大幅降低参数量级(降维),避免过拟合
- 原始图片是20×20的,我们对其进行下采样,采样窗口为10×10,最终将其下采样成为一个2×2大小的特征图。
- 全连接层
- 类似传统神经网络的部分,用来输出想要的结果
- 经过卷积层和池化层降维过的数据,全连接层才能”跑得动”,不然数据量太大,计算成本高,效率低下
- 典型的 CNN 并非只是上面提到的3层结构,而是多层结构,例如 LeNet-5 的结构:卷积层 – 池化层- 卷积层 – 池化层 – 卷积层 – 全连接层
各种各样的卷积
- 卷积与互相关
下图展示了卷积与互相关之间的差异。
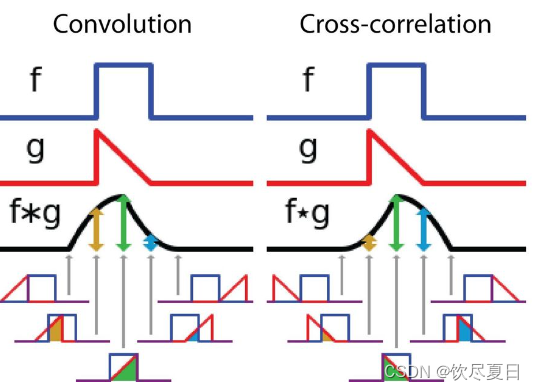
- 在卷积中,内核(kernel)在进行卷积操作时是经过翻转的。这意味着内核在进行卷积时是从右到左移动的。
在互相关中,内核在进行操作时保持不变,不进行翻转。 - 卷积操作通常用星号(*)表示,例如 f∗g。
互相关操作通常用圆圈(⊕)表示,例如 f⊕g。 - 在神经网络中,通常我们使用的是互相关而不是传统的卷积。这是因为在反向传播(backpropagation)过程中,互相关对梯度的计算更为高效。
- 从信号处理的角度来看,卷积表示的是两个信号之间的叠加。互相关表示的是两个信号之间的相似性。
-
3D卷积
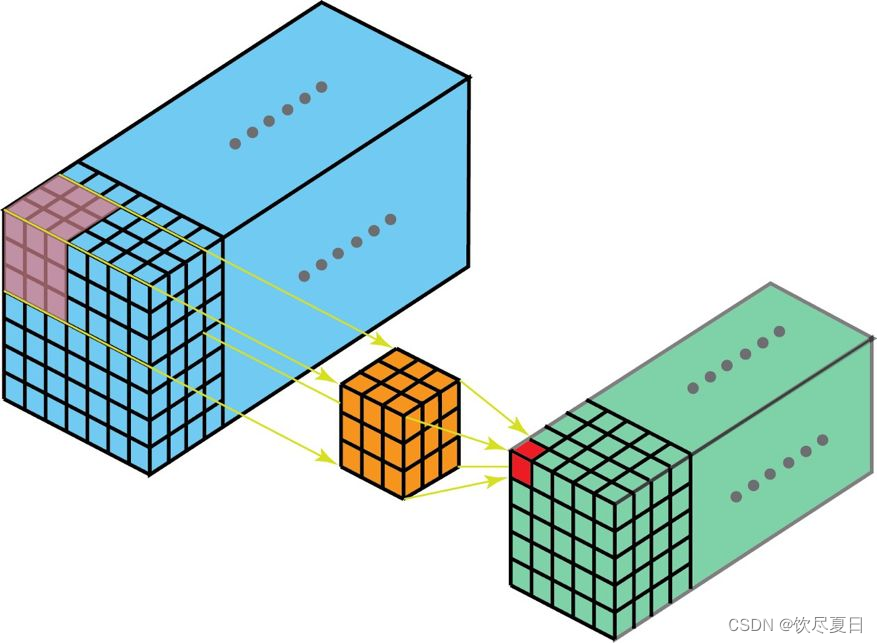
在3D卷积中,卷积核是一个立方体,它在三个维度上同时移动。每个维度上的滑动步幅、卷积核的大小以及使用的填充方式都是可以调整的超参数。 -
转置卷积
转置卷积,也称为反卷积(Transpose Convolution)或分数步长卷积(Fractionally-Strided Convolution),是一种用于上采样的卷积运算。它的主要目的是将输入的尺寸扩大,与传统的卷积相反,因此也被称为“反卷积”。
需要注意的是,尽管称为“反卷积”,转置卷积并不是卷积的逆操作。它更多地用于上采样和生成任务,而不是卷积的精确逆过程。
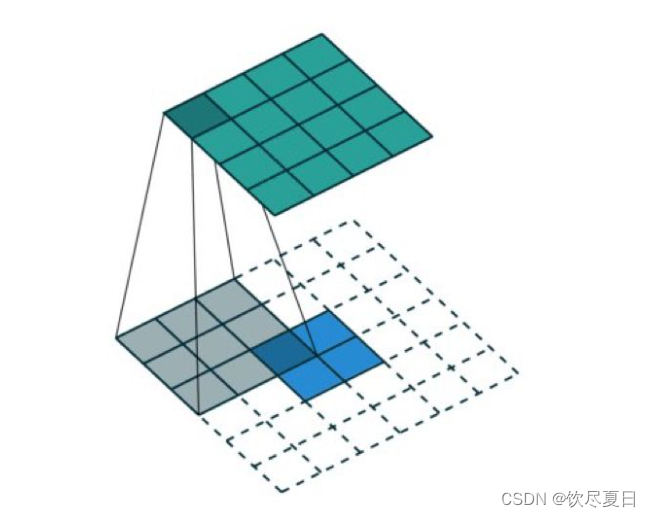
- 下图的例子,我们在一个 2×2 的输入(周围加了 2×2 的单位步长的零填充)上应用一个 3×3 核的转置卷积。上采样输出的大小是 4×4。
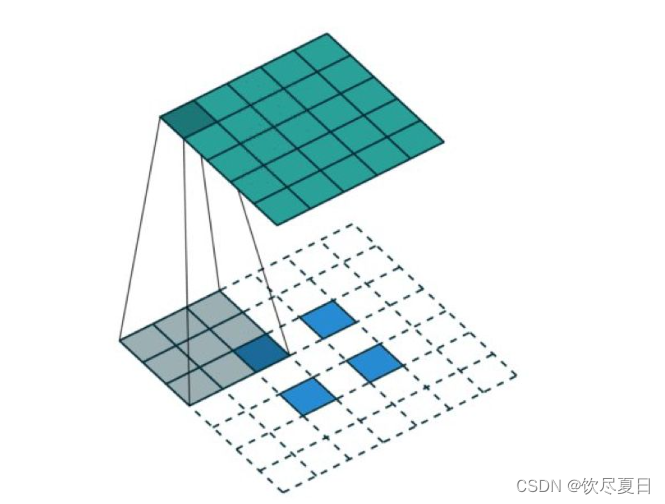
- 通过应用各种填充和步长,我们可以将同样的 2×2 输入图像映射到不同的图像尺寸。下面,转置卷积被用在了同一张 2×2 输入上(输入之间插入了一个零,并且周围加了 2×2 的单位步长的零填充),所得输出的大小是 5×5。
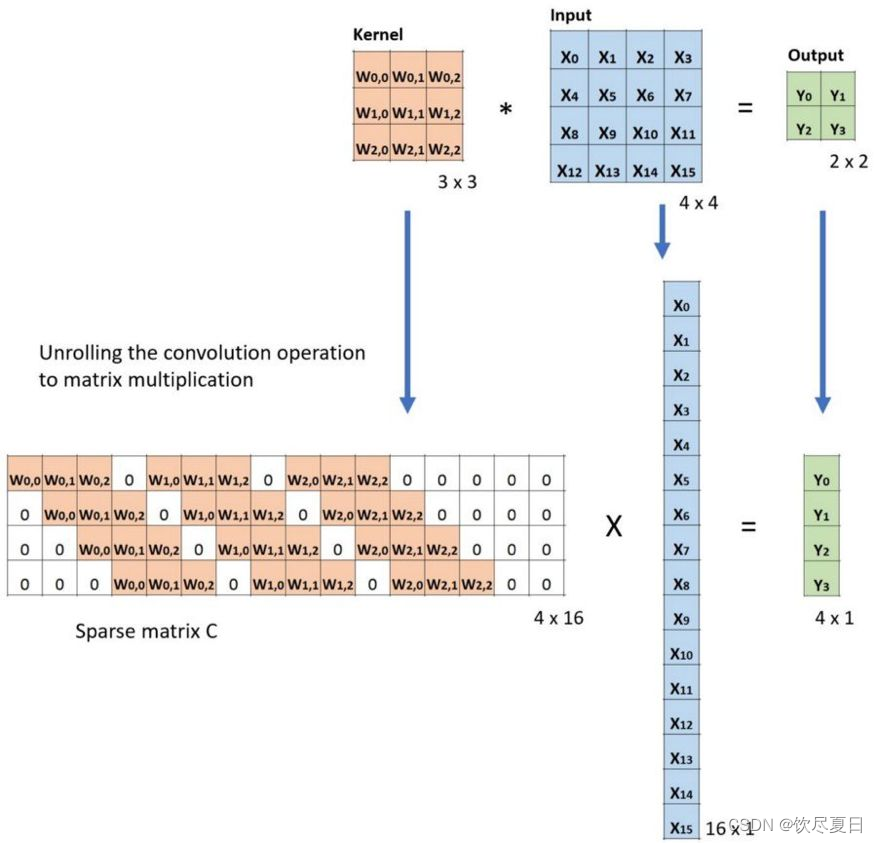
- 在卷积中,我们定义 C 为卷积核,Large 为输入图像,Small 为输出图像。经过卷积(矩阵乘法)后,我们将大图像下采样为小图像。这种矩阵乘法的卷积的实现遵照:C x Large = Small。
下面的例子展示了这种运算的工作方式。它将输入平展为 16×1 的矩阵,并将卷积核转换为一个稀疏矩阵(4×16)。然后,在稀疏矩阵和平展的输入之间使用矩阵乘法。之后,再将所得到的矩阵(4×1)转换为 2×2 的输出。
现在,如果我们在等式的两边都乘上矩阵的转置 CT,并借助「一个矩阵与其转置矩阵的乘法得到一个单位矩阵」这一性质,那么我们就能得到公式 CT x Small = Large,如下图所示。
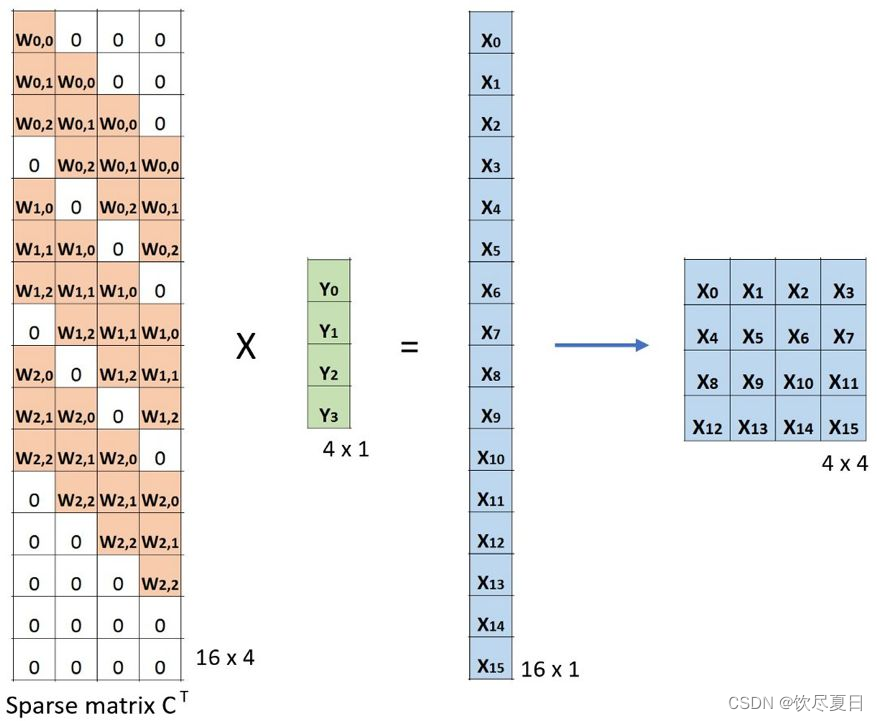
这里可以看到,我们执行了从小图像到大图像的上采样。
- 扩张卷积(Atrous卷积)
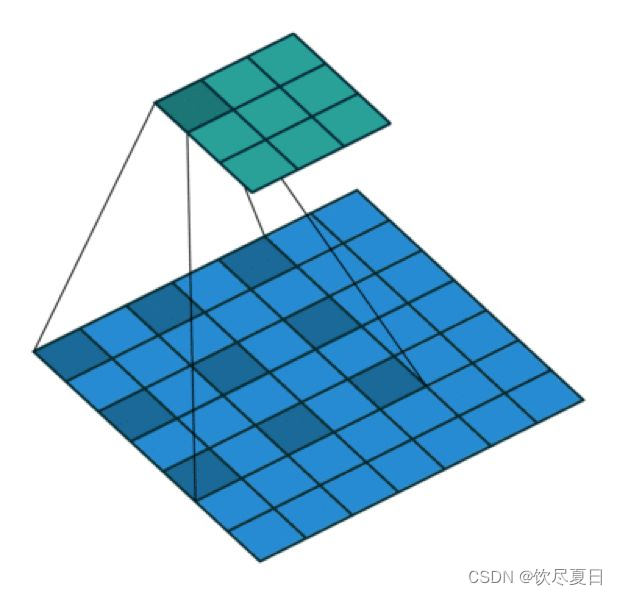
相比于传统的卷积,扩张卷积具有更大的感受野(receptive field),可以更好地捕捉输入数据中的全局信息。
在扩张卷积中,卷积核内的元素之间不再密集排列,而是通过在它们之间引入空洞来实现。这个空洞的大小由一个称为扩张率(dilation rate)的超参数控制。较大的扩张率导致更大的感受野,因此网络可以捕捉到更远处的关联信息。
扩张卷积就是通过在核元素之间插入空格来使核「膨胀」。新增的参数 l(扩张率)表示我们希望将核加宽的程度。具体实现可能各不相同,但通常是在核元素之间插入 l-1 个空格。
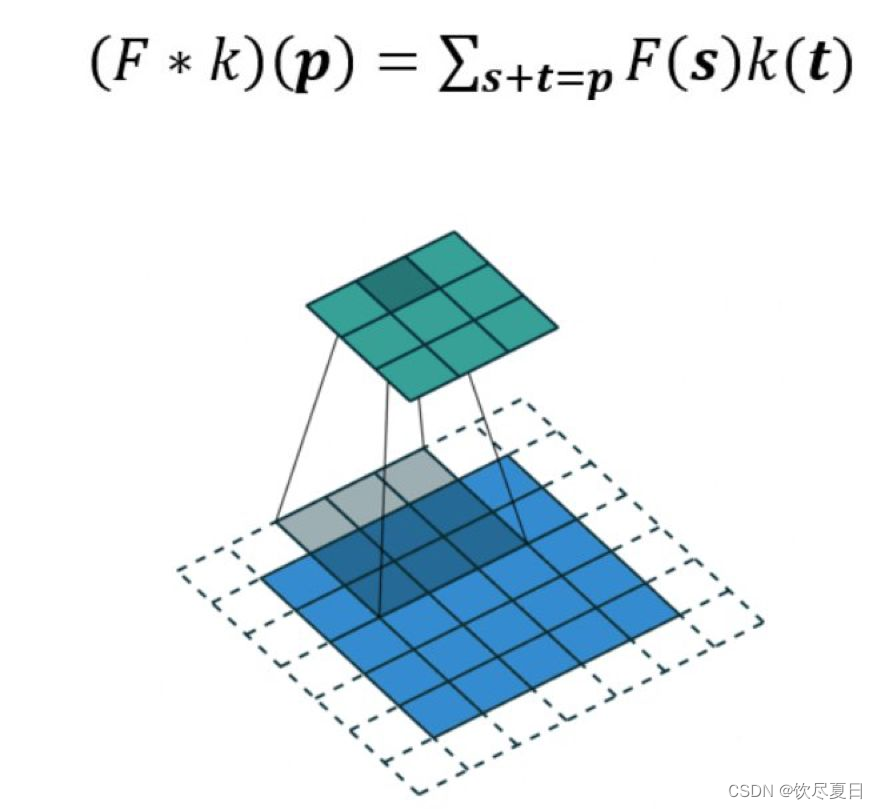
- 一个标准的离散卷积如下:
扩张卷积如下:
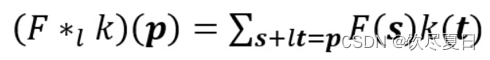
下面展示了 l = 1, 2, 4 时的核大小。
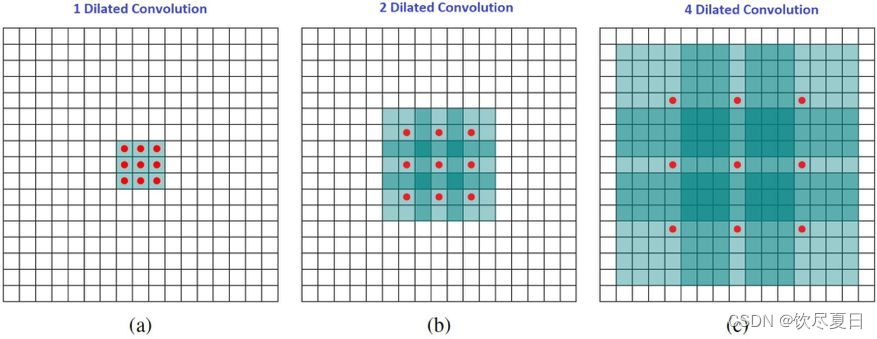
l=1 时感受野为 3×3,l=2 时为 7×7。l=3 时,感受野的大小就增加到了 15×15。
有趣的是,与这些操作相关的参数的数量是相等的。我们「观察」更大的感受野不会有额外的成本。
因此,扩张卷积可用于廉价地增大输出单元的感受野,而不会增大其核大小,这在多个扩张卷积彼此堆叠时尤其有效。
- 可分卷积
可分离卷积(Separable Convolution)是一种卷积操作的变体,它将标准的卷积拆分为两个步骤:深度卷积和逐点卷积。这种拆分有助于减少参数数量,提高计算效率,并在一定程度上减轻过拟合的风险。
在可分离卷积中,首先对输入的每个通道进行独立的深度卷积,然后再应用逐点卷积(pointwise convolution)对这些通道的输出进行组合。逐点卷积是指使用 1×1的卷积核,用来整合各个通道的信息。
-
空间可分卷积操作的是图像的 2D 空间维度,即高和宽。
从概念上看,空间可分卷积是将一个卷积分解为两个单独的运算。
对于下面的示例,3×3 的 Sobel 核被分成了一个 3×1 核和一个 1×3 核。
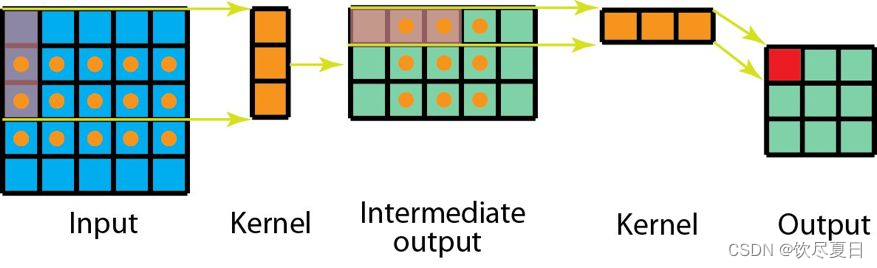
在卷积中,3×3 核直接与图像卷积。在空间可分卷积中,3×1 核首先与图像卷积,然后再应用 1×3 核。这样,执行同样的操作时仅需 6 个参数,而不是 9 个。
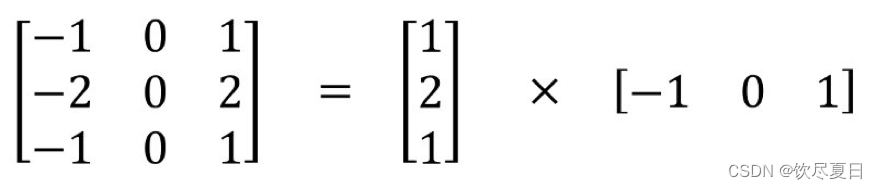
- 另一方面,对于空间可分卷积,我们首先在 5×5 的图像上应用一个 3×1 的过滤器。我们可以在水平 5 个位置和垂直 3 个位置扫描这样的核。总共就是 5×3=15 个位置,表示为下图中的点。在每个位置,会应用 3 次逐元素乘法。总共就是 15×3=45 次乘法。现在我们得到了一个 3×5 的矩阵。这个矩阵再与一个 1×3 核卷积,即在水平 3 个位置和垂直 3 个位置扫描这个矩阵。对于这 9 个位置中的每一个,应用 3 次逐元素乘法。这一步需要 9×3=27 次乘法。因此,总体而言,空间可分卷积需要 45+27=72 次乘法,少于普通卷积。
- 推广:
假设我们现在将卷积应用于一张 N×N 的图像上,卷积核为 m×m,步幅为 1,填充为 0。传统卷积需要 (N-2) x (N-2) x m x m 次乘法,空间可分卷积需要 N x (N-2) x m + (N-2) x (N-2) x m = (2N-2) x (N-2) x m 次乘法。空间可分卷积与标准卷积的计算成本比为:
2 m + 2 m ( N − 2 ) \frac {2}{m} + \frac {2} {m(N-2)} m2+m(N−2)2 - 尽管空间可分卷积能节省成本,但深度学习却很少使用它。一大主要原因是并非所有的核都能分成两个更小的核。如果我们用空间可分卷积替代所有的传统卷积,那么我们就限制了自己在训练过程中搜索所有可能的核。这样得到的训练结果可能是次优的。
- 另一方面,对于空间可分卷积,我们首先在 5×5 的图像上应用一个 3×1 的过滤器。我们可以在水平 5 个位置和垂直 3 个位置扫描这样的核。总共就是 5×3=15 个位置,表示为下图中的点。在每个位置,会应用 3 次逐元素乘法。总共就是 15×3=45 次乘法。现在我们得到了一个 3×5 的矩阵。这个矩阵再与一个 1×3 核卷积,即在水平 3 个位置和垂直 3 个位置扫描这个矩阵。对于这 9 个位置中的每一个,应用 3 次逐元素乘法。这一步需要 9×3=27 次乘法。因此,总体而言,空间可分卷积需要 45+27=72 次乘法,少于普通卷积。
-
深度可分卷积包含两个步骤:深度卷积核 1×1 卷积。
- 假设输入层的大小是 7×7×3(高×宽×通道),而过滤器的大小是 3×3×3。经过与一个过滤器的 2D 卷积之后,输出层的大小是 5×5×1(仅有一个通道)。
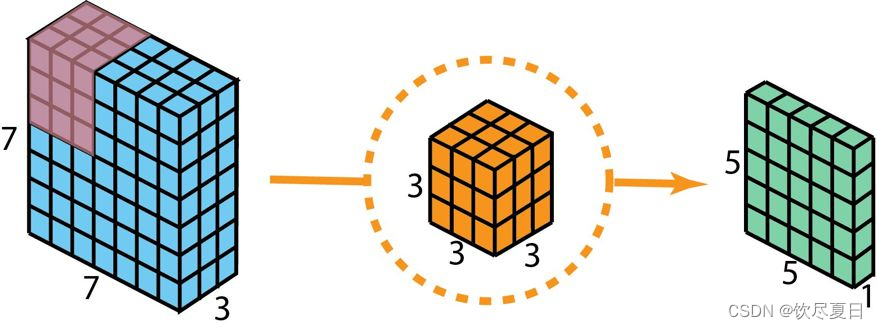
- 假设我们这里有 128 个过滤器。在应用了这 128 个 2D 卷积之后,我们有 128 个 5×5×1 的输出映射图(map)。然后我们将这些映射图堆叠成大小为 5×5×128 的单层。空间维度(即高度和宽度)会变小,而深度会增大。
有 128 个 3×3×3 个核移动了 5×5 次,也就是 128 x 3 x 3 x 3 x 5 x 5 = 86400 次乘法。
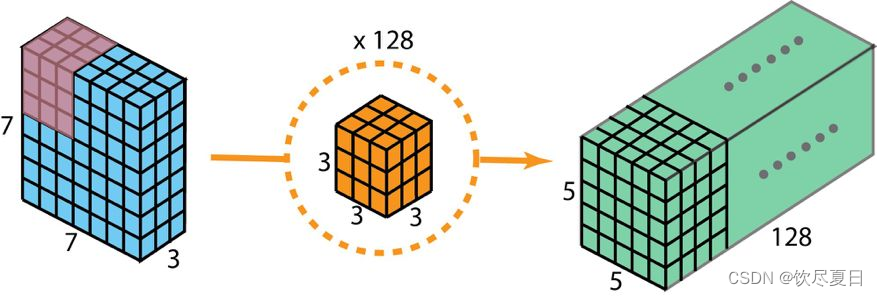
- 假设输入层的大小是 7×7×3(高×宽×通道),而过滤器的大小是 3×3×3。经过与一个过滤器的 2D 卷积之后,输出层的大小是 5×5×1(仅有一个通道)。
-
现在 使用深度可分卷积,看看我们如何实现同样的变换。
- 首先,我们将深度卷积应用于输入层。但我们不使用 2D 卷积中大小为 3×3×3 的单个过滤器,而是分开使用 3 个核。每个过滤器的大小为 3×3×1。每个核与输入层的一个通道卷积(仅一个通道,而非所有通道!)。每个这样的卷积都能提供大小为 5×5×1 的映射图。
- 然后我们将这些映射图堆叠在一起,创建一个 5×5×3 的图像。经过这个操作之后,我们得到大小为 5×5×3 的输出。现在我们可以降低空间维度了,但深度还是和之前一样。
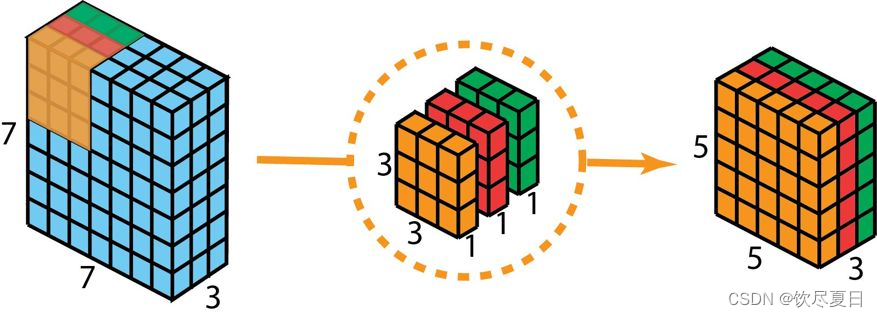
- 在深度可分卷积的第二步,为了扩展深度,我们应用一个核大小为 1×1×3 的 1×1 卷积。将 5×5×3 的输入图像与每个 1×1×3 的核卷积,可得到大小为 5×5×1 的映射图。
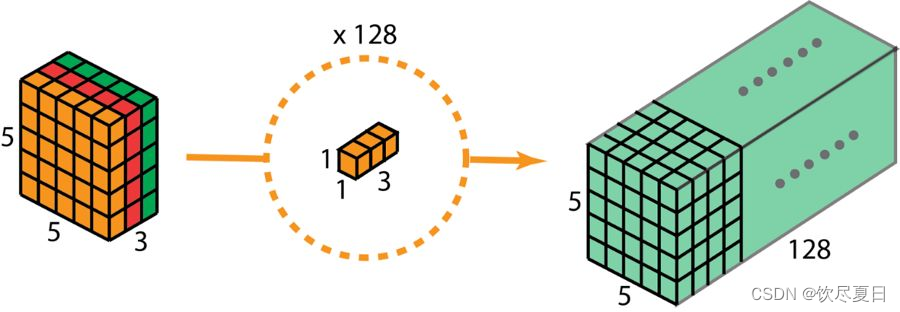
全过程如图: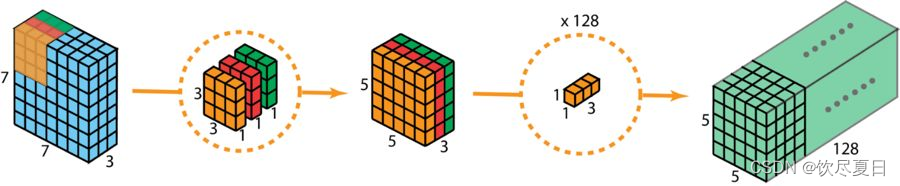
在第一个深度卷积步骤,有 3 个 3×3×1 核移动 5×5 次,也就是 3x3x3x1x5x5 = 675 次乘法。在 1×1 卷积的第二步,有 128 个 1×1×3 核移动 5×5 次,即 128 x 1 x 1 x 3 x 5 x 5 = 9600 次乘法。因此,深度可分卷积共有 675 + 9600 = 10275 次乘法。
-
于大小为 H×W×D 的输入图像,如果使用 Nc 个大小为 h×h×D 的核执行 2D 卷积(步幅为 1,填充为 0,其中 h 是偶数)。为了将输入层(H×W×D)变换到输出层((H-h+1)x (W-h+1) x Nc),所需的总乘法次数为:Nc x h x h x D x (H-h+1) x (W-h+1)
另一方面,对于同样的变换,深度可分卷积所需的乘法次数为:
D x h x h x 1 x (H-h+1) x (W-h+1) + Nc x 1 x 1 x D x (H-h+1) x (W-h+1) = (h x h + Nc) x D x (H-h+1) x (W-h+1)
则深度可分卷积与 2D 卷积所需的乘法次数比为:
1 N c + 1 h 2 \frac {1} {N_c} + \frac {1}{h^2} Nc1+h21
- 分组卷积
分组卷积(Grouped Convolution)是一种卷积神经网络中的卷积操作,其中输入和输出被分为若干组,每组进行独立的卷积操作。这个概念旨在减少参数数量,提高计算效率,并在一定程度上提高模型的并行性。
分组卷积常常用于设计深度神经网络的卷积层,特别是在计算资源受限的情况下。
- 因为卷积被分成了多个路径,每个路径都可由不同的 GPU 分开处理,所以模型可以并行方式在多个 GPU 上进行训练。相比于在单个 GPU 上完成所有任务,这样的在多个 GPU 上的模型并行化能让网络在每个步骤处理更多图像。
卷积核一定越大越好?
- 卷积核越大,receptive field(感受野)越大,看到的图片信息越多,因此获得的特征越好。
- 虽说如此,但是大的卷积核会导致计算量的暴增,不利于模型深度的增加,计算性能也会降低。
- 于是在VGG(最早使用)、Inception网络中,利用2个3×3卷积核的组合比1个5×5卷积核的效果更佳,同时参数量被降低,因此后来3×3卷积核被广泛应用在各种模型中。
每层卷积只能用一种尺寸的卷积核?
- 传统的层叠式网络,基本上都是一个个卷积层的堆叠,每层只用一个尺寸的卷积核,例如VGG结构中使用了大量的3×3卷积层。
- 事实上,同一层feature map可以分别使用多个不同尺寸的卷积核,以获得不同尺度的特征,再把这些特征结合起来,得到的特征往往比使用单一卷积核的要好,谷歌的GoogleNet,或者说Inception系列的网络,就使用了多个卷积核的结构。
怎样才能减少卷积层参数量?
-
假设输入feature map的维度为256维,要求输出维度也是256维。有以下两种操作:
- 256维的输入直接经过一个3×3×256的卷积层,输出一个256维的feature map,那么参数量为:256×3×3×256 = 589,824
- 256维的输入先经过一个1×1×64的卷积层,再经过一个3×3×64的卷积层,最后经过一个1×1×256的卷积层,输出256维,参数量为:256×1×1×64 + 64×3×3×64 +64×1×1×256 = 69,632。
-
第二种操作足足把第一种操作的参数量降低到九分之一。
1×1卷积核也被认为是影响深远的操作,往后大型的网络为了降低参数量都会应用上1×1卷积核。
越深的网络就越难训练吗?
- 传统的卷积层层叠网络会遇到一个问题,当层数加深时,网络的表现越来越差,很大程度上的原因是因为当层数加深时,梯度消散得越来越严重,以至于反向传播很难训练到浅层的网络。
- 为了解决这个问题,何凯明想出了一个“残差网络”,使得梯度更容易地流动到浅层的网络当中去。
- BN通过规范化输入数据改变数据分布,在前传过程中消除梯度弥散。
- 而skip connection则能在后传过程中更好地把梯度传到更浅的层次中。
卷积操作时必须同时考虑通道和区域吗?
- Xception网络就是基于以上的问题发明而来。我们首先对每一个通道进行各自的卷积操作,有多少个通道就有多少个过滤器。
- 得到新的通道feature maps之后,这时再对这批新的通道feature maps进行标准的1×1跨通道卷积操作。这种操作被称为 “DepthWise convolution” ,缩写“DW”。
分组卷积能否对通道进行随机分组?
- 在AlexNet的Group Convolution当中,特征的通道被平均分到不同组里面,最后再通过两个全连接层来融合特征,这样一来,就只能在最后时刻才融合不同组之间的特征,对模型的泛化性是相当不利的。
- 为了解决这个问题,ShuffleNet在每一次层叠这种Group conv层前,都进行一次channel shuffle,shuffle过的通道被分配到不同组当中。进行完一次group conv之后,再一次channel shuffle,然后分到下一层组卷积当中,以此循环。
- 经过channel shuffle之后,Group conv输出的特征能考虑到更多通道,输出的特征自然代表性就更高。
- 另外,AlexNet的分组卷积,实际上是标准卷积操作,而在ShuffleNet里面的分组卷积操作是depthwise卷积,因此结合了通道洗牌和分组depthwise卷积的ShuffleNet,能得到超少量的参数以及超越mobilenet、媲美AlexNet的准确率!
通道间的特征都是平等的吗?
- 无论是在Inception、DenseNet或者ShuffleNet里面,我们对所有通道产生的特征都是不分权重直接结合的,那为什么要认为所有通道的特征对模型的作用就是相等的呢? 这是一个好问题,于是,ImageNet2017 冠军SEnet就出来了。
- 一组特征在上一层被输出,这时候分两条路线,第一条直接通过,第二条首先进行Squeeze操作(Global Average Pooling),把每个通道2维的特征压缩成一个1维,从而得到一个特征通道向量(每个数字代表对应通道的特征)。
- 然后进行Excitation操作,把这一列特征通道向量输入两个全连接层和sigmoid,建模出特征通道间的相关性,得到的输出其实就是每个通道对应的权重,把这些权重通过Scale乘法通道加权到原来的特征上(第一条路),这样就完成了特征通道的权重分配。
能否让固定大小的卷积核看到更大范围的区域?
见扩张卷积。
卷积核形状一定是矩形吗?
- 传统的卷积核一般都是长方形或正方形,但MSRA提出了一个相当反直觉的见解,认为卷积核的形状可以是变化的,变形的卷积核能让它只看感兴趣的图像区域 ,这样识别出来的特征更佳。
- 要做到这个操作,可以直接在原来的过滤器前面再加一层过滤器,这层过滤器学习的是下一层卷积核的位置偏移量(offset),这样只是增加了一层过滤器,或者直接把原网络中的某一层过滤器当成学习offset的过滤器,这样实际增加的计算量是相当少的,但能实现可变形卷积核,识别特征的效果更好。
论文扩展阅读(未读)
图解10大CNN架构
dropout
- Dropout可以比较有效的缓解过拟合的发生,在一定程度上达到正则化的效果。当一个复杂的前馈神经网络被训练在小的数据集时,容易造成过拟合。为了防止过拟合,可以通过阻止特征检测器的共同作用来提高神经网络的性能。
- Dropout可以作为训练深度神经网络的一种trick供选择。在每个训练批次中,通过忽略一半的特征检测器(让一半的隐层节点值为0),可以明显地减少过拟合现象。这种方式可以减少特征检测器(隐层节点)间的相互作用,检测器相互作用是指某些检测器依赖其他检测器才能发挥作用。
- Dropout说的简单一点就是:我们在前向传播的时候,让某个神经元的激活值以一定的概率p停止工作,这样可以使模型泛化性更强,因为它不会太依赖某些局部的特征
假设我们要训练这样一个神经网络
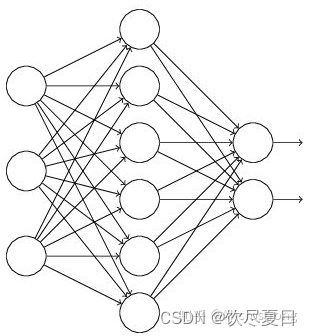
正常的流程是:我们首先把x通过网络前向传播,然后把误差反向传播以决定如何更新参数让网络进行学习。
使用Dropout之后,过程变成如下:
- 首先随机(临时)删掉网络中一半的隐藏神经元,输入输出神经元保持不变
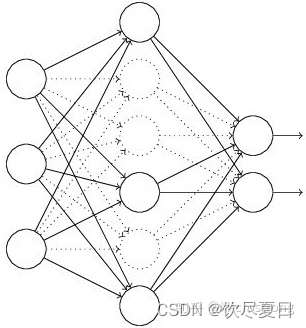
- 把输入x通过修改后的网络前向传播,然后把得到的损失结果通过修改的网络反向传播。一小批训练样本执行完这个过程后,在没有被删除的神经元上按照随机梯度下降法更新对应的参数(w,b)。
- 然后继续重复这一过程:
- 恢复被删掉的神经元(此时被删除的神经元保持原样,而没有被删除的神经元已经有所更新)
- 从隐藏层神经元中随机选择一个一半大小的子集临时删除掉(备份被删除神经元的参数)。
- 对一小批训练样本,先前向传播然后反向传播损失并根据随机梯度下降法更新参数(w,b) (没有被删除的那一部分参数得到更新,删除的神经元参数保持被删除前的结果)。

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 1
 0
- 0


 已为社区贡献1条内容

所有评论(0)