决策树算法
·决策树的介绍
·3种常见的特征选择方法
·决策树示例解说
·决策树的优缺点
1.决策树的介绍
决策树是一种基本的机器学习算法,属于有监督学习方法,以下是关于它的详细介绍:
定义与原理
定义:决策树是基于树结构进行决策,每个内部节点是一个属性上的测试,分支是测试输出,叶节点是类别或值,通过对样本属性的测试,从根节点逐步走向叶节点,以确定样本的类别或值。
原理:决策树算法的核心是通过选择合适的属性作为节点,将样本空间逐步划分成纯度更高的子空间,使得在每个子空间中,样本尽可能属于同一类别。
构建过程
特征选择:选择具有最高信息增益(或其他划分标准)的特征作为当前节点的分裂特征。信息增益衡量了使用某个特征进行划分后,样本集合的不确定性减少的程度。常见的特征选择方法有基于信息熵的 ID3 算法、基于信息增益比的 C4.5 算法,基尼系数等。
决策树生成:根据选定的特征,将样本集合划分为若干个子集,每个子集对应一个分支,然后递归地对每个子集进行特征选择和划分,直到满足停止条件,如所有样本属于同一类别、没有更多的特征可供选择或达到预设的树深度。
剪枝:决策树可能会过拟合训练数据,通过剪枝来去掉一些不必要的分支,降低模型复杂度,提高泛化能力。剪枝方法分为预剪枝和后剪枝,预剪枝是在决策树生成过程中,提前停止某些分支的生长;后剪枝是在决策树生成后,根据一定的规则剪掉一些子树。
2.3种常见的特征选择方法:
1.ID3算法
基本原理
ID3 算法以信息熵为基础,通过计算每个特征的信息增益来选择最优的分裂特征。信息熵是衡量数据集不确定性的一个指标,数据集的熵越大,其不确定性就越高。信息增益表示使用某个特征对数据集进行划分后,信息熵的减少量。ID3 算法选择信息增益最大的特征作为当前节点的分裂特征,因为该特征能够最大程度地降低数据集的不确定性,使得划分后的子数据集更加纯净。
算法步骤
初始化:将所有训练样本作为根节点的数据集。
计算信息增益:对于每个特征,计算其对数据集的信息增益。具体步骤如下:
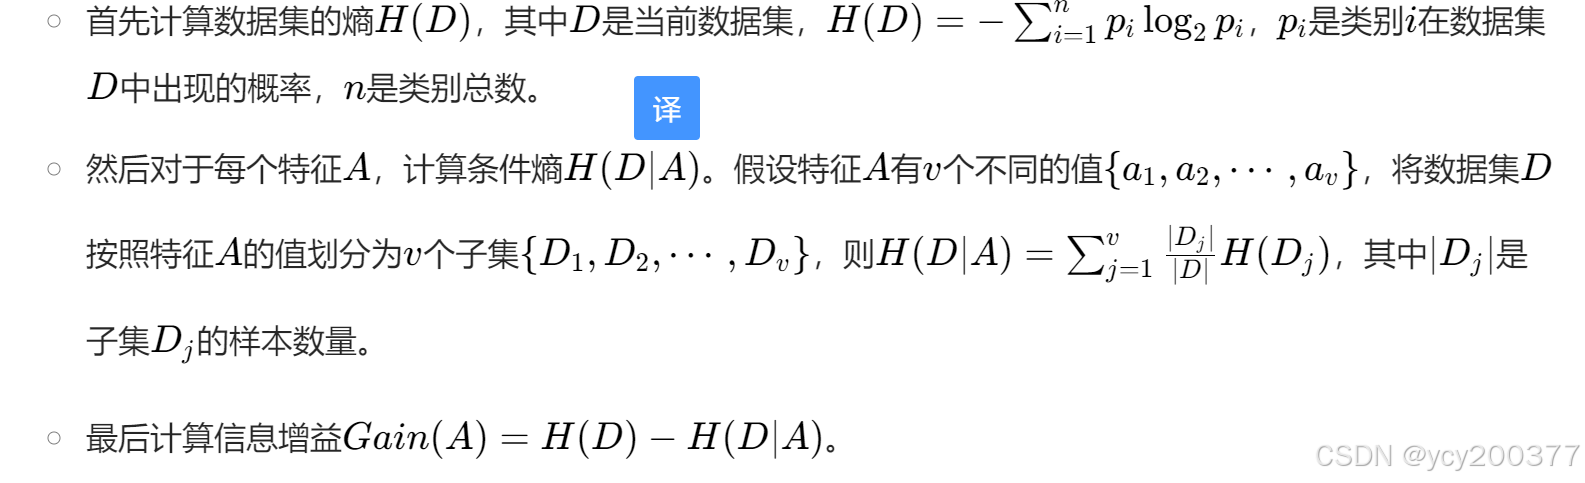
按照示例简单讲解一下,首先我们来看一组数据
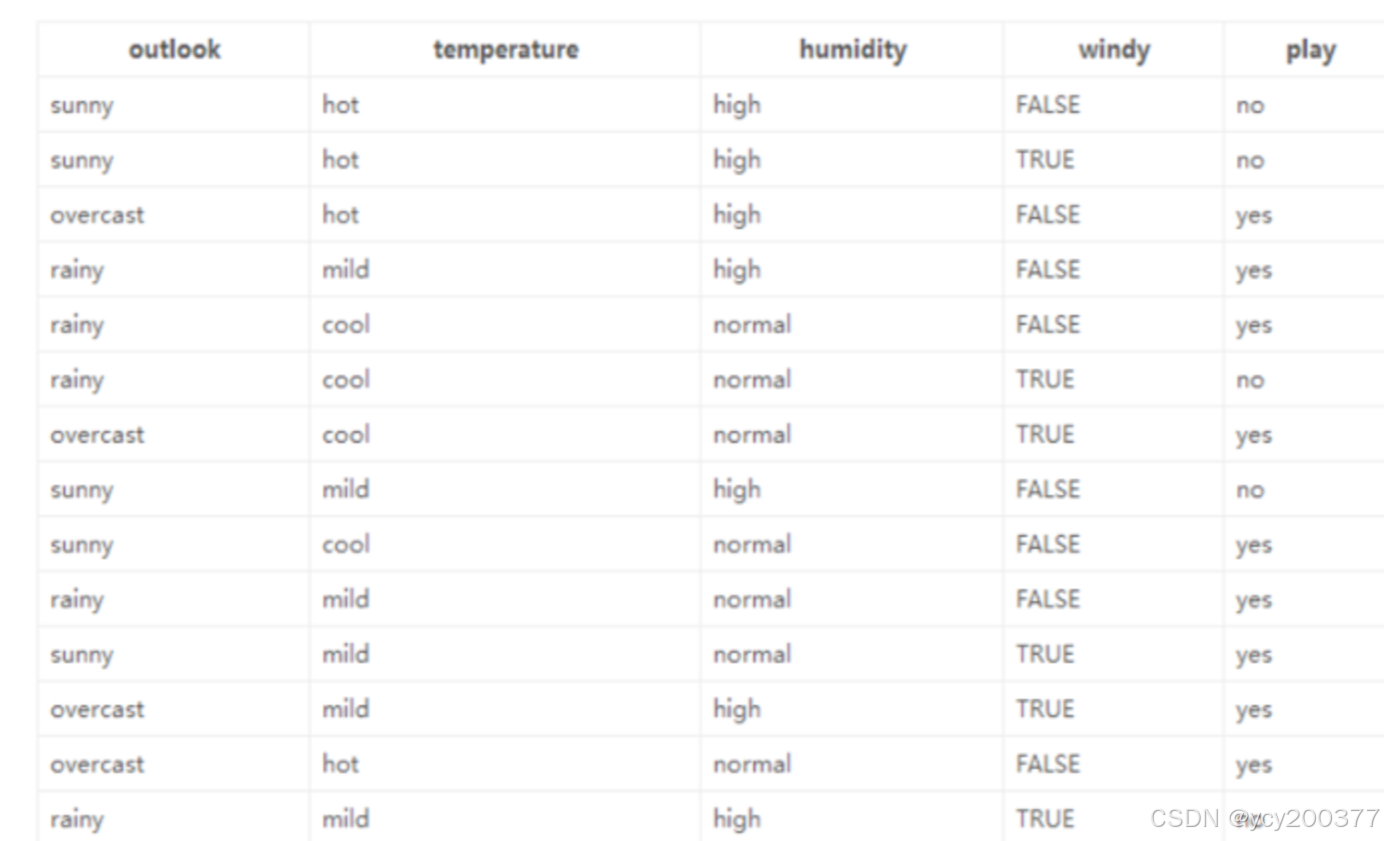
1.标签(结果是否外出打球)的熵(类别熵):
14天中,9天打球,5天不打球,熵为: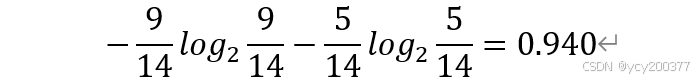
2.基于天气的划分:
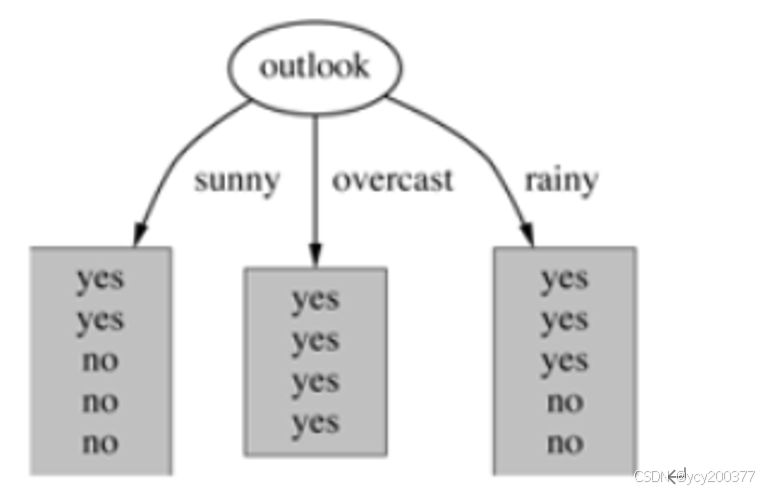
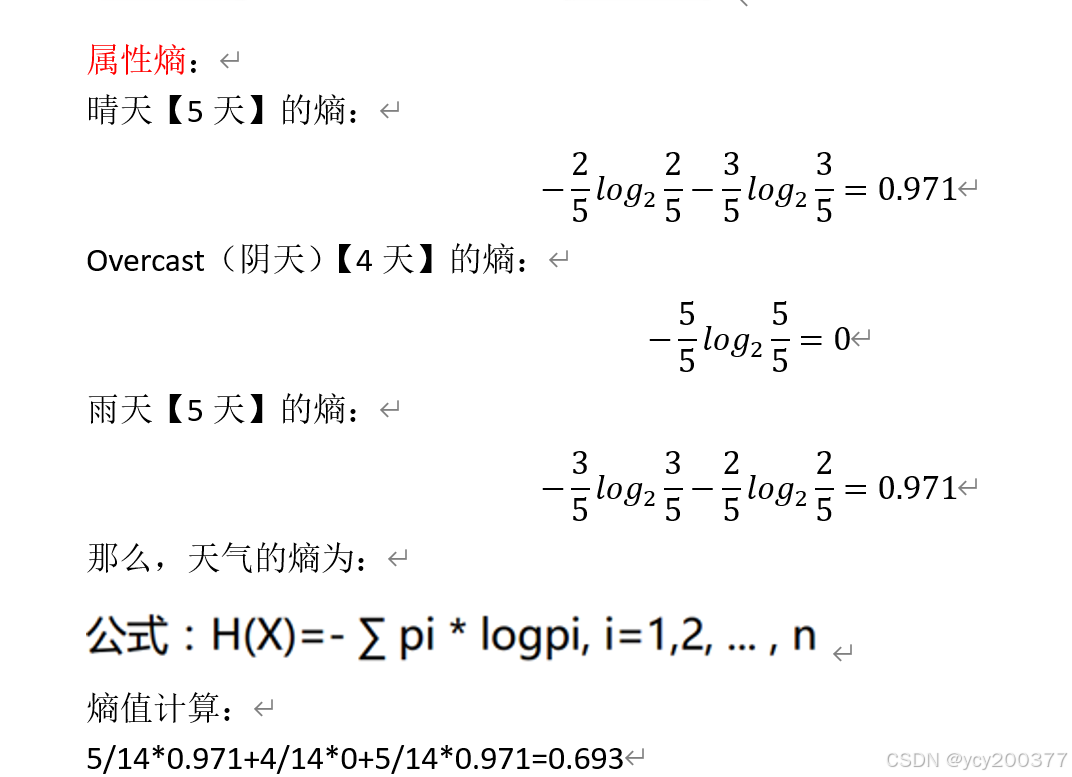
则信息增益为:0.940-0.693=0.247
然后,我们依次算出温度,湿度,风的信息增益
得出:天气 > 湿度 > 有风 > 温度,然后依次构建出决策树。
2.c4.5
方法步骤
初始化决策树,将所有训练样本作为根节点的数据集。
对于每个特征,计算其信息增益率。
选择信息增益率最大的特征作为当前节点的分裂特征。如果有多个特征的信息增益率相同,则选择信息增益较大的特征。
根据分裂特征的取值对数据集进行划分,为每个取值创建一个子节点,并将相应的样本分配到子节点中。
对于每个子节点,如果该节点的样本都属于同一类别,或者达到预设的停止条件(如树的深度达到上限、样本数量过少等),则将该节点标记为叶节点,并设置其类别为该节点中样本的多数类别。否则,递归地对该子节点执行步骤 2 - 5。
决策树生成完成后,使用剪枝算法对决策树进行剪枝,以提高决策树的泛化能力。
公式: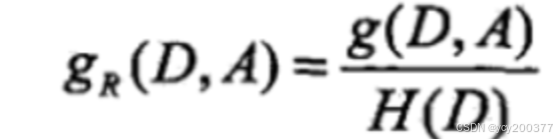
3.基尼系数
在决策树中,基尼系数是一种用于衡量数据集纯度的指标
定义:基尼系数表示一个随机选中的样本在分类时被错误分类的概率。它的值介于 0 到 1 之间,值越小,说明数据集的纯度越高,即样本被正确分类的概率越高。
计算方法:对于一个具有K个类别的数据集D,其基尼系数的计算公式为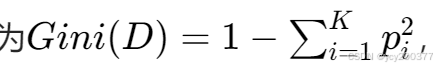
其中p i是类别i在数据集D中出现的概率。例如,一个数据集中有 3 个类别,分别是A、B、C,其出现的概率分别为0.5、0.3、0.2,那么该数据集的基尼系数为
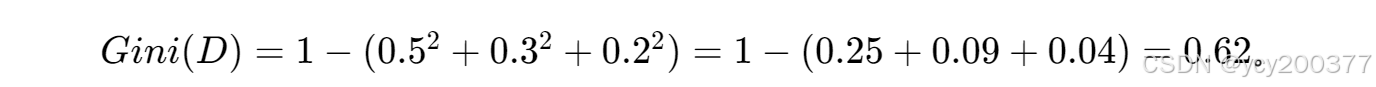
3.决策树示例解说
数据集获取方式:电信客户流失数据(1).xlsx链接: https://pan.baidu.com/s/1ay0CYE6xb3Qj6kDQOM8Nog 提取码: fyah
首先我们先导入数据集
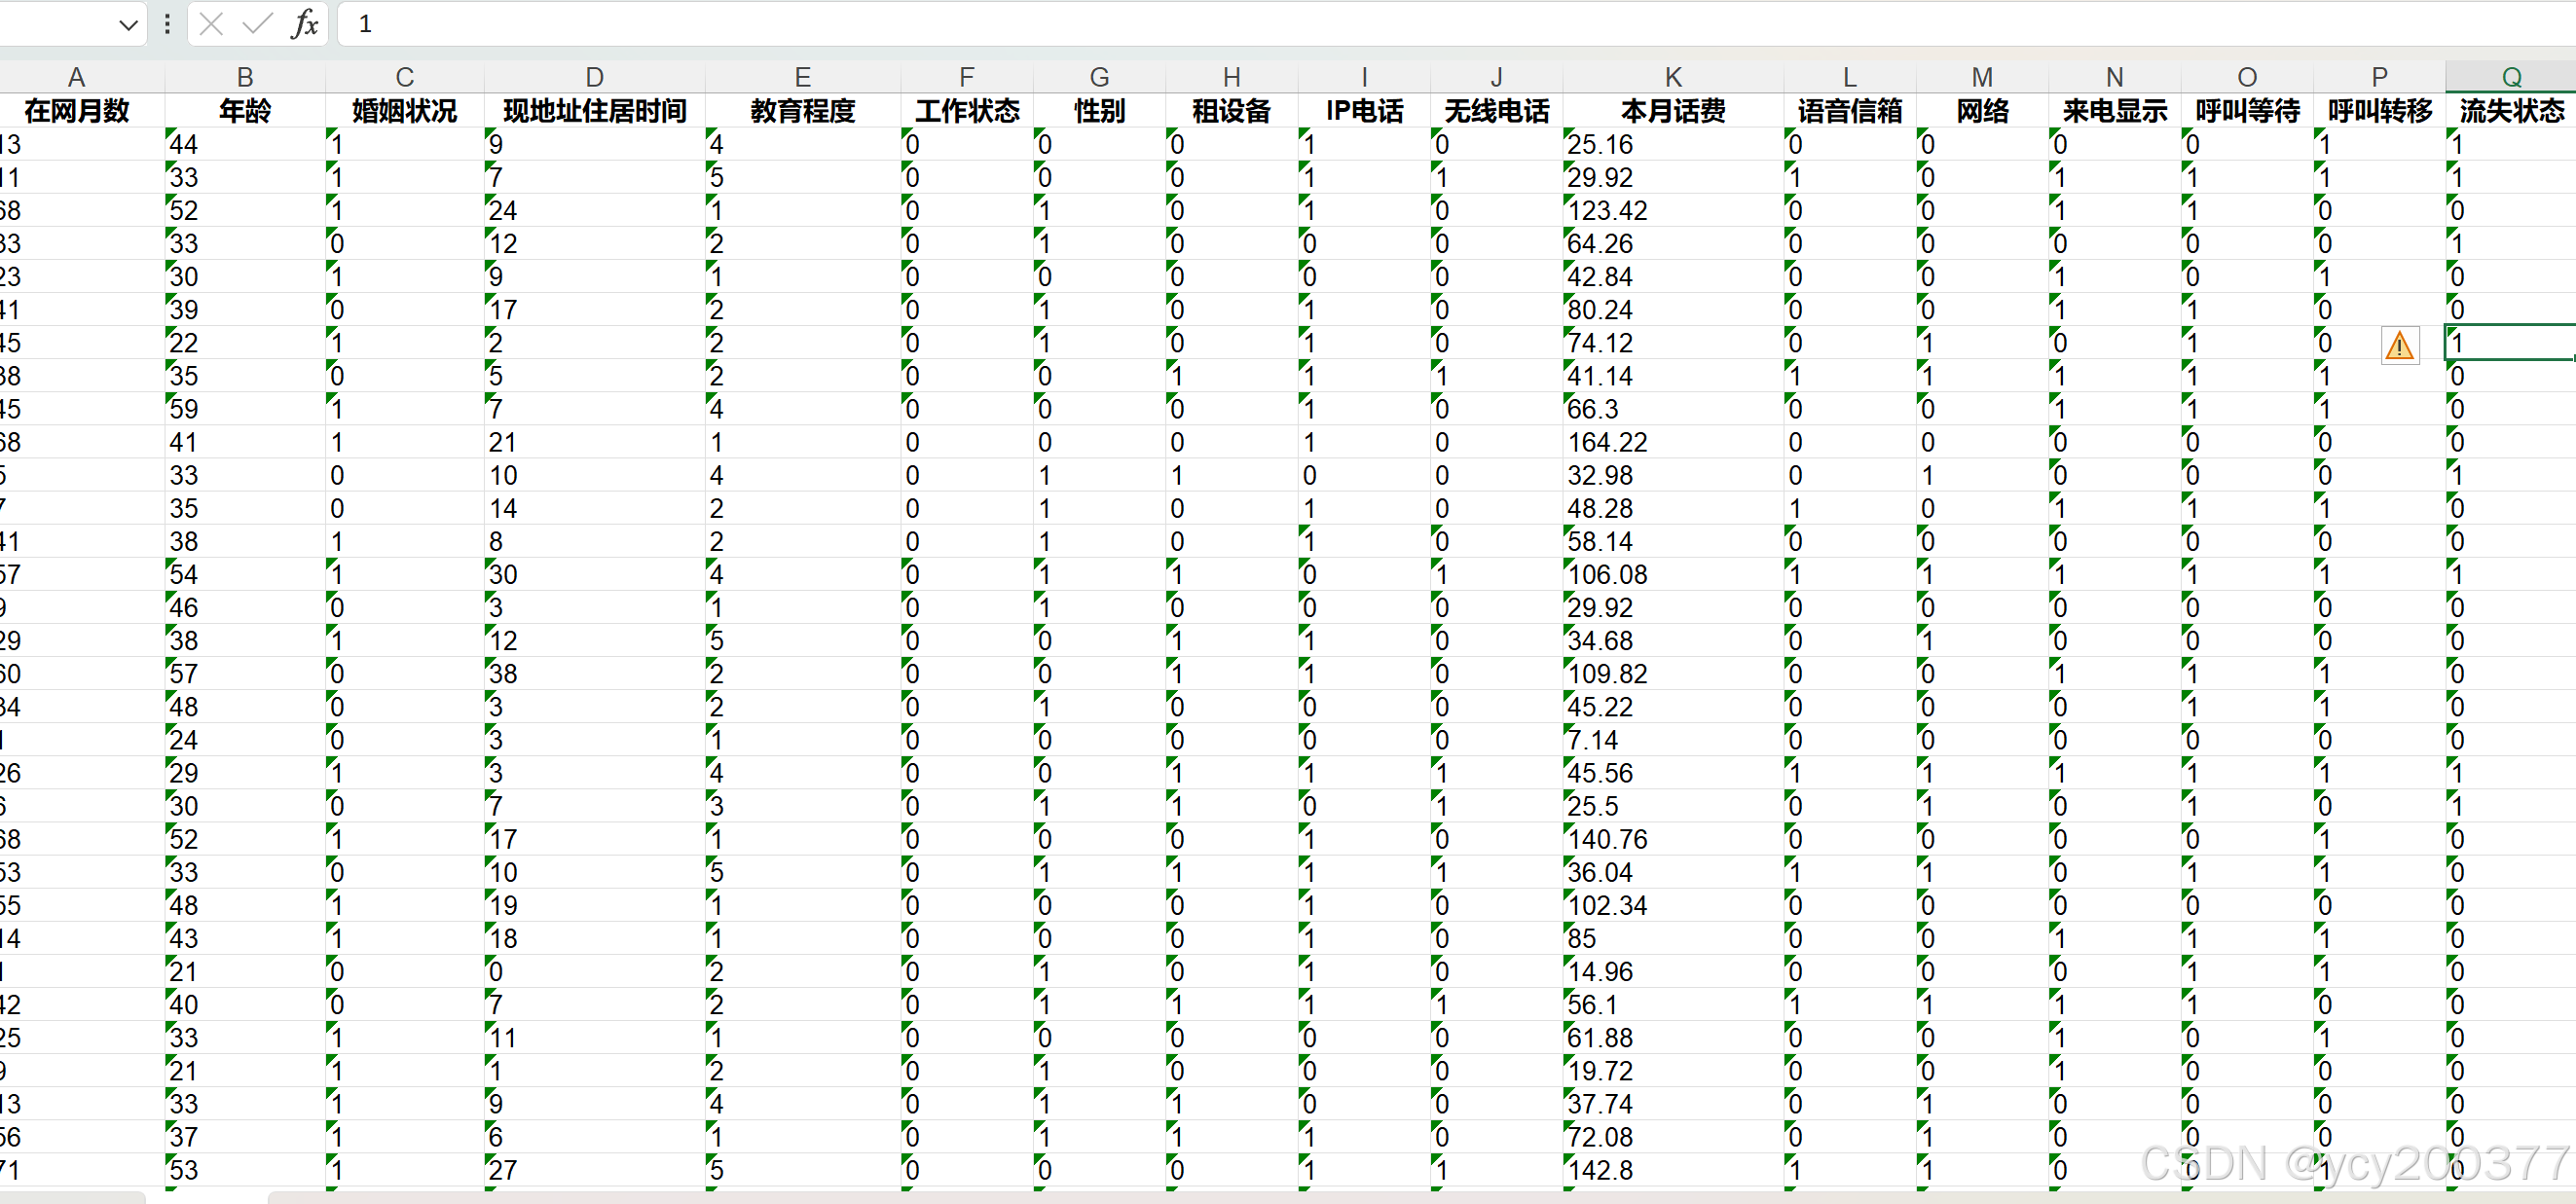
运行以下代码
import pandas as pd
from sklearn import tree
import numpy as np
import openpyxl
from sklearn.metrics import confusion_matrix
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split
from sklearn import metrics

# 定义混淆矩阵绘制函数
def cm_plot(y, yp):
    cm = confusion_matrix(y, yp)
    plt.matshow(cm, cmap=plt.cm.Blues)
    plt.colorbar()
    for x in range(len(cm)):
        for y in range(len(cm)):
            plt.annotate(cm[x, y], xy=(y, x), horizontalalignment='center',
                         verticalalignment='center')
    plt.ylabel('True label')
    plt.xlabel('Predicted label')
    return plt

# 读取数据
datas = pd.read_excel("电信客户流失数据(1).xlsx")
data = datas.iloc[:, :-1]
target = datas.iloc[:, -1]

# 数据集划分
data_train, data_test, target_train, target_test = train_test_split(data, target, test_size=0.2, random_state=42)

# 模型构建与训练
dtr = tree.DecisionTreeClassifier(criterion='gini', max_depth=10, min_samples_split=6, min_samples_leaf=3, random_state=42)
dtr.fit(data_train, target_train)

# 训练集预测与评估
train_predicted = dtr.predict(data_train)
print("训练集分类报告:")
print(metrics.classification_report(target_train, train_predicted))
# 绘制训练集混淆矩阵
cm_plot(target_train, train_predicted).show()

# 测试集预测与评估
test_predicted = dtr.predict(data_test)
print("测试集分类报告:")
print(metrics.classification_report(target_test, test_predicted))
# 绘制测试集混淆矩阵
cm_plot(target_test, test_predicted).show()

# 对决策树测试集进行评分
test_score = dtr.score(data_test, target_test)
print(f"测试集评分:{test_score}")

# 决策树可视化
fig, ax = plt.subplots(figsize=(32, 32))
plot_tree(dtr, filled=True, ax=ax)
plt.show()
最终得到
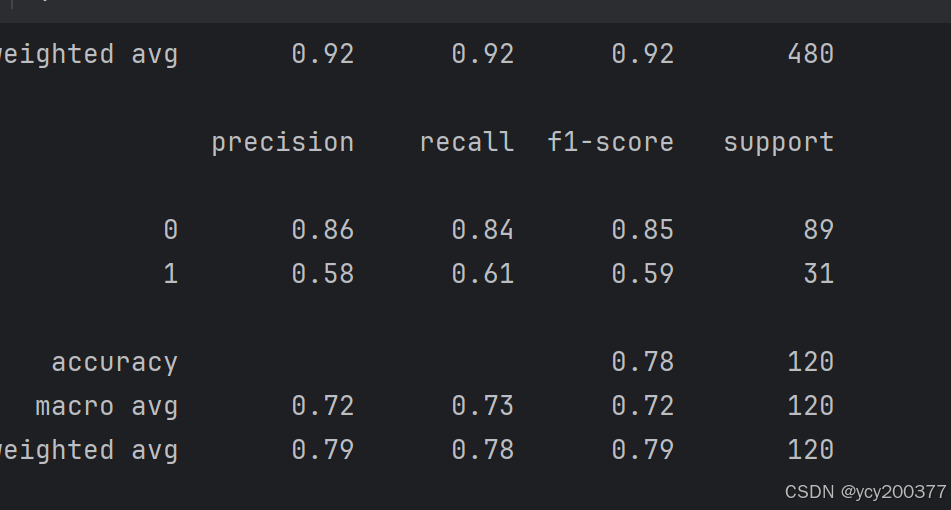
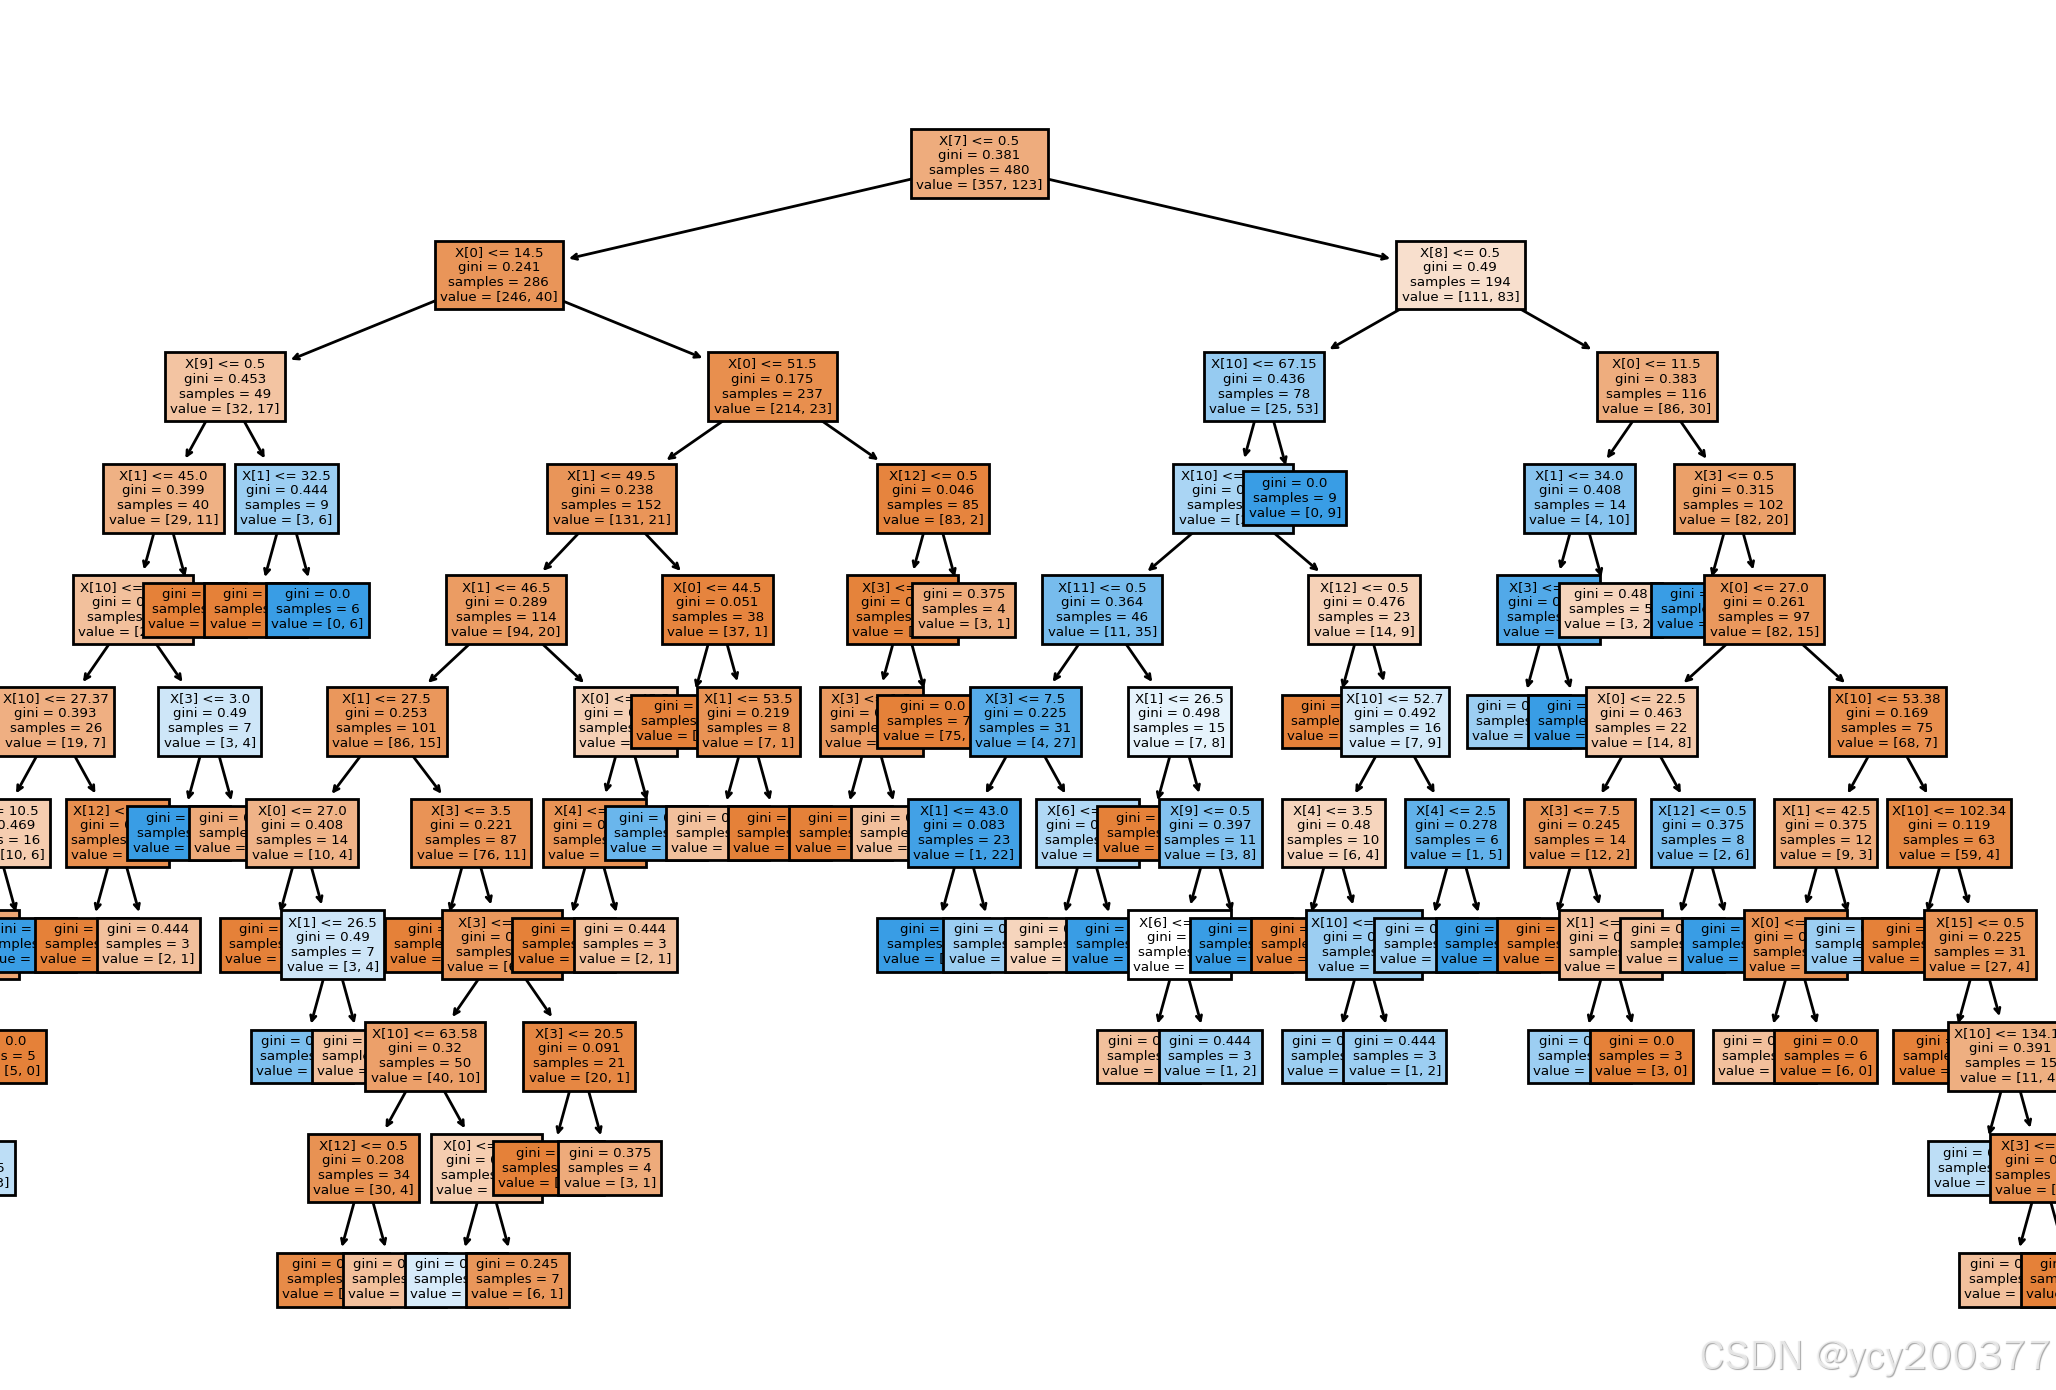
4.决策树的优缺点
决策树算法的优点: 简单易于理解和解释:决策树算法的模型可以直观地表示为树形结构,易于理解和解释,可以帮助人们做出可靠的决策。 适用于多类型的数据:决策树算法可以处理包含分类和数值型特征的数据,也可以用于处理多分类问题,适用于大规模数据集。
决策树算法的缺点: 容易过拟合:决策树算法容易在训练数据上过拟合,导致在新数据上的泛化能力较差。可以通过剪枝等技术来减少过拟合的风险。 对输入数据的微小变化敏感:决策树算法对输入数据的微小变化非常敏感,这可能导致不稳定的预测结果。 忽略属性之间的相关性:决策树算法假设每个特征在判断类别时都是独立的,忽略了特征之间的相关性。这在某些情况下可能导致模型的性能下降。

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 13
 0
- 0


 已为社区贡献8条内容

所有评论(0)