登录社区云,与社区用户共同成长
邀请您加入社区
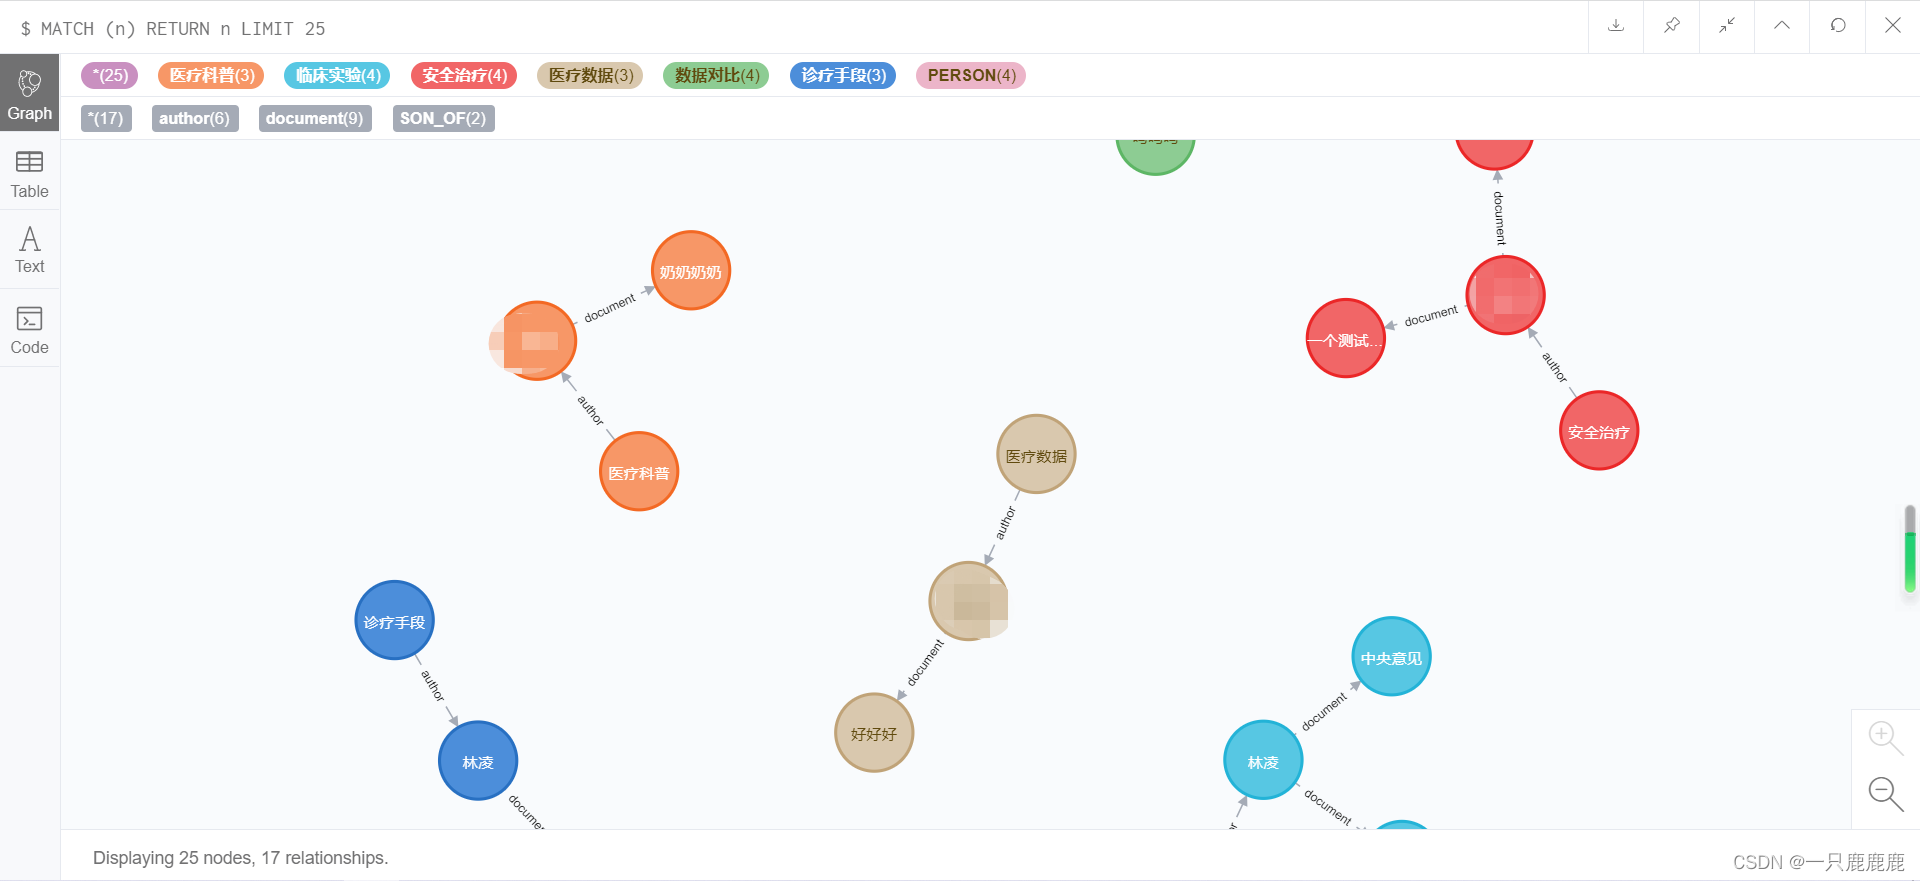
ps:折磨了一天,查了好多资料说是要下载社区版,然而却卡在了配置环境变量的操作上,最后发现桌面版就能导出,不用下载apoc等插件,总算解决上述问题,哭。使用d3库将neo4j存储的知识图谱在网页端可视化需要将数据导出为json文件。切换到table模式 点击右上方下载箭头 选择导出格式 即可导出。本人使用的是neo4j桌面版。
内存配置Neo4j服务的内存划分为很多部分,以下是其中的一部分:neo4j 内存管理「JVM堆」JVM堆是一个单独的动态内存分配,Neo4j使用它来存储实例化对象。Java对象的内存由垃圾收集器自动管理,更多垃圾回收器的调整可以参考垃圾回收器的内容。堆内存的大小由参数dbms.memory.heap.initial_size和 dbms.memory.heap.max_s...
近期公司项目要实现一个知识图谱的功能,所以了解到了neo4j,接着去查询相关的实现方案,就选定了neovis来进行实现,因为它可以直接对接neo4j的数据,不需要对接接口首先我使用的的版本为,开始使用的是版本的,但是由于这个版本不能对节点进行样式设置,所以就选用了最新的版本注意:因为我们下面有一些业务上的查询,所以也要同步下载这里我下载的是的。
对图算法有兴趣的朋友可以关注微信公众号 :《 Medical与AI的故事》原文链接:《《图算法》第六章-1 社区检测算法-形成一个社区在所有类型的网络中都很常见,识别它们对于评估群体行为和突发现象都很重要。通常来说,社区的成员在群体内的关系比在群体外的节点多,这是社区检测的一般原则。识别这些相关集体可以揭示节点群集、独立组和网络结构。此信息有助于推断对等的各组的相似行为和偏好、弹性估算和查找嵌..
在configuration中新建一个apoc.conf文件,不知道怎么创建,可以直接复制neo4j.conf,再把里面删光,添加。json文件放在import里。
Neo4j Desktop通过apoc 导入json文件一、Apoc 安装(github)1、安装2、查看文件夹3、修改neo4j.confapoc.import.file.enabled=true二、使用1、控制台输入json文件下载地址// YIELD关键字表示每次导入json数据中的一组数据,即`[...]`中的每一个`{}`CALL apoc.load.json("file:///data
先执行 python main.py 再执行 python main.py --phase=test。1、从github上下载代码。
一个集计算、展示于一体的平台。
随着技术的飞速发展,编程领域每天都在演化,新的技术、框架和工具层出不穷。本文将聚焦2025年最具潜力和吸引力的编程技术与工具,从前沿语言到最受欢迎的开发框架,带您一起探索软件开发领域的最新趋势。
官网下载客户端,需要先注册。命令行安装neo4j:wget -O - https://debian.neo4j.org/neotechnology.gpg.key | sudo apt-key add -echo 'deb https://debian.neo4j.org/repo stable/' | sudo tee -a /etc/apt/sources.list.d/neo4...
以安装neo4j版本neo4j-community-3.5.28为例1、把3.5版本的jar包下载到neo4j对应的plugins文件夹中https://github.com/neo4j-contrib/neo4j-apoc-procedures/releases/3.5.0.112、修改该jar包的权限(添加执行权限),chmod 755 xxxxx.jar3、修改neo4j.conf:放开注释
org.springframework.transaction.CannotCreateTransactionException:CouldnotopenNeo4jSessionfortransaction;nestedexceptionisorg.neo4j.driver.exceptions.AuthenticationException:Theclientisunauthorizedduet
下载 neo4j-community-3.5.13-unix.tar.gz 和 openjdk-11.0.0.2_linux-x64.tar.gz。注意这里要填入你自己将下载文件解压后的路径。生效后,我们可以测试Java。
public interface BaseNodeRepository extends Neo4jRepository<BaseNode, Long> {@Query("MATCH (n) WHERE n.name =~ ('.*'+$name+'.*') RETURN n")List<BaseNode> findBaseNodeByNameLike(String name
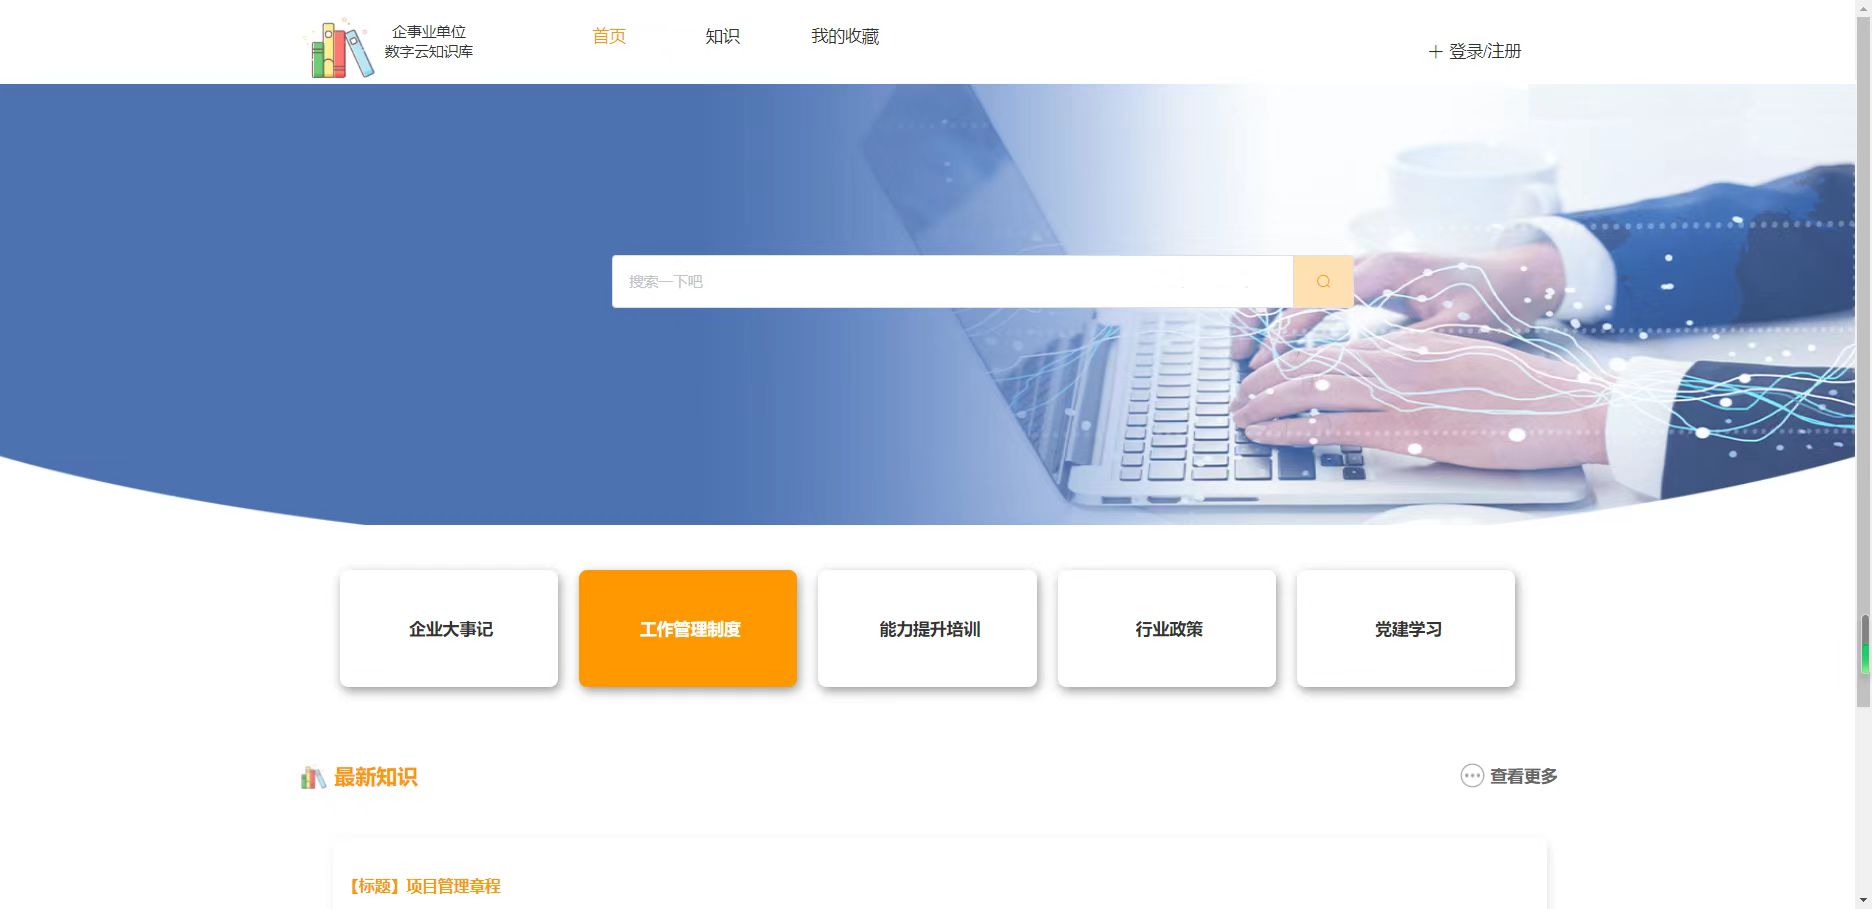
精准全面的搜索能力,统一化管理,此套知识库管理系统以科学的方法论并且通过实际项目锤炼做到了很好的赋能效应,解决了企事业数字知识库的良性全生命周期管理。源码获取链接:+Q:2500564056。
springboot 连接 neo4j 一直连接失败。
通过工具类使用neo4j
springboot整合neo4j报错Could not find mappable nodes or relationships inside Record for org.springframework.data.neo4j.core.mapping.DefaultNeo4jPersistentEntity@6662974a
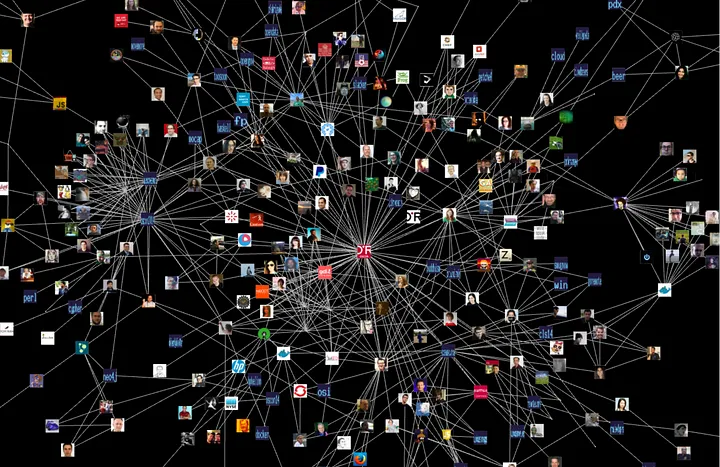
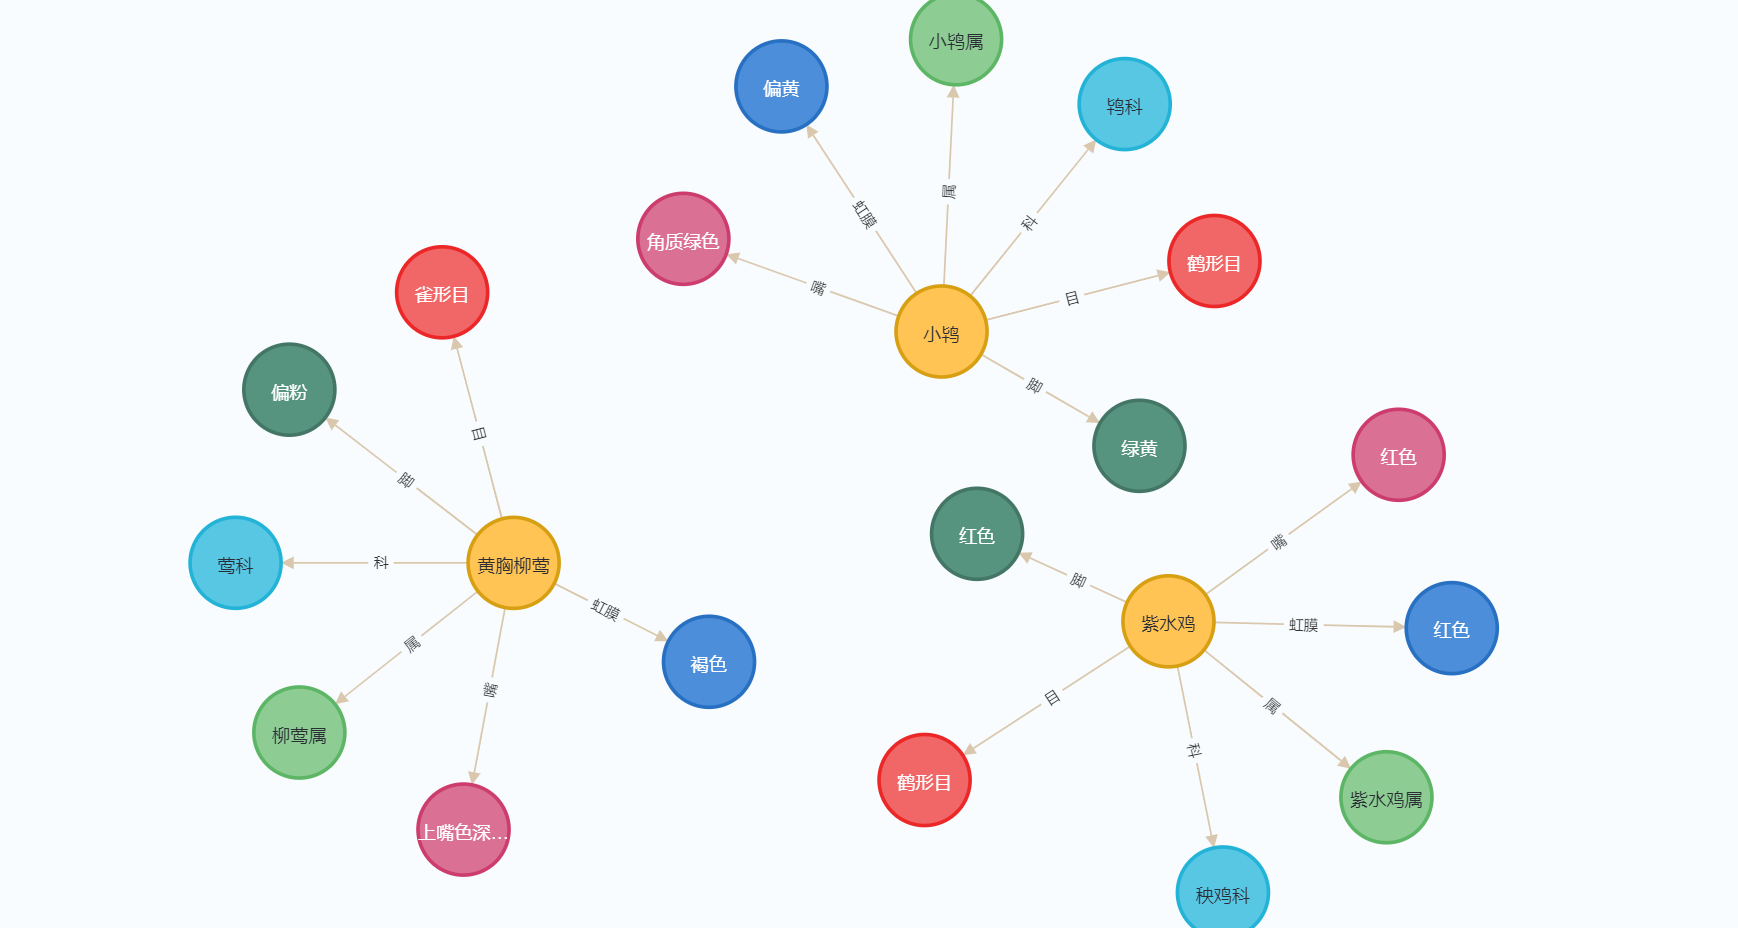
知识图谱一种基于图的数据结构,由节点(Point)和边(Edge)组成。其中节点即实体,由一个全局唯一的ID标示,关系(也称属性))用于连接两个节点。通俗地讲,知识图谱就是把所有不同种类的信息(Heterogeneous Information)连接在一起而得到的一个关系网络。知识图谱提供了从“关系”的角度去分析问题的能力。neo4jneo4j 是目前比较主流的图数据库,存储,查询图谱数据非常高效
neo4j 5.x
需求:如图将下列数据存储到neo4j中步骤:1、启动neo4j数据库neo4j console2、安装py2neo,pip install py2neo3、读取csv文件并存储节点# 导入必要的包import csvfrom py2neo import Graph, Nodefrom dataProcess.entity.article import Articlefrom dataProcess
毕业设计——基于SpringBoot+Neo4j+Spark实现的论文智能分析问答系统(采用朴素贝叶斯分类器)
前言问答系统是NLP在业界最为重要的落地场景之一,但由于其全链路比较复杂,学习的时候难以入手。这是一个基础的图谱构建和问答系统的项目,为大家学习问答系统提供一个思路。ps:之前断断续续写了知识图谱和问答系统的构建,干脆整合成一个完整的github项目,并对知识图谱进行系统性介绍。
本系统是基于neo4j的图谱数据展示系统和问答系统,问题数据主要是基于旅游领域,基本完成以下功能- 关系图谱的展示- 关系图谱的查询- 旅游领域关系图谱的问题- 问题过程包括语句解析--模板匹配--match语句生成--获取结果- 返回结果以及过程的可视化
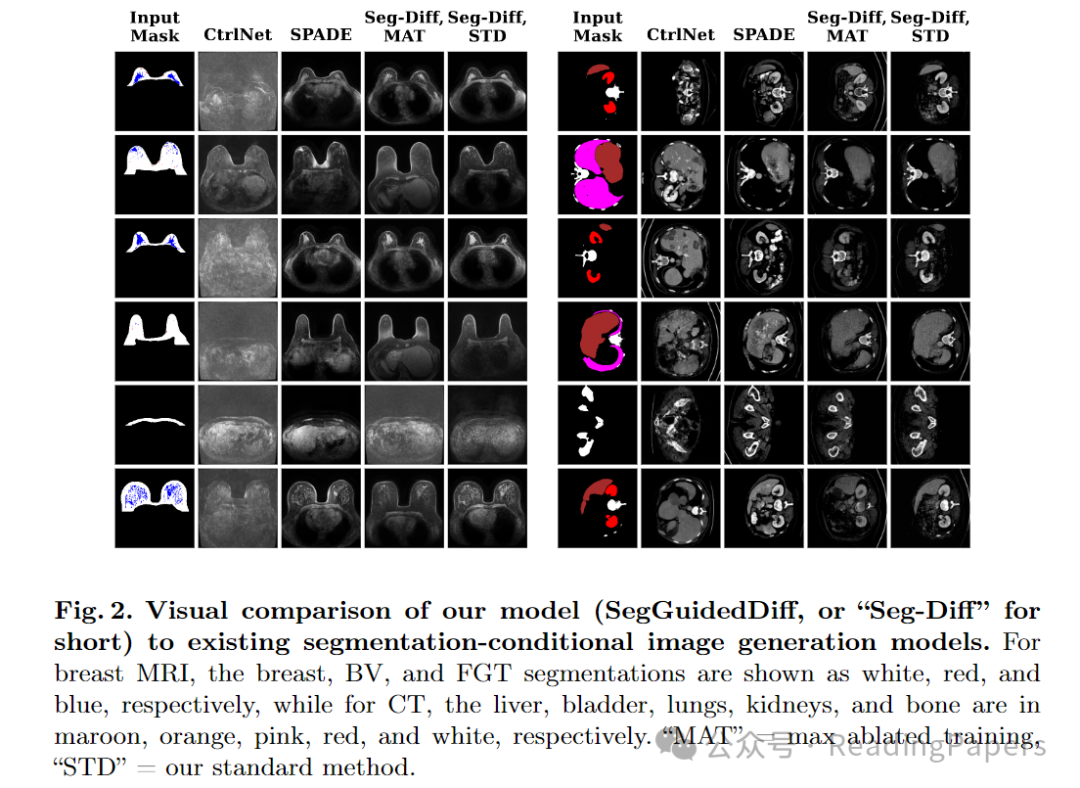
扩散模型使得医学图像生成的质量非常高,但在生成的图像中加入解剖学约束仍然是一个挑战。为此,我们提出了一种基于扩散模型的方法,该方法通过在每个采样步骤中遵循多类解剖学分割掩模来支持解剖学可控的医学图像生成。此外,我们还引入了一种随机掩模消融训练算法,使得在允许其他解剖区域灵活的同时,能够对选定的解剖学约束组合进行条件控制。我们在带有各种解剖对象的乳房 MRI 和腹部/颈部至盆腔 CT 数据集上与现有
针对这些文档性的东西,手工纸质化去管理是非常消耗工作量的,并且纸质化查阅难,易损耗,所以电子化管理显得尤为重要。精准全面的搜索能力,统一化管理,此套知识库管理系统以科学的方法论并且通过实际项目锤炼做到了很好的赋能效应,解决了企事业数字资产的良性全生命周期管理。可根据文档的任意关键字进行全文检索知识,效果如同“百度一下”,简单快速的收集到自己所要查询的知识,解决了纸质化时代的繁琐流程。知识图谱可视化
基于知识图谱+flask的KBQA医疗问答系统基于医疗方面知识的问答,通过搭建一个医疗领域知识图谱,并以该知识图谱完成自动问答与分析服务。基于知识图谱+flask的KBQA医疗问答系统以neo4j作为存储,本系统知识图谱建模使用的最大向前匹配是一种贪心算法,从句首开始匹配,每次选择最长的词语。由于只需一次遍历,因此在速度上相对较快。算法相对简单,容易实现和理解,不需要复杂的数据结构。对于中文文本中
知识图谱 之 python 操作neo4j (导入CSV操作)知识图谱之python操作Neo4j导入CSV构建复杂的知识图谱基于python的Django框架和Neo4j的知识图谱可视化大家可以先看看这几篇文章 在这里面我已经把我们需要的知识图谱给构建好了。然后就是我们的问答环节。因为我们构建的知识图谱就是基于学者网上面的学者信息,所以我们的问答系统也只能回答关于学者网上学者的信息问题。而我们构
知识图谱是一种用于表示和存储知识的图形化知识库,它描述了现实世界中实体、概念、实体间的关系以及属性等信息。知识图谱的构建需要从多个来源收集数据,并使用自然语言处理、机器学习等技术进行数据清洗、实体识别、关系抽取等处理,最终形成一个结构化的知识库。
它是一个嵌入式的、基于磁盘的、具备完全的事务特性的Java持久化引擎,但是它将结构化数据存储在网络(从数学角度叫做图)上而不是表中。程序员工作在一个面向对象的、灵活的网络结构下而不是严格、静态的表中——但是他们可以享受到具备完全的事务特性、企业级的数据库的所有好处。在一个图中包含两种基本的数据类型:Nodes**(节点)** 和 Relationships**(关系)。直接在user目录中创建一个
你是否遇到过这样的问题?想从社交网络中找“两个用户之间的最短关系链”,用SQL写了5层JOIN,结果查询超时;要做电商推荐系统,“找购买过A商品的用户还买了什么”,关系型数据库的多表关联慢得让人崩溃;分析金融欺诈,“识别环状交易链路”,传统方法根本理不清复杂的资金流向。这些关联数据的深度分析,正是传统关系型数据库的“软肋”——而图数据库(Graph Database)和它的查询语言Cypher,刚
知识图谱(Knowledge Graph)是一种用于表示和存储知识的结构化数据模型。它通过节点(Node)和边(Edge)来表示实体(Entity)及其之间的关系(Relationship),形成一个复杂的网络结构。知识图谱的核心在于其能够捕捉实体间的复杂关系,这些关系不仅仅是简单的键值对,而是多维度的、层次化的关联。知识图谱的重要性信息整合:知识图谱能够将分散在不同来源的信息整合在一起,形成一个
Neo4j 是一种高性能图形存储,具有成熟且强大的数据库所需的所有功能,例如友好的查询语言和 ACID 事务。
完整项目资源链接:https://download.csdn.net/download/m0_46573428/87796553项目详细信息请看:https://blog.csdn.net/m0_46573428/article/details/130071302在进入数据处理的模块先需要先选择数据集。功能设计:选择数据集,进入对应的数据处理模块。
个人项目总结:用cypher或python在neo4j导入csv建立知识图谱,建立了一些简单的结点和关系,适合刚接触neo4j的学习(本人也是小白)
python电影知识图谱 电影推荐系统 影视作品 数据分析 可视化 Neo4j图形数据库 协同过滤推荐算法 大数据 毕业设计(建议收藏)✅
文章目录一、Neo4j 的安装与配置1、安装JDK2、安装Neo4j3、Neo4j环境变量配置4、启动服务器二、Neo4j 使用教程一、Neo4j 的安装与配置1、安装JDK由于Neo4j是基于Java的图形数据库,运行Neo4j需要启动JVM进程,因此必须安装JAVA SE的JDK。通过上文搭建的neo4j 服务,是一个空数据库,这个数据库有单独的cql语法,去执行一些操作,针对存储的数据,其实
以IncoPat专利数据库为数据来源,通过构建检索式(IPC=(A01C15/00)) AND (PD=[20220101 TO 20230101])筛选出2022年施肥机械相关的数据,共获取到1901条专利数据。只是想记录一下自己的课程作业,如果对读者也有一些帮助就更好啦!专利号,专利的唯一标识符,包含属性title:专利的中文标题。专利的类型,共有三种:发明申请、发明授权、实用新型。该本体结构
neo4j是使用最广泛的中小型图数据库,提供了图形操作界面和cypher查询语言。这里尝试基于docker构建neo4j环境,并使用python进行图数据库的基本操作。示例代码参考和修改自网络资料。
Dify是一款开源的LLM应用开发平台,专为简化AI应用构建而设计,适合非技术用户使用。它通过低代码和模块化设计,让用户能够像搭积木一样创建专业级AI应用。Dify支持多种AI功能,包括聊天助手、文本生成、智能代理和工作流程自动化。特别地,Dify与RAG(检索增强生成)技术结合,可以快速构建智能知识库,支持多种检索方式如向量搜索、全文搜索和混合搜索。此外,Dify还支持智能代理的创建,用户可以通
本文给出了b站的一个知识图谱构建实例-构建红楼梦知识图谱,基于neo4j,给出了实现过程
一、安装环境操作系统:CentOS7JDK版本:1.8工具:Xshell6、Xftp6二、安装步骤Neo4j是基于Java的图形数据库,运行Neo4j需要启动JVM进程,因此必须安装JAVA SE的JDK。1:下载安装包liunx环境Neo4j下载地址:https://neo4j.com/download/other-releases/#releases(社区版免费...
未来,我们将继续探索这两种技术的结合,提升智能体的能力。我们的方法更进一步,通过结合 Neo4j (https://neo4j.com/) 来捕捉实体和概念之间的关系,提供更细致的信息理解。该智能体结合了 图数据库和向量搜索的强大功能,能够为用户查询提供准确和相关的答案。魔法发生在这里:我们的智能体能够结合来自 Milvus 和 Neo4j 的结果,从而更好地理解信息,提供更准确和细致的答案。–
【代码】Neo4j 5.26.x容器 APOC插件Generating Graphs无法正常使用解决方法/Neo4j 5.26.x容器安装APOC拓展库。
图数据库是处理复杂关联数据的利器,但当数据规模达到千万级节点/亿级关系时,原本高效的图遍历会陷入性能瓶颈——全图扫描、深度遍历超时、索引失效等问题频发。本文从Neo4j的底层存储引擎和查询执行模型出发,结合第一性原理拆解性能瓶颈的本质,系统讲解从数据建模到分布式部署如何通过索引设计将查询时间从分钟级压缩到毫秒级?如何用Cypher优化避免90%的无效遍历?如何通过分布式架构支撑万亿级图数据的低延迟
一 Neo4j 简介Neo4j是一个高性能的,NOSQL图形数据库,它将结构化数据存储在网络上而不是表中。Neo4j也可以被看作是一个高性能的图引擎,该引擎具有成熟数据库的所有特性。程序员工作在一个面向对象的、灵活的网络结构下而不是严格、静态的表中——但是他们可以享受到具备完全的事务特性、企业级的数据库的所有好处。1.1 图形数据结构在一个图中包含两种基本的数据类型:Nodes(节点) 和 Rel
解决 AuraDB 的 Neo4j 连接报错问题