生成对抗网络Generative Adversarial Networks(GANs)----数学细节Mathematic Details
·
生成对抗网络Generative Adversarial Networks(GANs)
----数学细节Mathematic Details
神经网络建模本质上需要定义两件事:
- 架构
- 损失函数
生成对抗网络的架构。
它由两个网络组成:
- 一个生成网络G(.),它接受具有密度p_z的随机输入z,并返回输出x_g = G(z),该输出应遵循(训练后)目标概率分布
- 判别网络D(.)接受输入x,可以是“真实”的(x_t,其密度表示为p_t)或“生成”的(x_g,其密度p_g是密度p_z通过G的密度所诱导的密度),并返回x的概率D(x)为“真实”数据
GAN的“理论”损失函数
以相同的比例向判别器发送“真实”和“生成”数据,那么判别器的预期绝对误差可以表示为:
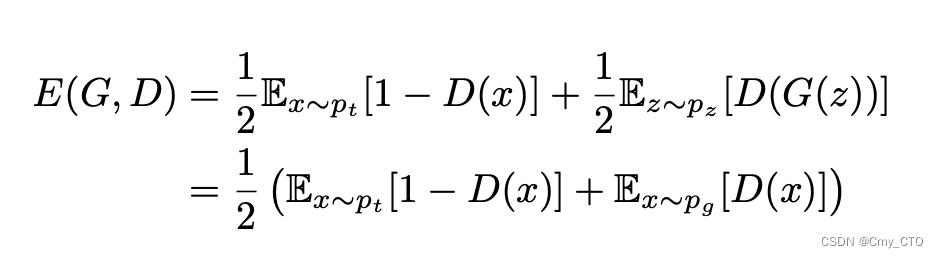
生成器的目标:愚弄辨别者,
其目标是能够区分真实数据和生成的数据。
因此,在训练生成器时,我们希望最大化(Maximize)此误差,
同时尝试为鉴别器最小化它。
它给了我们
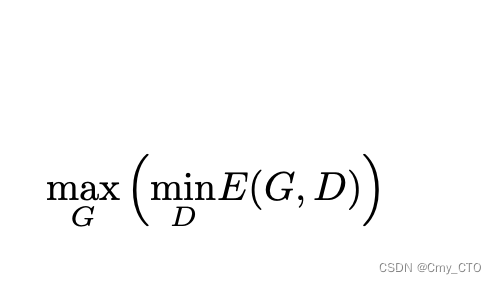
对于任何给定的生成器G(以及诱导概率密度p_g),最好的鉴别器是最小化:
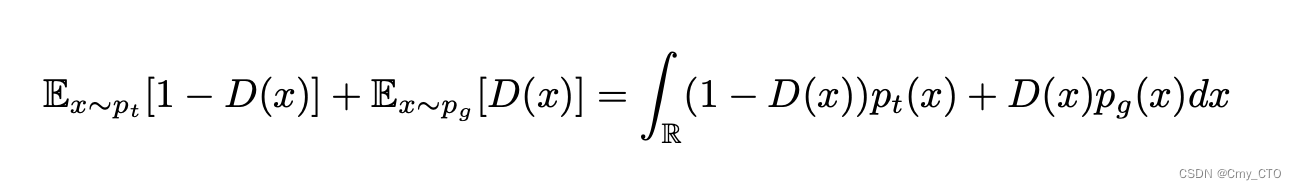
为了最小化(关于D)这个积分,
我们可以:
- 最小化x每个值的积分内的函数。
然后,
- 它为给定的生成器定义了最佳的鉴别器
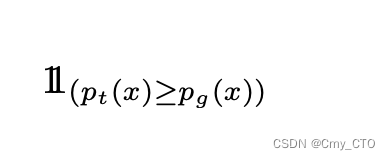
(事实上,最好的之一,因为x值,例如p_t(x)=p_g(x)可以用另一种方式处理,但以下内容并不重要)。
然后我们搜索最大化的G
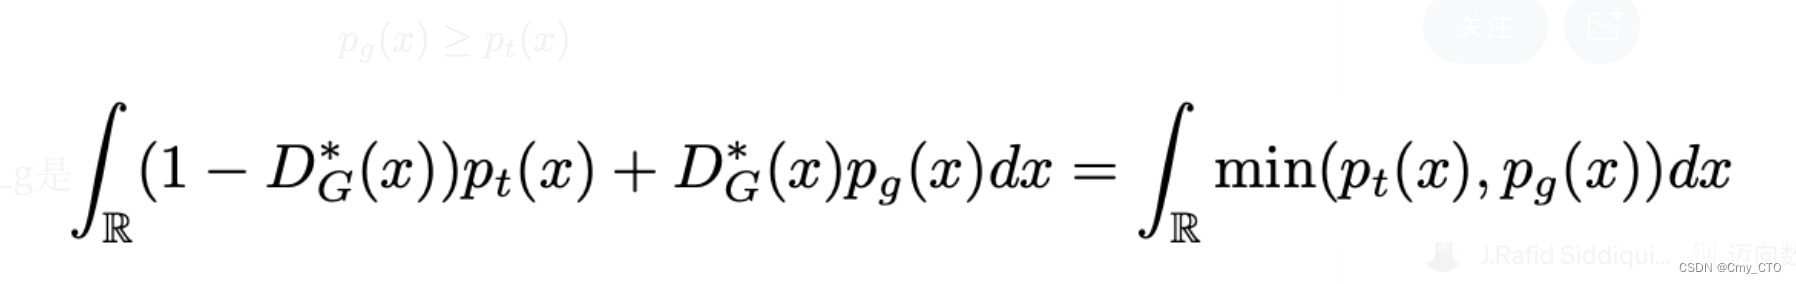
同样,为了**最大化(关于G)**这个积分,
我们可以: - 最大化x每个值的积分内的函数。
由于密度p_t独立于生成器G,我们不能比设置G做得更好。
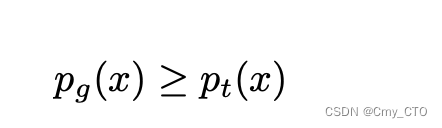
由于p_g是一个概率密度,应该积分到1,我们必然有最好的G,
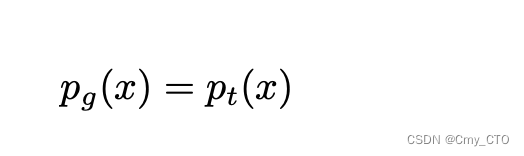
已经表明:
在具有无限容量生成器和判别器的理想情况下,对抗设置的最佳点是:
生成器产生与真实密度相同的密度,判别器不能比在两种情况中的一种情况下更真实,
注意:G最大化
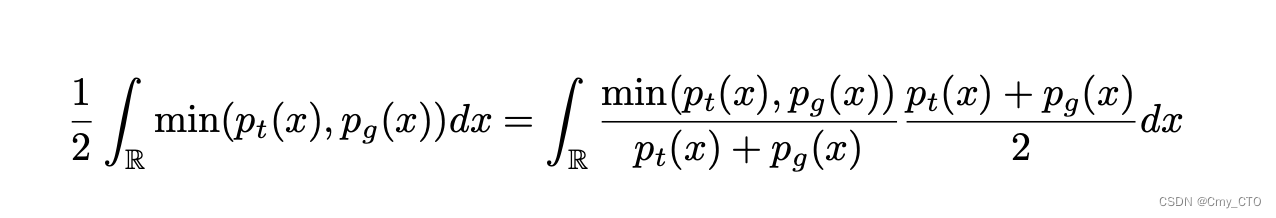
在这种形式下,我们最好看到G希望最大限度地提高鉴别者出错的预期概率。
(i.e. Maximize G)

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 2
 0
- 0


 已为社区贡献2条内容

所有评论(0)