[机器学习笔记] K-mean聚类算法即实现代码
-在机器学习领域有一个非常特殊的存在——无监督学习, 其中最为经典就是聚类算法了。聚类算法因为其不需要先验标签,因此在很多领域应用都较为广泛,其中最经典的算法就是Kmean Cluster。
1. K-mean聚类算法原理
对于给定的样本集,K-means按照样本之间的距离大小,将样本集划分为K个簇。让簇内的点尽量紧密的连在一起,而让簇间的距离尽量的大。
Kmean聚类的算法如下:
- 对于K个簇,随机生成K个随机点作为中心点。
- 对剩下的所有样本点计算到K个中心点的距离,并将自己标识为和距离自己最近的中心点同一个类别。
- 对得到的K个簇,重新计算每个簇的中心点,也就是簇 C_i 中所有样本的均值向量
- 基于新的中心点,再次把每个样本重新标识为和自己最近的中心点一样的类别,也就得到了新的K个簇
- 重复3-4步知道中心点不再有变化为止
2. K-mean的几种距离计算
K-mean聚类算法中可以使用不同的距离计算方式,除了最常见的欧式距离,还可以使用曼哈顿距离,余弦距离等。对这几种距离的定义如下。
-
欧式距离(Euclidean Distance)
这就是最为常用的距离计算方法,计算公式如下
V1=x0,x1,...xn,V2=y0,y1,...ynV1={x_0,x_1,...x_n},V2={y_0,y_1,...y_n}V1=x0,x1,...xn,V2=y0,y1,...yn
d12=∑i=0n(xi−yi)2d_{12}=\sqrt{\sum_{i=0}^n(x_i-y_i)^2}d12=i=0∑n(xi−yi)2 -
曼哈顿距离(Manhattan Distance)
纽约
曼哈顿的街道规划是非常整齐的块状,街道纵横交错,从一个地方到另一个地方,需要经过的距离是走过的纵向和横向街道的距离和,这就是所谓的曼哈顿距离。
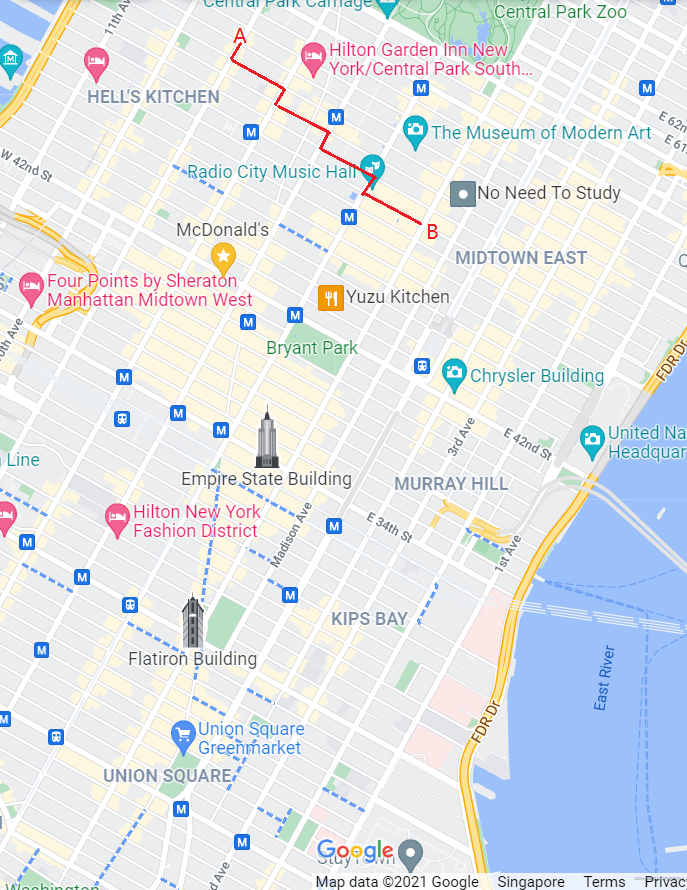
计算公式如下:
V1=x0,x1,...xn,V2=y0,y1,...ynV1={x_0,x_1,...x_n},V2={y_0,y_1,...y_n}V1=x0,x1,...xn,V2=y0,y1,...yn
d12=∑i=0n∣xi−yi∣d_{12} = \sum_{i=0}^{n}|x_i-y_i|d12=i=0∑n∣xi−yi∣ -
余弦距离(Cosine)
cosine(θ)=V1.V2∣V1∣∣V2∣cosine(\theta)= \frac{V1.V2}{|V1||V2|}cosine(θ)=∣V1∣∣V2∣V1.V2
3. K-mean聚类算法的数据预处理
3.1 数值类型的特征数据
因为Kmean算法是通过计算离散的点之间的距离来判定类别的,因此对数据的预处理,归一化就变得很重要。如果输入的数据值差异很大,那么在计算距离时一些值比较大的特征就会对距离的影响比较大,反之一些数值较小的特征对于距离计算的影响就会比较小。比如,年龄的范围在0-100,而收入的范围可能时1000-100,000之间,显然在聚类时收入的形象就会比年龄大出10-1000倍。为了排除这种特征本身数值范围对聚类的影响,对输入特征数据进行归一化就显得非常的重要了。
数值型数据的归一化有两种方式:
- Min-Max Normalization: 通过线性变换把数值数据映射到一个区域里,比如[0-1]之间。这种方法适用于特征数据在某特特定的值域内,比如年龄可以设定在0-150之间,比较目前还没有超过150岁的人类出现。
转换方法: X=x−minmax−minX= \frac{x-min}{max-min}X=max−minx−min - Z-score standardize: 这种方法使用原始数据的均值(mean)和标准差(standard deviation)进行数据的标准化。经过处理的数据符合标准正态分布,即均值为0,标准差为1。这种方法适用于特征数据没有明确的上下限,比如年收入,最高收入始终可以被刷新,现在的训练数据可能无法覆盖未来实际数据的值域。
转换方法:X=x−meanstdX=\frac{x-mean}{std}X=stdx−mean
mean是X的均值,std是他的标准差mean是X的均值,std是他的标准差mean是X的均值,std是他的标准差
3.2 类别类型的特征数据
对于类别型的特征数据,分两类进行处理。
- 第一类是有层级关系的类别,比如受教育程度。文盲,小学,初中,高中,大学本科,硕士学历,博士学历,这显然是有一个层级关系的,相比小学,博士学历和文盲之间的差距显然要更大一些。对于这种类别特征,我们可以通过编码将他们转换成数值类型,比如我们可以将受教育程度转变成受教育年限,文盲,小学,初中依次可以对应与受教育年限0年,5年,9年,等。
- 第二类就是无层级关系的类别,比如性别,职业等。这些类别需要转换成数值形式,但不可以用1,2,3,这样有大小关系的数值来表示,因为这样编码就会拉大了一些类别之间的距离。我们应该用OneHot的编码方式将他们转换成哑码 —— 这是我自己定义的,就是说每个编码除了表示不同的类别之外不包含任何其他信息。以性别位例,我们可以将性别栏转换成性别男,性别女两栏,对于原来的性别为男的,性别男栏数据为1,性别女栏数据为0,反正亦然。
原数据:
| 索引 | 姓名 | 性别 |
|---|---|---|
| 1 | 张三 | 男 |
| 2 | 李四 | 女 |
| 3 | 刘五 | 男 |
转换后数据:
| 索引 | 姓名 | 性别男 | 性别女 |
|---|---|---|---|
| 1 | 张三 | 1 | 0 |
| 2 | 李四 | 0 | 1 |
| 3 | 刘五 | 1 | 0 |
把一个类别特征数据转换成哑码,在这个类别中有多少个不同的类别值,那么就要产生多少个新数据栏,每个数据栏仅有两个值,0或1。
4. K值的选取和K-mean算法的衡量
4.1 聚类算法的评估指标
对聚类算法的评估指标有silhouette score和calinski harabasz scores两种。
- 轮廓系数(silhouette score): 这个指标是用来衡量每个簇内部的聚合度。
计算方法:
对于每个数据点 i∈Ci{\displaystyle i\in C_{i}}i∈Ci (数据点 i{\displaystyle i}i 在簇内部 Ci{\displaystyle C_{i}}Ci), 让
a(i)=1∣Ci∣−1∑j∈Ci,i≠jd(i,j){\displaystyle a(i)={\frac {1}{|C_{i}|-1}}\sum _{j\in C_{i},i\neq j}d(i,j)}a(i)=∣Ci∣−11j∈Ci,i=j∑d(i,j)
Ck是与CiC_{k}是与C_{i}Ck是与Ci距离最近的簇,对于每个数据点 i∈Ci{\displaystyle i\in C_{i}}i∈Ci (数据点 i{\displaystyle i}i 在簇内部)
b(i)=1∣Ck∣∑j∈Ckd(i,k){\displaystyle b(i)={\frac {1}{|C_{k}|}}\sum _{j\in C_{k}}d(i,k)}b(i)=∣Ck∣1j∈Ck∑d(i,k)
定义a:一个样本与同一簇类中的其他样本点的平均距离;
定义b:一个样本与距离最近簇类中所有样本点的平均距离;
silhouettescore=b−amax(a,b)silhouette score=\frac{b-a}{max(a,b)}silhouettescore=max(a,b)b−a
轮廓系数处于[-1,1]的范围内,-1表示错误的聚类,1表示高密度的聚类,0附近表示重叠的聚类。
- calinski-harabasz Index: 这个指标是用来衡量每个簇和其它簇的距离。
计算方法:
对于一组规模为nEn_EnE 的数据集 EEE,聚类成kkk个簇,
calinski−harabaszIndex=tr(Bk)tr(Wk)∗nE−kk−1calinski-harabasz Index=\frac{tr(B_k)}{tr(W_k)}*\frac{n_E-k}{k-1}calinski−harabaszIndex=tr(Wk)tr(Bk)∗k−1nE−k
其中tr(Bk)tr(B_k)tr(Bk)为簇间离散矩阵的积,tr(Wk)tr(W_k)tr(Wk)为簇内离散矩阵的积,定义如下:
Bk=∑q=1knq(cq−cE)(cq−cE)TB_k=\sum^k_{q=1} {n_q(c_q-c_E)(c_q-c_E)^T}Bk=q=1∑knq(cq−cE)(cq−cE)T
Wk=∑q=1k∑x∈Cq(x−cq)(x−cq)TW_k=\sum^k_{q=1} \sum_{x \in C_q}{(x-c_q)(x-c_q)^T}Wk=q=1∑kx∈Cq∑(x−cq)(x−cq)T
其中 CqC_qCq为簇 q 中的样本集合,cqc_qcq 为簇 qqq的中心,cEc_EcE为数据集EEE的中心,nqn_qnq 为簇 qqq 中的样本数。
此外,常用的方法还有 手肘法(Elbow),这个方法适用于K值比较小的时候,查看在不同K值下的损失函数的值,并作图。选取损失函数值下降趋势明显变小的这个点,就是最佳的K值选取点。
4.2 K值的选取
我们可以根据我们的需要设定一个聚类评估标准,然后根据这个评估标准来选取最佳的K值。此处我们以轮廓系数为例,来看一个实列。
首先,我们用make_blobs来生成一组数据,1000个数据点,5个中心。
x, y = make_blobs(n_samples=1000, n_features=2, centers=5)
plt.scatter(x[:,0],x[:,1],c=y)
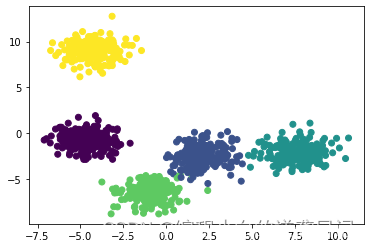
我们对它用kmean算法进行聚类,分别设分类为3,4,5,6,7,然后来看一下使用手肘法得到的图像结果。
Sum_of_squared_distance = []
for n_clusters in range(3,7)
	model = KMeans(n_clusters=n_clusters, init="random", random_state=8).fit(x)
	labels = model.predict(x)
	Sum_of_squared_distance.append(model.inertia_)
plt.plot([3,4,5,6,7], Sum_of_squared_distance, 'bx-')
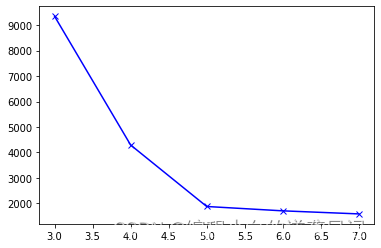
在Kmean模型中inertia_参数是每个样本到它们最近的聚类中心的距离平方和,在sklearn的KMeans对象中inertia_属性就记录了该值。作图,从图中可以容易的发现,从k=5起该平方和值的递减变小,由此可以确定选择K值为5是最佳的。
同时,我们使用轮廓系数来确定K值。计算轮廓系数可以直接使用sklean.metrics对象下的方法silhouette_score, 其参数包括x值,kmean输出的类别值,以及计算距离的方法,此处我们选择euclidean即使用欧氏空间的距离计算规则。
from sklearn import metrics
for n_clusters in range(3,8)
	model = KMeans(n_clusters=n_clusters, init="random", random_state=8).fit(x)
	labels = model.predict(x)
	silhouette_score = metrics.silhouette_score(
        x,
        labels,
        metric='euclidean'
	)
	print("K=%d, silhouette_score=%.6f"%(n_clusters,silhouette_score))
得到输出:
K=3, silhouette_score=0.559099
K=4, silhouette_score=0.639296
K=5, silhouette_score=0.701195
K=6, silhouette_score=0.630837
K=7, silhouette_score=0.542077
可见当K=5的时候, 轮廓系数分值最高,这个结论也是和手肘法是相互验证的。
但情况并不总是如此,在一些边界模糊的分类中,轮廓系数显示的结果和手肘法不一样。比如,我们生成的数据如下所示。
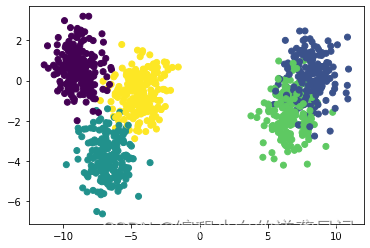
当K分别等于2到7时,我们得到的聚类结果如下图所示: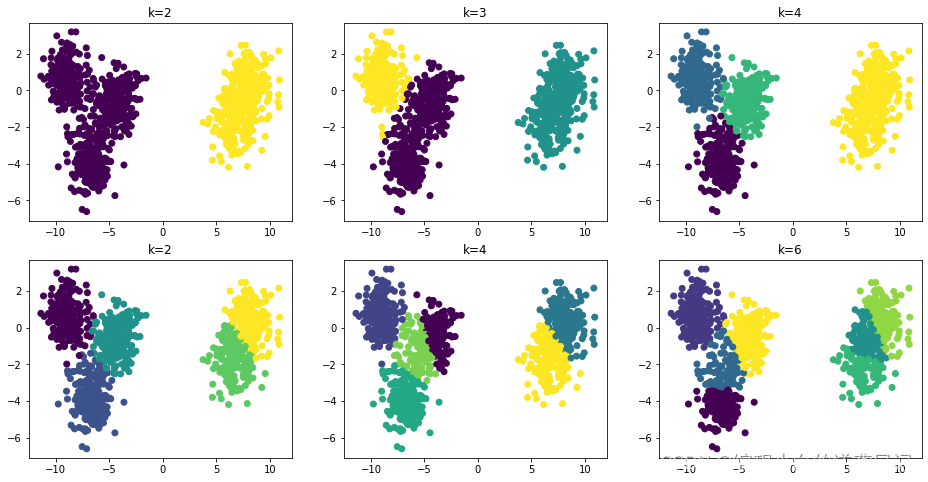
由于这个数据分布中三个类别聚集在图像左边,二另外两个类别聚集在图像右边,因此从图像上看,分成两大类或四类(左三类,右一类)都是合理的。那如果参考手肘法和轮廓系数又会得到什么样的结论呢?
首先我们来看一下轮廓系数,确实如先前所说,K=2和4时轮廓系数都是最大的。
K=2, silhouette_score=0.773288
K=3, silhouette_score=0.618731
K=4, silhouette_score=0.667729
K=5, silhouette_score=0.513711
K=6, silhouette_score=0.441556
K=7, silhouette_score=0.409318
再看手肘法的结果,你会惊讶的发现手肘法依旧显示在K=5的时候是最优,K值继续增加后距离平方和的减小不再明显。
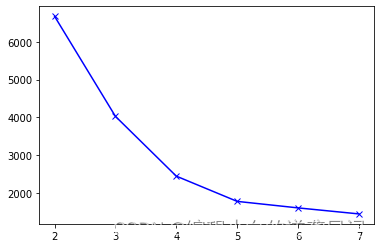
由此可见,轮廓系数和手肘法在评估上的侧重点是不同的的,轮廓系数同时侧重类别内部的聚合度以及和其他类别的的距离,仅从图像上看该数据分成两类也是有其合理性的,但是手肘法的结果却非常一致,他仅考虑点和中心的距离,而不考虑不同类别之间的距离,因此他给出的结果始终是5个类。因此,在考虑K值时还是主要从实际需求出发,考虑多种评估手段的结果,做出判断。
5. PCA降维在聚类算法中的应用
PCA降维算法是将高维的数据降维到低维数据,并尽可能的保留最多的特征。比如,我们的数据有100个特征,对100个特征的数据进行聚类,那计算效率比如很低,但如果我们可以将其降维到5个特征且最大程度的保留原有100个特征中的信息,再进行聚类就会很大程度上提高计算效率。
这里需要注意的是这5个降维后的特征和原来100个特征不存在一对一的对于关系,也就是说这5个新的特征中的任何一个都是原来100个特征经过信息提取综合后的综合体。
PCA降维的核心思想就是矩阵的特征值和特征向量。读书时学习矩阵的特征值和特征向量,那是就纳闷什么叫特征,现在终于明白了就是包括矩阵最大的信息量的向量。
PCA降维的基本步骤如下:
- 用x减去x每一行的均值,这是为了对x做归一化处理
- 对与m行n列的数据x(有m条记录,每条记录有n个特征)首先计算他和他的协方矩阵 C=X.XTC = X.X^TC=X.XT,C的维度应该是nxnnxnnxn的。
- 求C的特征值和特征向量。
- 对特征值和特征向量对按照特征值从大到小的秩序进行排序。
- 根据给定的降维的维度p提取前p个特征向量组成n∗pn*pn∗p的矩阵A
- x点乘A得到m∗pm*pm∗p的降维后的矩阵,该矩阵以及是m行数据,每行数据又p个特征数据。
以下为numpy实现代码:
import numpy as np
# Generate a numpy array with 10000 recorders and each recorder contains 12 features
x = np.random.randn(10000, 12)
# For each value in the matrix, reduce its row mean
x -= x.mean(axis=0)
# Calculate the cov matrix
C = np.dot(x.T,x)
eigvalue, eigvector = np.linalg.eig(C)
# Get the sort index of eigen values (large -> small)
new_index = np.argsort(eigvalue)[::-1]
# Sort the eigen vetors according to the eigen value index, choose to the top 30 (reduce the deminsion to 30)
A = -eigvector[:,new_index].T[: 30]
x_cal_reduced_dimension = x.dot(A[:30].T)
# Print out the first data recorders
print("result from manual calculation")
print(x_cal_reduced_dimension[0])
print("components")
print(A)
print("explained variance ")
print(eigvalue[:3])
print("explained variance ratio ")
print((eigvalue/eigvalue.sum())[:3])

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 4
 0
- 0


 已为社区贡献3条内容

所有评论(0)