【机器学习】梯度下降、岭回归、Lasso回归等
·
【机器学习】梯度下降、岭回归、Lasso回归等
0 简要复习线性回归(Linear Regression)
- 线性回归模型函数:y(x)=β0+β1∗x1+β2∗x2y(x) = \beta_0+ \beta_1*x_1+ \beta_2*x_2y(x)=β0+β1∗x1+β2∗x2 或 y(x)=∑i=0nbetai∗xi=BTXy(x) = \sum_{i=0}^{n} beta_i*x_i = B^TXy(x)=∑i=0nbetai∗xi=BTX
- 参数估计的评价机制: 损失函数(loss function) 或 错误函数(error function) 或 评价函数 —— 真实值和预测值之间的误差,最小二乘思维
- 均方误差损失函数(mean squared error loss):MSE=1n∑i=1n(yi^−yi)2MSE=\frac{1}{n}\sum_{i=1}^{n}(\hat{y_i} -y_i)^2MSE=n1∑i=1n(yi^−yi)2
- 平方损失函数(Square Loss):J(θ)=12∑i=1m(hθ(x(i))−y(i))2=(y−Xθ)T(y−Xθ)J(\theta)=\frac{1}{2}\sum_{i=1}^{m}(h_{\theta}(x^{(i)}) -y^{(i)})^2 = (y-X\theta)^T(y-X\theta)J(θ)=21∑i=1m(hθ(x(i))−y(i))2=(y−Xθ)T(y−Xθ),对x(i)的估计值与真实值y(i)差的平方和作为错误估计函数,通过乘以0.5消除系数
- 为什么损失函数要用平方和?
- x,y的条件概率(正态分布):p(y(i)∣x(i);θ)=12πσexp(−(y(i)−θTx(i))22σ2)p(y^{(i)}|x^{(i)};\theta)=\frac{1}{\sqrt{2\pi}\sigma}exp(-\frac{(y^{(i)}-\theta^Tx^{(i)})^2}{2\sigma^2})p(y(i)∣x(i);θ)=2πσ1exp(−2σ2(y(i)−θTx(i))2);
- 最大似然求解:12∑i=1m(y(i)−θTx(i))2\frac{1}{2}\sum_{i=1}^{m}(y^{(i)} - \theta^Tx^{(i)})^221∑i=1m(y(i)−θTx(i))2
- 目标:如何调整θ以使得J(θ)取得最小值 argminθJ(θ)argmin_\theta J(\theta)argminθJ(θ)问题
1 梯度下降法
- 梯度下降法问题:结果与初始点的选取有关,可能只能得到全局极小值
- 注意点:此处不是随机梯度下降法(均方误差损失函数是凸函数);注意特征归一化
- 步骤:
- 第一步:首先对θ赋初值,初值选择:1)随机;2)全零向量
- 第二步:迭代更新改变θ的值,使得J(θ)按梯度下降的方向进行减少,其中梯度方向由J(θ)对θ的偏导数的反方向确定,即:θj:=θj+α(y(i)−hθ(x(i)))xj(i)\theta_j:=\theta_j+\alpha(y^{(i)}-h_\theta(x^{(i)}))x_j^{(i)}θj:=θj+α(y(i)−hθ(x(i)))xj(i),以下为两种迭代更新方法:
- 批梯度下降:对全部的训练数据求得误差后,再对θ进行更新,能够不断收敛
- 增量梯度下降:每扫描一步都要对θ进行更新,不断在收敛处徘徊
2 最小二乘法 OLS
- 方法:求偏导,即θ=(XTX)−1XTy\theta = (X^TX)^{-1}X^Tyθ=(XTX)−1XTy
- 缺点:要求X是列满秩;求矩阵的逆比较慢
- 改进:对于不能直接求矩阵的逆的解决方案 —— θ=(XTX+δ2Id)−1XTy\theta = (X^TX + \delta^2I_d)^{-1}X^Tyθ=(XTX+δ2Id)−1XTy (这一步是工程实践结果,意外发现和 岭回归损失函数求偏导一样)
3 岭回归(Ridge Regression)与Lasso回归(Lasso Regression)
- 描述/核心思想:
- 通过损失最小二乘法的无偏性(有偏估计),以损失部分信息、降低精度为代价,提升数值稳定性泛化能力,获得回归系数更为符合实际、更可靠的回归方法
- 特征选择
- 特殊针对:
- 训练样本数量少(甚至少于样本维数),即矩阵无法求逆;
- 样本特征大量相似,即很多参数意义重复(共线性)
- 损失函数:
- 线性回归(J0=(y−Xθ)T(y−Xθ) or ∑i=1m(hθ(xi)−yi)2J_0 = (y-X\theta)^T(y-X\theta) \ or\ \sum_{i=1}^{m}{(h_\theta (x^i ) - y^i )^2 }J0=(y−Xθ)T(y−Xθ) or ∑i=1m(hθ(xi)−yi)2),正则因子(模型参数向量的范数) * 其中m为观察数,n为变量数
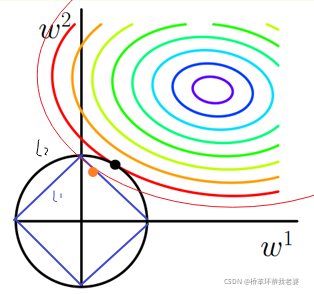
- 岭回归:J(θ)=J0+δ2∑j=1nθj2J(\theta) = J_0 + \delta^2\sum_{j=1}^{n}\theta_j^2J(θ)=J0+δ2∑j=1nθj2 (θTθ\theta^T\thetaθTθ,L2范数,即高斯分布) —— 消除共线性;模的平方处理
- Lasso回归:J(θ)=J0+δ2∑j=1n∣θj∣J(\theta) = J_0 + \delta^2\sum_{j=1}^{n}|\theta_j|J(θ)=J0+δ2∑j=1n∣θj∣(使用模型参数向量的L1范数,即拉普拉斯分布)—— 压缩变量(降维);模的平方处理
- 理解:
- 差异:
- Lasso能够实现提取有用特征、删除无效变量(即将系数设置零,直接消除影响)
- Lasso回归计算更复杂,因为第一范数不是连续可导的
4 权衡:弹性网络回归(ElasticNet Regression)
- ElasticNet 回归,即岭回归和Lasso技术的混合,使用 L1, L2 范数作为先验正则项训练的线性回归模型。
- 为什么有 ElasticNet?
- Lasso回归太过(太多特征被稀疏为0) —— 允许少量参数被稀疏(比如共线变量Lasso只选择一个,Elastic可能选择两个)
- 岭回归也正则化的不够(回归系数衰减太慢) —— 保持正则化强度与Ridge的稳定性
- 为什么有 ElasticNet?
- 公式:
- Min(12m[J0+λ∑j=1nθj2]+λ∑j=1n∣θ∣)Min( \frac{1}{2m} [ J_0 + \lambda \sum_{j=1}^{n} \theta_j^2 ] + \lambda \sum_{j=1}^{n} |\theta| )Min(2m1[J0+λ∑j=1nθj2]+λ∑j=1n∣θ∣)
- Min(12mJ0+α(1−ρ)2∣θ∣∣22+αρ∣∣θ∣∣1)Min( \frac{1}{2m}J_0 + \frac{\alpha(1-\rho)}{2}|\theta||_2^2 + \alpha\rho ||\theta||_1 )Min(2m1J0+2α(1−ρ)∣θ∣∣22+αρ∣∣θ∣∣1),α接近0时ElasticNet接近Lasso;当α从1到0,目标函数的稀疏解从0逐渐增加
- 代码
from sklearn import linear_model
#得到拟合模型,其中x_train,y_train为训练集
ENSTest = linear_model.ElasticNetCV(alphas=[0.0001, 0.0005, 0.001, 0.01, 0.1, 1, 10], l1_ratio=[.01, .1, .5, .9, .99],  max_iter=5000).fit(x_train, y_train)
#利用模型预测,x_test为测试集特征变量
y_prediction = ENSTest.predict(x_test)
致谢:
高永峰_GYF(https://www.jianshu.com/p/aadad14db00e)
mantch(cnblogs.com/mantch/p/10242077.html)
魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐
 1
 0
- 0


 已为社区贡献4条内容

所有评论(0)