小白也可以部署私有化大模型知识库
透过产品了解RAG技术原理,对未来大模型应用开发也将起到事半功倍的效果。
虽然网络上有很多此类技术文章,这里自己也进行一次总结,加深印象的同时给小伙伴做一个参考,多多交流。
准备
-
Linux服务器、windows也可以
-
Docker环境,记得安装docker-compose指令
-
GPT账号(我用的是Azure的账号)one-api也支持多类大模型账号
RAG原理介绍
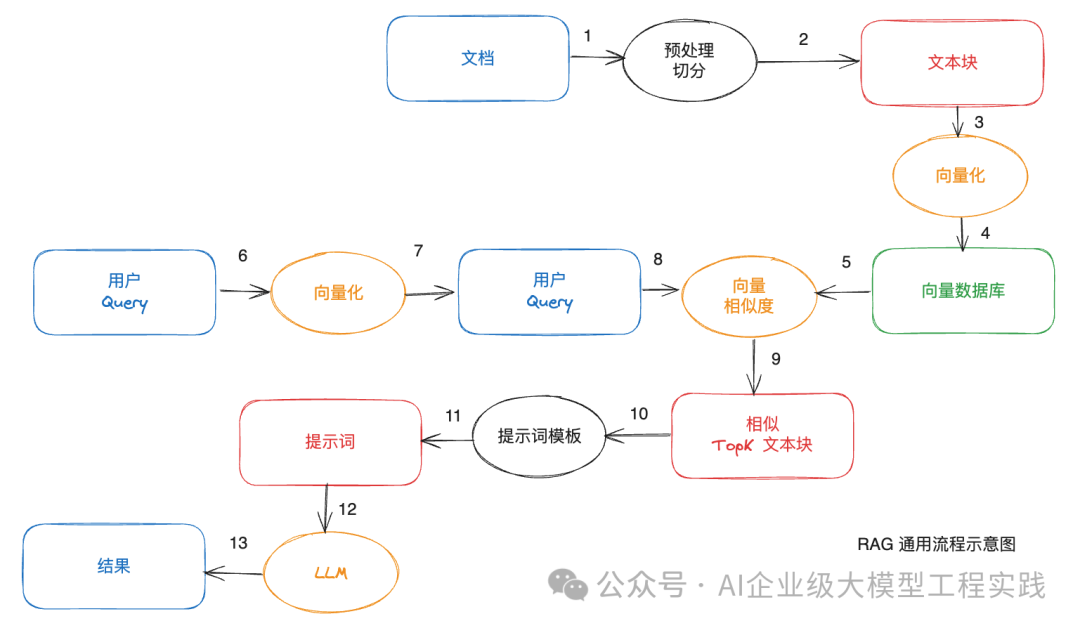
RAG技术原理图可以看到,通过检索获取相关的知识并将其融入Prompt,让RAG技术是一种检索增强生成的技术,它通过检索获取相关的知识并将其融入Prompt,让大模型能够参考相应的知识从而给出合理回答。因此,可以将RAG的核心理解为“检索+生成”,前者主要是利用向量数据库的高效存储和检索能力,召回目标知识;后者则是利用大模型和Prompt工程,将召回的知识合理利用,生成目标答案。
RAG架构包含数据准备和应用两个阶段:数据准备阶段主要是将私域数据向量化后构建索引并存入数据库的过程;应用阶段则是用户提问——>数据检索(召回)——>注入Prompt——>LLM生成答案。
FastGPT服务部署
FastGPT 是一个基于 LLM 大语言模型的知识库问答系统,提供开箱即用的数据处理、模型调用等能力。同时可以通过 Flow 可视化进行工作流编排,从而实现复杂的问答场景!
FastGPT提供开源版本支持私有化部署,同时也提供在线版本,可自行体验,这里是官网介绍。
FastGPT支持多种本地化部署方式,这里采用Docker-compose的方式部署
- 下载配置文件docker-compose.yml、config.json
mkdir fastgpt``cd fastgpt``curl -O https://raw.githubusercontent.com/labring/FastGPT/main/files/deploy/fastgpt/docker-compose.yml``curl -O https://raw.githubusercontent.com/labring/FastGPT/main/projects/app/data/config.json
2、启动容器服务
可自行修改yml文件配置,指定暴露的端口
# 在 docker-compose.yml 同级目录下执行``docker-compose pull``docker-compose up -d``version: '3.3'``services:` `pg:` `#image: ankane/pgvector:v0.5.0 # git` `image: registry.cn-hangzhou.aliyuncs.com/fastgpt/pgvector:v0.5.0 # 阿里云` `container_name: pg` `restart: always` `ports: # 生产环境建议不要暴露` `- 5432:5432` `networks:` `- fastgpt` `environment:` `# 这里的配置只有首次运行生效。修改后,重启镜像是不会生效的。需要把持久化数据删除再重启,才有效果` `- POSTGRES_USER=username` `- POSTGRES_PASSWORD=password` `- POSTGRES_DB=postgres` `volumes:` `- ./pg/data:/var/lib/postgresql/data` `mongo:` `#image: mongo:5.0.18` `image: registry.cn-hangzhou.aliyuncs.com/fastgpt/mongo:5.0.18 # 阿里云` `container_name: mongo` `restart: always` `ports: # 生产环境建议不要暴露` `- 27017:27017` `networks:` `- fastgpt` `environment:` `# 这里的配置只有首次运行生效。修改后,重启镜像是不会生效的。需要把持久化数据删除再重启,才有效果` `- MONGO_INITDB_ROOT_USERNAME=username` `- MONGO_INITDB_ROOT_PASSWORD=password` `volumes:` `- ./mongo/data:/data/db` `fastgpt:` `container_name: fastgpt` `#image: ghcr.io/labring/fastgpt:latest # git` `image: registry.cn-hangzhou.aliyuncs.com/fastgpt/fastgpt:latest # 阿里云` `ports:` `- 3000:3000` `networks:` `- fastgpt` `depends_on:` `- mongo` `- pg` `restart: always` `environment:` `# root 密码,用户名为: root` `# root 密码,用户名为: root` `- DEFAULT_ROOT_PSW=1234` `# 中转地址,如果是用官方号,不需要管。务必加 /v1` `- OPENAI_BASE_URL=http://ip:端口/v1` `- CHAT_API_KEY=sk-xxxx` `- DB_MAX_LINK=5 # database max link` `- TOKEN_KEY=any` `- ROOT_KEY=root_key` `- FILE_TOKEN_KEY=filetoken` `# mongo 配置,不需要改. 如果连不上,可能需要去掉 ?authSource=admin` `- MONGODB_URI=mongodb://username:password@mongo:27017/fastgpt?authSource=admin` `# pg配置. 不需要改` `- PG_URL=postgresql://username:password@pg:5432/postgres` `volumes:` `- ./config.json:/app/data/config.json
3、访问服务
服务启动后,可通过ip:端口的方式访问。
One-API服务部署
one-api服务作为大模型服务代理,支持国内外主流的大模型服务,对外提供openai规范的api,可采用openai的协议或开源组件进行调用。(目前已支持 Azure、Anthropic Claude、Google PaLM 2 & Gemini、智谱 ChatGLM、百度文心一言、讯飞星火认知、阿里通义千问、360 智脑以及腾讯混元)
这里也使用docker-compose方式部署one-api服务
- 访问项目地址下载源码,获得docker-compose.yml文件
#注意修改文件中指定端口避免冲突!``#拷贝至指定目录``mkdir /oneapi``cp docker-compose.yml /oneapi``cd /oneapi``#文件同级目录执行命启动容器``docker-compose up -d

- 启动完成后通过ip端口访问控制台

- 点击渠道,配置我们的GPT账号

3.点击测试验证是否可用

4.点击令牌,添加新的令牌,用于配置到FastGPT

5.点击复制令牌(sk-xxxx),配置到FastGPT安装目录下的docker-compose.yml文件中

修改fastgpt的config.json配置文件,需要与渠道模型名称对应,(如果渠道不支持此模型则请求会失败)
{` `"SystemParams": {` `"pluginBaseUrl": "",` `"vectorMaxProcess": 15,` `"qaMaxProcess": 15,` `"pgHNSWEfSearch": 100` `},` `"ChatModels": [` `{` `"model": "gpt-3.5-turbo",` `"name": "GPT35-turbo",` `"price": 0,` `"maxContext": 16000,` `"maxResponse": 4000,` `"quoteMaxToken": 2000,` `"maxTemperature": 1.2,` `"censor": false,` `"vision": false,` `"defaultSystemChatPrompt": ""` `},` `{` `"model": "gpt-4-turbo",` `"name": "gpt-4-turbo",` `"maxContext": 8000,` `"maxResponse": 8000,` `"price": 0,` `"quoteMaxToken": 4000,` `"maxTemperature": 1.2,` `"censor": false,` `"vision": false,` `"defaultSystemChatPrompt": ""` `}` `],` `"QAModels": [` `{` `"model": "gpt-3.5-turbo",` `"name": "GPT35-turbo",` `"maxContext": 16000,` `"maxResponse": 16000,` `"price": 0` `},` `{` `"model": "gpt-4-turbo",` `"name": "GPT4-turbo",` `"maxContext": 16000,` `"maxResponse": 16000,` `"price": 0` `}` `],` `"CQModels": [` `{` `"model": "gpt-3.5-turbo",` `"name": "GPT35",` `"maxContext": 4000,` `"maxResponse": 4000,` `"price": 0,` `"functionCall": true,` `"functionPrompt": ""` `},` `{` `"model": "gpt-4-turbo",` `"name": "GPT4-turbo",` `"maxContext": 8000,` `"maxResponse": 8000,` `"price": 0,` `"functionCall": true,` `"functionPrompt": ""` `}` `],` `"ExtractModels": [` `{` `"model": "gpt-3.5-turbo",` `"name": "GPT35",` `"maxContext": 16000,` `"maxResponse": 4000,` `"price": 0,` `"functionCall": true,` `"functionPrompt": ""` `}` `],` `"QGModels": [` `{` `"model": "gpt-4-turbo",` `"name": "GPT4-turbo",` `"maxContext": 1600,` `"maxResponse": 4000,` `"price": 0` `}` `],` `"VectorModels": [` `{` `"model": "text-embedding-ada-002",` `"name": "Embedding-2",` `"price": 0.0,` `"defaultToken": 700,` `"maxToken": 3000` `},` `{` `"model": "text2vec-large-chinese",` `"name": "text2vec-large-chinese",` `"price": 0.0,` `"defaultToken": 700,` `"maxToken": 3000` `},` `{` `"model": "m3e",` `"name": "m3e",` `"price": 0.0,` `"defaultToken": 700,` `"maxToken": 3000` `}`` ` `],` `"ReRankModels": [],` `"AudioSpeechModels": [` `{` `"model": "tts-1",` `"name": "OpenAI TTS1",` `"price": 0,` `"voices": [` `{ "label": "Alloy", "value": "alloy", "bufferId": "openai-Alloy" },` `{ "label": "Echo", "value": "echo", "bufferId": "openai-Echo" },` `{ "label": "Fable", "value": "fable", "bufferId": "openai-Fable" },` `{ "label": "Onyx", "value": "onyx", "bufferId": "openai-Onyx" },` `{ "label": "Nova", "value": "nova", "bufferId": "openai-Nova" },` `{ "label": "Shimmer", "value": "shimmer", "bufferId": "openai-Shimmer" }` `]` `}` `],` `"WhisperModel": {` `"model": "whisper-1",` `"name": "Whisper1",` `"price": 0` `}``}
重启fastgpt服务生效
#执行命令重启fastgpt服务``cd /fastgpt``docker-compose restart
5.测试FastGPT
登录fastgpt,创建知识库,选择我们添加的模型版本进行预览测试。具体fastgpt使用请参考官网链接

私有化m3e向量模型
通过RAG技术原理图可以了解,向量模型和向量数据库的用途,在对知识或问题进行向量转换时需要使用到向量模型服务,FastGPT默认使用的openai的text-embedding-ada模型,考虑到成本、安全和转换性能问题,可以使用 M3E 向量模型进行私有化部署。向量模型属于小模型,资源使用不高,CPU 也可以运行。
- 部署向量模型服务镜像,如下为m3e服务的docker-compose.yml,运行启动即可
version: '1'``services:` `m3e:` `image: registry.cn-hangzhou.aliyuncs.com/fastgpt_docker/m3e-large-api:latest` `restart: no` `ports:` `- "6008:6008"
- 接入one-api服务
登录one-api控制台,添加m3e渠道

- 接入fastgpt
修改fastgpt config.json配置文件,加入m3e模型
"VectorModels": [` `{` `"model": "text-embedding-ada-002",` `"name": "Embedding-2",` `"price": 0.2,` `"defaultToken": 500,` `"maxToken": 3000` `},` `{` `"model": "m3e",` `"name": "M3E(测试使用)",` `"price": 0.1,` `"defaultToken": 500,` `"maxToken": 1800` `}``]
- 测试效果
使用FastGPT创建知识库,选择m3e模型

导入数据

测试搜索结果

基于FastGPT搭建知识库示例
官方参考文档

写在最后
更多实操内容,期待后续陆续输出,欢迎大家关注交流!!
如何学习大模型 AI ?
由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。
但是具体到个人,只能说是:
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
-END-
👉AI大模型学习路线汇总👈
大模型学习路线图,整体分为7个大的阶段:(全套教程文末领取哈)

第一阶段: 从大模型系统设计入手,讲解大模型的主要方法;
第二阶段: 在通过大模型提示词工程从Prompts角度入手更好发挥模型的作用;
第三阶段: 大模型平台应用开发借助阿里云PAI平台构建电商领域虚拟试衣系统;
第四阶段: 大模型知识库应用开发以LangChain框架为例,构建物流行业咨询智能问答系统;
第五阶段: 大模型微调开发借助以大健康、新零售、新媒体领域构建适合当前领域大模型;
第六阶段: 以SD多模态大模型为主,搭建了文生图小程序案例;
第七阶段: 以大模型平台应用与开发为主,通过星火大模型,文心大模型等成熟大模型构建大模型行业应用。
👉大模型实战案例👈
光学理论是没用的,要学会跟着一起做,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。

👉大模型视频和PDF合集👈
观看零基础学习书籍和视频,看书籍和视频学习是最快捷也是最有效果的方式,跟着视频中老师的思路,从基础到深入,还是很容易入门的。


👉学会后的收获:👈
• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;
• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;
• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;
• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。
👉获取方式:
😝有需要的小伙伴,可以保存图片到wx扫描二v码免费领取【保证100%免费】🆓


魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 7
 0
- 0


 已为社区贡献134条内容

所有评论(0)