机器学习 实验课2 KNN近邻算法
一、KNN详解
1.算法原理
K最近邻(K-Nearest Neighbors,KNN)算法是一种基于实例的、非参数化的监督学习算法。它用于分类和回归问题。KNN算法的基本思想是通过计算样本之间的距离,找到与待预测样本最近的K个训练样本,并根据这K个样本的类别或者平均值来进行分类或者回归预测。
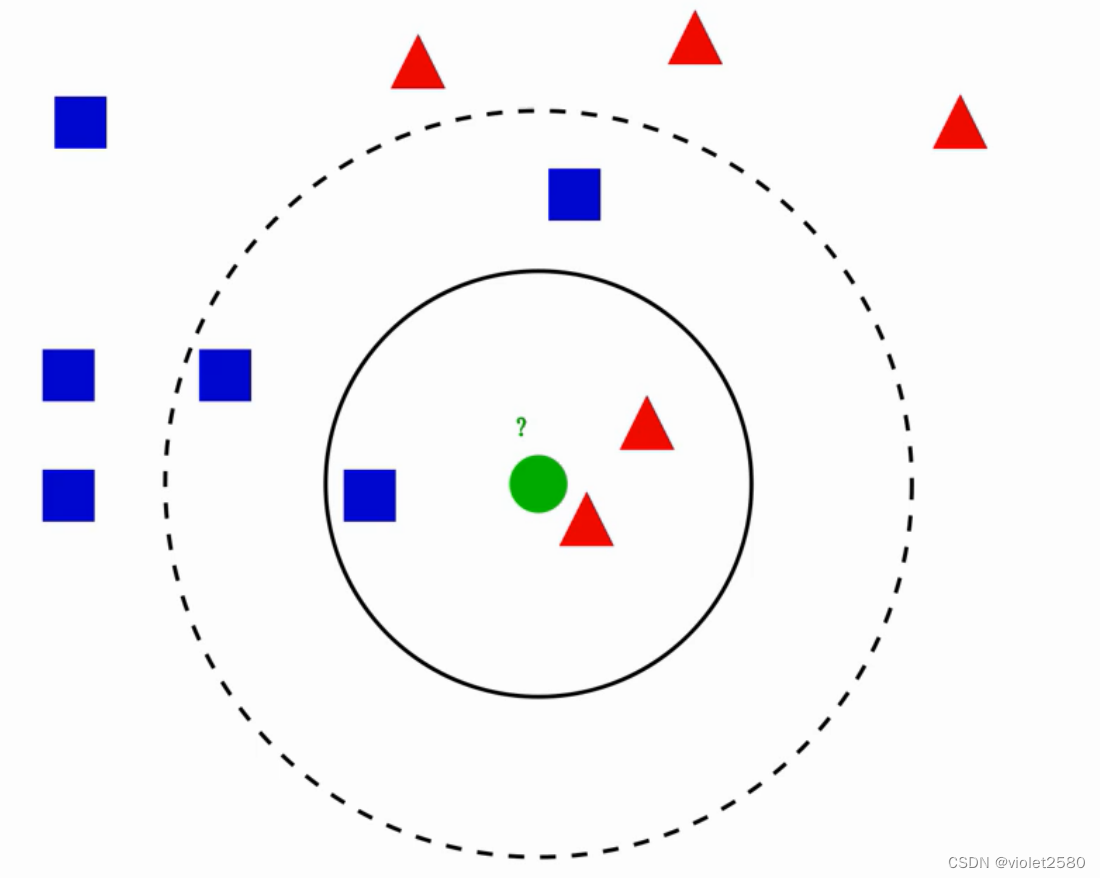
如下图1.1所示,当要判断绿色实例的类别的时候,我们可以看看它的附近有哪些类,然后采取多数表决的决策规则(在实线内红色2个多于蓝色1个),于是把绿色实例也分类为红色那一类。
2.算法步骤
2.1准备训练集
收集和准备已知类别的训练数据。
2.2选择K值——交叉验证方法
KNN算法中只有一个超参数k,k值的确定对KNN算法的预测结果有着至关重要的影响。接下来,我们讨论一下k值大小对算法结果的影响以及一般情况下如何选择k值。
如果k值比较小,相当于我们在较小的领域内训练样本对实例进行预测。这时,算法的近似误差(Approximate Error)会比较小,因为只有与输入实例相近的训练样本才会对预测结果起作用。
但是,它也有明显的缺点:算法的估计误差比较大,预测结果会对近邻点十分敏感,也就是说,如果近邻点是噪声点的话,预测就会出错。因此,k值过小容易导致KNN算法的过拟合。
同理,如果k值选择较大的话,距离较远的训练样本也能够对实例预测结果产生影响。这时候,模型相对比较鲁棒,不会因为个别噪声点对最终预测结果产生影响。但是缺点也十分明显:算法的近邻误差会偏大,距离较远的点(与预测实例不相似)也会同样对预测结果产生影响,使得预测结果产生较大偏差,此时模型容易发生欠拟合。
在许多实际应用中数据是不充足的。为了选择好的模型,可以采用交叉验证方法。交叉验证的基本想法是重复地使用数据,把给定的数据进行切分,将切分的数据组合为训练集与测试集,在此基础上反复进行训练测试以及模型的选择。在实现过程中将采用sklearn.model_selection.cross_val_score()实现交叉验证选取k值。
2.3计算距离
-
欧氏距离(Euclidean Distance):
欧氏距离是最常见的距离度量方法,它基于两个样本点在各个特征上的差异进行计算。对于样本点A(x1, x2, ..., xn)和B(y1, y2, ..., yn),欧氏距离可以通过以下公式计算:
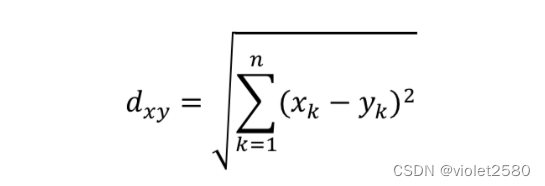
-
曼哈顿距离(Manhattan Distance):
曼哈顿距离是另一种常见的距离度量方法,它衡量两个样本点在各个特征上的绝对差值之和。对于样本点A(x1, x2, ..., xn)和B(y1, y2, ..., yn),曼哈顿距离可以通过以下公式计算:
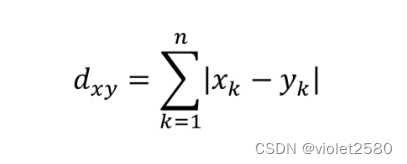
-
闵可夫斯基距离(Minkowski Distance):
闵可夫斯基距离是一种通用的距离度量方法,欧氏距离和曼哈顿距离都是其特殊情况。对于样本点A(x1, x2, ..., xn)和B(y1, y2, ..., yn),闵可夫斯基距离可以通过以下公式计算:
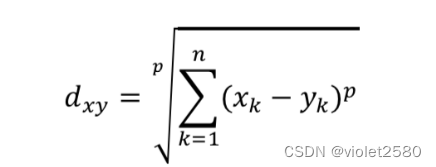
其中,p是控制距离的参数。当p=1时,闵可夫斯基距离等同于曼哈顿距离;当p=2时,闵可夫斯基距离等同于欧氏距离。
2.4影响因素
1. 特征缩放:由于KNN算法是基于距离的,所以要确保各个特征之间的数值范围相似,可以使用标准化或归一化等方法进行特征缩放。如果不对特征进行归一化,不同特征之间的尺度差异可能会对距离计算产生较大影响。例如,一个特征取值范围在0-1之间,而另一个特征取值范围在1000-10000之间,欧氏距离计算时会主要受到后者的特征影响,导致距离计算结果不准确。
通过归一化可以消除特征尺度之间的差异,使得各个特征对距离计算贡献相对均衡。KNN算法是基于实例的学习方法,对于训练数据中的异常值或噪音数据较为敏感。当特征尺度不一致时,某些特征上的噪音可能会对距离计算产生较大影响,从而影响算法的性能。通过归一化,可以减小特征的噪音差异,使得模型对异常值或噪音数据更具鲁棒性。
2.缺失值处理:KNN算法对于含有缺失值的数据处理较为困难,需要进行适当的缺失值填充或者处理。
3.数据集大小:KNN算法需要存储所有的训练样本,对于大规模数据集来说计算开销较大,因此在处理大规模数据集时可能会遇到性能问题。
二、KNN实现案例
1.鸢尾花分类
1.1导入sklearn库
Scikit-learn(简称sklearn)是一个用于机器学习的Python库,提供了丰富的机器学习算法和工具。它建立在NumPy、SciPy和matplotlib等科学计算库的基础上,并与它们紧密集成,使得机器学习任务变得更加方便和高效。
第一个import是用来导入一个样本数据。sklearn库本身已经提供了不少可以用来测试模型的样本数据,所以通过这个模块的导入就可以直接使用这些数据了。 第二个import是用来做数据集的分割,把数据分成训练集和测试集,这样做的目的是为了评估模型。第三个是导入了KNN的模块,是sklearn提供的现成的算法。
1.2读取数据集
根据sklearn中提供的iris数据集来进行训练。
1.3设置k值
设置近邻k值为5
1.4输入数据并判断花型
代码如下:
#引入sklearn库
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.neighbors import KNeighborsClassifier
import numpy as np
if __name__ == '__main__':
    #获取sklearn库中鸢尾花的数据集
    iris = load_iris()
    data = iris.get("data")
    target = iris.get("target")
    #划分20%的测试集
    x_train, x_test, y_train, y_test = train_test_split(data, target, test_size=0.2, random_state=0)
    #设置k值为5
    KNN = KNeighborsClassifier(n_neighbors=5)
    KNN.fit(x_train, y_train)
    #评价模型的准确程度
    train_score = KNN.score(x_train, y_train)
    test_score = KNN.score(x_test, y_test)
    print("模型的准确率:", test_score)
    # 输入带预测的数据
    X1 = np.array([[1.5, 3, 5.8, 2.2], [6.2, 2.9, 4.3, 1.3],[2.1,6.6,1.6,6.3]])
    prediction = KNN.predict(X1)
    k = iris.get("target_names")[prediction]
    #返回鸢尾花的类型(山鸢尾为Setosa、变色鸢尾为Versicolor、维吉尼亚鸢尾为Virginica)
    print("第一朵花的种类为:", k[0])
    print("第二朵花的种类为:", k[1])
    print("第二朵花的种类为:", k[2])
2.图像展示
代码如下:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import matplotlib as mpl
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
from matplotlib.colors import ListedColormap
#导入iris数据
from sklearn.datasets import load_iris
iris = load_iris()
X=iris.data[:,:2] #只取前两列
y=iris.target

X_train, X_test, y_train, y_test = train_test_split(X, y, stratify=y,random_state=42) #划分数据,random_state固定划分方式
#导入模型
from sklearn.neighbors import KNeighborsClassifier
#训练模型
n_neighbors = 5
knn = KNeighborsClassifier(n_neighbors=n_neighbors)
knn.fit(X_train, y_train)
y_pred = knn.predict(X_test)
#查看各项得分
print("y_pred",y_pred)
print("y_test",y_test)
print("score on train set", knn.score(X_train, y_train))
print("score on test set", knn.score(X_test, y_test))
print("accuracy score", accuracy_score(y_test, y_pred))

# 可视化

# 自定义colormap
def colormap():
    return mpl.colors.LinearSegmentedColormap.from_list('cmap', ['#FFC0CB','#00BFFF', '#1E90FF'], 256)

x_min, x_max = X[:, 0].min() - 1, X[:, 0].max() + 1
y_min, y_max = X[:, 1].min() - 1, X[:, 1].max() + 1
axes=[x_min, x_max, y_min, y_max]
xp=np.linspace(axes[0], axes[1], 500) #均匀500的横坐标
yp=np.linspace(axes[2], axes[3],500) #均匀500个纵坐标
xx, yy=np.meshgrid(xp, yp) #生成500X500网格点
xy=np.c_[xx.ravel(), yy.ravel()] #按行拼接,规范成坐标点的格式
y_pred = knn.predict(xy).reshape(xx.shape) #训练之后平铺

# 可视化方法一
plt.figure(figsize=(15,5),dpi=100)
plt.subplot(1,2,1)
plt.contourf(xx, yy, y_pred, alpha=0.3, cmap=colormap())
#画三种类型的点
p1=plt.scatter(X[y==0,0], X[y==0, 1], color='blue',marker='^')
p2=plt.scatter(X[y==1,0], X[y==1, 1], color='green', marker='o')
p3=plt.scatter(X[y==2,0], X[y==2, 1], color='red',marker='*')
#设置注释
plt.legend([p1, p2, p3], iris['target_names'], loc='upper right',fontsize='large')
#设置标题
plt.title(f"3-Class classification (k = {n_neighbors})", fontdict={'fontsize':15} )

# 可视化方法二
plt.subplot(1,2,2)
cmap_light = ListedColormap(['pink', 'cyan', 'cornflowerblue'])
cmap_bold = ListedColormap(['darkorange', 'c', 'darkblue'])
plt.pcolormesh(xx, yy, y_pred, cmap=cmap_light)

# Plot also the training points
plt.scatter(X[:, 0], X[:, 1], c=y, cmap=cmap_bold,
                edgecolor='k', s=20)
plt.xlim(xx.min(), xx.max())
plt.ylim(yy.min(), yy.max())
plt.title(f"3-Class classification (k = {n_neighbors})" ,fontdict={'fontsize':15})
plt.show()
在k的值为5的时候,三种花型的特征分布如下图结果所示

三、实验总结
k近邻算法是分类数据最简单最有效鄂算法,本次实验通过鸢尾花实例学习如何使用k近邻算法构造分类器。k近邻算法是基于实例的学习,使用算法时我们必须有接近实际数据的训练样本数据。k近邻算法必保存全部数据集,如果训练数据集很大,必须使用大量的存储空间。此外,由于必须对数据集中的每个数据计算距离值,实际使用时可能非常耗时。
k近邻的另一个缺陷是他无法给出任何数据的基础结构信息,因此我们也无法知晓平均实例样本和典型实力样本具有什么特征。
魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐
 3
 0
- 0


 已为社区贡献3条内容

所有评论(0)