Python机器学习之特征抽取
·
声明:参考B站自学成长记录
https://www.bilibili.com/video/BV134411f7os?p=5
安装相关包
安装 NumPy / Scikit-learn:–清华镜像
pip3 install numpy scipy matplotlib -i https://pypi.tuna.tsinghua.edu.cn/simple
pip3 install Scikit-learn -i https://pypi.tuna.tsinghua.edu.cn/simple
代码实现
# coding=utf-8
# 字典数据抽取
from sklearn.feature_extraction import DictVectorizer
# 文本数据抽取
from sklearn.feature_extraction.text import CountVectorizer


def dictvec():
    """
    字典特征提取
    :return:None
    """
    dict = DictVectorizer()

    # 调用fit_transform
    data = dict.fit_transform([{'city':'北京', 'temp':'100'},\
                               {'city':'上海', 'temp':'60'},\
                               {'city':'广州', 'temp':'40'}])

    print(dict.get_feature_names())
    print(data)

    return None

def countvec():
    """
    文本特征提取
    :return:None
    """
    text = CountVectorizer()
    data = text.fit_transform(['life is short, i like python','life is too long, i dislike python'])

    print(text.get_feature_names())
    print(data.toarray())

    return None

if __name__ == '__main__':
    dictvec()
    print('*'*20)
    countvec()
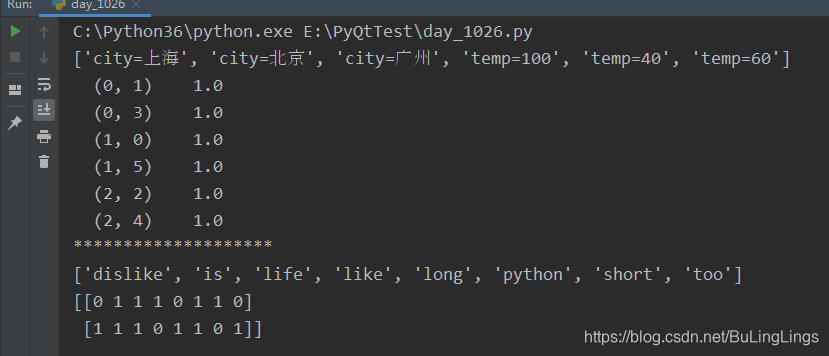
代码执行结果如下图

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)