吴恩达机器学习[16]-异常检测
异常检测 Anomaly detection
引入:**异常检测(Anomaly detection)**是机器学习的一个常见应用。虽然这种算法用于无监督学习,但它跟监督学习非常相似。那么,什么是异常检验呢?
问题动机 problem motivation
引入:什么是异常检验呢?
假设你是一个飞机引擎制造商,生产过程中需要质量测试检验。为此,需要测试一些飞机的特征变量信息,从而得到如下图所示数据集。
据此,可将异常检测定义如下:给定一个飞机引擎特征样本
x
t
e
s
t
x_{test}
xtest,检测它是否异常。
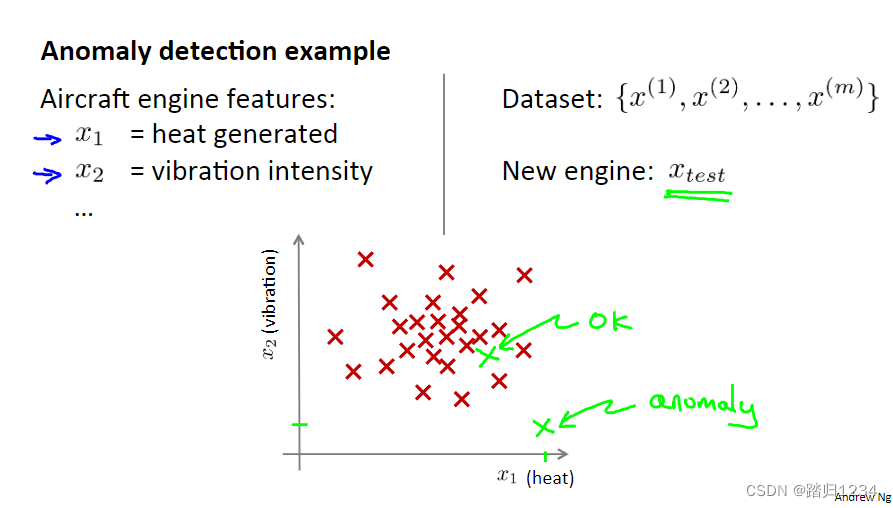
正式来说,异常检测(Anomaly detection)定义如下:
假设我们有一个数据集
x
(
1
)
,
x
(
2
)
,
…
,
x
(
1
m
{x^{(1)}, x^{(2)} ,…,x^{(1m}}
x(1),x(2),…,x(1m,通常它是正常的。我们需要一个学习算法来判断新的样本数据
x
t
e
s
t
x_{test}
xtest是否异常。为此,我们需要给上述无标签的训练集建立数学模型
p
(
x
)
p(x)
p(x),也就是给
x
x
x的分布概率建模。然后把新样本数据代入,如果
p
(
x
t
e
s
t
)
p(x_{test})
p(xtest)小于阈值,意味着样本是异常的,反之则是正常的。
注意:在数学模型
p
(
x
)
p(x)
p(x)中,越靠近中心,
p
(
x
t
e
s
t
)
p(x_{test})
p(xtest)越大。
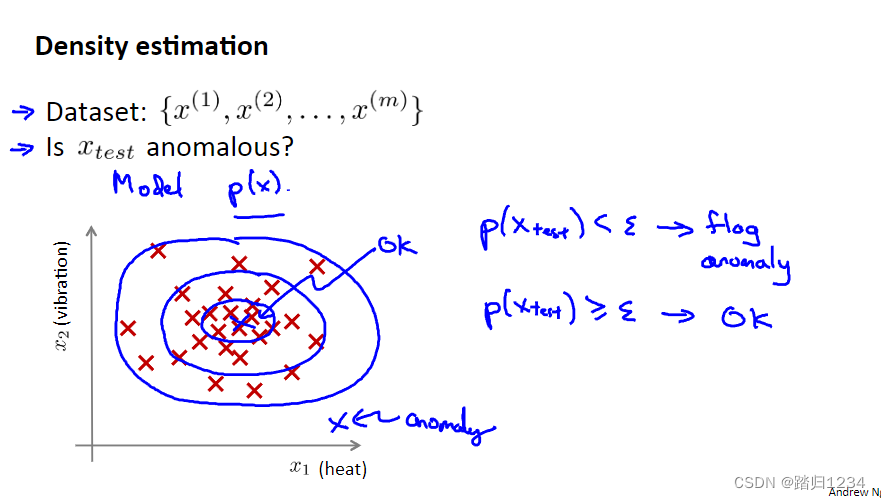
下图展示异常检测的一些案例。如欺诈检测(Fraud detection)、工业生产中异常产品检测、数据中心的计算机监控(Monitoring computers in a data center)
高斯分布 Gaussian distribution
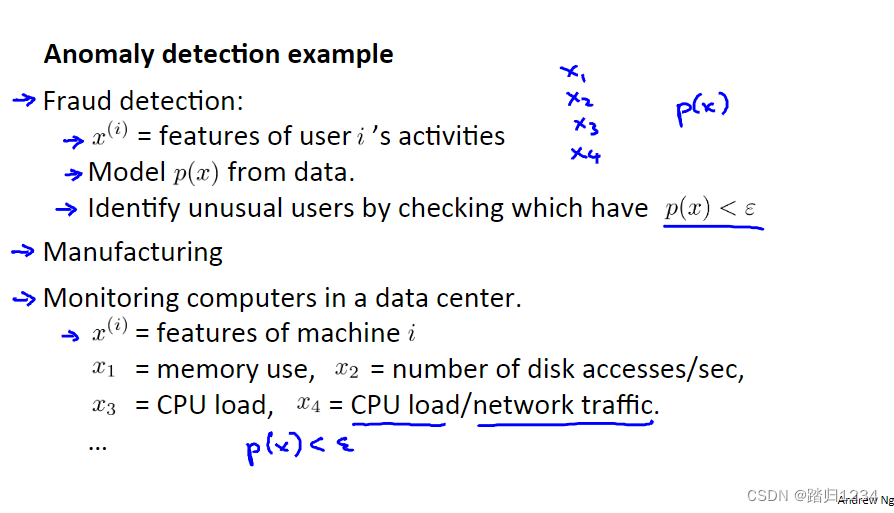
引入:本部分将介绍高斯分布(Gaussian distribution),又称正态分布(normal distribution)。
高斯分布符号表示:
x
x
x~
N
(
u
,
σ
2
)
N(u,\sigma^2)
N(u,σ2),钟形曲线。
高斯分布的概率密度函数为
p
(
x
;
u
,
σ
2
)
=
1
2
π
σ
e
−
(
x
−
u
)
2
2
σ
2
p(x; u,\sigma^2)=\frac 1{\sqrt[]{2 \pi}\sigma} e^{- \frac{(x-u)^2}{2\sigma^2}}
p(x;u,σ2)=2πσ1e−2σ2(x−u)2。
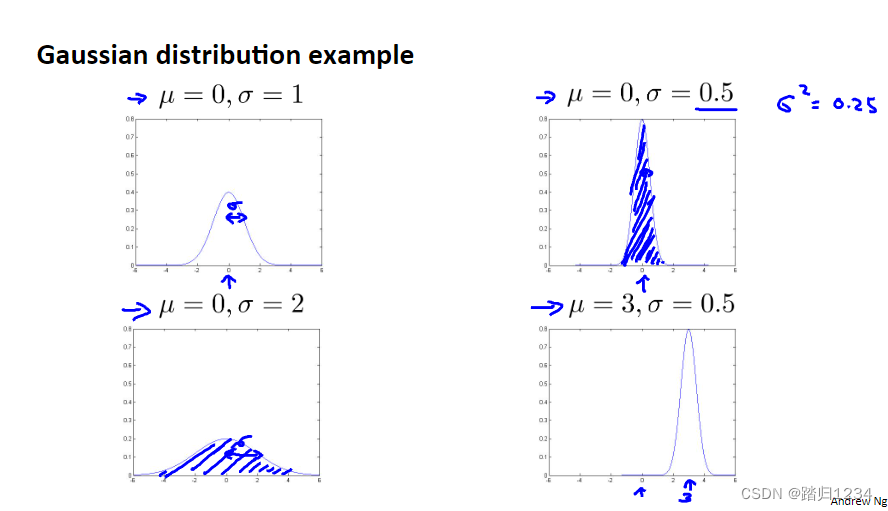
下图展示高斯分布随
u
,
σ
u, \sigma
u,σ变化的曲线。
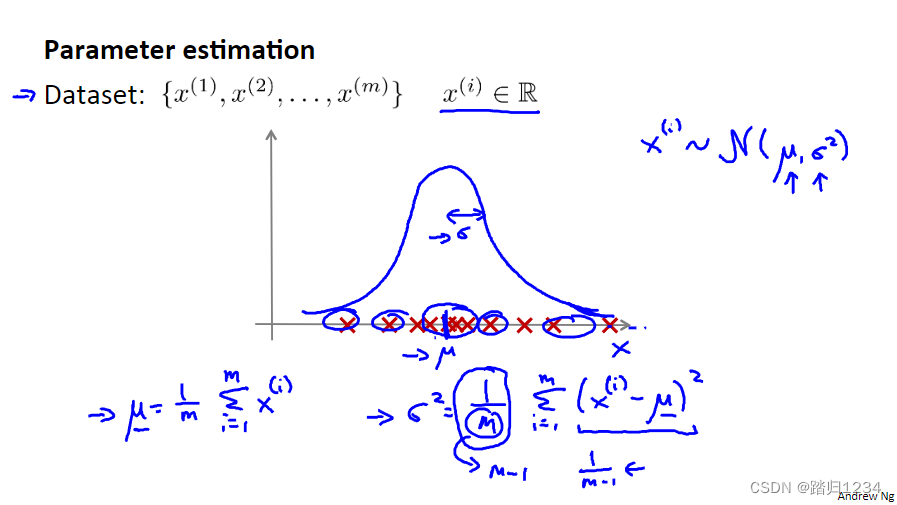
下面讨论参数估计问题(parameter estimation problem)。
给定数据集如图。假设数据集来自高斯分布的总体,也就是
x
x
x服从高斯分布。此时需要求出参数
u
,
σ
2
u, \sigma ^2
u,σ2的值。这就是参数估计。
图下部分展示了求解参数
u
,
σ
2
u, \sigma ^2
u,σ2的公式,公式使用到了极大似然估计。
注意:在统计学中,求解参数 σ 2 \sigma ^2 σ2的公式中往往使用 1 m − 1 \frac 1{m-1} m−11而不是 1 m \frac 1{m} m1。在机器学习中,其实这两种做法的结果相差不大,而且常见的做法是使用 1 m \frac 1{m} m1。
算法 Algorithm
引入:使用高斯分布来构建一个异常检验算法。
假设有一个共
m
m
m个样本的,
n
n
n维无标签训练集。我们需要为其构建一个异常检验算法,即算出
x
x
x的概率分布函数
p
(
x
)
p(x)
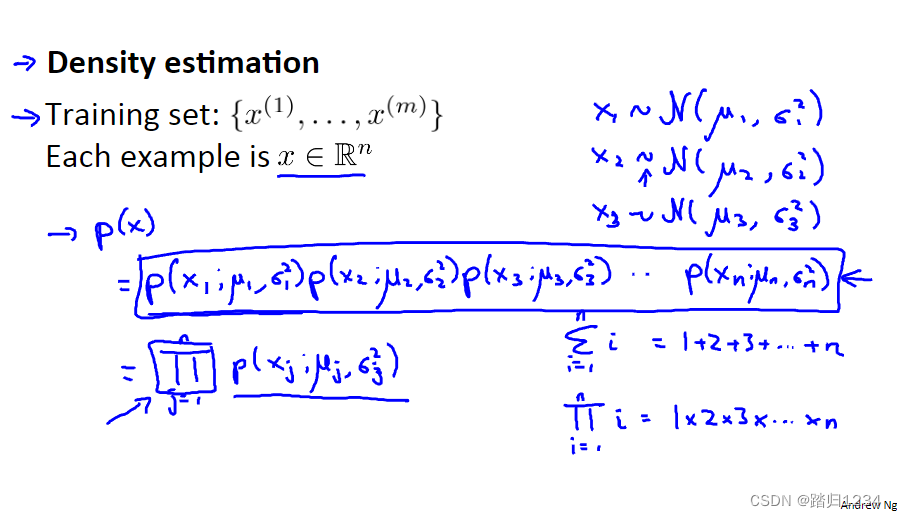
p(x)。——密度估计问题(Density estimation )
如果
x
1
,
x
2
,
…
,
x
n
x_1, x_2, …, x_n
x1,x2,…,xn都服从高斯分布,则
p
(
x
)
=
p
(
x
1
;
u
1
,
σ
1
2
)
p
(
x
2
;
u
2
,
σ
2
2
)
…
p
(
x
n
;
u
n
,
σ
n
2
)
=
∏
j
=
1
n
p
(
x
j
;
u
j
,
σ
j
2
)
p(x)=p(x_1; u_1,\sigma_1^2)p(x_2; u_2,\sigma_2^2)…p(x_n; u_n,\sigma_n^2)=\prod_{j=1}^n p(x_j; u_j,\sigma_j^2)
p(x)=p(x1;u1,σ12)p(x2;u2,σ22)…p(xn;un,σn2)=j=1∏np(xj;uj,σj2)
注意:理论上, x 1 , x 2 , … , x n x_1, x_2, …, x_n x1,x2,…,xn服从独立分布时才能得到上述公式;但实际中,无论 x 1 , x 2 , … , x n x_1, x_2, …, x_n x1,x2,…,xn是否满足近乎独立,该算法都能正常运行。
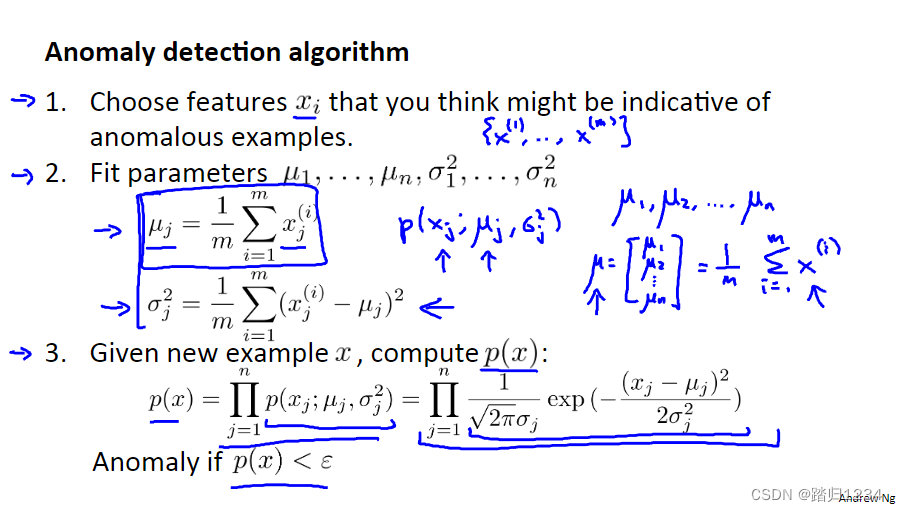
综上,得到异常检验算法如下图。
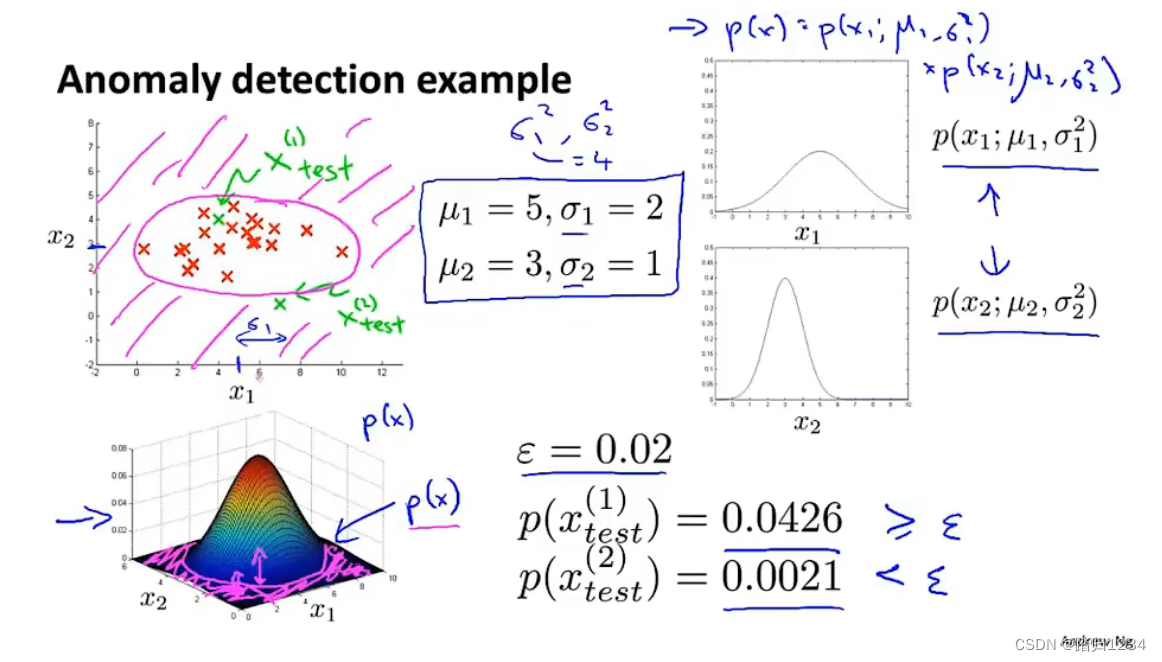
下图展示运用上述方法的一个案例。
如何选定阈值
ϵ
\epsilon
ϵ呢?放在
p
(
x
)
p(x)
p(x)分布曲线中,可以选择
(
x
1
(
i
)
,
x
2
(
i
)
)
(x_1^{(i)}, x_2^{(i)})
(x1(i),x2(i))对应的高度不太高的值为阈值
ϵ
\epsilon
ϵ。
开发和评估异常检测系统
引入:上一节中讲述了如何构建一个异常检验算法,本部分讨论如何开发一个解决实际问题的异常检验应用。我们将重点关注如何评估异常检验算法。
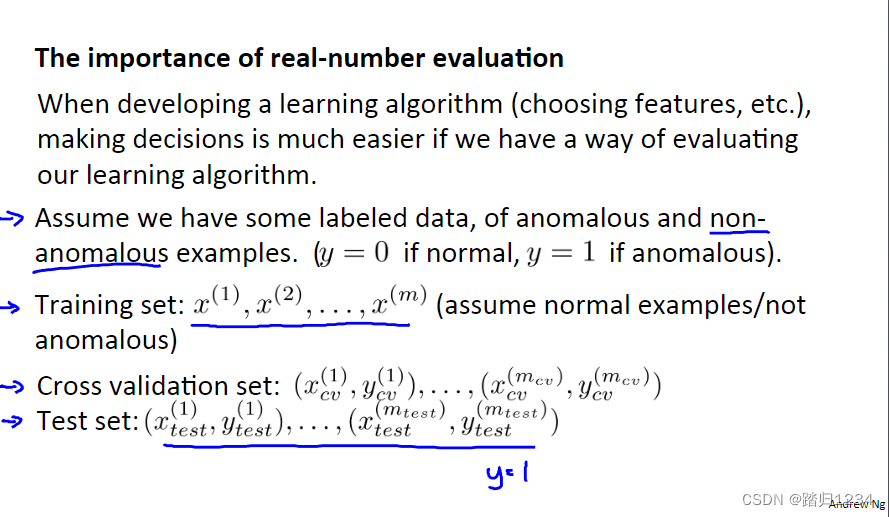
下图展示异常检验算法评估系数的重要性,以及异常检验步骤。
其中,训练集中混入少量异常样本对异常检验模型建立的影响不大。
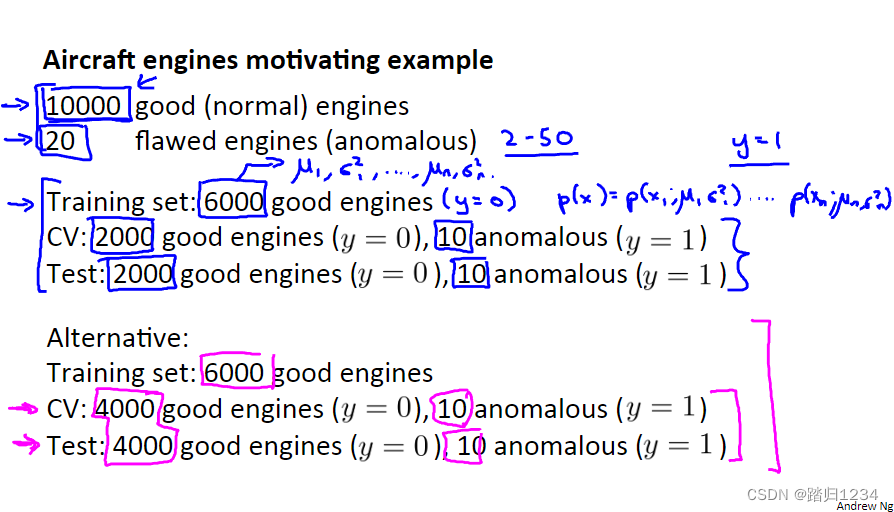
下图用飞机引擎例子进行说明。一般来说,正常样本数量往往大于10000,异常样本数量在2-50之间都是合理的。
为了构建异常检验模型,用6000个正常样本构建训练集,分别用2000个正常样本和10个异常样本构建交叉验证集和测试集。(60%:20%:20%)
需要注意的是:交叉验证集和测试集是两个不同的集合,因此不能将相同的正常样本同时用于验证和测试。即图中第二种数据分配方法是不推荐的。
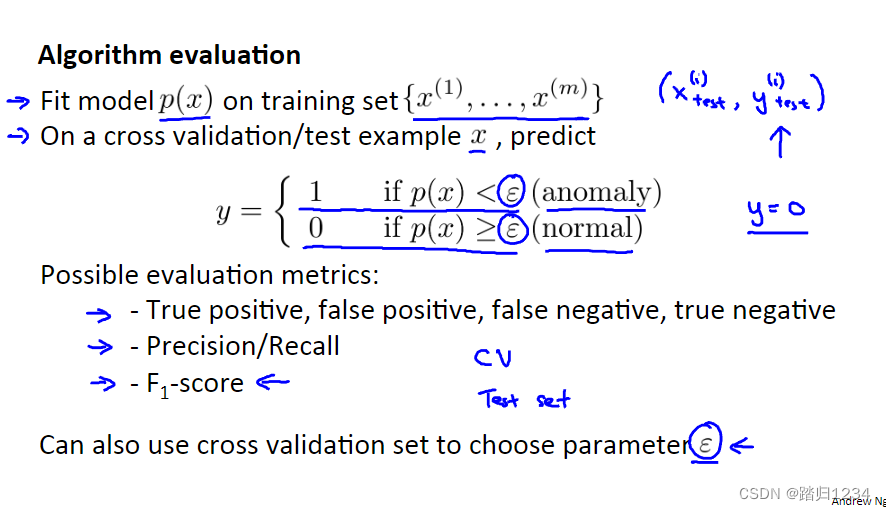
得到训练集、交叉验证集、测试集后,下面展示如何推导出异常检验算法以及评估算法。
在交叉验证集、测试集,所做的工作与监督学习很像——给定带标签的数据集,评估异常检验算法预测的好坏。因此可以考虑使用监督学习评估系数进行评估。
考虑到交叉验证集、测试集的样本倾斜度很大(正负样本数量比大),因此可考虑使用如图的系数用于评估。这些系数也可以通过交叉验证集来确定阈值
ϵ
\epsilon
ϵ的值。
异常检测 VS 监督学习
引入:什么时候可以使用异常检验算法?什么时候可以使用监督学习算法呢?两种算法的区别是什么呢?
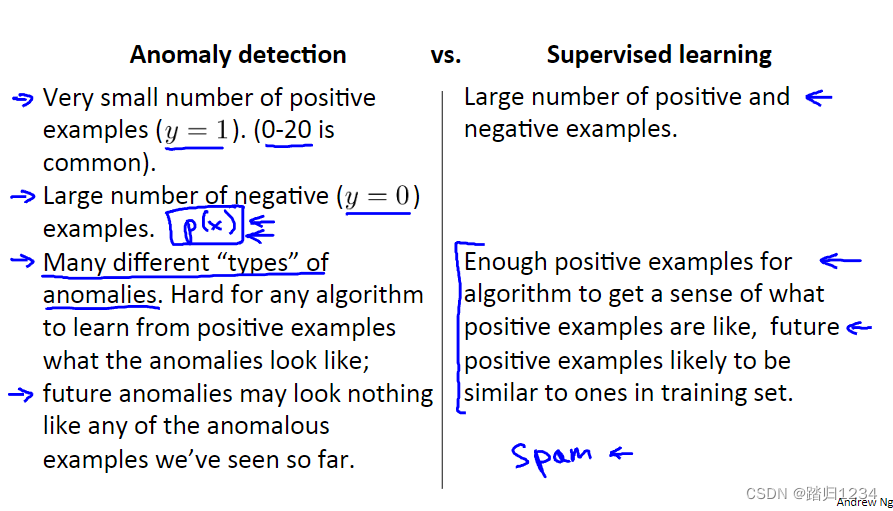
下图展示异常检验和监督学习适用情况对比。
注意:虽然之前提到过的垃圾邮件问题中,垃圾邮件有很多种类,但它的数据同时也非常巨大,因此使用监督学习。
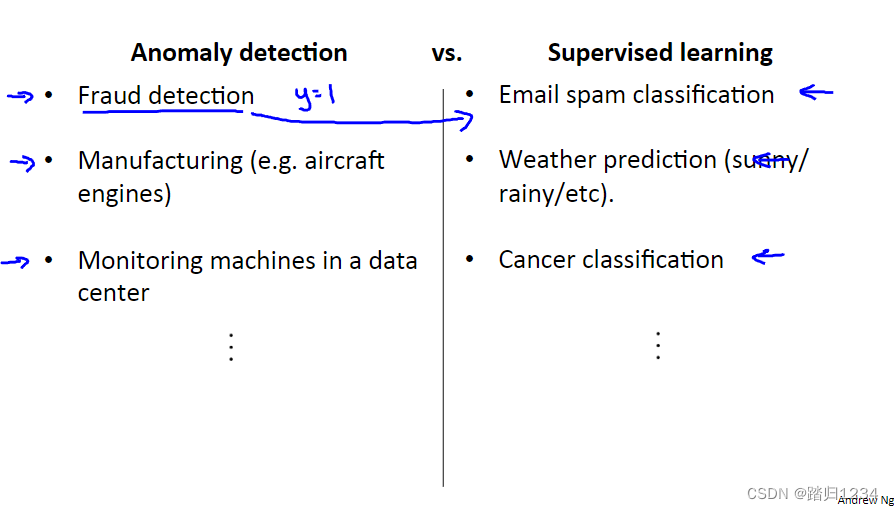
下图分别展示异常检验和监督学习的常见应用场景。
对于欺诈问题,欺诈案例数量巨大时可使用监督学习算法;否则可使用异常检验算法。
选择需要使用的功能
引入:在使用异常检验算法时,使用什么特征对算法的运用影响巨大。本部分将为异常检验算法选择怎么样的特征提供建议。
-
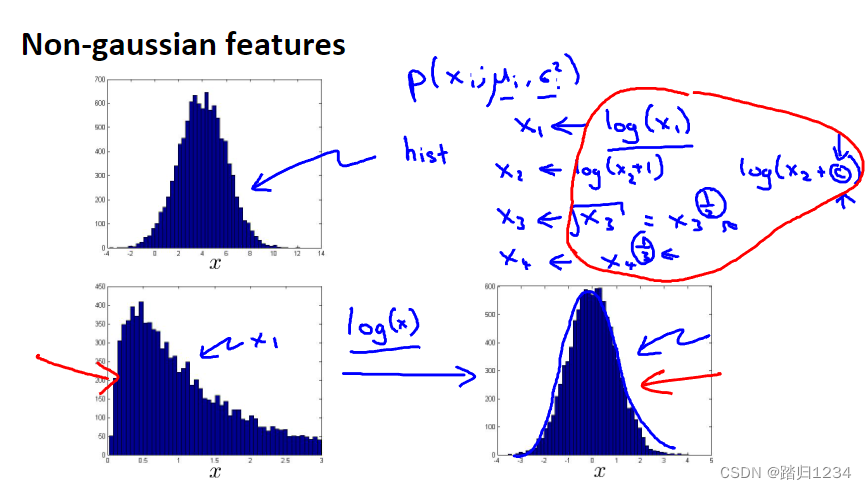
异常检验中常常使用高斯分布对特征进行建模,因此首先需要判断特征是否近似符合高斯分布。
实际上,不符合高斯分布对运行影响不大,只不过符合时运行结果可能更好。将特征转换为高斯分布常见做法是使用: l o g ( x + c ) , x a log(x+c), \sqrt[a] x log(x+c),ax函数
-
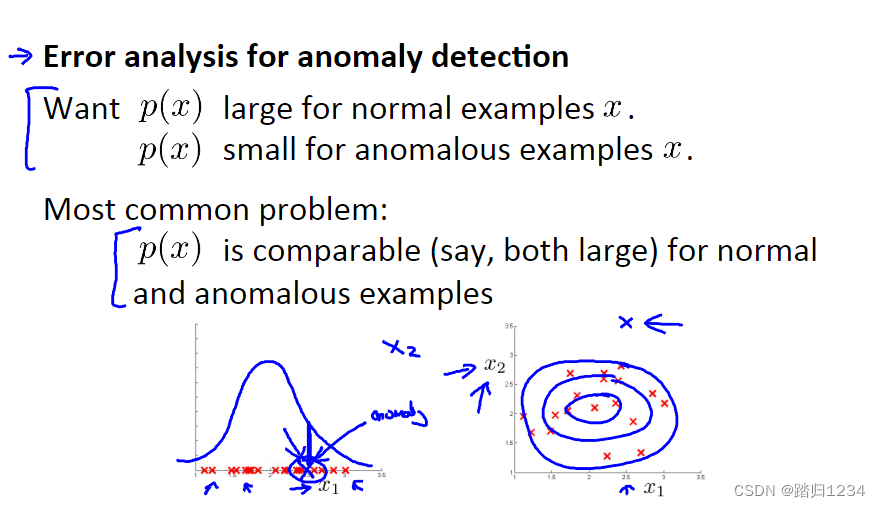
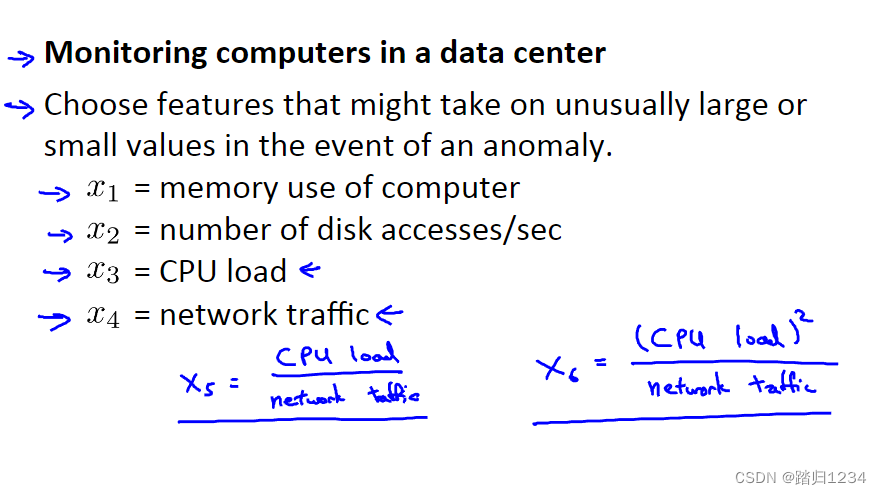
如何得到异常检验算法的特征呢?常见的做法是使用误差分析(error analysis)。如图,一般选择对样本异常与否影响很大的特征。
- 下面展示异常检验选择特征时的一些常见思考。
一般选择异常发生时,异常大或异常小的特征。
多变量高斯分布 Multivariate Gaussian distribution
学习目标:介绍异常检验算法的一种可能延伸,这种延伸可用于多变量高斯分布(Multivariate Gaussian distribution)。
下面使用监控数据中心中计算机的例子。假设我们有图上这些数据,把
x
1
,
x
2
x_1, x_2
x1,x2当做高斯分布来建模。
假设有样本(0.5,1.5)(如图左上角绿点),似乎绿点与正常点被隔离开来了,能明显看出属于异常值。
异常检验算法会怎么做呢?此时的
p
(
x
1
),
p
(
x
2
)
p(x_1), p(x_2)
p(x1),p(x2)都会比较高,因此异常检验算法不会将其标记为异常。对于异常检验算法,同一同心圆上的样本具有相同的概率。
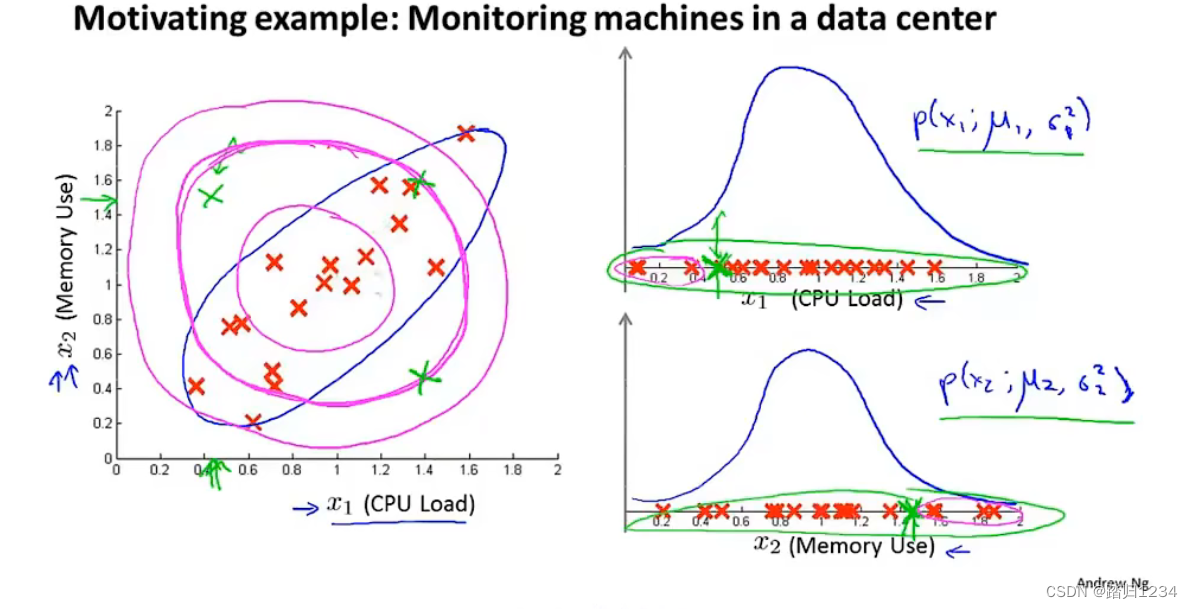
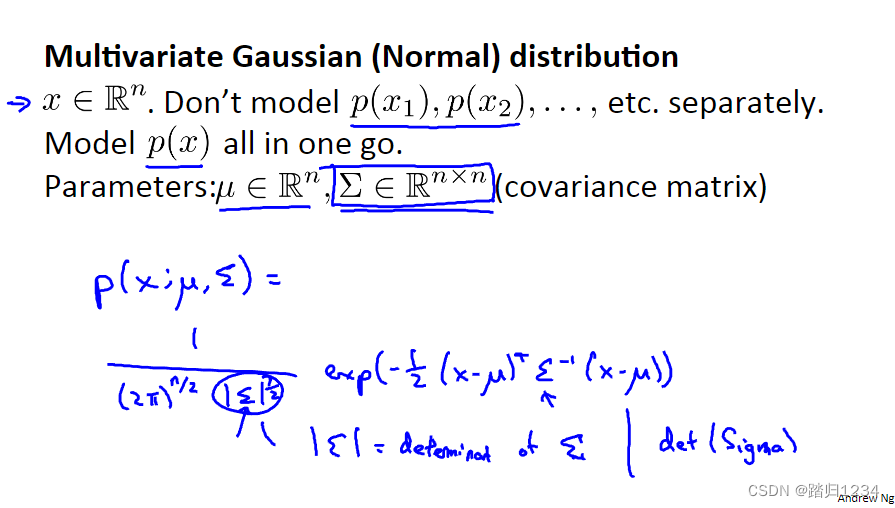
为了解决这一问题,有了改良版的异常检验算法——多变量高斯分布(Multivariate Gaussian distribution),又称多变量正态分布(Multivariate Normal distribution)。
下面是具体做法。我们使用所有的变量建立统一
p
(
x
)
p(x)
p(x)模型——
p
(
x
;
u
,
Σ
)
p(x; u,\Sigma)
p(x;u,Σ)。
其中,
Σ
\Sigma
Σ是协方差矩阵,
∣
Σ
∣
1
2
|\Sigma|^{\frac 12}
∣Σ∣21是
n
∗
n
n*n
n∗n的行列式。
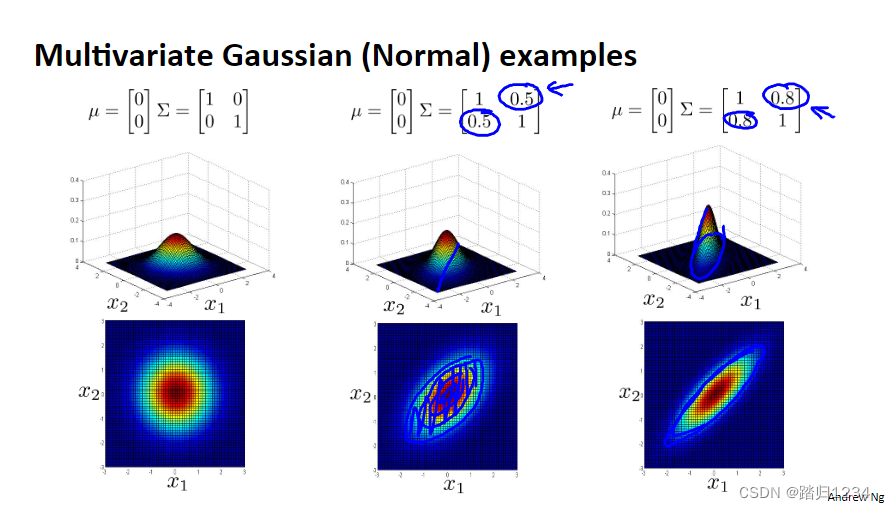
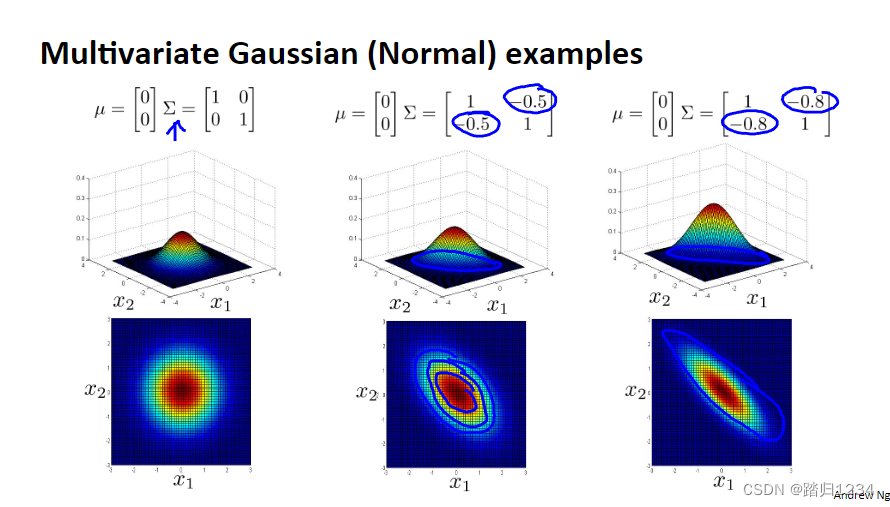
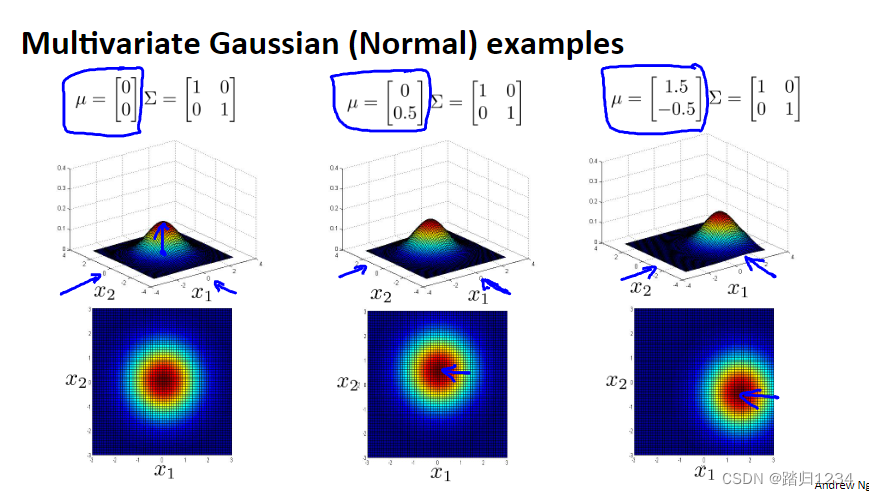
那么多变量高斯分布到底长什么样呢?下面展示一些多变量高斯分布的例子。(概率分布曲线的积分必须为1)。
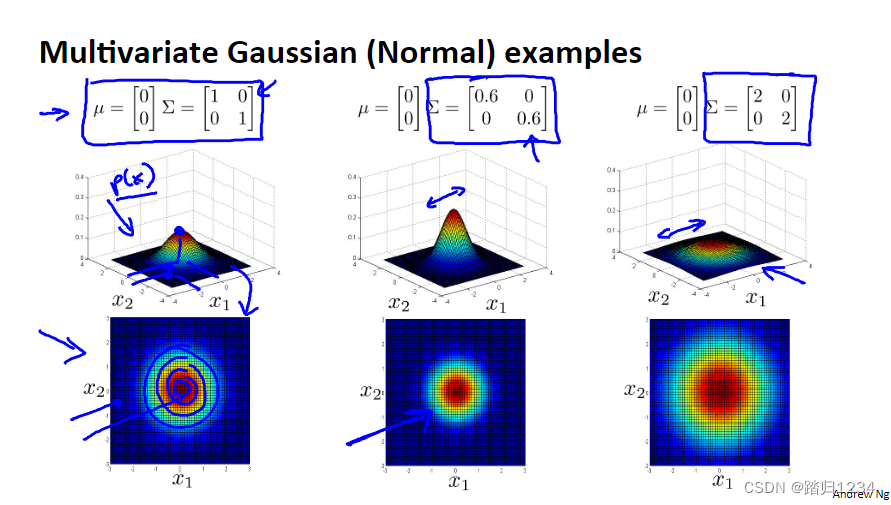
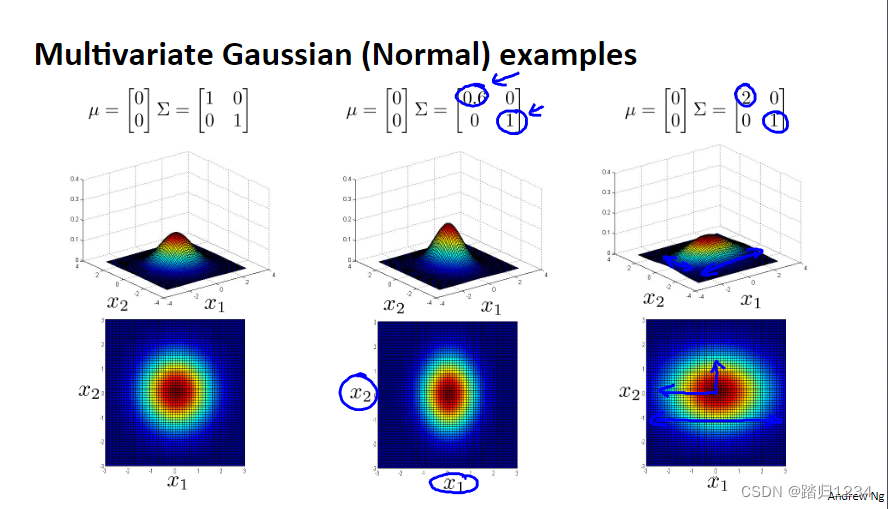
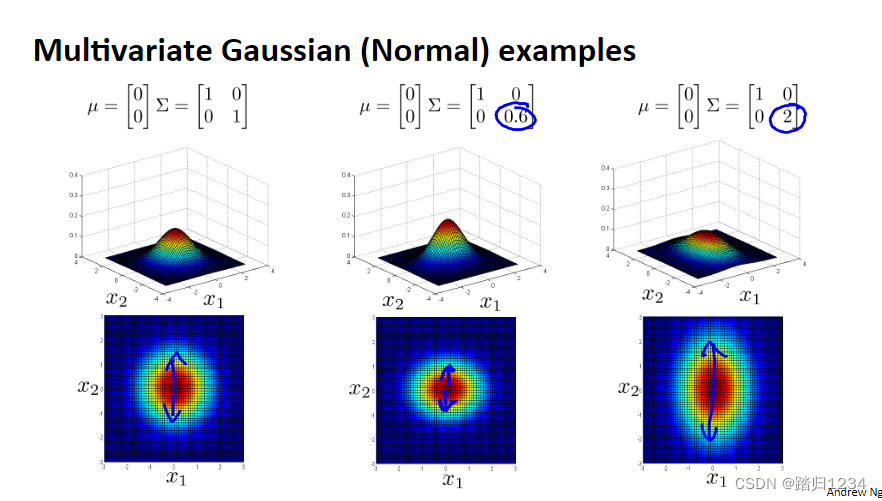
多变量高斯分布中,可以使用数据的相关性建模。也就是可以在
x
1
,
x
2
x_1, x_2
x1,x2高度相关时使用多变量高斯分布。
改变参数
u
u
u会如何呢?峰值点会改变。
使用多变量高斯分布的异常检测
引入:在本部分,我们将把多变量高斯分布应用到异常检验中。
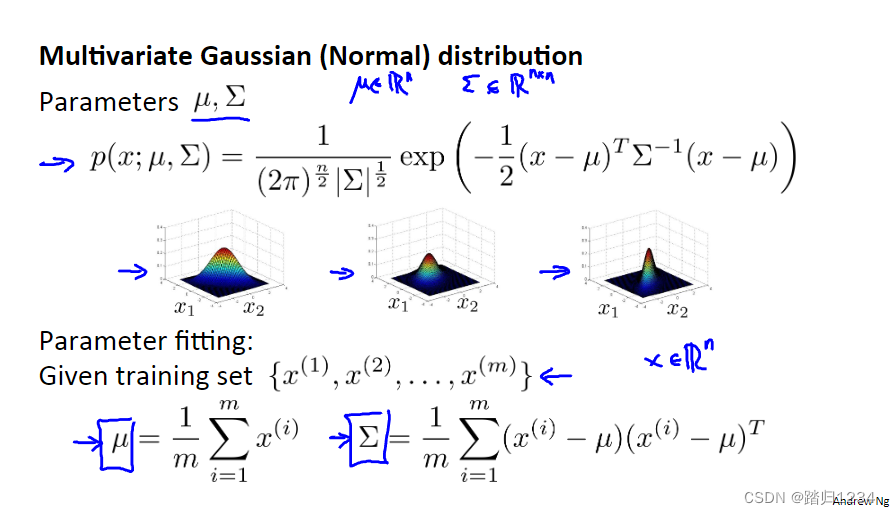
多变量高斯分布公式及曲线如下图,它有两个参数均值
u
u
u和协方差矩阵
Σ
\Sigma
Σ 。
于是又有参数估计问题:给定样本求参数
u
,
Σ
u, \Sigma
u,Σ,求导公式如图下侧。
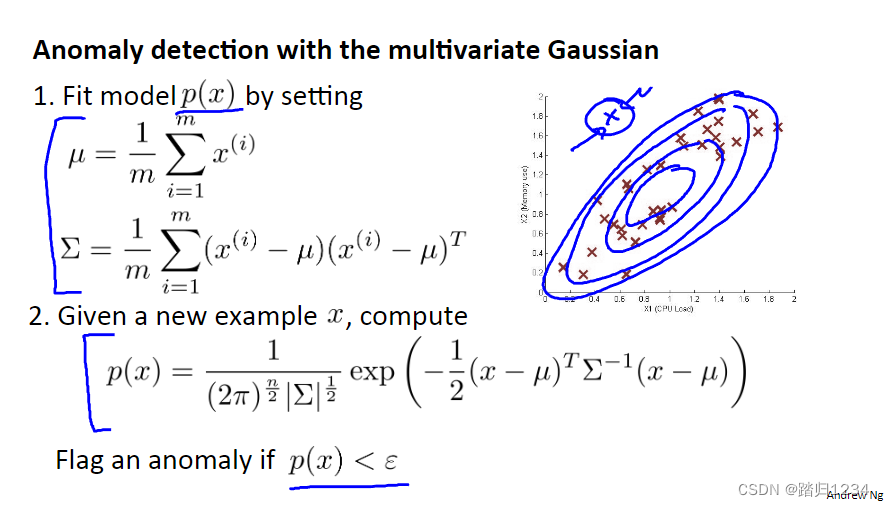
综上,可开发出异常检验算法如下图:
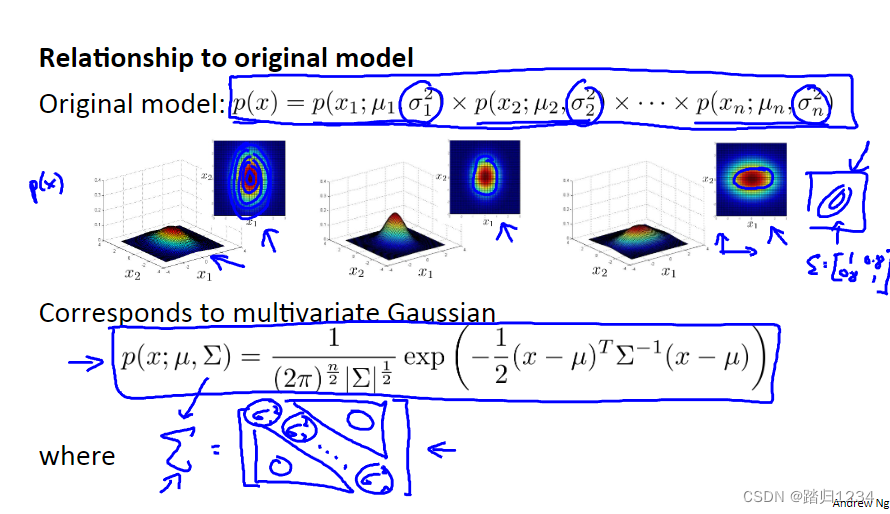
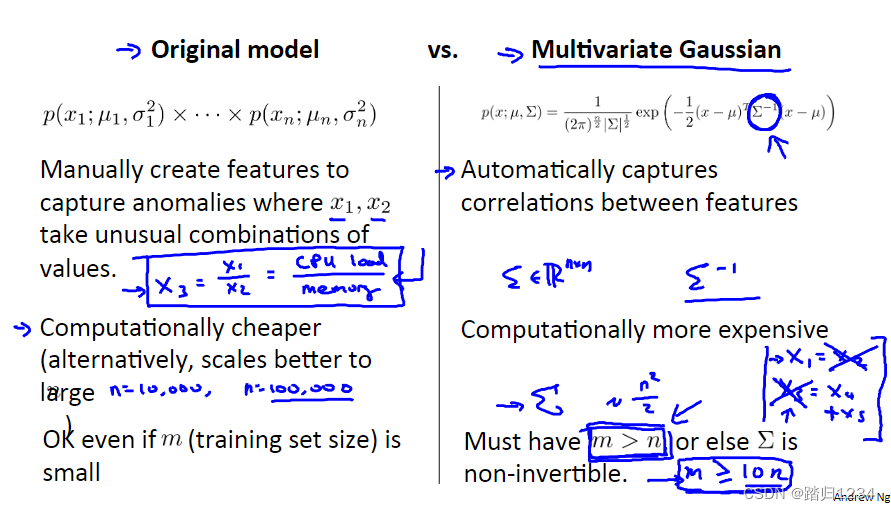
下面介绍多元高斯分布模型与原始模型的关系。
相对于多变量高斯模型,原始模型的轮廓(等高线)总是轴轴对齐的(axis-aligned)。
通过数学证明不难得到,原始模型实际是一种特殊的多变量高斯模型,只要
Σ
\Sigma
Σ是对角矩阵即可。此外,前者也往往能用后者拟合。
那么,如何在这两种模型中进行选择呢?
| 原始模型 | 多变量高斯分布模型 | |
|---|---|---|
| 使用频率 | 较为常用 | 使用较少 |
| 优点 | 计算成本较低,能适应巨大规模的特征n | 在捕捉特征间的关系方面优点更多,如能自动捕捉特征间的关系 |
| 使用情况 | 希望使用**异常特征的组合值(新特征)**来捕捉异常样本(捕捉特征间的关系) 特征量n巨大 训练集数量m较小时也可使用 | 特征量n不能过高 训练集数量m必须大于特征量n(一般需要 m ≥ 10 n m\ge10n m≥10n),否则 Σ \Sigma Σ将不可逆(奇异矩阵) |
注意: Σ \Sigma Σ不可逆存在两种原因:1、不满足 m ≥ n m \ge n m≥n; 2、存在冗余的特征(存在线性相关的变量,如 x 1 = x 2 x_1=x_2 x1=x2 or x 1 = x 2 + x 3 x_1=x_2+x_3 x1=x2+x3)。

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 1
 0
- 0


 已为社区贡献8条内容

所有评论(0)