本篇文章是根据视频( link.)所作的学习笔记,旨在对机器学习的相关知识更好的理解和巩固。本人基础较弱,推导中看不懂的公式可能会细究,如果有理解不当之处也欢迎指出。

线性分类概述

· 数据介绍

D={(x_{1},y_{1}),(x_{2},y_{2}),...,(x_{N},y_{N})}

X=(x_{1},x_{2},...,x_{N})^{T}=\begin{bmatrix} x_{11} & x_{12} &... &x_{1p} \\ x_{21}& x_{22} &... &x_{2p} \\ ... & ... & ...& ...\\ x_{N1}& x_{N2}& ...& x_{Np} \end{bmatrix}_{N\times p}

Y=\begin{bmatrix} y_{1}\\ y_{2}\\ ...\\ y_{N} \end{bmatrix}_{N\times 1}

线性分类可以理解在线性回归的基础上利用激活函数或者降维操作对数据进行分类。线性可理解为对二维数据,能用一条直线将正、负样本分开;对三维数据,线性可分意味着能用一个平面将正、负样本分开;对n维数据,线性可分意味着能用n-1维超平面将正、负样本分开。线性分类包括硬分类和软分类(以二分类为例):

1)硬分类

    y\in {\left \{ -1,1 \right \},常见的硬分类模型有感知机和Fisher线性判别。

 2)软分类

    y\epsilon \left [ 0,1 \right ],常见的软分类模型有概率判别模型(逻辑回归)和概率生成模型(高斯判别分析和朴素贝叶斯)。

本篇主要介绍两种常见的硬分类模型——感知机 和 Fisher判别,软分类见下篇。

线性分类之感知机

感知机算法由Rosenblatt在1957年提出,是一类简单的线性判别算法。如下图所示,黑色和红色分别为两类,S1,S2,S3为不同参数下的分界函数。

感知机思想——错误驱动学习,逐步使分类错误的样本数量减少至0。

感知机模型:

                      f(x)=sign(\omega ^{T}x+b)

                       sign(a)=\left\{\begin{matrix} +1, & a\geq 0\\ -1,& a< 0 \end{matrix}\right.

目标函数:

                     L(\omega, b)=\sum_{x_{i}\epsilon M}-y_{i}(\omega ^{T}x_{i}+b)

其中M为分类错误的样本数量,负号是因为在分错的时候才有y_{i}(\omega ^{T}x_{i}+b)< 0,分对的时候看sign()函数,同正得正,负负得正。

求解目标函数中的参数时,采用随机梯度下降法(SGD):

\left\{\begin{matrix} \bigtriangledown _{\omega }L(\omega ,b)=-\sum_{​{x_{i}\epsilon M}}x_{i}y_{i} \\ \\ \bigtriangledown _{b}L(\omega ,b)=-\sum_{​{x_{i}\epsilon M}}y_{i} \end{matrix}\right.

\left\{\begin{matrix} \omega ^{(t)}-\lambda \bigtriangledown _{\omega }L(\omega ,b)\rightarrow \omega ^{(t+1)} \\ \\ b^{(t)}- \lambda\bigtriangledown _{b}L(\omega ,b)\rightarrow b^{(t+1)} \end{matrix}\right.

\left\{\begin{matrix} \omega ^{(t)}+\lambda x_{i}y_{i}\rightarrow \omega ^{(t+1)} \\ \\ b ^{(t)}+\lambda y_{i}\rightarrow b ^{(t+1)} \end{matrix}\right.


其中感知机学习算法是收敛的,定理此处不予证明。按照公式结果依次迭代,直到把训练样本中的数据全部分类正确,即L(w,b)=0。

引申——当数据线性不可分的时候,允许一点错误出现的感知机做法叫做pocket算法,感兴趣者自行了解。

线性分类之Fisher线性判别

Fisher线性判别可以理解为将不好分类的数据投影到其他的方向,从而达到容易区分的目的。
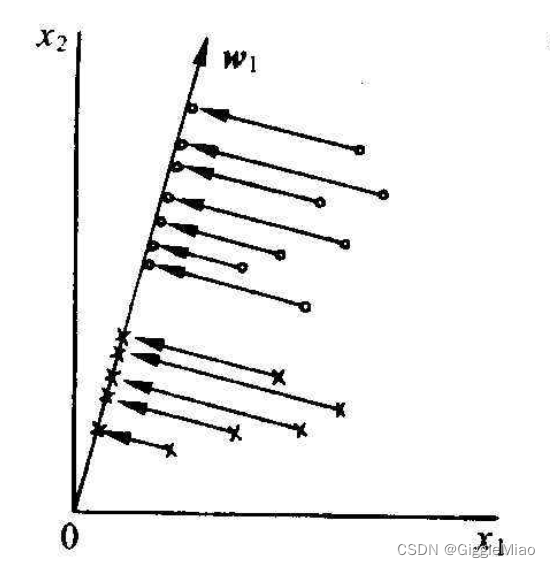
                   

其中,投影方向为\omega,在该上面的投影值为z=\omega ^{T}x,(投影值为<xi,w>的内积计算得到)。

 设二分类分别为C1,C2类,对应于y\in {\left \{ -1,1 \right \},则有:

\begin{Bmatrix} X_{C1}=\left \{ x_{i}|y_{i} =+1\right \},& |X_{C1}|=N_{1}\\ X_{C2}=\left \{ x_{i}|y_{i} =-1\right \},& |X_{C2}|=N_{2} \end{Bmatrix}_{N_{1}+N_{2}=N}

Lisher分类的基本思想——希望投影到\omega方向上的数据达到,类内距离小,类间距离大。并以此来设置目标函数J(\omega ):

 {\color{Red} {\color{Red} }J(\omega )=\frac{(\bar{Z_{1}}-\bar{Z_{2}})^{2}}{S_{1}+S_{2}}}

说明——\bar{Z_{1}}是类C1投影值的均值,S1类C1投影值的方差;\bar{X_{C1}}是类C1数据自身的均值,S_{C1}是类C1数据自身的方差。C2类同样如此。

随机向量自身的均值和方差公式(以类C1的投影Z1为例):

\left\{\begin{matrix}\bar{Z}=\frac{1}{N_{1}}\sum_{i=1}^{N_{1}}\omega ^{T}x_{i}\\ \\ S_{z}=\frac{1}{N_{1}}\sum_{i=1}^{N_{1}}(z_{i}-\bar{z})(z_{i}-\bar{z})^{T} \end{matrix}\right.

下面对目标函数进行化简:

(\bar{Z_{1}}-\bar{Z_{2}})^{2}\\ =(\frac{1}{N_{1}}\sum_{i=1}^{N_{1}}\omega ^{T}x_{i}-\frac{1}{N_{2}}\sum_{i=1}^{N_{2}}\omega ^{T}x_{i})^{2}\\ =[\omega ^{T}(\frac{1}{N_{1}}\sum_{i=1}^{N_{1}}x_{i}-\frac{1}{N_{2}}\sum_{i=1}^{N_{2}}x_{i})]^{2}\\\\ =[\omega ^{T}(\bar{X_{C1}}-\bar{X_{C2}})]^{2}\\\\ =\omega ^{T}(\bar{X_{C1}}-\bar{X_{C2}})^(\bar{X_{C1}}-\bar{X_{C2}})^{T}\omega

S_{1}=\frac{1}{N_{1}}\sum_{i=1}^{N_{1}}(\omega ^{T}x_{i}-\frac{1}{N_{1}}\sum_{i=1}^{N_{1}}\omega ^{T}x_{i})(\omega ^{T}x_{i}-\frac{1}{N_{1}}\sum_{i=1}^{N_{1}}\omega ^{T}x_{i})^{T} \\ =\frac{1}{N_{1}}\sum_{i=1}^{N_{1}}\omega ^{T}(x_{i}-\frac{1}{N_{1}}\sum_{i=1}^{N_{1}}x_{i})(x_{i}-\frac{1}{N_{1}}\sum_{i=1}^{N_{1}}x_{i})^{T}\omega \\ =\omega ^{T}\frac{1}{N_{1}}\sum_{i=1}^{N_{1}}(x_{i}-\bar{X_{C1}})(x_{i}-\bar{X_{C1}})^{T}\omega \\\\ =\omega ^{T}S_{C1}\omega

同理,S_{2}=\omega ^{T}S_{C2}\omega

\therefore S_{1}+S_{2}=\omega ^{T}S_{C1}\omega+\omega ^{T}S_{C2}\omega=\omega ^{T}(S_{C1}+S_{C1})\omega

{\color{Red} {\color{Red} }J(\omega )=\frac{\omega ^{T}(\bar{X_{C1}}-\bar{X_{C2}})(\bar{X_{C1}}-\bar{X_{C2}})^{T}\omega}{\omega ^{T}(S_{C1}+S_{C1})\omega}},分子分母上的向量不能随意化简约去,有方向

 至此,我们就得到了fisher判别中的目标函数,下一步分析如何来确定投影方向\omega:

令S_{b}=(\bar{X_{C1}}-\bar{X_{C2}})(\bar{X_{C1}}-\bar{X_{C2}})^{T},叫做类间方差;S_{\omega }=S_{C1}+S_{C1},叫做类内方差。

此时J(\omega )=\frac{\omega ^{T}S_{b}\omega }{\omega ^{T}S_{\omega }\omega }=(\omega ^{T}S_{b}\omega )(\omega ^{T}S_{\omega }\omega )^{-1}

 基于“类内距离小,类间距离大”,可得:

{\color{Red} {\color{Red} }\hat{\omega }=argmaxJ(\omega )}

\frac{\partial J(\omega )}{\partial \omega }=2S_{b}\omega(\omega ^{T}S_{\omega }\omega )^{-1}+(-1)(\omega ^{T}S_{\omega }\omega )^{-2}\cdot S_{\omega }\omega \cdot \omega ^{T}S_{b}\omega=0

S_{b}\omega(\omega ^{T}S_{\omega }\omega )^{-1}=(\omega ^{T}S_{\omega }\omega )^{-2}\cdot S_{\omega }\omega \cdot \omega ^{T}S_{b}\omega

两边同时乘以(\omega ^{T}S_{\omega }\omega )^{-2},得S_{b}\omega\cdot \omega ^{T}S_{\omega }\omega =S_{\omega }\omega \cdot \omega ^{T}S_{b}\omega

分析:\omega \in R^{p\times 1},\omega ^{T}\in R^{1\times p},S_{b},S_{\omega }\in R^{p\times p},\therefore \omega ^{T}S_{\omega }\omega与\omega ^{T}S_{b}\omega都为实数,不影响方向

\therefore \omega \propto S_{\omega } ^{-1}S_{b}\omega= S_{\omega } ^{-1}(\bar{X_{C1}}-\bar{X_{C2}})(\bar{X_{C1}}-\bar{X_{C2}})^{T}\omega

其中,(\bar{X_{C1}}-\bar{X_{C2}})^{T}\omega 也是一个实数,不影响方向

{\color{Red} \therefore \omega \propto S_{\omega } ^{-1}(\bar{X_{C1}}-\bar{X_{C2}})}

推完啦同志们!提前给自己下班!新年快乐~

参考: https://blog.csdn.net/jian_qiao/article/details/85346664

https://blog.csdn.net/qq_18870127/article/details/79097735

Logo

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。

更多推荐

