吴恩达机器学习作业(一)线性单变量回归实验
题目:
假设你是一家特许经营餐厅的首席执行官,正在考虑在不同的城市开一家新餐厅。该连锁店已经在各个城市有了卡车,你有了来自城市的利润和人口数据。你希望使用此数据来帮助您选择下一步要扩展到哪个城市。文件ex1data1.txt包含用于我们的线性回归问题的数据集。第一列是一个城市的人口第二列是这个城市的食品卡车的利润。利润为负值表示亏损。
解题思路:
第一步:设定假设函数:
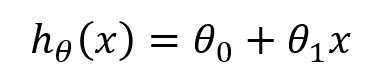
其中,θ0为常数项,θ1为x项系数,我们要做的就是不断优化这两个参数,使得函数h所求得的解尽可能接近实际值。
第二步:设定代价函数:
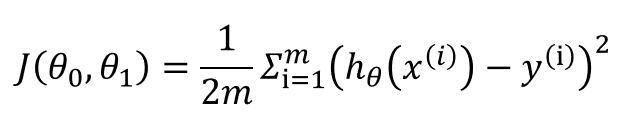
我们优化参数θ0和θ1的目的实际上就是为了减少代价,使损失尽可能降到最低。
第三步:梯度下降过程:
梯度下降算法的思想就是在开始时随机选择一个参数组合作为初始值,计算代价函数,在训练过程中不断寻找下一个能够使得代价函数下降速度最快的参数组合。持续计算直到寻找到一个局部最小值,而初始值的不同可能会造成函数寻找到不同的最小值点。 但是对于线性回归而言,其代价函数总是凸函数,因此线性回归函数中的局部最优解就是全局最优解。
注意:在梯度下降过程中,多个不同参数应该是同时更新的。
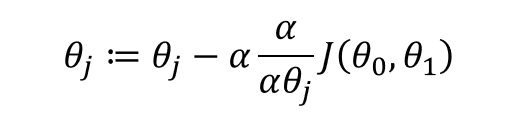
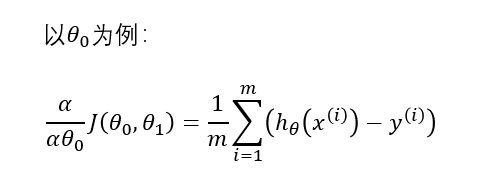
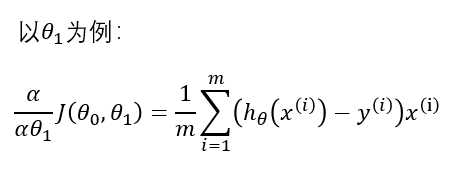
在梯度下降的计算过程中,使用到了学习率α这个概念,学习率决定了沿着代价函数下降的步长,因此会影响算法收敛速度的快慢,选择合适的学习率非常重要。起初我们不确定最合适的α 值是多少时,一般会选取等比的一系列α 值做尝试,如0.001,0.003,0.01,0.03,0.1,0.3,1,… 每次尝试间隔大约是3倍左右。最终比较不同学习率下算法的收敛速度,选取合适的学习率α 。
python代码(梯度下降法)
import numpy as np
import matplotlib.pyplot as plt
#计算误差(对应损失函数)
def compute_error_for_line_given_points(b, w, points):
    total = 0
    for i in range(len(points)):
        x = points[i,0]
        y = points[i,1]
        total = total + (y-(w*x+b))**2
    return total/(2*len(points))

#梯度下降更新参数
def step_gradient(b_current, w_current, points, learningRate):
    b_gradient = 0
    w_gradient = 0
    for i in range(len(points)):
        x = points[i,0]
        y = points[i,1]
        b_gradient = b_gradient + ((w_current*x+b_current)-y)
        w_gradient = w_gradient + x*((w_current*x+b_current)-y)
    b_new = b_current - learningRate*(b_gradient/len(points))
    w_new = w_current - learningRate*(w_gradient/len(points))
    #返回更新的参数
    return b_new,w_new
#执行梯度下降迭代过程
def gradient_runner(points, start_b, start_w, learningRate, iteration):
    b = start_b
    w = start_w
    #cost用来保存每轮迭代的误差,用以绘制误差函数图像
    cost=[]
    for i in range(iteration):
        b, w = step_gradient(b,w,points,learningRate)
        #将此轮迭代的误差添加到cost数组
        cost.append(compute_error_for_line_given_points(b, w, points))
    plt.figure()
    #绘制误差函数对应的图像
    plt.plot(range(iteration),cost)
    plt.xlabel('iteration times')
    plt.ylabel('loss')
    plt.title('cost iteration')
    plt.show()
    return b,w

def run(points):
    #运行程序,并定义所需参数
    learningRate = 0.01
    b_initial = 0
    w_initial = 0
    iteration = 5000
    b, w = gradient_runner(points, b_initial, w_initial, learningRate, iteration)
    return b,w

if __name__ == '__main__':
    #读取数据保存到points
    points = np.loadtxt("E:\homework/no_01\ex1data1.txt", delimiter=',')
    b_conclusion, w_conclusion = run(points)
    #输出最终得出的参数结果
    print(b_conclusion, w_conclusion)
    #绘制拟合图像
    a = np.linspace(1.0, 25.0, 10)
    b = np.ones(10)
    for i in range(10):
        b[i] = a[i]*w_conclusion + b_conclusion
    plt.figure()
    #添加原始数据
    x = points[:, 0]
    y = points[:, 1]
    plt.scatter(x, y, c='r', s=4.0)
    plt.plot(a,b)
    plt.title('linear line')
    plt.show()
所得拟合图像:

所得代价函数变化图像:
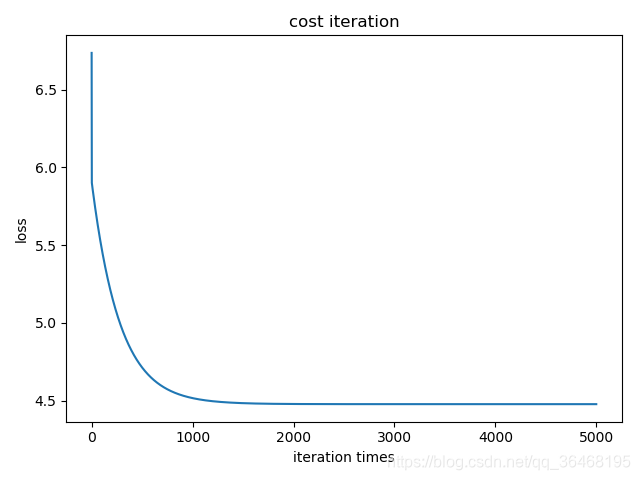
注意:学习率的不同会很大程度上影响曲线变化,可以多尝试几种不同的学习率观察函数变化
附上数据集文件:
链接:https://pan.baidu.com/s/1_ubyonM8Dv6ON6zEElkVpw
提取码:czpy

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 2
 0
- 0


 已为社区贡献2条内容

所有评论(0)